Como criar uma aplicação web sem servidor na AWS
9 de maio de 2016
0 minutos de leituraNota do editor
Este blog foi publicado originalmente em fugue.co. A Fugue se juntou à Snyk em 2022 e é um componente essencial do Snyk IaC.
Aqui na Fugue, a equipe Web é pequena, mas apaixonada por JavaScript, 60 quadros por segundo e DevOps simples. Gostamos de experimentar e explorar novas abordagens de computação que priorizem conteúdo e elegância, em vez de modismos e firulas. Há algum tempo usamos o AWS Lambda com tópicos do SNS e votebots, mas ainda não tínhamos feito nada grande com ele. Até agora. O framework Serverless nos deu o impulso de que precisávamos. Nosso objetivo? Criar uma aplicação útil para uma área de negócios por meio de uma API desenvolvida com Lambda e API Gateway, sem prejudicar nenhuma instância EC2 nesse processo.
Vamos voltar um instante para explicar brevemente o AWS Lambda. Assim como o IBM OpenWhisk, o Google Cloud Functions e o Azure Functions, ele é um serviço “para executar código em resposta a eventos específicos, como o upload de um arquivo para o Amazon S3, um fluxo de eventos ou uma solicitação a um gateway de API”. Fintan Ryan, citado parcialmente, apresenta uma boa visão geral aqui. Seu código é escalado automaticamente para atender às solicitações. Esse modelo de computação direta está em plena expansão.
A aplicação
A aplicação web de front-end que criamos é simples. O usuário faz login e vê conteúdo sobre nossas compilações de software e URLs seguras para download. A aplicação fica no S3. Estamos criando uma API REST para viabilizar essa experiência. Veja a arquitetura da API:
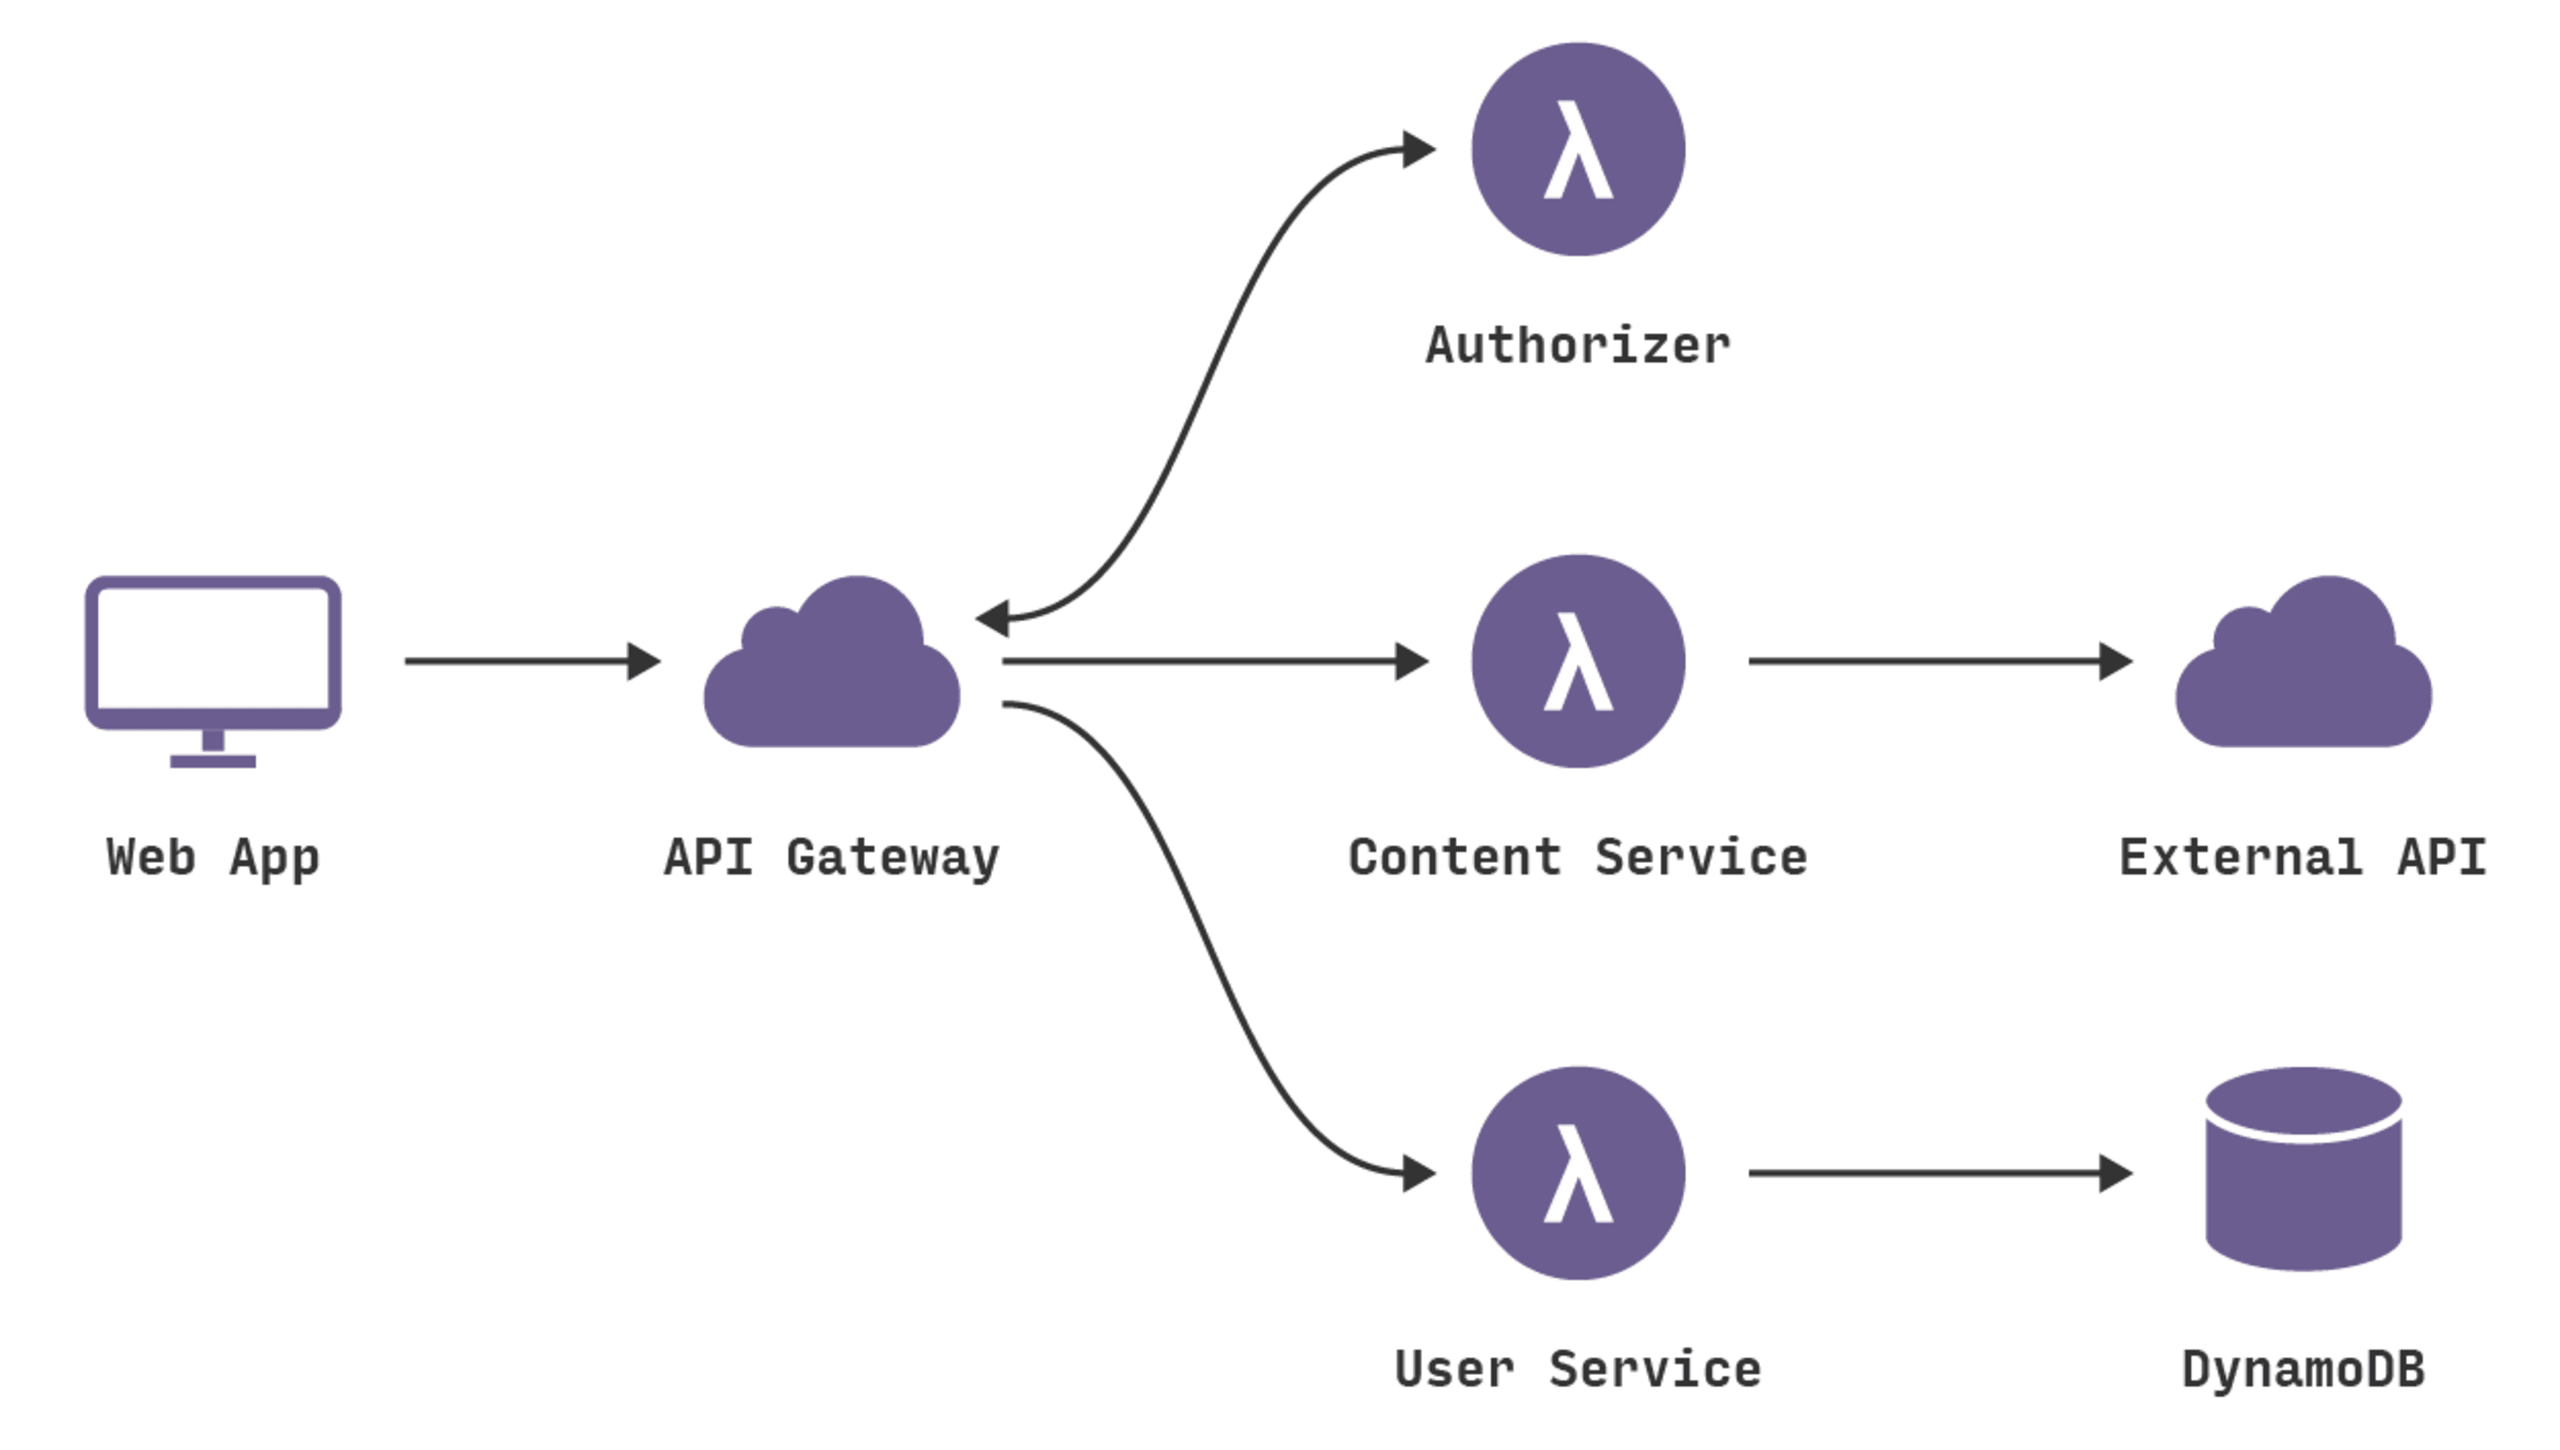
Observe que temos um conjunto de endpoints do API Gateway que acionam funções Lambda. A função Lambda do User Service armazena dados no DynamoDB. A função Lambda do Content Service se conecta à API do nosso serviço de distribuição para recuperar conteúdo, faz algumas transformações visuais e envia esse conteúdo de volta para a aplicação de front-end. A função Lambda de autorização valida os tokens de sessão dos usuários e permite o acesso aos endpoints protegidos.
Você poderia configurar todos esses serviços manualmente na AWS, mas usamos o framework Serverless como ferramenta de implantação e para dar estrutura ao nosso projeto.
Conheça o Serverless
O Serverless é um framework para criar aplicações com Lambda e API Gateway. Ele também permite gerenciar outros recursos da AWS por meio de modelos do CloudFormation. Ele é distribuído como uma CLI do Node.js bem documentada.
O Serverless é poderoso porque gerencia tanto seu código quanto sua configuração da AWS. Ele tem uma estrutura de projeto específica, com arquivos de configuração JSON para as funções Lambda. Esses arquivos incluem definições dos endpoints do API Gateway e de outros eventos que podem acionar a função. Para implantar seu projeto, você precisa criar um usuário Serverless na sua conta da AWS e conceder a ele permissões para os serviços que está usando. Depois, você pode usar a CLI para fazer a implantação. Ela configura os serviços da AWS que você utiliza e publica o código da sua função Lambda.
Resolvendo pontos problemáticos
O Serverless resolve com eficiência alguns dos problemas que encontramos ao tentar configurar esse tipo de projeto na AWS sem usar um framework:
1) As funções Lambda são independentes e não podem compartilhar código.
Se você está desenvolvendo um projeto com várias funções, provavelmente vai querer compartilhar algum código entre elas, mesmo que seja apenas uma biblioteca utils. As funções Lambda são implantadas em contêineres isolados, então não podem depender de um diretório de biblioteca comum. O Serverless resolve isso permitindo configurar o nível específico do diretório que queremos incluir no pacote de implantação. Assim, você pode incluir na função código de uma pasta em um diretório superior, que também pode ser usada por outras funções. Os arquivos incluídos serão compactados junto com o pacote de implantação.
2) As funções Lambda não oferecem suporte a variáveis de ambiente.
Como incluir credenciais secretas, como chaves de API, com segurança na sua função Lambda sem inseri-las diretamente no código e deixá-las visíveis para quem acessa seu repositório do Github? O Serverless armazena as definições das variáveis de ambiente em arquivos JSON em uma pasta _meta ignorada pelo Git e insere os valores nas funções durante o processo de implantação. Se você trabalha em equipe, o plugin Meta Sync sincroniza essas definições de variáveis com segurança pelo S3.
3) É difícil fazer o API Gateway se comunicar com o Lambda.
Cada endpoint do API Gateway precisa de um modelo de solicitação que especifique quais informações da solicitação ficarão disponíveis para a função Lambda acionada. Sua função Lambda provavelmente precisará saber o caminho e o método da solicitação, os parâmetros da URL, os parâmetros de consulta e, talvez, um cabeçalho personalizado ou o corpo de uma solicitação POST. Nada disso fica disponível sem um modelo de solicitação. Da mesma forma, por padrão, o API Gateway não interpreta a resposta de uma função Lambda. Portanto, se sua função retornar um erro, não haverá mapeamento automático para códigos de erro HTTP. Você precisará adicionar um modelo de resposta para mapear as mensagens de erro da função Lambda para o código de resposta adequado. O Serverless facilita esse processo com suporte à herança de modelos de solicitação e resposta. Assim, você pode definir modelos universais para todos os endpoints e substituí-los individualmente quando necessário.
Estrutura do projeto
Veja a estrutura de diretórios do projeto Serverless da nossa aplicação:
s-project.json
Esse arquivo contém o nome e a descrição do projeto, além dos plugins personalizados usados nele.
s-resources-cf.json
Esse é um modelo do CloudFormation para os recursos usados pelo projeto, além do Lambda e do API Gateway. No nosso caso, trata-se de uma tabela do DynamoDB e de uma função e uma política do IAM que permitem à função Lambda ler e gravar dados no DynamoDB.
_meta
Essa pasta contém arquivos JSON com variáveis de ambiente do projeto, que podem ser específicas da etapa de implantação e da região. Essa pasta é ignorada pelo Git.
functions
Essa pasta contém subpastas para cada uma das nossas funções Lambda. O Serverless não impõe uma estrutura organizacional, então você pode aninhar funções em pastas como preferir. A pasta de cada função deve conter um arquivo com o código da função (neste caso, handler.js) e um arquivo s-function.json, que contém a configuração da função e os endpoints que podem acioná-la. Ela também pode conter um arquivo event.json, que guarda um objeto de teste sobre o qual falaremos mais adiante. Como mencionamos, temos uma pasta lib ao lado das pastas das funções, que pode ser incluída por cada uma delas (ou seja, user e content).
Um olhar mais de perto nos componentes do projeto Serverless
O projeto Serverless tem três componentes arquitetônicos principais: funções Lambda, uma API REST do API Gateway e outros recursos da AWS, como nossa tabela do DynamoDB e a função do IAM. Vamos ver com mais detalhes como usamos esses componentes.
Funções Lambda
Além da função Lambda authorizer, sobre a qual falaremos em breve, dividimos o código em duas funções: content e user. Por quê?
Tecnicamente, você pode dividir o código Lambda como quiser. Todos os endpoints poderiam acionar uma única função, que analisaria a solicitação e decidiria como responder. Ou você pode criar funções para cada endpoint e evento do projeto. Optamos por uma abordagem híbrida, agrupando o código em funções de microsserviços após considerar alguns fatores:
Organização do código
Faz sentido atribuir endpoints semelhantes à mesma função. Todo o nosso código relacionado a usuários trabalha com a mesma tabela do banco de dados e usa as mesmas bibliotecas externas. Ao agrupar esse código semelhante em uma função, garantimos que as alterações no código sejam aplicadas imediatamente a todos os endpoints.
Desempenho
A documentação do Lambda indica que funções menores têm melhor desempenho. A latência da função é muito maior quando ela não é invocada há algum tempo — pela nossa experiência, quando não é chamada há cerca de cinco minutos. Após a primeira invocação, a latência cai drasticamente. A latência inicial, ou “tempo de inicialização a frio”, está diretamente relacionada ao tamanho da função. Funções menores têm tempos de inicialização a frio mais rápidos. (Você também pode reduzir esse tempo aumentando a alocação de memória das funções, o que aumenta proporcionalmente a CPU.)
Esse tempo de inicialização a frio mais lento não é um problema em casos de uso assíncrono do Lambda, mas é para uma API que recebe pouco tráfego. Nossa API precisa responder rapidamente, caso contrário, a experiência de uso da aplicação será prejudicada.
Agrupar funcionalidades relacionadas em funções Lambda maiores garante certo nível de aquecimento. Por exemplo, quando um usuário entra na conta e, em seguida, visualiza o perfil, isso pode gerar duas chamadas de API. A primeira pode ser lenta se a função não tiver sido invocada recentemente, mas a segunda será rápida se os dois endpoints acionarem a mesma função.
Observação: conversamos sobre manter nossas funções aquecidas enviando um ping a um endpoint a cada cinco minutos. Isso certamente funcionaria, mas não sentimos necessidade de implementar essa solução.
Manipulador de função
No arquivo s-function.json, definimos o manipulador da função. No nosso caso, é uma função chamada handler em handler.js. Essa é a função chamada quando a função Lambda é invocada. Veja como é o content da função handler.js:
Como você pode ver, ele funciona basicamente como um roteador da nossa função. Todo o código importante fica separado em /lib/download.js, que não sabe que faz parte de uma função Lambda. Isso facilita a criação de testes de unidade para o código, já que /lib/download.js é apenas um arquivo JavaScript, sem dependências especiais do Lambda.
API REST do API Gateway
Os endpoints são configurados no arquivo s-function.json. Veja um exemplo de configuração de endpoint:
Esse endpoint ficará disponível em GET /downloads.
Modelos de solicitação e resposta
No exemplo de configuração de endpoint acima, você viu $${requestTemplate} e $${responseTemplate}. Isso indica que o endpoint downloads herdará os modelos requestTemplate e responseTemplate definidos em um arquivo global de modelos do projeto.
Os modelos de solicitação e resposta são representados em JSON e usam expressões JSONPath. É possível manipular expressões JSONPath com a Apache Velocity Template Language (VTL). A sintaxe é um pouco complicada.
O Serverless adicionou recentemente suporte a modelos YAML de solicitação e resposta, mas atualmente usamos o formato JSON. Veja nosso modelo de solicitação:
Sim, ele parece um pouco maluco, como é de se esperar de um JSON escapado dentro de outro JSON, mas gera um objeto de evento para a função Lambda com todas as informações necessárias sobre a solicitação:
body contém o corpo JSON analisado da solicitação
path é o caminho do endpoint solicitado
method é o método HTTP usado na solicitação
headers contém todos os cabeçalhos HTTP da solicitação
params contém os parâmetros de caminho da solicitação
query contém os parâmetros de consulta da solicitação
authorizedUser é o nome de usuário autorizado, caso o endpoint exija autorização
E aqui está nosso modelo de resposta. Se a função Lambda for executada com sucesso, a string do resultado será enviada ao usuário como JSON (usando o fragmento de modelo response200). Se a função falhar, as expressões regulares tentarão corresponder à string do resultado. Retornamos códigos de erro HTTP diferentes de acordo com a mensagem de erro.
Como lidar com a autorização
Estamos usando dois recursos do API Gateway no componente de permissões da nossa aplicação: chaves de API e funções de autorização personalizadas. Esses dois recursos simplificam o código da aplicação, removendo as questões de autorização das funções Lambda principais.
Chaves de API
O API Gateway permite criar uma chave de API e atribuí-la a endpoints específicos. Usamos esse recurso para proteger determinados endpoints sensíveis que não devem ser acessados pelo cliente, como os de gerenciamento de usuários. O API Gateway procura um cabeçalho x-api-key nas solicitações aos endpoints selecionados e tenta comparar o valor com a chave de API criada. Se o cabeçalho estiver ausente ou incorreto, a solicitação retorna um erro 403 e a função Lambda nem chega a ser invocada.
Autorizadores personalizados
Recentemente, o API Gateway adicionou a autorização personalizada, que permite que uma função Lambda controle o acesso aos endpoints. Uma solicitação recebida invoca a função de autorização personalizada com um token de autorização enviado em um cabeçalho personalizado especificado. O autorizador personalizado valida o token (no nosso caso, um JSON Web Token) e retorna uma política do IAM para autorizar a solicitação. Se a política não for válida para a solicitação ou a autorização falhar, o API Gateway retornará um erro 403. Se a política for válida, a função Lambda associada ao endpoint será acionada.
Veja um exemplo da política do IAM retornada pelo nosso autorizador personalizado:
Como nosso aplicativo web não tem permissões granulares, concedemos acesso a todos os endpoints da API que usam o autorizador personalizado. O API Gateway armazena em cache a política do IAM gerada junto com o token de autorização usado para criá-la. Nas solicitações seguintes a qualquer endpoint protegido, com o mesmo cabeçalho de token de autorização, essa política será aplicada automaticamente, sem passar pelo autorizador personalizado, durante o TTL especificado.
Fluxo de trabalho do projeto Serverless
Ambientes
No mínimo, nosso projeto precisa de ambientes separados de desenvolvimento, teste e produção.
O Serverless usa o conceito de “stages”, implementado de maneiras diferentes nos vários serviços da AWS, mas que, em conjunto, funciona como um ambiente.
Lambda: sempre que o código de uma função Lambda muda, uma nova versão é criada automaticamente. As funções Lambda podem ter aliases para as versões, e o Serverless usa aliases para apontar para versões diferentes em cada stage. Por exemplo, se o stage dev for publicado e se tornar a v1 da função Lambda, o Serverless também criará um alias dev que aponta para a v1. Se o stage prod da função for publicado em seguida, o código de produção se tornará a v2, mas o alias dev continuará apontando para a v1.
API Gateway: uma única API no API Gateway pode ter vários stages. Cada stage de um endpoint de API pode acionar um alias Lambda diferente. Assim, o stage dev do API Gateway pode usar o alias dev da função Lambda, seja qual for a versão para a qual ele estiver apontando. O nome do stage passa a fazer parte do caminho do endpoint.
Outros serviços da AWS, como tabelas do DynamoDB e buckets do S3, existem individualmente em cada stage.
Testes
Cada pasta de função Lambda pode conter um objeto de evento simulado para testes em um arquivo event.json:
serverless function run executa a função usando event.json como evento. Isso é útil para testar a função de ponta a ponta.
Há alguns plugins do Serverless que simulam o API Gateway localmente para testes, como o Offline e o Serve. Como o API Gateway ainda está adicionando recursos, descobrimos que esses plugins nem sempre ofereciam suporte aos recursos que queríamos usar. Por isso, acabamos fazendo a maior parte dos testes do API Gateway no Console da AWS.
Usamos Jasmine para testes unitários nos nossos arquivos JavaScript lib.
Implantação
Para que nosso projeto fique pronto para uso, é preciso implantar três itens: funções, endpoints e recursos do projeto (ou seja, os recursos da AWS listados em s-resources.json). Podemos implantá-los individualmente com estes comandos da CLI:
Ou podemos usar o prático painel interativo de implantação, com o comando serverless dash deploy:
Com qualquer uma dessas opções, podemos fazer implantações bem granulares e atualizar uma função ou um endpoint sem alterar mais nada.
O painel interativo é ótimo para desenvolvimento e testes locais, mas usamos o primeiro conjunto de comandos com ferramentas de integração contínua. Por padrão, a CLI solicita as opções ausentes, mas você pode desativar essa interação definindo como true uma variável de ambiente chamada CI. Usamos o Travis CI para integração contínua e implantações. Assim, o Travis executa nossos testes unitários e depois usa a CLI no modo CI para implantar nosso código na AWS.
Consulte a referência da CLI do Serverless para saber mais.
Considerações finais
Há alguns meses, nosso CEO, Josh, compartilhou suas reflexões sobre o AWS Lambda e a evolução contínua da nuvem. Ele observou:
O Lambda é um serviço que define uma arquitetura de aplicação específica, ao contrário das ofertas tradicionais de PaaS. Ele não tenta ser um computador tradicional nem um cluster de computadores tradicionais. Em vez disso, o Lambda é naturalmente orientado a eventos e impõe a ausência de estado no nível da função. Isso significa que você precisará pensar de um jeito um pouco diferente sobre como compor uma aplicação. Em comparação com instâncias de computação ou contêineres, você ganha escalabilidade quase infinita e custos muito baixos. Como contrapartida, é preciso dedicar tempo ao aprendizado, mas é bem possível que você invente novos padrões durante a experimentação e a investigação.
Concordamos. Vale a pena investir tempo para aprender e colocar a mão na massa. Esperamos que o exemplo apresentado aqui seja útil. É provável que surjam outros frameworks como o Serverless em um futuro próximo, mas este é uma boa opção para começar e criar uma aplicação web sólida.
Segurança de IaC pensada para quem desenvolve
A Snyk protege sua infraestrutura como código do ciclo de vida do desenvolvimento de software até a execução na nuvem, com um mecanismo unificado de políticas como código para que todas as equipes possam desenvolver, implantar e operar com segurança.


