Criando um resumo de notícias de segurança com um agente de IA do CrewAI
Escrito por

0 minutos de leitura
Acompanhar tantas fontes de notícias de segurança e bancos de dados de vulnerabilidades dá trabalho. Mas, com o avanço dos fluxos de trabalho de IA agentiva, podemos delegar essa tarefa a um LLM. Neste artigo, mostramos como usar o framework de código aberto CrewAI para criar um agente de IA que seleciona notícias de segurança.
Agentes de IA para selecionar notícias de segurança
Na aplicação que vamos criar, o foco será selecionar novas vulnerabilidades de segurança do Snyk Vulnerability Database para compor um feed de notícias de segurança.
Nosso agente de IA será uma ferramenta de linha de comando que abre a página do Snyk Vulnerability Database para determinado ecossistema (usaremos o ecossistema JavaScript do npm) e seleciona os três relatórios de CVE mais relevantes, que considerar mais importantes.
Primeiros passos com o CrewAI
Na primeira etapa, vamos criar a estrutura de um novo projeto em um diretório à sua escolha no ambiente de desenvolvimento local e inicializar o framework CrewAI.
Você vai precisar de:
O gerenciador de pacotes uv instalado e disponível localmente
Um ambiente de execução Python >= 3.x (pode ser instalado com
uv)
No diretório escolhido, vamos começar instalando a biblioteca e as ferramentas crewai:
Em seguida, adicione o CrewAI ao ambiente do shell em uso para que possamos executar o comando crewai como um executável global:
Agora, vamos criar a estrutura de um novo projeto crewai:
Depois, instale as dependências do projeto executando este comando:
A estrutura do projeto criado deve ficar assim:
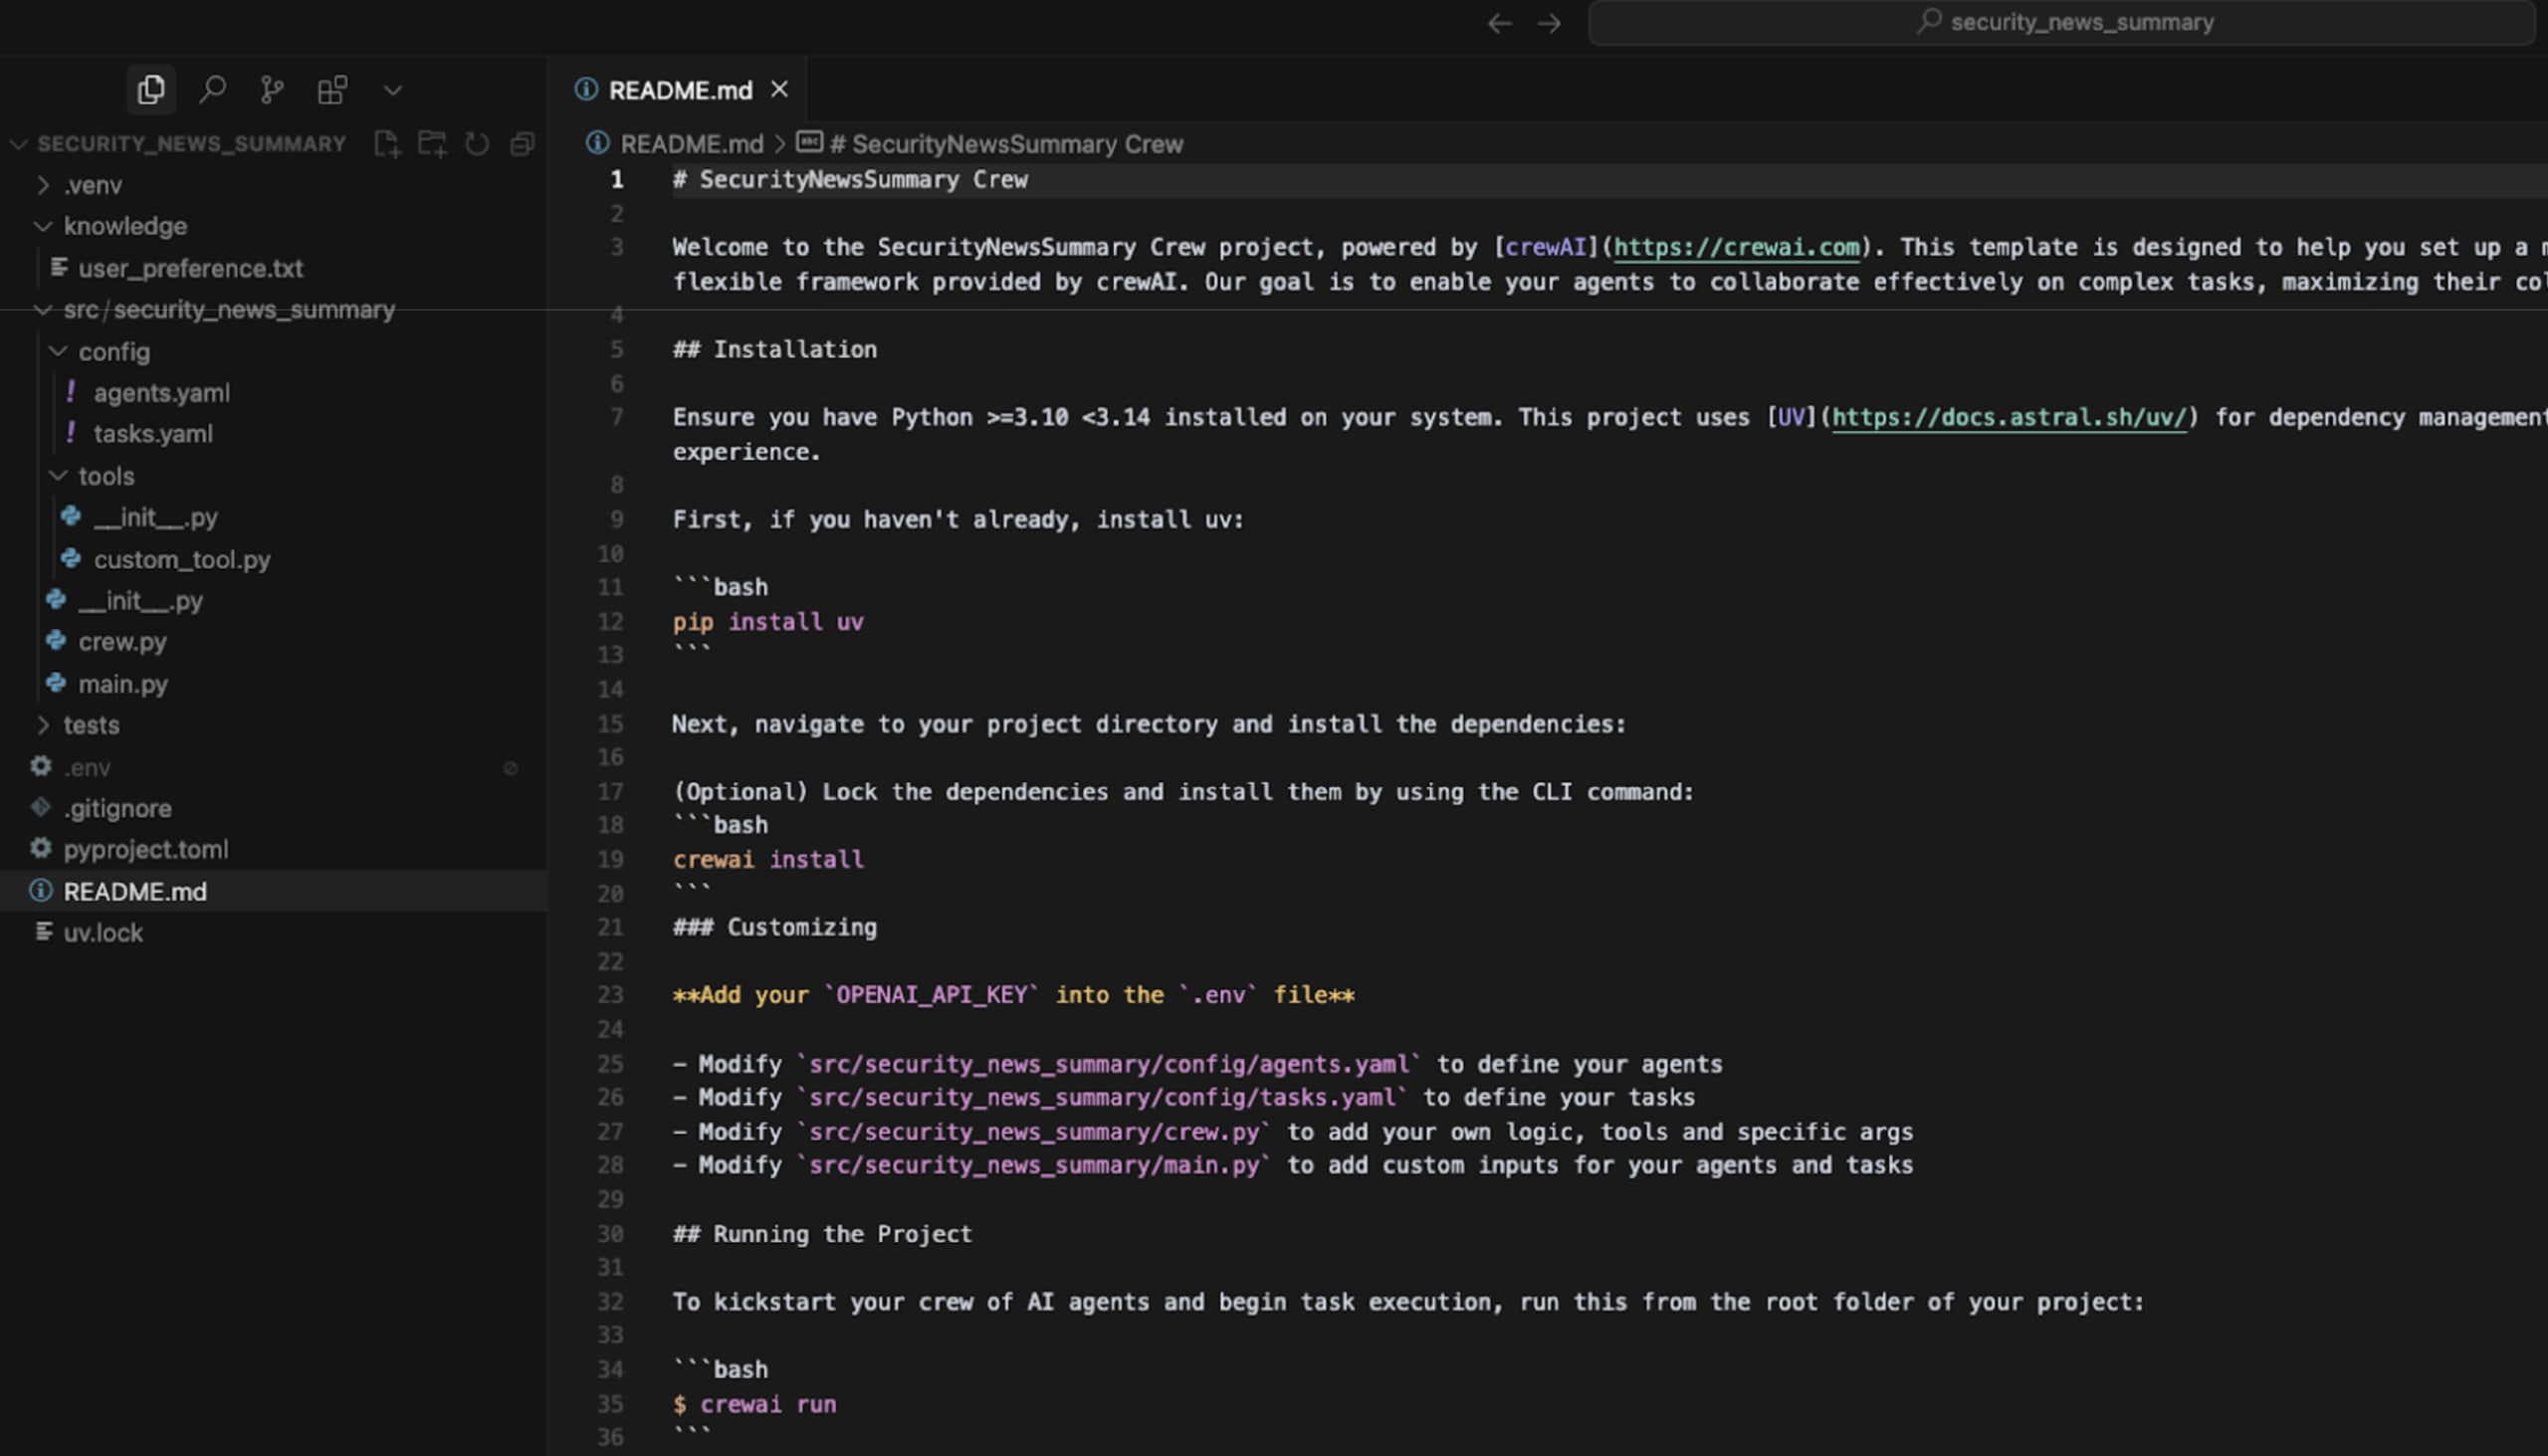
Em linhas gerais, o CrewAI tem um arquivo crew.py que define os agentes e as tarefas:
Esse mesmo arquivo também inclui as tarefas que queremos executar com esses agentes:
O arquivo main.py exporta várias funções, como run(), train() e outras, que acionam os agentes e fornecem as entradas necessárias para que realizem o trabalho.
Veja como funciona o fluxo de inicialização dos agentes no arquivo principal do Python:
Tudo isso descreve a estrutura padrão de diretórios de exemplo que o CrewAI cria para o projeto. Mas vamos fazer alterações, definir nossos próprios agentes e tarefas e criar uma ferramenta personalizada para eles usarem.
Criando fluxos de trabalho agentivos personalizados com o CrewAI
Vamos alterar três partes principais da estrutura criada para o projeto CrewAI:
Alterações nos agentes em
config/agents.yamlAlterações nas tarefas em
config/tasks.yamlAlterações no programa Python principal CrewAI, em crew.py
Além disso, vamos criar uma ferramenta personalizada no diretório tools/ para extrair o HTML de uma página da Web usando a popular biblioteca Python BeautifulSoup.
Agentes de IA
Uma boa regra para criar agentes de IA é dividir as tarefas em etapas tão pequenas quanto possível. Assim como na engenharia e no design de software, dividir problemas grandes em partes menores ajuda bastante.
Seguindo essa recomendação, vamos definir dois agentes:
Um curador de CVEs, cuja função é encontrar na página da Web links para as CVEs que considerar mais importantes.
Um pesquisador de CVEs, cuja função é acessar cada link de CVE (página da Web) e extrair os dados.
Abra config/agents.yaml e substitua a definição de agentes criada pelo CrewAI pelo seguinte:
Tarefas
Em seguida, precisamos definir as tarefas dos agentes:
A tarefa inicial é extrair os links das CVEs do diretório do banco de dados de vulnerabilidades (a página principal da Web com os resultados da busca e a lista de vulnerabilidades).
Na tarefa seguinte, o agente pesquisador de CVEs deve extrair os dados da vulnerabilidade de cada CVE na respectiva página de informações.
Abra o arquivo config/tasks.yaml e substitua o conteúdo criado pela biblioteca CrewAI pelo seguinte:
Repare como as tarefas foram redigidas cuidadosamente para que nossos agentes de IA consigam interpretá-las e executá-las, com um exemplo do resultado esperado e regras a seguir.
Ferramentas personalizadas
Para a primeira tarefa e o primeiro agente, o curador de CVEs, precisamos criar nossa própria ferramenta em Python. Isso é necessário porque a ferramenta integrada ScrapeWebsiteTool do CrewAI só extrai o texto de uma página da Web e não consegue analisar o código-fonte HTML para encontrar os elementos âncora (<a href>) com links para os dados de cada CVE na página.
Para começar a criar uma ferramenta personalizada que nossos agentes possam usar, abra o arquivo tools/__init__.py e atualize-o para exportar uma nova TableScraperTool, desta forma:
Observação: o MyCustomTool já fazia parte da estrutura de exemplo de projeto criada pelo CrewAI.
Em seguida, precisamos criar a TableScraperTool. Para isso, crie um arquivo em tools/table_scraper.py e adicione o seguinte código Python:
Por fim, também precisamos incluir e atualizar a biblioteca Python BeautifulSoup no projeto. Para isso, atualize a lista de dependencies em myproject.toml, desta forma:
Em seguida, aplique as alterações com este comando:
Arquivo principal de execução do CrewAI
Agora, vamos nos concentrar no arquivo principal crew.py, que deve estar em src/security_news_summary ou no diretório escolhido para criar a estrutura do projeto CrewAI.
Edite o arquivo e, primeiro, faça as seguintes alterações nas importações (vamos incluir nossa ferramenta personalizada TableScraperTool):
Em seguida, role a página até encontrar as funções anotadas como agentes (com a anotação @agent) e tarefas (com a anotação @task) e atualize-as para usar os agentes e as tarefas que acabamos de definir:
Executando agentes de IA com o CrewAI
Pronto. Agora podemos executar nossos agentes de IA para selecionar novas vulnerabilidades de segurança usando o Snyk Vulnerability Database como fonte de dados.
Para iniciar os agentes CrewAI, basta executar este comando no terminal:
Os agentes de IA começam a trabalhar:
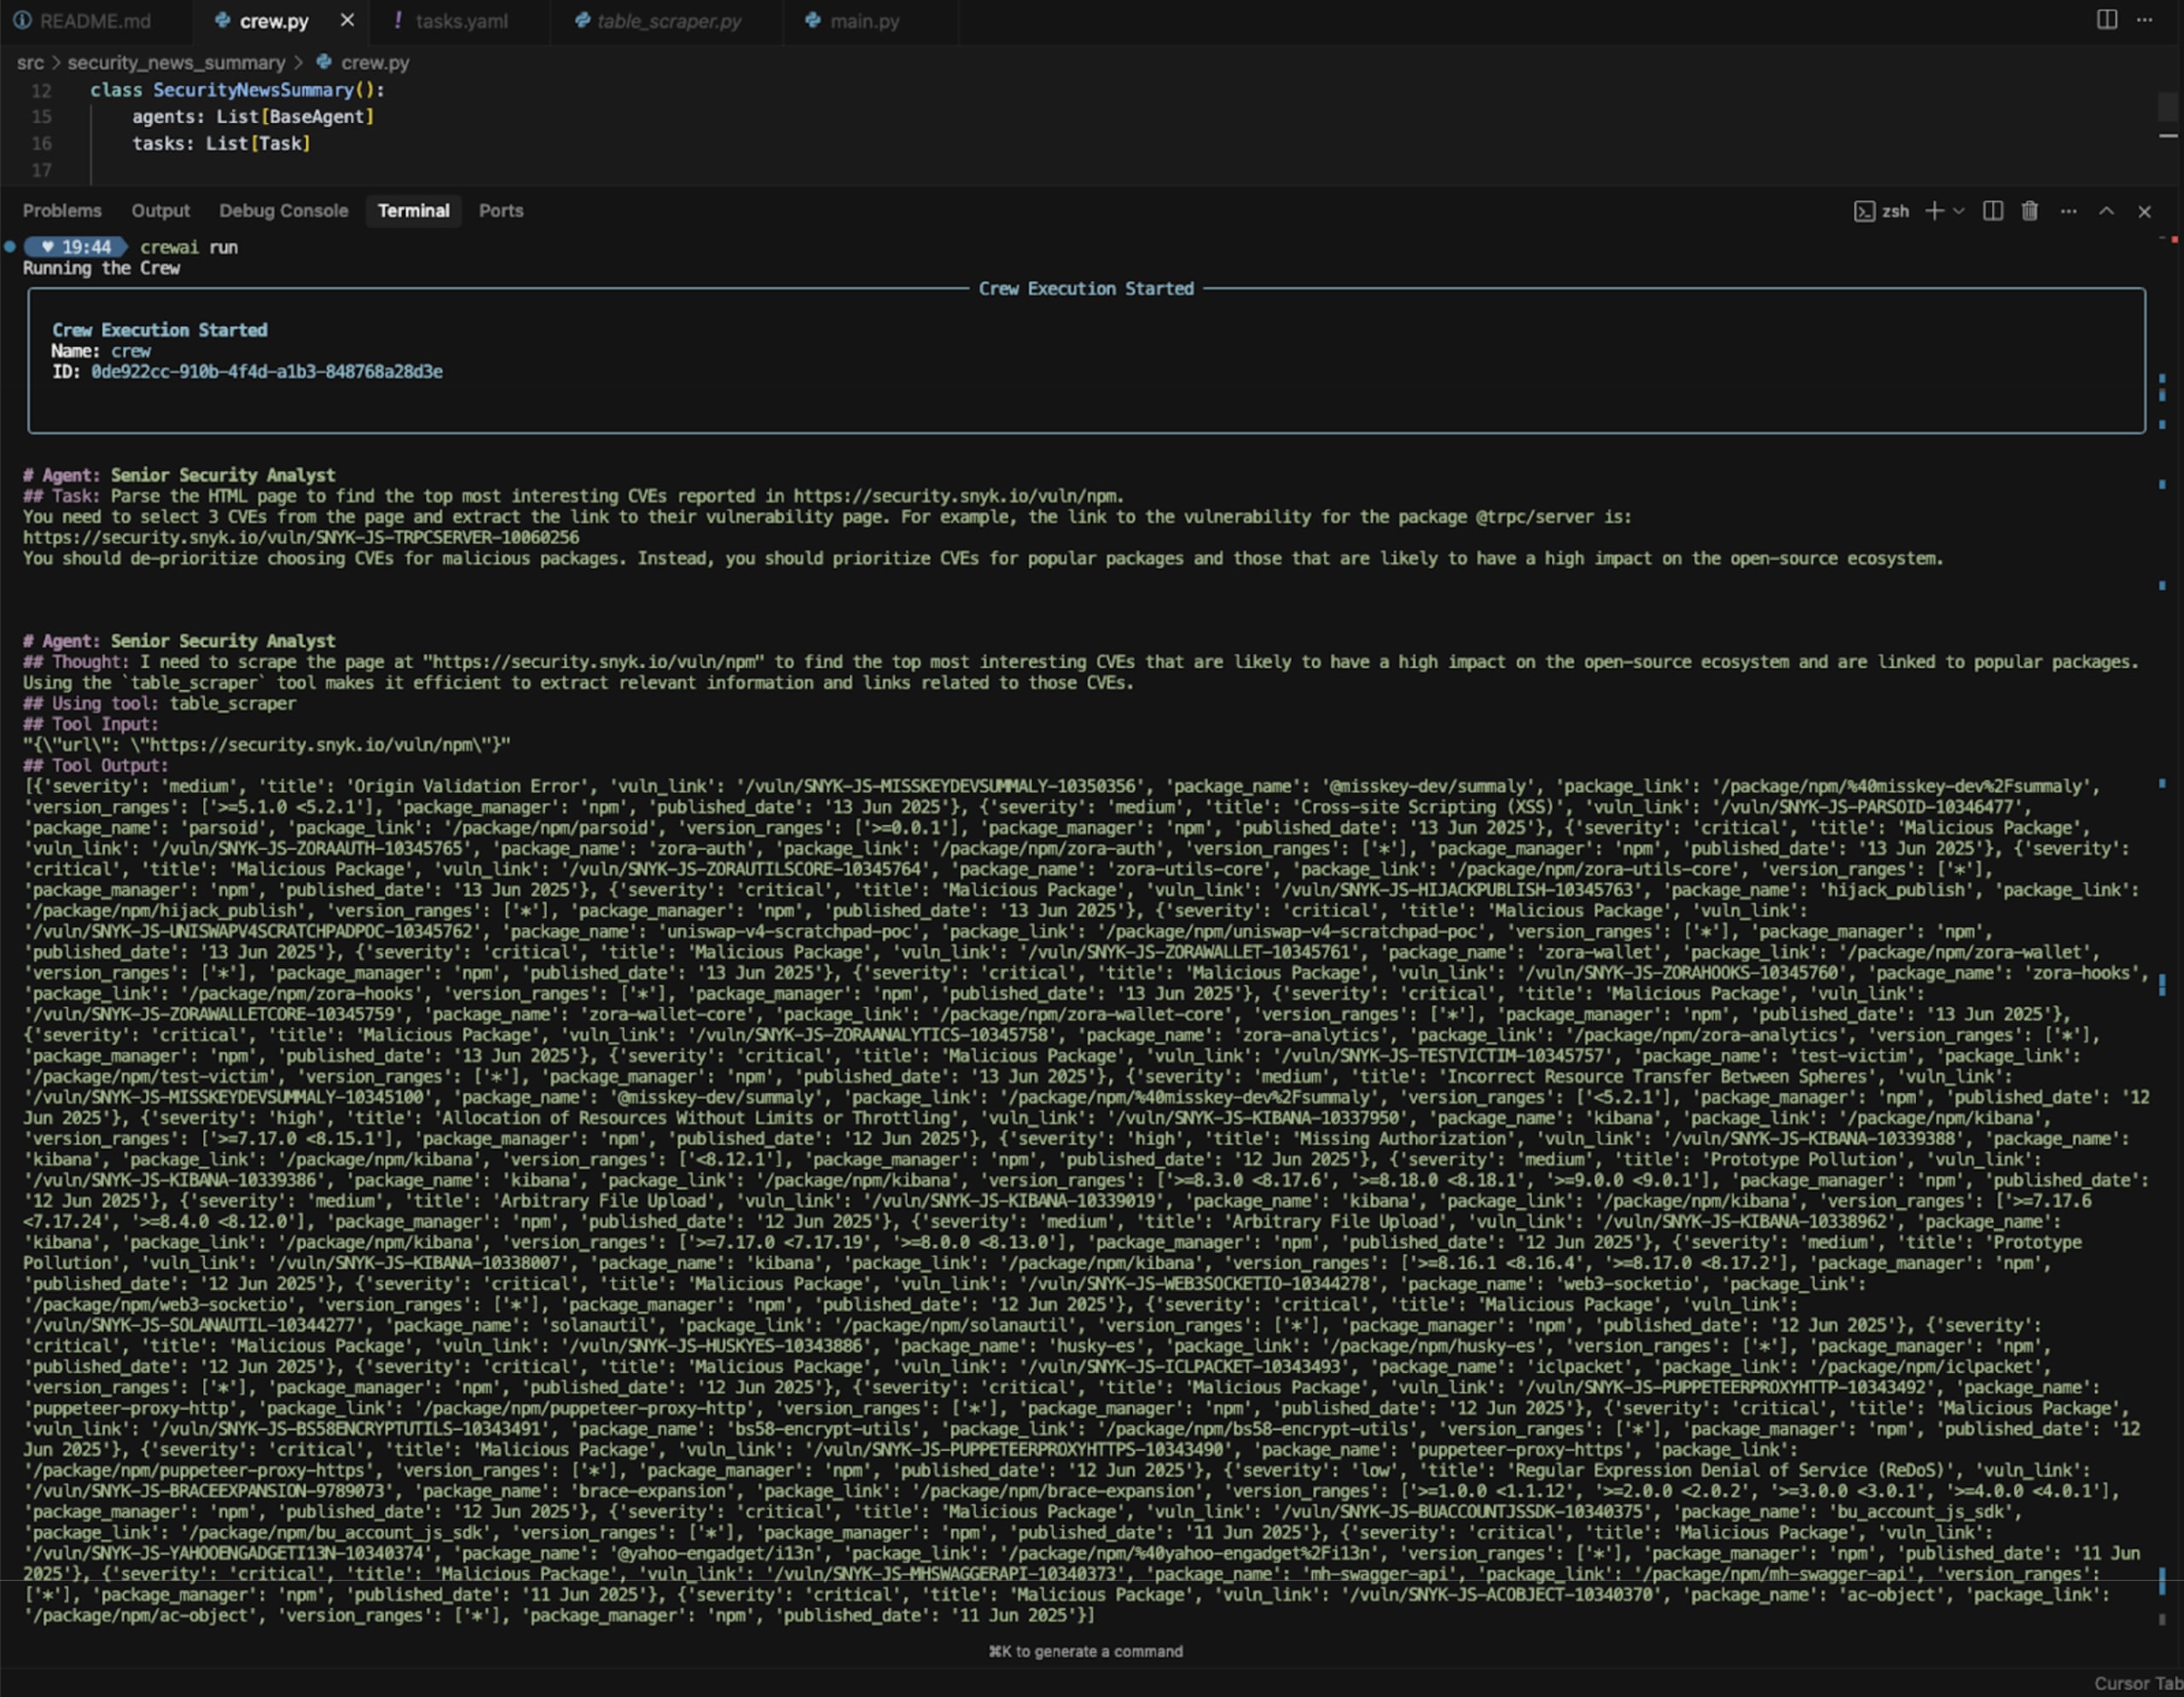
E as tarefas são informadas conforme o progresso avança:

Sobre segurança de IA e fluxos de trabalho agentivos
Criar agentes de IA parece mágica. Quando tudo funciona, a execução é surpreendentemente eficiente, e a biblioteca CrewAI para orquestração de agentes é muito fácil de usar.
Como os fluxos de trabalho de programação com IA e IA agentiva evoluem tão rapidamente, é importante ficar de olho na confiabilidade da IA e estabelecer barreiras de segurança para evitar riscos e problemas como implantações inseguras de servidores MCP, ataques de injeção de prompt e outras vulnerabilidades na superfície de ataque da IA.
Recomendo estes recursos:
Confira os guardrails de código de IA da Snyk
Programação segura com IA usando a Snyk (e servidores MCP)
Entenda a injeção de prompt: técnicas, desafios e riscos.
Desenvolva com IA com segurança desde o início
Aprenda a integrar a segurança em cada etapa do seu fluxo de desenvolvimento com IA — com dicas práticas de implementação de especialistas.