RPM Package Manager:SnykによるRPMパッケージのセキュリティスキャン

Ivan Stanev
2020年11月13日
0 分で読めますコンテナイメージのスキャンでは、SnykはOSディストリビューション、ソフトウェアパッケージマネージャー、インストール済みアプリケーション、そしてアプリケーションの依存関係など、さまざまな情報を検出できます。RPMはLinuxエコシステムで最も一般的なパッケージマネージャーの1つであり、Snykで完全にサポートされています。
RPM Package Managerとは?
RPMは、Red Hat Enterprise Linux、Fedora、CentOSなど、多くのLinuxディストリビューションで使用されています。Red Hat Linuxで生まれ、当初はRedHat Package Managerの略称でしたが、現在はRPM Package Managerを表す再帰的頭字語となっています。RPMはパッケージマネージャーを指す場合と、アプリケーションの配布に使用されるrpmファイル形式を指す場合があります。
RPMで使われるデータ形式とは?
RPMパッケージマネージャーの扱いが特に難しいのは、依存関係が人間に読み取れる形式(JSONやXMLなど)で一覧表示されないためです。代わりに、パッケージはBerkeleyDBデータベース内にバイナリ形式で保存されます。そのため、データベースとデータベースエントリーの正確なバイナリ形式とレイアウトがわからなければ、パッケージを読み取ることはできません。
RPMデータベースを読み取るオープンソースコードはありましたが、Snykの技術スタックはNode.jsとTypeScriptをベースとしているため、簡単には利用できませんでした。BerkeleyDB用のCバインディングをコンパイルして使用する方法もありますが、クロスコンパイルやメンテナンスのオーバーヘッドを避けたかったのです。また、必要なのはRPMパッケージを読み取るライブラリだけで、RPMとBerkeleyDBが提供する機能のごく一部にすぎませんでした。
オープンソースの力を借りて、RPMで使われるBerkeleyDBのライセンスではコードを自由に読み、変更できることがわかったため、私たちは機能を自分たちで再現することにしました。最終的に課題を解決し、完全なオープンソースのTypeScriptライブラリを公開しました。こちらのSnykのGitHub上のrpm-parserリポジトリでご覧いただけます。
このブログでは、その方法を紹介し、RPMデータベースの内部構造を解き明かす手順を説明します。低レベルなビットやバイトをいじる作業に備えてください! ?ï¸
RPMデータベースの構造は?
BerkeleyDBはバイナリデータベースですが、どうすれば意味のある内容を取り出せるでしょうか?バイナリファイル形式は通常、ファイルの先頭を調べて識別します。たとえば、ファイルの種類を示す特別なマーカー(「マジックナンバー」など)が見つかることがあります。これを調べる最善の方法は、ソースコードを読み、RPMデータベースのコピーで試すことです。RPMが作成するBerkeleyDBデータベースは/var/lib/rpm/Packagesに保存されているため、まずその内容を調べます。BerkeleyDBのソースコードによると、ファイルの先頭数バイトには次の情報が含まれています。
BerkeleyDBは、B-Tree、Hash(HStore)、Queueのほか、比較的新しいバージョンではその他の種類のデータベースもサポートしています。データベースの種類ごとにマジックナンバーは異なり、B-Treeは0x053162、Hashは0x061561、Queueは0x042253です。開いたRPMデータベースはすべてHash型であることがわかりました。/var/lib/rpm/Packagesファイルの12バイト目から0x061561が見つかり、さらにtypeには0x08が格納されています。ソースコードの型定義では、これは次のように示されています。
型定義内のpagesizeフィールドと、その後に続くlast_pgno(最終ページ番号)から、データベースが同じサイズのページに分割されているとわかります。つまり、個々のデータ項目が複数のデータベースページにまたがることがあり、ページの順序もおそらく順不同です(後ほど分析する際に確認します)。
この汎用データベースメタデータは、どのデータベース型でも共通していることがわかりました。そのため、最初の_dbmeta33セクションはデータベース型に応じて拡張されます。Hashデータベースだけに注目するので、次の追加データを確認できます。
nelem(要素数)から、データベース内の要素数もわかります。一方、iv(初期化ベクトル)とchksum(チェックサム)は、暗号化が使われている可能性を示唆しています。
これらのバイトを読み取り、後で出力できるようJavaScriptオブジェクトに格納すると、次のようになります。
実際には、少なくともデフォルトではRPMデータベースの暗号化は行われていないため、このケースは完全に無視できます。
ここまでで、データベースのレイアウトは次のようになります。
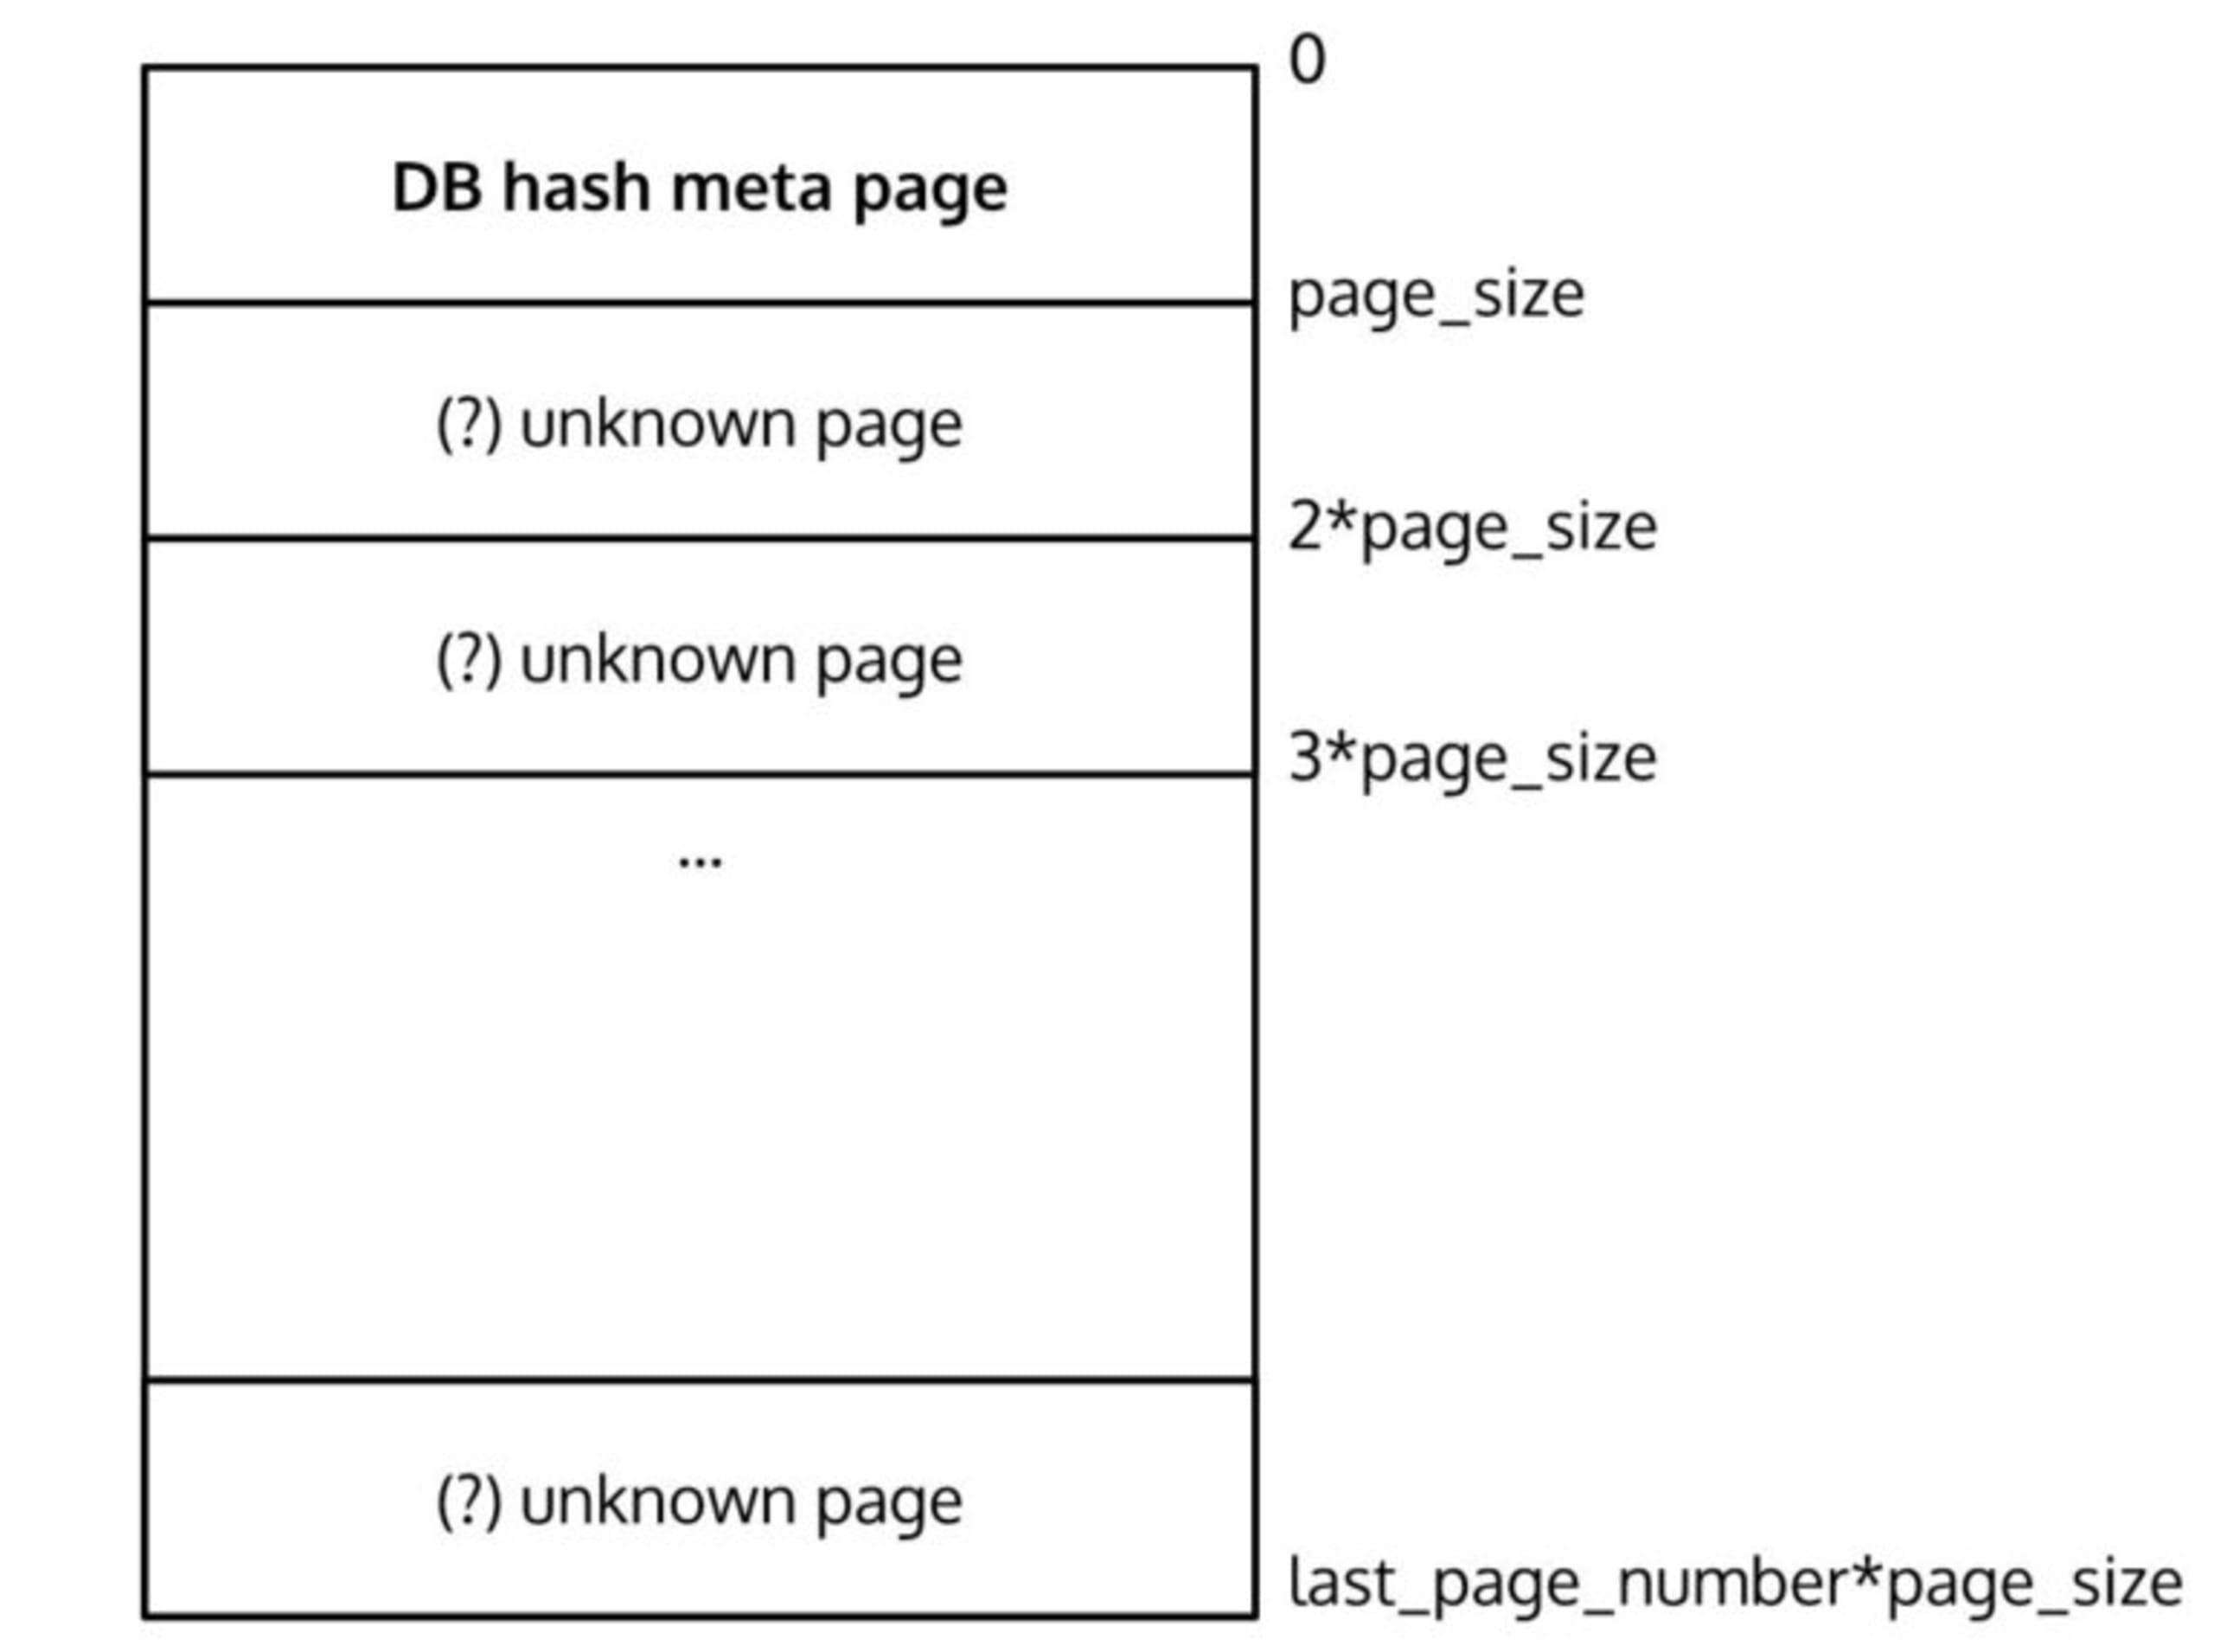
ページのサイズは4096バイトで、最初のページにはデータベースのメタデータが格納されています。次のページに進み、どのようなデータがあるか確認しましょう。BerkeleyDBのソースコードも参考になり、次のレイアウトが示されています。
型定義から、それぞれのエントリーのサイズがわかります。適切なバイト数を読み取ってJavaScriptオブジェクトにマッピングすると、次のようになります。
type: 13に注目してください。これはまったく新しいページ型を示しており、型定義では次のように記されています。
prev_pgnoとnext_pgnoは0に設定されています。つまり、データ(内容はともかく)はこのページ内にすべて格納されているため、収集のために他のページへ移動する必要はありません。
hf_offsetの値に注目してください。ページに格納されたデータ全体を見ると、約2850バイト付近がゼロになっており、これはhf_offsetの値と一致します。つまり、hf_offsetはページ上のデータの終端を示しています。後ほど複数ページにまたがるデータ項目を読み取る際、データの開始位置と終了位置を把握するうえで役立ちます。
各ページの先頭には共通の26バイトのページヘッダーがあり、残りの4070バイトの一部またはすべてにデータが格納されています。Hash型のページには、現在のページ上のバイト位置やオフセットを指すエントリーを含むインデックスがあります。このオフセットはページの反対側にあるデータを指しています。Hashページ上でのデータの保存方法は、スタックとヒープの構造に似ています。
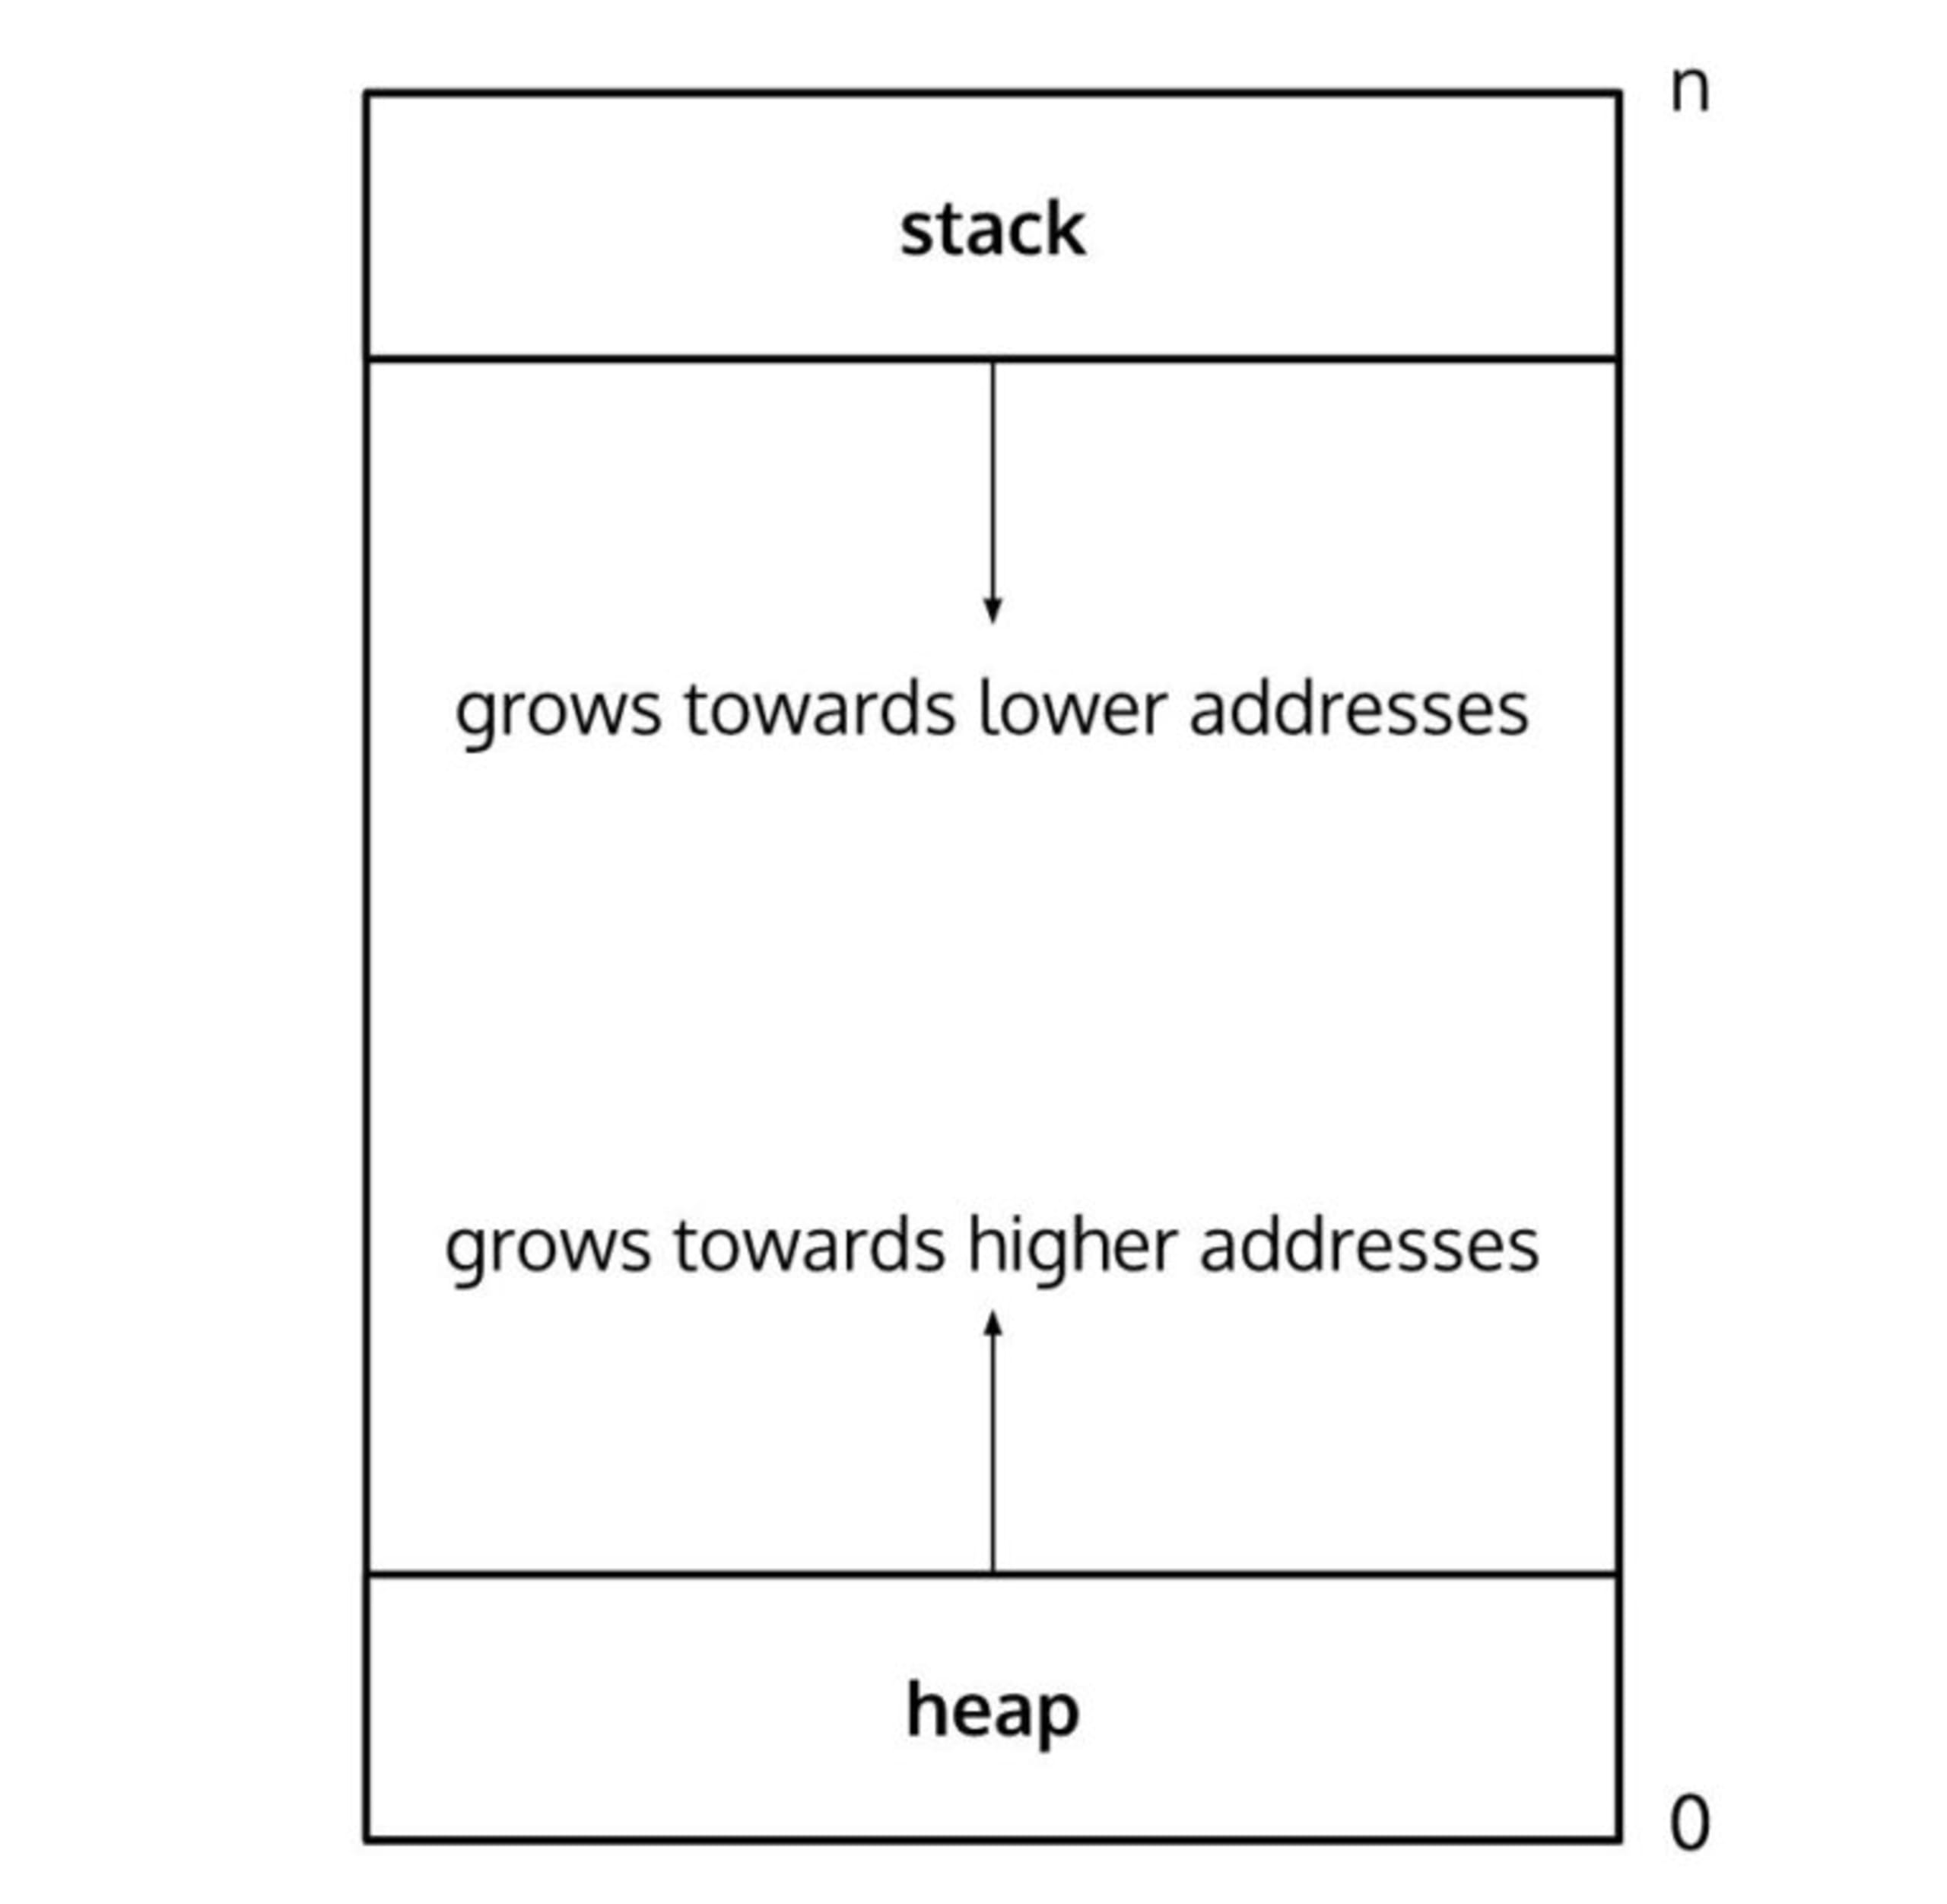
インデックスはページのヒープ領域に保存され、データ(インデックス内のオフセットが指す先)はスタック領域に保存されます。
インデックスにはキーと値のペアが1つずつ並んでいます。キーはデータベース内の内部識別子で、値は現在のページ内のオフセットを指します。各オフセットに何が格納されているかを解釈するために、次の型定義を利用できます。
この情報があれば、BerkeleyDB全体のどこにデータが格納されているか、少なくともその開始位置を特定できます。データは特定のページ番号から始まり、長さがページサイズを超える場合は複数ページにまたがります(ページ0から読み取ったpagesizeを思い出してください)。
ここまでで、データベースの構造は次のようになります。
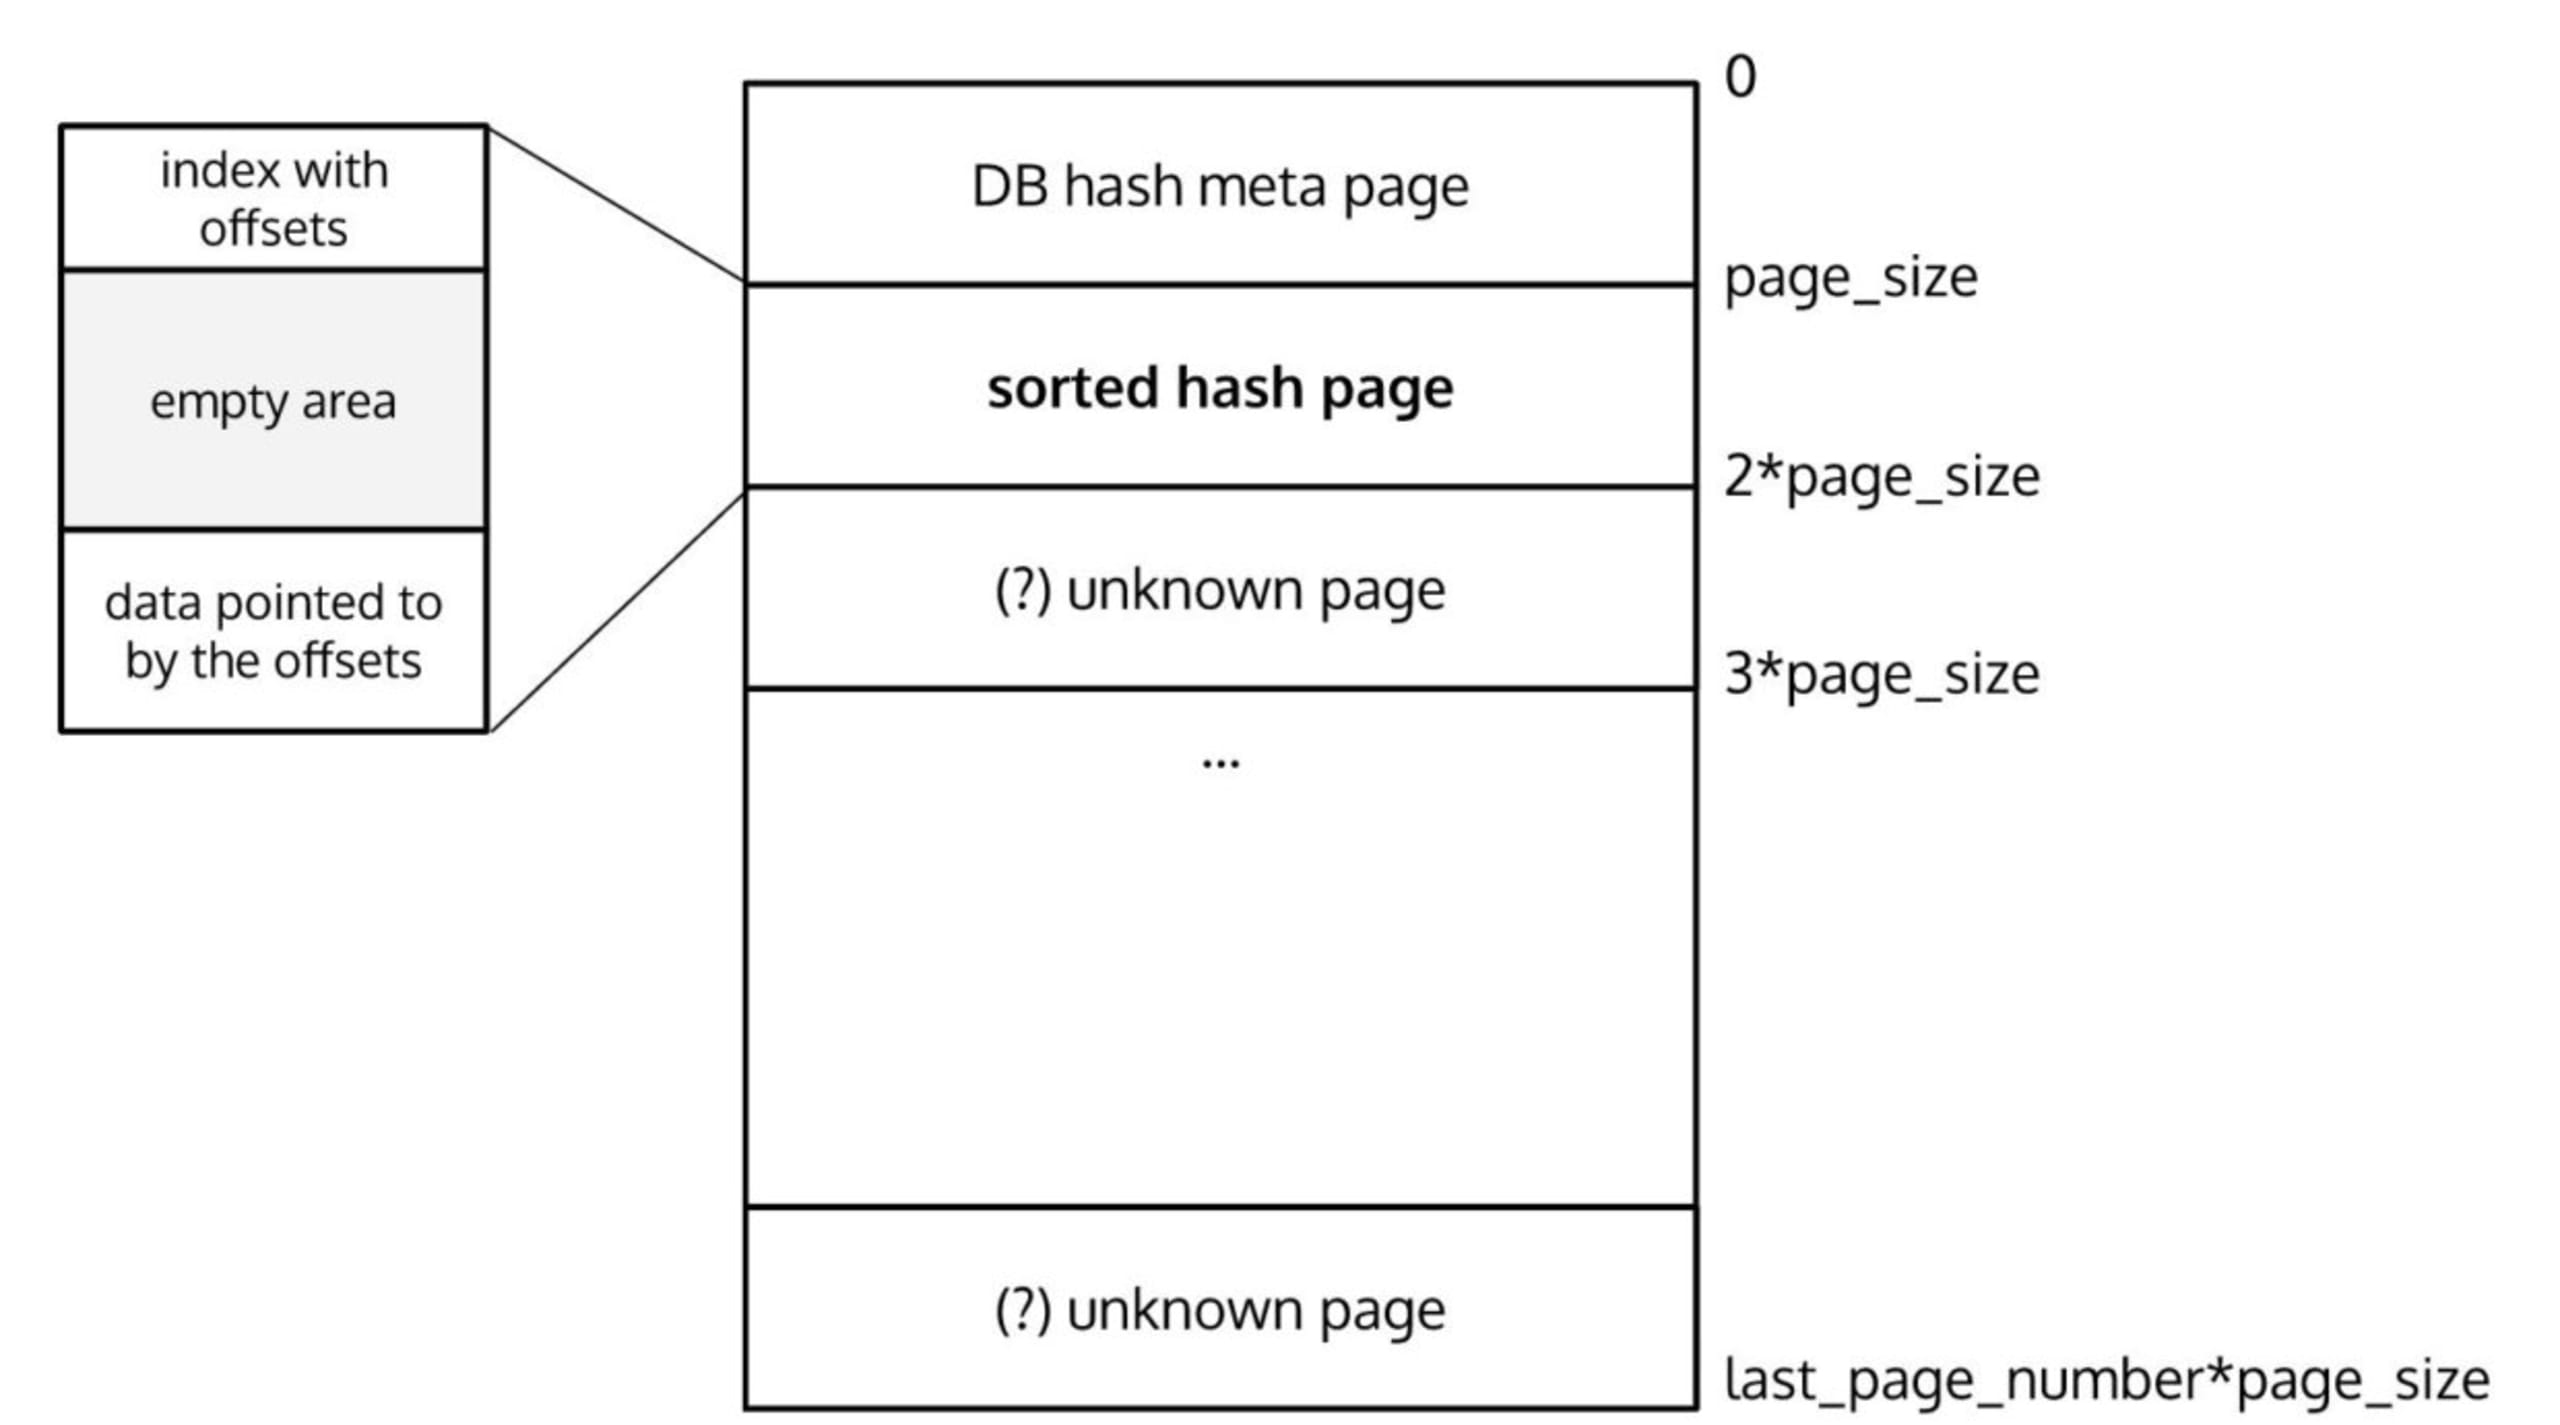
次に、データインデックス(struct __hoffpageで表される)からエントリーを1つ選び、そのエントリーが指すページを見てみましょう。ページ番号と各ページのサイズがわかっているので、そのページを読み込み、内容を確認できます。
next_pgnoに値が設定されており、残りのデータが格納された次のページを指していることに注目してください。hf_offsetの値は4070です。これは、このページ全体がデータで埋まっていることを意味します(ページサイズ4096バイトから共通ページヘッダーの26バイトを引いた4070バイトです)。したがって、データ全体を取得するには、next_pgnoをたどって複数のページを巡り、すべてのバイトをつなぎ合わせる必要があります。
データベースの最終的な構造は次のとおりです。
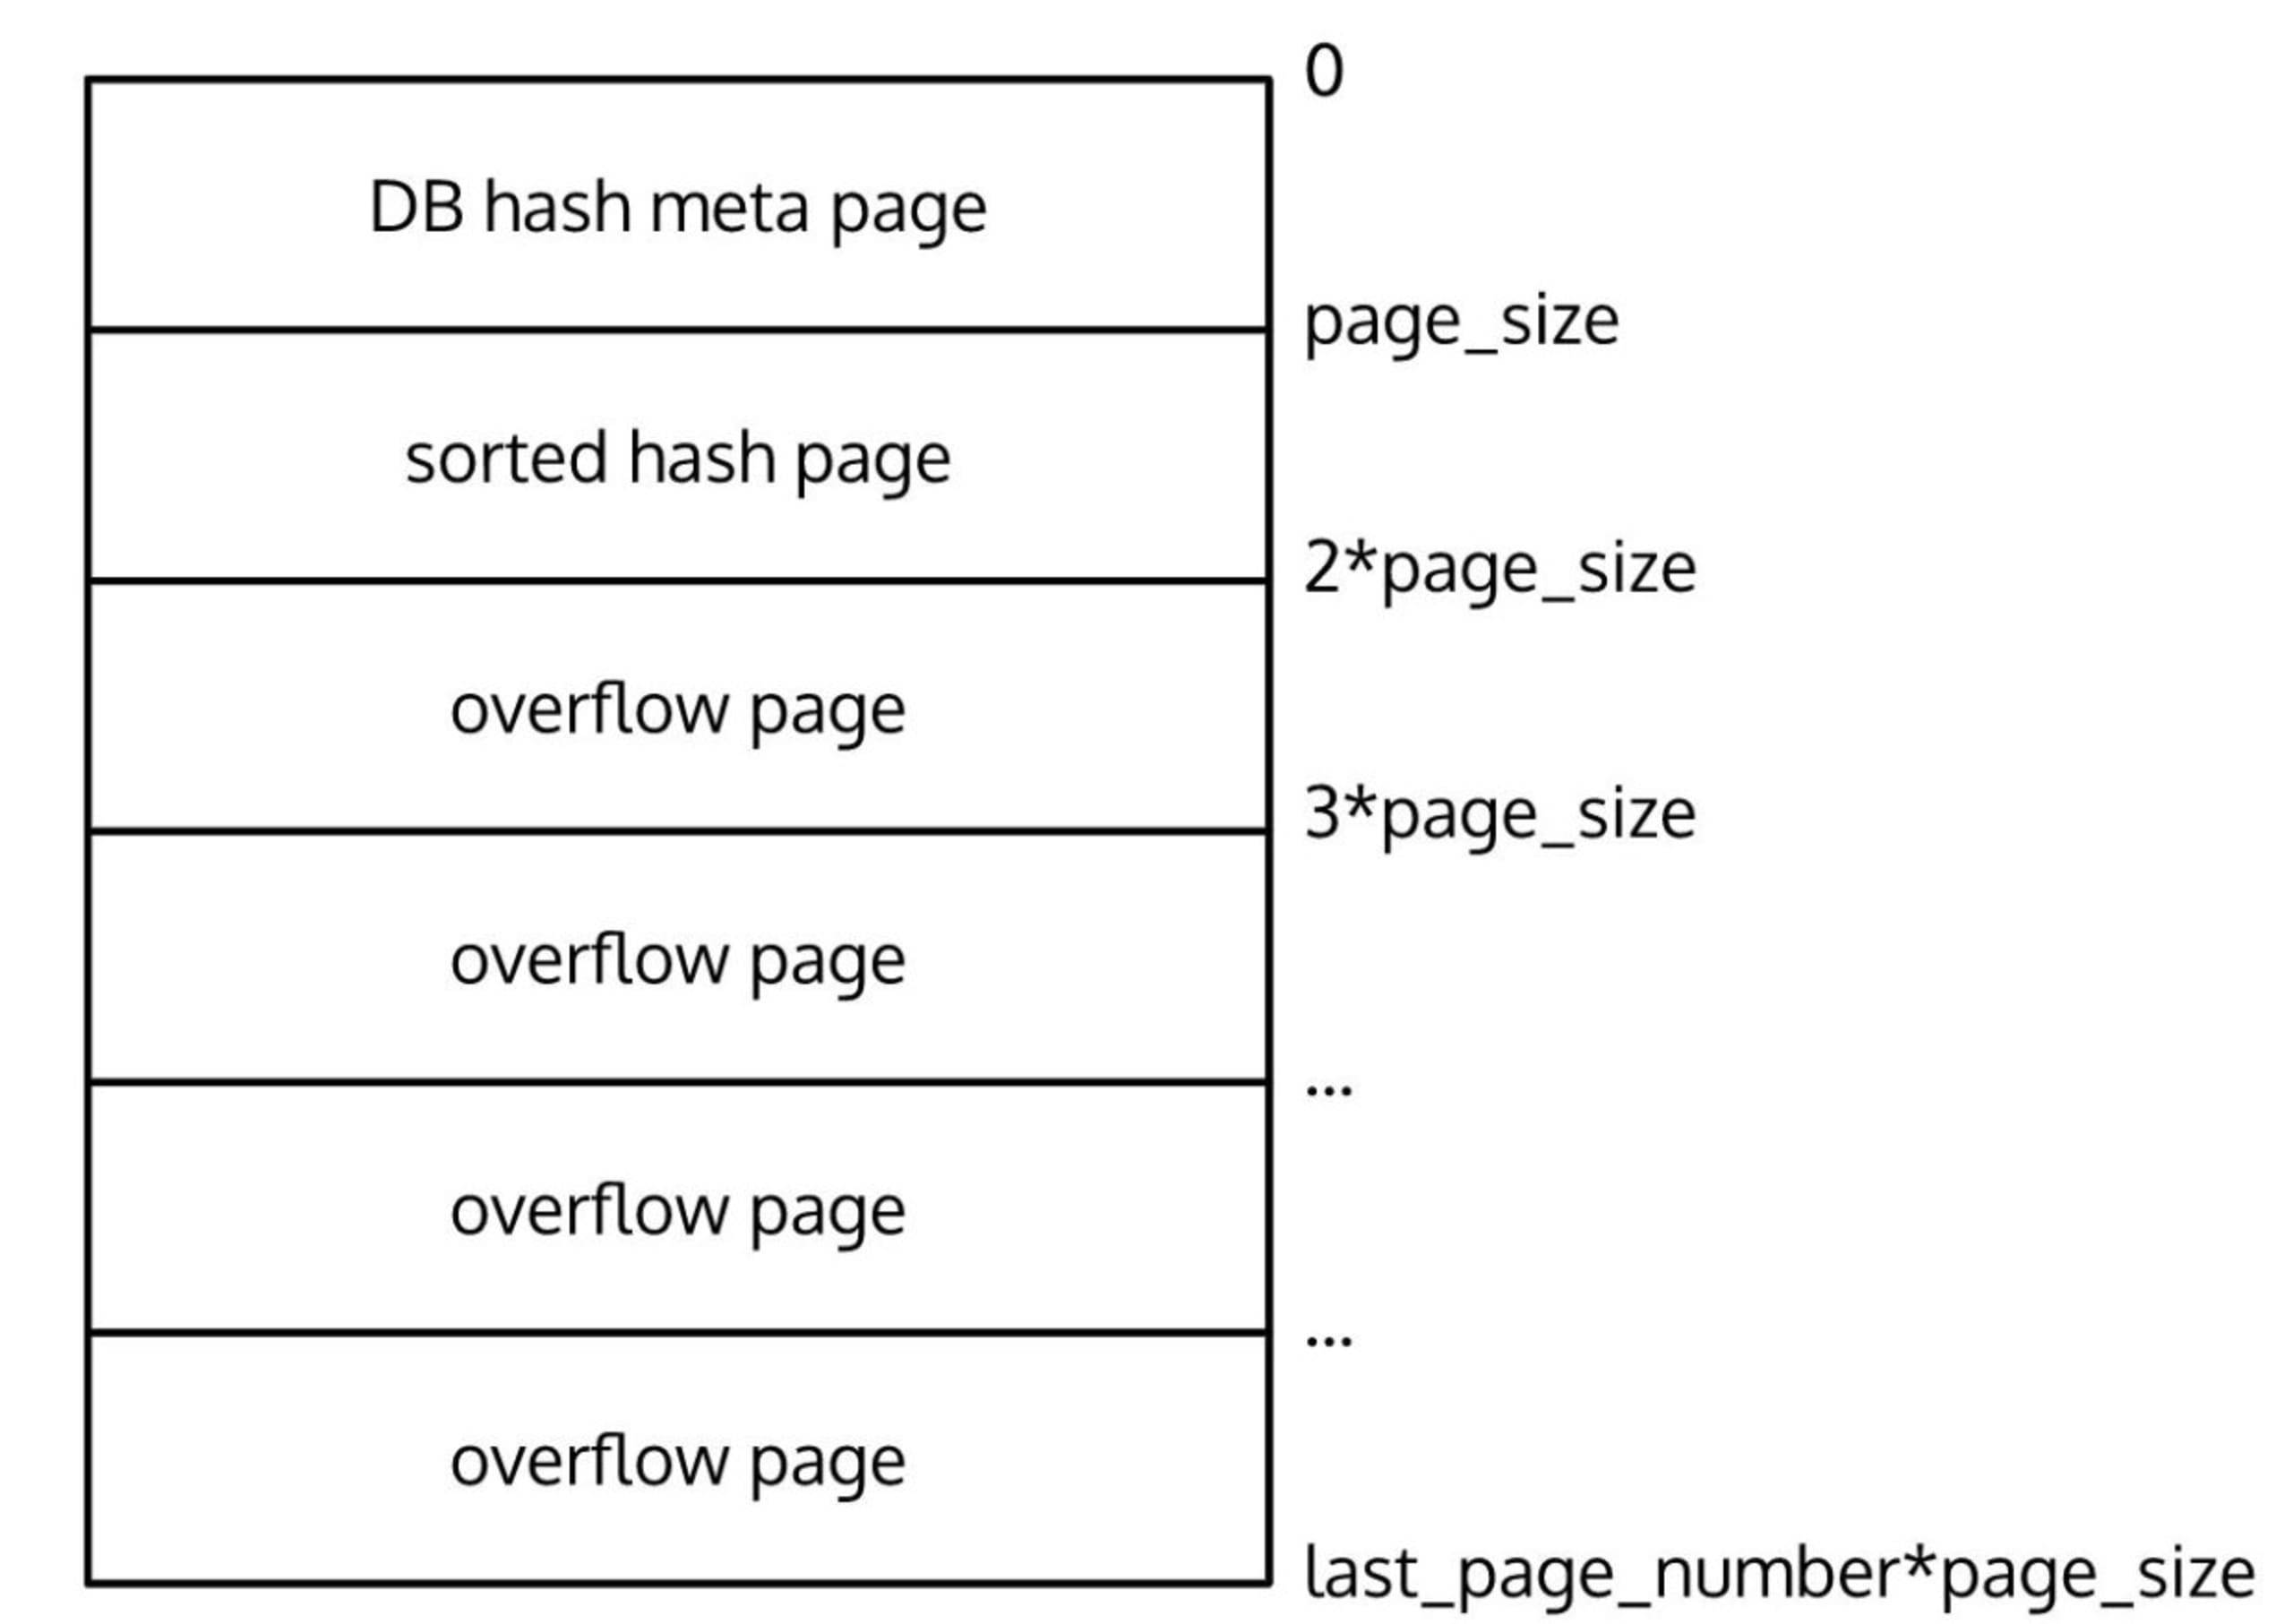
データを読み取るために必要な情報は以上です。連結されたオーバーフローページをすべてたどると、実際のRPMパッケージであるバイナリブロブのリストが得られます。次はパッケージを読み取り、パッケージ名、バージョン、アーキテクチャなどの情報を抽出します。
RPMパッケージのメタデータを解析する
ここからはBerkeleyDBの話を離れ、RPMパッケージそのものとメタデータ形式に移ります。RPMパッケージの構造を理解するために、RPMファイル形式のドキュメントを参照します。
rpmファイルは、リード、署名ヘッダー、ペイロードヘッダー、そしてペイロード(実際のデータ)の4つのセクションで構成されます。2つのヘッダーセクションは同じ形式です。それぞれの形式は以下のセクションで説明されています。各セクションはファイル内に順番に並び、セクションの前後や間に追加情報はありません。
試行錯誤の結果、BerkeleyDBのバイナリブロブに格納されているのは、実際には部分的なペイロードヘッダーと完全なペイロードの2項目だとわかりました。リードと署名ヘッダーは完全に省略されています。RPMのドキュメントを見ると、ペイロードヘッダーの構造は次のとおりです。
HMx(ヘッダーマジック)の各エントリー、バージョン、予約済みバイトもすべて欠落していることがわかりました。代わりに、indexcount(ヘッダーインデックスエントリーの数)、storesize(データストアのサイズ、バイト単位)、インデックスエントリー、データストアを含む部分的なヘッダーが得られます。
ここで重要なのは、データがビッグエンディアン形式で保存されている点です。そのため、各エントリーは明示的にその形式で読み取り、解釈する必要があります。
これまでにBerkeleyDBから収集したバイナリブロブは、擬似コードで表すと次のようになります。
最初の2項目は簡単に読み取れますが、index_entriesを読むにはそのレイアウトを理解する必要があります。RPMファイル形式のドキュメントには、次のように記載されています。
各index_entryは16バイトです。この情報とindexcountの値があれば、RPMヘッダーのエントリーをすべて取得できます。
JavaScriptですべてのインデックスエントリーを読み取り、次のようなリストを作成できるようになりました。
RPMのドキュメントを見ると、各tagの値が何を表すかを示す表があります。タグはパッケージ名(1000)、バージョン(1001)、アーキテクチャ(1022)などの情報を示します。typeもRPMのドキュメントで確認でき、string(6)、int32(4)、さらにはnull型(0)などのエントリーがあります。
次にoffsetを使い、各エントリーのデータ開始位置に移動します。このとき、データの位置に正しくたどり着くため、オフセット計算にindexcountも含めます。そしてtypeの値に応じて、その後に続くバイト配列を適切に処理します。たとえばstring型では、C言語系のソフトウェアで一般的な文字列の終端を示す0バイトに達するまで、バイト列を読み取ります。一方、int32型なら4バイトだけを読み取ればよいとわかります。
これらの情報を使ってインデックス内のすべてのエントリーを順に処理すれば、依存関係を構築するのに十分なパッケージデータを抽出できます。エントリーの例を1つ紹介します。
同じ処理をすべてのBerkeleyDBブロブに対して繰り返すことで、パッケージ情報をすべて抽出し、依存関係のリストを作成できます。
まとめ
RPMパッケージマネージャーの内部構造を深く掘り下げ、データのバイナリレイアウトと、インストール済みパッケージの情報が内部でどのように表現されているかを確認しました。これは、Snykがコンテナイメージ内の依存関係の一覧を読み取り、解析する際に用いているのと同じプロセスです。Snykは無料でご利用いただけます。アカウントに登録してください。この処理を担うオープンソースライブラリ、GitHub上のRPM parserもぜひご覧ください。
CTFを始めよう
オンデマンドのバーチャル入門ワークショップを視聴して、CTFの課題の解き方を学びましょう。


