OPA Regoのパフォーマンス:ボトムアップとトップダウン

2021年4月29日
0 分で読めますこのブログでは、Regoの評価の仕組みと、パフォーマンスへの影響について解説します。Regoはポリシーを記述するためのDSLです。RBACなど特定の種類のポリシーに限定されず、汎用性が高いため、さまざまなサービスや技術スタック間でポリシーを共有できます。Fugueではクラウドインフラのセキュリティに、オープンソースプロジェクトのRegulaではInfrastructure as Codeのセキュリティに、Regoが最適だと考えています。
Regoは宣言型言語であるDatalogをベースにしています。直感的に言えば、宣言型言語では、プログラマーは求める結果を指定し、その結果をどのように計算するかまでは必ずしも指定しません。これはJavaScriptやPythonなどの命令型言語とは対照的です。命令型言語では、プログラマーが常に具体的なアルゴリズムを指定します。
この違いは必ずしも明確ではありません。ほとんどの宣言型言語には、何かをどのように計算するかを示す仕組みがあり(このブログでも説明します)、命令型言語で宣言型DSLを構築することもできます。いずれにしても、Regoはスペクトルの宣言型の端に大きく寄っています。
プログラマーが結果の計算方法を指定する必要がないため、コンパイラーやインタープリターにはより多くの自由度があります。Regoのような言語には、ボトムアップとトップダウンという2つの重要な戦略があります。
簡単な例を使って、この2つの戦略を説明し、それぞれのメリットとデメリットを見ていきましょう。
例
書き込み権限がきめ細かく設定されていることを保証するポリシーを作成するとします。入力は次のようになります。
ここに示すロールの一部には、危険な書き込み権限であるwrite: *が設定されています。このポリシーでは、危険なロールが割り当てられているユーザーごとにエラーを出力します。
2つのルールを定義します。
dangerous_roles:write: *を含むすべてのポリシーをまとめたセットdeny:すべてのエラーメッセージをまとめたセット
ポリシー全体は次のとおりです。
opa evalを使って、期待どおりの出力が得られることを確認できます。
この例を踏まえて、ボトムアップとトップダウンの評価を見ていきましょう。
ボトムアップ
この2つの評価戦略の違いは、ルールの依存関係ツリーを図にすると理解しやすくなります。
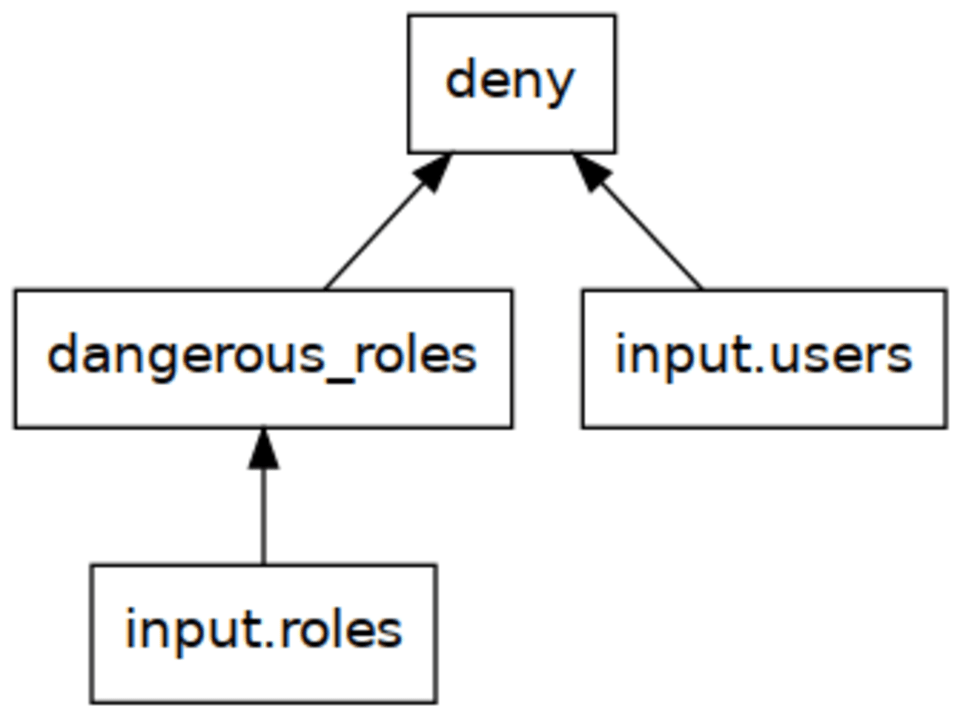
denyはdangerous_rolesに依存し、どちらも入力ドキュメントに依存します。ボトムアップ戦略では、このツリーの下から評価を始め、上へと進めていきます。
入力ドキュメントは、それ以上評価する必要がありません。その上にあるのがdangerous_rolesセットです。まずこのセットを計算します。この例では、セットは{"temporary_hack"}になります。
dangerous_rolesが分かれば、denyルールの依存関係がすべて明らかになるため、次に2つ目のセットを評価します。その結果は {"Please remove role temporary_hack from user bob"}となります。
ボトムアップ戦略は実装が簡単ですが、大きな欠点があります。必要以上に計算してしまうことがよくあるのです。denyメッセージをすべて列挙するのではなく、temporary_hackが危険なロールかどうかだけを確認したいとします。ボトムアップ戦略では、dangerous_roles["temporary_hack"]を評価すると、temporary_hackがセットに含まれていると分かった時点で止まらず、(場合によっては非常に大きな)セット全体を計算してしまいます。
トップダウン戦略は、この問題に対処します。
トップダウン
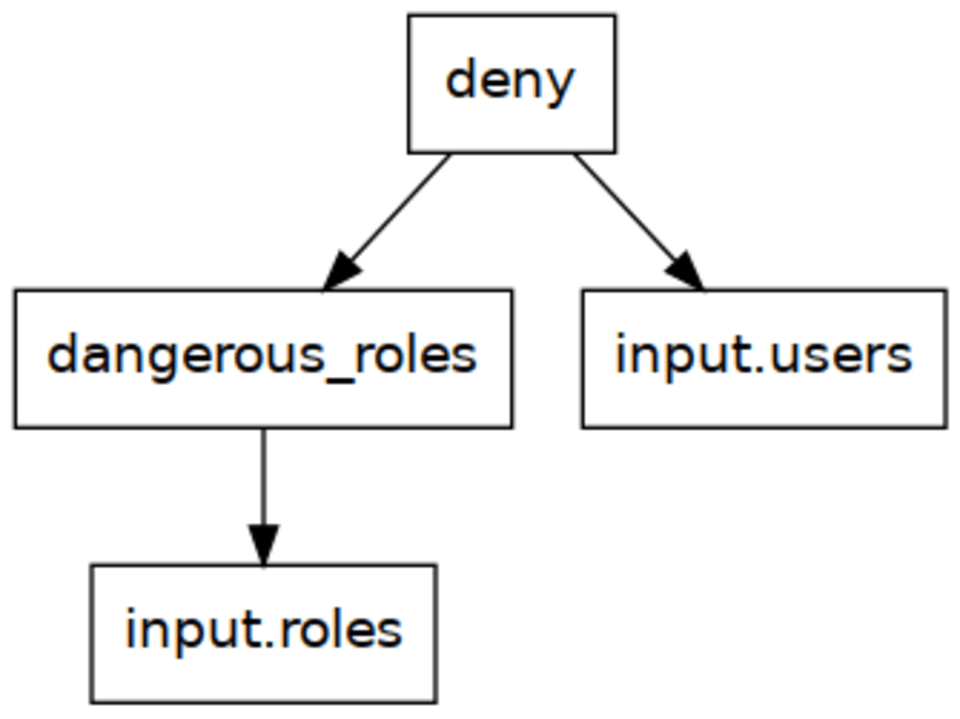
トップダウン戦略では、逆に、必要に応じてツリーの上からルールを評価します。これは、ほとんどの言語で関数を呼び出すのとよく似ています。
要求された値であるdenyの評価から始めます。このルールはユーザーを順に処理し、role_nameに値を割り当ててから、dangerous_roles[role_name]を呼び出します。関数にたとえると、これはdangerous_roles(role_name)を呼び出すようなものです。
dangerous_rolesは、それ以上「関数」を呼び出すのではなく、入力ドキュメント内のポリシーを順に処理します。
これでdangerous_roles["temporary_hack"]を評価したときに、期待どおりの動作になることが分かります。セットを構築する代わりに、入力内のポリシーを順に処理し、名前が一致する危険なロールが見つかった時点で返します。
OPAはRegoの評価にトップダウン戦略を採用しています。
意図せず二次計算量に
ただし、このトップダウン方式にも欠点があります。疑似コードで示すと、ボトムアップ評価では内部的に2つのループが実行されます。
トップダウン評価はこれとは異なります。ここでもdangerous_rolesを関数呼び出しと考えると、次のようになります。
これは、実行時間が二次になりそうな処理に見えます。
実際、ユーザー1,000人、ポリシー1,000件の入力を生成すると、opaの評価には3.47秒かかります。この数を10,000に増やすと、4分をわずかに超えます。
これは作為的な例に聞こえるかもしれませんが、Fugueで実際に遭遇した問題と似ています。コンプライアンスのために大量のリソースを分析するので、こうした評価の処理時間が積み重なることがあります。
トップダウンとボトムアップ
これで終わりでしょうか。クエリが遅いままなのでしょうか。幸い、そうではありません。
簡単な回避策があります。ルールを「まとめて」評価したいと分かっている場合は、セット内包表記を使って評価できます。こうすると、dangerous_rolesは単一の値を持つ完全なルールになります。
構文は次のようになります。
この簡単な工夫(クエリアナリストは嫌がるでしょう)だけで、ユーザー10,000人でも0.4秒未満になりました。
まとめ
宣言型言語を使うと、どのように計算するかではなく、何を計算したいかに集中できます。ただし、実行モデルを完全に忘れてはいけません。実行時間が大幅に増え、タイムアウトを引き起こす可能性があるからです。
幸い、修正は簡単ですぐにできます。Regoルールを書くときは、ルールを関数として表現するべきか、一度だけ計算するセットとして表現するべきかを考え、それに応じて内包表記または増分ルールを使うとよいでしょう。
このブログではセットだけを取り上げましたが、同じことはオブジェクトにも当てはまります。
まだ答えていない明らかな疑問があります。真の宣言型の方法で、コードを変更せずにこの問題を解決できるのでしょうか。
dangerous_roles[role]の呼び出し結果をキャッシュするのは、有望な方法に思えます。私もまずこれを検討しました。しかし、再計算を避けるには、セット内の項目だけでなく、セットに含まれない項目もキャッシュする必要があります。後者はメモリに収まらない可能性があるうえ、いずれの場合もLRU方式の退避処理が必要になり、コードが複雑になります。
コンパイラーが、任意のルールをボトムアップとトップダウンのどちらで計算するのがよいか、常に判断できるわけではありません。しかし、だからといって試すのをやめる必要はありません。実験的なRegoエンジンであるfregotで、最適化パスのプロトタイプを作りました。代入パターンを調べ、引数が評価の短絡に使われる可能性があるかをテストし、ボトムアップ評価の候補となるルールを特定します。タイムアウトしていたケースをすべて検出できたため、有望な方法です。
開発者のために設計されたIaCセキュリティ
Snykは、統合されたポリシー・アズ・コードエンジンにより、SDLCからクラウドでの実行時までInfrastructure as Codeを保護します。すべてのチームが安全に開発、デプロイ、運用できるよう支援します。