RPM Package Manager : analyse de sécurité des packages RPM avec Snyk

Ivan Stanev
13 novembre 2020
0 minutes de lectureLors de l’analyse des images de conteneurs, Snyk peut détecter différentes informations, comme la distribution du système d’exploitation, le gestionnaire de packages, les applications installées et toutes leurs dépendances. RPM est l’un des gestionnaires de packages les plus répandus dans l’écosystème Linux et est entièrement pris en charge par Snyk.
Qu’est-ce que RPM Package Manager ?
RPM est utilisé par de nombreuses distributions Linux, notamment Red Hat Enterprise Linux, Fedora, CentOS et d’autres. Né au sein de Red Hat Linux, son nom signifiait à l’origine RedHat Package Manager. Il s’agit désormais d’un acronyme récursif, qui signifie RPM Package Manager. RPM désigne à la fois le gestionnaire de packages et le format de fichier rpm utilisé pour distribuer les applications.
Quel format de données RPM utilise-t-il ?
Le gestionnaire de packages RPM est particulièrement difficile à utiliser, car il ne répertorie pas ses dépendances dans un format lisible (comme JSON ou XML). Les packages sont plutôt stockés au format binaire dans une base de données BerkeleyDB. Il est donc impossible de les lire sans connaître le format binaire et la structure de la base de données et de ses entrées.
Il existait du code open source permettant de lire la base de données RPM, mais son utilisation dans Snyk n’était pas simple, car notre stack technologique repose sur Node.js et TypeScript. Il est possible de compiler et d’utiliser des liaisons C pour BerkeleyDB, mais nous voulions éviter la complexité de la compilation croisée et de la maintenance. De plus, nous avions seulement besoin d’une bibliothèque capable de lire les packages RPM, soit une infime partie des fonctionnalités de RPM et de BerkeleyDB.
Grâce à la magie de l’open source, la licence BerkeleyDB utilisée par RPM nous autorisait à lire et à modifier librement le code. Nous avons donc choisi de recréer nous-mêmes ces fonctionnalités. Au final, nous avons relevé le défi et publié une bibliothèque TypeScript entièrement open source, disponible dans notre dépôt Snyk rpm-parser sur GitHub.
Dans cet article, je vais vous expliquer comment nous avons procédé et vous présenter le processus d’exploration des rouages internes de la base de données RPM. Préparez-vous à manipuler des bits et des octets à bas niveau ! ?ï¸
À quoi ressemble une base de données RPM ?
Nous savons que BerkeleyDB est une base de données binaire. Comment en extraire des informations utiles ? Les formats de fichiers binaires sont généralement identifiés en examinant le début du fichier, où l’on trouve un marqueur spécial (par exemple, un « nombre magique ») qui indique le type du fichier. Pour le découvrir, le mieux est de lire le code source et de tester sur une copie de la base de données RPM. La base BerkeleyDB créée par RPM se trouve dans /var/lib/rpm/Packages ; nous allons donc commencer par en examiner le contenu. Le code source de BerkeleyDB nous indique que les premiers octets du fichier contiennent ceci :
BerkeleyDB prend en charge plusieurs types de bases de données : B-Tree, Hash (HStore) et Queue, ainsi que d’autres types dans les versions les plus récentes. Chaque type de base de données possède un nombre magique différent : 0x053162 pour B-Tree, 0x061561 pour Hash et 0x042253 pour Queue. Il s’avère que toutes les bases de données RPM que nous ouvrons sont de type Hash : le nombre magique 0x061561 apparaît à partir de l’octet 12 du fichier /var/lib/rpm/Packages. Le champ type contient également la valeur 0x08, que les définitions de type du code source associent à ce qui suit :
Le champ pagesize et le champ last_pgno (numéro de la dernière page) qui le suit nous indiquent que la base de données est divisée en pages de taille égale. Cela signifie également que des éléments de données individuels peuvent être répartis sur plusieurs pages de la base de données et que les pages ne sont probablement pas dans l’ordre (comme nous le verrons en les analysant plus loin).
Il s’avère que ces métadonnées génériques de la base de données sont communes à tous les types. La section initiale _dbmeta33 est donc complétée selon le type de base de données. Comme seul le type Hash nous intéresse, voici les données supplémentaires que nous obtenons :
Le champ nelem (nombre d’éléments) nous indique également combien d’éléments contient la base de données. En revanche, iv (vecteur d’initialisation) et chksum (somme de contrôle) laissent penser qu’un chiffrement est probablement utilisé.
Si nous lisons ces octets et les stockons dans un objet JavaScript que nous pourrons ensuite afficher, nous obtenons quelque chose comme ceci :
En réalité, RPM ne chiffre pas la base de données, du moins pas par défaut. Nous pouvons donc ignorer complètement ce cas d’usage.
Voici, à ce stade, la représentation de la structure de la base de données :
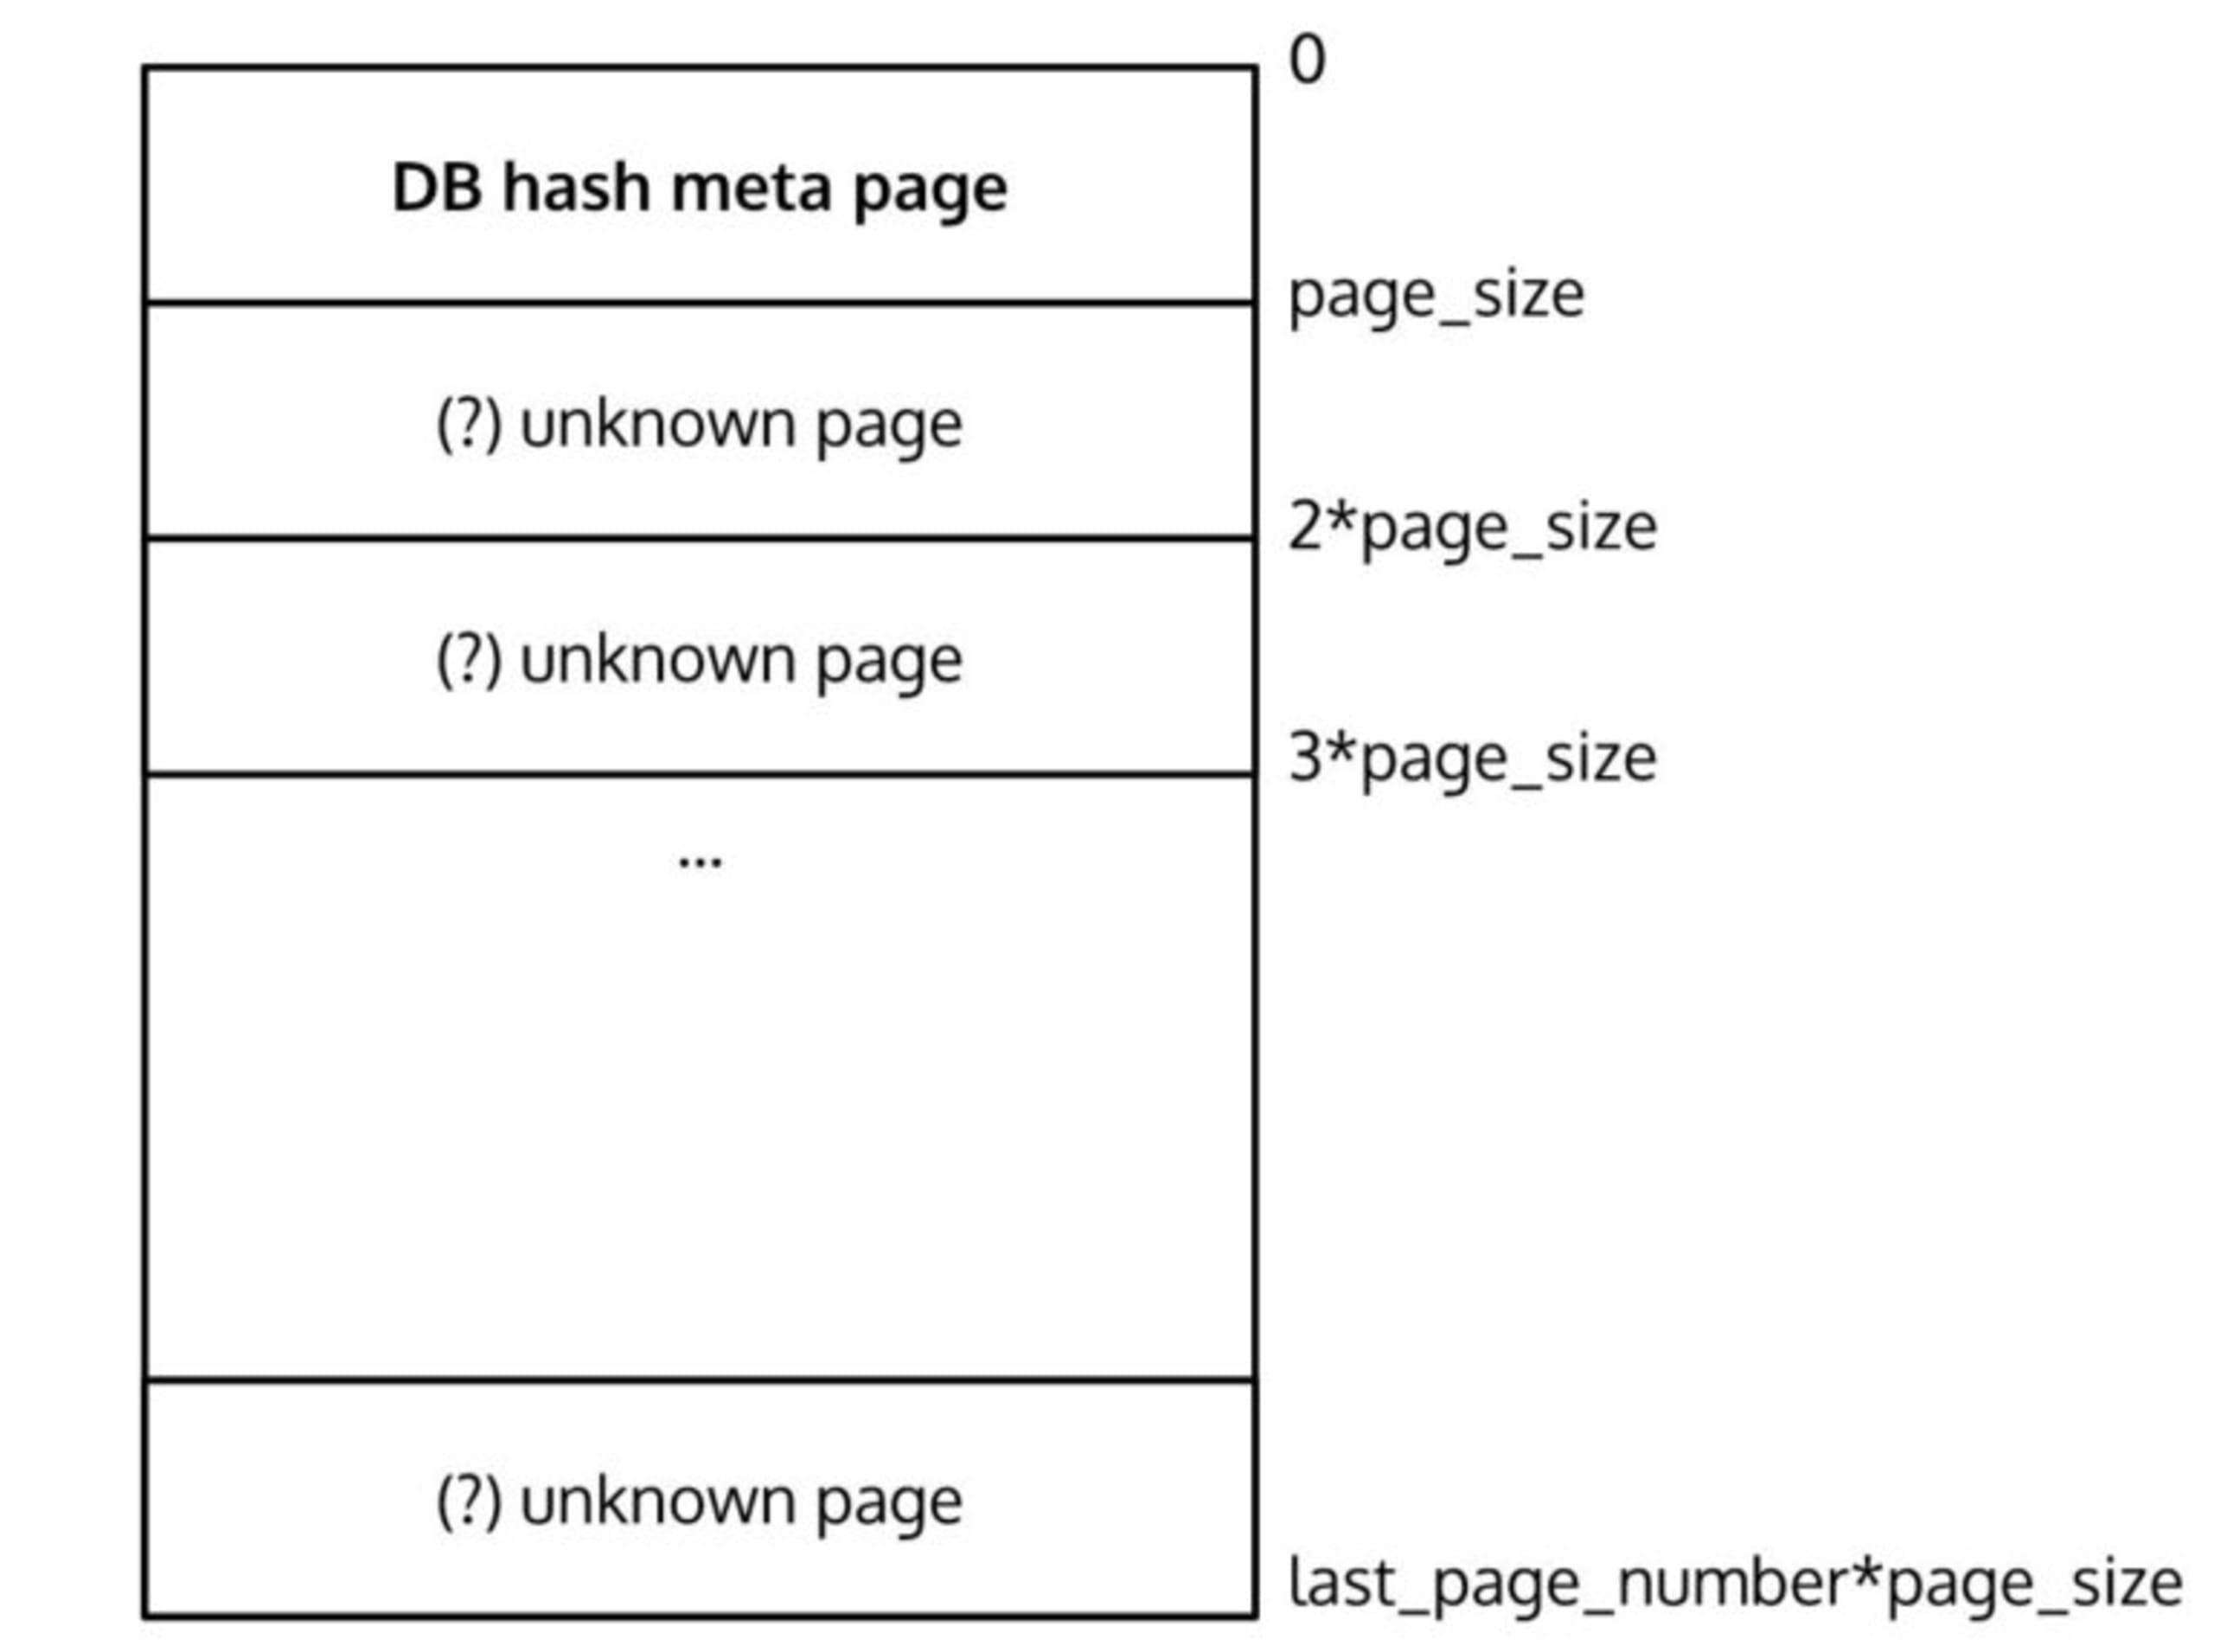
Comme une page fait 4096 octets et que la première contient les métadonnées de la base de données, passons à la page suivante pour voir quel type de données nous pouvons y trouver. Le code source de BerkeleyDB nous est également très utile et nous indique que la structure attendue est la suivante :
Les définitions de type nous donnent la taille de chacune de ces entrées. En lisant le nombre d’octets approprié, nous pouvons les associer à un objet JavaScript et obtenir ceci :
Remarquez le type: 13, qui indique un type de page entièrement nouveau, défini comme suit dans les définitions de type :
Les champs prev_pgno et next_pgno valent 0. Cela signifie que les données (quelles qu’elles soient) sont entièrement stockées sur cette page et que nous n’avons pas besoin d’en consulter d’autres pour les récupérer.
Remarquez la valeur de hf_offset. En examinant l’ensemble des données stockées sur la page, nous voyons que les octets situés autour de la position ~2850 sont à zéro, ce qui correspond à la valeur de hf_offset. Cela signifie que hf_offset indique où les données se terminent sur la page. Cette information nous sera particulièrement utile plus tard, lorsque nous lirons des éléments de données répartis sur plusieurs pages et que nous chercherons à déterminer où ils commencent et où ils se terminent.
Chaque page commence donc par un en-tête générique de 26 octets, et les 4070 octets restants sont partiellement ou entièrement remplis de données. La page de type Hash contient un index dont les entrées pointent vers des octets ou des positions de décalage sur la page courante. Ces positions pointent vers des données situées à l’autre extrémité de la page. La façon dont ces données sont stockées sur la page Hash rappelle la disposition d’une pile et d’un tas :
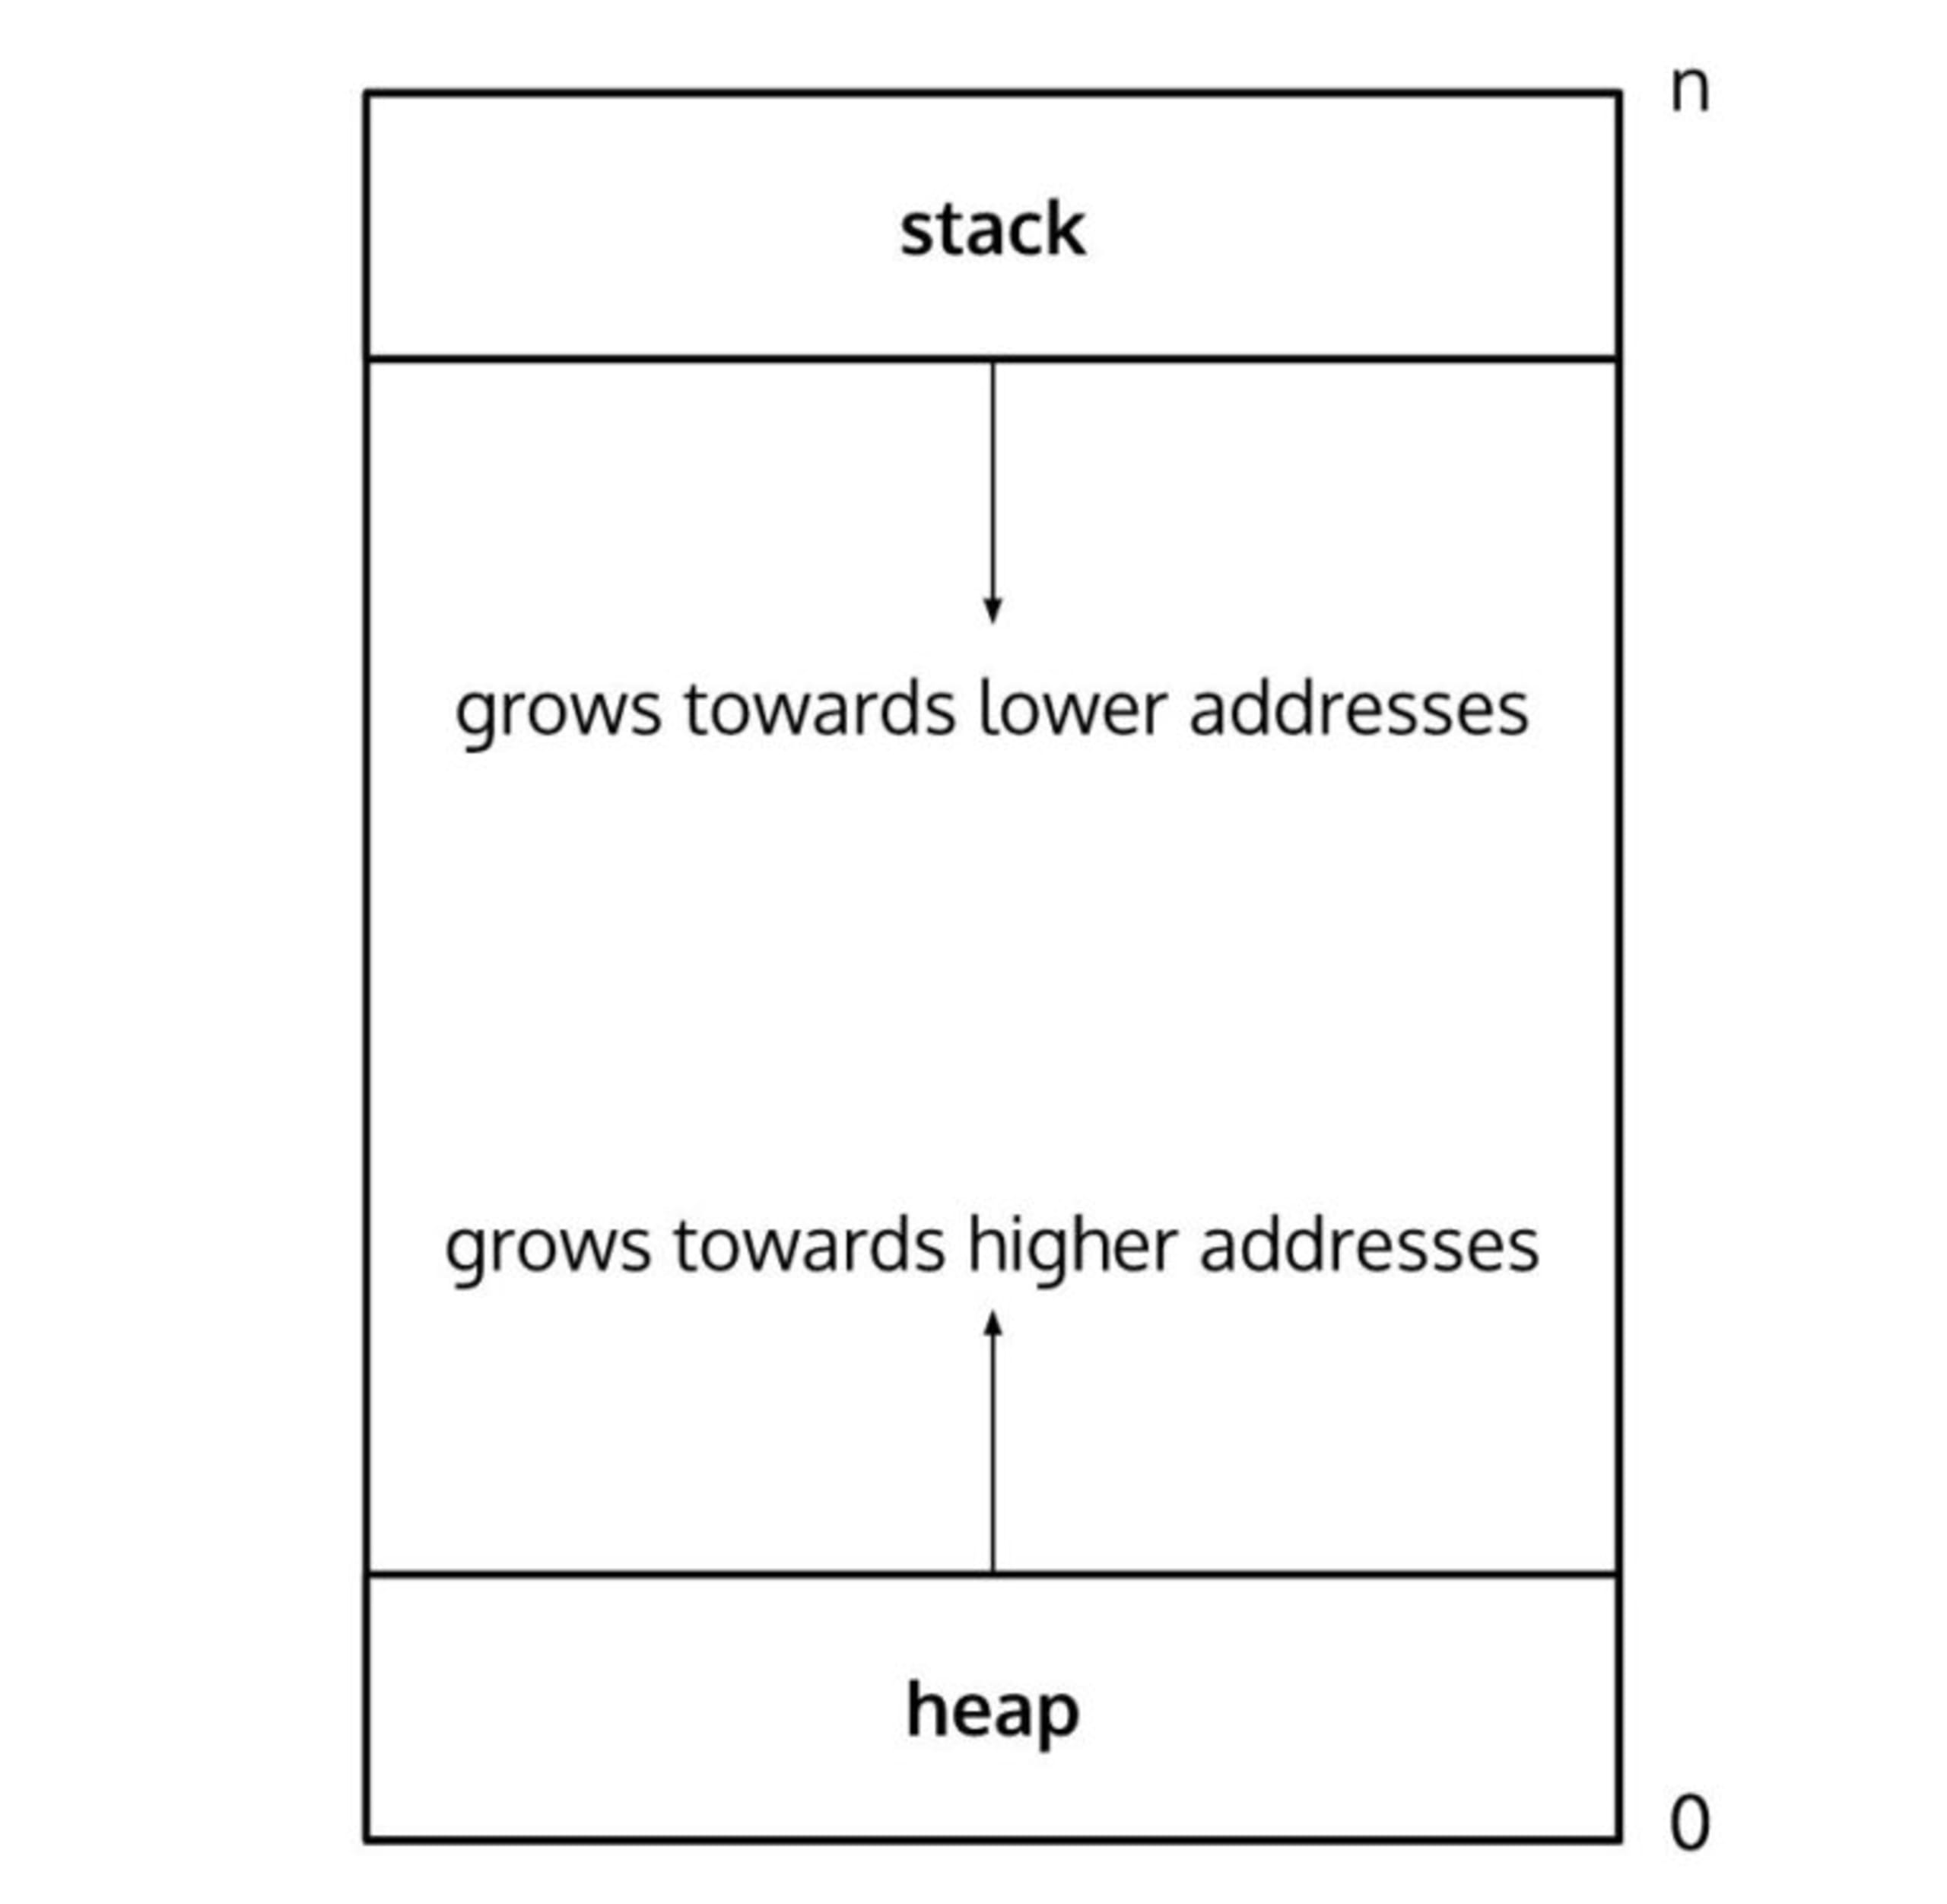
L’index se trouve dans la zone tas de la page, tandis que les données (pointées par les positions de décalage de l’index) se trouvent dans la zone pile.
L’index contient des entrées composées de paires de clés et de valeurs, listées les unes après les autres. La clé est un identifiant interne à la base de données ; la valeur pointe vers une position de décalage dans la page courante. Nous pouvons trouver une définition de type qui nous aide à interpréter les données stockées à chaque position :
Grâce à ces données, nous pouvons déterminer où se trouve cet élément dans l’ensemble de BerkeleyDB, ou du moins où il commence. Les données commencent à un numéro de page donné et peuvent s’étendre sur plusieurs pages si leur longueur dépasse la taille d’une page (vous vous souvenez de la valeur pagesize lue sur la page 0 ?).
Voici, à ce stade, la représentation de la base de données :
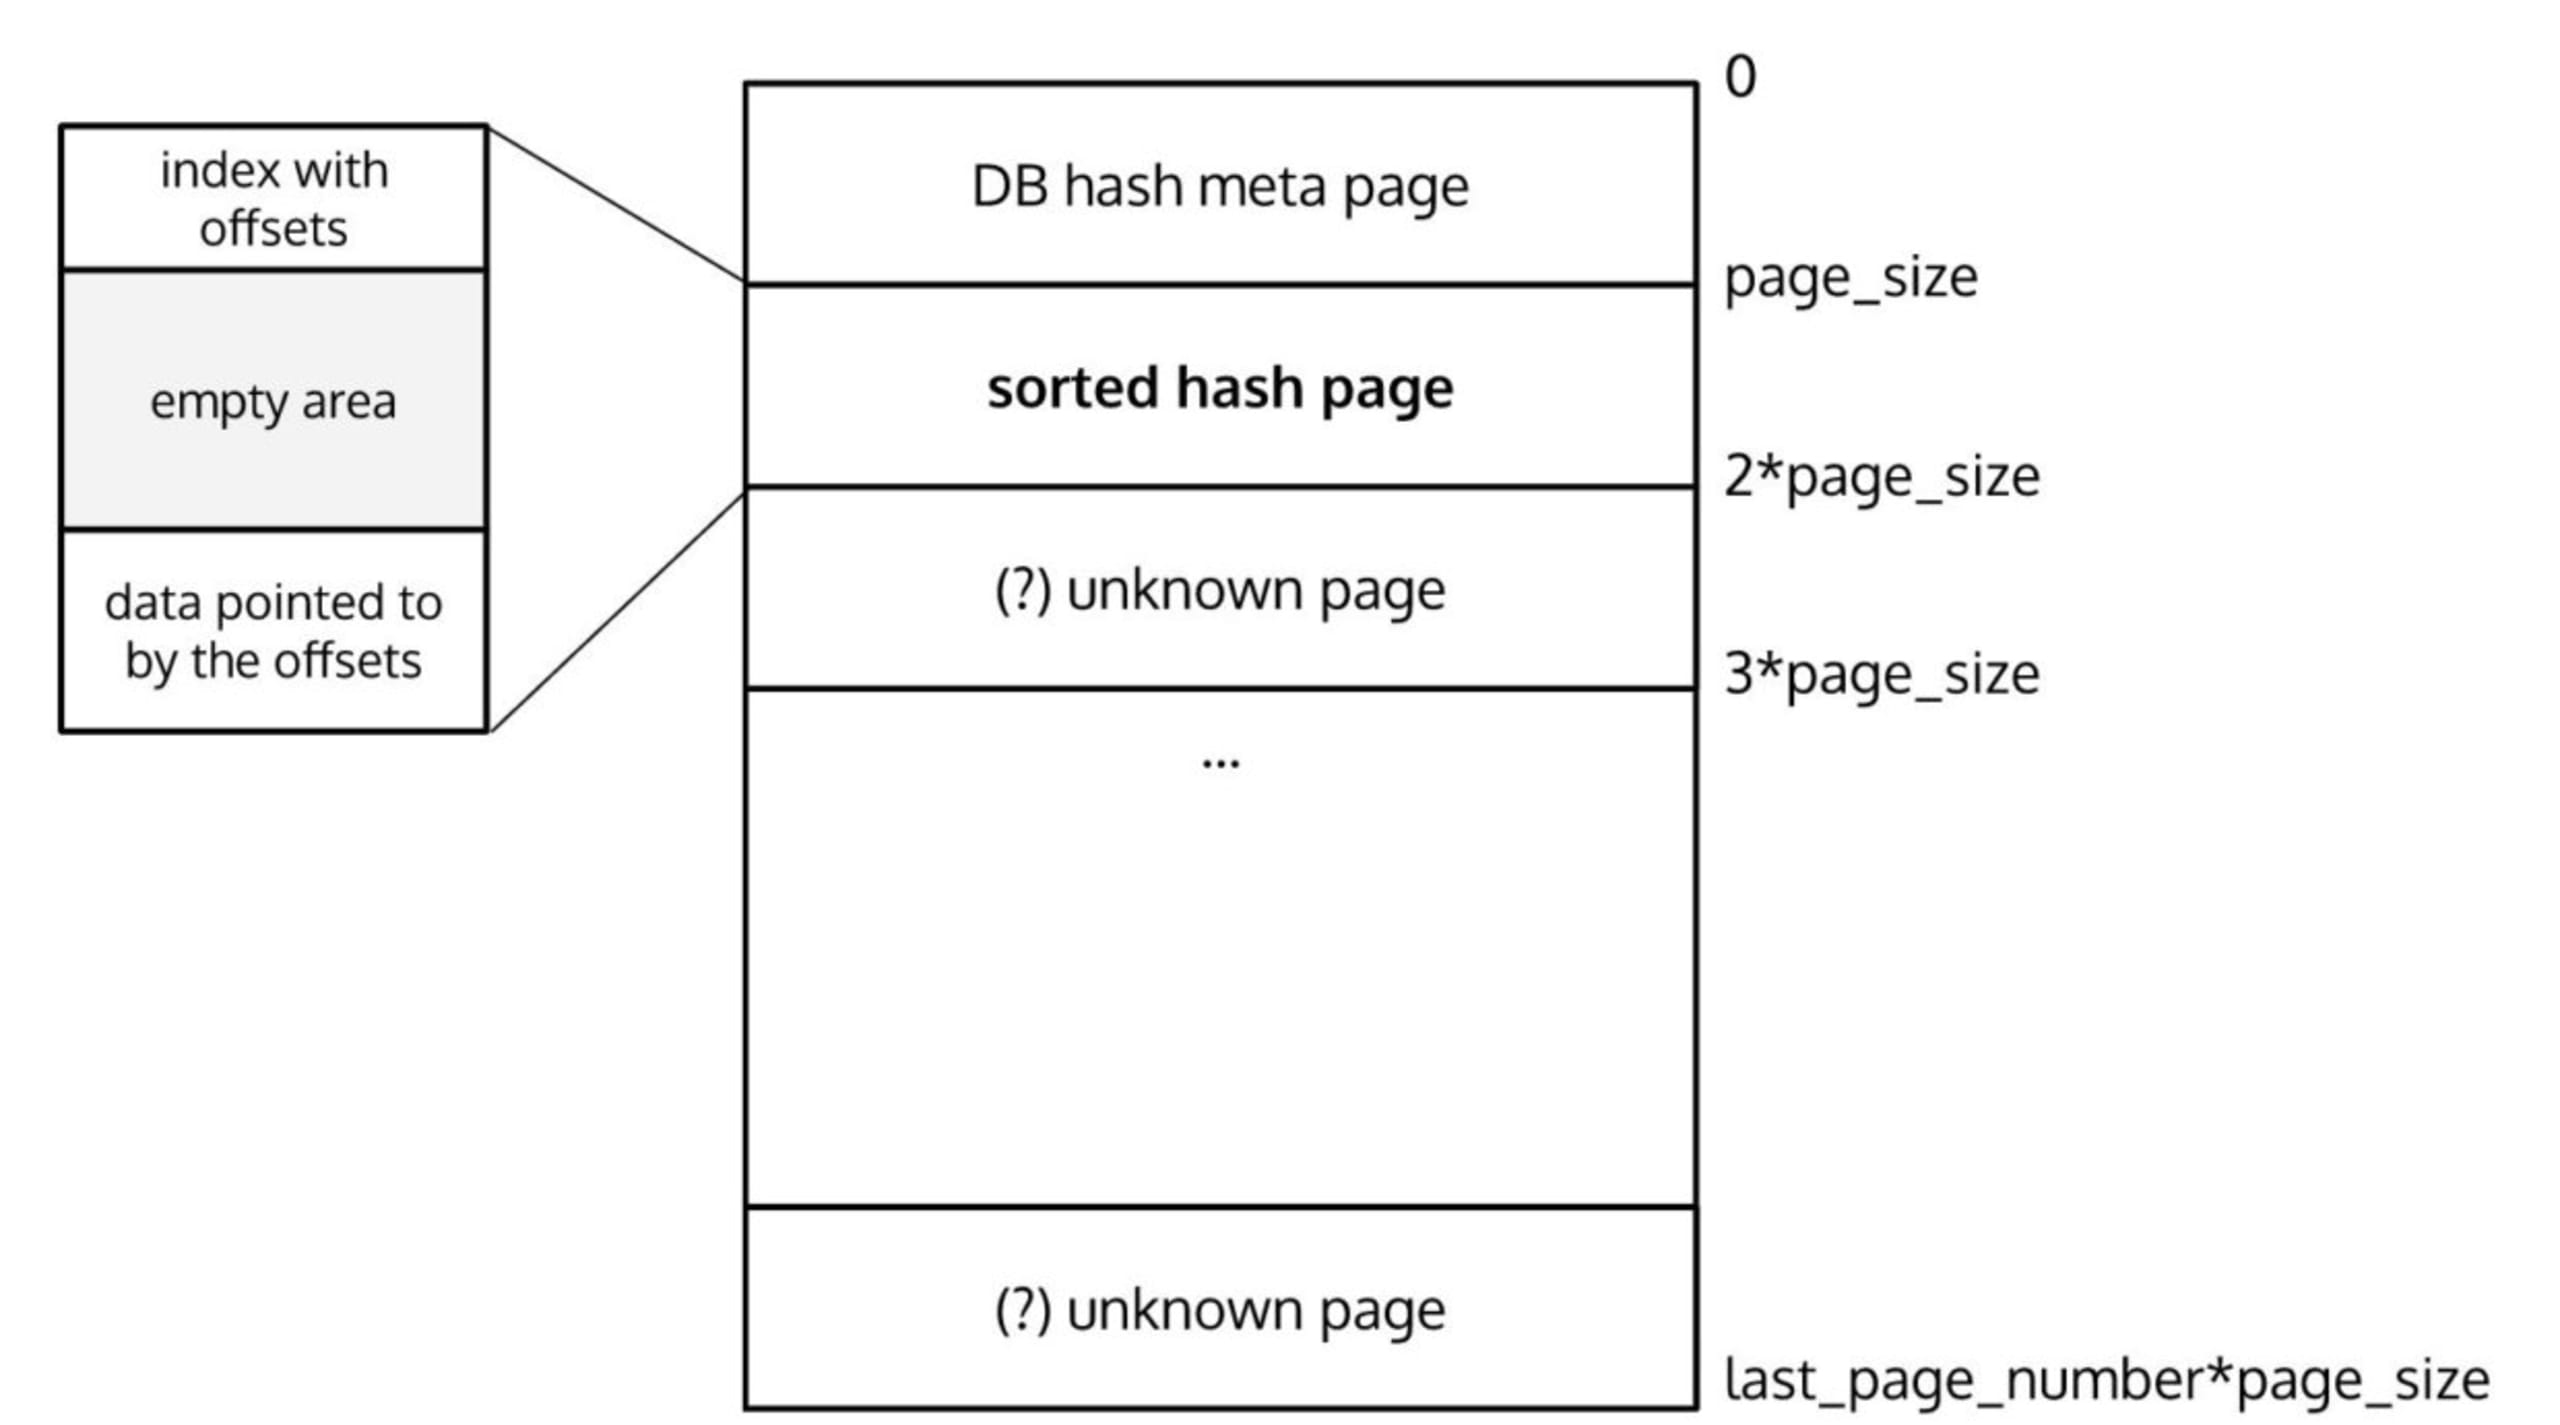
Prenons ensuite une entrée de l’index des données (représentée par struct __hoffpage) et examinons la page vers laquelle elle pointe. Nous pouvons charger cette page, puisque nous connaissons son numéro ainsi que la taille de chaque page, et en observer le contenu :
Remarquez que next_pgno contient une valeur et pointe vers la page suivante, qui contient le reste des données. hf_offset vaut 4070, ce qui signifie que cette page est entièrement remplie de données (elle fait 4070 octets, soit la taille de la page, 4096 octets, moins l’en-tête générique de 26 octets). Pour récupérer toutes les données, nous devons donc parcourir plusieurs pages en suivant next_pgno et en regroupant tous les octets.
Voici la représentation finale de la base de données :
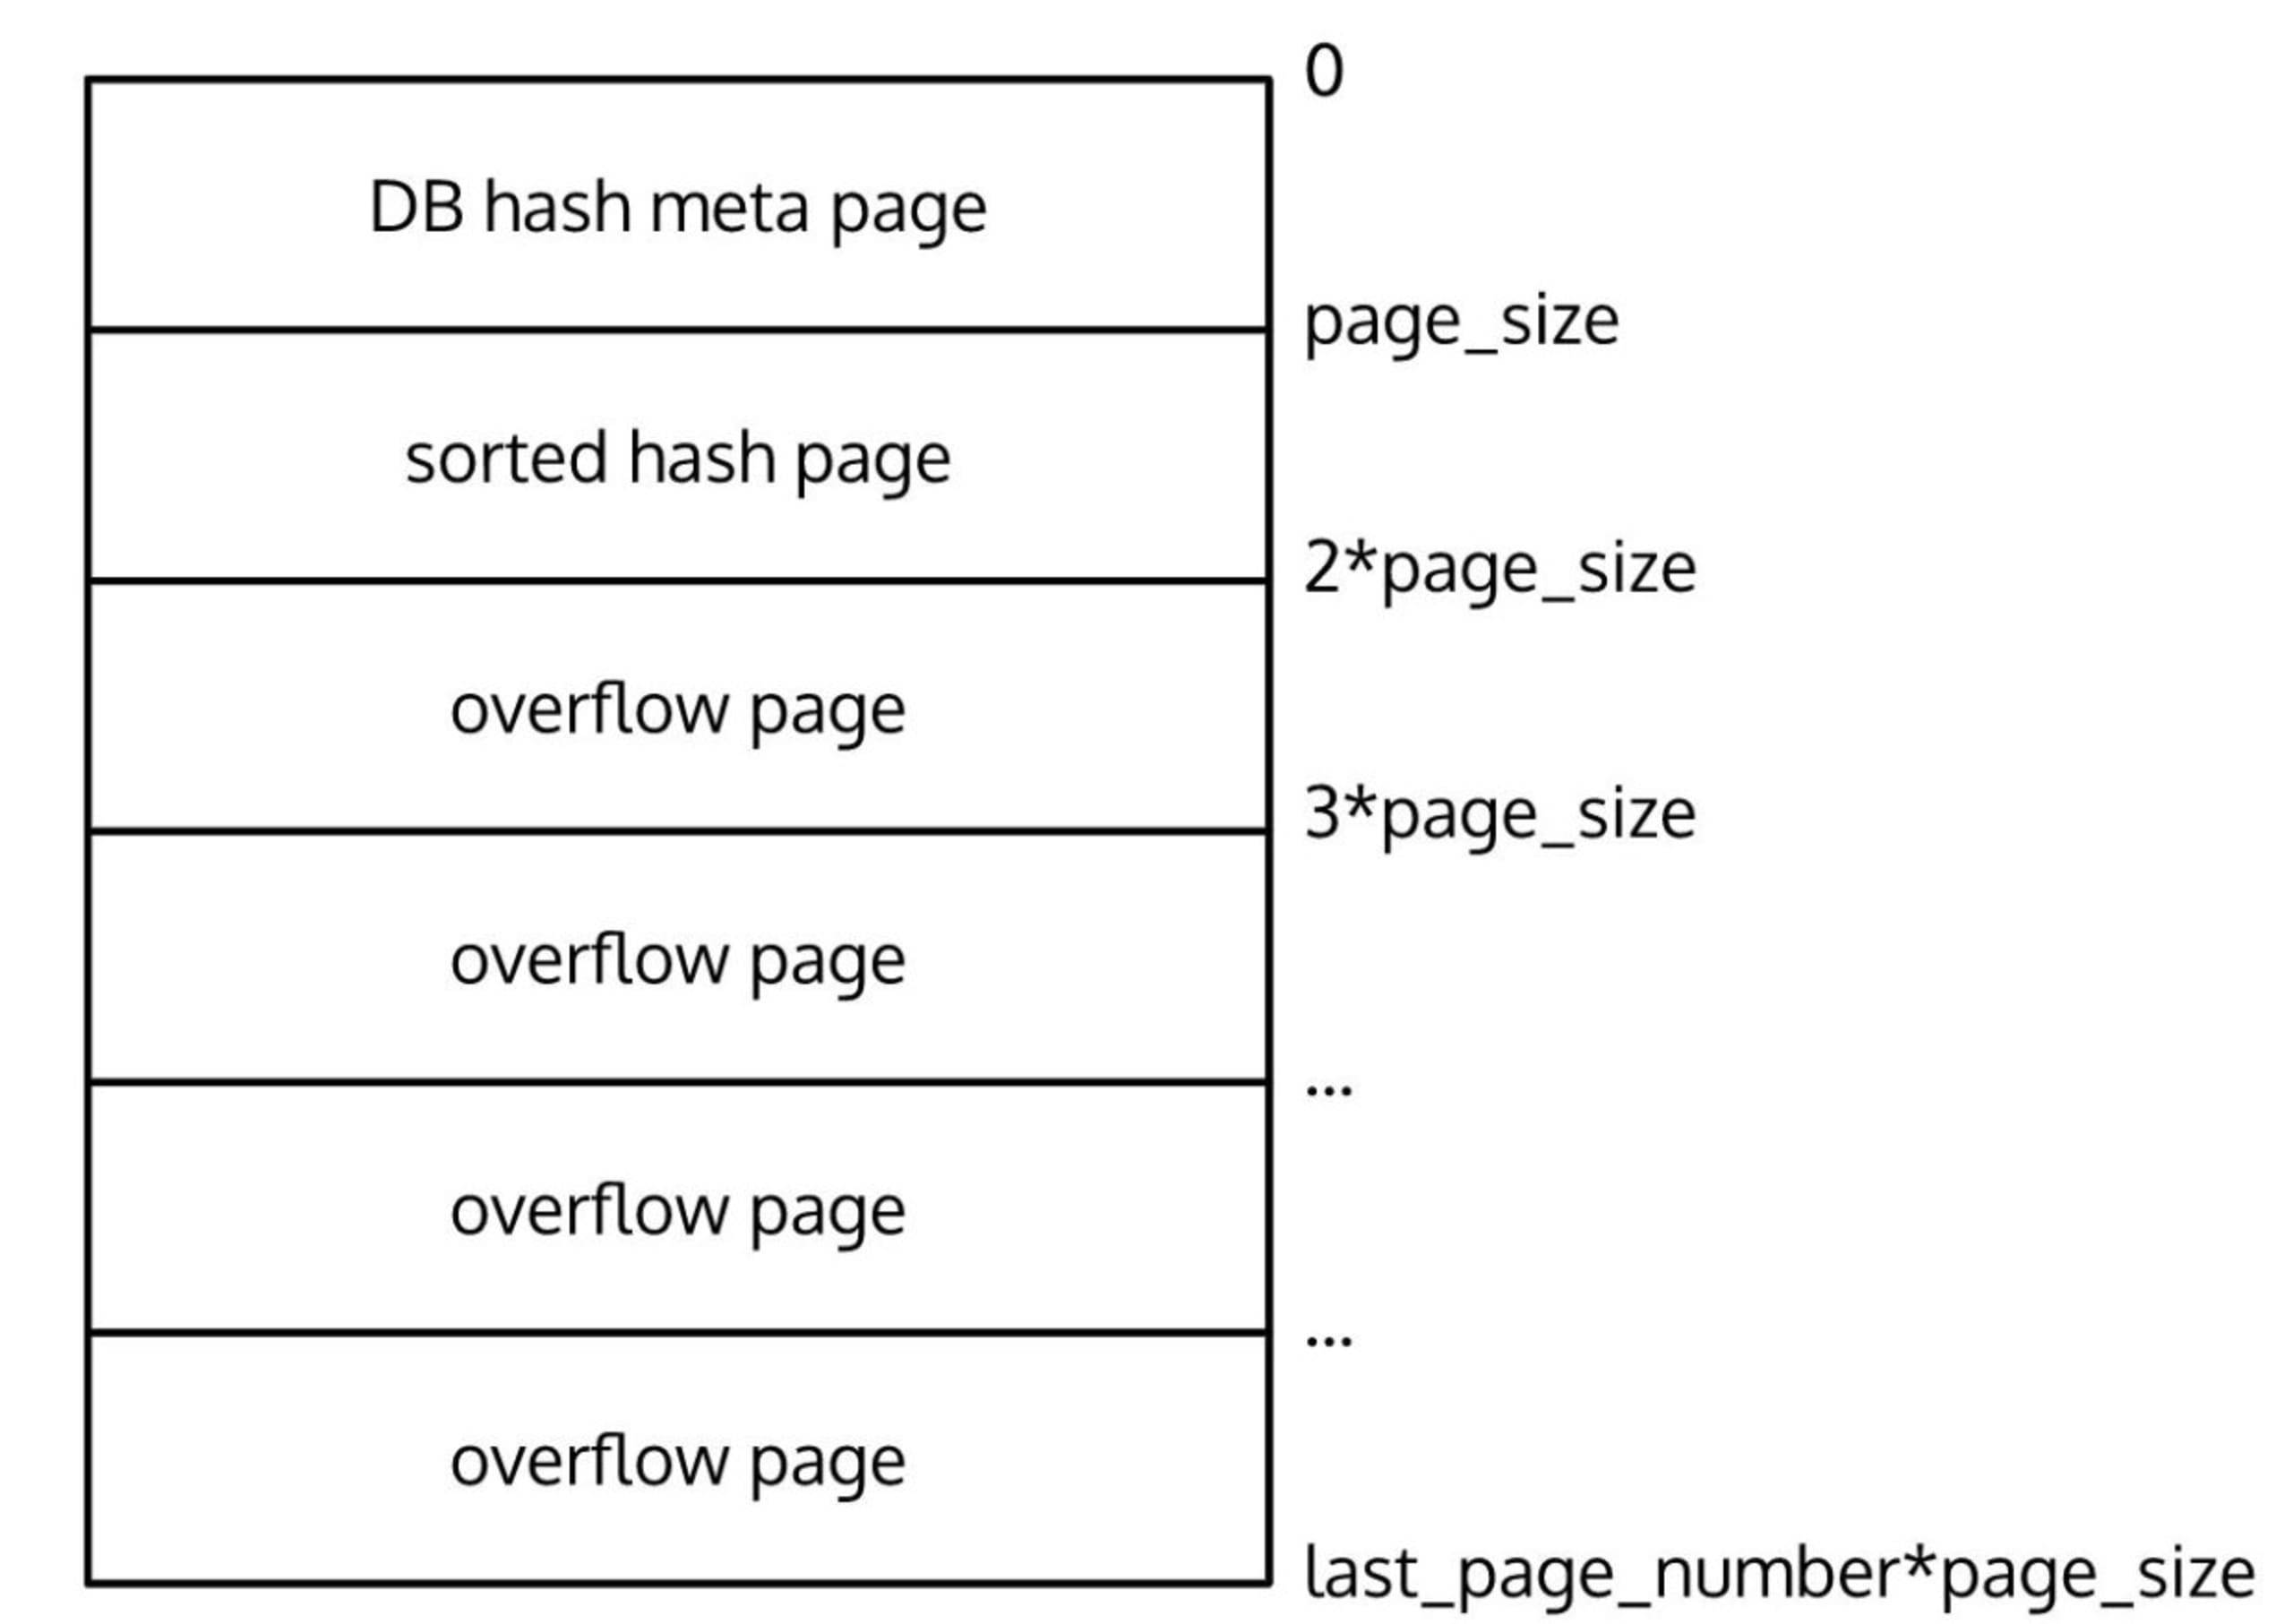
Nous savons maintenant tout ce qu’il faut pour lire les données ! Après avoir parcouru toutes les pages de débordement associées, nous obtenons une liste de blobs binaires qui correspondent aux packages RPM proprement dits. Il ne reste plus qu’à lire ces packages pour en extraire des informations comme le nom du package, sa version, son architecture, etc.
Analyser les métadonnées des packages RPM
Nous passons maintenant du contexte de BerkeleyDB au format des packages RPM et de leurs métadonnées. Pour comprendre à quoi ressemble un package RPM, nous consultons la documentation du format de fichier RPM.
Un fichier rpm se compose de quatre sections : un lead, un en-tête de signature, un en-tête de charge utile et une charge utile (les données proprement dites). Les deux sections d’en-tête ont le même format, décrit dans les sections suivantes. Elles se suivent dans le fichier, sans aucune information supplémentaire avant, entre ou après elles.
Après quelques essais, nous découvrons que les blobs binaires stockés dans BerkeleyDB contiennent en réalité ces deux éléments : un en-tête de charge utile partiel et une charge utile complète. Le lead et l’en-tête de signature sont entièrement absents. Selon la documentation RPM, la structure de l’en-tête de charge utile est la suivante :
En réalité, toutes les entrées HMx (magic de l’en-tête), la version et les octets réservés sont également absents ! À la place, nous obtenons un en-tête partiel qui contient indexcount (le nombre d’entrées de l’index de l’en-tête), storesize (la taille du magasin de données en octets), les entrées de l’index et le magasin de données.
À noter : les données sont stockées au format gros-boutiste. Chaque entrée doit donc être lue et interprétée explicitement dans ce format.
À ce stade, les blobs binaires récupérés depuis BerkeleyDB ressemblent à ceci en pseudocode :
Nous pouvons lire facilement les deux premiers éléments, mais pour lire index_entries, nous devons en comprendre la structure. La documentation du format de fichier RPM nous indique ceci :
Chaque index_entry fait 16 octets. Grâce à cette information et à la valeur de indexcount, nous pouvons récupérer toutes les entrées de l’en-tête RPM.
Nous pouvons maintenant lire toutes les entrées de l’index en JavaScript et produire une liste semblable à celle-ci :
La documentation RPM contient un tableau qui indique la signification de chaque valeur de tag. Les tags précisent des informations sur le package, comme le nom (1000), la version (1001), l’architecture (1022), etc. La documentation RPM décrit également le type : on trouve notamment string (6), int32 (4) ou même le type null (0).
Nous pouvons maintenant utiliser offset pour accéder au début des données de chacune de ces entrées. Veillons à inclure également indexcount dans le calcul du décalage afin d’atteindre l’emplacement des données. Selon la valeur de type, nous pouvons traiter différemment la suite d’octets obtenue. Par exemple, pour les types string, nous lisons les octets jusqu’à rencontrer un octet 0, qui marque la fin de la chaîne (comme c’est généralement le cas dans les logiciels écrits en C). Pour le type int32, nous savons au contraire qu’il faut lire seulement 4 octets.
Grâce à toutes ces informations, nous pouvons parcourir les entrées de l’index et extraire suffisamment de données sur les packages pour construire une dépendance. Voici un exemple d’entrée :
En répétant le même processus pour tous les blobs BerkeleyDB, nous pouvons extraire les informations de tous les packages et générer la liste des dépendances.
En résumé
Nous avons exploré en profondeur le fonctionnement interne du gestionnaire de packages RPM afin de comprendre la structure binaire des données et la représentation interne des informations sur les packages installés. C’est exactement ainsi que Snyk lit et analyse la liste des dépendances dans vos images de conteneurs. Snyk est gratuit : vous pouvez créer un compte. Découvrez également notre bibliothèque open source RPM parser sur GitHub, qui se charge de tout ce travail !
Lancez-vous dans les compétitions Capture The Flag
Apprenez à résoudre des défis de capture du drapeau en regardant à la demande notre atelier virtuel d’initiation.


