Performances dans OPA Rego : évaluation ascendante et descendante

29 avril 2021
0 minutes de lectureDans cet article, nous allons voir comment fonctionne l’évaluation de Rego et quel est son impact sur les performances. Rego est un DSL qui permet de rédiger des politiques. Il n’est pas limité à un seul type de politique (comme le RBAC), mais est très polyvalent : il est ainsi possible de partager des politiques entre différents services et environnements technologiques. Nous avons constaté que Rego est idéal pour sécuriser les infrastructures cloud dans Fugue, ainsi que pour sécuriser l’infrastructure as code dans notre projet open source, Regula.
Rego s’appuie sur Datalog, un langage déclaratif. En d’autres termes, le programmeur indique les résultats souhaités, sans nécessairement préciser comment les obtenir. C’est l’inverse des langages impératifs (comme JavaScript et Python), dans lesquels le programmeur fournit toujours l’algorithme exact.
La distinction n’est pas toujours nette : la plupart des langages déclaratifs disposent d’un moyen d’indiquer comment effectuer un calcul (comme nous le verrons dans cet article), et il est possible de créer des DSL déclaratifs dans des langages impératifs. Dans les deux cas, Rego se situe clairement du côté déclaratif du spectre.
Puisque le programmeur n’a pas à préciser comment obtenir un résultat, le compilateur ou l’interpréteur dispose d’une plus grande liberté. Pour les langages comme Rego, deux stratégies sont importantes : l’évaluation ascendante et l’évaluation descendante.
À l’aide d’un exemple simple, nous allons expliquer ces deux stratégies et examiner leurs avantages et leurs inconvénients respectifs.
Un exemple
Imaginons que nous écrivions une politique visant à garantir que les autorisations d’écriture sont définies de manière granulaire. Voici à quoi pourrait ressembler notre entrée :
Certains de ces rôles disposent de ce que nous appellerons des autorisations d’écriture dangereuses : write: *. Dans notre politique, nous voulons afficher une erreur pour chaque utilisateur auquel un rôle dangereux est attribué.
Nous définissons deux règles :
dangerous_roles:un ensemble contenant toutes les politiques avecwrite: *deny: un ensemble contenant tous les messages d’erreur
Voici la politique complète :
Nous pouvons vérifier que le résultat obtenu est celui attendu en utilisant opa eval :
Maintenant que nous avons cet exemple en tête, examinons l’évaluation ascendante et descendante.
Évaluation ascendante
Je trouve que le plus simple pour comprendre la différence entre ces deux stratégies d’évaluation est de représenter l’arbre de dépendances des règles :
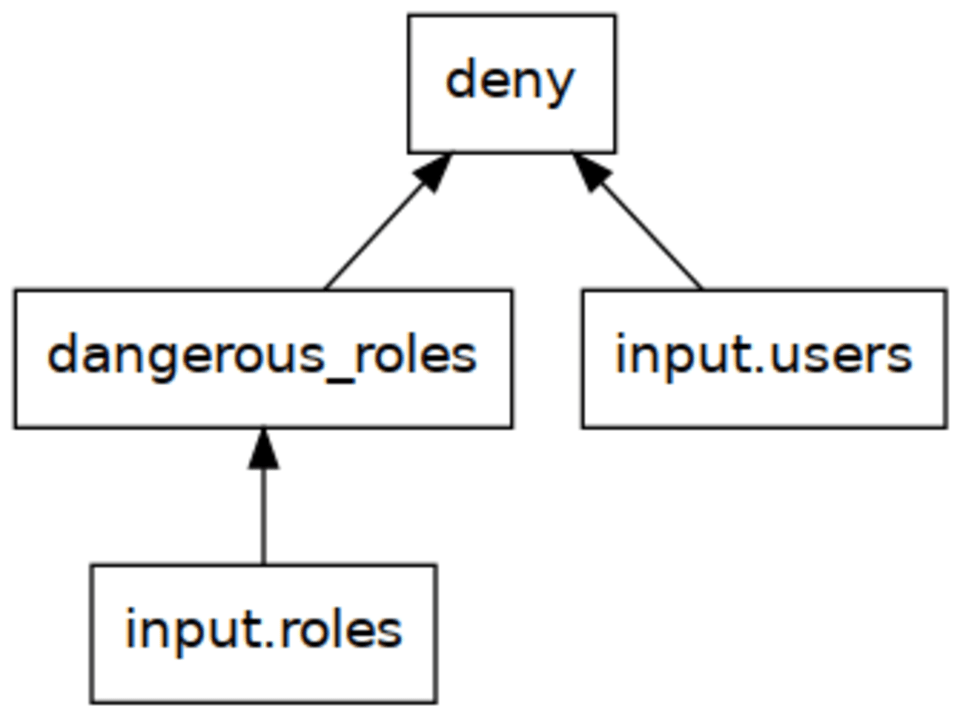
deny dépend de dangerous_roles, et les deux dépendent du document d’entrée. Une stratégie ascendante commence par évaluer l’arbre depuis la base, puis remonte vers le sommet.
Le document d’entrée ne nécessite aucune évaluation supplémentaire. Au-dessus se trouve l’ensemble dangerous_roles : nous commençons par calculer cet ensemble. Dans notre exemple, il s’agira de l’ensemble {"temporary_hack"}.
Une fois que nous connaissons dangerous_roles, toutes les dépendances de la règle deny sont connues. Nous poursuivons donc en évaluant ce deuxième ensemble, qui devient {"Please remove role temporary_hack from user bob"}.
Une stratégie ascendante est simple à mettre en œuvre, mais présente un inconvénient majeur : elle calcule souvent trop de choses ! Supposons qu’au lieu de répertorier tous les messages deny, nous voulions simplement vérifier si temporary_hack est un rôle dangereux. Avec une stratégie ascendante, dangerous_roles["temporary_hack"] calculerait l’ensemble entier (potentiellement volumineux), au lieu de s’arrêter dès qu’elle constate que temporary_hack en fait bien partie.
Une stratégie descendante permet de résoudre ce problème.
Évaluation descendante
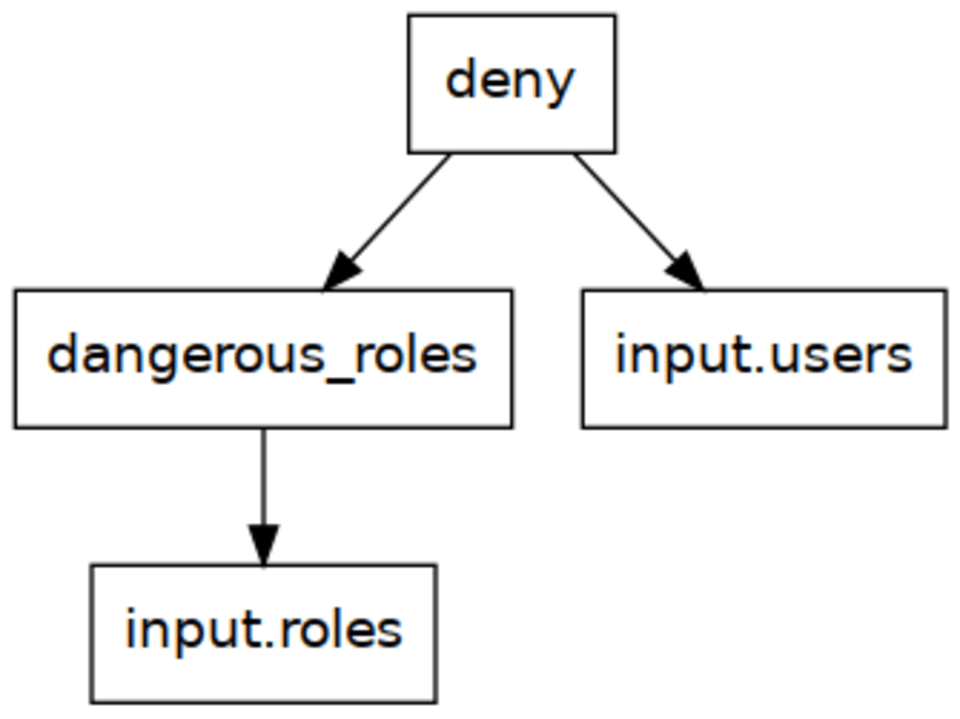
La stratégie descendante fonctionne à l’inverse : elle évalue les règles au fur et à mesure des besoins, en partant du sommet. C’est très similaire à l’appel de fonctions dans la plupart des langages.
Nous commençons par évaluer deny, puisque c’est la valeur demandée. Cette règle parcourt les utilisateurs, attribue une valeur à role_name, puis appelle dangerous_roles[role_name]. Par analogie avec une fonction, vous pouvez considérer cela comme dangerous_roles(role_name).
dangerous_roles n’appelle pas d’autres « fonctions », mais parcourt plutôt les politiques du document d’entrée.
Nous voyons que cette approche donne le comportement souhaité pour l’évaluation de dangerous_roles["temporary_hack"] : au lieu de construire un ensemble, elle parcourt les politiques de l’entrée et renvoie un résultat dès qu’elle trouve le rôle dangereux correspondant à ce nom.
OPA utilise une stratégie descendante pour évaluer Rego.
Un comportement quadratique imprévu
Mais cette approche descendante n’est pas sans inconvénients ! En pseudocode, l’évaluation ascendante effectue en interne deux boucles :
L’évaluation descendante, elle, fonctionne différemment. Si nous considérons à nouveau dangerous_roles comme un appel de fonction, nous obtenons :
Cela ressemble étrangement à un algorithme dont le temps d’exécution est quadratique !
Et effectivement, avec une entrée générée comprenant 1 000 utilisateurs et 1 000 politiques, opa met 3,47 secondes à effectuer l’évaluation. En passant à 10 000, le temps dépasse tout juste 4 minutes !
Cet exemple peut sembler artificiel, mais il est comparable à un problème réel rencontré chez Fugue ! Nous analysons un grand nombre de ressources pour vérifier leur conformité : ces évaluations peuvent donc finir par s’accumuler.
Évaluation descendante et ascendante
Est-ce tout ? Sommes-nous condamnés à des requêtes lentes ? Heureusement, non !
Il existe une solution simple : si nous savons que nous voulons évaluer une règle « en une seule fois », nous pouvons utiliser une compréhension d’ensemble. Ainsi, dangerous_roles devient une règle complète avec une seule valeur.
Voici la syntaxe :
Grâce à cette petite astuce (que les analystes de requêtes détestent), nous passons sous la barre des 0,4 seconde pour 10 000 utilisateurs !
Conclusion
Un langage déclaratif permet de se concentrer facilement sur ce que l’on veut calculer plutôt que sur la façon de le faire. Cependant, nous ne pouvons pas complètement ignorer le modèle d’exécution, surtout lorsqu’il risque d’allonger considérablement le temps d’exécution et de provoquer des délais d’attente dépassés !
Heureusement, la solution est simple et rapide. Lorsque vous écrivez des règles Rego, il est utile de vous demander si une règle doit être représentée sous forme de fonction ou d’ensemble calculé une seule fois, puis d’utiliser une compréhension ou une règle incrémentale en conséquence.
Dans cet article, nous avons parlé uniquement des ensembles, mais le même principe s’applique aux objets.
Une question évidente reste sans réponse : peut-on résoudre ce problème sans avoir à modifier le code, dans le plus pur esprit déclaratif ?
La mise en cache des résultats des appels à dangerous_roles[role] semble être une piste intéressante, et c’est celle que j’ai explorée en premier. Toutefois, pour éviter les recalculs, il faut mettre en cache les éléments présents dans l’ensemble, mais aussi ceux qui n’y figurent pas. Cela pose problème, car ces derniers risquent de ne pas tenir en mémoire. Dans les deux cas, il faut également prévoir une éviction LRU, ce qui complique le code.
Il n’est pas toujours possible pour un compilateur de déterminer si une règle arbitraire est plus efficace lorsqu’elle est évaluée de manière ascendante ou descendante. Cela ne doit toutefois pas nous empêcher d’essayer. J’ai prototypé une passe d’optimisation dans fregot, notre moteur Rego expérimental, qui identifie les règles susceptibles d’être évaluées de manière ascendante en examinant les motifs d’affectation et en vérifiant si l’argument peut être utilisé pour interrompre l’évaluation de façon anticipée. Cette passe a identifié tous les cas qui dépassaient le délai d’attente : c’est donc une piste prometteuse !
Une sécurité IaC pensée pour les développeurs
Snyk sécurise votre infrastructure en tant que code, du cycle de développement logiciel à l’exécution dans le cloud, grâce à un moteur unifié de politiques sous forme de code. Chaque équipe peut ainsi développer, déployer et exploiter ses applications en toute sécurité.