Mettre en place des politiques sous forme de code (PaC) avec OPA et Rego

19 janvier 2022
0 minutes de lectureLe Cambridge Dictionary définit une politique comme suit : « un ensemble d’idées ou un plan d’action pour des situations particulières, approuvé officiellement par un groupe de personnes, une entreprise, un gouvernement ou un parti politique ». Dans le contexte du développement logiciel, votre organisation peut avoir des règles qui définissent comment une politique est conçue, configurée, déployée et utilisée. Voici quelques exemples de politiques logicielles :
Politiques applicatives
Certains contextes de services web ne sont accessibles qu’aux utilisateurs internes.
Les fonctionnalités régionales ne s’affichent que pour les requêtes provenant d’utilisateurs dont l’adresse IP correspond à la même zone géographique.
Les utilisateurs ayant un rôle de gestionnaire sont les seuls autorisés à effectuer des transactions dépassant certains montants.
Politiques de build et de déploiement
Toutes les bibliothèques open source utilisées dans les applications doivent être distribuées sous l’une des licences approuvées.
Toutes les images de conteneur doivent être extraites de registres spécifiques.
Aucun Pod Kubernetes ne doit jamais s’exécuter en mode privilégié.
Le jeton par défaut d’un ServiceAccount ne doit pas être monté automatiquement dans un conteneur.
Les politiques sous forme de code (PaC)consistent à définir des politiques dans du code à l’aide d’un langage déclaratif de haut niveau. Vous pouvez ainsi automatiser leur application et les gérer de façon centralisée. Cette approche limite la duplication de logique entre les services applicatifs, de plus en plus distribués et susceptibles d’utiliser des langages et des plateformes très variés.
Dans cet article, nous allons découvrir Open Policy Agent (OPA) et son langage de règles Rego, qui peuvent vous aider à simplifier vos initiatives PaC, tant pour vos propres applications que pour l’application de politiques aux charges de travail conteneurisées sur Kubernetes.
Définir des politiques uniformes pour des services hétérogènes
L’application des politiques applicatives est souvent intégrée directement au code. Dans les systèmes distribués actuels, une même logique peut donc être dupliquée. Le problème s’accentue lorsque ces services distincts sont développés par différentes équipes et/ou avec des technologies différentes.
Il est essentiel de disposer de définitions de politiques et d’outils d’application standardisés, utilisables par toutes les équipes de votre organisation, quels que soient les langages utilisés ou les frameworks sur lesquels elles s’appuient. Des définitions uniformes facilitent la mise en œuvre, offrent une grande flexibilité et simplifient la gouvernance de la conformité pour toutes les personnes concernées.
Application proactive ou réactive des politiques de build et de déploiement
Les règles de politique relatives au build et au déploiement sont souvent appliquées au moyen d’une combinaison de revues de code manuelles, d’analyses statiques (idéalement automatisées dans votre pipeline CI/CD) ou simplement par la menace de mesures disciplinaires en cas de non-respect. Ces pratiques sont réactives : elles nous alertent en cas de violation lors d’un audit. Cette méthode peut fonctionner, mais elle crée souvent une relation conflictuelle entre les responsables des politiques et les développeurs, qui ne sont pas toujours au courant de l’existence de ces règles.
Mettre en œuvre les politiques et les appliquer dans le workflow des développeurs, dans le cadre de leurs processus de build ou comme condition préalable au déploiement, permet de bloquer les violations dès qu’elles surviennent au lieu de s’en remettre à des audits tardifs ou à des revues manuelles.
Appliquer uniformément les politiques à des environnements hétérogènes
Une fois vos règles de politique réunies sur une plateforme unique et partagée, vous pouvez les appliquer uniformément à tous vos environnements. Par exemple, si votre cluster Kubernetes de développement permet de tout déployer sans restriction, contrairement à votre cluster de production, les développeurs risquent de ne découvrir une violation que plus tard dans le cycle de vie du développement logiciel (SDLC). En revanche, si tous les clusters partagent le même ensemble de règles, il est beaucoup moins probable que ces violations soient validées dans le contrôle de code source, puisqu’elles auront été détectées lors des premiers tests unitaires.
Open Policy Agent (OPA)
Open Policy Agent, généralement désigné par ses initiales OPA et prononcé « oh-pah », est un projet open source reconnu par la CNCF qui met en œuvre un moteur de politiques généraliste. Il est largement utilisé pour les politiques applicatives, en particulier dans les architectures distribuées à microservices, ainsi que comme contrôleur d’admission de l’API Kubernetes, souvent intégré via le projet OPA Gatekeeper.
Les applications peuvent déléguer la validation des politiques à OPA, évitant ainsi d’intégrer étroitement cette logique à leur base de code. En pratique, un processus OPA est souvent démarré à côté du service applicatif et expose une API REST avec laquelle l’application peut communiquer. Dans un déploiement Kubernetes, cela se fait généralement au moyen d’un conteneur sidecar dans le même Pod que le conteneur de service. Cette configuration offre une connexion « localhost » à très faible latence, mais OPA peut aussi être exécuté comme service externe. Il existe également d’autres façons d’intégrer OPA à votre application. À la date de rédaction de cet article, elles incluent une API Go, WebAssembly et un SDK permettant d’intégrer OPA à une application Go.
Dans OPA, les politiques sont écrites sous forme d’un ensemble de règles dans un langage appelé Rego.
Rego : le langage de règles de politique d’OPA
Rego est un langage déclaratif de haut niveau conçu pour appliquer des règles à des documents structurés, comme JSON. Un tutoriel détaillé sur la rédaction de règles Rego dépasse le cadre de cet article, mais je vous recommande vivement de consulter la documentation officielle et l’excellent parcours de formation de Styra, les créateurs d’OPA et de Rego.
Les bases de Rego
Rego peut fonctionner de plusieurs façons avec des documents de données structurés, mais le cas le plus courant consiste pour le processus appelant à lui transmettre un document, souvent au format JSON ou YAML, en tant que entrée. Les règles sont ensuite appliquées en comparant les éléments de ce document d’entrée à des expressions.
Par exemple, imaginons une politique de validation de Pod Kubernetes qui renvoie true tant que la valeur image de l’entrée ne se termine pas par « :latest ». Une implémentation Rego simple de cette politique pourrait ressembler à ceci :
Si le JSON suivant est évalué par cette politique, la réponse { “allow”: false } sera renvoyée, car « :latest » ne figure pas à la fin de l’image.
Explication de l’exemple Rego
Examinons le code Rego de l’exemple ci-dessus :
Nous déclarons ici le package auquel appartient la règle. Cela ressemble à la gestion des packages dans d’autres langages et permet de regrouper des règles similaires dans le même espace de noms.
Le mot-clé import indique simplement à l’analyseur Rego d’ajouter la règle in du package future.keyworks à la portée de cette politique, afin qu’elle puisse être désignée simplement par in.
« Cela définit la valeur default de allow sur « false » si aucune autre expression d’affectation dans la politique ne lui attribue une autre valeur.
Voici l’essentiel de la logique de la règle. Lors de son exécution, allow reçoit le résultat de l’évaluation du contenu entre les accolades { }. Toutes les expressions entre ces accolades sont évaluées avec un « AND » implicite : elles doivent donc toutes renvoyer « true » pour que allow prenne la valeur « true ».
On peut interpréter ces trois lignes ainsi : « Tant que la valeur input.kind est « Pod » et que input.spec contient au moins quelques conteneurs, renvoyer « true », sauf si le champ image de l’un des conteneurs se termine par « :latest ». »
Rego Playground
Le projet OPA héberge un environnement d’édition Rego en ligne appelé The Rego Playground. Vous pouvez y tester des règles et les exécuter à volonté sur des documents d’entrée. C’est un excellent moyen d’expérimenter vos idées de règles de façon interactive et de partager vos essais.
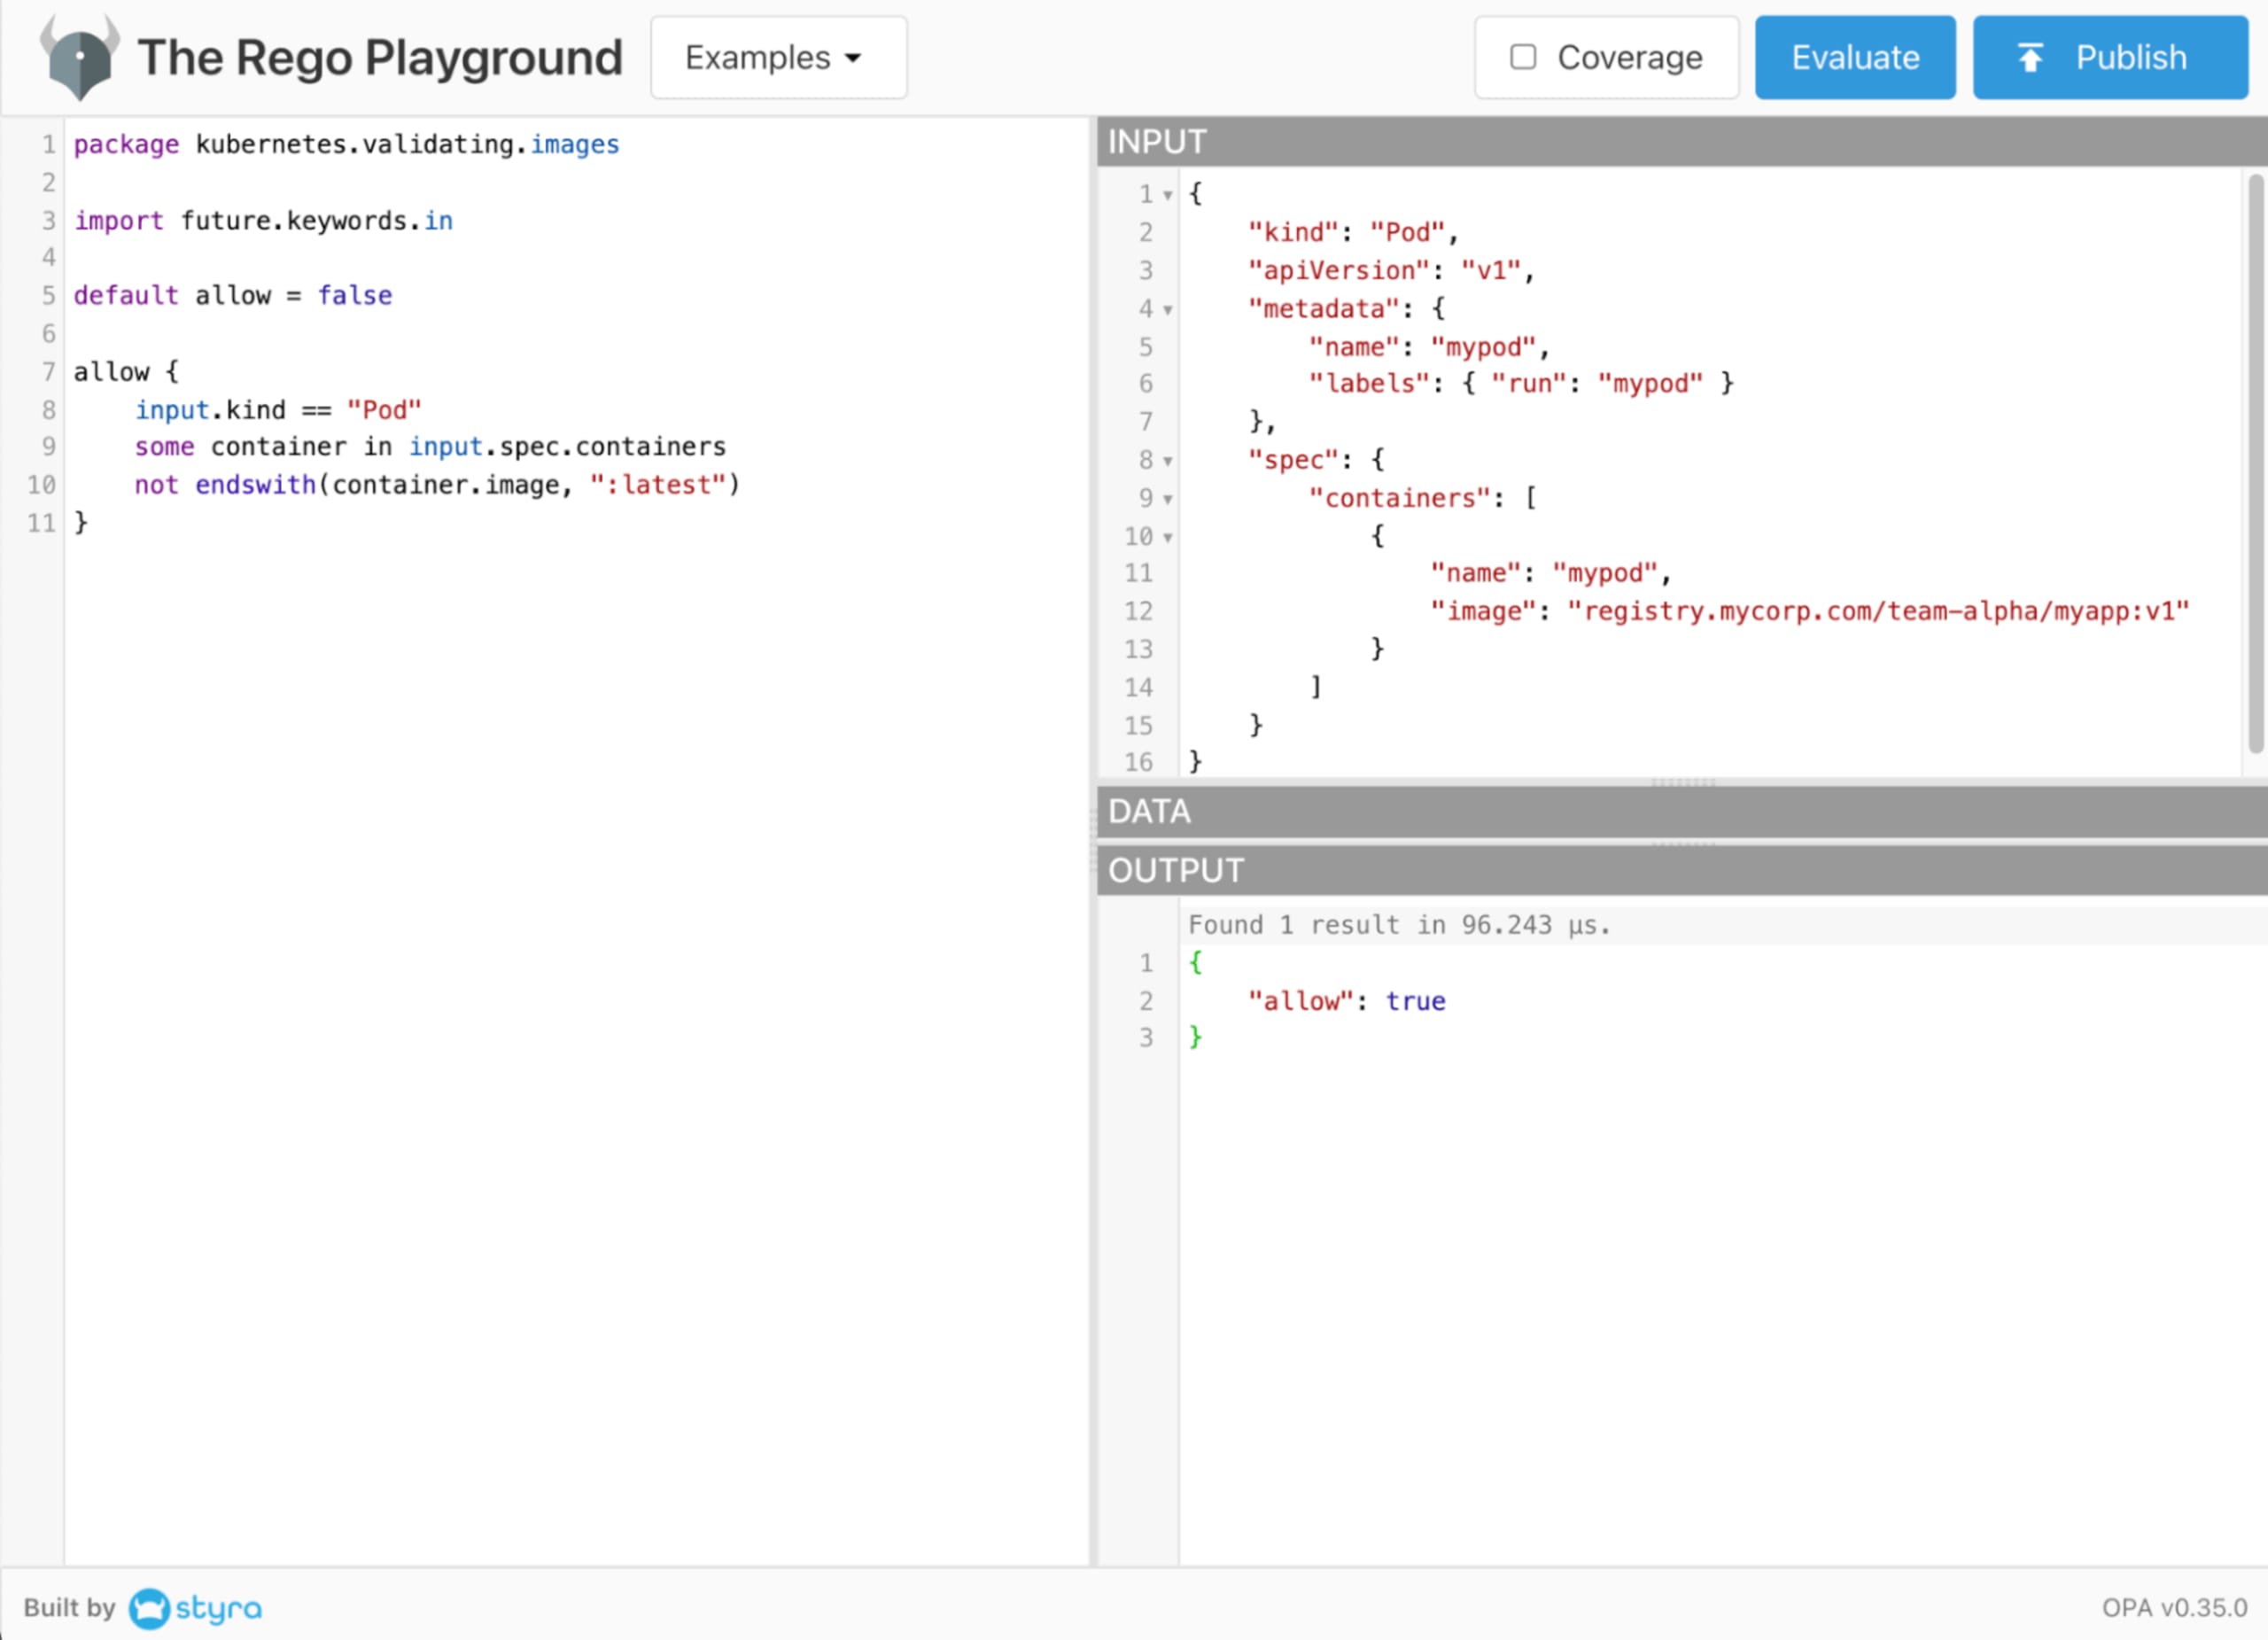
Le code Rego et le document d’entrée ci-dessus sont disponibles dans cet exemple Rego Playground. Ouvrez-le dans un autre onglet, exécutez-le et amusez-vous à le modifier.
Écrire des politiques personnalisées avec Snyk IaC et Rego
Snyk Infrastructure as Code (Snyk IaC) s’appuie sur OPA pour analyser les politiques. Vous pouvez ajouter vos propres politiques à vos analyses à l’aide de quelques commandes simples. Consultez la documentation de Snyk IaC ainsi que notre article Développer des règles IaC personnalisées avec Snyk, pour vous lancer.
En créant un compte Snyk gratuit, vous pouvez identifier et corriger les erreurs de configuration IaC en intégrant facilement à vos workflows des contrôles de sécurité, des garde-fous de politique et des conseils de correction adaptés aux développeurs.
Sécurisez votre infrastructure dès la source
Snyk automatise la sécurité et la conformité de l’IaC dans vos workflows, et détecte les ressources dont la configuration a dérivé ou qui sont manquantes.
Pour en savoir plus
Vous avez maintenant une compréhension générale d’OPA et de Rego, ainsi que de certaines de leurs utilisations. Je vous invite à découvrir les nombreuses façons de les exploiter dans vos logiciels :
Apprenez Rego grâce à l’excellent parcours de formation de Styra.
Utilisez The Rego Playground pour tester et créer vos règles.
Installez OPA Gatekeeper pour contribuer à sécuriser vos clusters Kubernetes.
Personnalisez les politiques d’analyse Snyk IaC pour intégrer la sécurité plus tôt dans vos pipelines SDLC et détecter les violations avant leur mise en production.
Merci d’avoir lu cet article. Amusez-vous bien à automatiser l’application des politiques !