Comment des fonctions asynchrones Node.js, même rapides, peuvent bloquer la boucle événementielle

Michael Gokhman
4 février 2019
0 minutes de lectureUne application Node.js classique est essentiellement constituée de fonctions de rappel exécutées en réaction à différents événements : connexion entrante, fin d’une opération d’E/S, expiration d’un délai, résolution d’une Promise, etc. Un seul thread principal (la boucle événementielle) exécute toutes ces fonctions de rappel. Elles doivent donc s’exécuter rapidement, car toutes les autres fonctions en attente doivent patienter jusqu’à leur tour. Cette limitation bien connue de Node est difficile à gérer et est également très bien expliquée dans la documentation.
Je suis récemment tombé sur un véritable cas de blocage de la boucle événementielle chez Snyk. En essayant de résoudre le problème, j’ai compris que je connaissais en réalité très peu le fonctionnement de la boucle événementielle. J’ai aussi fait quelques découvertes qui m’ont d’abord surpris, ainsi que certains développeurs avec qui j’en ai parlé. Je pense qu’il est important que le plus grand nombre possible de développeurs Node disposent de ces connaissances. C’est ce qui m’a conduit à écrire cet article.
Il existe déjà beaucoup d’informations utiles sur la boucle événementielle de Node.js, mais il m’a fallu du temps pour trouver les réponses aux questions précises que je me posais. Je vais faire de mon mieux pour partager ces différentes questions et les réponses que j’ai trouvées dans plusieurs articles excellents, ainsi qu’au fil d’expérimentations et de recherches plutôt amusantes.
Commençons par bloquer la boucle événementielle de Node.js !
Remarque :
Les exemples ci-dessous utilisent Node 10.9.0 sur une machine virtuelle Ubuntu 18.04 à 4 cœurs, exécutée sur un MacBook Pro 2017
Vous pouvez tester le code ci-dessous en clonant https://github.com/michael-go/node-async-block
Commençons par un serveur Express simple :
Ajoutons maintenant un endpoint qui bloque la boucle événementielle :
On s’attend donc à ce que, pendant l’exécution de l’endpoint /compute-sync, les requêtes vers /healthcheck restent bloquées. Nous pouvons tester /healthcheck avec cette commande bash en une ligne :
Cette commande interrogera l’endpoint /healthcheck chaque seconde et expirera si elle ne reçoit aucune réponse au bout de 5 secondes.
Essayons :
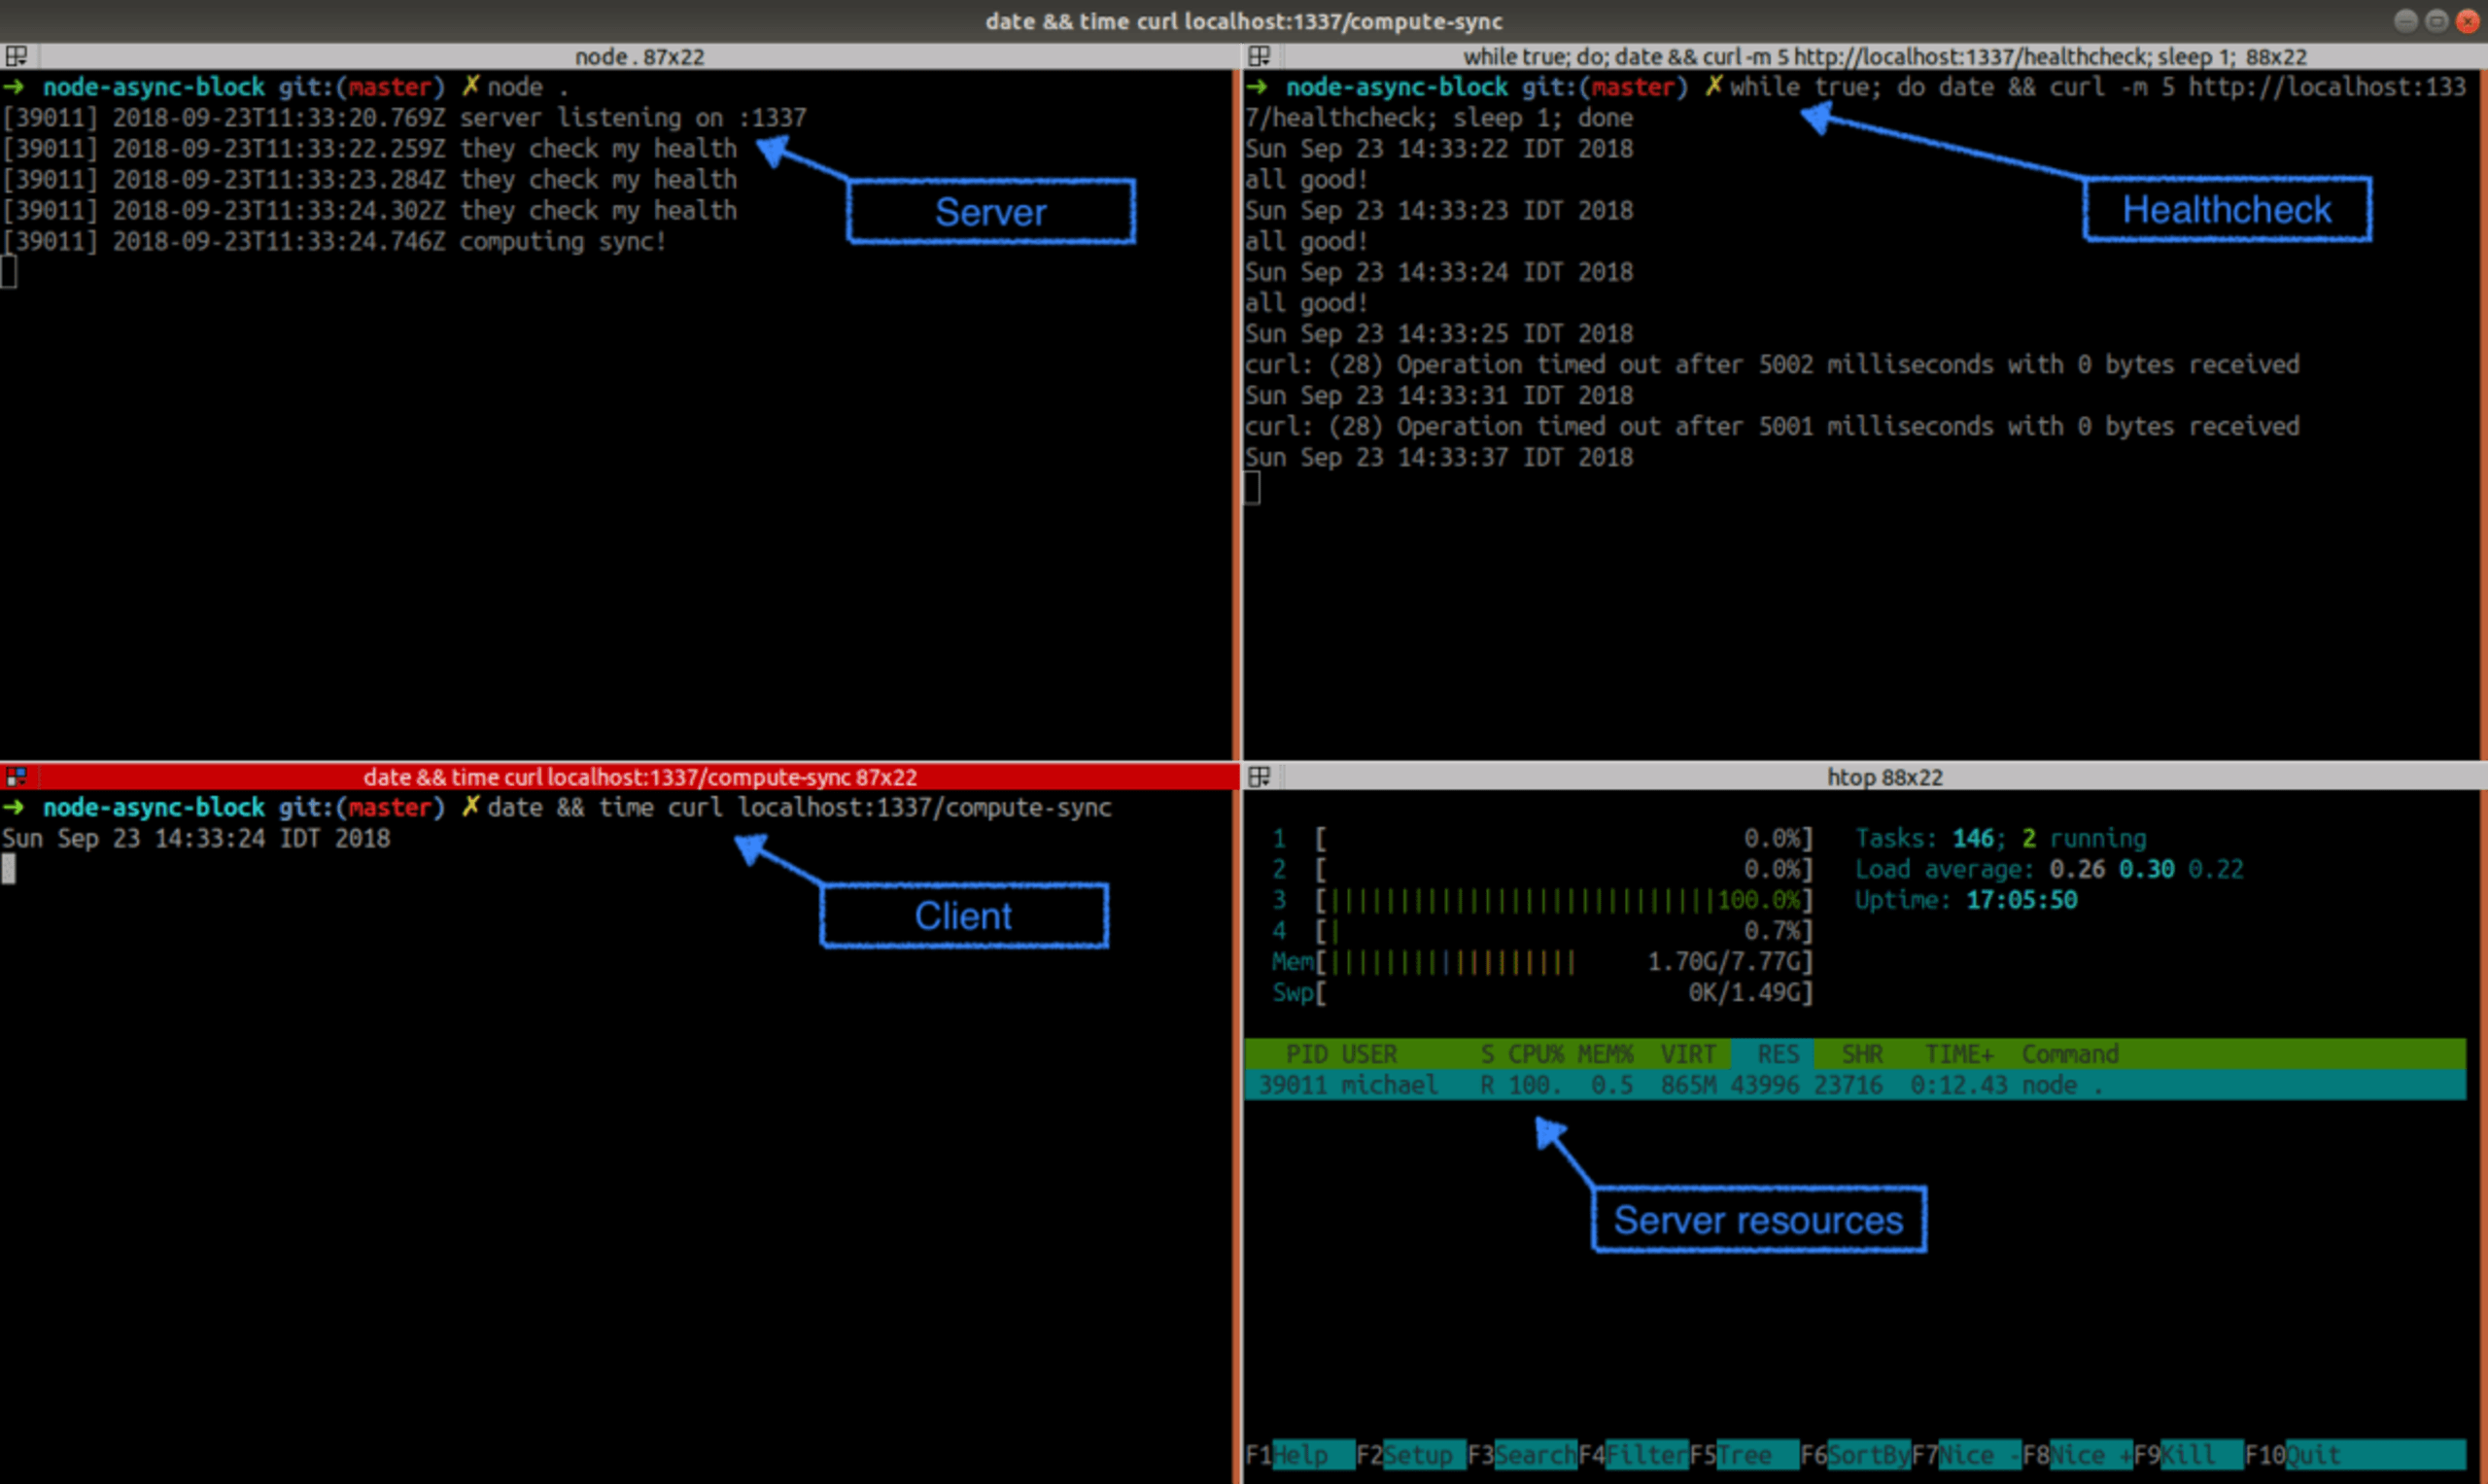
Dès que nous avons appelé l’endpoint /compute-sync, les vérifications de l’état de santé ont commencé à expirer et aucune n’a abouti. Notez que le processus node tourne à plein régime, avec une utilisation du processeur proche de 100 %.
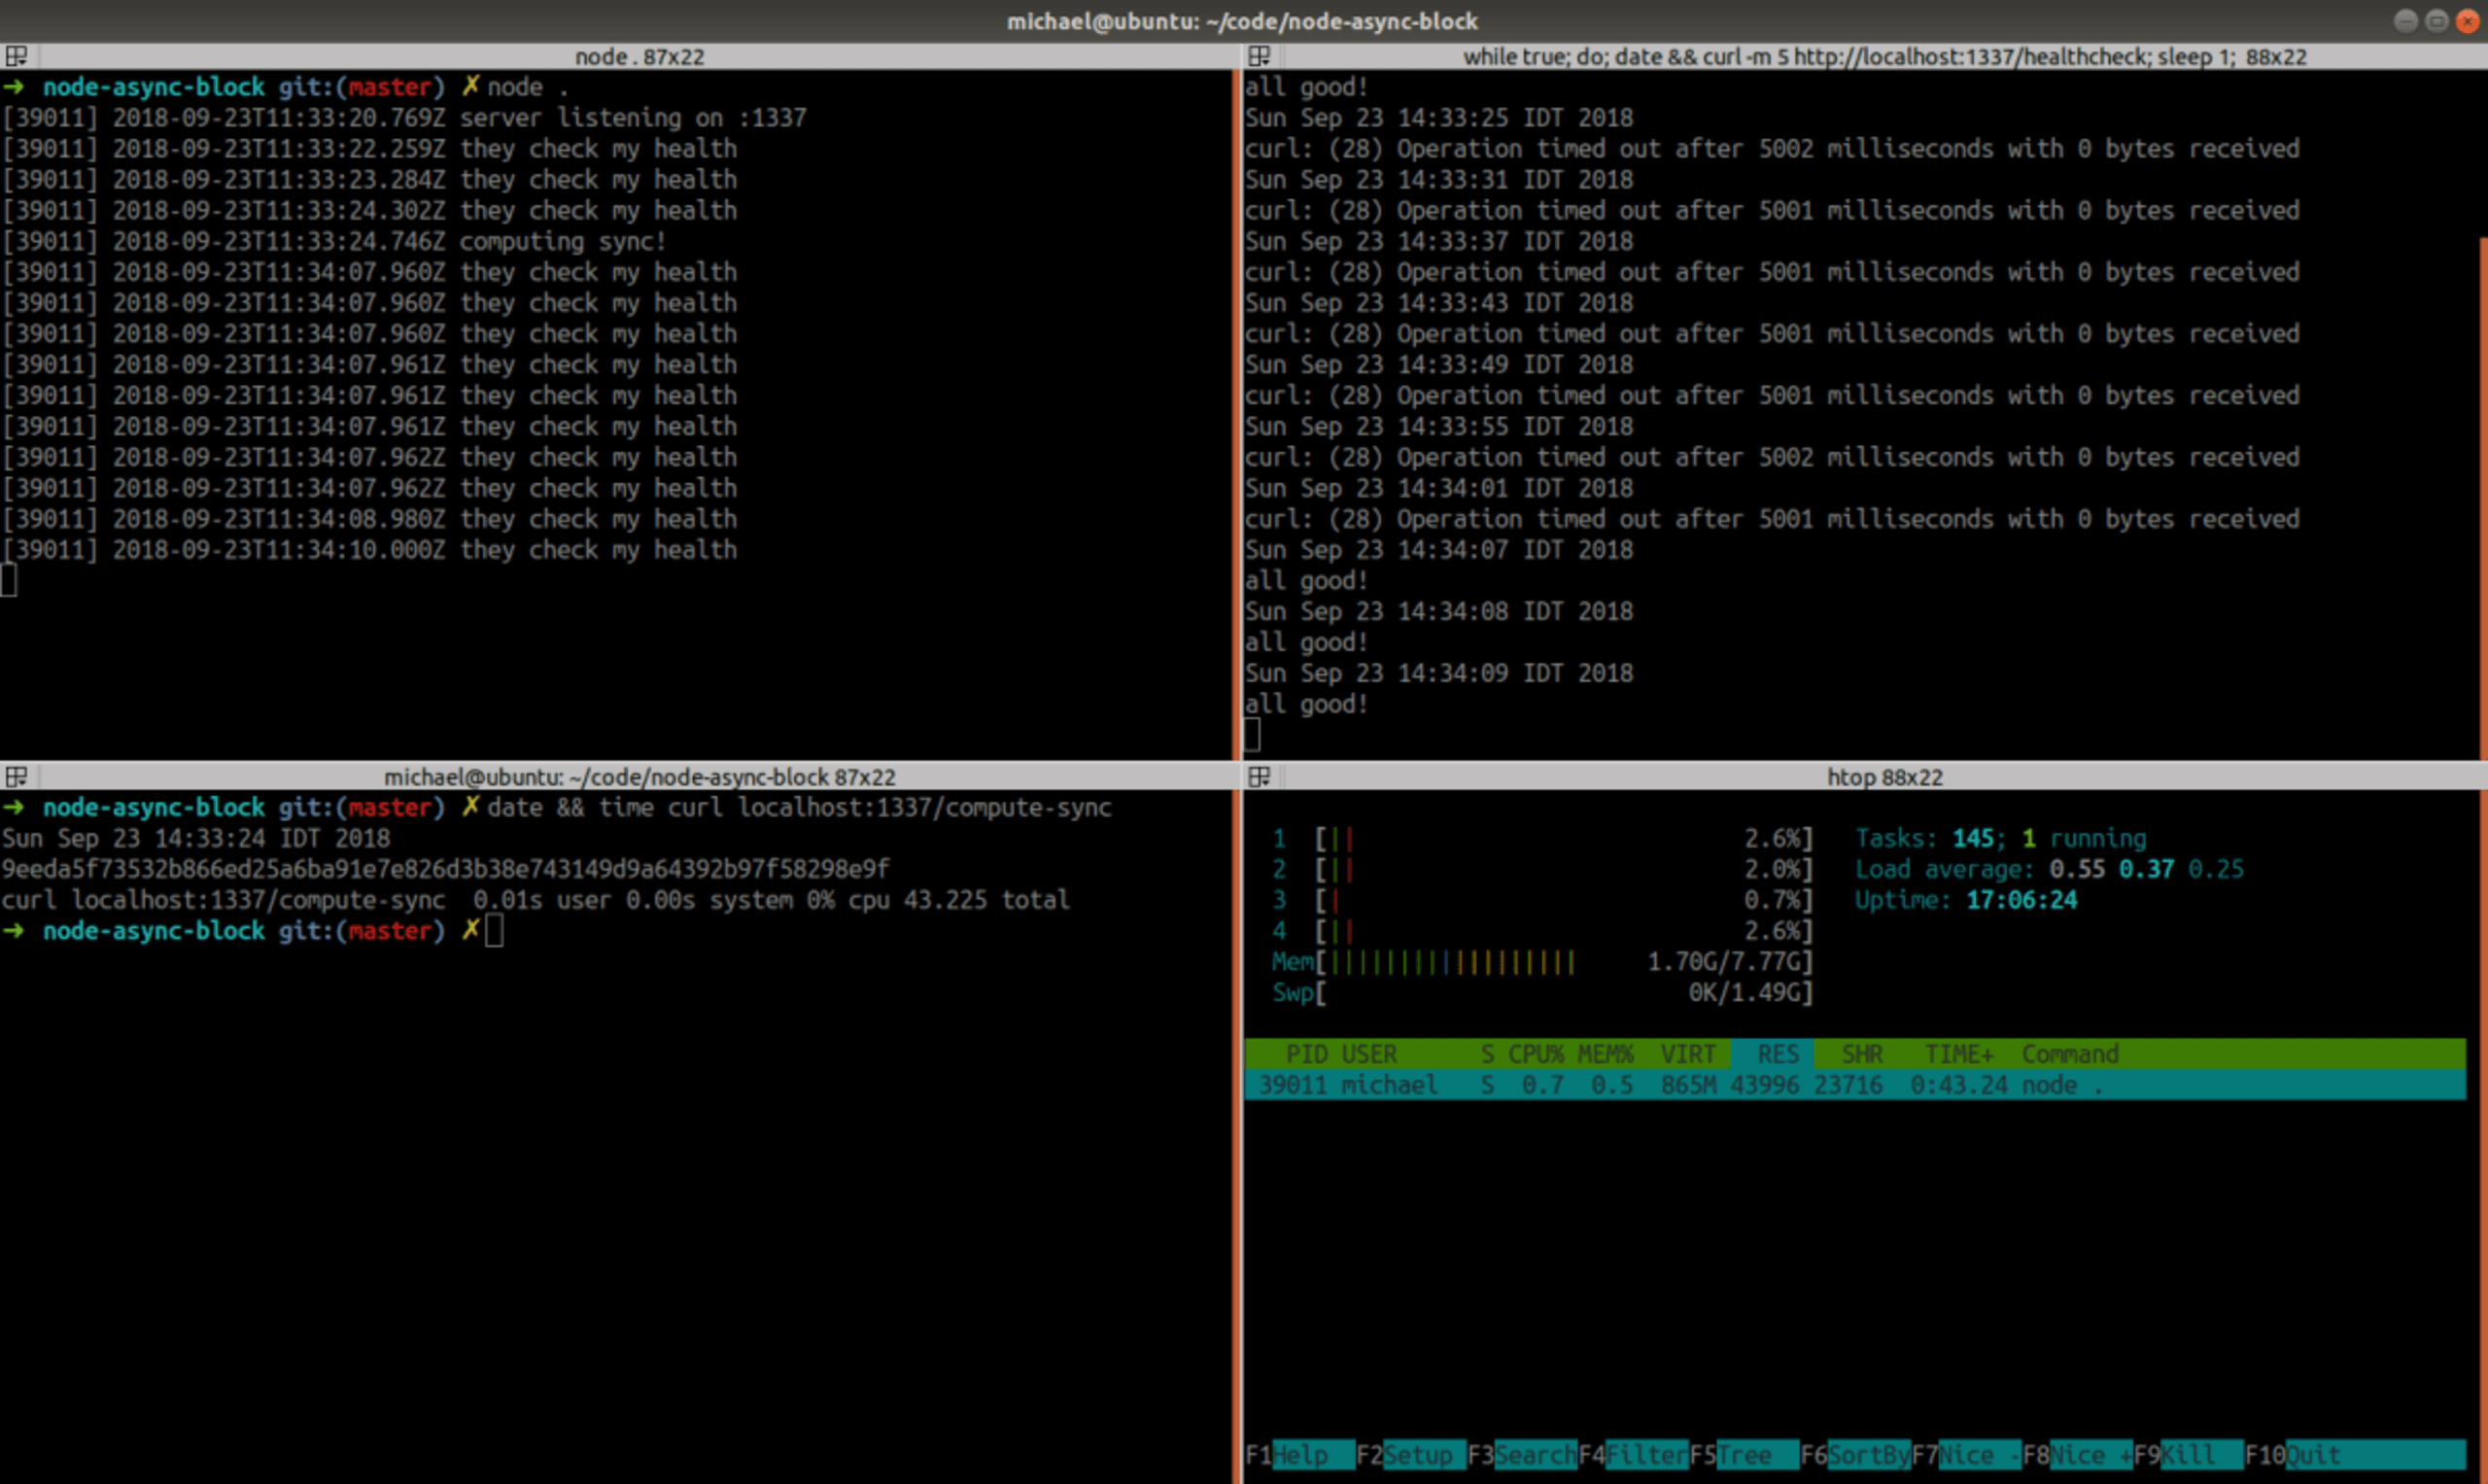
Au bout de 43,2 secondes, le calcul est terminé, les 8 requêtes /healthcheck en attente aboutissent et le serveur répond de nouveau.
La situation est problématique : une seule requête mal conçue bloque complètement le serveur. Compte tenu de ce que nous savons sur la « boucle événementielle à thread unique », on comprend pourquoi le code de /compute-sync bloque toutes les autres requêtes : tant qu’il n’est pas terminé, il ne rend pas la main à l’ordonnanceur de la boucle événementielle. Le gestionnaire /healthcheck n’a donc aucune chance de s’exécuter.
Débloquons-la !
Ajoutons un nouvel endpoint /compute-async, où nous découperons la longue boucle bloquante en rendant la main à la boucle événementielle après chaque étape de calcul (trop de changements de contexte ? Peut-être… Nous pourrons optimiser plus tard et ne rendre la main que toutes les X itérations, mais commençons simplement) :
Essayons :
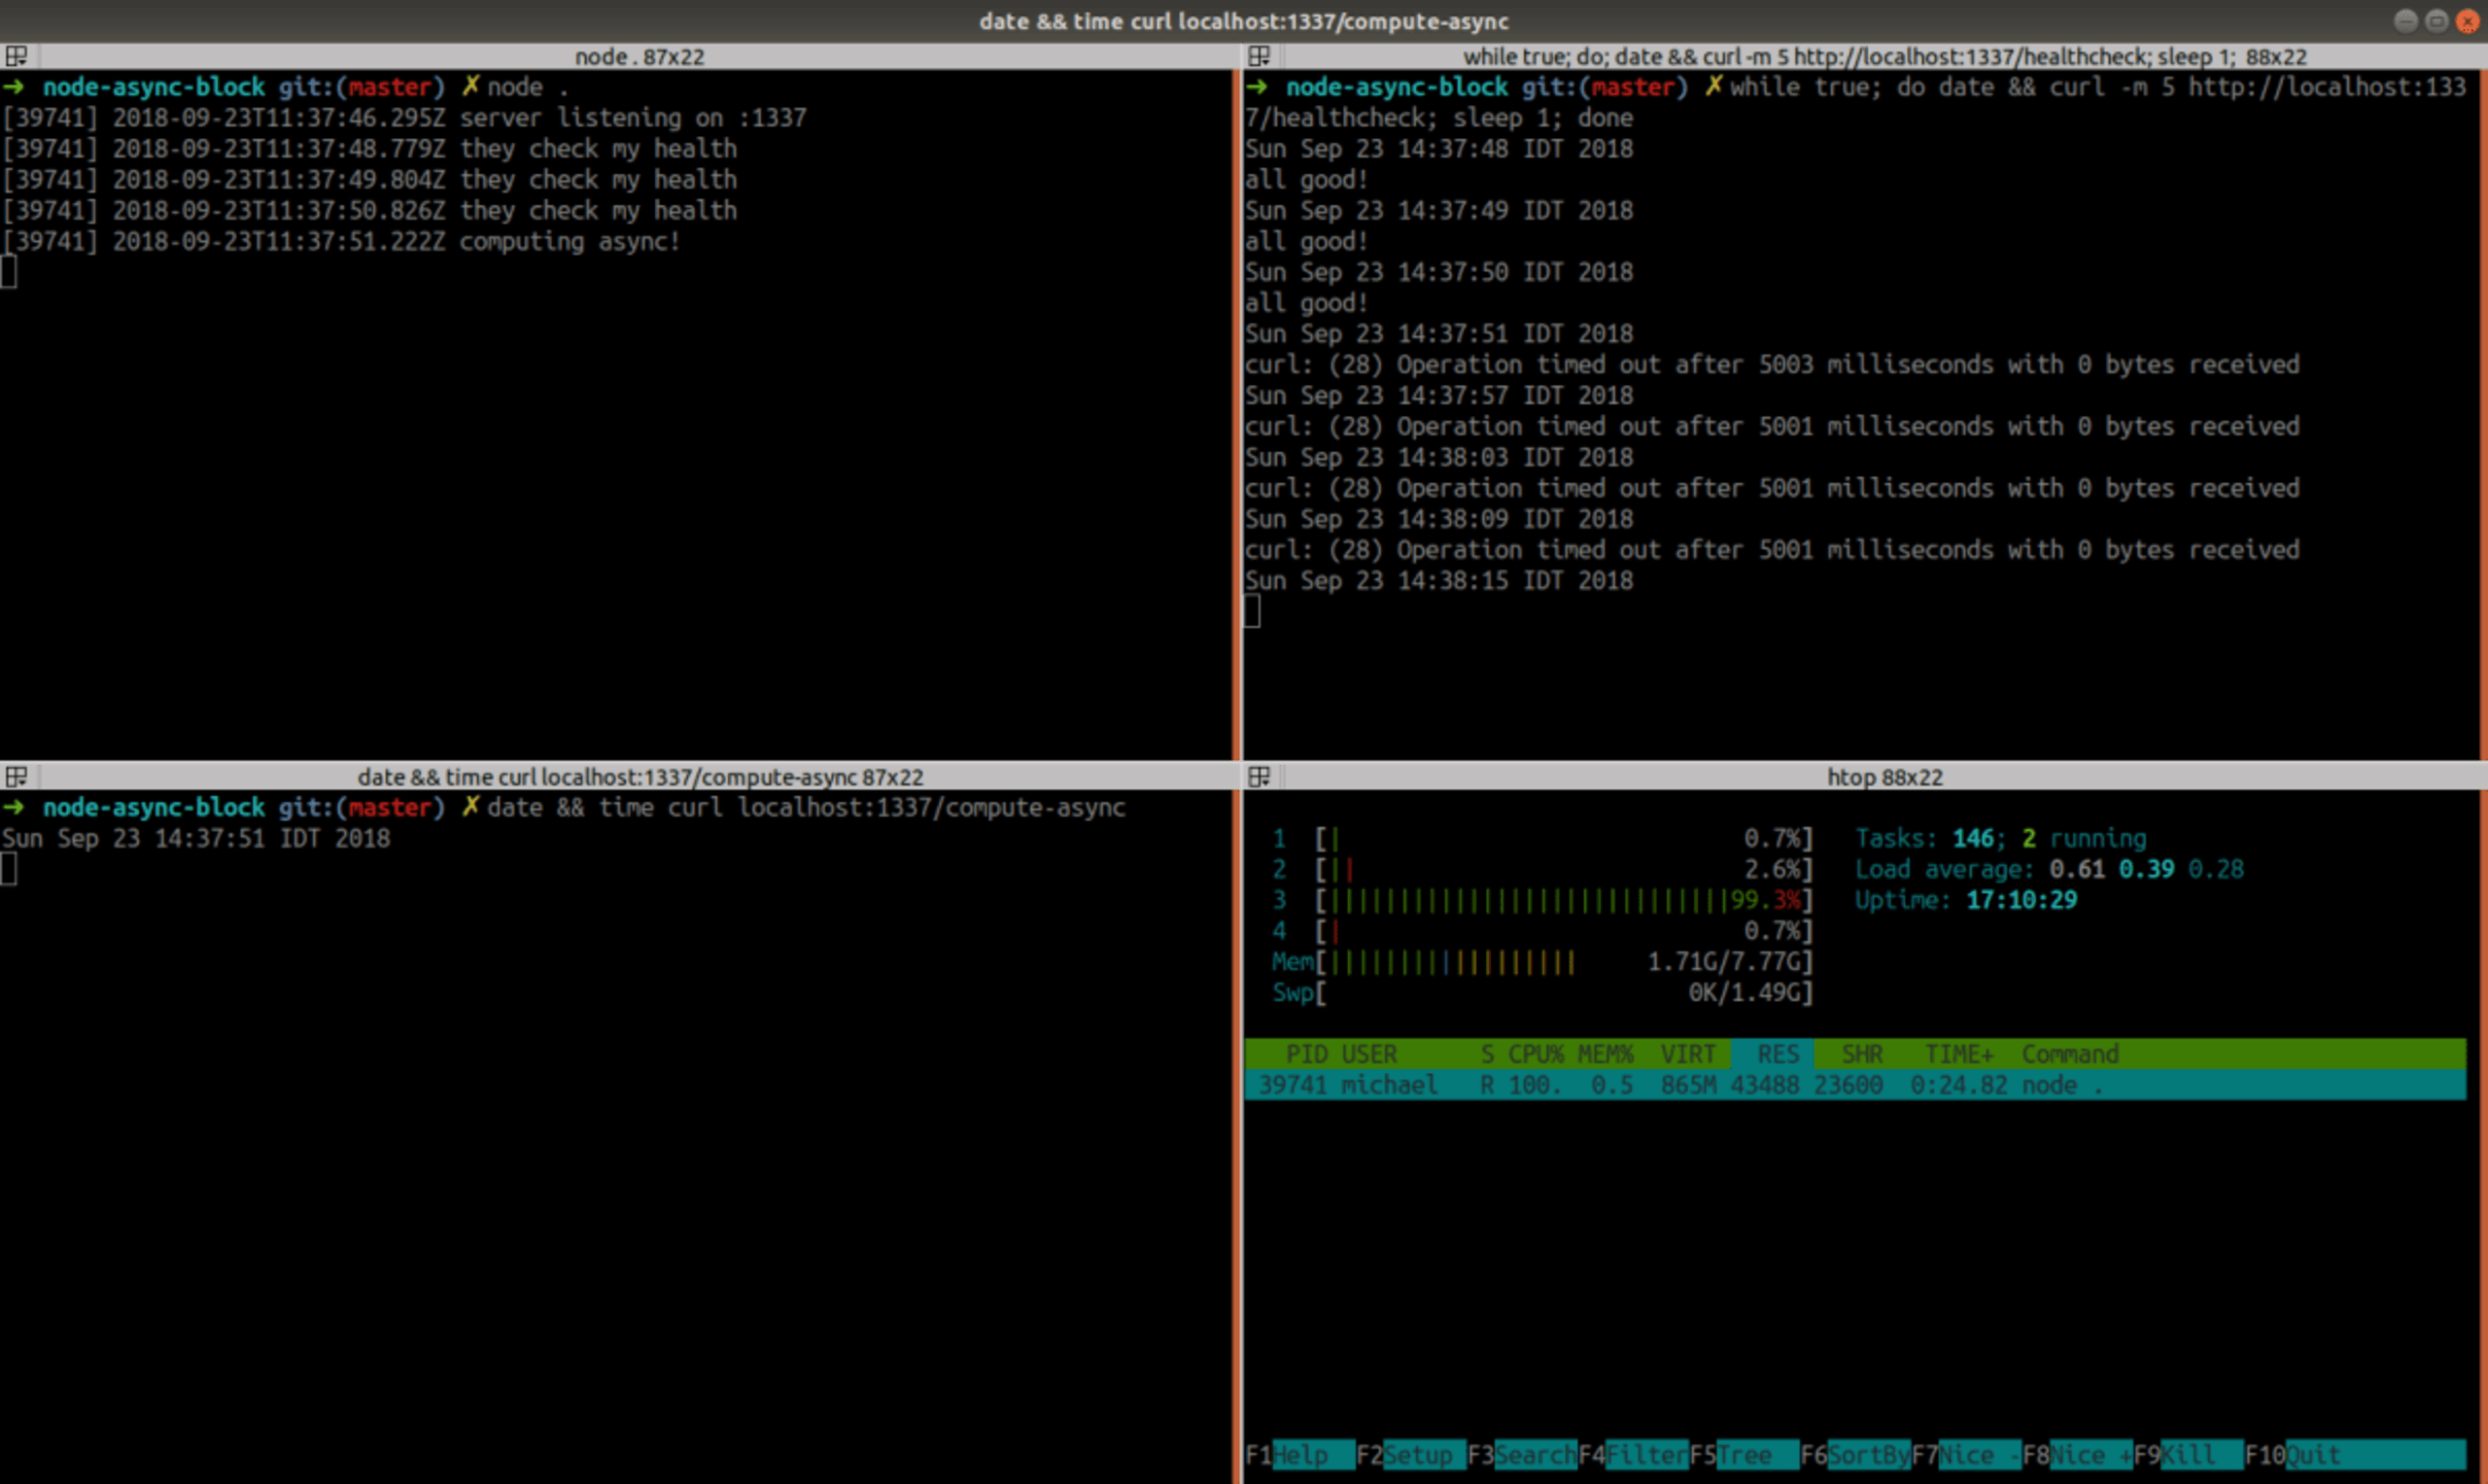
Hmm… la boucle événementielle est toujours bloquée ?
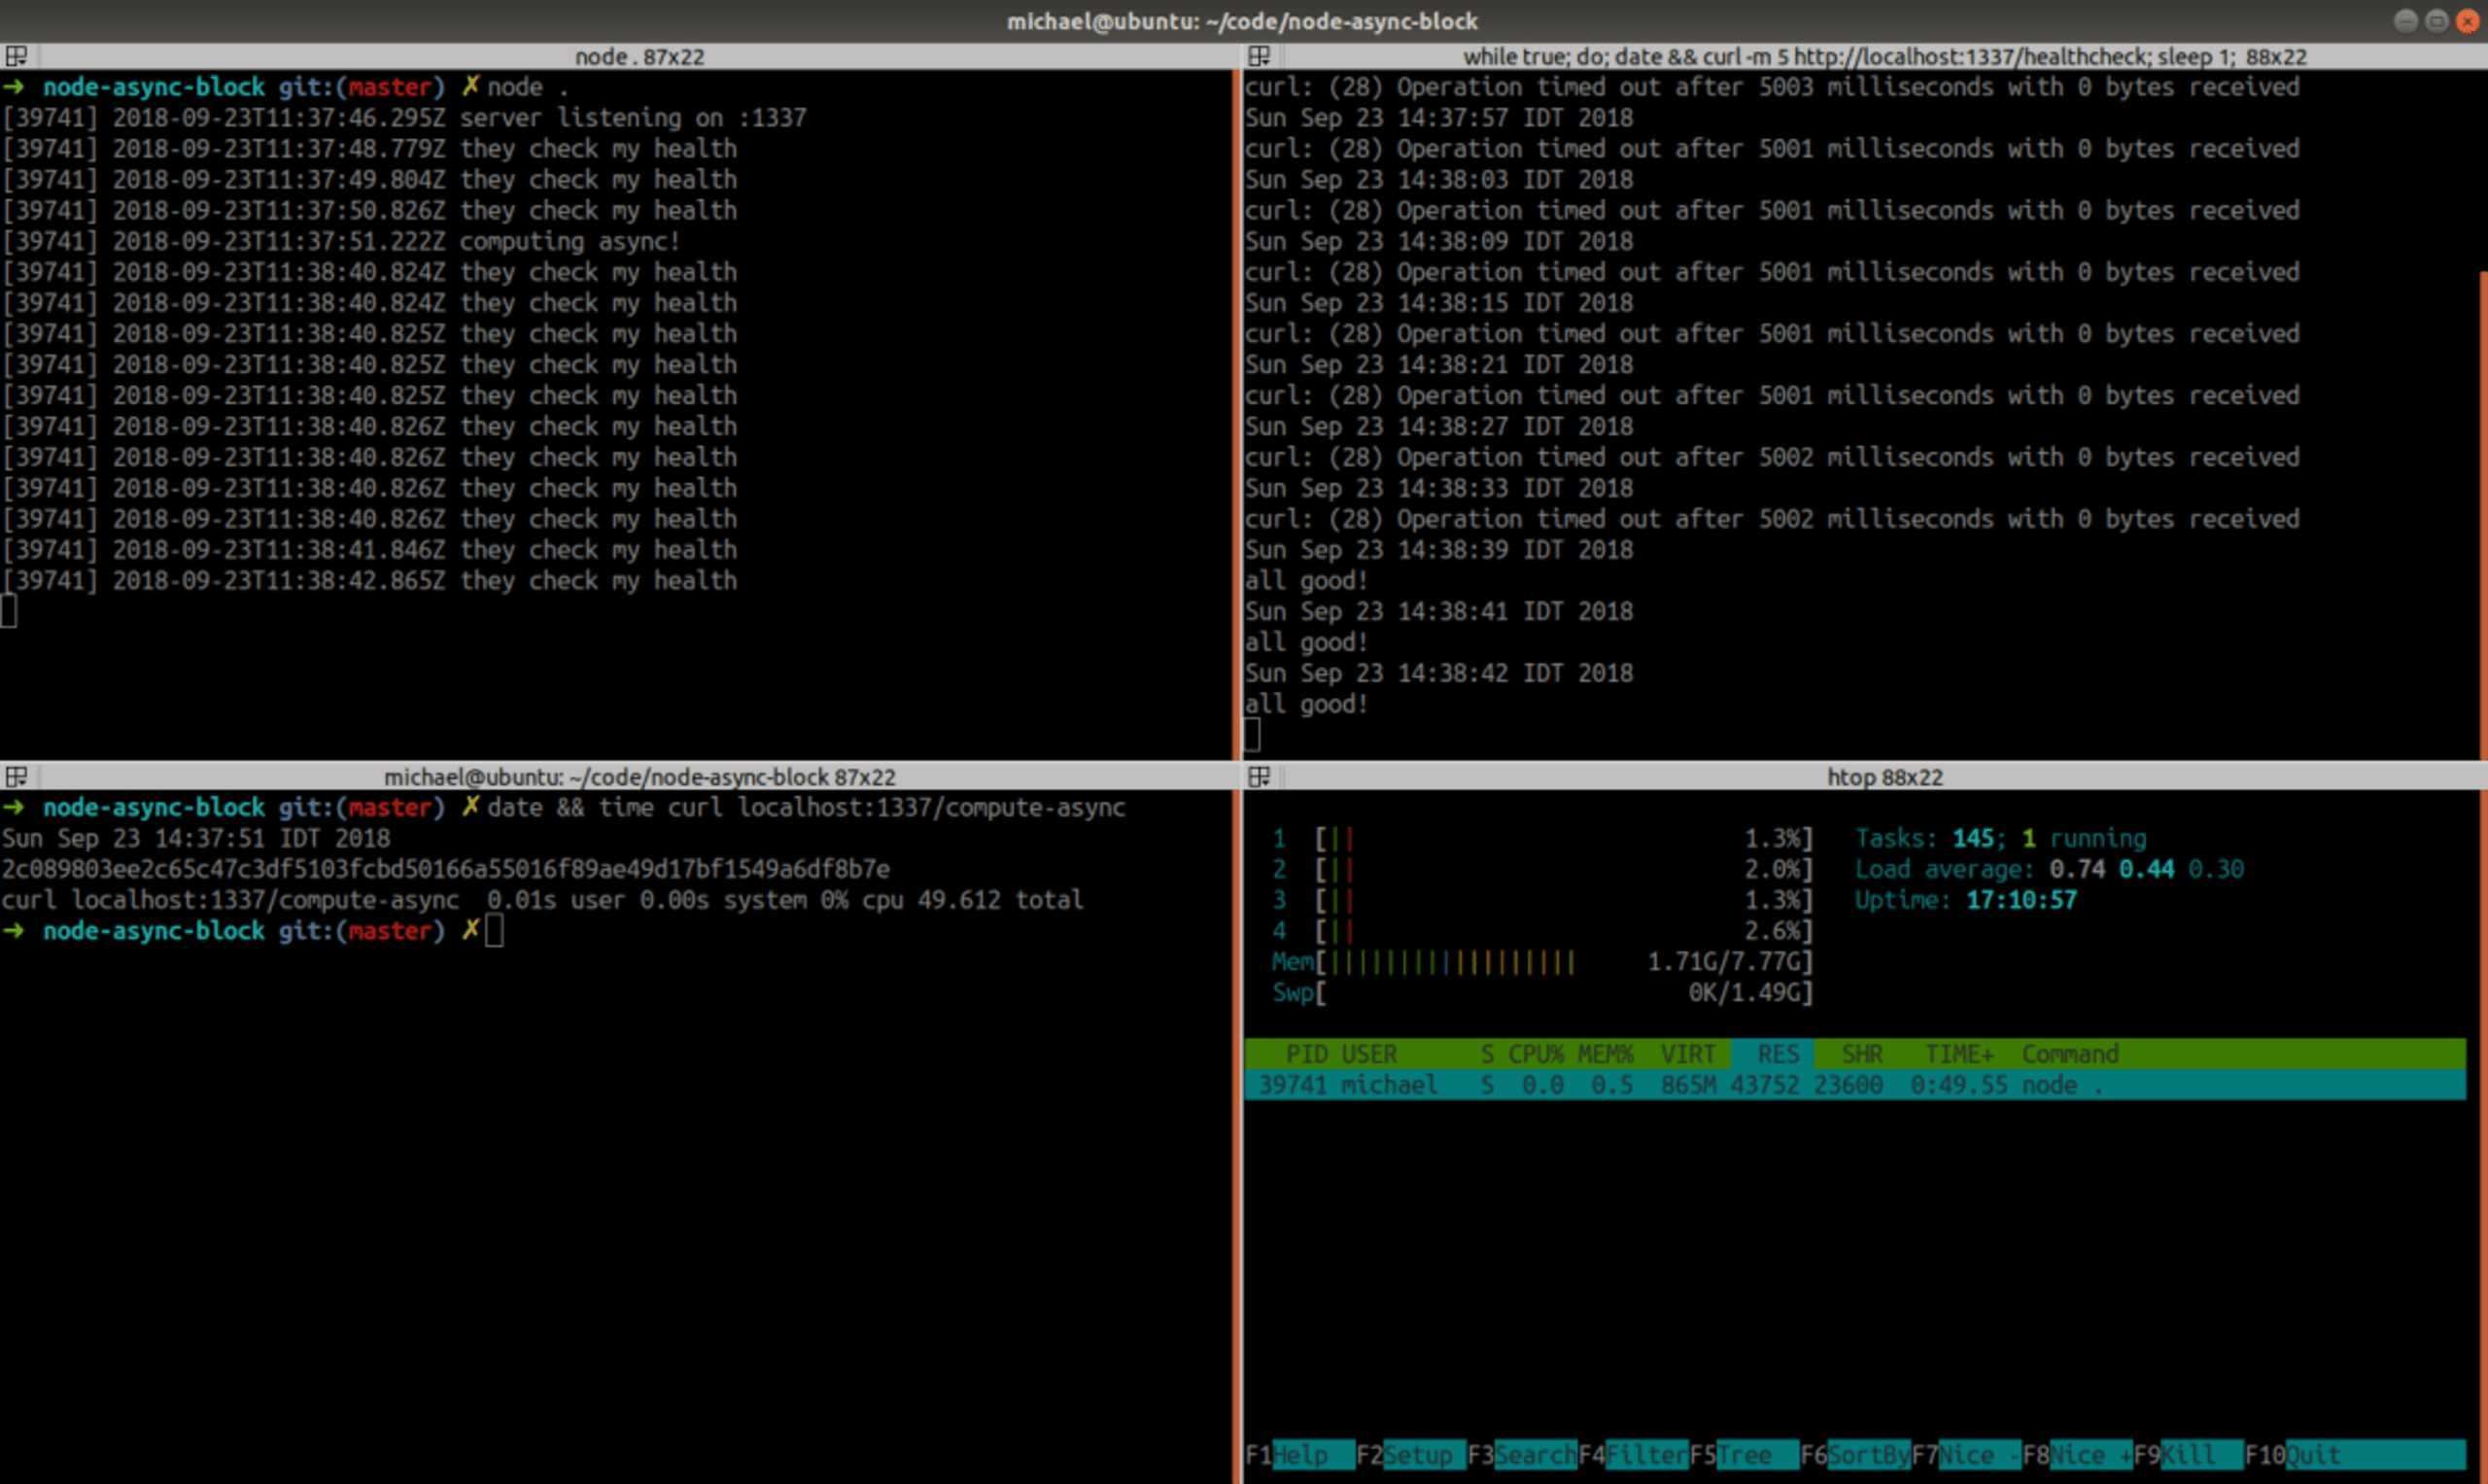
Que se passe-t-il ? Node.js optimise-t-il notre exemple simpliste utilisant async/await ? L’exécution a pris quelques secondes de plus, donc ce n’est pas le cas, semble-t-il… Les graphiques en flammes peuvent nous donner une indication sur l’efficacité réelle de async. Nous pouvons utiliser ce super projet GitHub pour générer facilement des graphiques en flammes :
Commençons par le graphique en flammes capturé pendant l’exécution de /compute-sync :
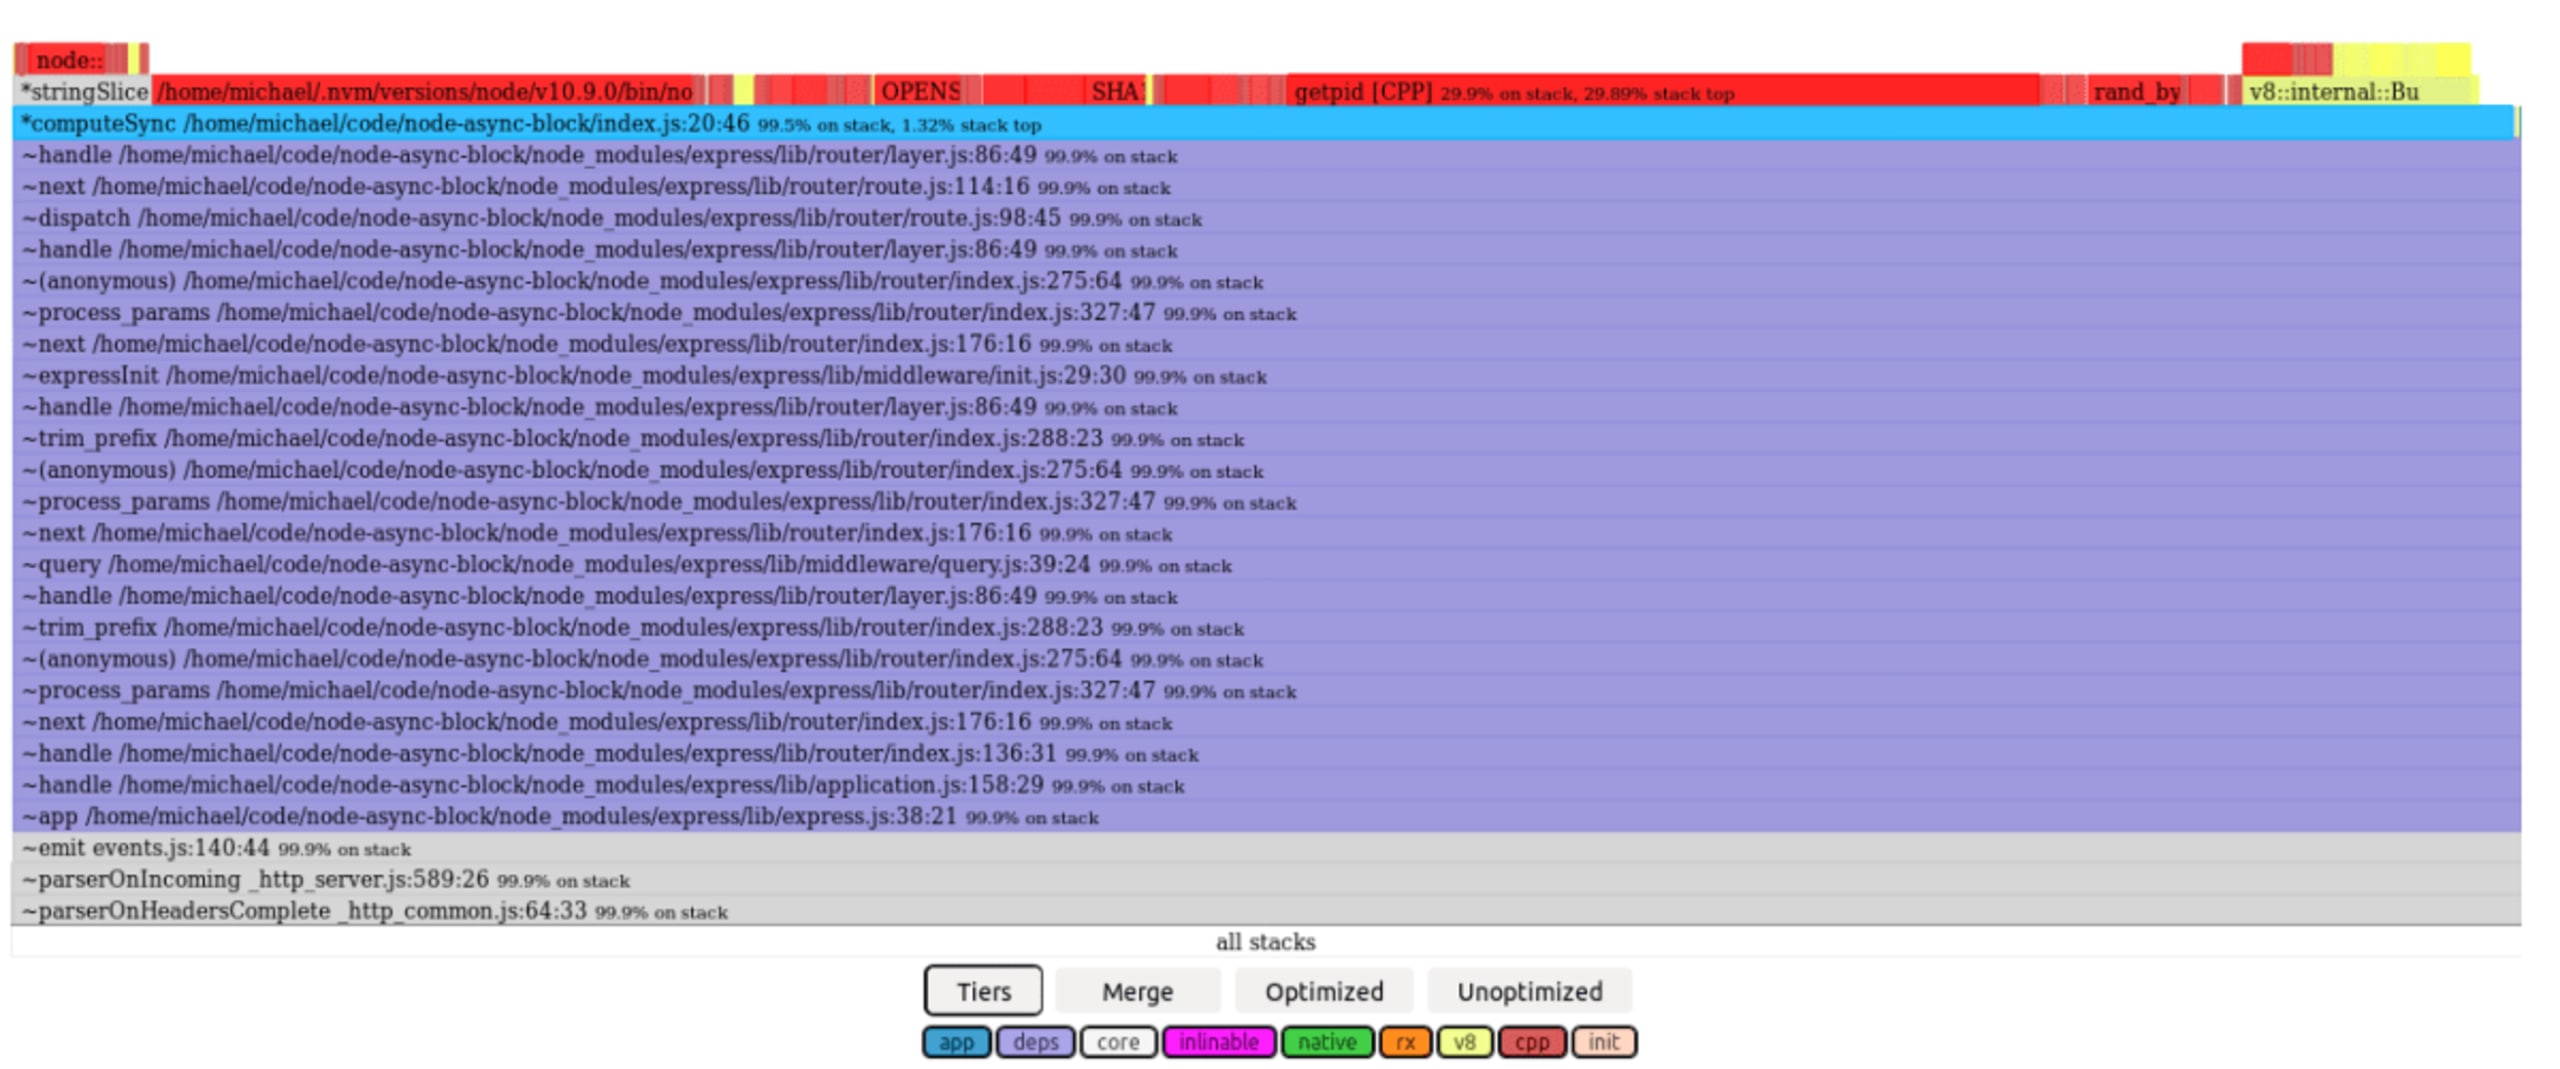
On voit que la pile de /compute-sync comprend celle du gestionnaire Express, car l’exécution était entièrement synchrone.
Voici maintenant le graphique en flammes capturé pendant l’exécution de /compute-async :
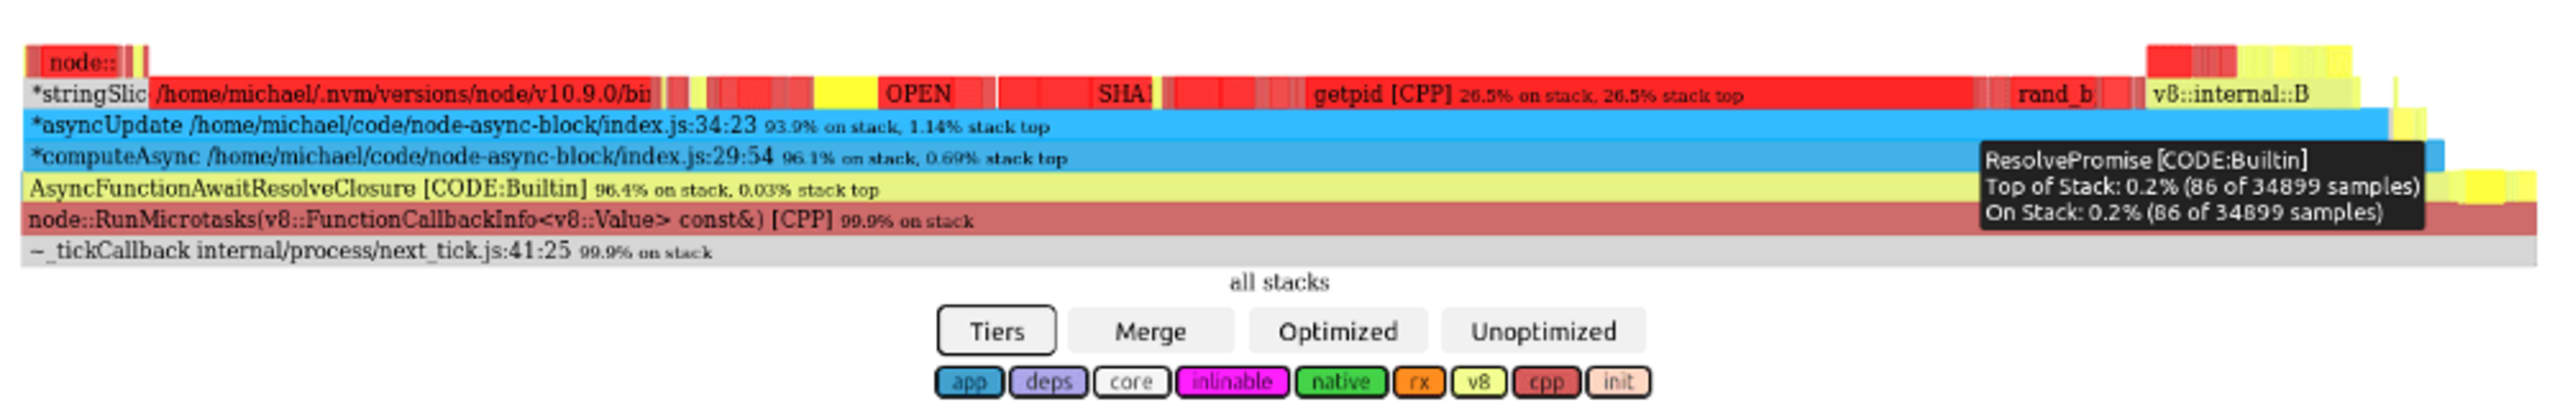
Le graphique en flammes de /compute-async est très différent : l’exécution se déroule dans le contexte des fonctions V8 RunMicrotask et AsyncFunctionAwaitResolveClosure. Donc non… async/await ne semble pas avoir été « optimisé ».
Avant d’approfondir, essayons une dernière solution désespérée, à laquelle nous, développeurs, avons parfois recours : ajouter un appel à sleep !
Lançons le test :
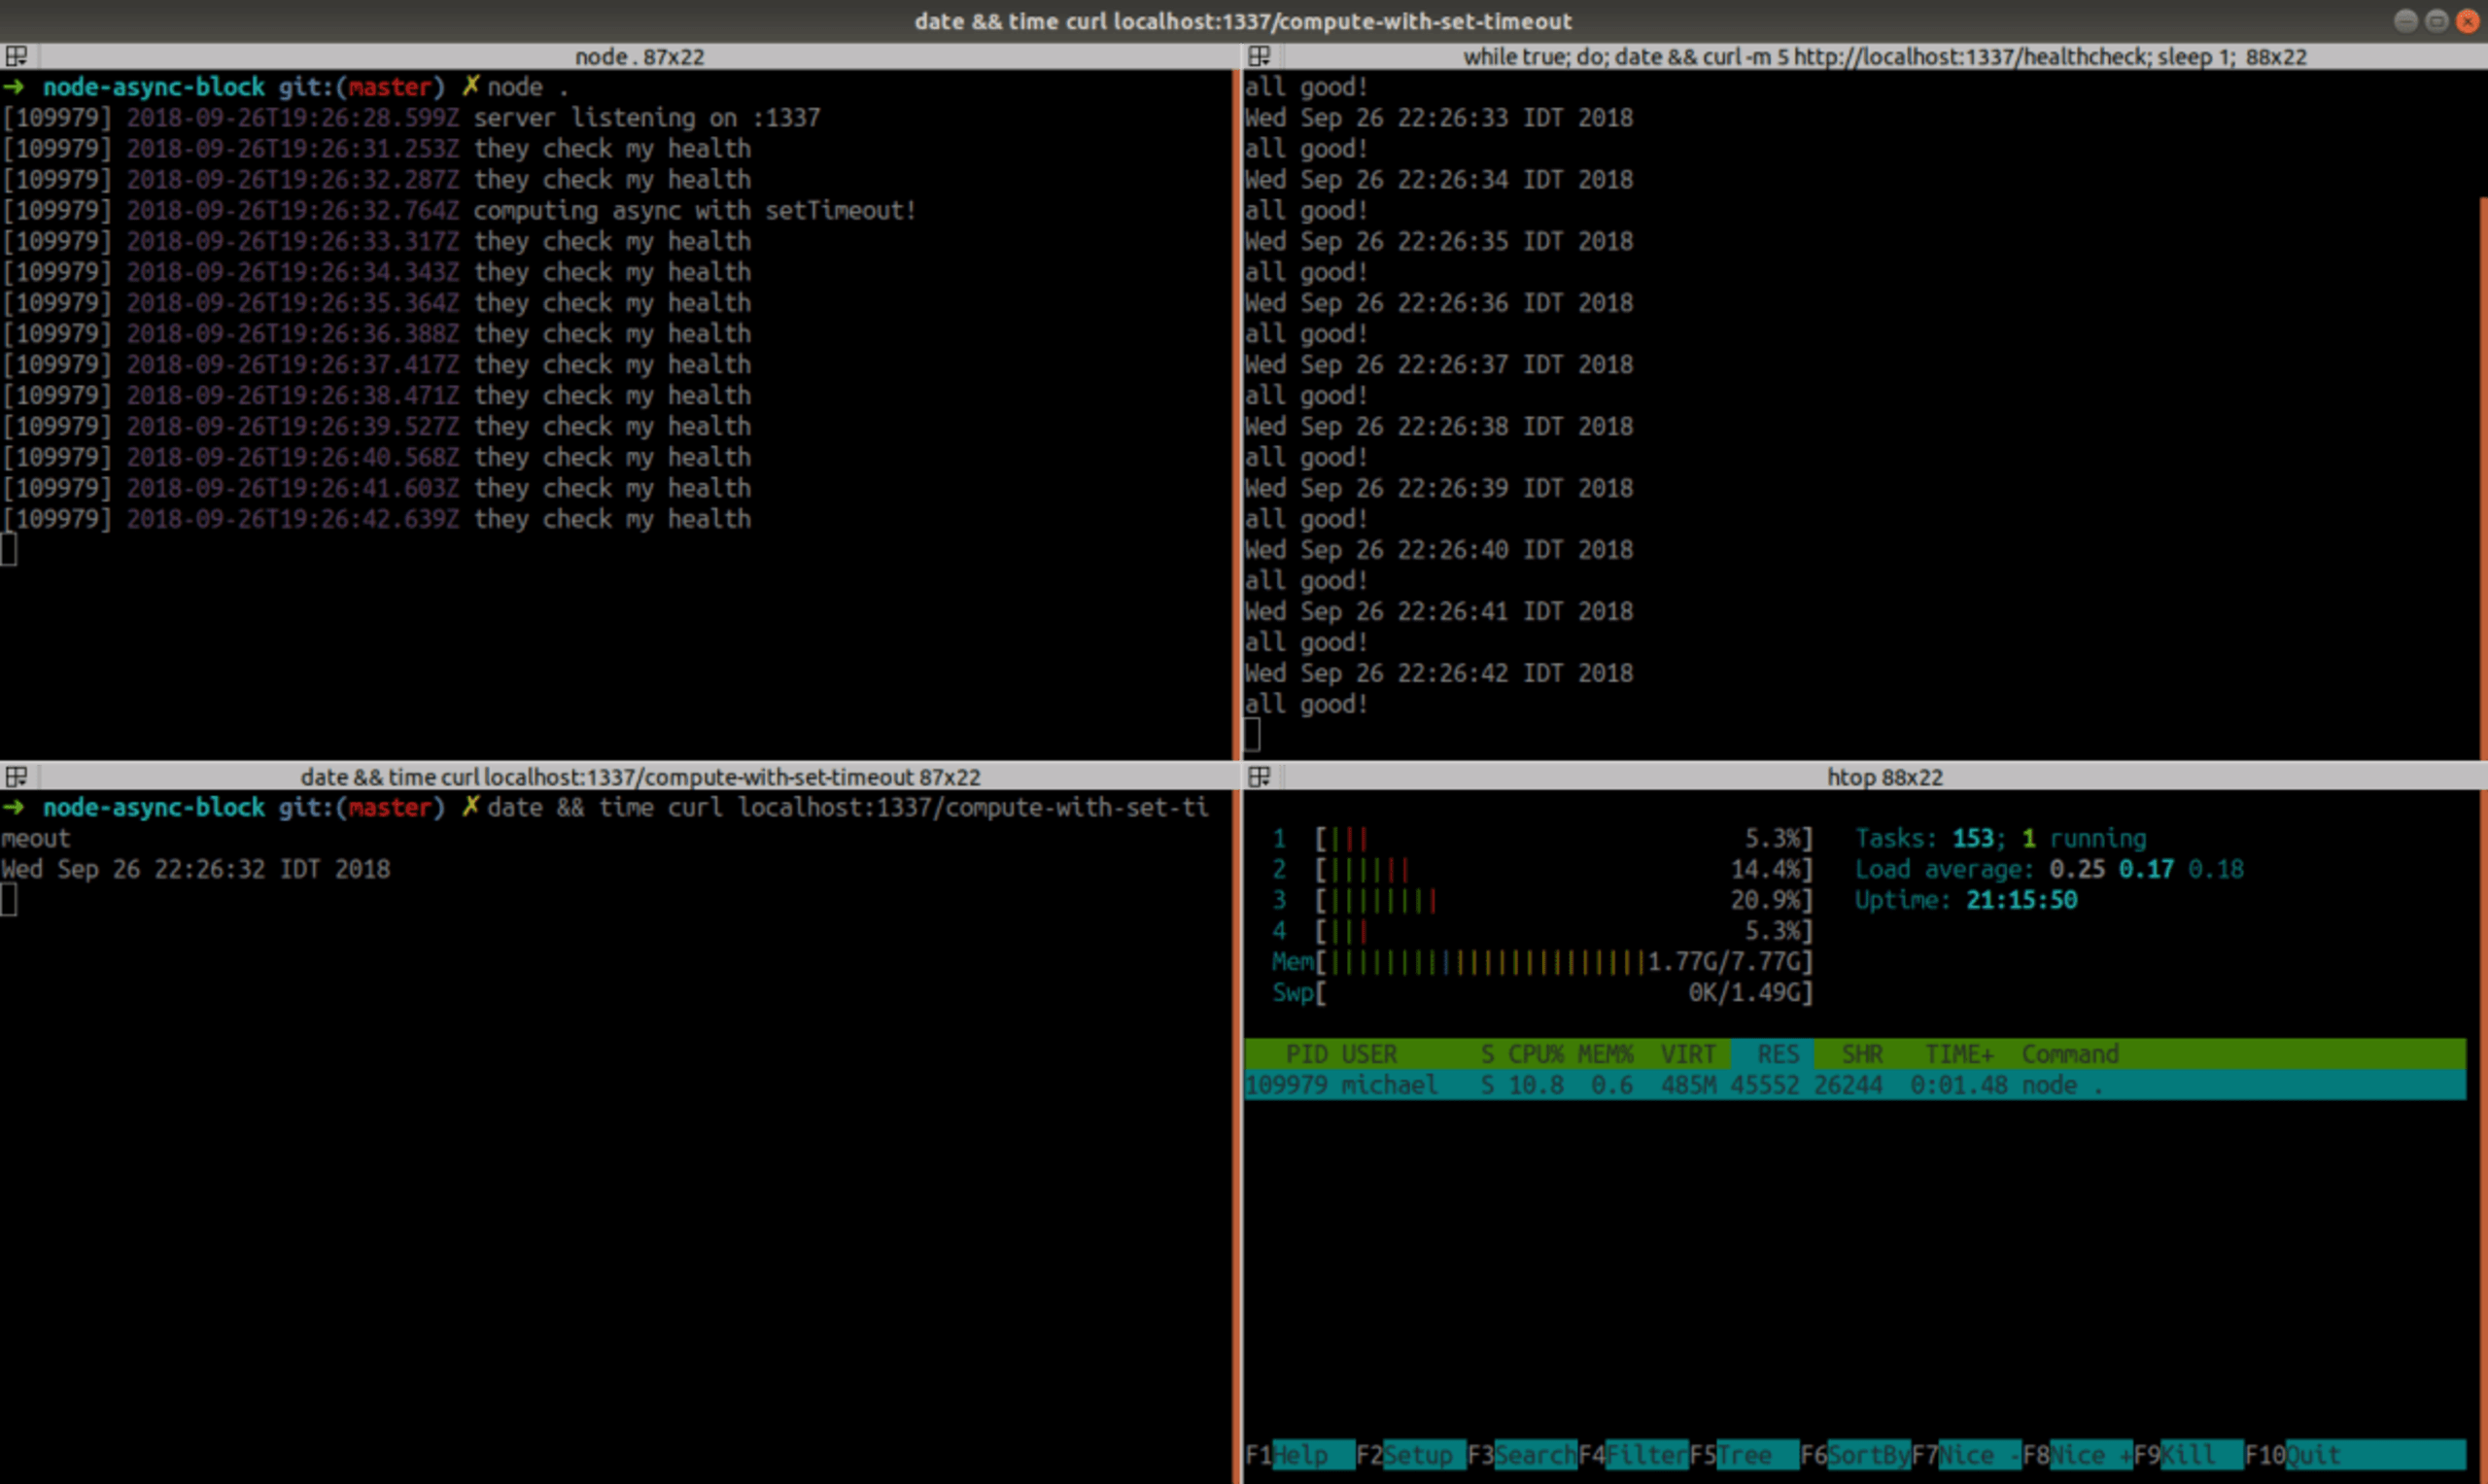
Enfin, le serveur reste réactif pendant le calcul intensif. Malheureusement, le coût de cette solution est trop élevé : le processeur n’est utilisé qu’à environ 10 %, le calcul ne semble donc pas avancer suffisamment vite et prend pratiquement une éternité (je n’ai pas eu la patience d’attendre la fin). En réduisant le nombre d’itérations de 10⁷ à 10⁵, le calcul s’est terminé au bout de 2 min 23 s ! (À titre indicatif, passer 1 au lieu de 0 comme paramètre de délai de setTimeout ne change rien ; nous y reviendrons)
Cela soulève plusieurs questions :
pourquoi le code
asyncétait-il bloqué sans l’appel àsetTimeout()?pourquoi
setTimeout()a-t-il eu un coût si important sur les performances ?comment débloquer notre calcul sans subir une telle pénalité ?
Les phases de la boucle événementielle
Quand une situation similaire m’est arrivée, je me suis tourné vers Google. En cherchant des expressions comme « node async block event loop », l’un des premiers résultats renvoyait vers cette page officielle de Node.js. Elle m’a vraiment ouvert les yeux.
Elle explique que la boucle événementielle n’est pas l’ordonnanceur magique que je l’imaginais, mais une boucle assez simple composée de plusieurs phases. Voici un joli schéma ASCII des principales phases, repris du guide :
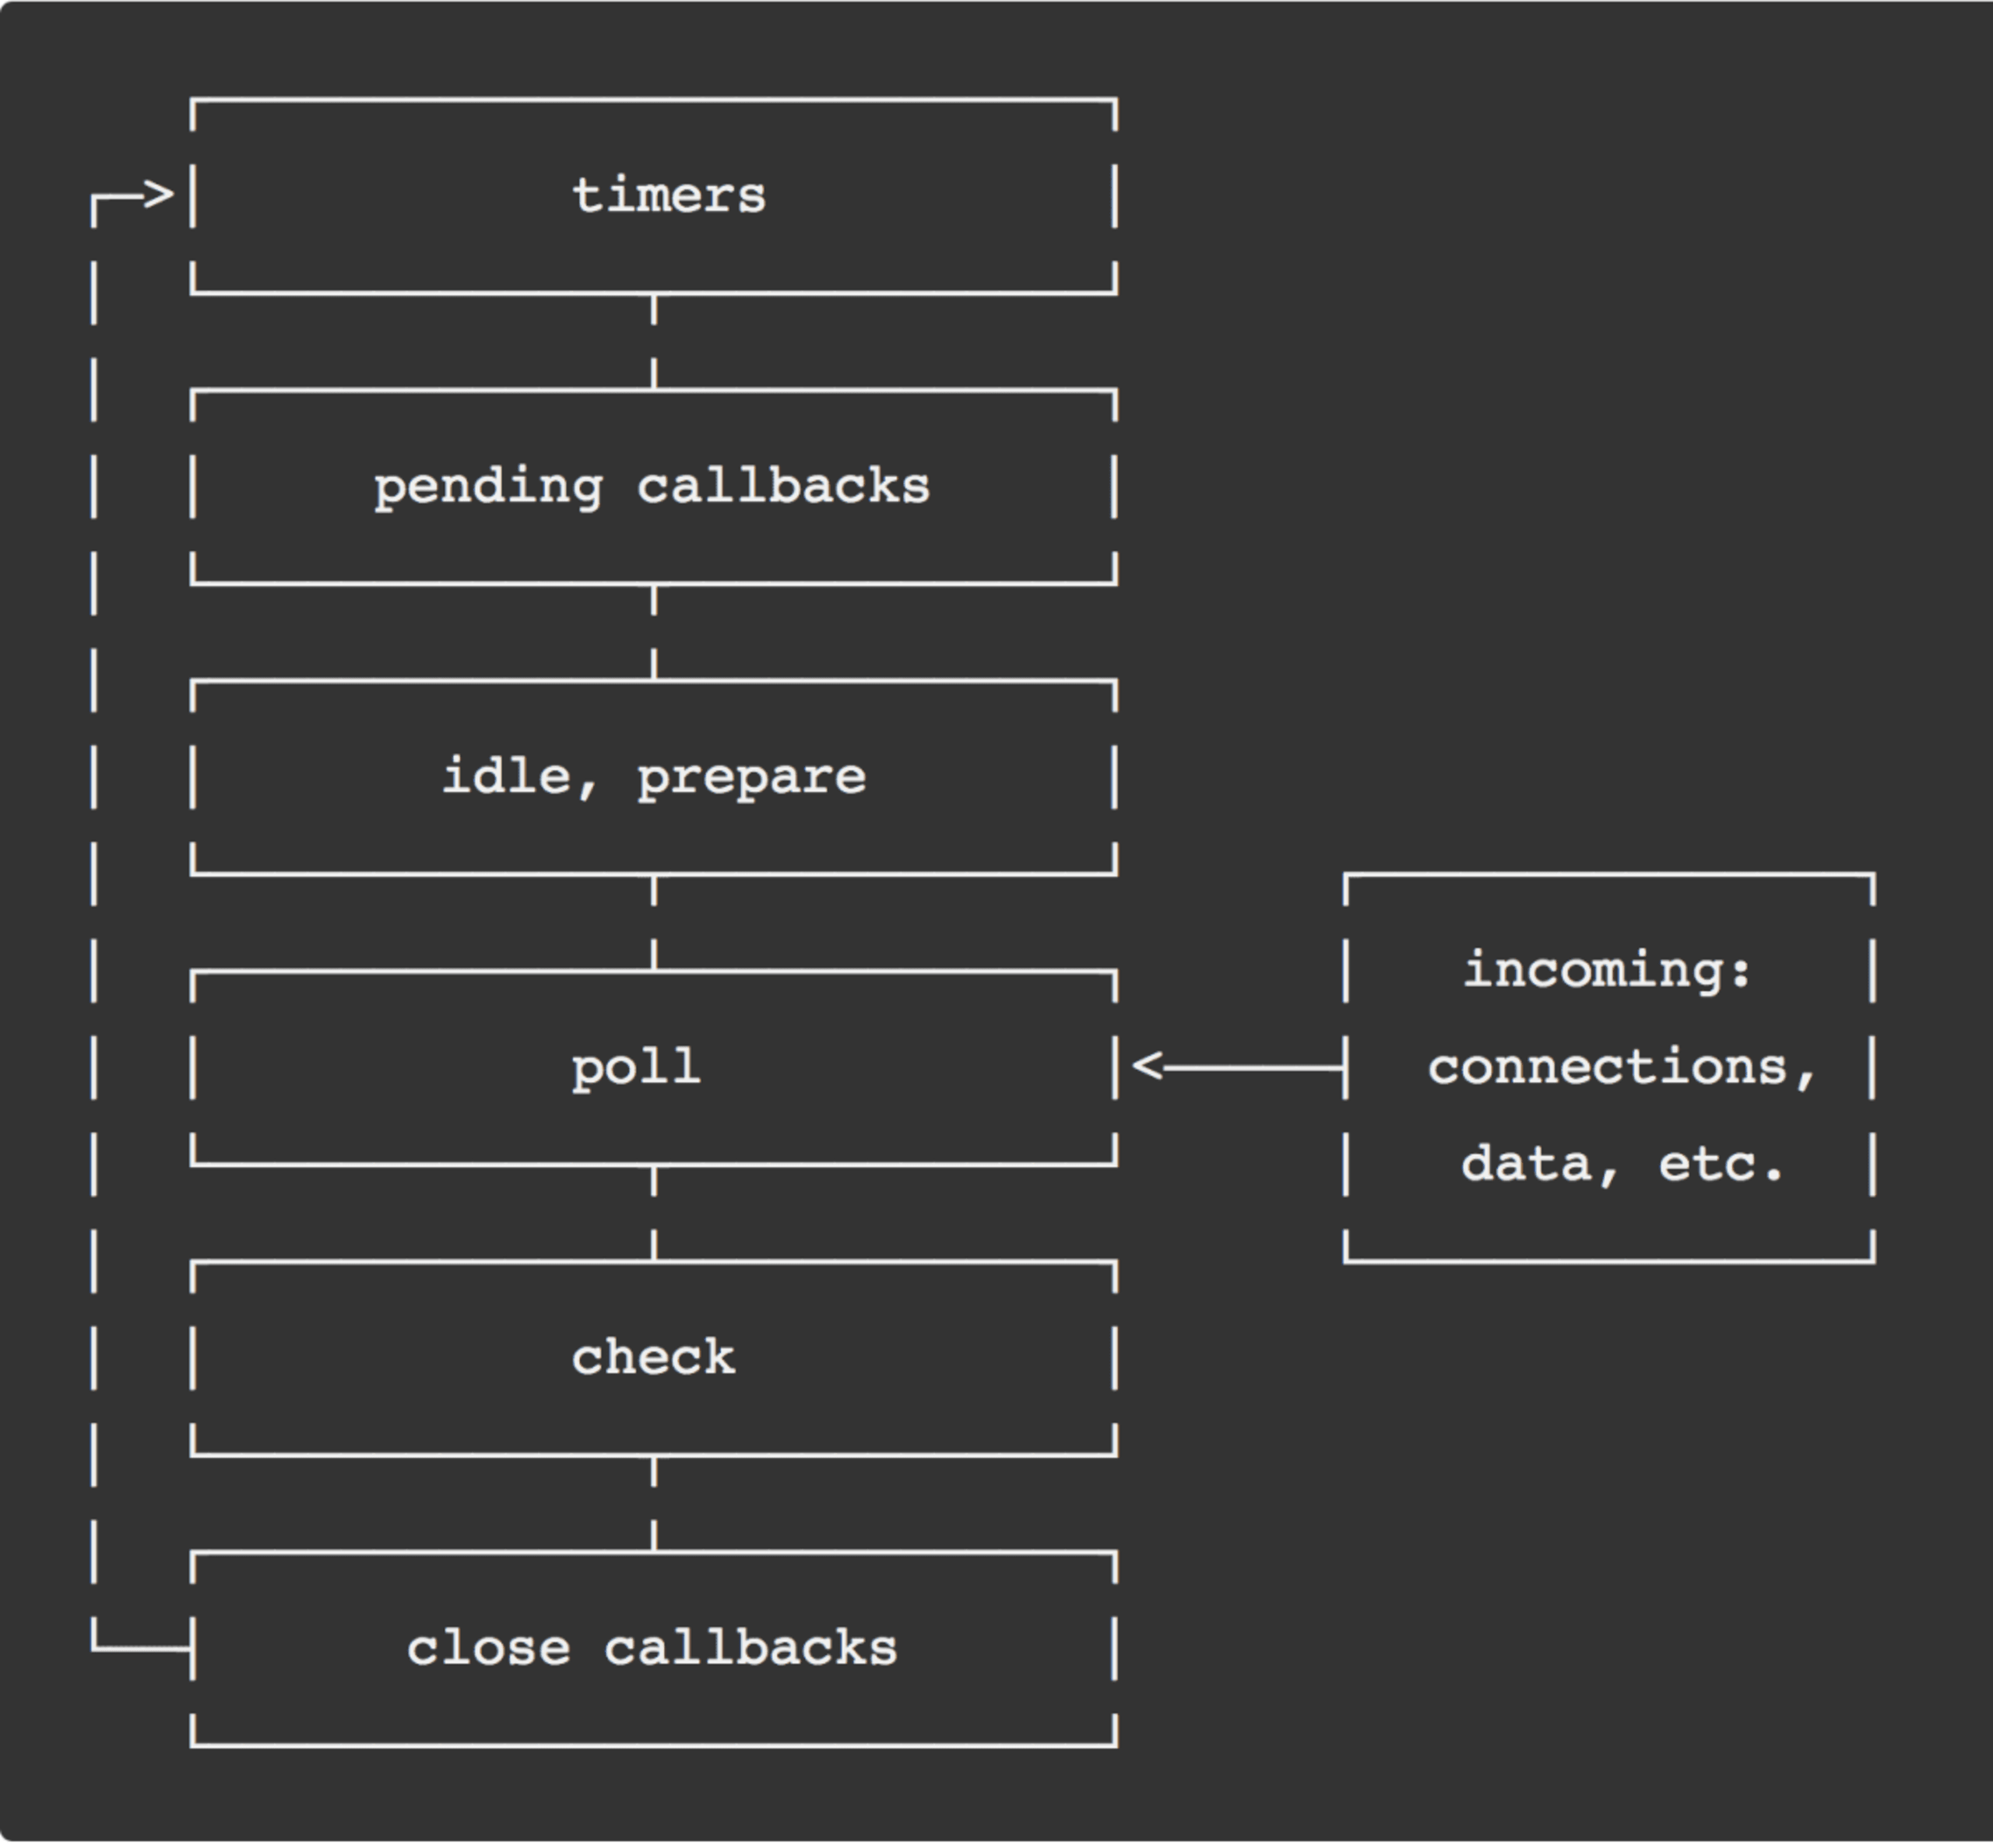
(J’ai découvert plus tard que cette boucle est très bien implémentée dans libuv, avec des fonctions dont les noms correspondent au schéma : https://github.com/libuv/libuv/blob/v1.22.0/src/unix/core.c#L359)
Le guide explique les différentes phases et en donne l’aperçu suivant :
timers : cette phase exécute les fonctions de rappel planifiées par
setTimeout()etsetInterval().pending callbacks : exécute les fonctions de rappel d’E/S reportées à l’itération suivante de la boucle.
idle, prepare : phases utilisées uniquement en interne.
poll : récupère les nouveaux événements d’E/S et exécute les fonctions de rappel associées aux E/S.
check : les fonctions de rappel
setImmediate()sont appelées ici.close callbacks : certaines fonctions de rappel de fermeture, par exemple
socket.on('close', ...).
Cette citation commence à répondre à notre question :
« En général, lorsque la boucle événementielle entre dans une phase donnée, elle effectue les opérations propres à cette phase, puis exécute les fonctions de rappel de sa file d’attente jusqu’à ce qu’elle soit vide… Comme chacune de ces opérations peut en planifier d’autres… ».
Cela laisse (vaguement) entendre que lorsqu’une fonction de rappel en ajoute une autre qui peut être traitée dans la même phase, cette dernière sera exécutée avant le passage à la phase suivante.
Node.js ne vérifie les sockets réseau à la recherche de nouvelles requêtes que pendant la phase poll. Cela signifie-t-il que ce que nous avons fait dans /compute-async a empêché la boucle événementielle de quitter une phase donnée, et qu’elle n’a donc jamais atteint la phase poll pour recevoir la requête /healthcheck ?
Il nous faudra approfondir pour obtenir des réponses plus précises, mais on comprend maintenant pourquoi setTimeout() a été utile : chaque fois que nous ajoutons une fonction de rappel de timer et que la file de la phase en cours est vide, la boucle événementielle doit parcourir toutes les phases pour atteindre la phase « Timers ». Elle passe alors par la phase poll et traite les requêtes réseau en attente.
Microtâches
Les mots-clés async/await utilisés dans /compute-async sont considérés comme du sucre syntaxique autour des Promise. En pratique, à chaque itération de la boucle, nous créons une Promise (une opération asynchrone) pour calculer un hachage et, une fois celle-ci résolue, la boucle passe à l’itération suivante. Le guide officiel mentionné n’explique pas comment les Promise sont traitées dans le contexte des phases de la boucle événementielle, mais nos expériences suggèrent que les fonctions de rappel de Promise et de resolve ont toutes deux été appelées sans passage par la phase poll.
En poursuivant mes recherches sur Google, j’ai trouvé une série de 5 articles très détaillés et bien écrits sur la boucle événementielle par Deepal Jayasekara, qui traite aussi de la gestion des Promise !
Elle contient ce schéma utile :
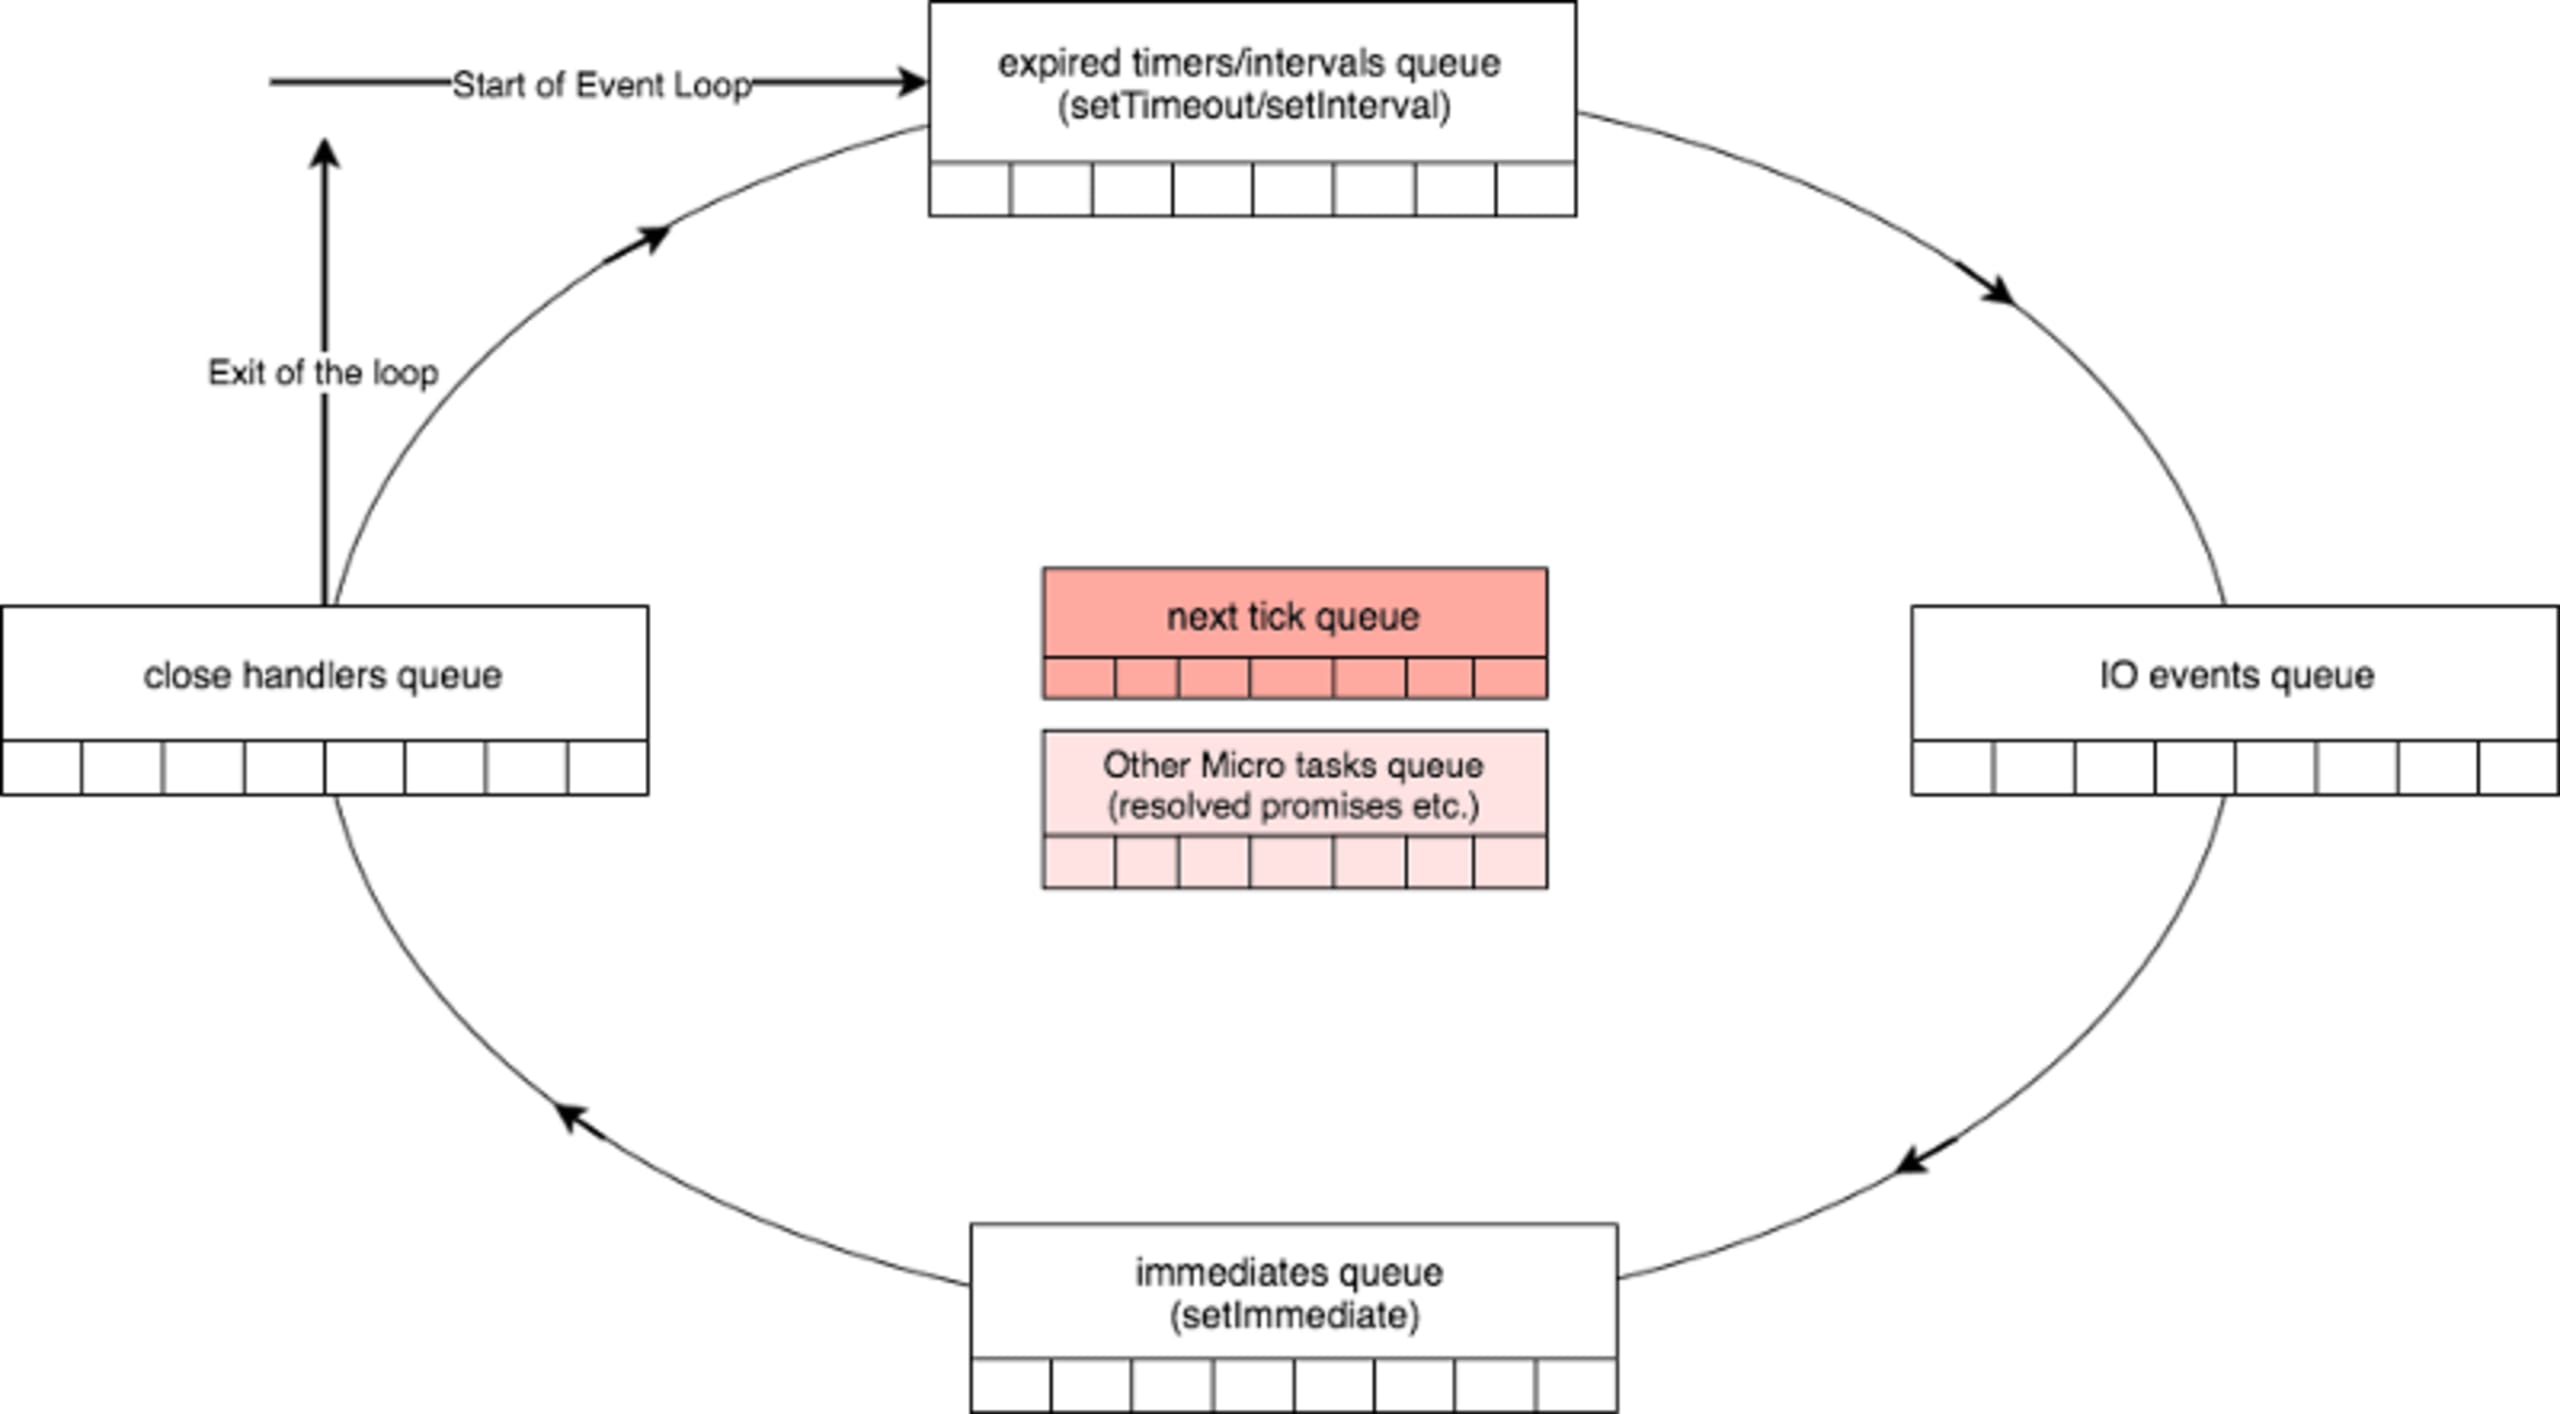
Les cases autour du cercle représentent les files d’attente des différentes phases vues précédemment. Les deux cases centrales représentent deux files spéciales qui doivent être vidées avant de passer d’une phase à l’autre. La « next tick queue » traite les fonctions de rappel enregistrées avec nextTick(), et la « Other Micro Tasks queue » répond à notre question sur les Promise.
Dans notre cas, si une Promise résolue en crée une autre, celle-ci sera-t-elle traitée pendant la même phase, avant de passer à la suivante ? Comme nous l’avons vu, oui ! On peut voir comment cela fonctionne dans le code source de V8. Ce lien pointe vers l’implémentation de RunMicrotask(). Voici un extrait de l’implémentation avec les lignes pertinentes :
Ce code C est étrange et effectue des boucles à l’aide des fonctions/macros bas niveau Goto() et Branch(), qui semblent magiques, car il est écrit avec « CodeStubAssembly », un « assembleur personnalisé, indépendant de la plateforme, qui fournit des primitives bas niveau sous la forme d’une fine abstraction au-dessus de l’assembleur ».
On voit dans le gist une boucle externe intitulée init_queue_loop et une boucle interne intitulée loop. La boucle externe vérifie le nombre réel de microtâches en attente, puis la boucle interne les traite une par une. Une fois qu’elles sont terminées, comme on le voit à la ligne 62 du gist ci-dessus, la boucle externe reprend et vérifie de nouveau le nombre de microtâches en attente. La fonction ne se termine que si aucune nouvelle tâche n’a été ajoutée.
Pour découvrir comment les microtâches sont traitées à la fin de chaque phase de la boucle événementielle, je vous recommande de lire cet autre excellent article de Deepal Jayasekara.
(Au fait, vous vous souvenez du flame graph créé pour /compute-async ? Si vous remontez pour le revoir, vous reconnaîtrez RunMicrotasks() dans la pile.)
Notez également que les microtâches sont propres à V8 : cela concerne donc aussi Chrome, où les Promise sont traitées de la même manière, sans faire tourner la boucle événementielle du navigateur.
nextTick() ne fera pas avancer la boucle
Le guide Node.js indique :
les fonctions de rappel transmises à
process.nextTick()seront exécutées avant que la boucle événementielle ne continue. Cela peut poser problème, car cette méthode vous permet d’« affamer » vos E/S en effectuant des appels récursifs àprocess.nextTick()
Cette fois, le texte est assez explicite, je vous épargne donc une autre capture du terminal. Vous pouvez toutefois faire l’expérience en exécutant GET /compute-with-next-tick dans node async block.
La file nextTick est traitée ici.
On voit bien que si callback appelle un autre process.nextTick(), la boucle traite la fonction de rappel suivante dans la même boucle et ne s’arrête que lorsque la file nextTick est vide.
À la rescousse avec setImmediate() ?
Les Promise sont rouges, les timers bleus… que pouvons-nous faire d’autre ?
Si l’on regarde les schémas ci-dessus, ils mentionnent tous deux la file setImmediate(), traitée pendant la phase « check », juste après la phase « poll ». Le guide officiel de Node.js indique également :
setImmediate()etsetTimeout()sont similaires, mais leur comportement diffère selon le moment où ils sont appelés…
Le principal avantage de
setImmediate()par rapport àsetTimeout(), c’est quesetImmediate()s’exécute toujours avant les timers lorsqu’il est planifié pendant un cycle d’E/S, quel que soit le nombre de timers présents.
Cela semble prometteur, mais la citation la plus intéressante est :
Si la phase poll devient inactive et que des scripts sont en file d’attente avec
setImmediate(), la boucle événementielle peut passer à la phase check au lieu d’attendre.
Vous vous souvenez que lorsque nous avons utilisé setTimeout(), le processus était presque inactif (c’est-à-dire en attente) et n’utilisait qu’environ 10 % du processeur ? Voyons si setImmediate() peut résoudre le problème :
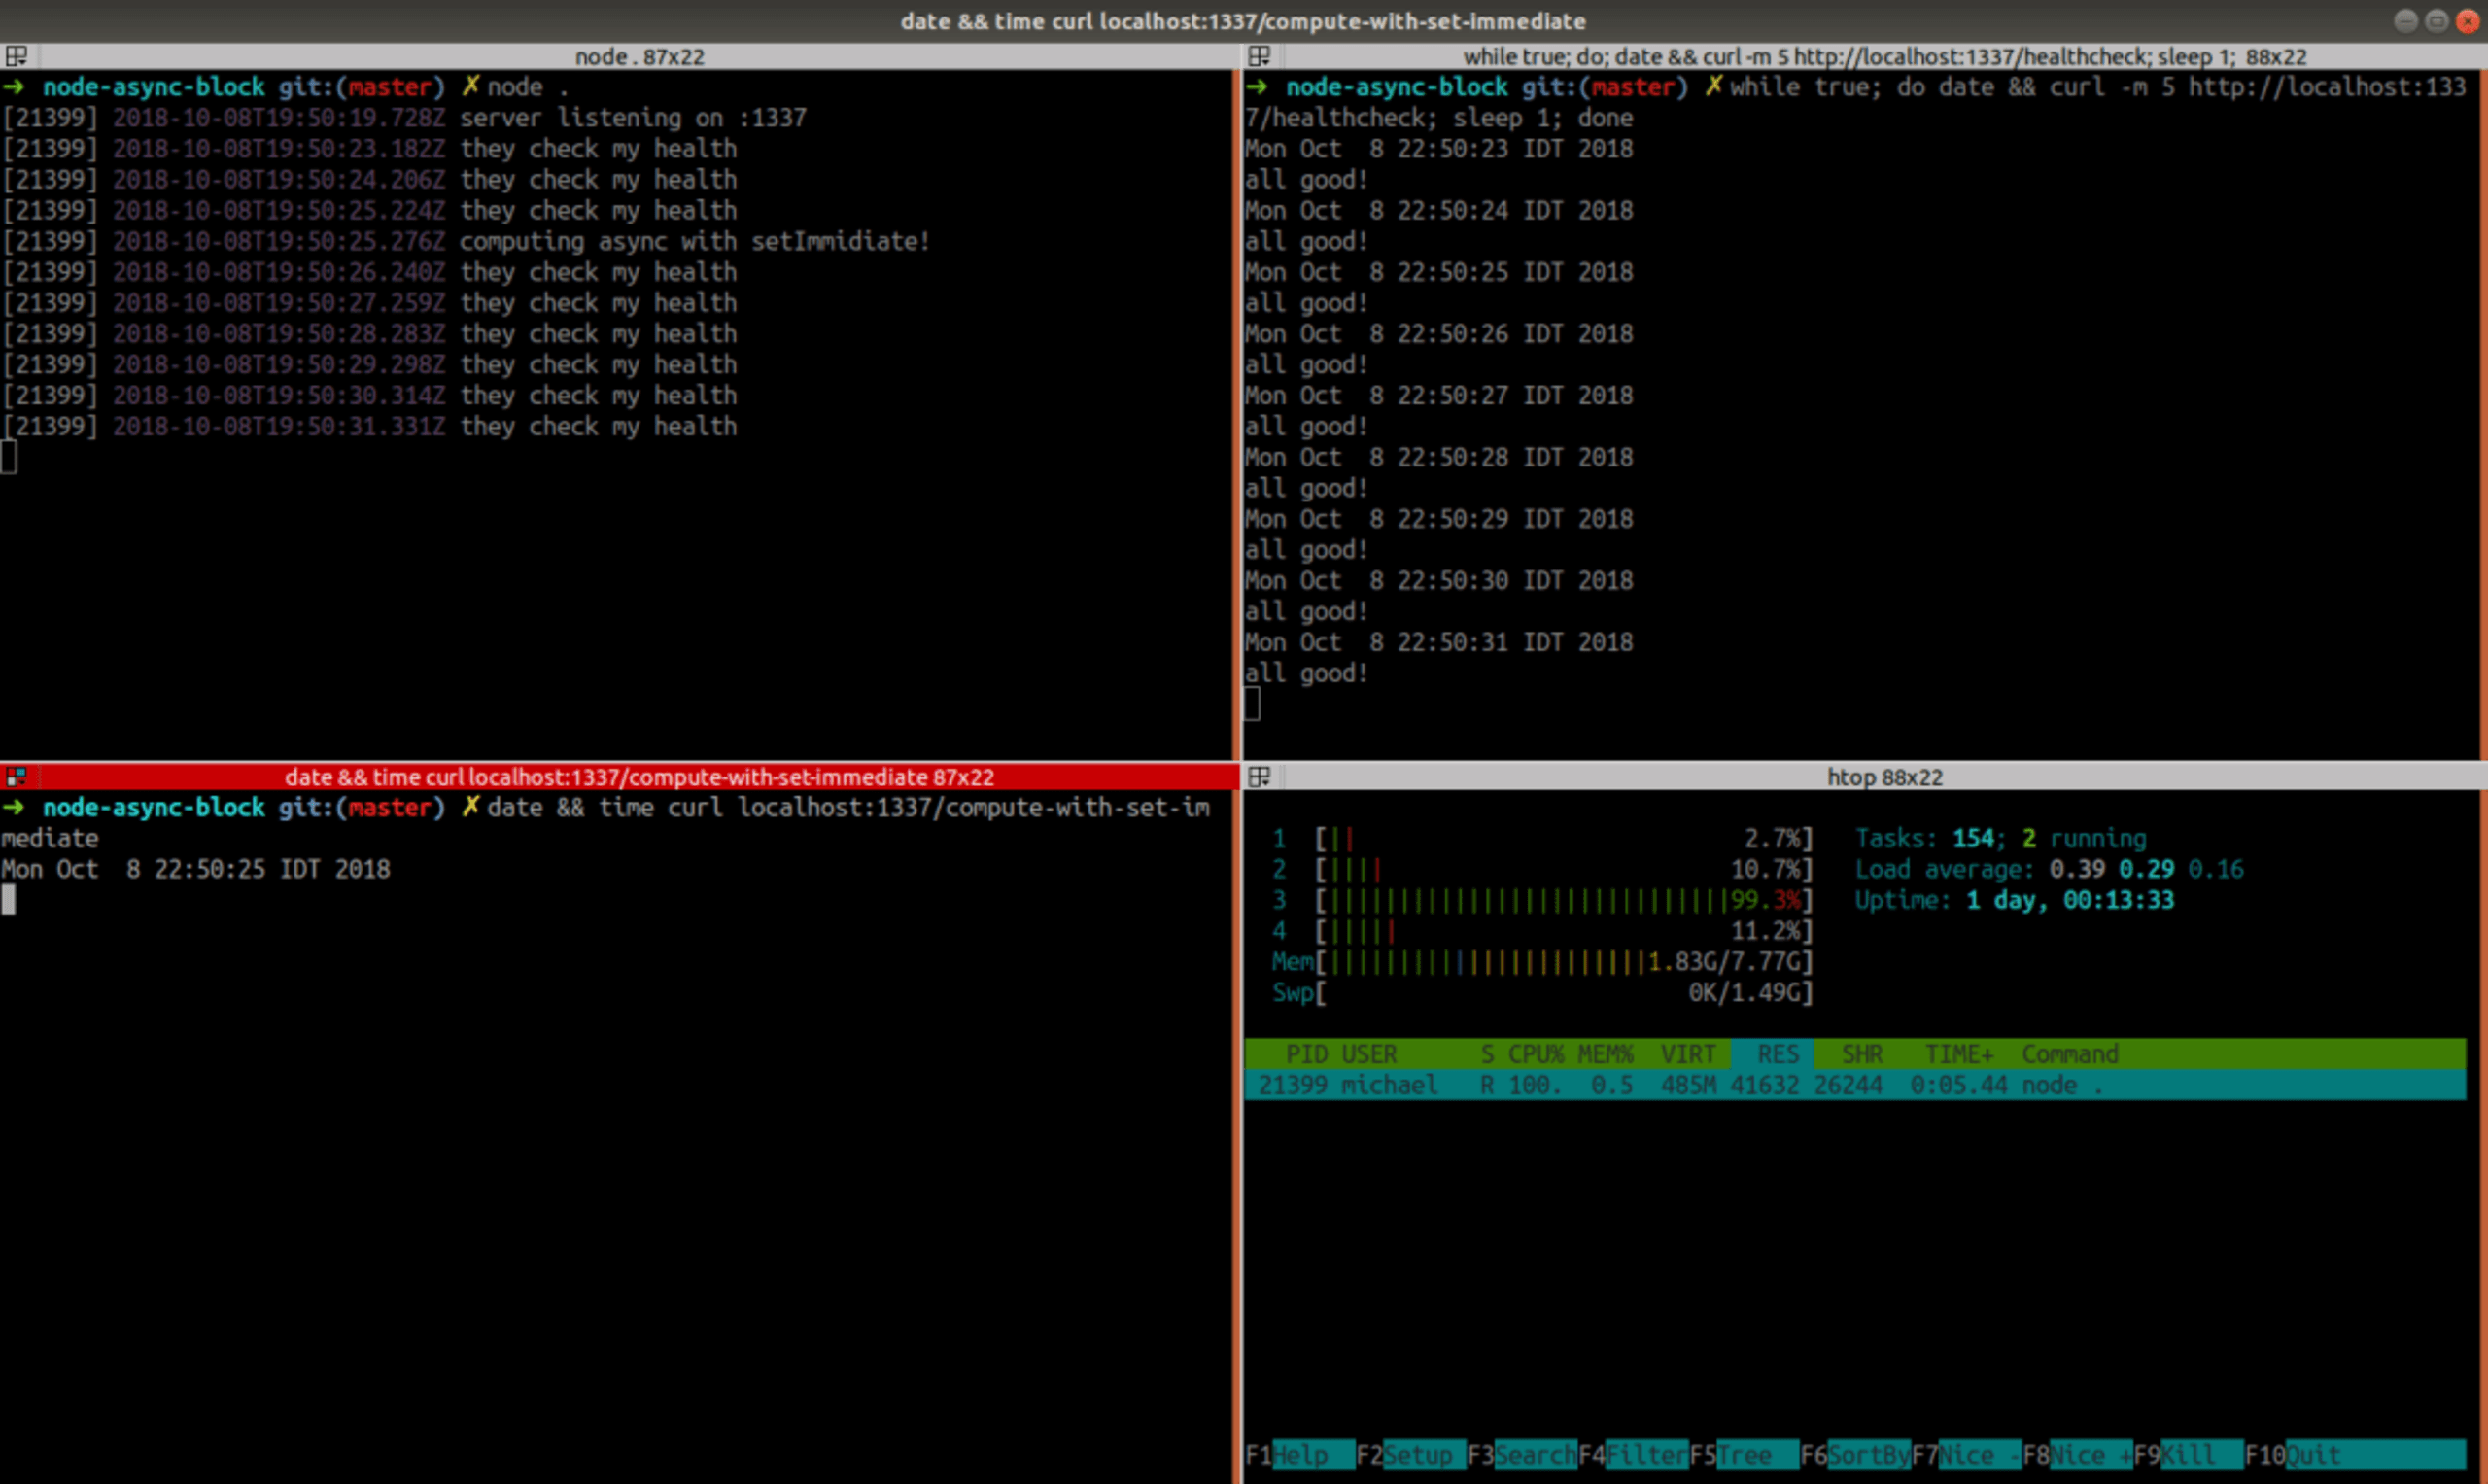
Youpi ! Le serveur ne bloque pas et le processeur est utilisé à 100 % ! Voyons combien de temps il faut pour terminer :
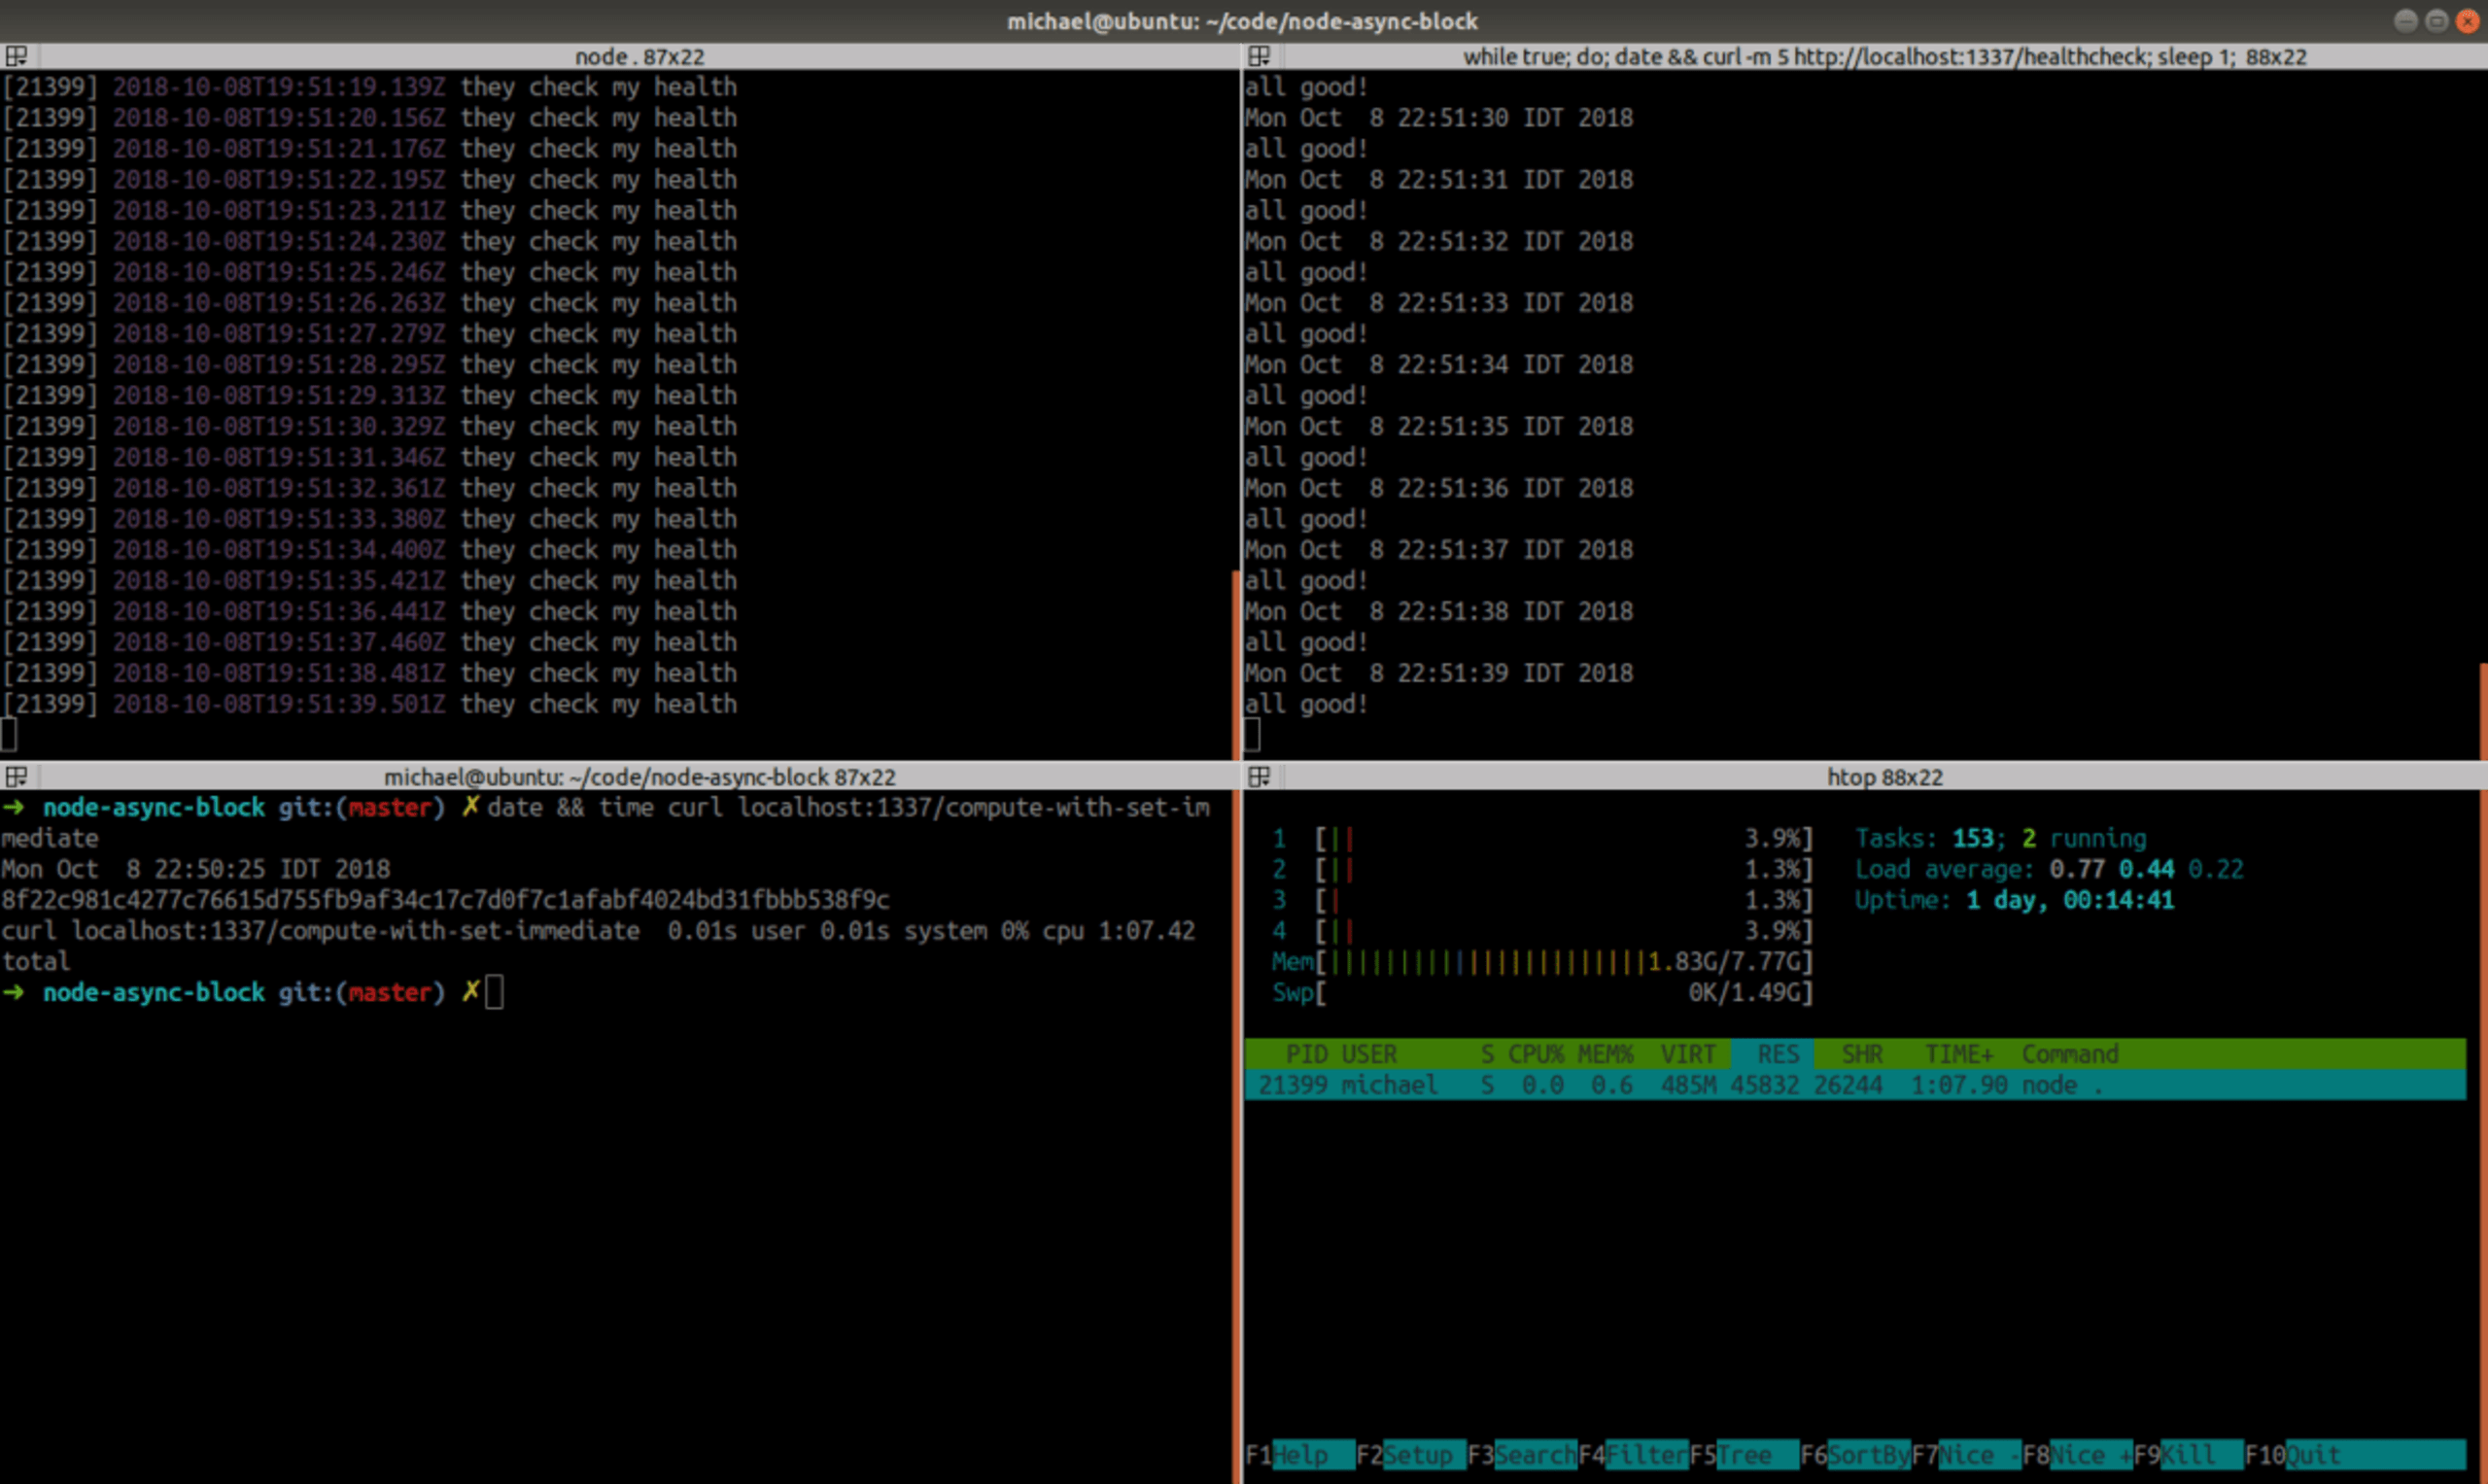
Eh bien, pas mal. L’exécution s’est terminée en 1 min 07 s, soit environ 50 % de plus que /compute-sync et 34 % de plus que /compute-async — mais le résultat est exploitable, contrairement à /compute-with-set-timeout. Étant donné qu’il s’agit d’un exemple fictif, dans lequel nous avons utilisé setImmediate() à chacune des 10⁷ minuscules itérations, ce qui a probablement entraîné 10⁷ cycles complets de la boucle d’événements, ce ralentissement est tout à fait compréhensible. Alors, programmer un setImmediate() depuis un rappel setImmediate() ne le fait pas rester dans la même phase ? En effet, la documentation Node.js l’indique clairement :
Si un minuteur immédiat est mis en file d’attente depuis un rappel en cours d’exécution, il ne sera déclenché qu’à la prochaine itération de la boucle d’événements.
Pour comparer setImmediate() et process.nextTick(), le guide Node.js indique :
Nous recommandons aux développeurs d’utiliser
setImmediate()dans tous les cas…
Vous avez déjà été gâtés avec des références au code ; pour ne pas vous décevoir, je pense qu’il s’agit du code qui exécute réellement les rappels setImmediate() — au fait, un détail intéressant mentionné dans la partie 3 de la série de Deepal : Bluebird, une bibliothèque Promise populaire non native, utilise setImmediate() pour planifier les rappels Promise.
Pour conclure
(Presque : une section bonus consacrée à setTimeout() suit) Ainsi, setImmediate() semble être une solution efficace pour découper du code synchrone de longue durée. Mais ce n’est pas toujours facile à mettre en œuvre correctement. Chaque passage à setImmediate() entraîne bien sûr une surcharge. En outre, plus il y a de requêtes en attente, plus la tâche de longue durée mettra de temps à se terminer : un découpage trop fin pose donc problème, tandis qu’un découpage insuffisant risque de bloquer trop longtemps. Dans certains cas, le code bloquant n’est pas une simple boucle comme dans notre exemple, mais une récursion qui parcourt une structure complexe ; il devient alors plus difficile de trouver le bon endroit et la bonne condition pour céder la main. Dans certains cas, une idée pourrait être de suivre le temps passé à bloquer avant de céder la main à setImmediate(). Cet extrait ne cédera la main que si au moins 10 ms se sont écoulées depuis la dernière fois :
Dans d’autres cas, du code tiers sur lequel vous avez moins de contrôle peut bloquer — même des fonctions intégrées comme JSON.parse() peuvent bloquer.
Une solution plus radicale consiste à décharger le code susceptible de bloquer vers un autre service (qui n’utilise pas Node.js), des sous-processus (avec des packages comme tiny-worker) ou de véritables threads via des packages comme webworker-threads ou le module intégré worker-threads de Node.js (encore expérimental). Dans bien des cas, c’est la bonne solution, mais toutes ces approches impliquent aussi de transmettre des données sérialisées dans les deux sens, car le code déchargé ne peut pas accéder au contexte du thread JS principal (et unique).
Un défi commun à toutes ces solutions est que la responsabilité d’éviter les blocages incombe à chaque développeur, plutôt qu’au système d’exploitation, comme dans la plupart des langages à threads, ou à la machine virtuelle d’exécution, comme dans Erlang. Non seulement il est difficile de s’assurer que tous les développeurs en sont toujours conscients, mais il n’est souvent pas optimal de céder explicitement la main dans le code, qui ne dispose ni du contexte ni de la visibilité sur les autres routines et opérations d’E/S en attente.
Le haut débit permis par Node.js peut, s’il n’est pas utilisé avec précaution, entraîner la mise en file d’attente de nombreuses requêtes derrière une seule opération bloquante. Pour signaler au répartiteur de charge aussi vite que possible qu’un serveur accumule les requêtes en retard et lui permettre de router les requêtes vers d’autres nœuds, vous pouvez essayer d’utiliser des packages comme toobusy-js dans vos points de terminaison de vérification d’état (cela ne vous aidera pas pendant le blocage lui-même…). Il est également important de surveiller la boucle d’événements à l’exécution, à l’aide de packages comme blocked-at ou de solutions telles que N|Solid et New-Relic.
Bonus : pourquoi le 0 de setTimeout(0) n’est pas vraiment égal à 0
Je me demandais vraiment pourquoi setTimeout(0) avait rendu le processus inactif à 90 %, au lieu de traiter notre calcul. Une utilisation inactive du processeur signifie probablement que le thread principal de node a appelé une fonction système qui a suspendu son exécution (c’est-à-dire l’a mis en veille) suffisamment longtemps avant que le noyau ne le planifie à nouveau, ce qui nous oriente vers setTimeout().
À la lecture du code source de libuv relatif à la gestion des minuteurs, il semble que la « veille » ait lieu dans uv__io_poll(), dans le cadre de l’appel système poll(), via son paramètre timeout.
La page de manuel de poll() indique :
L’argument
timeoutindique le nombre de millisecondes pendant lesquelles poll() doit bloquer en attendant qu’un descripteur de fichier soit prêt… une valeur négative pourtimeoutsignifie un délai d’attente infini. Une valeurtimeoutde zéro fait revenir poll() immédiatement.
Ainsi, sauf si le délai d’attente est exactement égal à 0, le processus se met en veille. Nous supposons que, même si nous transmettons 0 à setTimeout(), le délai d’attente réellement transmis à poll() est supérieur à zéro. Nous pouvons tenter de le vérifier en déboguant node lui-même avec gdb.
Nous pouvons tracer tous les appels à uv__io_poll() à l’aide de la commande gdb de dprintf :
Affichons aussi l’heure actuelle à chaque trace :
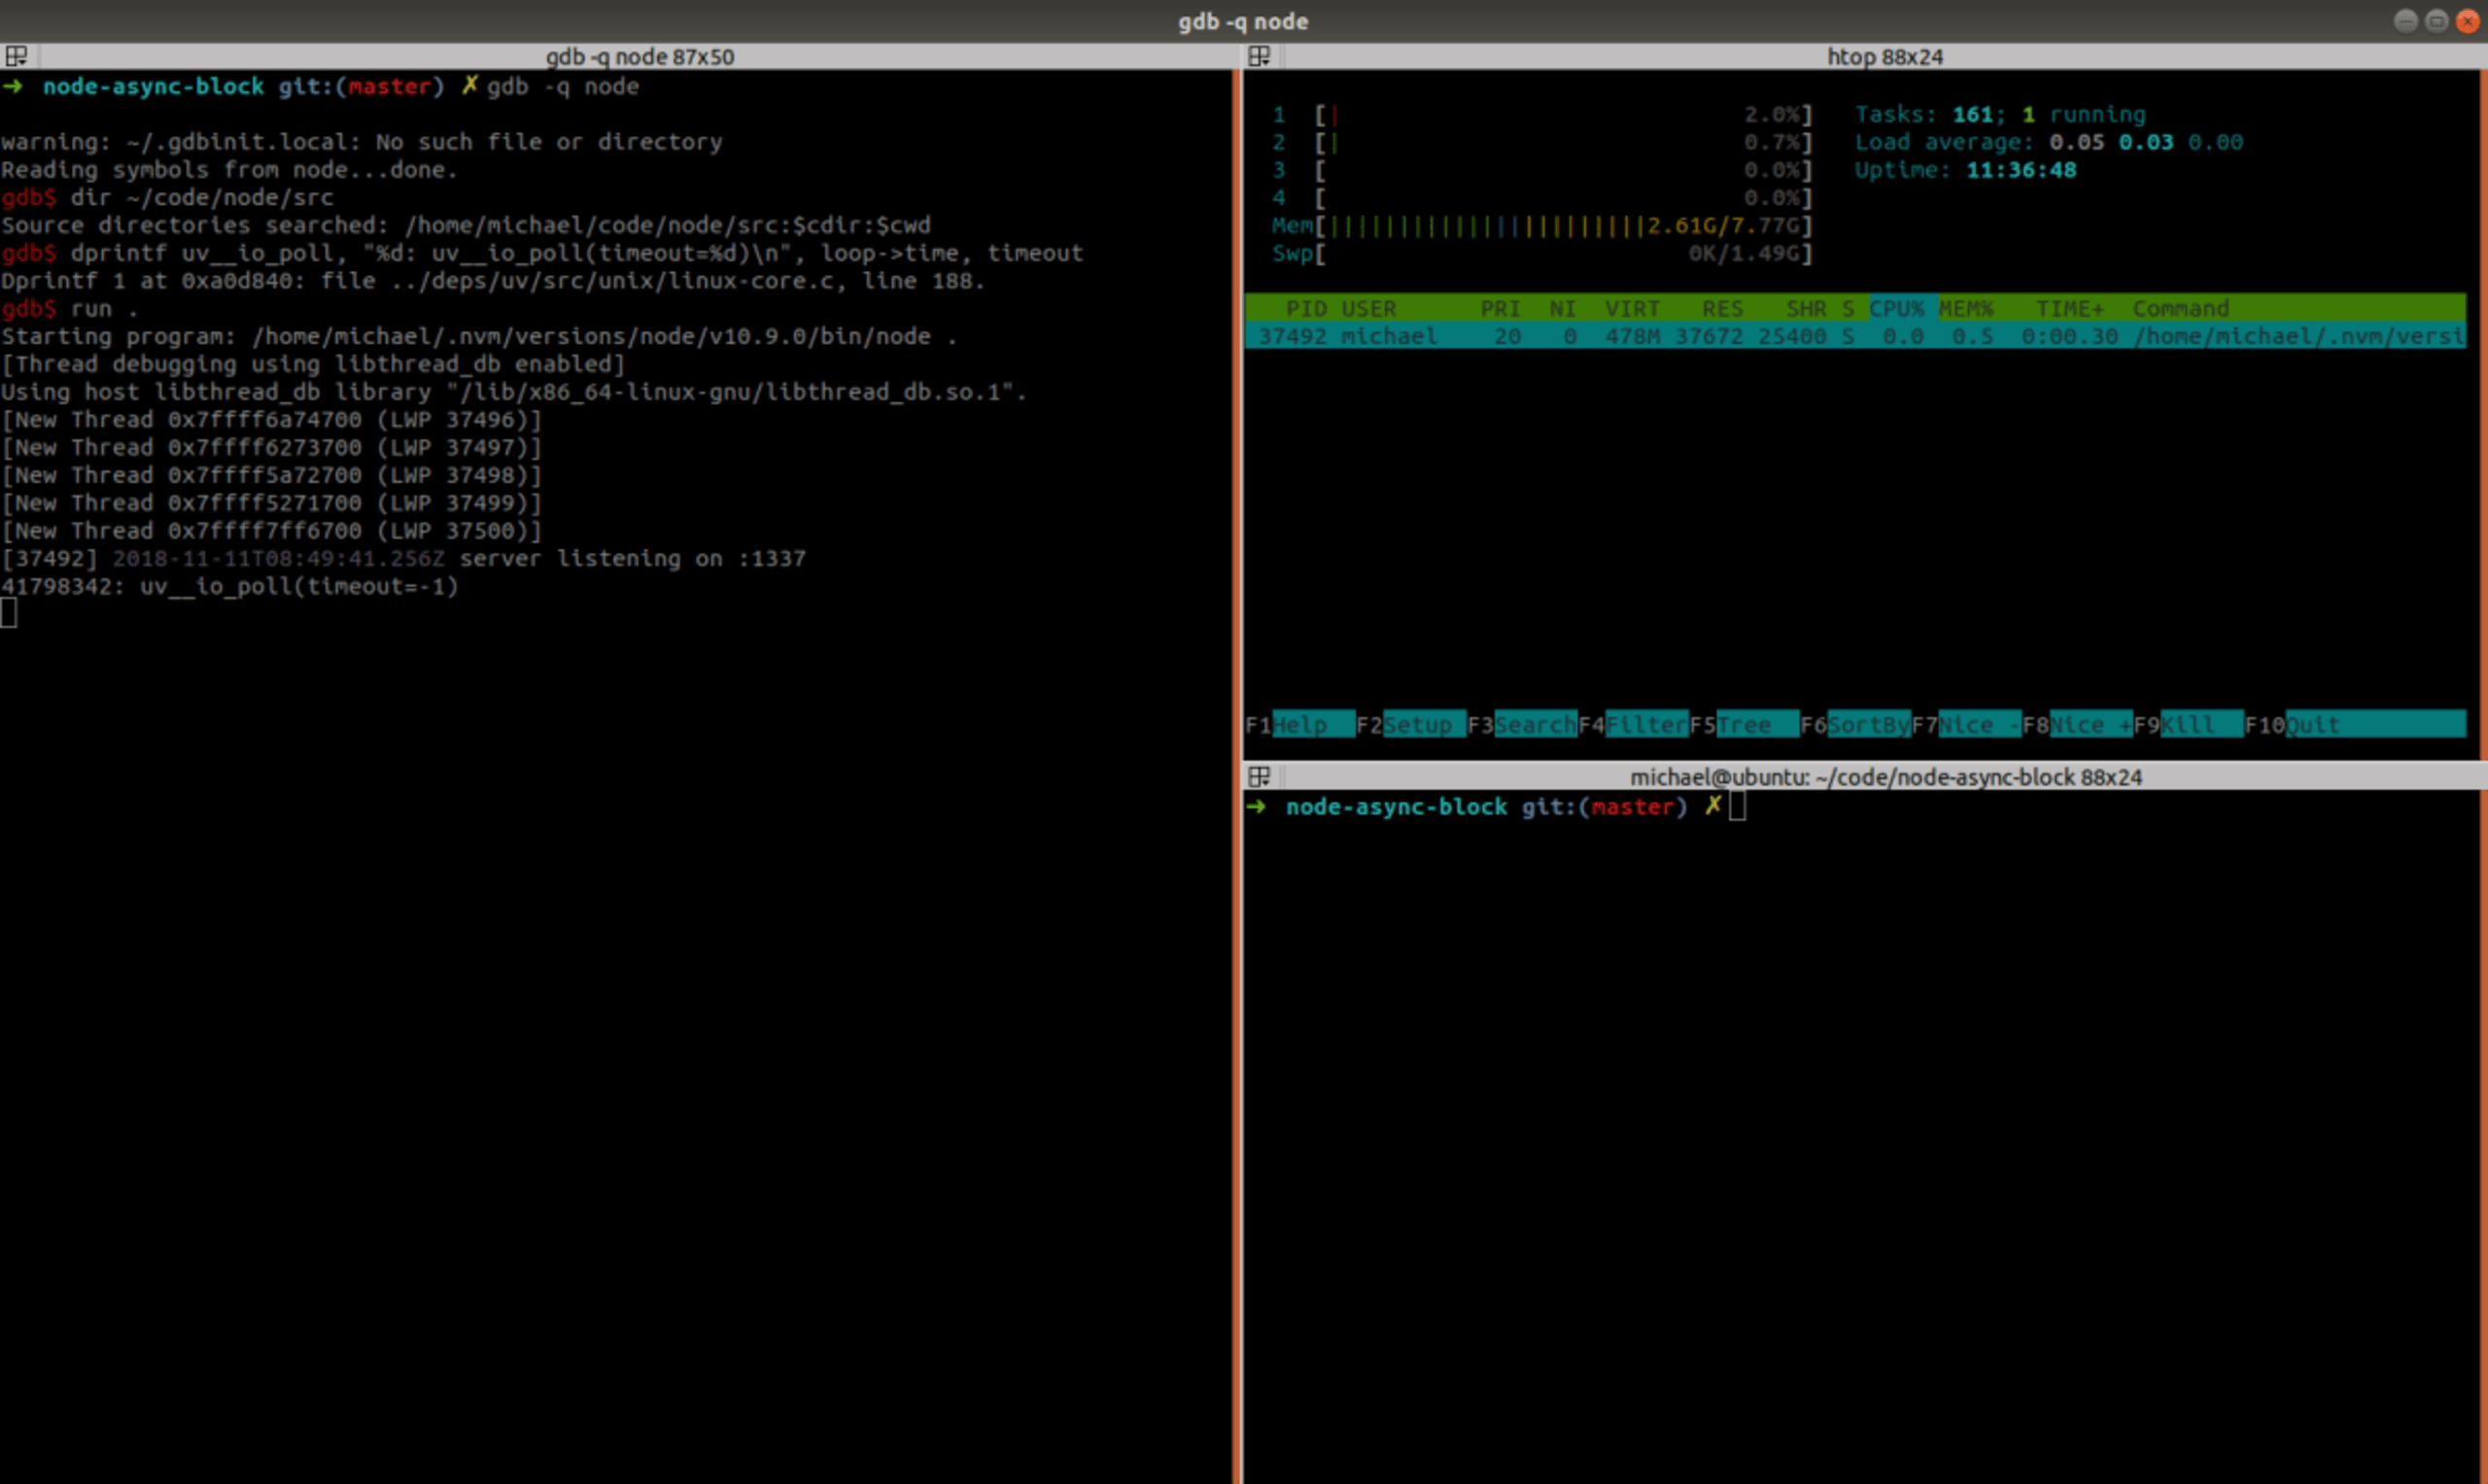
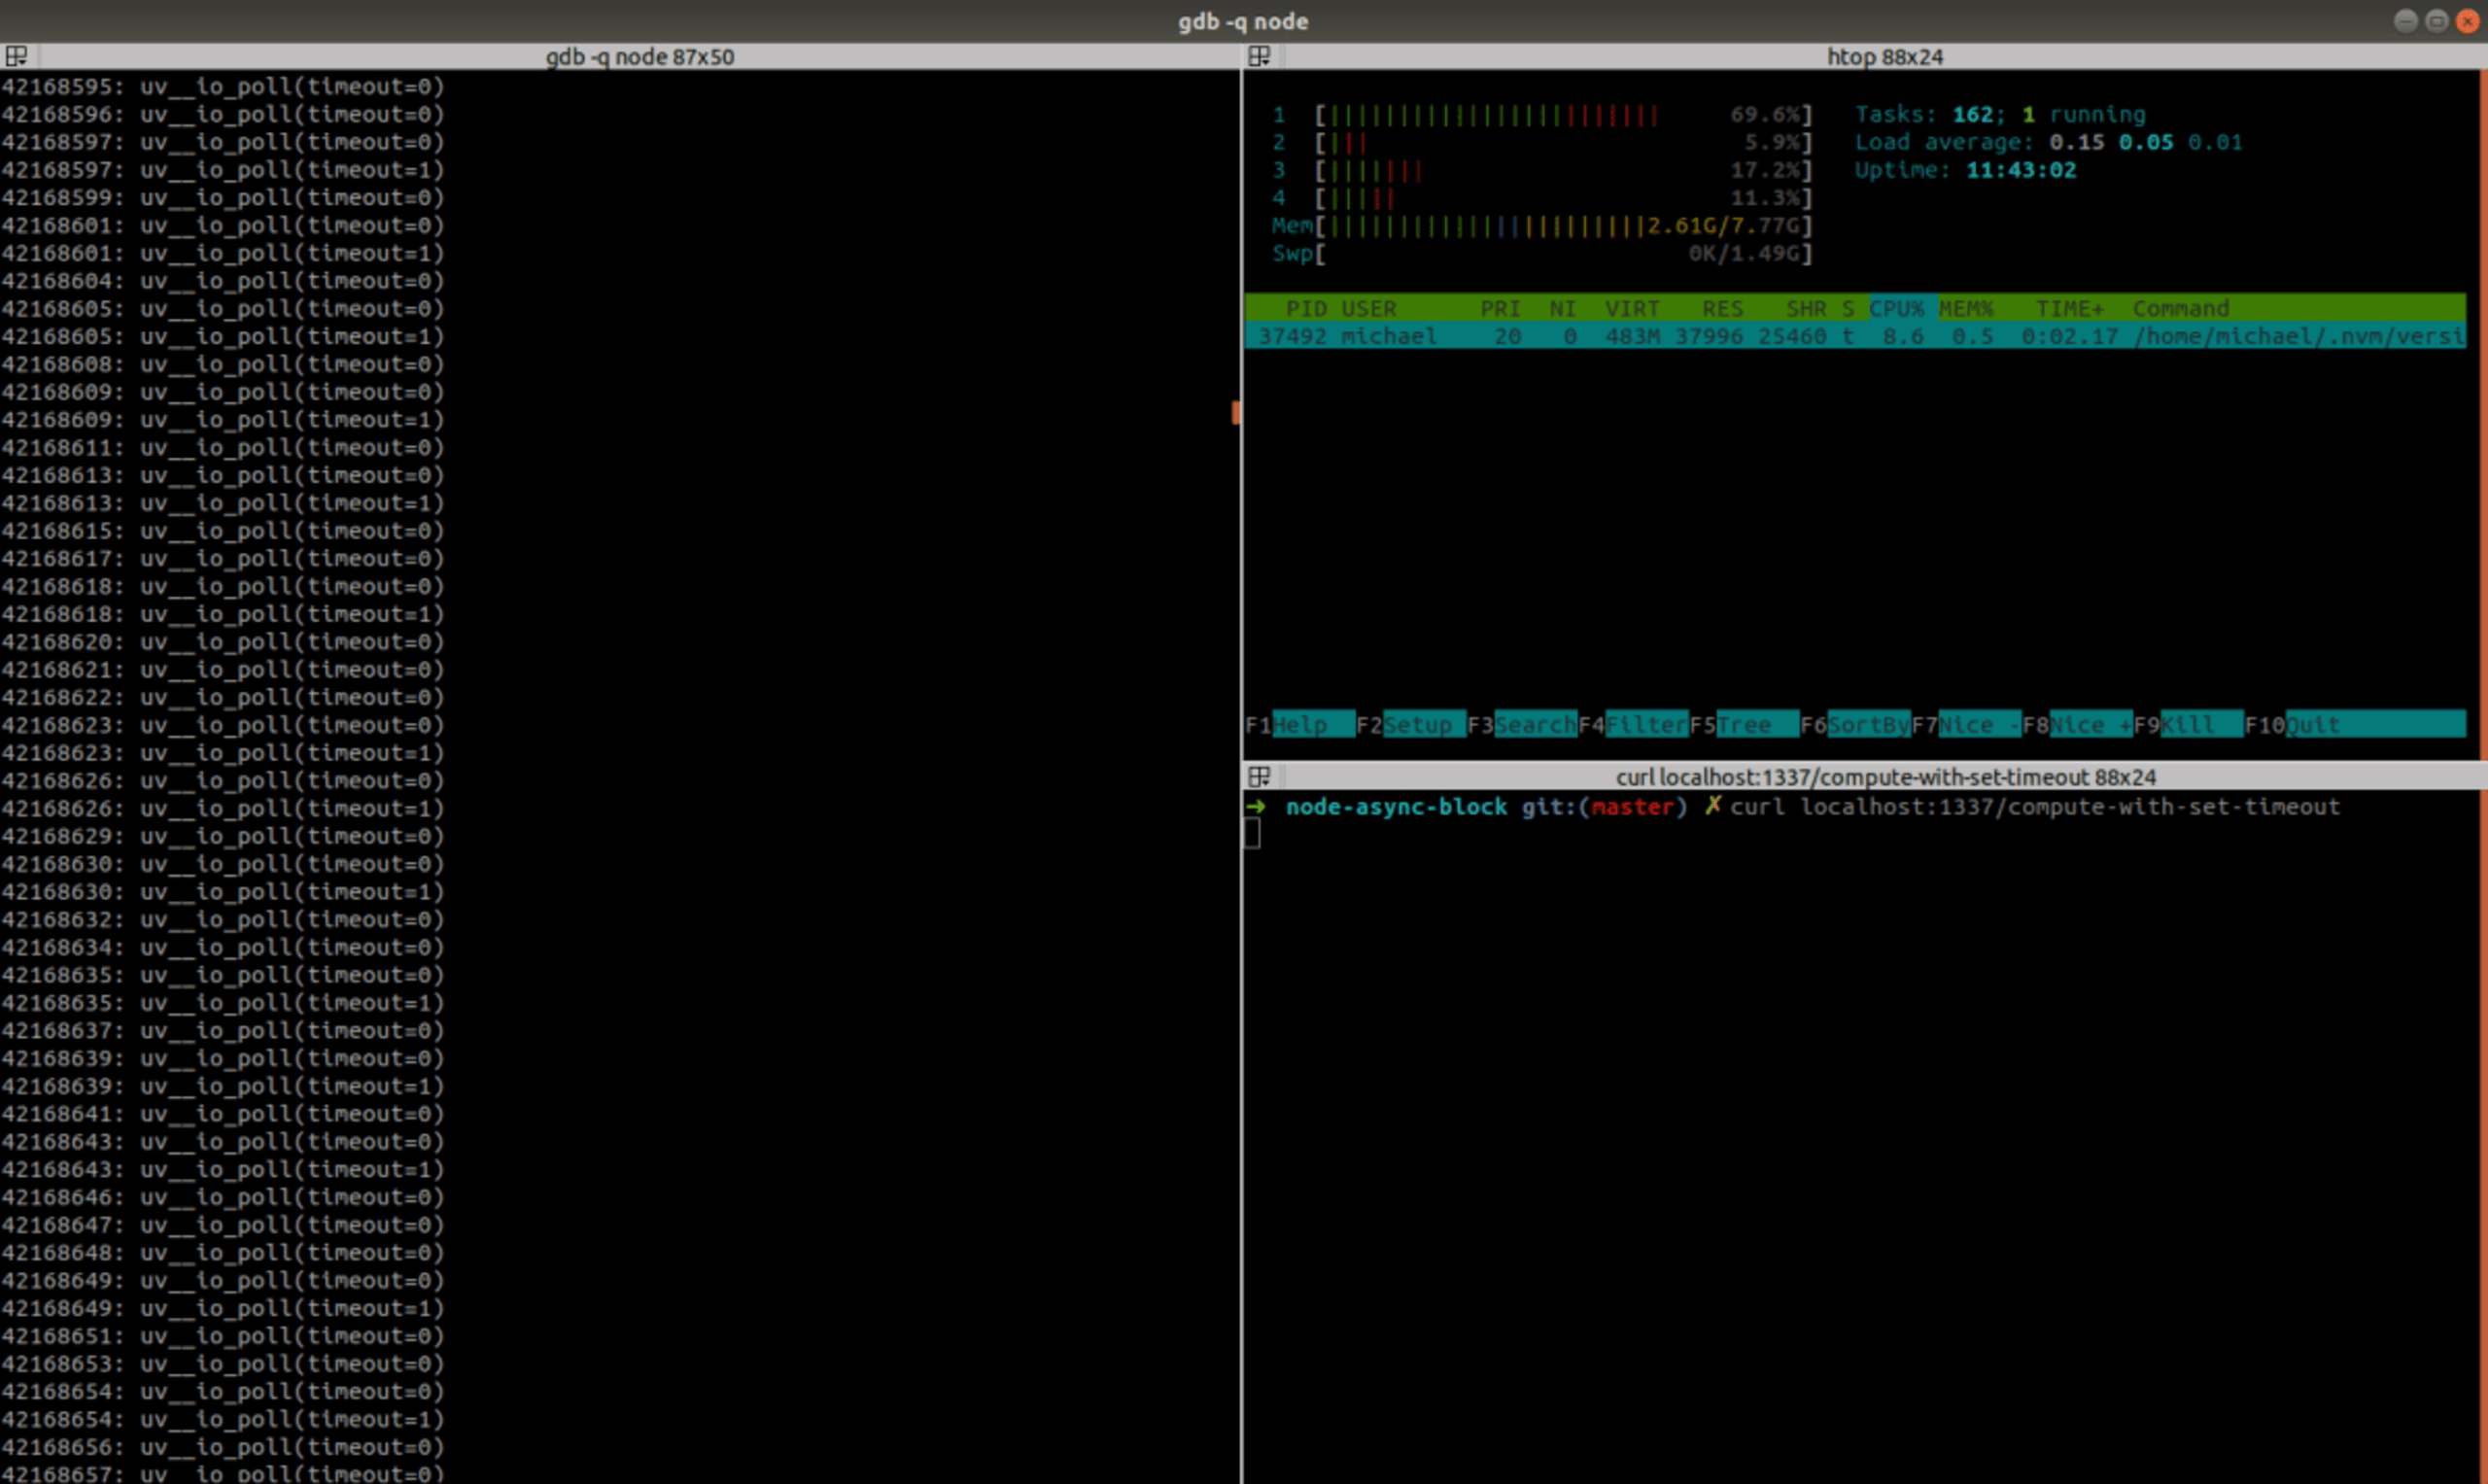
Au démarrage de notre serveur, uv__io_poll() est appelé avec un délai d’attente de -1, ce qui signifie « délai d’attente infini » — puisqu’il n’a rien d’autre à faire qu’attendre une requête HTTP. Envoyons maintenant une requête GET au point de terminaison /compute-with-set-timeout :
Comme nous pouvons le voir, le délai d’attente est parfois de 1 et, même lorsqu’il est de 0, au moins 1 ms s’écoule généralement entre deux appels consécutifs. Si nous procédons de la même façon en envoyant une requête GET à /compute-with-set-immediate, nous obtenons toujours timeout=0.
Pour un processeur, 1 milliseconde est une durée assez longue. La boucle serrée de /compute-sync a effectué 10⁷ itérations en 43 secondes, soit environ 233 calculs de hachage aléatoires par milliseconde. Attendre 1 ms à chaque itération revient à attendre 10 000 secondes, soit 2 h 45 !
Essayons de comprendre pourquoi le délai d’attente transmis à uv__io_poll() n’est pas égal à 0. Le délai est calculé par uv_backend_timeout(), puis transmis à uv__io_poll(), comme on peut le voir dans la boucle principale de libuv. Dans certains cas (par exemple, lorsqu’il y a des handles ou des requêtes actifs en attente), uv_backend_timeout() renvoie 0 ; sinon, il renvoie le résultat de uv__next_timeout(), qui sélectionne le délai le plus proche dans le « tas de minuteurs » et renvoie le temps restant avant son expiration.
La fonction utilisée pour ajouter les « délais d’attente » au « tas de minuteurs » est uv_timer_start(). Cette fonction est appelée à de nombreux endroits ; nous pouvons donc définir un point d’arrêt dessus pour mieux repérer l’appelant qui transmet une valeur non nulle dans notre cas. L’exécution de la commande info stack dans GDB au point d’arrêt affiche :
TimerWrap::Start n’est qu’une fine couche autour de uv_timer_start(), et les adresses illisibles plus haut dans la pile indiquent que le code que nous cherchons est probablement implémenté en JavaScript. En recherchant les utilisations de TimerWrap:Start dans le code source de Node, ou simplement en entrant dans l’implémentation de setTimeout() côté JS avec un débogueur JS, nous pouvons rapidement localiser le constructeur Timeout dans https://github.com/nodejs/node/blob/v10.9.0/lib/internal/timers.js#L53 :
Enfin, nous voyons ici qu’un délai d’attente de 0 est ramené à 1.
J’espère que cet article vous a été utile. Merci de l’avoir lu.
Références :
https://nodejs.org/en/docs/guides/event-loop-timers-and-nexttick/
https://jsblog.insiderattack.net/event-loop-and-the-big-picture-nodejs-event-loop-part-1-1cb67a182810 (série de 5 articles)
https://github.com/libuv/libuv (également intégré dans nodejs/node)
https://github.com/v8/v8 (également intégré dans nodejs/node)
Pour approfondir le sujet :
https://javabeginnerstutorial.com/node-js/event-loop-and-asynchronous-non-blocking-in-node-js/
https://stackoverflow.com/questions/34824460/why-does-a-while-loop-block-the-event-loop
https://stackoverflow.com/questions/46004290/will-async-await-block-a-thread-node-js
https://stackoverflow.com/questions/51694299/node-js-socket-io-async-and-blocking-event-loop
http://voidcanvas.com/setimmediate-vs-nexttick-vs-settimeout/
http://dtrace.org/blogs/brendan/2012/11/14/dtracing-in-anger/
https://developer.mozilla.org/en-US/docs/Web/JavaScript/EventLoop
https://jakearchibald.com/2015/tasks-microtasks-queues-and-schedules/ - navigateurs
https://blog.risingstack.com/node-js-at-scale-understanding-node-js-event-loop/
https://humanwhocodes.com/blog/2013/07/09/the-case-for-setimmediate/