Comment le cloud transforme la sécurité informatique en sécurité des applications

12 mars 2020
0 minutes de lectureL’informatique en cloud bouleverse indéniablement le monde de la technologie, en ouvrant la voie à des gains d’efficacité et à des innovations sans précédent. Mais elle a aussi entraîné un autre changement majeur, dont on parle rarement : le cloud a intégré l’infrastructure à l’application.
Cette évolution a des conséquences importantes sur notre approche de la sécurité. Dans l’ensemble, les outils et pratiques de sécurité actuels sont conçus pour les équipes centrales d’informatique et de sécurité, et adaptés à leurs compétences et à leurs environnements. Dans les applications cloud, ce sont les développeurs, et non l’informatique, qui prennent les décisions concernant l’accès réseau, les correctifs du système d’exploitation, les autorisations d’accès et bien d’autres aspects. Ces décisions sont prises pour chaque application, individuellement, et non de manière centralisée. Elles sont aussi prises en continu, dans le cadre du processus de développement, plutôt qu’à des étapes de validation précises.
Pourtant, les conséquences de ces décisions sur la sécurité restent les mêmes. Un port ouvert peut compromettre un VPC cloud tout autant qu’un segment de réseau dans un centre de données. Un conteneur non corrigé peut être piraté comme une machine physique. Les mêmes risques s’appliquent, et sont souvent amplifiés par l’étendue de l’application.
Nous devons donc repenser notre approche de ces menaces, cette fois en tenant compte du contexte des applications : équipes, processus et compétences différents. Dans cet article, j’explique comment le périmètre des applications s’est étendu jusqu’à englober l’infrastructure, et j’examine les conséquences sur la sécurité. Je pense que cette perspective peut vous aider à concevoir vos pratiques de sécurité, à choisir vos outils et à organiser vos équipes.
Note de style : j’emploie le mot « Cloud » pour désigner non seulement l’informatique cloud, mais aussi les conteneurs, le serverless et de nombreuses technologies qui ont suivi. Je parle également de l’« avant » et de l’« après » le cloud, même si, dans les faits, peu d’entreprises suivent une trajectoire intermédiaire. Cette simplification est volontaire : elle permet de mieux faire ressortir la vue d’ensemble — je sais bien que la réalité est complexe !
Les applications à l’ère pré-cloud
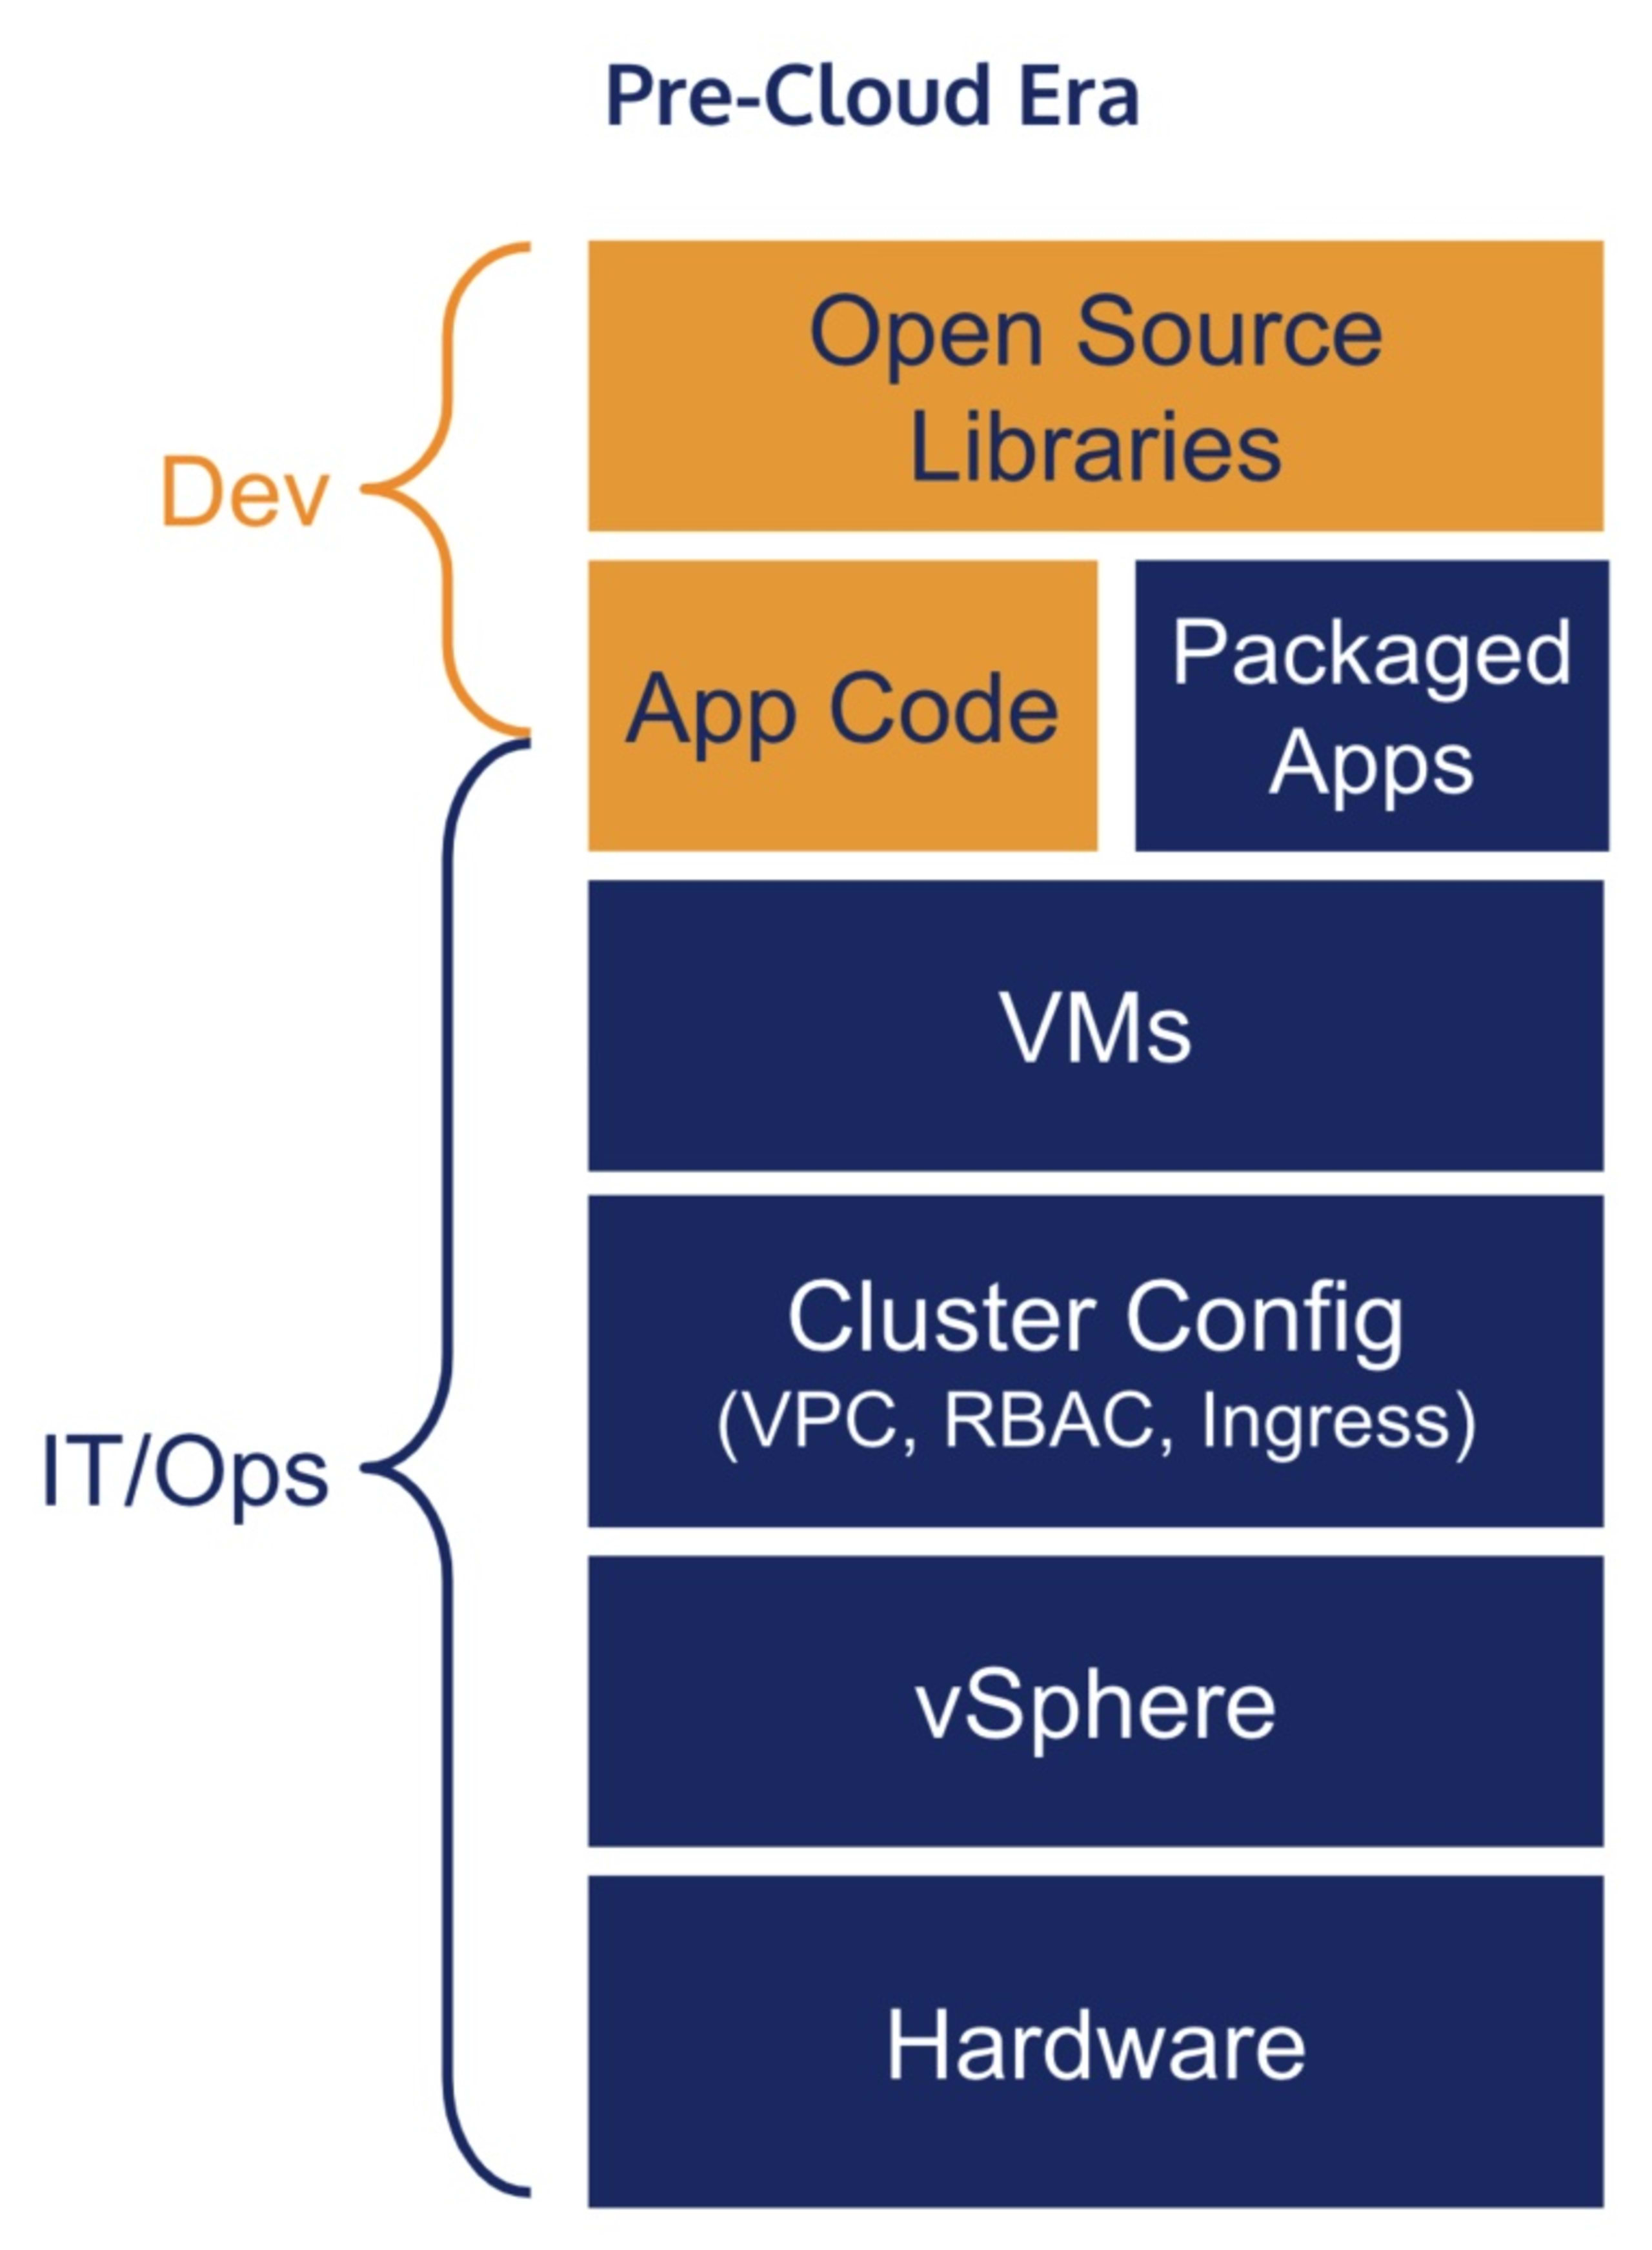
Avant le cloud, les applications reposaient sur une imposante pile informatique. J’évoquerai cette période au passé, même si, dans les faits, la plupart des entreprises fonctionnent encore principalement de cette manière.
Vous disposiez d’un centre de données où l’équipe informatique centrale gérait soigneusement les capacités et allouait les ressources. Les entreprises devaient gérer la surface occupée par les racks, acheter des serveurs et les mettre en service, gérer les pannes matérielles et suivre l’attribution de chaque serveur. Si une application avait besoin d’un serveur, il fallait remplir des formulaires et obtenir une autorisation : ajouter un serveur impliquait soit de dépenser plus, soit de priver quelqu’un d’autre d’un serveur.
Avec l’arrivée de la virtualisation, une nouvelle couche informatique est apparue, généralement vSphere, pour gérer les machines virtuelles au-dessus des machines physiques. L’efficacité s’en est trouvée améliorée, mais le processus fondamental n’a pas changé : les capacités restaient limitées et partagées. Pour obtenir un serveur, il fallait donc créer un ticket, et un groupe informatique central devait gérer à la fois la capacité des serveurs et la couche de virtualisation.
L’informatique gérait aussi les réseaux, au-delà des serveurs. Configurés à l’aide de commutateurs et de routeurs physiques, ils étaient davantage axés sur les contrôles d’accès que sur les capacités : quels utilisateurs pouvaient accéder au réseau et quels réseaux pouvaient communiquer entre eux. Les réseaux sont souvent complexes. Là encore, l’informatique centrale jouait donc un rôle essentiel en gérant les autorisations de communication complexes dans le centre de données et en allouant la bande passante.
Au-delà du matériel, l’informatique gérait également des ressources centralisées. Les images de référence pour les machines virtuelles en étaient un exemple. Ces machines virtuelles de référence contenaient des logiciels approuvés, évalués sous l’angle juridique, de la sécurité et de la qualité générale. L’informatique centrale surveillait aussi ces machines virtuelles et les mettait à jour pour corriger les vulnérabilités ou tenir compte des changements de politique de l’entreprise. Les applications étaient installées sur ces machines virtuelles, souvent manuellement, puis redémarrées au besoin pour appliquer les mises à jour.
Les services gérés constituaient un autre type de ressource centralisée. Par exemple, l’informatique pouvait gérer une grande base de données Oracle centrale, nécessaire au fonctionnement des applications. Un ou plusieurs administrateurs de bases de données (DBA) géraient les index et les tables, en collaboration avec les différentes équipes applicatives pour les adapter à leurs besoins.
Au-dessus de toutes ces couches se trouvait l’application elle-même. Les applications étaient constituées de code et de bibliothèques, et devaient être déployées dans des environnements très spécifiques pour fonctionner. Toute modification du matériel, des machines virtuelles de base, de l’utilisation des bases de données, du CDN ou de tout autre élément exigeait de créer un ticket et d’attendre.
À l’époque, cela avait du sens, car les ressources étaient limitées et devaient être partagées. L’ajout de capacité physique — qu’il s’agisse de serveurs, de réseau ou de stockage — prenait beaucoup de temps et coûtait cher. La mise en place ou l’extension d’une application centralisée demandait un effort considérable de la part de l’informatique centrale, une autre ressource partagée dont la capacité augmentait lentement et à grands frais. Ainsi, si une application recevait une part plus importante, une autre en recevait moins : un jeu à somme nulle.
Les applications à l’ère post-cloud
Puis le cloud est arrivé et a supprimé ces contraintes.
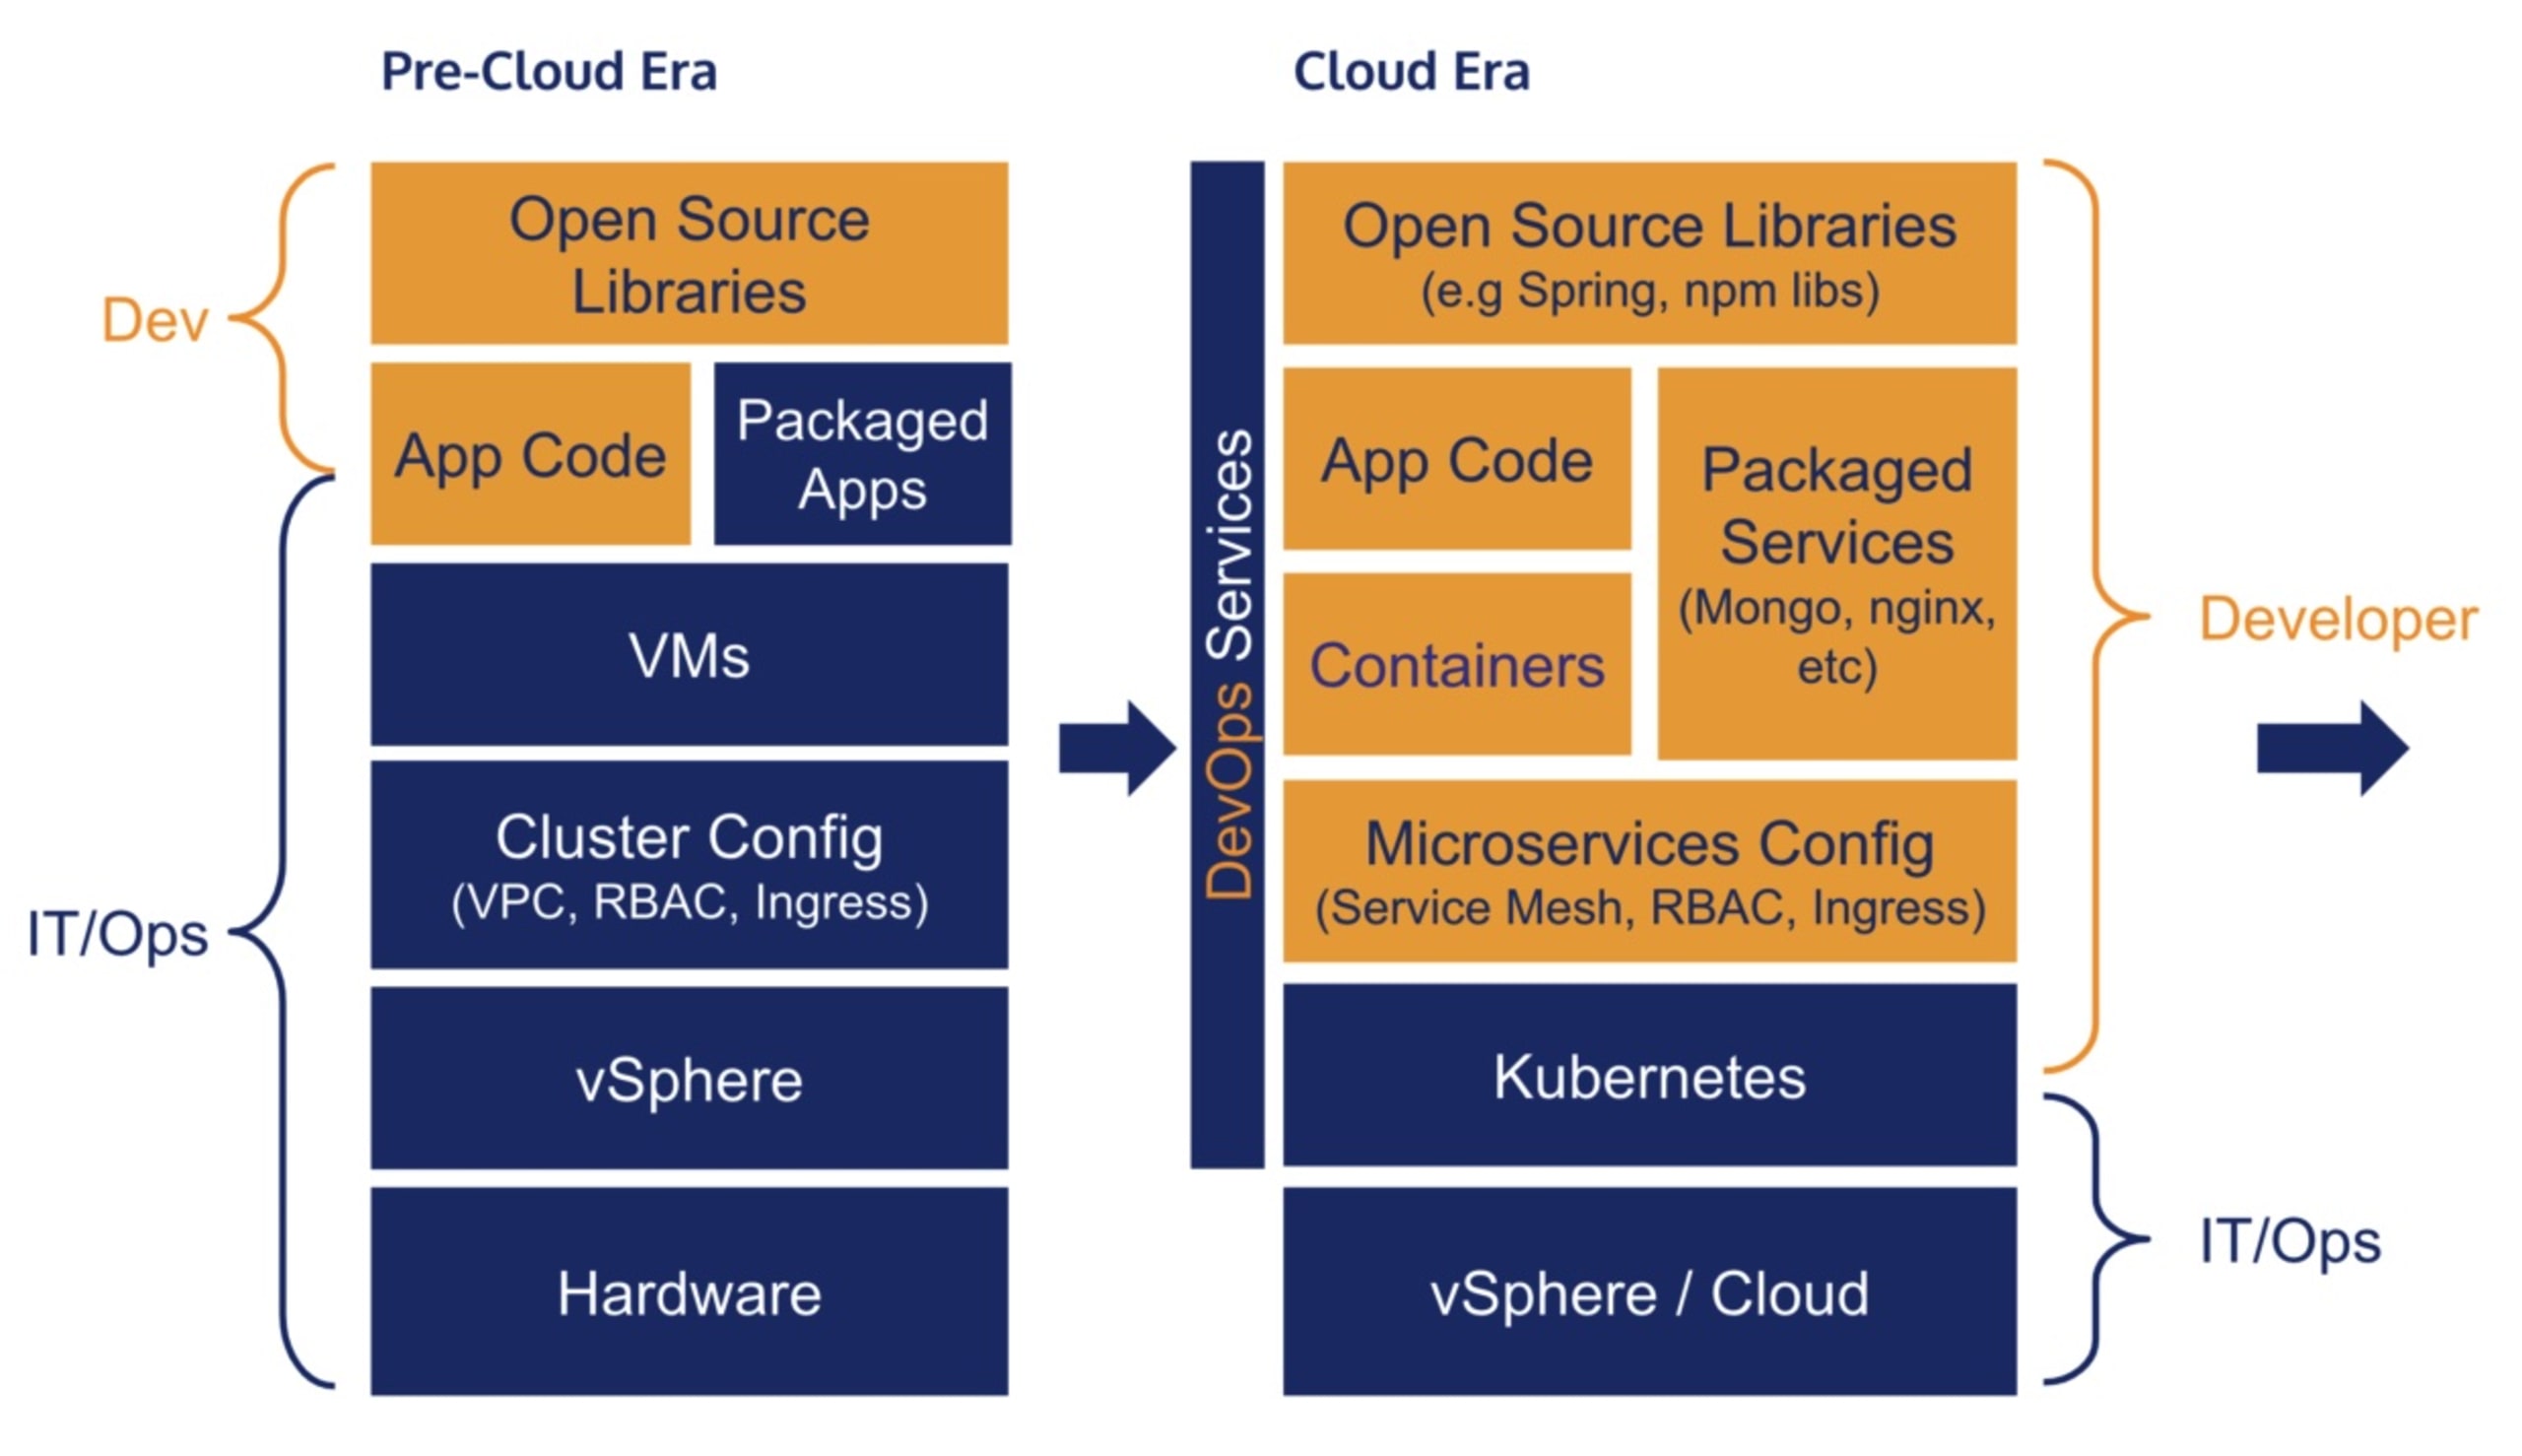
Les capacités matérielles ne posaient plus de problème. Les développeurs avaient seulement besoin d’accéder à un compte cloud pour pouvoir ensuite provisionner autant de serveurs que leur budget le permettait. Grâce à des commandes en libre-service pilotées par logiciel, ces serveurs pouvaient évoluer automatiquement à la hausse ou à la baisse, sans intervention de l’informatique centrale.
Les réseaux ne dépendaient plus d’une gestion centralisée. Les équipes applicatives pouvaient créer leur propre cloud privé virtuel (VPC), que la plateforme cloud isolait du reste. Les accès à ces réseaux étaient configurés avec précision selon les besoins de l’application, et entièrement paramétrables par logiciel, en libre-service.
Les machines virtuelles cloud étaient moins gérées de façon centralisée que leurs prédécesseures dans les centres de données, mais les conteneurs ont véritablement rompu ce lien. Les instructions de création des conteneurs sont généralement définies dans un dépôt de code source et intégrées à l’application. L’informatique centrale a donc du mal à les voir et ne peut, dans les faits, pas y appliquer de correctifs. Même les « images de référence » gérées de façon centralisée perdent de leur intérêt : les correctifs qui leur sont apportés ne s’appliquent pas avant la reconstruction de l’application, et les développeurs s’appuient de plus en plus sur des images de base externes.
Les applications centralisées ont été remplacées par des services faciles à utiliser, intégrés à la plateforme cloud, comme les bases de données, l’authentification, la messagerie et bien d’autres. Contrairement à la plupart des applications centralisées, ces services reposent sur des API et sont conçus pour être provisionnés et utilisés en libre-service par les équipes de développement. Les conteneurs préconfigurés ont remplacé les petites applications. Facilement accessibles depuis Docker Hub, ils sont devenus de simples microservices dans la topologie de l’application. Dans les deux cas, plus besoin de créer un ticket ni d’attendre que l’informatique, aux ressources limitées, provisionne votre application.
Enfin, les équipes DevOps (parfois appelées équipes SRE ou plateforme) ont vu le jour, remplaçant l’informatique centrale par des équipes opérationnelles intégrées. Elles ne cherchent pas à contrôler l’infrastructure utilisée par les applications. Elles fournissent plutôt des outils et des services, comme Kubernetes, qui permettent aux développeurs de gérer eux-mêmes les couches d’infrastructure intégrées à leurs applications.
Sécuriser l’infrastructure comme une application
Au fil du temps, le cloud supprime le besoin de gérer de manière centralisée la plupart des infrastructures. Celles-ci font désormais partie intégrante de l’application. Cette tendance va inévitablement se poursuivre : les CDN, les passerelles API, les intergiciels et bien d’autres éléments deviennent eux aussi partie intégrante de l’application, ce qui accroît l’autonomie et la rapidité des équipes de développement. Cette évolution a débuté dans le cloud public, mais s’est aussi étendue au cloud privé, qui a adopté les mêmes pratiques.
Les problèmes de sécurité, eux, n’ont pas disparu.
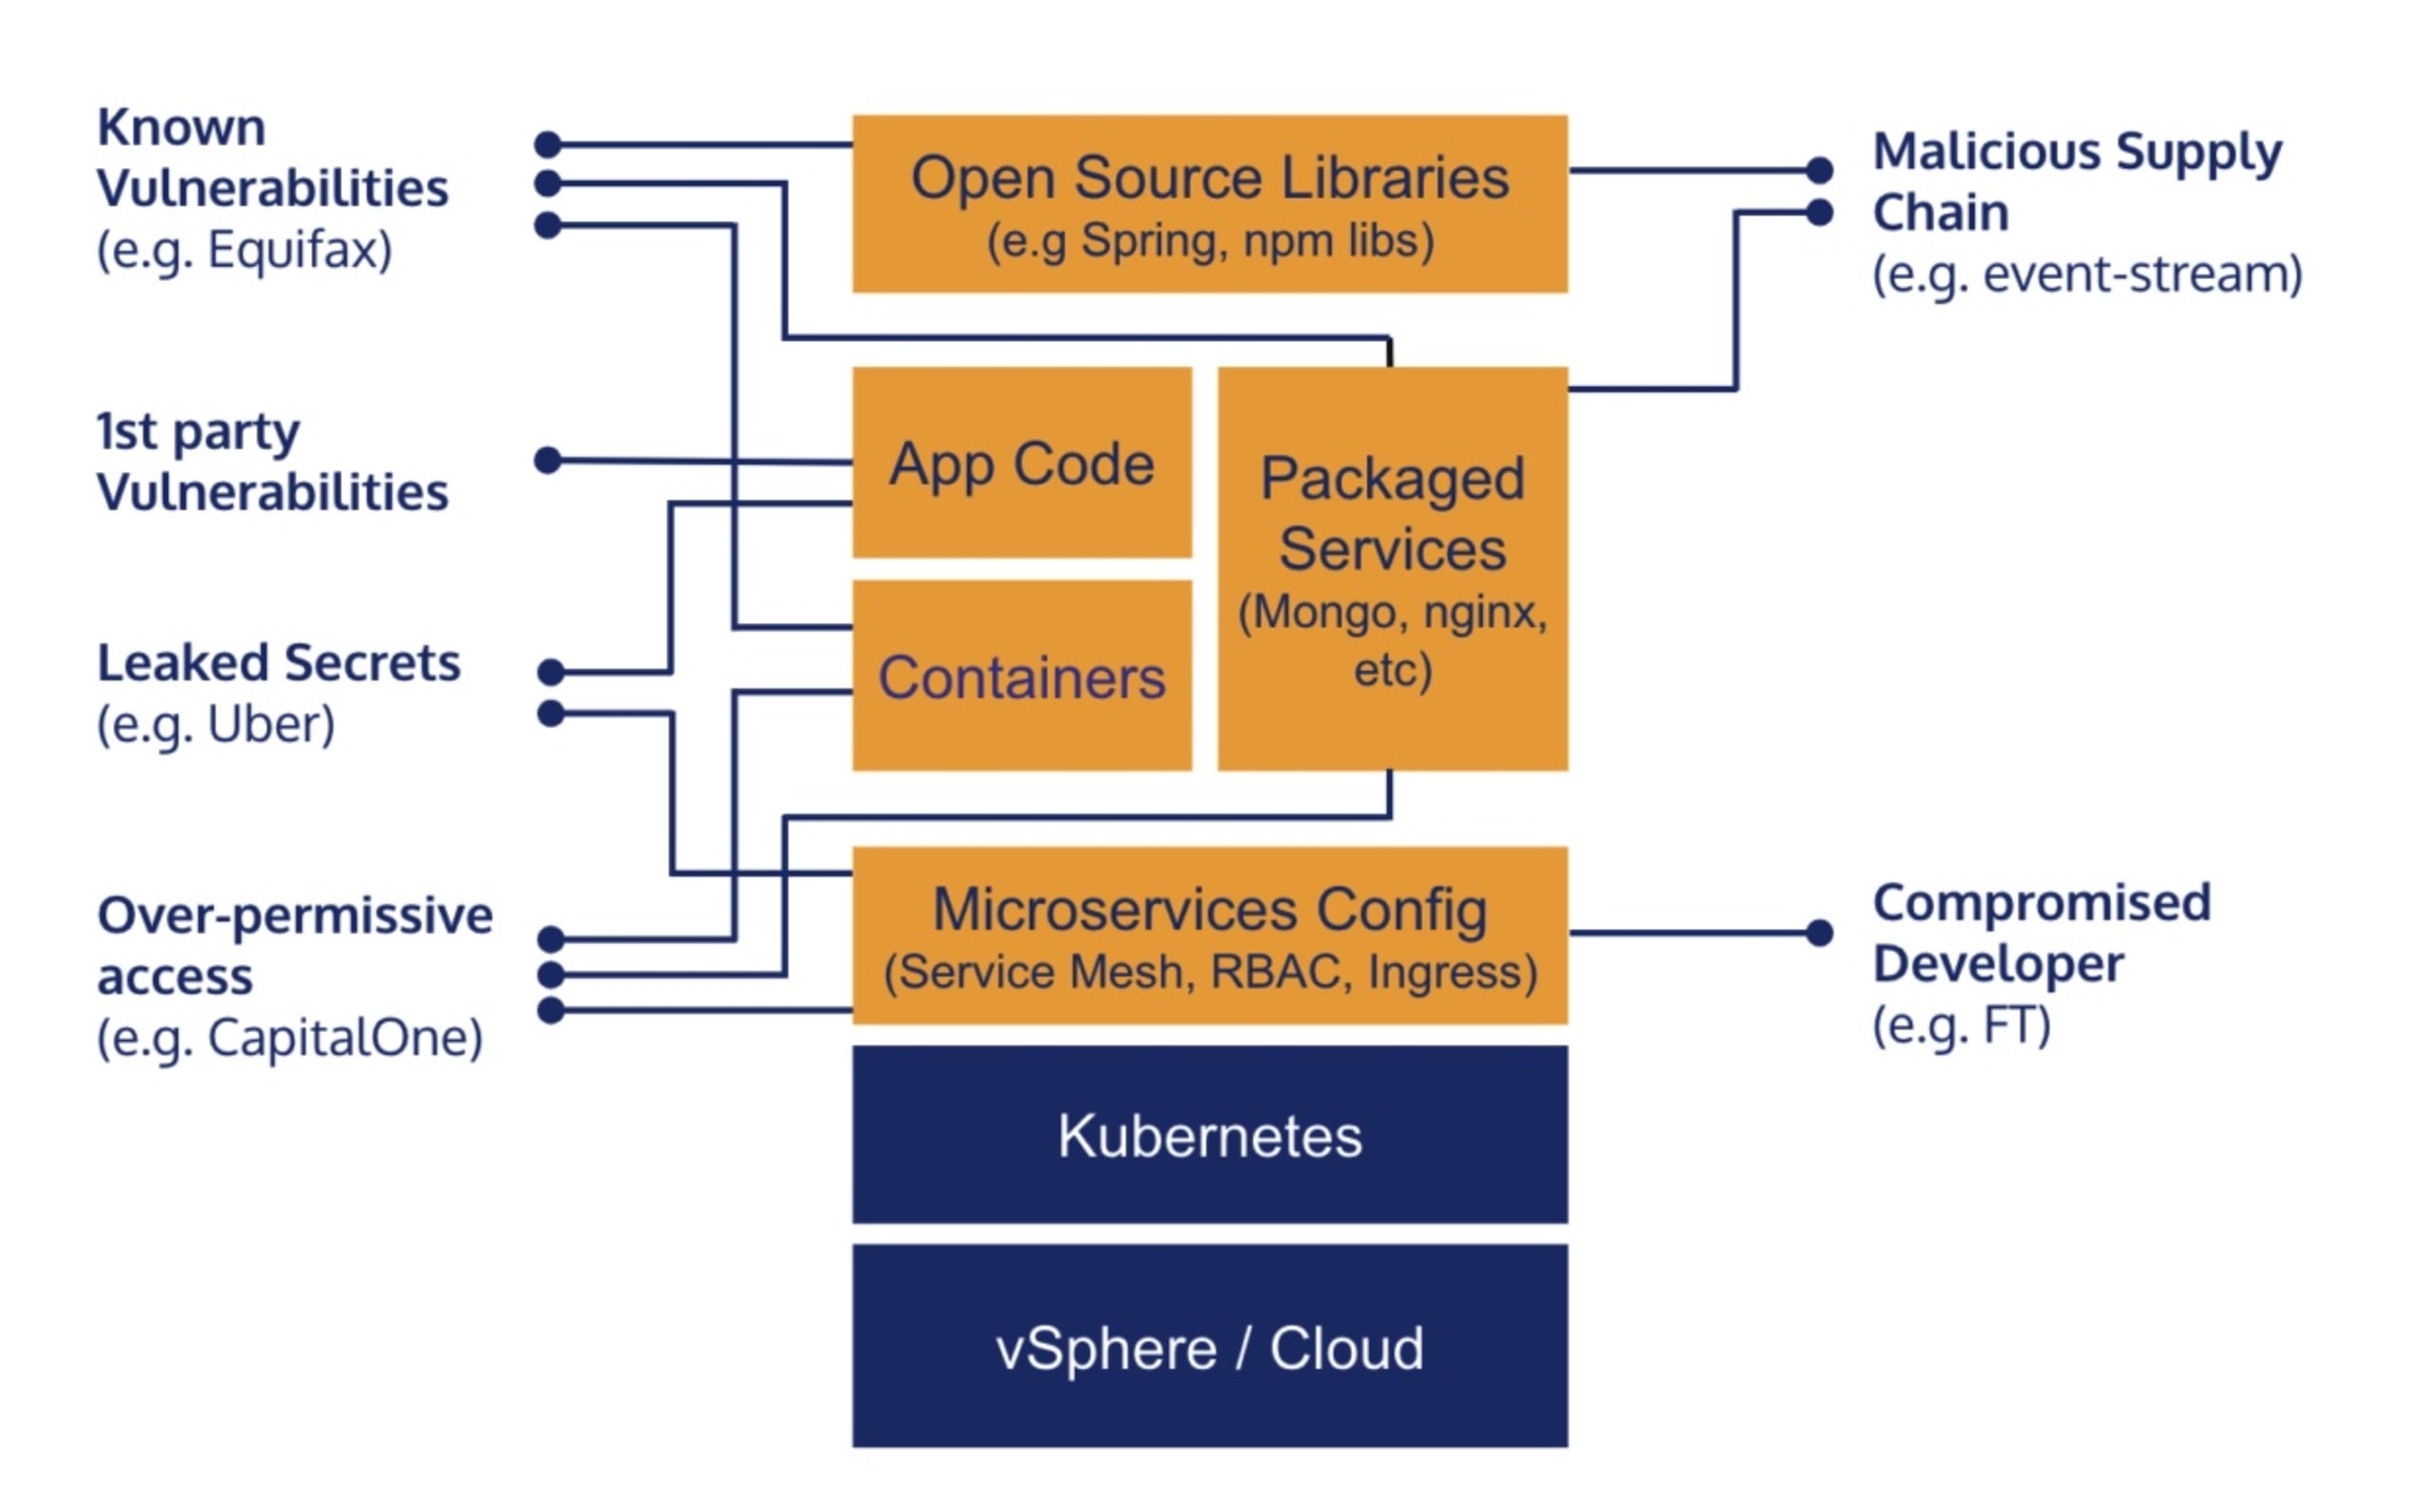
Un conteneur non corrigé peut être piraté aussi facilement qu’une machine virtuelle négligée ou une machine physique. Un port ouvert sans nécessité peut donner à un attaquant accès à des données sensibles, quel que soit leur emplacement d’hébergement. Et des données non chiffrées dans une base de données peuvent rapidement être compromises, surtout si elles sont stockées dans un service partagé. Les mêmes vecteurs d’attaque s’appliquent : nous devons rester vigilants face à ces risques et prendre des mesures pour protéger nos applications.
Ce qui doit changer, c’est la manière dont nous nous défendons contre ces menaces liées à l’infrastructure.Aujourd’hui, les solutions et pratiques sont conçues pour les équipes informatiques centrales, et non pour des équipes applicatives autonomes. Elles sont parfois adaptées après coup pour être utilisées par des équipes distinctes, mais elles répondent rarement vraiment à leurs besoins.
Nous devons adopter une nouvelle perspective, fondée sur cette nouvelle réalité : « l’infrastructure comme application ». Cette remise en question est une vaste entreprise que je ne peux résumer en quelques points, mais voici quelques changements à envisager :
Repensez l’organisation de vos équipes de sécurité pour sécuriser les produits cloud. La sécurité des piles informatiques a été conçue pour s’intégrer à l’organisation informatique. Celle des piles applicatives, elle, doit être structurée de façon à collaborer avec les équipes de développement. J’aurais beaucoup plus à dire sur le sujet, mais cela fera sans doute l’objet d’un article à part…
Comprenez les besoins des développeurs d’applications. Prenez le temps de comprendre leur réalité, et pas seulement leur technologie, et adaptez vos pratiques, vos outils et vos attentes en conséquence. Les bonnes pratiques du secteur répondent souvent aux besoins de l’informatique, pas à ceux du développement : ne vous y fiez pas systématiquement.
Ne partez pas du principe que vos solutions pré-cloud sont adaptées aux applications cloud. Il peut être pratique de conserver les mêmes outils pour vos anciennes et nouvelles piles, mais il est peu probable qu’ils conviennent aux deux réalités. Renseignez-vous sur les autres outils proposés par votre fournisseur, ou par d’autres fournisseurs, et choisissez ceux qui sont adaptés à l’environnement cloud.
Investissez dans des outils de sécurité flexibles, pilotés par API et en libre-service. Les équipes informatiques sont une fonction centrale : vous pouvez donc consacrer plus de temps à des intégrations personnalisées. Les équipes et les piles de développement, elles, varient bien davantage. Investissez dans des outils capables de s’adapter à différents environnements tout en assurant des contrôles de sécurité et une gouvernance cohérents.
Cette transition ne se fera pas du jour au lendemain. D’ici dix ans, les applications pré-cloud seront considérées comme des systèmes hérités, au même titre que les environnements mainframe aujourd’hui, avec leurs contrôles de sécurité obsolètes. C’est maintenant qu’il faut commencer à bâtir la nouvelle génération de sécurité.