Qualité de l’IA : déchets en entrée, déchets en sortie

11 juin 2024
0 minutes de lectureSi vous utilisez des ingrédients périmés et moisis pour préparer un dessert, vous obtiendrez peut-être quelque chose qui a l’air appétissant, mais qui a un goût affreux. Et vous n’auriez certainement pas envie de le servir à vos invités. Le principe « déchets en entrée, déchets en sortie » (GIGO) ne s’applique pas qu’à la technologie et à l’IA. Utiliser de mauvais ingrédients dans une recette peut produire un résultat potentiellement toxique. Bien sûr, s’il a l’air un peu suspect, vous pouvez le recouvrir de glaçage, et personne n’y verra rien. C’est le danger auquel nous sommes confrontés aujourd’hui.
Avec l’IA/ML, tout semble réussi. Vous pouvez utiliser votre bot préféré et récupérer un bout de code qui a l’air parfait. Il est commenté, correctement indenté et peut même utiliser une bibliothèque pour vous aider. Mais si le lait était avarié et que le bot l’a pris dans le réfrigérateur, votre code risque d’avoir tourné.
On parle souvent du principe GIGO de manière théorique, mais examinons un exemple concret. J’ai enseigné un cours d’intelligence artificielle à l’université et, dans le cadre de ce cours, nous avons créé un système expert à l’aide d’un arbre de décision.
Un système expert est un type de programme informatique d’intelligence artificielle (IA) qui reproduit la capacité d’un expert humain à prendre des décisions dans un domaine ou un champ de connaissances donné. Il est conçu pour résoudre des problèmes complexes, formuler des recommandations ou fournir des conseils de niveau expert à partir d’un ensemble de règles, de connaissances et de raisonnements logiques. Dans notre exemple, il résoudra un problème très simple.
Un système expert s’appuie sur une base de connaissances. C’est là que le système stocke les informations propres à un domaine, les faits, les règles et les heuristiques. Il dispose également d’un moteur d’inférence, qui constitue le composant de raisonnement du système expert. Celui-ci utilise les connaissances de la base pour tirer des conclusions, prendre des décisions et résoudre des problèmes. Il met en œuvre différentes techniques de raisonnement, comme le chaînage avant (partir de faits connus pour parvenir à des conclusions) ou le chaînage arrière (partir d’un objectif et remonter jusqu’aux éléments qui le justifient). Mais ce qui nous intéresse ici, ce sont les données contenues dans le système.
Le principe du devoir que j’ai proposé était simple. Le programme devait deviner un animal à partir des caractéristiques indiquées par l’utilisateur. S’il se trompait, il ajoutait une nouvelle caractéristique au système.
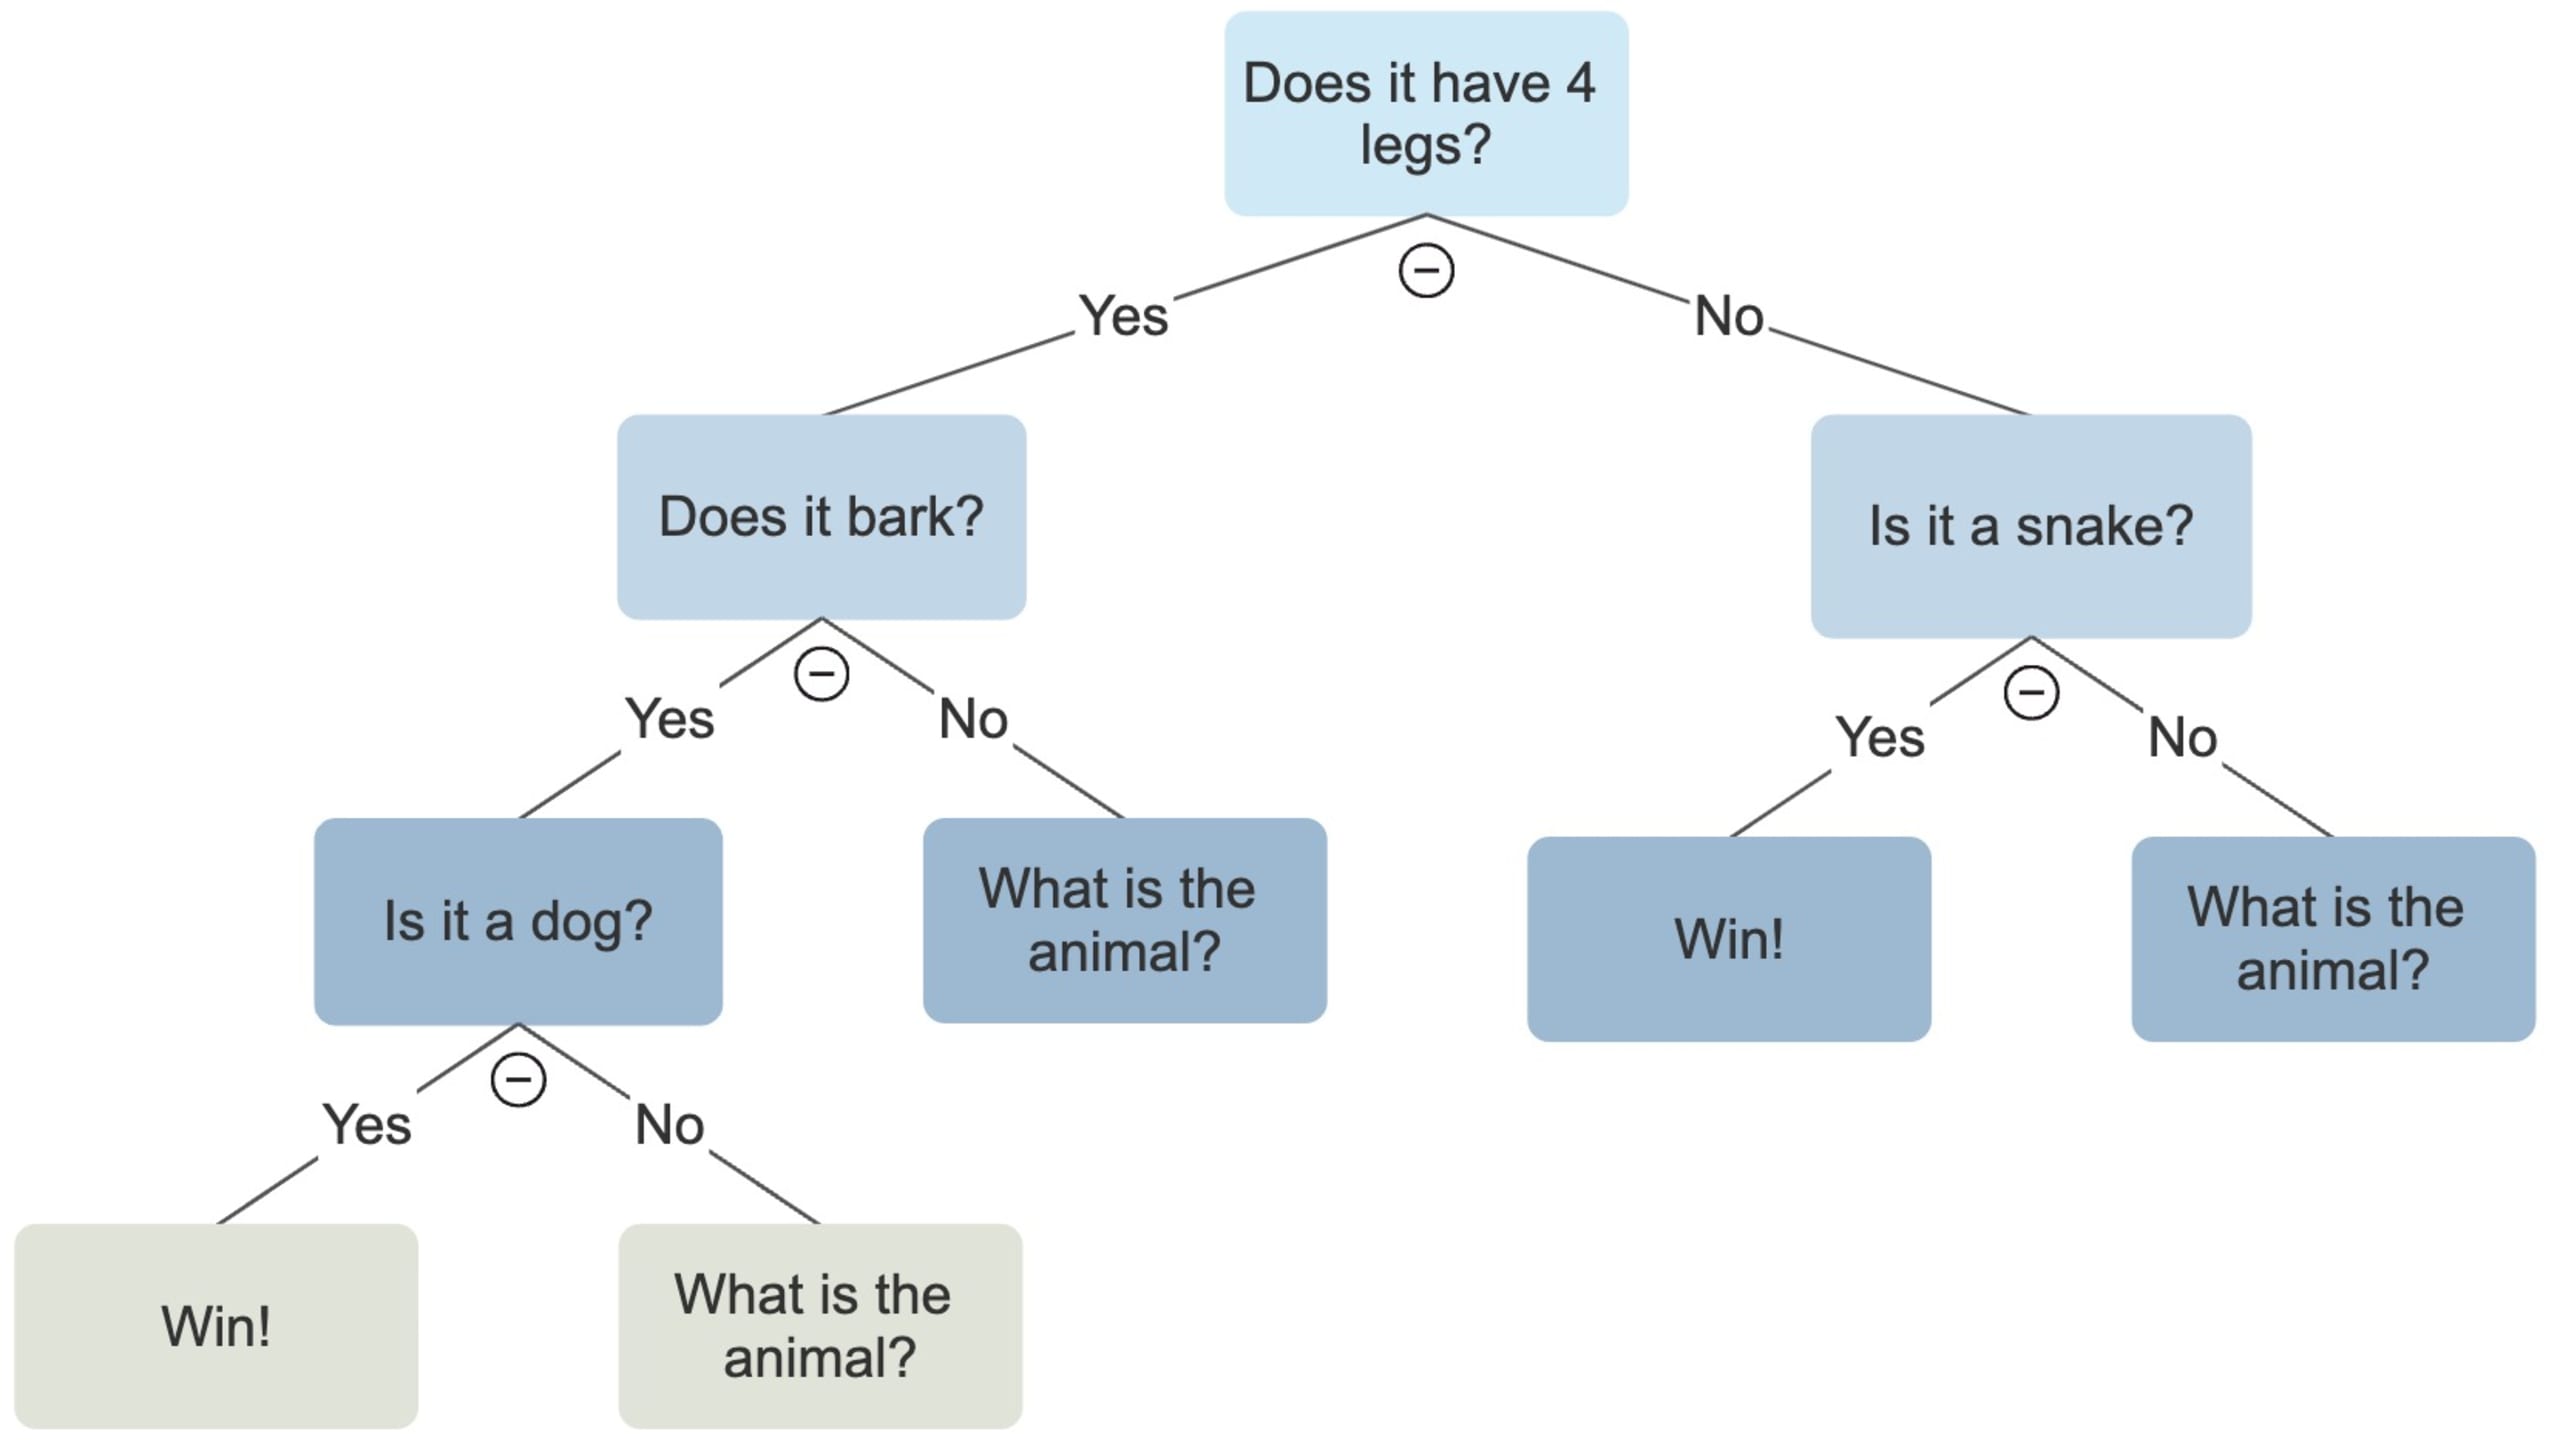
Avec ce système expert, le programme peut sembler apprendre et ainsi manifester une forme d’intelligence artificielle. Par exemple, si l’utilisateur pense à un chat, le système répondra d’abord OUI à la question de savoir s’il a quatre pattes, puis NON à celle de savoir s’il aboie. Le système demandera ensuite de quel animal il s’agit, puis posera la question suivante : « Quelle question permettrait de distinguer un chat d’un chien ? »
Dans ce cas, l’utilisateur pourrait répondre : « Est-ce qu’il miaule ? »
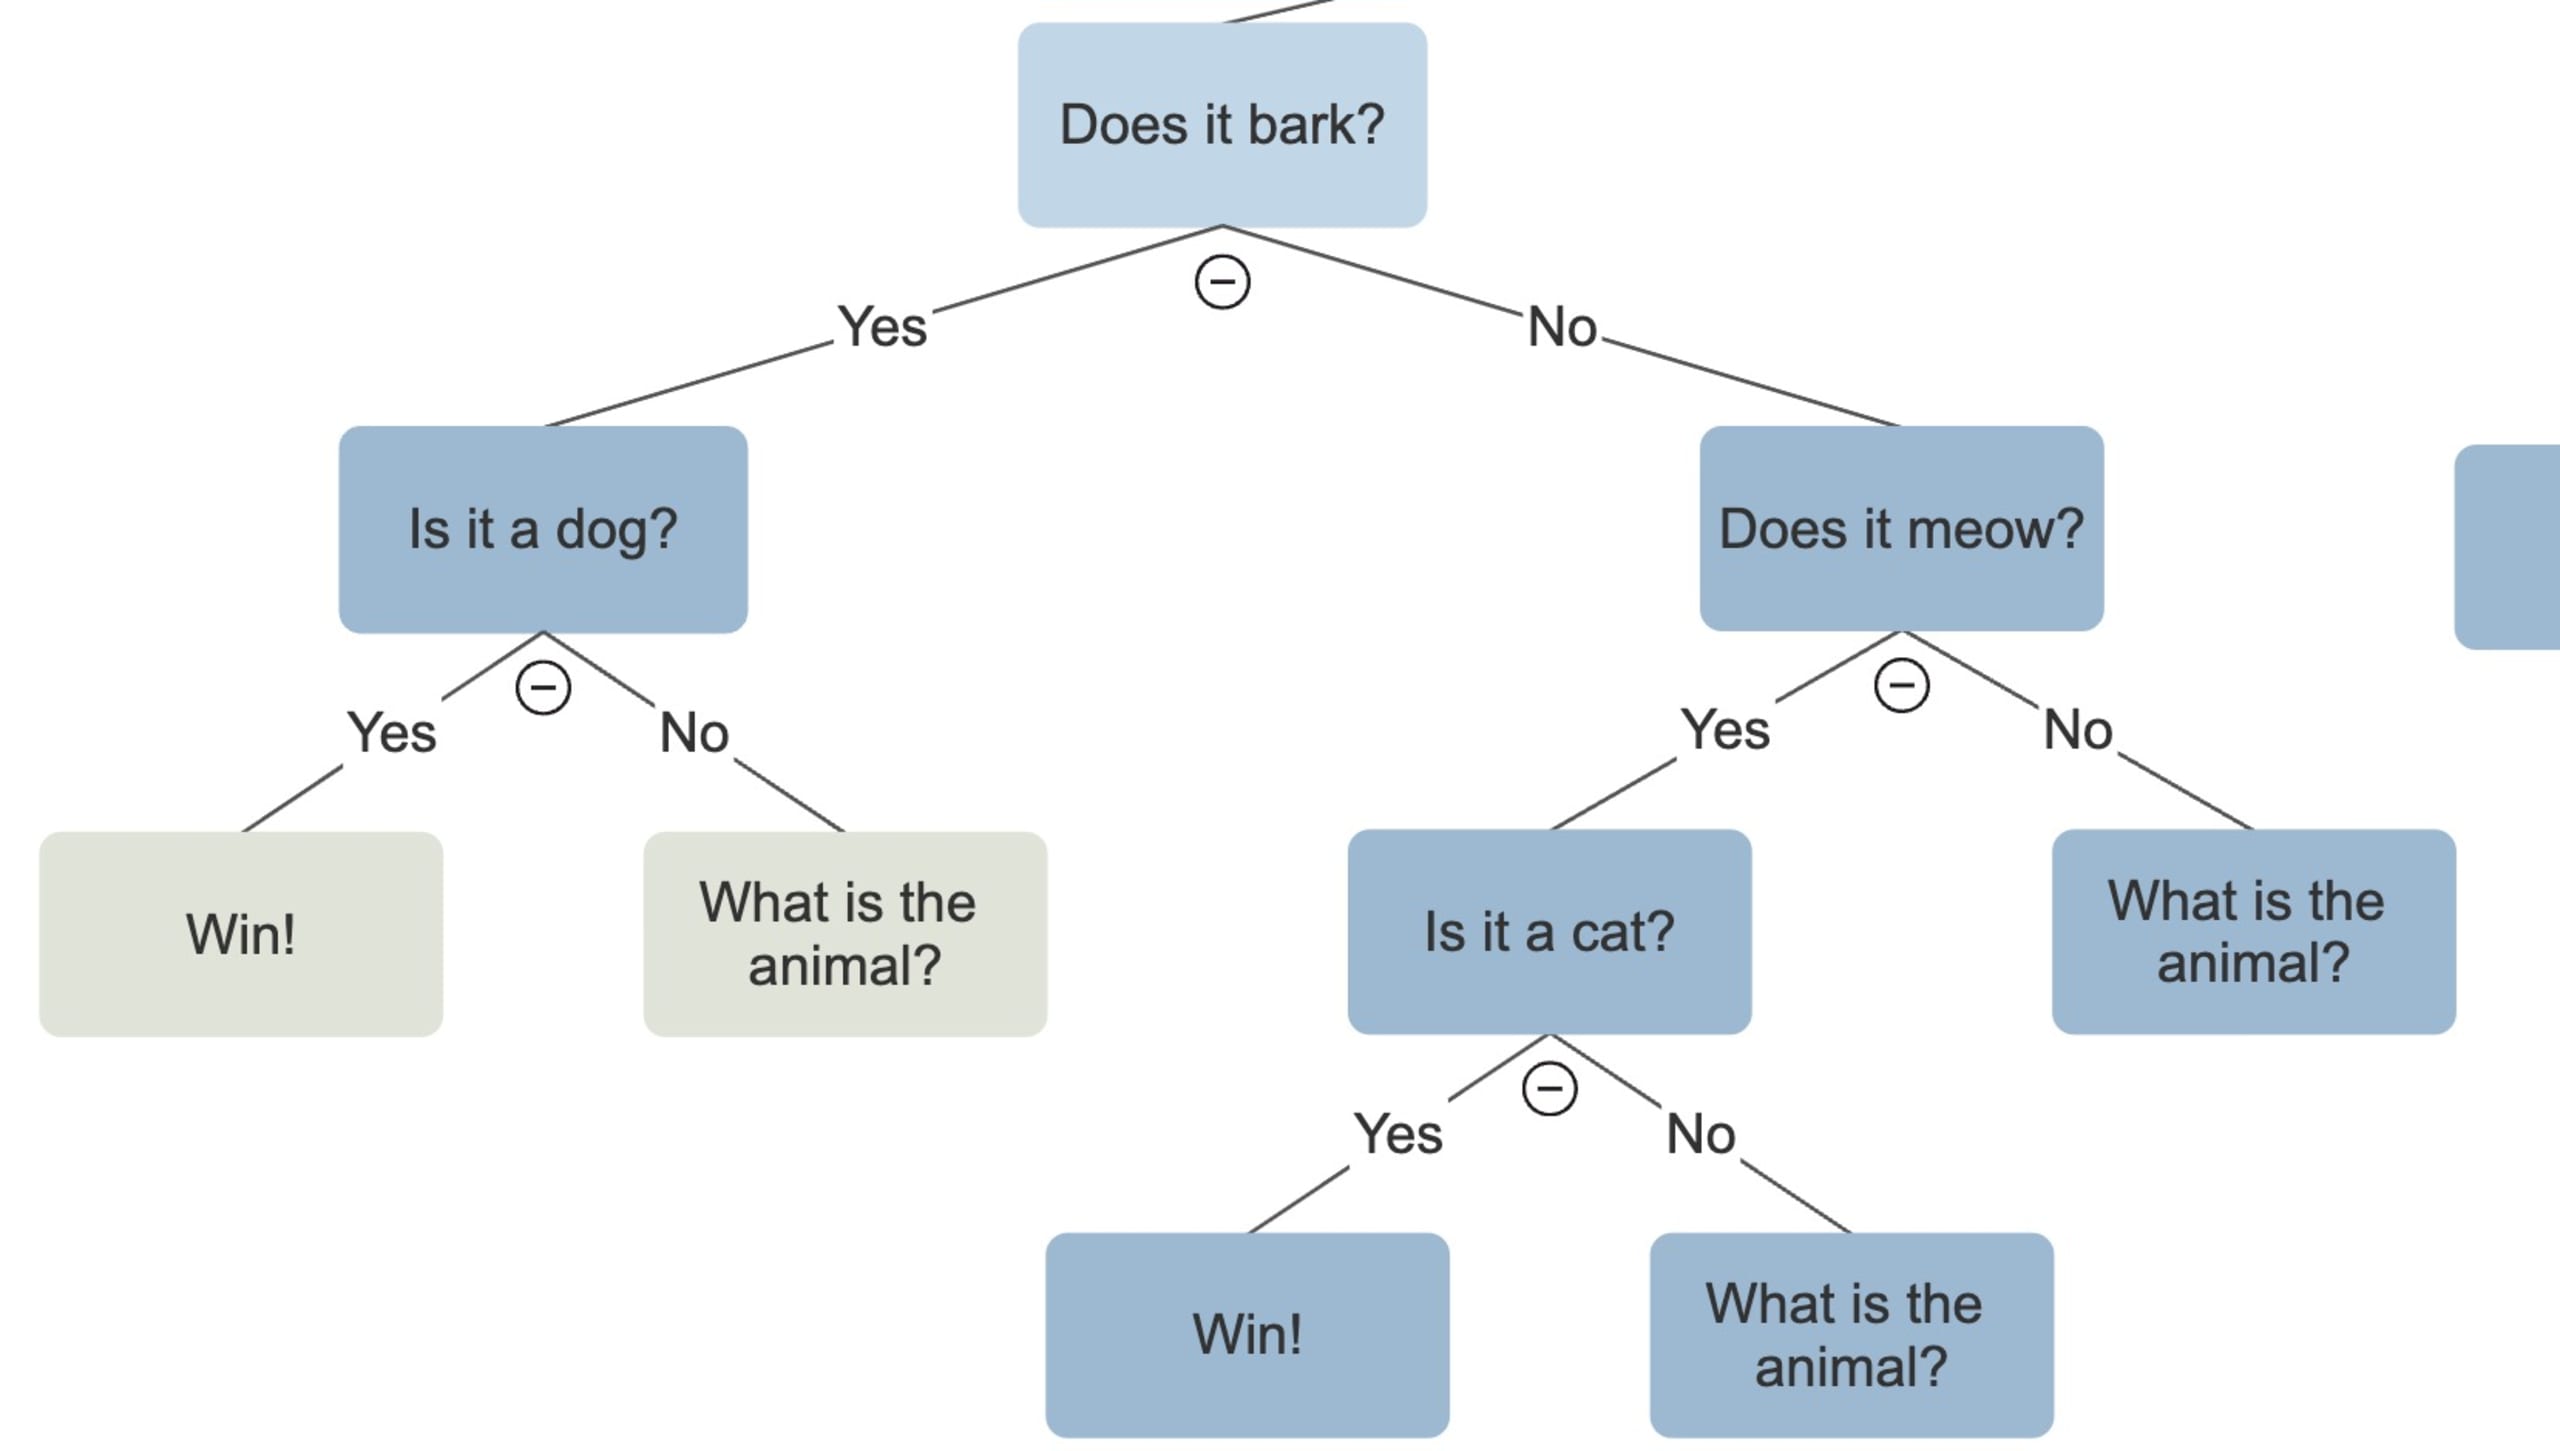
Demander à un utilisateur de construire ce système un animal à la fois est incroyablement inefficace. Mais n’oubliez pas qu’il ne s’agissait que d’un devoir destiné à apprendre le fonctionnement des arbres de décision et des systèmes experts. Après 100 parties, le jeu pourrait compter 100 nouveaux animaux. Si un autre utilisateur y jouait, le système aurait de bonnes chances de deviner l’animal auquel il pense.
Mais tout cela repose sur une seule chose : des données de qualité.
Et si un utilisateur décidait qu’un chat aboie bel et bien, qu’un cheval miaule et qu’une vache grogne ? Le système fonctionnerait-il toujours ? Oui. Produirait-il des résultats souhaitables ? Non.
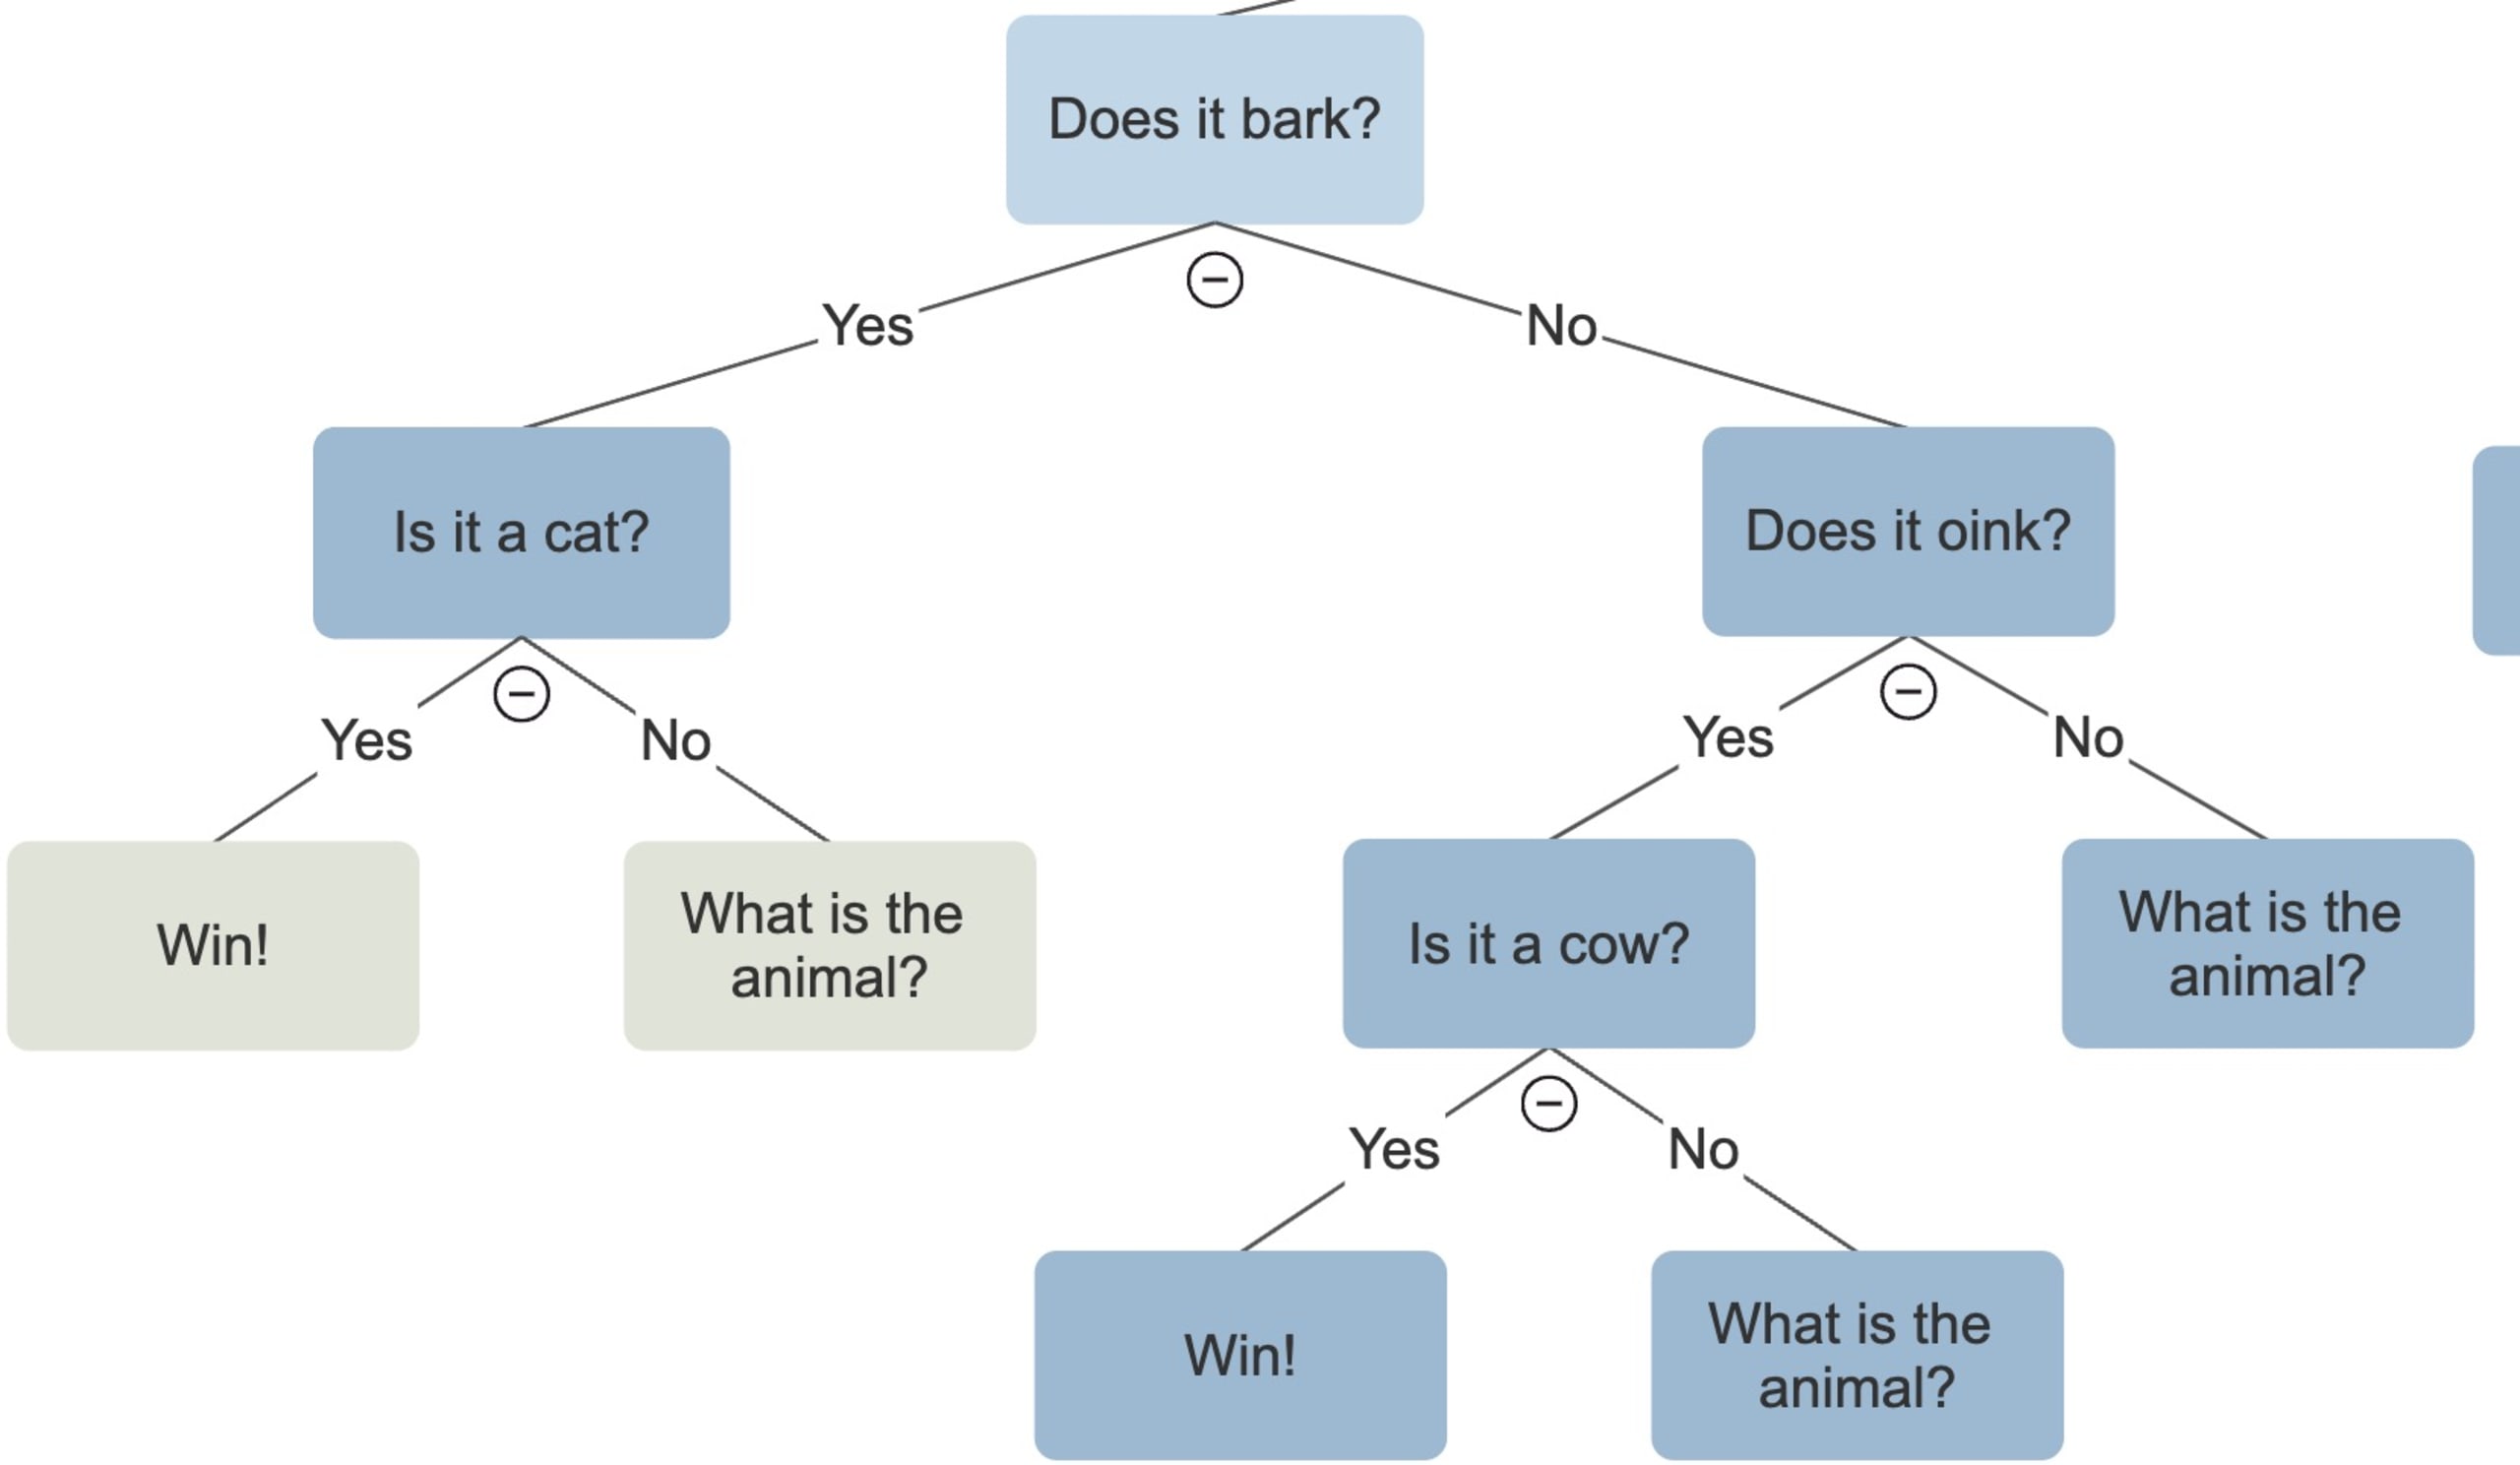
Les systèmes experts (comme de nombreux autres systèmes d’IA) peuvent échouer à cause de données incomplètes ou biaisées, de saisies humaines et de bien d’autres facteurs. Si nous demandons à une IA de générer du code, elle le fait en s’appuyant sur les données existantes (données d’entraînement). Si ces données sont incorrectes, contiennent des erreurs ou sont biaisées, les résultats présenteront les mêmes défauts.
Les systèmes experts et les LLM sont très différents. L’un s’appuie sur une base de connaissances, tandis que l’autre apprend à partir de motifs et d’associations. Pourtant, tous deux sont concernés par le principe GIGO et dépendent fortement de données exactes.
Si vous fournissez des données de mauvaise qualité à un système d’IA, vous obtiendrez des résultats tout aussi mauvais, avec des conséquences concrètes. Et nous en constatons déjà les effets. Nos recherches ont révélé que plus des trois quarts des développeurs contournent les protocoles établis pour utiliser des outils de complétion de code, malgré les risques potentiels.
Pour en savoir plus sur les vulnérabilités de l’IA, consultez les 10 principaux risques des LLM selon l’OWASP ainsi que notre plateforme de formation à la sécurité et ses leçons sur l’IA.