Créer un résumé des actualités de sécurité avec un agent IA CrewAI
Écrit par

0 minutes de lecture
Parcourir de nombreuses sources d’actualités sur la sécurité et bases de données de vulnérabilités est un travail fastidieux. Mais avec l’essor des workflows d’IA agentique, nous pouvons confier cette tâche à un LLM. Cet article montre comment utiliser le framework open source CrewAI pour créer un agent IA qui sélectionne les actualités de sécurité.
Des agents IA pour sélectionner les actualités de sécurité
Pour l’application que nous allons créer, nous allons nous concentrer sur la sélection de nouvelles vulnérabilités de sécurité dans la Snyk Vulnerability Database, afin de créer un fil d’actualités sur la sécurité.
Notre agent IA sera un outil en ligne de commande qui ouvre la page Web de la Snyk Vulnerability Database pour un écosystème donné (nous utiliserons l’écosystème JavaScript npm) et sélectionne les trois rapports CVE les plus pertinents et, selon lui, les plus importants.
Bien démarrer avec CrewAI
Pour commencer, nous allons créer un répertoire de projet à l’emplacement de votre choix dans votre environnement de développement local, puis y initialiser le framework CrewAI.
Voici les prérequis :
Le gestionnaire de packages uv est installé et disponible localement
Un environnement d’exécution Python >= 3.x (peut être installé avec
uv)
Dans le répertoire de votre choix, commençons par installer la bibliothèque et les outils crewai :
Ajoutez-la ensuite à l’environnement de votre shell pour pouvoir exécuter la commande crewai comme un exécutable global :
Nous pouvons maintenant créer la structure d’un nouveau projet crewai :
Installez ensuite les dépendances du projet en exécutant cette commande :
Le répertoire du projet créé devrait maintenant ressembler à ceci :
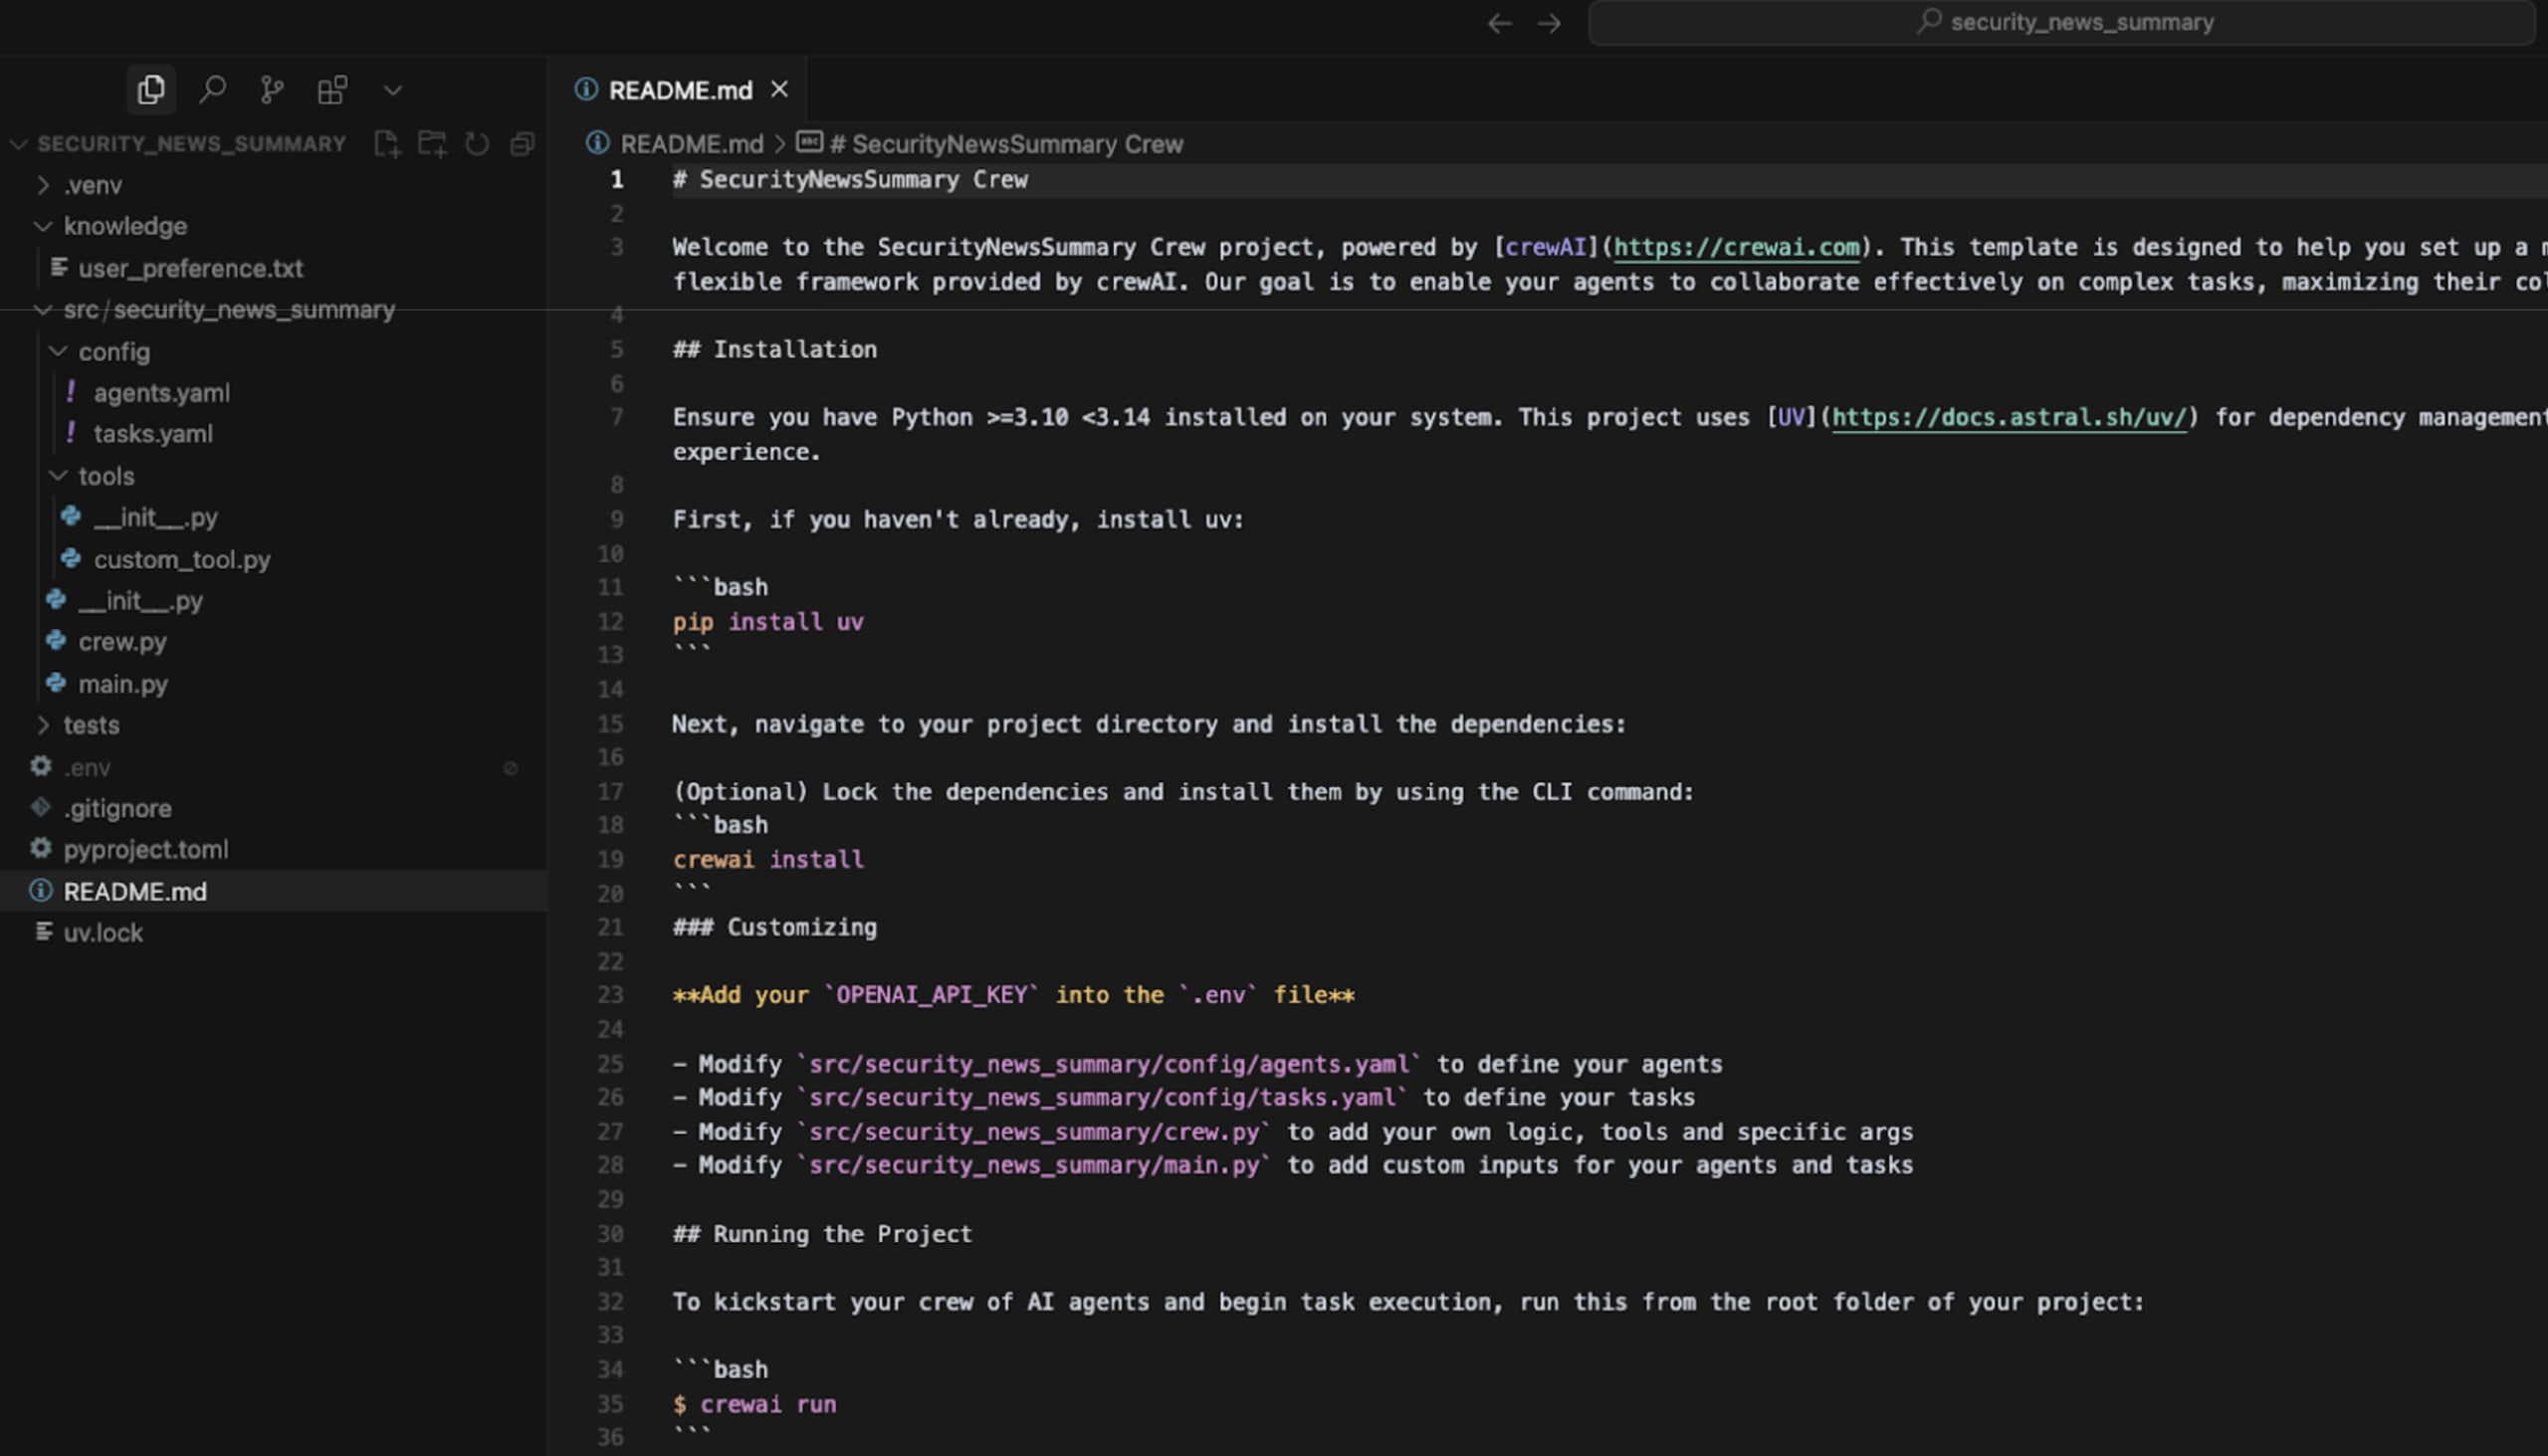
Dans les grandes lignes, CrewAI utilise un fichier crew.py qui définit les agents et les tâches :
Le même fichier contient également les tâches que nous voulons confier à ces agents :
Le fichier main.py exporte plusieurs fonctions, comme run(), train() et d’autres, qui invoquent les agents et leur fournissent les données nécessaires à leur travail.
Voici le déroulement du lancement des agents dans le fichier Python principal :
Tout ce qui précède décrit la structure de projet par défaut créée par CrewAI. Nous allons toutefois la modifier pour définir nos propres agents et tâches, et créer un outil personnalisé que les agents pourront appeler.
Créer des workflows agentiques personnalisés avec CrewAI
Nous allons modifier trois éléments principaux du répertoire de projet CrewAI :
Modifications des agents dans
config/agents.yamlModifications des tâches dans
config/tasks.yamlModifications du programme Python CrewAI principal crew.py
Nous allons également créer un outil personnalisé dans le répertoire tools/ pour analyser le code HTML d’une page Web à l’aide de BeautifulSoup, une bibliothèque Python populaire.
Agents IA
En règle générale, il est préférable de décomposer les tâches confiées aux agents IA en éléments aussi petits que possible. Comme en génie logiciel et en conception, diviser les problèmes complexes en problèmes plus simples est une approche efficace.
Pour mettre ce conseil en pratique, nous allons définir deux agents :
Un conservateur de CVE, chargé de trouver sur la page Web les liens vers les CVE qu’il juge les plus importants.
Un analyste de CVE, chargé de consulter les pages Web de ces CVE et d’en extraire les données.
Ouvrez config/agents.yaml et remplacez la définition des agents créée par CrewAI par ce qui suit :
Tâches
Nous devons ensuite définir les tâches correspondantes :
La première tâche consiste à extraire les liens vers les CVE depuis le répertoire de la base de données des vulnérabilités (la page Web principale qui affiche les résultats de recherche et la liste des vulnérabilités).
La tâche suivante de l’agent analyste de CVE consiste à extraire les données de vulnérabilité depuis la page d’information de chaque CVE.
Ouvrez le fichier config/tasks.yaml et remplacez son contenu, créé par la bibliothèque CrewAI, par ce qui suit :
Vous remarquerez que les tâches sont formulées avec soin pour que nos agents IA puissent les interpréter et les respecter. Elles comprennent notamment un exemple de résultat attendu et des règles à suivre.
Outils personnalisés
Pour la première tâche et notre premier agent, le conservateur de CVE, nous devons créer notre propre outil en Python. C’est nécessaire, car l’outil CrewAI intégré ScrapeWebsiteTool extrait uniquement le texte d’une page Web. Il ne peut pas analyser davantage le code HTML source pour extraire les éléments d’ancrage (<a href>) contenant les liens vers les données de chaque CVE sur la page.
Pour commencer à créer un outil personnalisé que nos agents pourront utiliser, ouvrez le fichier tools/__init__.py, puis modifiez-le pour exporter un nouvel outil TableScraperTool comme suit :
À noter : MyCustomTool était déjà présent dans la structure de projet créée à partir de l’exemple CrewAI.
Créez ensuite l’outil TableScraperTool : ajoutez un nouveau fichier tools/table_scraper.py, puis insérez-y le code Python suivant :
Enfin, nous devons ajouter la bibliothèque Python BeautifulSoup au projet. Modifiez donc la liste dependencies dans myproject.toml pour l’inclure comme suit :
Appliquez ensuite les modifications avec la commande suivante :
Fichier d’exécution principal de CrewAI
Intéressons-nous maintenant au fichier principal crew.py, que vous trouverez dans le répertoire src/security_news_summary ou dans un autre répertoire où vous avez créé la structure du projet CrewAI.
Modifiez d’abord les instructions d’importation du fichier pour y inclure notre outil personnalisé TableScraperTool :
Faites ensuite défiler le fichier jusqu’aux fonctions annotées pour les agents (annotation @agent) et les tâches (annotation @task), puis modifiez-les pour qu’elles correspondent aux agents et tâches que nous venons de définir :
Exécuter des agents IA avec CrewAI
Voilà, c’est prêt. Nous pouvons maintenant lancer nos agents IA pour sélectionner de nouvelles vulnérabilités de sécurité à partir de la Snyk Vulnerability Database.
Il ne nous reste plus qu’à lancer les agents CrewAI depuis le terminal avec cette commande :
Les agents IA se mettent alors au travail :
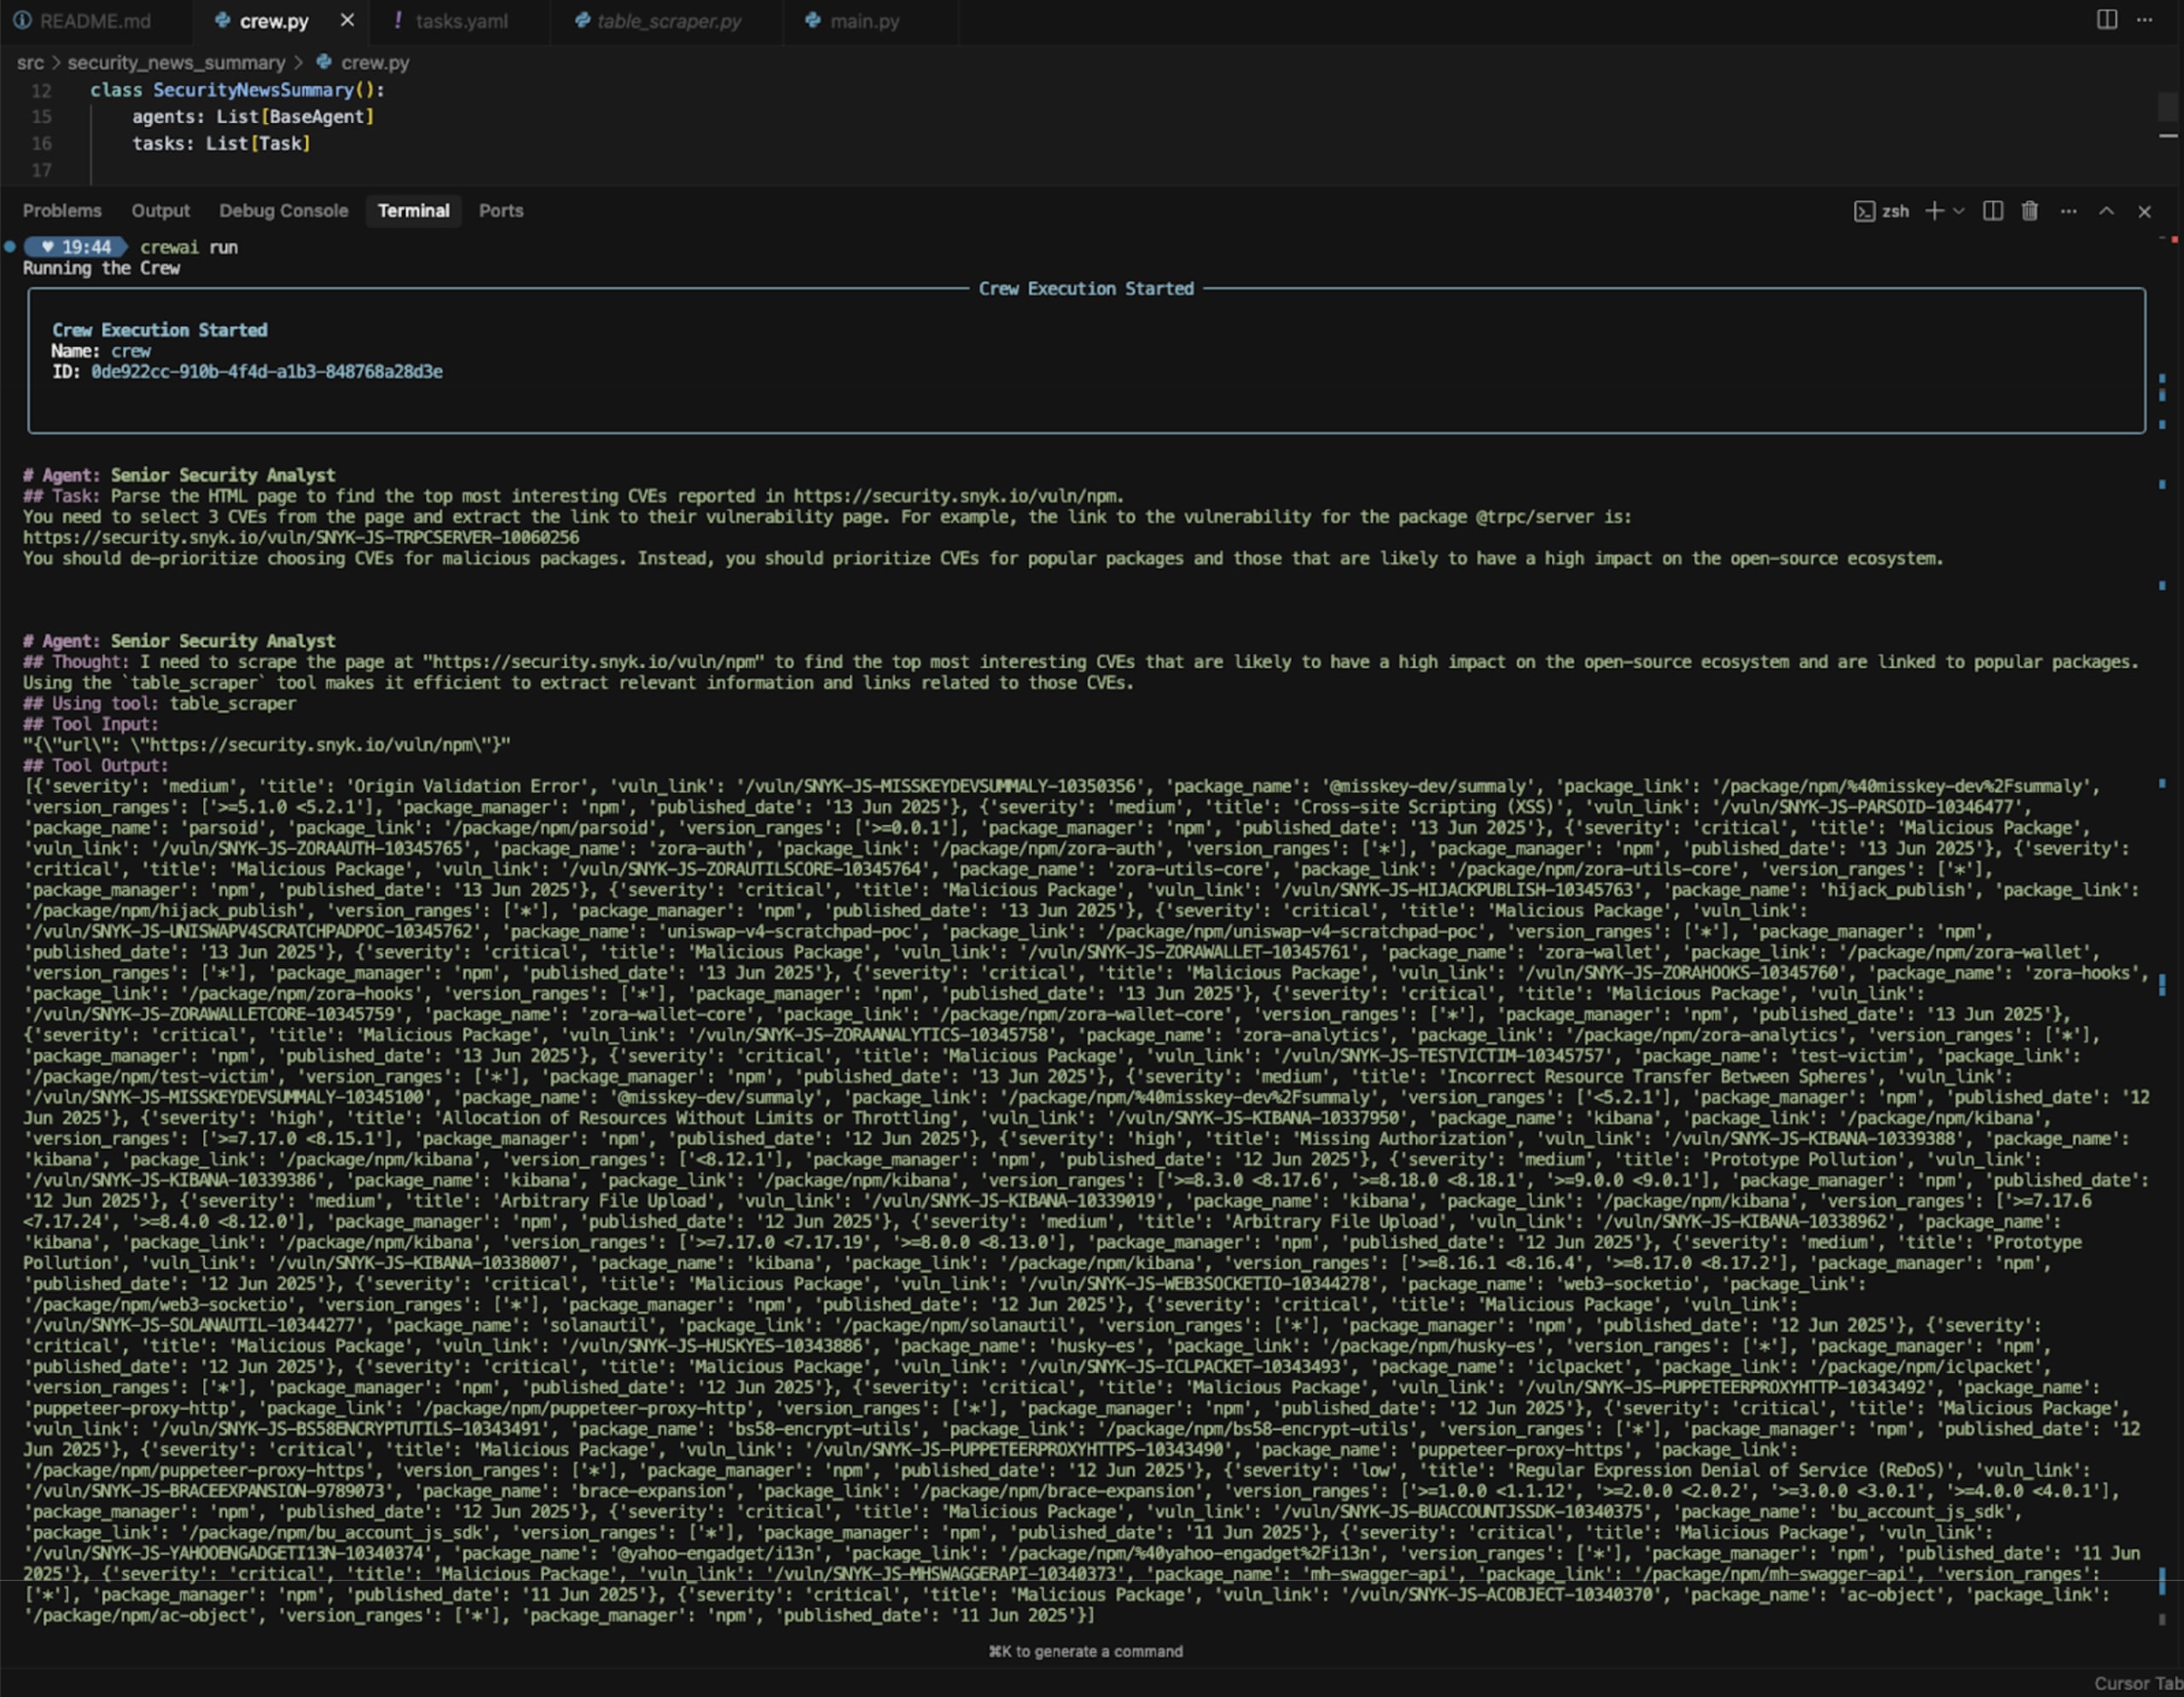
Les tâches s’affichent au fil de leur progression :

À propos de la sécurité de l’IA et des workflows agentiques
Créer des agents IA a quelque chose de magique. Quand tout fonctionne, les résultats sont étonnamment bons, et la bibliothèque CrewAI, qui orchestre les agents, est très simple à utiliser.
Les workflows de codage avec l’IA et les agents évoluent très rapidement. Il est donc essentiel de rester vigilant quant à la fiabilité de l’IA et de mettre en place des garde-fous de sécurité pour éviter les risques et les failles, comme le déploiement non sécurisé de serveurs MCP, les attaques par injection de prompt et les autres vecteurs de vulnérabilité liés à l’IA.
Voici les ressources que je vous recommande :
Consultez les garde-fous de sécurité pour le code IA de Snyk
Sécuriser le codage avec l’IA avec Snyk (et les serveurs MCP)
Comprendre les attaques par injection de prompt : techniques, défis et risques.
Sécurisez le développement avec l’IA dès le départ
Découvrez comment intégrer la sécurité à chaque étape de votre workflow de développement avec l’IA, grâce aux conseils pratiques de nos experts.