Evaluación comparativa de la corrección segura y funcional: cómo Snyk Agent Fix mejora en más del 14 % las tasas de corrección de los modelos de frontera


18 de agosto de 2026
0 minutos de lecturaResumen
Evaluamos qué tan bien los principales modelos generan correcciones de vulnerabilidades que son seguras y funcionales en cerca de 150 muestras de código vulnerable real en JavaScript, Java y Python. Probamos cada modelo por separado y con Snyk Intelligence (la nueva arquitectura agentic de Agent Fix). Estos son los principales hallazgos:
Los modelos de frontera listos para usar se agrupan entre el 72 y el 75 %. Gemini 3.1 Pro, Claude Sonnet 4.6 y Claude Opus 4.6 quedan a pocos puntos entre sí. En cuanto a las correcciones seguras y funcionales, la elección del modelo apenas cambia el resultado.
Snyk Intelligence permite que los mismos modelos superen ese grupo. Opus 4.6 sube del 74.6 % al 85.4 %, una mejora de 10.8 puntos (un 14.48 % más de muestras corregidas). La diferencia está en el contexto de seguridad, no en el modelo.
La mejora es mayor donde el modelo tiene más dificultades. Opus por sí solo corrige apenas el 64 % de las muestras de Python; con Snyk Intelligence, llega al 88 %.
Introducción
Existen evaluaciones comparativas de agentes de programación para generar pruebas unitarias, corregir errores al estilo de SWE-bench y completar código. Sin embargo, no hay una evaluación pública de uso extendido para la tarea que realmente le importa a un equipo de seguridad: tomar código con una vulnerabilidad conocida y generar una corrección que elimine la vulnerabilidad y mantenga el código en funcionamiento. Son dos requisitos independientes, y cumplir uno mientras se falla el otro es un problema frecuente y costoso. Una corrección que elimina una inyección SQL pero cambia los resultados de la consulta no ayuda a nadie. Una corrección que parece adecuada, pero deja la inyección intacta, es aún peor porque parece una solución.
Por eso creamos una evaluación comparativa que califica ambos requisitos en cada corrección y probamos los modelos de frontera dos veces: por sí solos y con la inteligencia de seguridad de Snyk. Queríamos responder, en términos sencillos: ¿cuánto cambia el contexto de seguridad de Snyk lo que un modelo de frontera puede corregir y en qué casos?
En resumen: los modelos listos para usar se estancaron alrededor del 72–75 %, y Snyk Intelligence es lo que les permite superarlo. En el resto de esta publicación presentamos los datos y el método.
Cómo medimos: la evaluación comparativa Golden Test
La mayoría de las evaluaciones de código verifican si el código se ejecuta o si resuelve un reporte de error. Ninguna de las dos basta para la corrección de vulnerabilidades, que debe cumplir a la vez con un requisito de seguridad y uno de funcionalidad. Nuestro conjunto de evaluación, Golden Tests, está diseñado para medir ambos. El diseño se inspira en SWE-bench y está adaptado para seguridad.
Las muestras
El conjunto contiene cerca de 150 muestras de código vulnerable real: 50 en Python, 54 en JavaScript y 39 en Java. Cada muestra es un fragmento de código con exactamente una vulnerabilidad, detectada por Snyk Code y confirmada por un experto en seguridad, y se seleccionó para que pueda corregirse con el código disponible, sin que falte contexto externo.
La puntuación
Cada muestra incluye dos pruebas unitarias verificadas por personas:
Una prueba que falla porque la vulnerabilidad está presente, y
Una prueba que pasa cuando se conserva la funcionalidad original del código (por ejemplo, una función auxiliar que debe repetir «hello world» sigue devolviendo «hello world» después de la corrección).
Para aprobar, el modelo debe corregir el código de modo que ambas pruebas pasen, en el primer intento y sin haber visto ninguna de las pruebas. El modelo nunca ve las pruebas unitarias, así que aprobar demuestra que la corrección es realmente segura y funcional, en lugar de estar ajustada a una prueba conocida.
Tomemos una muestra de Python con una inyección SQL: el código crea una consulta concatenando la entrada del usuario. La prueba de seguridad envía una carga de inyección SQL y verifica que la base de datos no revele todas las filas; el código vulnerable no pasa la prueba. La prueba funcional envía un nombre de usuario común y verifica que se devuelva el registro correcto; el código original la pasa. La corrección solo cuenta si la reescritura del modelo hace que la prueba de seguridad pase y mantiene en verde la prueba funcional, en el primer intento y sin haber visto las pruebas.
Qué evaluamos
Seis configuraciones: el modelo interno de Agent Fix anterior de Snyk, basado en StarCoder; tres modelos de frontera listos para usar (Gemini 3.1 Pro, Claude Sonnet 4.6 y Claude Opus 4.6); y Sonnet 4.6 y Opus 4.6, cada uno con Snyk Intelligence y la nueva arquitectura agentic de Agent Fix. Aquí, «Snyk Intelligence» se refiere a la generación dinámica de ejemplos: al momento de corregir, incorporamos las correcciones relevantes escritas por expertos para esa debilidad específica, extraídas de la base de datos de Snyk, que contiene más de 35,000 vulnerabilidades. (Esto se basa en trabajos anteriores en los que la misma idea mejoró el rendimiento de los LLM listos para usar.)
¿Cómo se compara la evaluación de Snyk Agent Fix con las evaluaciones anteriores?
Golden Test forma parte de una línea de investigación que ha elevado progresivamente el nivel de las evaluaciones de IA para código. SWE-bench estableció el método de calificar modelos con pruebas reales ocultas, en lugar de basarse en la plausibilidad que declaran por sí mismos. En seguridad, Vul4J introdujo vulnerabilidades reproducibles junto con pruebas que demuestran la vulnerabilidad y un conjunto de pruebas de regresión funcional, el antecedente más cercano a nuestro diseño de FALLA a APROBACIÓN y de APROBACIÓN a APROBACIÓN. Trabajos más recientes, como BaxBench y SEC-bench, refuerzan la premisa que guía nuestro trabajo: el código funcionalmente correcto suele seguir siendo inseguro, por lo que una evaluación creíble de correcciones debe medir ambas propiedades a la vez. Lo que distingue a Golden Test es aplicar ambos criterios a la vez, en muestras reales verificadas por personas, con las pruebas ocultas para el modelo y en tres lenguajes de producción.
Resultados
La métrica principal es la proporción de Golden Tests en las que la corrección fue segura y funcional.
Configuración | Tasa de correcciones funcionales y seguras |
|---|---|
StarCoder (modelo anterior de Agent Fix) | 72.4 % |
Gemini 3.1 Pro | 74.2 % |
Claude Sonnet 4.6 | 72.4 % |
Claude Opus 4.6 | 74.6 % |
Claude Sonnet 4.6 + Snyk Intelligence | 82.5 % |
Claude Opus 4.6 + Snyk Intelligence | 85.4 % |
GRÁFICA 1: Tasa de correcciones funcionales y seguras.
Los modelos listos para usar quedan dentro de un rango de tres puntos. Al agregar Snyk Intelligence, se abre una brecha de 8 a 11 puntos con el mismo modelo: Opus 4.6 pasa del 74.6 % al 85.4 %.
Al desglosar por lenguaje la comparación de Opus, se ve que la mejora no es un artefacto del promedio. Se mantiene en todos los lenguajes que probamos y es mayor donde el modelo listo para usar tiene más dificultades.
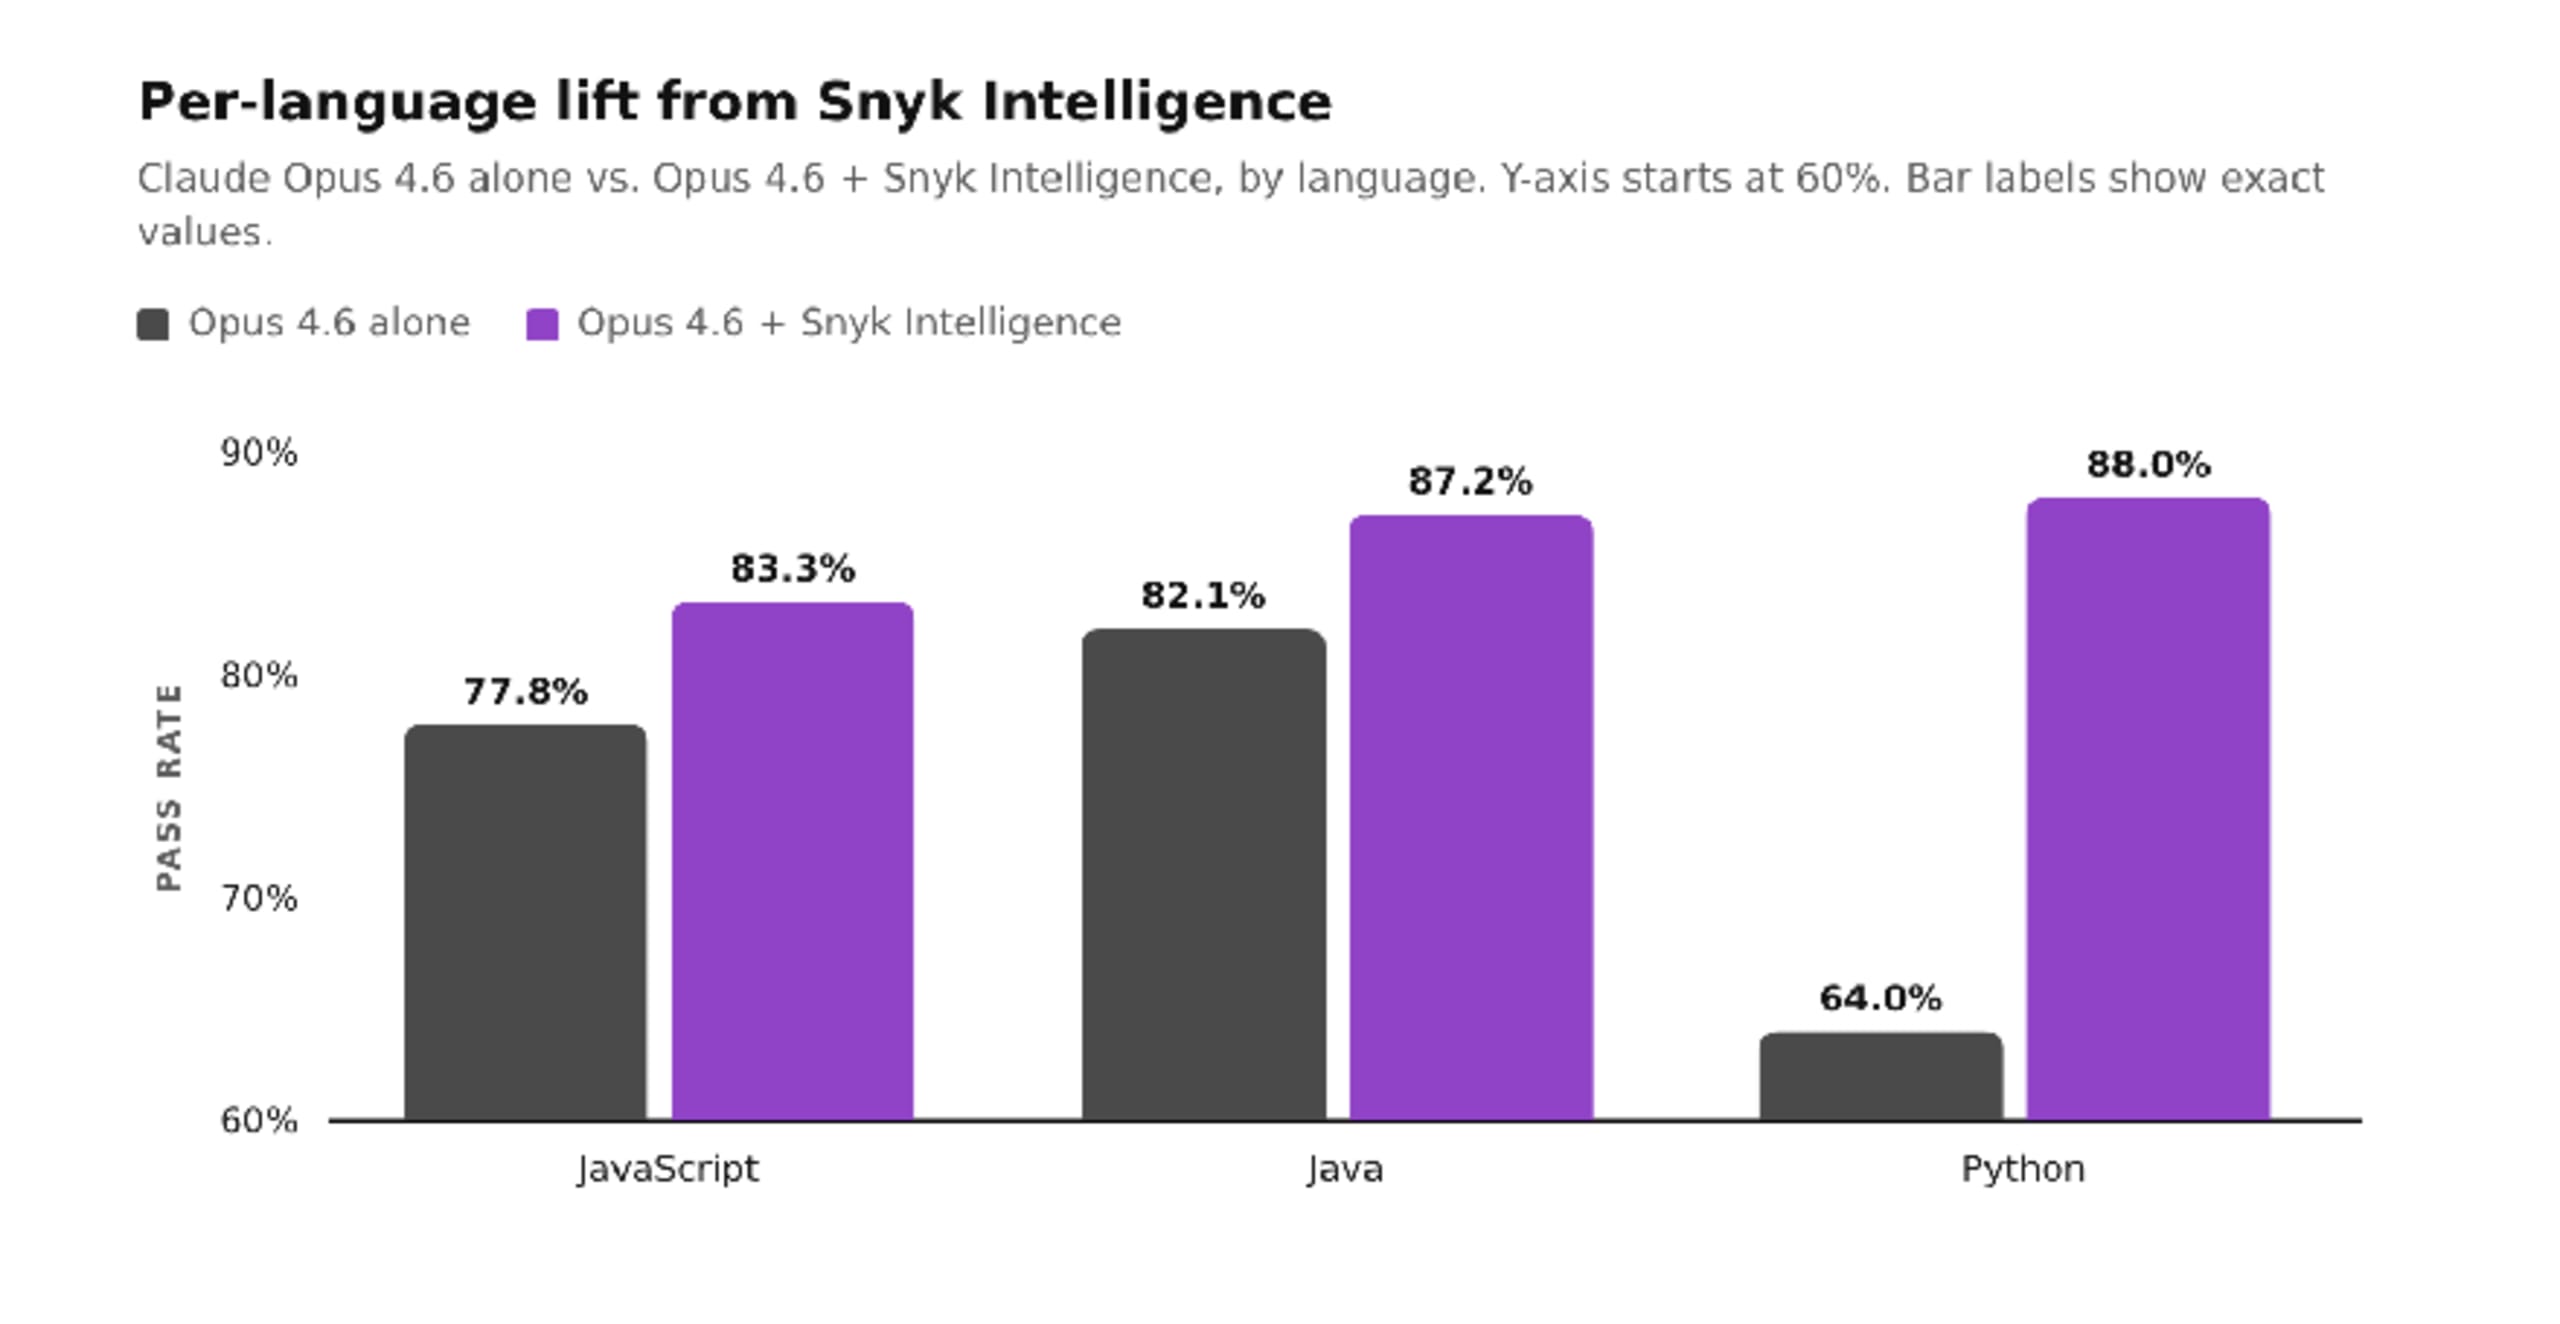
GRÁFICA 2: Mejora por lenguaje de programación
Python es el caso más claro: Opus por sí solo corrige el 64.0 % de las muestras; con Snyk Intelligence, la cifra sube al 88.0 %. JavaScript y Java, donde Opus ya parte de un nivel alto, mejoran entre cinco y seis puntos cada uno.
Qué significan las cifras
El tamaño bruto del modelo se ha estancado en las correcciones seguras y funcionales
Los tres modelos listos para usar van del 72.4 % al 74.6 %, una diferencia de 2.2 puntos entre dos proveedores. Si un modelo más grande o más nuevo fuera la clave para esta tarea, esperaríamos verlo aquí. No es así. Esta tarea es difícil por motivos que una mayor capacidad general no resuelve directamente: el modelo debe saber cómo es una corrección segura para esta debilidad, no limitarse a escribir código plausible.
El factor clave es el contexto de seguridad, no un modelo más grande
Opus 4.6 mejora 10.8 puntos (un 14.48 % más de muestras) únicamente gracias a los ejemplos de seguridad que se incorporan al momento de corregir. Como este enfoque es independiente del modelo, cada mejora en los modelos de frontera subyacentes se suma a ese contexto en lugar de competir con él. El activo duradero son las más de 35,000 correcciones de expertos; el modelo es un componente que podemos cambiar a medida que evoluciona el campo. Por eso, Agent Fix en producción ahora combina Snyk Intelligence con Claude Opus 4.7.
La mejora es mayor donde el modelo tiene más dificultades
Opus por sí solo corrigió apenas el 64 % de las muestras de Python, su lenguaje más difícil. Con Snyk Intelligence, llegó al 88 %, su mayor mejora de los tres lenguajes. El contexto de seguridad no solo eleva el promedio, sino también el nivel más bajo.
El resultado resiste una segunda revisión
La cifra de Opus con Snyk es un promedio de las ejecuciones (84.6 % y 86.0 % en las dos ejecuciones que agregamos), por lo que el 85.4 % principal refleja un rendimiento consistente entre ejecuciones. La variación entre ejecuciones en este conjunto es de aproximadamente un punto, algo que conviene tener en cuenta al comparar configuraciones cuyos resultados difieren por uno o dos puntos.
Próximamente: Snyk VulnBench y la detección de vulnerabilidades con agentes de programación
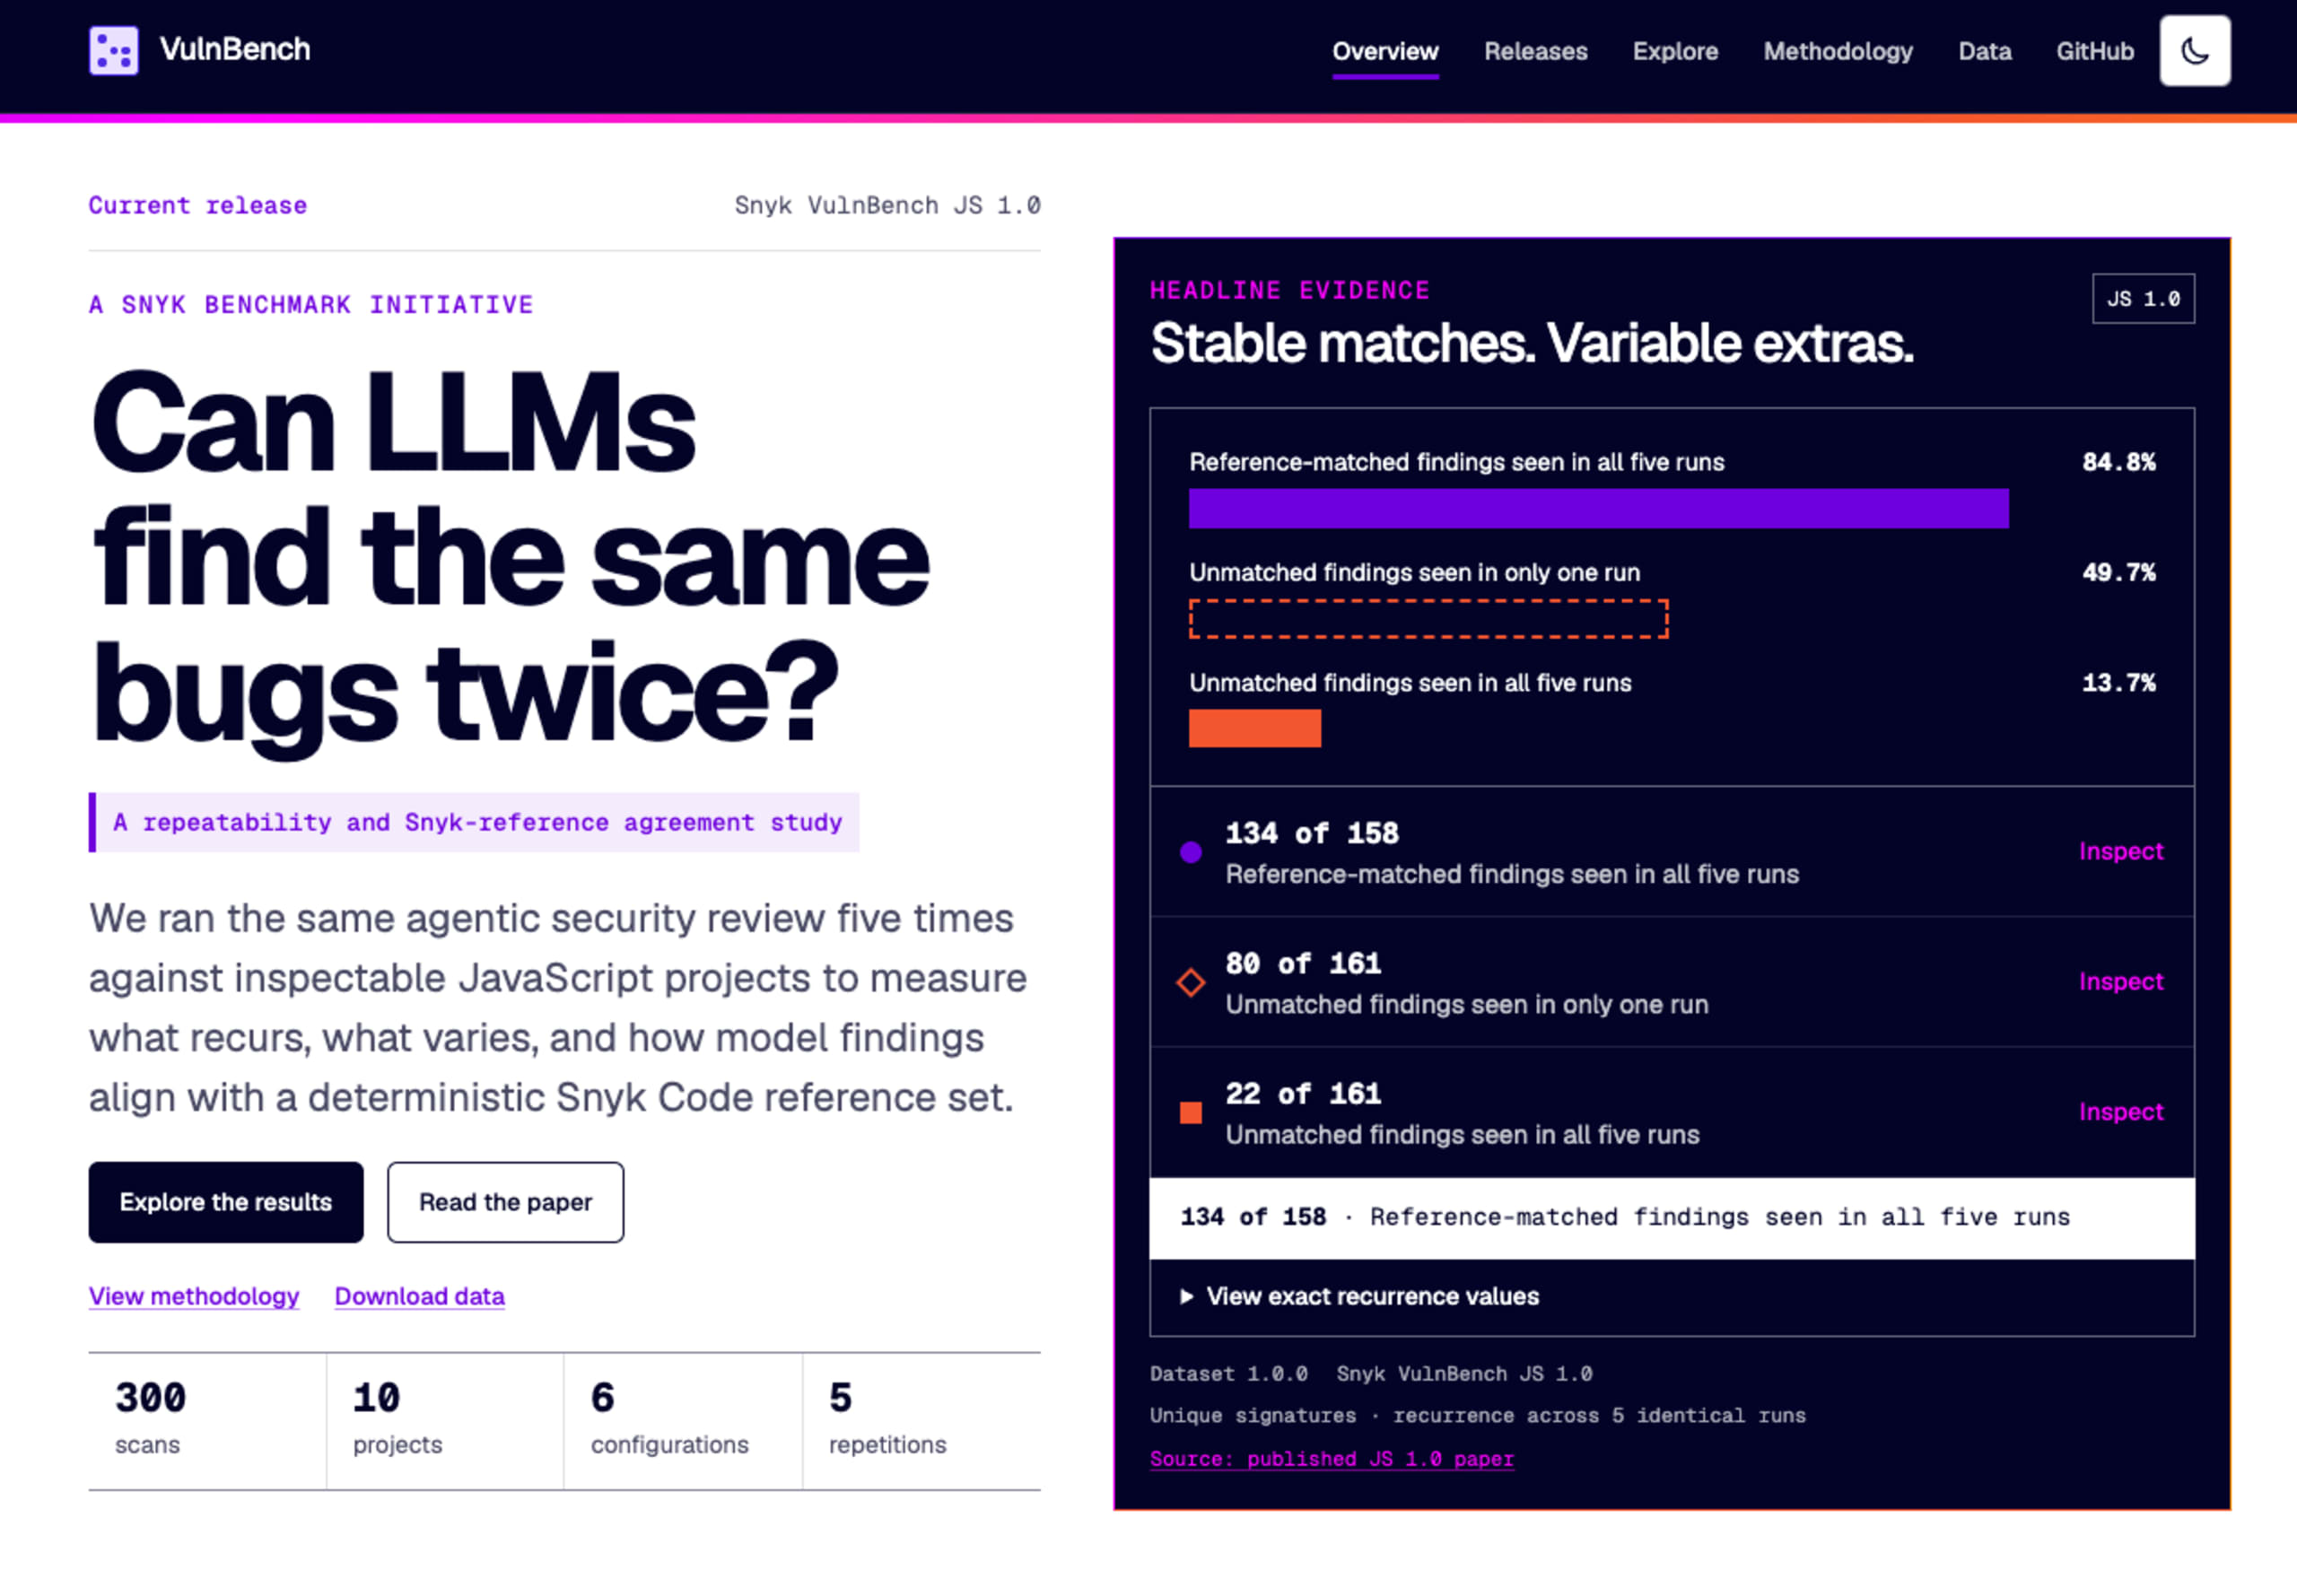
Corregir una vulnerabilidad presupone que la encontraste. En junio de 2026, publicamos el artículo de Snyk VulnBench JS 1.0, cuyo objetivo era evaluar Snyk Code como motor SAST determinista y rápido frente a los LLM impulsados por agentes de programación (el entorno de Claude Code) para detectar vulnerabilidades en el código antes de que sea necesario corregirlas.
Nuestros hallazgos de Snyk VulnBench revelaron que incluso los modelos de lenguaje grandes de frontera, como Claude Opus 4.7 con el nivel máximo de razonamiento (también llamado max), e incluso cuando se usa un entorno avanzado de agente de programación (Claude Code mismo), enfrentaban dificultades de repetibilidad y determinismo, entre otras. Algunos hallazgos destacados:
En un caso, el modelo y el agente de programación reportaron cerca del 50 % de hallazgos que no se repetían en cuatro de las cinco ejecuciones siguientes, lo que generó una acumulación de falsos positivos y fatiga por vulnerabilidades para desarrolladores agentic e ingenieros de seguridad de IA.
En otros casos, el 13 % de los agentes de programación reportaron que aparecían vulnerabilidades sin coincidencias en las cinco ejecuciones, lo que provocó una situación aún más confusa y una mayor carga cognitiva en torno a la acumulación de problemas de seguridad que podrían resultar ser falsos positivos.
Te invitamos a investigar y explorar el conjunto de datos de Snyk VulnBench, que está disponible públicamente en línea para que lo revises en https://vulnbench.com/
Limitaciones
Cuatro limitaciones que conviene considerar antes de basarse en estas cifras:
Tamaño del conjunto: Cerca de 150 muestras (50 de Python, 54 de JavaScript y 39 de Java) bastan para revelar patrones claros, pero no para afirmar que las diferencias pequeñas sean estadísticamente significativas. La línea de base de StarCoder se ejecutó con una muestra aproximadamente un 20 % más pequeña (solo reglas compatibles con Agent Fix para las que había datos de entrenamiento); con todas las reglas, obtiene un 54.9 %. Es el modelo interno de Snyk, ajustado con fine-tuning e incluido como referencia, no como modelo de frontera.
Fragmentos, no aplicaciones completas: Cada muestra es un solo archivo con una vulnerabilidad que se puede corregir a partir del contexto local. Las bases de código reales incluyen contexto entre archivos y varios problemas que interactúan; esta evaluación no mide eso.
Tres lenguajes: Evaluamos JavaScript, Java y Python. La nueva arquitectura es compatible con todos los lenguajes que admite Snyk Code, pero estos son los tres que cuentan con cobertura de Golden Test actualmente.
Pocas ejecuciones para medir la variación: Agregamos dos ejecuciones para las configuraciones potenciadas por Snyk y no hemos realizado suficientes repeticiones para publicar márgenes de error formales para cada resultado. Considera aproximadas las diferencias de menos de dos puntos.
Mencionamos estas limitaciones para ayudar a evaluar qué afirmaciones son confiables, no para restar valor a los hallazgos. La diferencia de más de 10 puntos que aporta Snyk Intelligence supera ampliamente el ruido entre ejecuciones; el orden de las pequeñas diferencias por lenguaje, no.
Qué sigue
Ampliar la cobertura de lenguajes: Extender los conjuntos de Golden Test más allá de JavaScript, Java y Python para que la evaluación refleje la compatibilidad completa de la arquitectura con distintos lenguajes.
Cuantificar la variación: Ejecutar cada configuración las veces necesarias para publicar márgenes de error adecuados, en lugar de un promedio de dos ejecuciones.
Detección, no solo corrección: Esta evaluación mide la corrección. Un proyecto complementario mide qué tan bien los agentes detectan vulnerabilidades en comparación con Snyk Code, y presentaremos los resultados por separado.
La nueva versión agentic de Agent Fix ya está implementada y combina Snyk Intelligence con Claude Opus 4.7. ¿Quieres ver correcciones seguras y funcionales en tu propio código? Empieza con Snyk Code y Agent Fix, y descubre más sobre la ingeniería detrás de estas cifras.
¿Puedes confiar en el código de IA? Creé un escáner para averiguarlo
Apéndice: metodología y agregación
Estructura de la evaluación: Cada prueba dorada consiste en una muestra de código con exactamente una vulnerabilidad, además de una prueba unitaria de seguridad (que falla con el código vulnerable) y una prueba unitaria funcional (que pasa con el código original). Una configuración supera una muestra solo si su corrección hace que ambas pruebas pasen en el primer intento, sin que el modelo tenga acceso a ellas.
Agregación: Las tasas informadas representan la proporción de muestras corregidas.
La cifra anterior del modelo StarCoder (72.4%) es el promedio de sus tasas por lenguaje y solo considera las reglas compatibles con Agent Fix; para todas las reglas, baja a 54.9%.
La cifra de Opus 4.6 + Snyk Intelligence (85.4%) es el promedio de las ejecuciones (ejecución 1 = 86.0%, ejecución 2 = 84.6%). Las cifras por lenguaje del segundo gráfico corresponden a una sola ejecución representativa, por eso su promedio es un poco más alto (~86%) que el resultado general de varias ejecuciones; la cifra general es la que debes citar.
Configuraciones: StarCoder (el modelo anterior de Agent Fix); Gemini 3.1 Pro; Claude Sonnet 4.6 y Claude Opus 4.6, cada uno sin modificaciones y con Snyk Intelligence dentro de la arquitectura agéntica de Agent Fix. Estos datos se recopilaron con Opus 4.6; desde entonces, Agent Fix en producción pasó a Claude Opus 4.7. Snyk Intelligence incorpora correcciones redactadas por expertos para la debilidad específica al momento de generar el código (prompting dinámico de pocos ejemplos).
Descubre Snyk en acción
Descubre por qué Snyk es la solución de AppSec elegida por desarrolladores y equipos de seguridad, y todo lo que puede hacer por tu equipo.