Más preciso que GPT-4: cómo CodeReduce de Snyk mejoró el rendimiento de otros LLM

7 de mayo de 2024
0 minutos de lecturaSnyk ha sido pionero en ciberseguridad impulsada por IA desde el lanzamiento de Snyk Code en 2021. El motor DeepCode AI ofreció por primera vez una precisión y velocidad inigualables para identificar problemas de seguridad en el ámbito de SAST. En los últimos 3 años, hemos visto el auge de la IA y los LLM, y Snyk ha estado a la vanguardia con la incorporación de nuevas funcionalidades basadas en IA, como Snyk Agent Fix, nuestra funcionalidad de corrección automática de vulnerabilidades, o nuestra funcionalidad de reachability para dependencias de terceros.
Hace poco anunciamos importantes mejoras en los modelos de Snyk Agent Fix, una funcionalidad beta que corrige automáticamente los problemas de seguridad identificados por Snyk Code. Snyk Agent Fix combina la tecnología de IA más reciente con capacidades internas especializadas para generar correcciones confiables. Corregir problemas de seguridad es complejo. Para conocer más sobre cómo lo hacemos, analizaremos a fondo el artículo de investigación que explica los ingredientes clave detrás de Snyk Agent Fix: la tecnología CodeReduce y nuestro conjunto de datos seleccionado de correcciones de seguridad.
Automatizar las correcciones de seguridad: un problema complejo
Los desarrolladores suelen dedicar mucho tiempo a encontrar y corregir problemas de seguridad por su cuenta. Antes de DeepCode AI, Snyk Code ayudaba a los desarrolladores con el primer paso: identificar los problemas. Pero incluso entonces, corregirlos podía ser difícil y llevar mucho tiempo, porque los desarrolladores no solían tener —y aún no suelen tener— capacitación en seguridad. Para corregir problemas de seguridad, deben revisar el código manualmente, averiguar cómo se supone que debe funcionar, comprender los problemas de seguridad en el contexto del código y luego investigar cómo solucionarlos antes de corregir el problema.
Durante años, muchas empresas han tenido como prioridad automatizar la corrección de problemas de seguridad, o la «corrección automática», con el objetivo de reducir la mayor parte del trabajo de remediación. Sin embargo, a pesar de los numerosos intentos, resultó difícil crear una solución que generara correcciones precisas. Como resultado, la mayoría de las herramientas de corrección automática se centraban en resolver solo un conjunto reducido de problemas, cambios triviales de unas pocas líneas de código o simples problemas de formato.
Con la llegada de los LLM, vimos el potencial de crear una mejor capacidad de corrección automática con esta nueva generación de IA. Sin embargo, los LLM también tienen limitaciones para corregir problemas de seguridad si no se configuran adecuadamente para obtener los resultados deseados. La mayoría se entrenó con una gran variedad de datos y código, pero no específicamente para la remediación de seguridad. Esto nos planteó dos problemas clave:
Para una tarea tan específica como la corrección automática de problemas de seguridad, los LLM necesitan aprender de un conjunto de datos especializado de correcciones de seguridad y semánticas de código para generar correcciones de código pertinentes y precisas.
Las alucinaciones y la capacidad de los LLM para procesar un contexto limitado cada vez que generan un resultado implican que agregar más código a las instrucciones para guiar a un LLM de «propósito general» (en lugar de uno entrenado específicamente para seguridad) hacia resultados más precisos no siempre ofrece mejores resultados.
Cómo superar las limitaciones de los LLM para generar mejores correcciones
Decidimos que los beneficios de usar LLM superaban el trabajo necesario para abordar los problemas identificados, así que nos propusimos resolverlos.
Conjunto de datos de correcciones
Creamos un conjunto de datos integral de correcciones de seguridad de código abierto para garantizar los mejores resultados posibles. Primero, etiquetamos exhaustivamente commits de código abierto y creamos un conjunto de datos depurado de problemas y correcciones para JavaScript (desde entonces, hemos hecho lo mismo con otros lenguajes, como Java, Python, C/C++, C#, Go y APEX). Segundo, en lugar de agregar manualmente más datos etiquetados, usamos las funciones de análisis de programas de Snyk Code, que provienen de nuestro motor DeepCode AI, para obtener de manera eficiente el mismo efecto cuantitativo que el etiquetado de datos y así crear conjuntos de datos depurados.
Tecnología CodeReduce (patente en trámite)
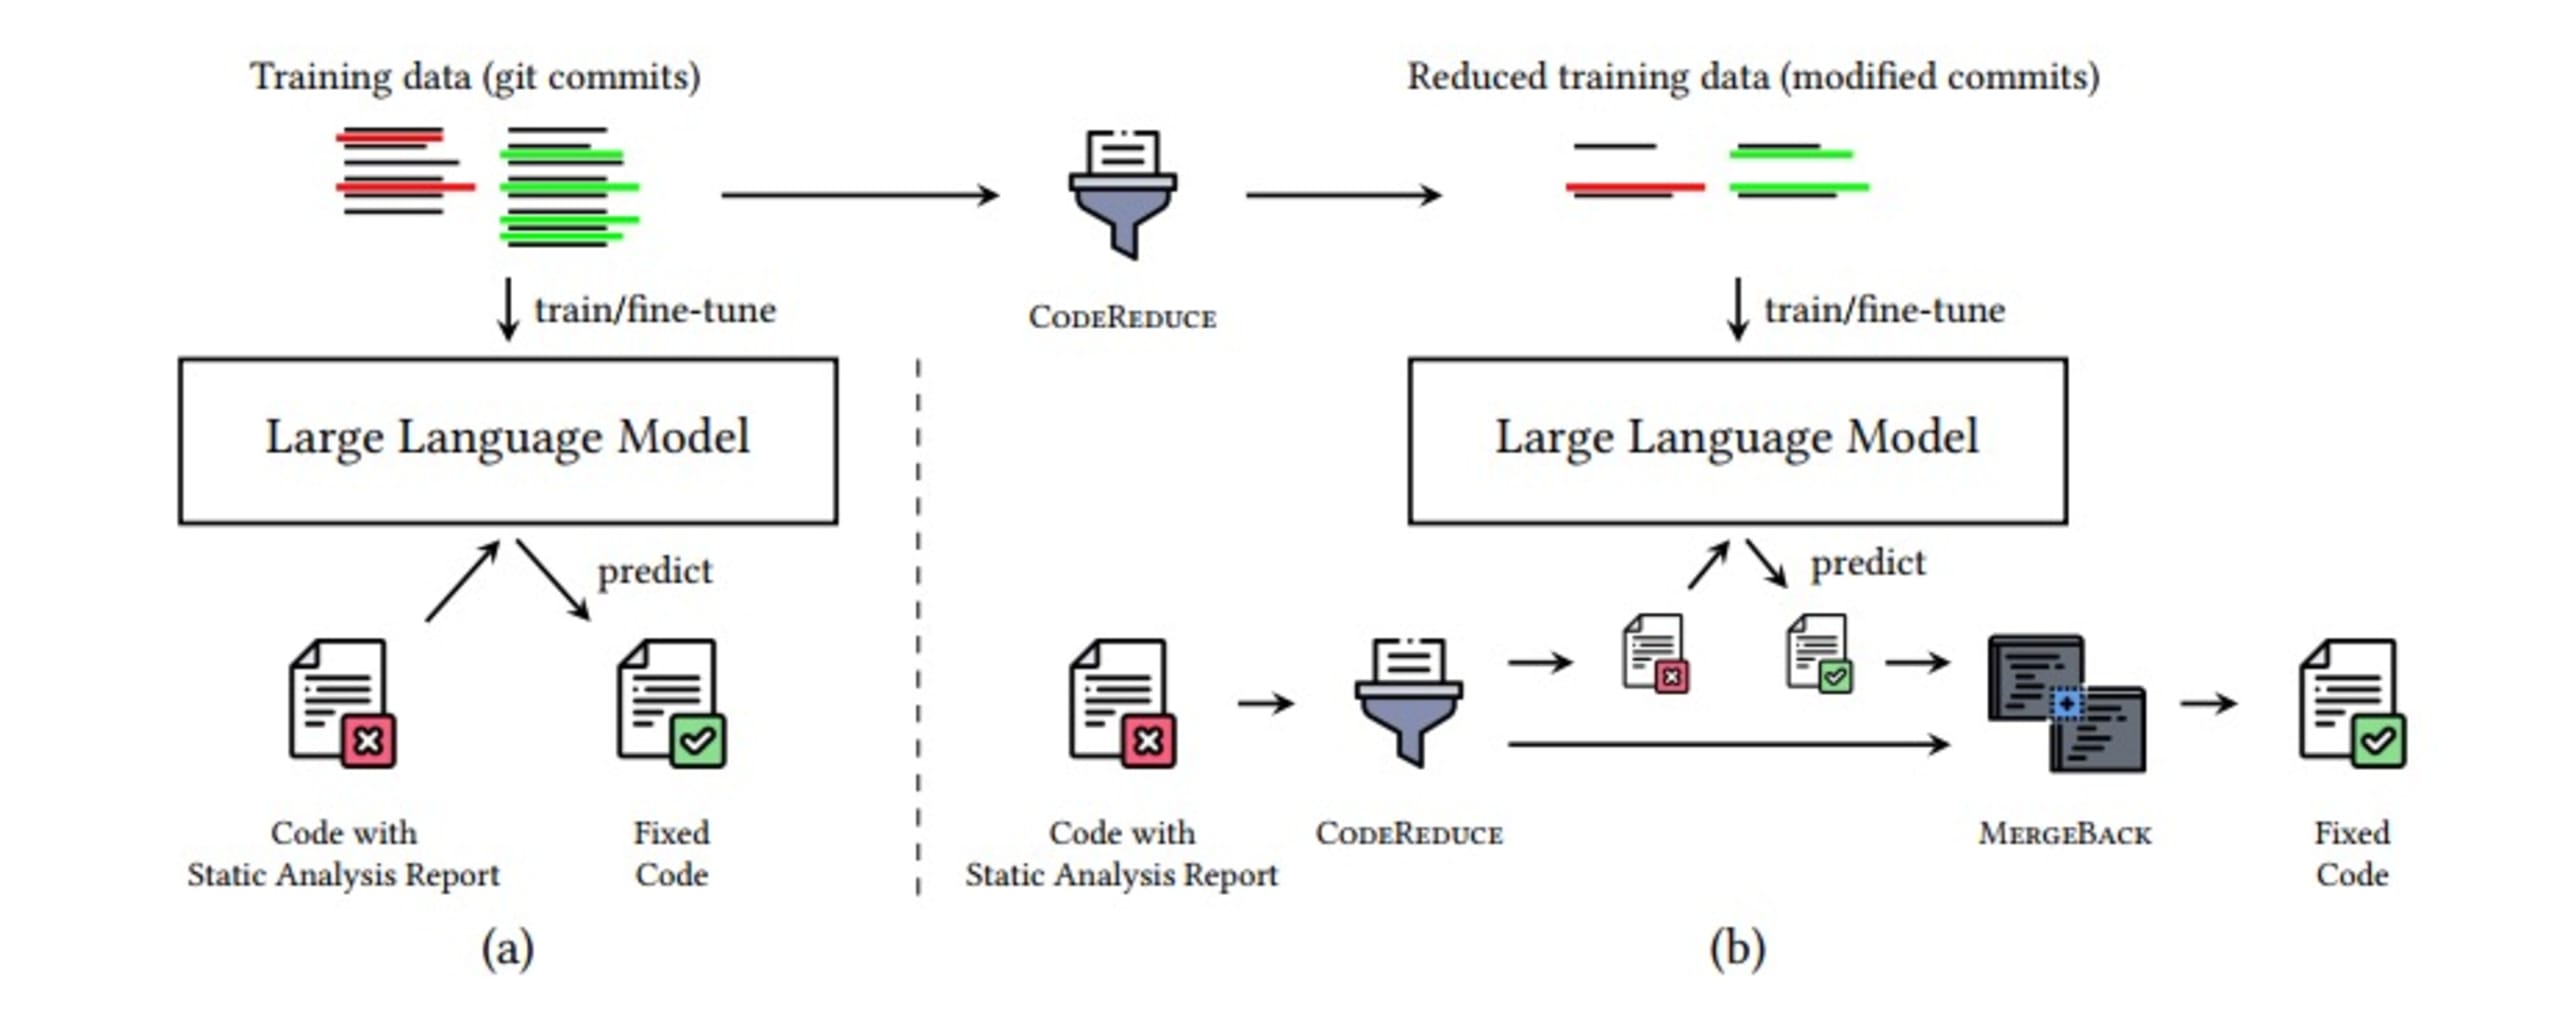
CodeReduce aprovecha el análisis de programas para limitar el mecanismo de atención del LLM únicamente a las partes del código necesarias para realizar la corrección. Para ello, concentra el LLM en un fragmento de código más breve que contiene el defecto reportado y el contexto necesario. Esto reduce drásticamente la cantidad de código que el LLM debe procesar, lo que a su vez ayuda a mejorar la calidad de las correcciones generadas en todos los modelos de IA probados y reduce las alucinaciones. Además, al pasar menos información por el modelo, el procesamiento es más rápido. Esto permite generar correcciones en tiempo real, para que no solo obtengas correcciones más precisas y pertinentes, sino también más rápidas.
El proceso de CodeReduce incluye los siguientes pasos:
Identificar el problema de seguridad
Reducirlo con CodeReduce al mínimo código necesario, incluido el contexto
Agregar el código reducido por CodeReduce a la instrucción del LLM y generar una corrección
Aplicar la corrección
Usar las capacidades de análisis de Snyk Code para volver a comprobar que Snyk Agent Fix corrigió la vulnerabilidad y que la corrección no introdujo vulnerabilidades nuevas
Integrar la corrección de nuevo en el código original
En conjunto, la imagen a continuación muestra cómo funciona el proceso de corrección automática de problemas de seguridad. Todo esto ocurre en cuestión de segundos gracias a optimizaciones adicionales que puedes conocer en el artículo de investigación sobre CodeReduce.
¿Cuáles son los resultados?
Una vez resueltos estos problemas, necesitábamos probar qué tan bien funcionaban nuestras correcciones automáticas de seguridad, así que creamos un benchmark que se pudiera usar con distintos LLM.
Realizamos nuestras evaluaciones con las métricas «Pass@𝑘» y «ExactMatch@𝑘» para los modelos que usan CodeReduce (indicados con el símbolo ‡ en la tabla a continuación), y los comparamos con las líneas de base de TFix, un modelo basado en ventanas, y varios modelos con contexto amplio, como GPT-3.5 y GPT-4.
La variable «k» en «Pass@k» mide cuántas de las 5 correcciones generadas cada vez —desde al menos una hasta las 5— abordan el problema de seguridad correspondiente sin introducir nuevos problemas de seguridad.
También definimos 5 categorías de problemas de seguridad para las pruebas:
AST: Vulnerabilidades que requieren un árbol de sintaxis abstracta, pero no un flujo de datos específico
Local: Valores incorrectos que se pasan a métodos que no los aceptarían
FileWide: Problemas de firmas o implementación
SecurityLocal: Uso de API y seguimiento de llamadas a métodos
SecurityFlow: Análisis complejo de contaminación que requiere un flujo de datos complejo
También elegimos varios LLM para compararlos: StarCoder, Mixtral, T5, GPT-3.5 y GPT-4. Estos fueron los resultados:
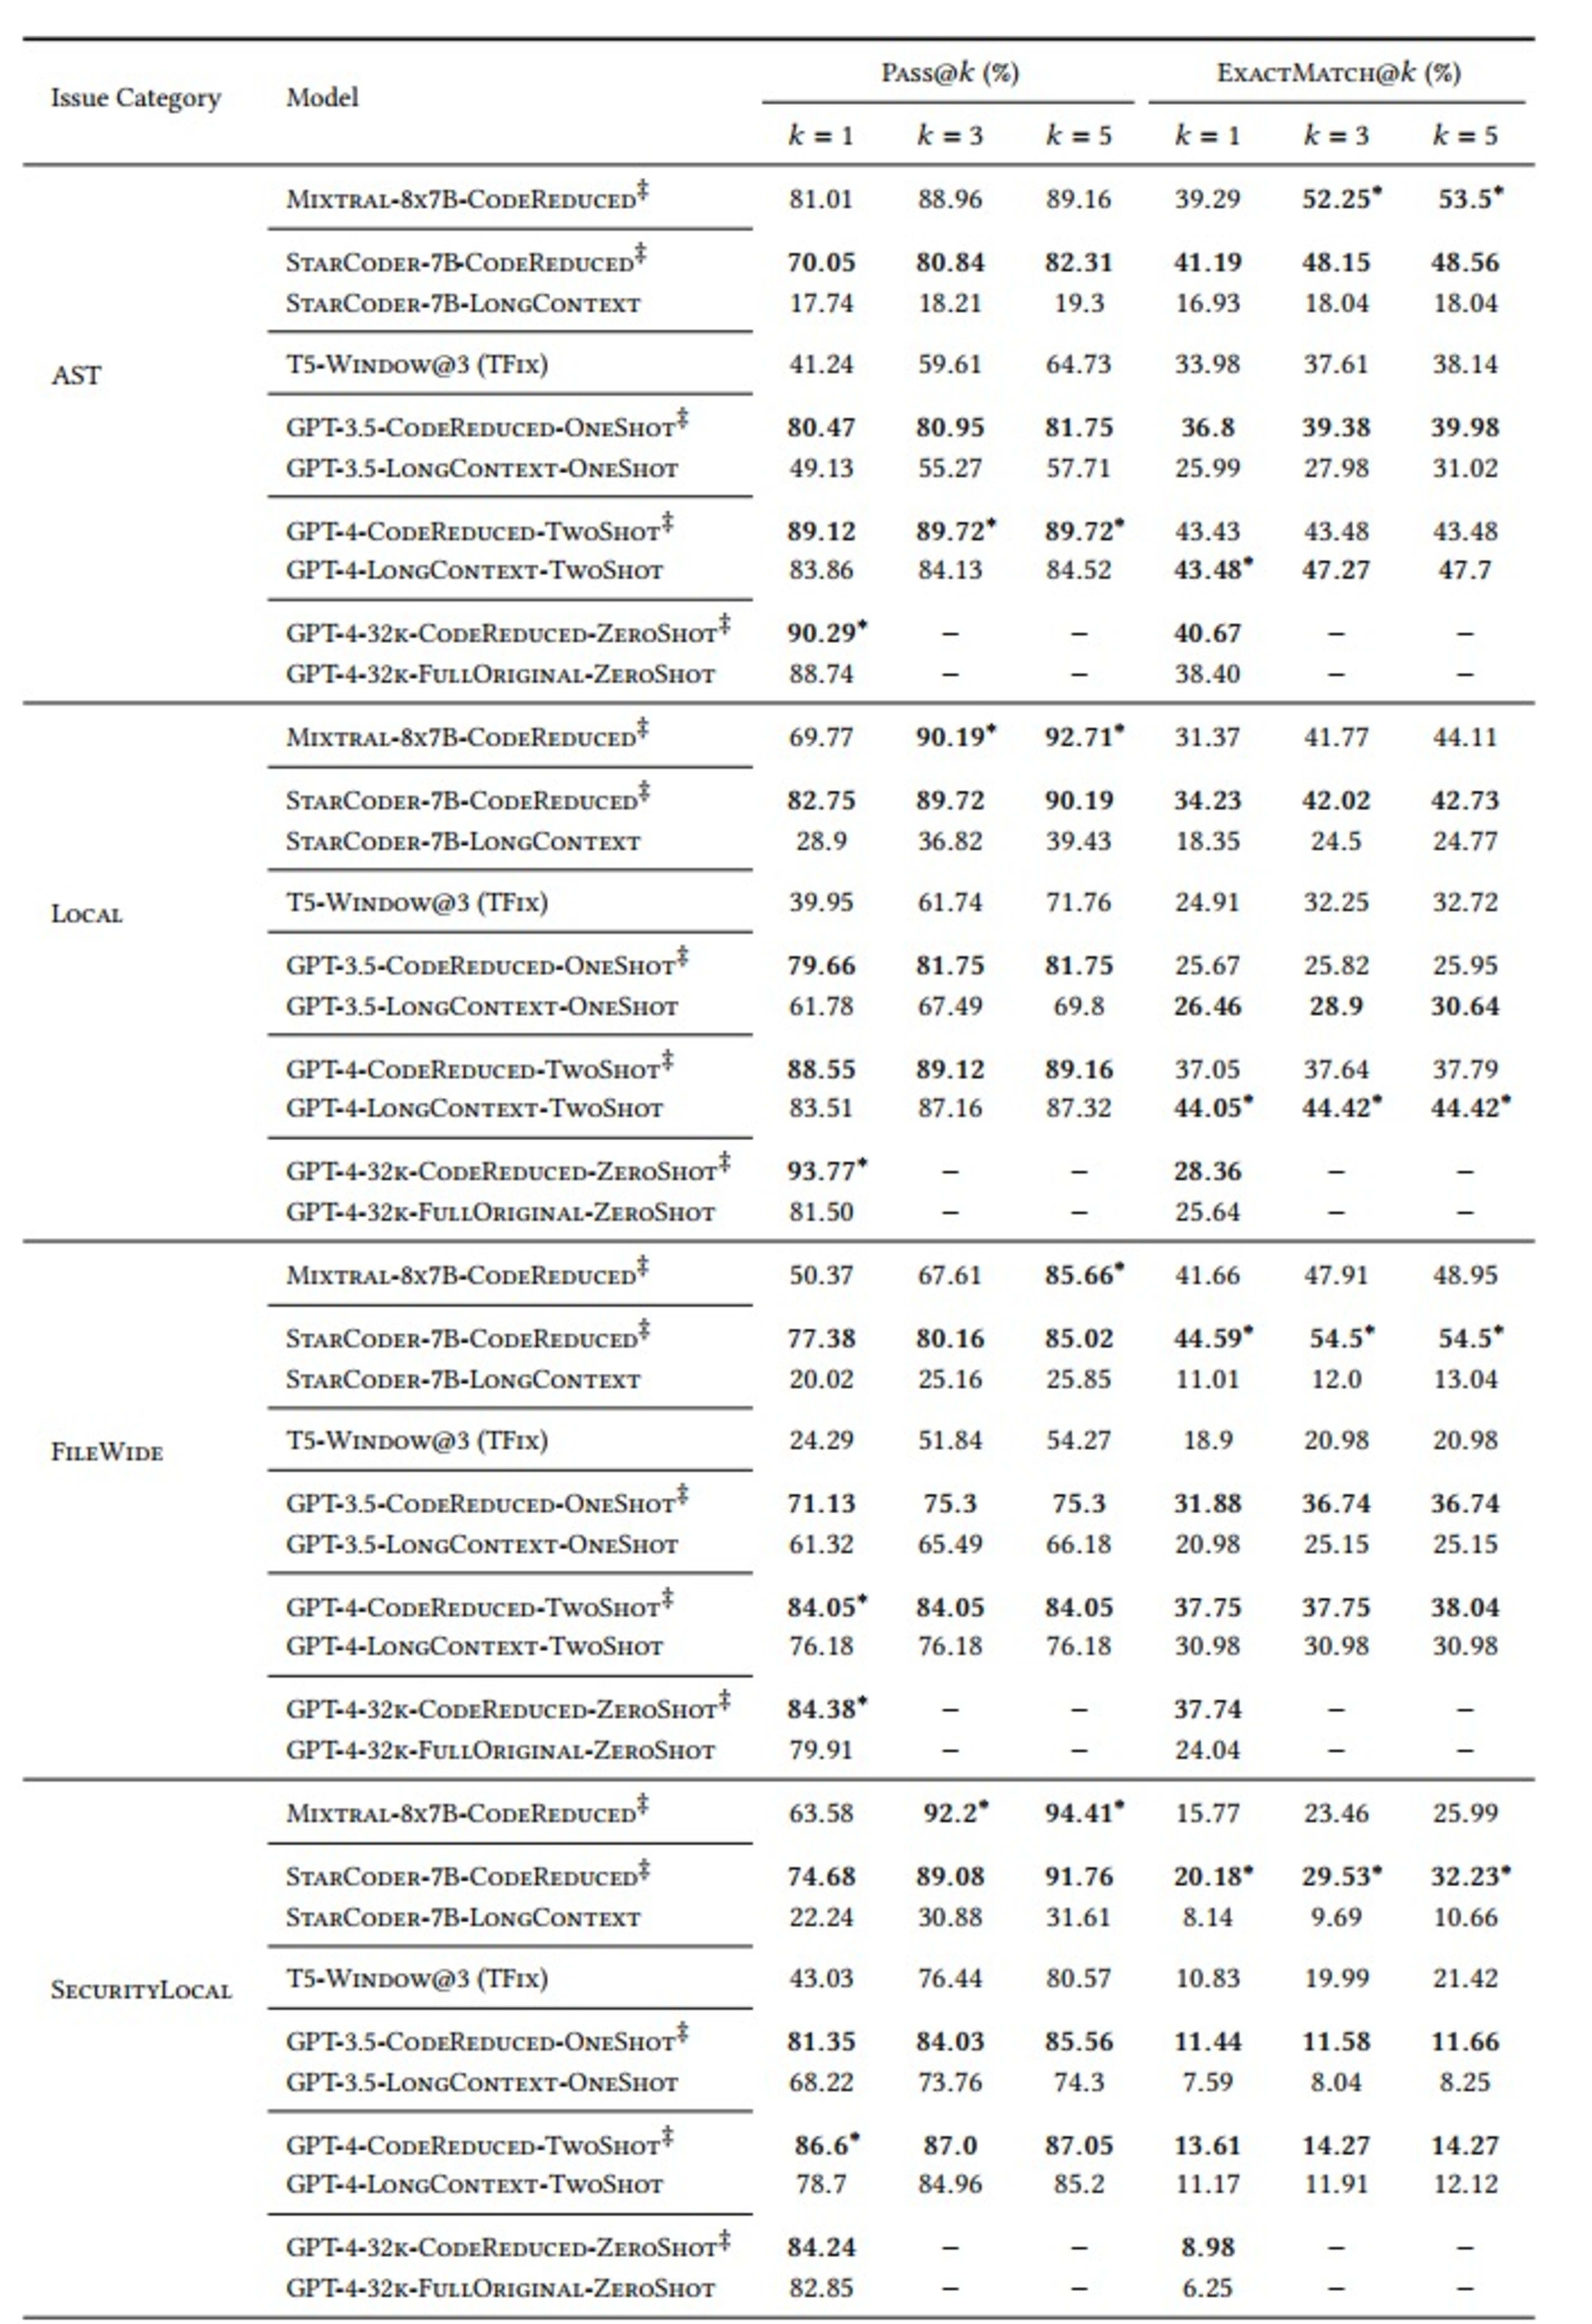
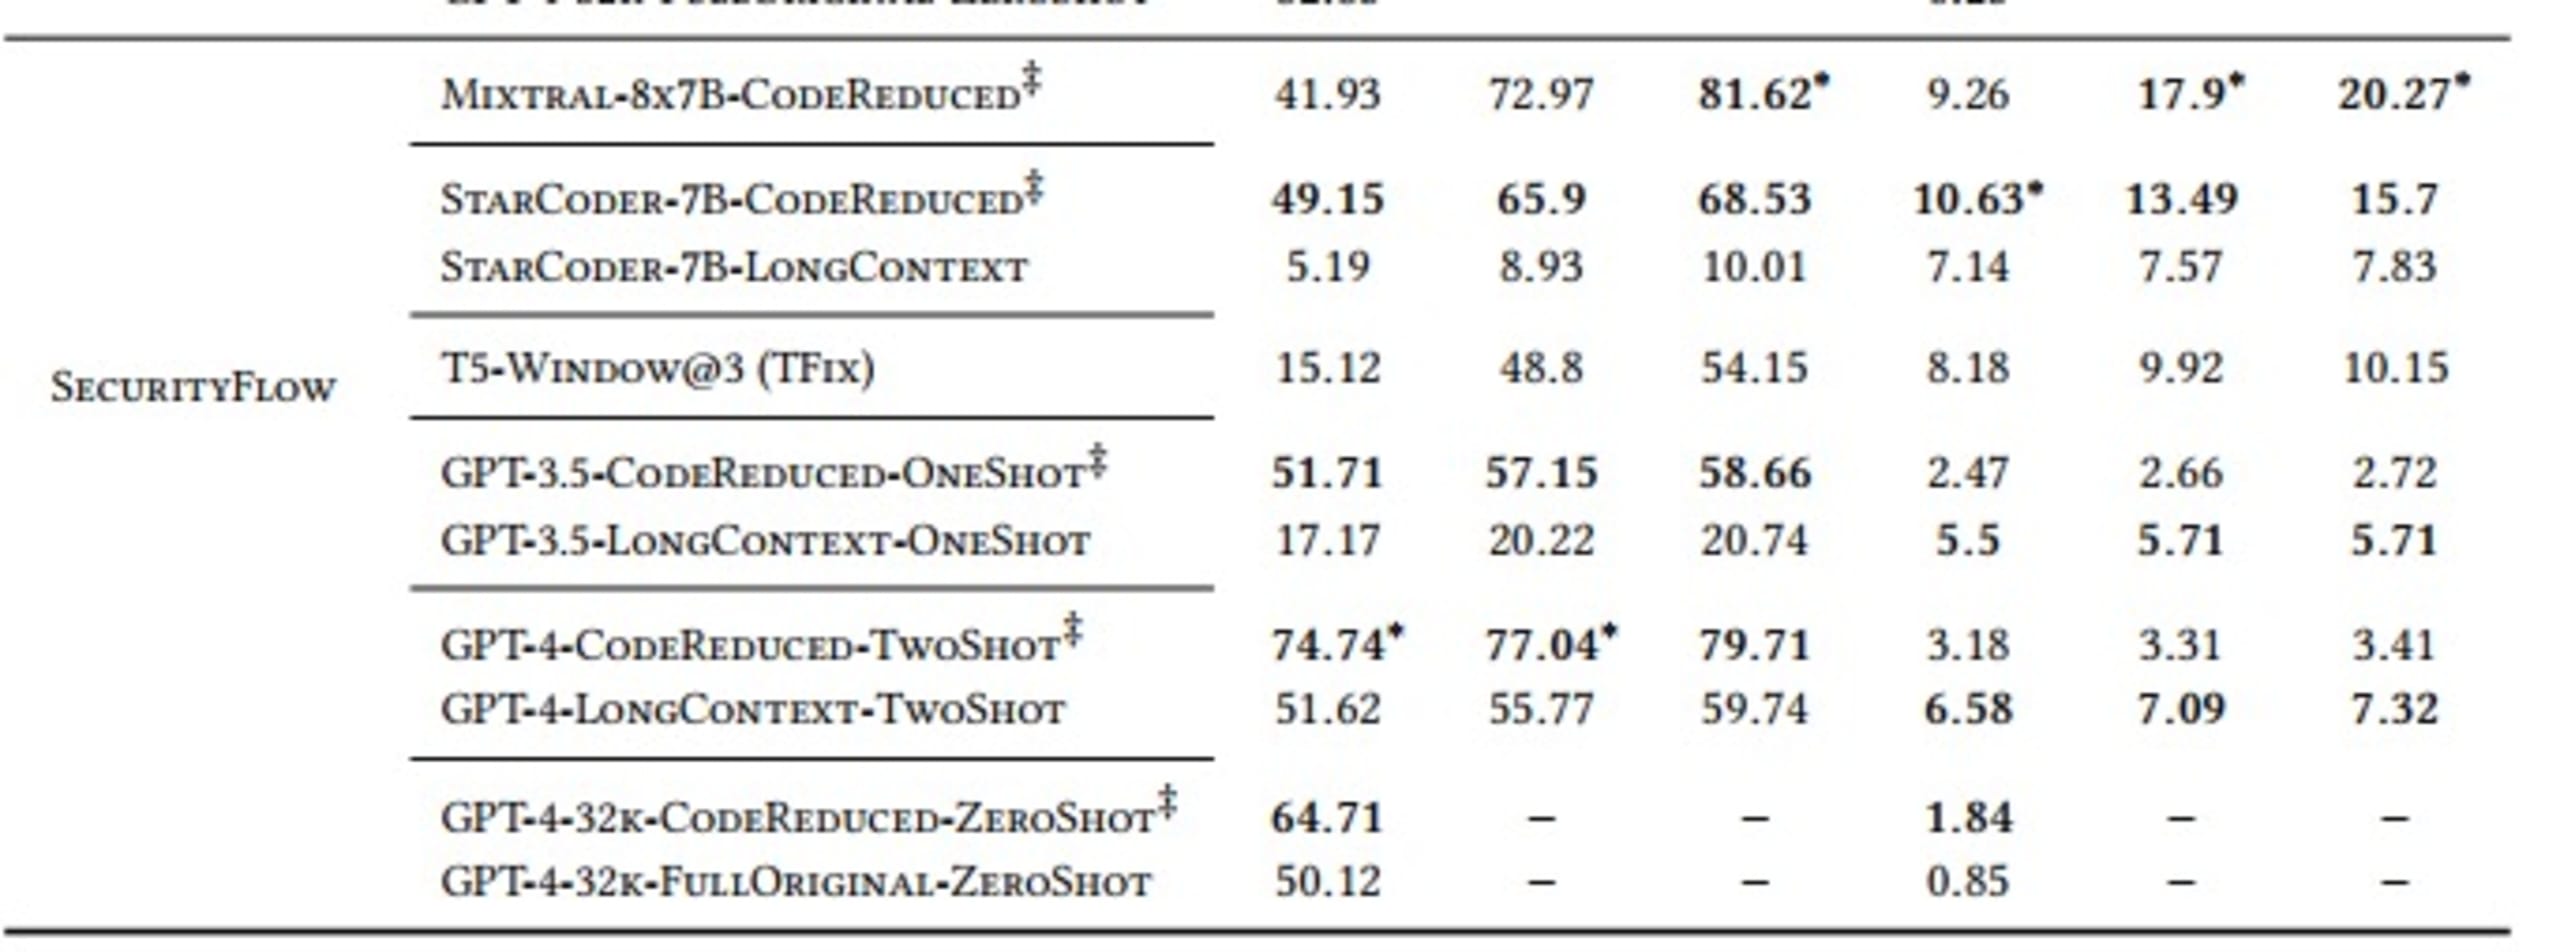
Como se muestra en la tabla, los modelos que normalmente aprenderían las complejas dependencias de largo alcance necesarias para generar una corrección correcta tienen un rendimiento significativamente mejor cuando usan el contexto de código extraído por CodeReduce que cuando generan correcciones sin su ayuda. Un buen ejemplo es la gran mejora en el resultado Pass@5 al corregir problemas de AST con el modelo StarCoder: la tasa de éxito pasó del 19.3 % (sin CodeReduce) a 82.31 % (con CodeReduce).
Conclusiones clave
En general, Snyk Agent Fix superó la línea de base anterior, establecida por TFix, y ayudó a mejorar el rendimiento de varios modelos de IA populares en distintas configuraciones. Esto se debe a que Snyk Agent Fix utiliza el análisis de programas mediante la tecnología patentada de Snyk CodeReduce para manejar dependencias de largo alcance y flujos de datos. De esta manera, Snyk Agent Fix simplifica considerablemente el aprendizaje sobre los problemas de seguridad pertinentes al limitar el enfoque de su atención, lo que da como resultado correcciones más precisas y pertinentes.
Ahora puedes probar la potente funcionalidad de Snyk Agent Fix en el IDE: regístrate en Snyk Code y activa «Snyk Code Fix Suggestions» en la configuración de Snyk Preview. Encontrarás más información en nuestra documentación. También puedes ayudar a definir el futuro de Snyk Agent Fix enviando comentarios sobre nuestras correcciones en Snyk Code.
Comienza con Capture the Flag
Aprende a resolver desafíos de Capture the Flag con nuestro taller virtual 101 a pedido.