Simplifica la seguridad de contenedores con la experiencia de Snyk en seguridad

Hadas Bloom
8 de marzo de 2022
0 minutos de lecturaLo más atractivo e inspirador del código abierto es, precisamente, que es de código abierto. Podemos ver los paquetes de código abierto como regalos que los desarrolladores intercambian en todo el mundo de la ingeniería. Esto les permite aprender del trabajo de otras personas, aportar su propia experiencia y desarrollar sus capacidades profesionales. Las contribuciones al código abierto son muy apreciadas, y es importante recordar que no solo debemos beneficiarnos de estos proyectos, sino también contribuir a ellos. Esta colaboración comunitaria hace que el código abierto evolucione continuamente, y el conocimiento y los paquetes compartidos sirven como base para tecnologías nuevas y emocionantes.
Pero estas bibliotecas y proyectos de uso gratuito también conllevan riesgos, ya sea por error o por actores maliciosos, y es precisamente aquí donde Snyk entra en juego y por qué.
Naturalmente, a medida que las tecnologías de código abierto siguen evolucionando, con nuevas y mejoradas distribuciones de Linux y herramientas para contenedores como Docker, se crean y utilizan cada vez más imágenes que agrupan estos paquetes de código abierto. En pocas palabras, una imagen de contenedor es un archivo que contiene el código, las bibliotecas, las dependencias y otras herramientas y archivos que las aplicaciones necesitan para ejecutarse. Un contenedor, por su parte, es la instancia en ejecución de esa imagen y define el «espacio» en el que se ejecuta y desarrolla la aplicación. Un contenedor te permite crear un entorno en el que tu código puede funcionar y depende de la imagen; de hecho, se inicia a partir de ella. Mejor aún, uno de los aspectos más potentes de las imágenes de contenedor es que pueden construirse unas sobre otras. Puedes empezar con una imagen que solo tenga los elementos básicos de Linux —por ejemplo, algo como alpine de Docker—; agregar herramientas y marcos de trabajo específicos para un lenguaje y crear una imagen para ese lenguaje; agregar herramientas de desarrollo para ese lenguaje; y, por último, incorporar las particularidades de tu propio código.
Si una imagen es solo un archivo con un conjunto de paquetes, probablemente ya te estés preguntando cuál es el desafío para determinar qué vulnerabilidades los afectan. ¿No podemos suponer que, si existe una vulnerabilidad en un paquete de código abierto y ese paquete se utiliza en una imagen, la imagen es vulnerable? ¡Excelente pregunta, gracias por hacerla! Así como usar una imagen base, como alpine en el ejemplo anterior, te brinda muchas herramientas y posibilidades, cada paquete también puede introducir vulnerabilidades ocultas. De pronto, ya no basta con descubrir vulnerabilidades en tu propio código: también debes asegurarte de que tu imagen base y todas las imágenes que creas al agregar herramientas sean seguras.
Para este blog, nos centraremos en la primera parte de la imagen: la imagen principal que seleccionas inicialmente como base (alpine en el ejemplo). Esta capa suele ser donde se incorporan la mayoría de los paquetes básicos de Linux y donde se agrega el administrador de paquetes de Linux. También es un área que suele generar confusión porque, a diferencia de todo lo demás que puedes elegir agregar, tienes muy poco control sobre lo que incluye esa imagen base. Así que profundicemos en el problema de las vulnerabilidades en contenedores y veamos cómo Snyk puede ayudar a resolverlo.
Cómo entender las vulnerabilidades de Linux en el mundo de los contenedores
Sistema de administración de paquetes
Cada distribución de Linux (Alpine, Debian, Ubuntu, etc.) tiene su propio grupo de responsables. Aunque todas ofrecen una versión de Linux, lo que implica ciertos elementos en común, cada una puede definir sus propios esquemas de nomenclatura y versionado para las actualizaciones. Esto significa que no siempre mantienen los mismos nombres o versiones que el paquete de origen correspondiente y, por eso, al consultar los detalles de las correcciones de un problema específico o incluso los parches generales del sistema, cada distribución puede dar recomendaciones distintas a sus usuarios.
Veamos, por ejemplo, la corrección de CVE-2021-44228, también conocida como Log4Shell, en el conocido paquete log4j. El paquete de origen, que mantiene el equipo de Apache en Maven, se llama logging-log4j2, y la corrección de esta vulnerabilidad crítica se publicó en la versión 2.15.0. Sin embargo, si usas Debian, el paquete que proporciona Debian se llama apache-log4j2 y la corrección se publicó en la rama estable actual, Debian 11 («bullseye»), en la versión 2.15.0-1~deb11u1. En Ubuntu, el nombre es similar al de Debian en este caso: apache-log4j2, pero la versión corregida en la última versión de Ubuntu (21.10) es 2.15.0-0.21.10.1.
Resumen de los paquetes corregidos para CVE-2021-44228:
Nombre del paquete | Versión corregida | |
|---|---|---|
Java de origen (Maven) | logging-log4j2 | 2.15.0 |
Debian 11 («Bullseye») | apache-log4j2 | 2.15.0~deb11u1 |
Ubuntu 21.10 («Impish Indri») | apache-log4j2 | 2.15.0-0.21.10.1 |
Este ejemplo relativamente sencillo muestra que, aunque nuestros dedicados analistas de seguridad hayan encontrado o evaluado una vulnerabilidad en un paquete de código abierto de origen, no podemos dar por hecho de inmediato qué paquete se basa en él en las distintas distribuciones de Linux, cuáles son las versiones afectadas o siquiera si una distribución en particular está afectada. Se necesita un proceso de evaluación distinto para los paquetes derivados que se incluyen en las diferentes imágenes.
La nomenclatura y el versionado se gestionan de esta manera para que los diferentes equipos de distribuciones de Linux puedan seguir sus propias versiones, identificar qué versión de origen usan según su propio formato y controlar sus paquetes. Cada distribución administra y es responsable de todos los aspectos de compilación y creación de los paquetes que se usan en su ecosistema. Mantener sus propios nombres y versiones de paquetes les permite controlar correctamente las versiones de parches y los backports en su sistema.
Lo más acertado es considerar cada paquete como una entidad diferente, según el lugar desde el que se descarga. Si el paquete «reside» en el administrador de paquetes de una distribución de Linux determinada, aunque tenga el mismo nombre que uno administrado en PyPi, Maven u otros repositorios, debemos tratarlo como un paquete diferente, mantenido por otro equipo que lo compiló específicamente para adaptarlo a su entorno y necesidades.
Terminología y estructura de los datos
Además de las diferencias en los nombres y las versiones de los paquetes que usa cada distribución de Linux, también varían los términos con que cada fuente define distintos aspectos de los datos de seguridad que proporciona.
Por ejemplo, puede haber diferencias en la definición de la gravedad «crítica». Un equipo puede usar «crítica» con más frecuencia y libertad que otro, que suele clasificar las vulnerabilidades como de gravedad «alta» y solo en situaciones muy específicas las marca como «críticas».
Por otro lado, distintos términos pueden significar lo mismo y usarse de forma equivalente; por ejemplo, «moderada» y «media», que distintos equipos pueden utilizar para indicar la misma gravedad.
Además, cuando un equipo usa el término «importante», por ejemplo, hay que distinguir entre la importancia para priorizar la corrección del problema y la importancia de la vulnerabilidad en sí (es decir, que su gravedad sea relativamente alta).
Para explicar esta complejidad, veamos CVE-2021-3507, que afecta a Debian:
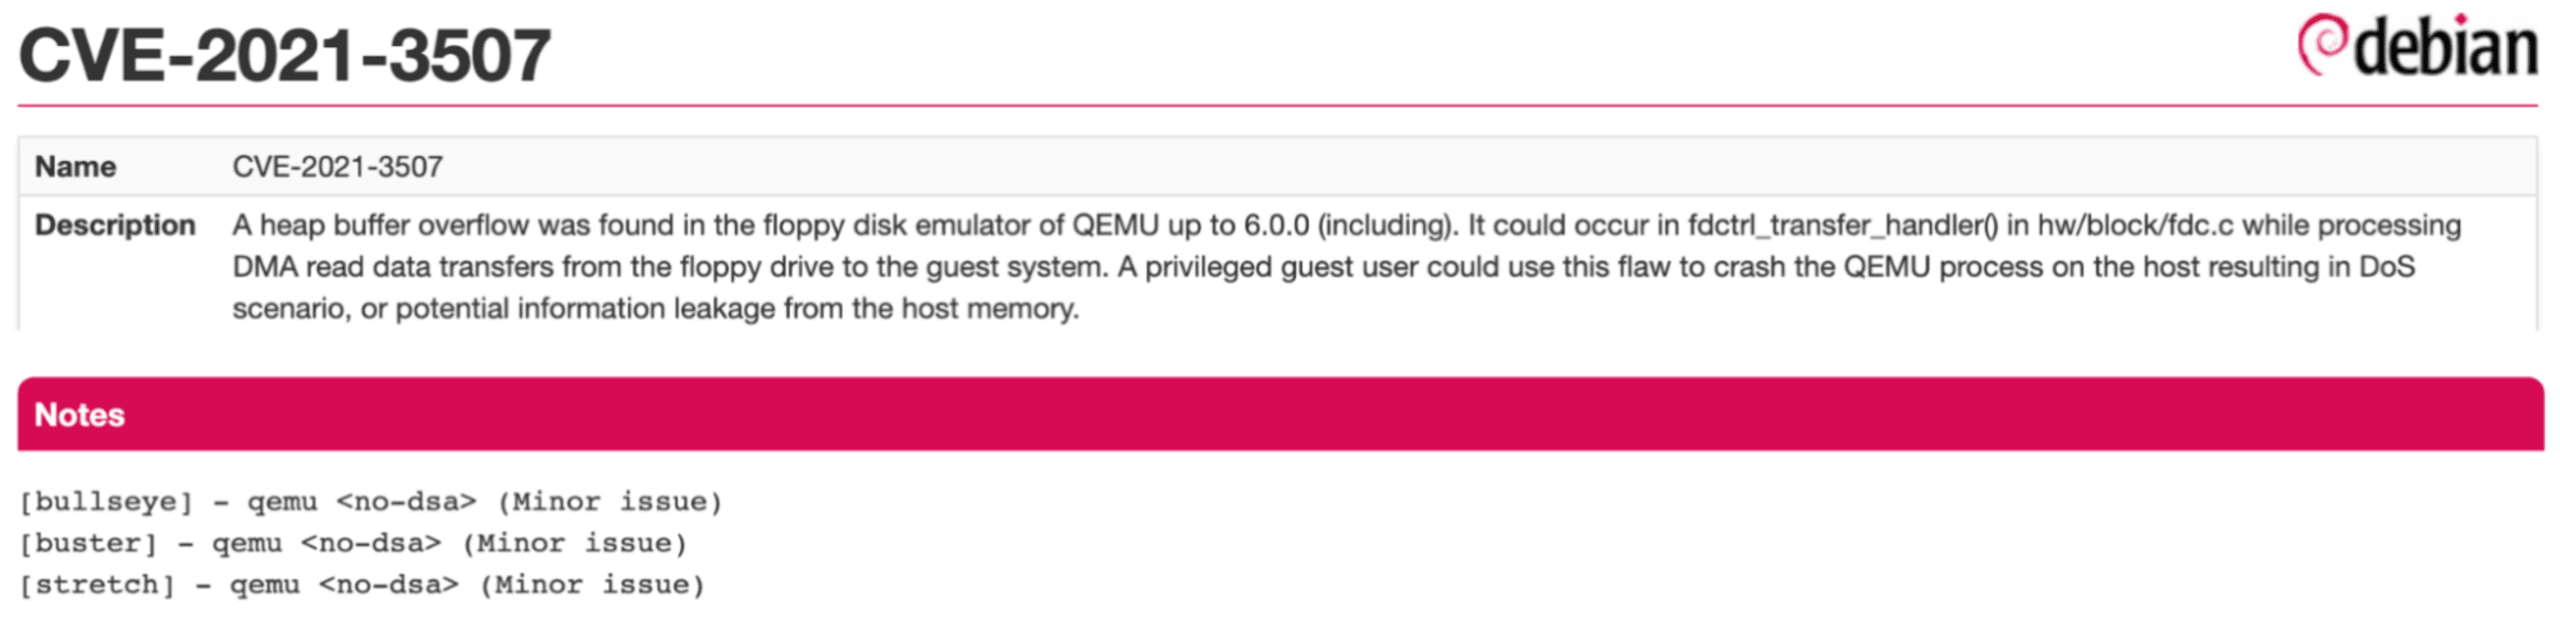
Como se ve en el aviso citado, esta CVE aparece marcada como <no-dsa> (Minor issue) para Stretch (Debian 9), Buster (10) y Bullseye (11). Según los responsables de Debian, esto indica la gravedad del problema para esas versiones de Debian.
Por otro lado, NVD asignó a esta CVE una puntuación CVSS «media», que refleja un análisis más amplio de la vulnerabilidad, especialmente relevante para el paquete de origen qemu.
Gran cantidad de datos
Cada distribución de Linux y cada una de sus versiones incluye muchos paquetes de manera predeterminada, y muchos (muchísimos) más que se pueden descargar del repositorio de esa distribución. Esto significa que nuestro contenedor podría tener cientos de vulnerabilidades que afectan a paquetes escritos en varios lenguajes de programación. La gran cantidad de datos sobre vulnerabilidades en el entorno de contenedores dificulta que Snyk, los equipos de seguridad y los desarrolladores que usan contenedores evalúen y comprendan las vulnerabilidades específicas y qué hacer al respecto. Por eso, analizar a fondo todas y cada una de las vulnerabilidades es todo un desafío.
Estos problemas propios del mundo de las vulnerabilidades en contenedores plantean el desafío de identificar los datos más precisos dentro de un contenedor. ¿Qué vulnerabilidades son relevantes para un contenedor específico y cuál es su riesgo real, en función de cómo interactúa el contenedor con el kernel de Linux y con la aplicación que se ejecuta en su interior? Nuestro equipo de vulnerabilidades en contenedores de Snyk trabaja continuamente para responder esta pregunta con la mayor precisión posible. Creamos un modelo complejo que considera muchos factores diferentes para identificar y priorizar estas vulnerabilidades con precisión.
¿Cómo se resuelven estos desafíos?
Una vez definida la complejidad, podemos explorar cómo identificar los datos más precisos. El proceso para recopilar, analizar y reportar las vulnerabilidades correctas en contenedores comienza con una canalización escalable, capaz de manejar grandes volúmenes de datos de muchas fuentes de forma inteligente y automatizada, pero que también activa la intervención humana cuando es necesario. Se requieren conocimientos profundos, basados en una combinación de experiencia en seguridad y colaboración con los equipos de seguridad de las distintas distribuciones de Linux, que aportan el contexto adicional que nos falta. Con todos estos conocimientos, derivados de muchas fuentes, podemos recopilar y seleccionar la información más pertinente y útil. Por último, podemos priorizar las vulnerabilidades en su contexto específico, según todos estos factores y cualquier otro dato externo que podamos recopilar, para reducir el ruido irrelevante. Esto es lo que significa para nosotros en Snyk.
¿Cómo analiza Snyk las vulnerabilidades de contenedores y Linux?
El objetivo principal de nuestro equipo de seguridad de contenedores es responder estas preguntas: ¿Qué vulnerabilidades afectan a un contenedor, qué prioridad tiene corregirlas y qué puedo hacer al respecto?
Así nos aseguramos de responder estas preguntas de la forma más precisa, completa y oportuna:
Recopilación oportuna de datos
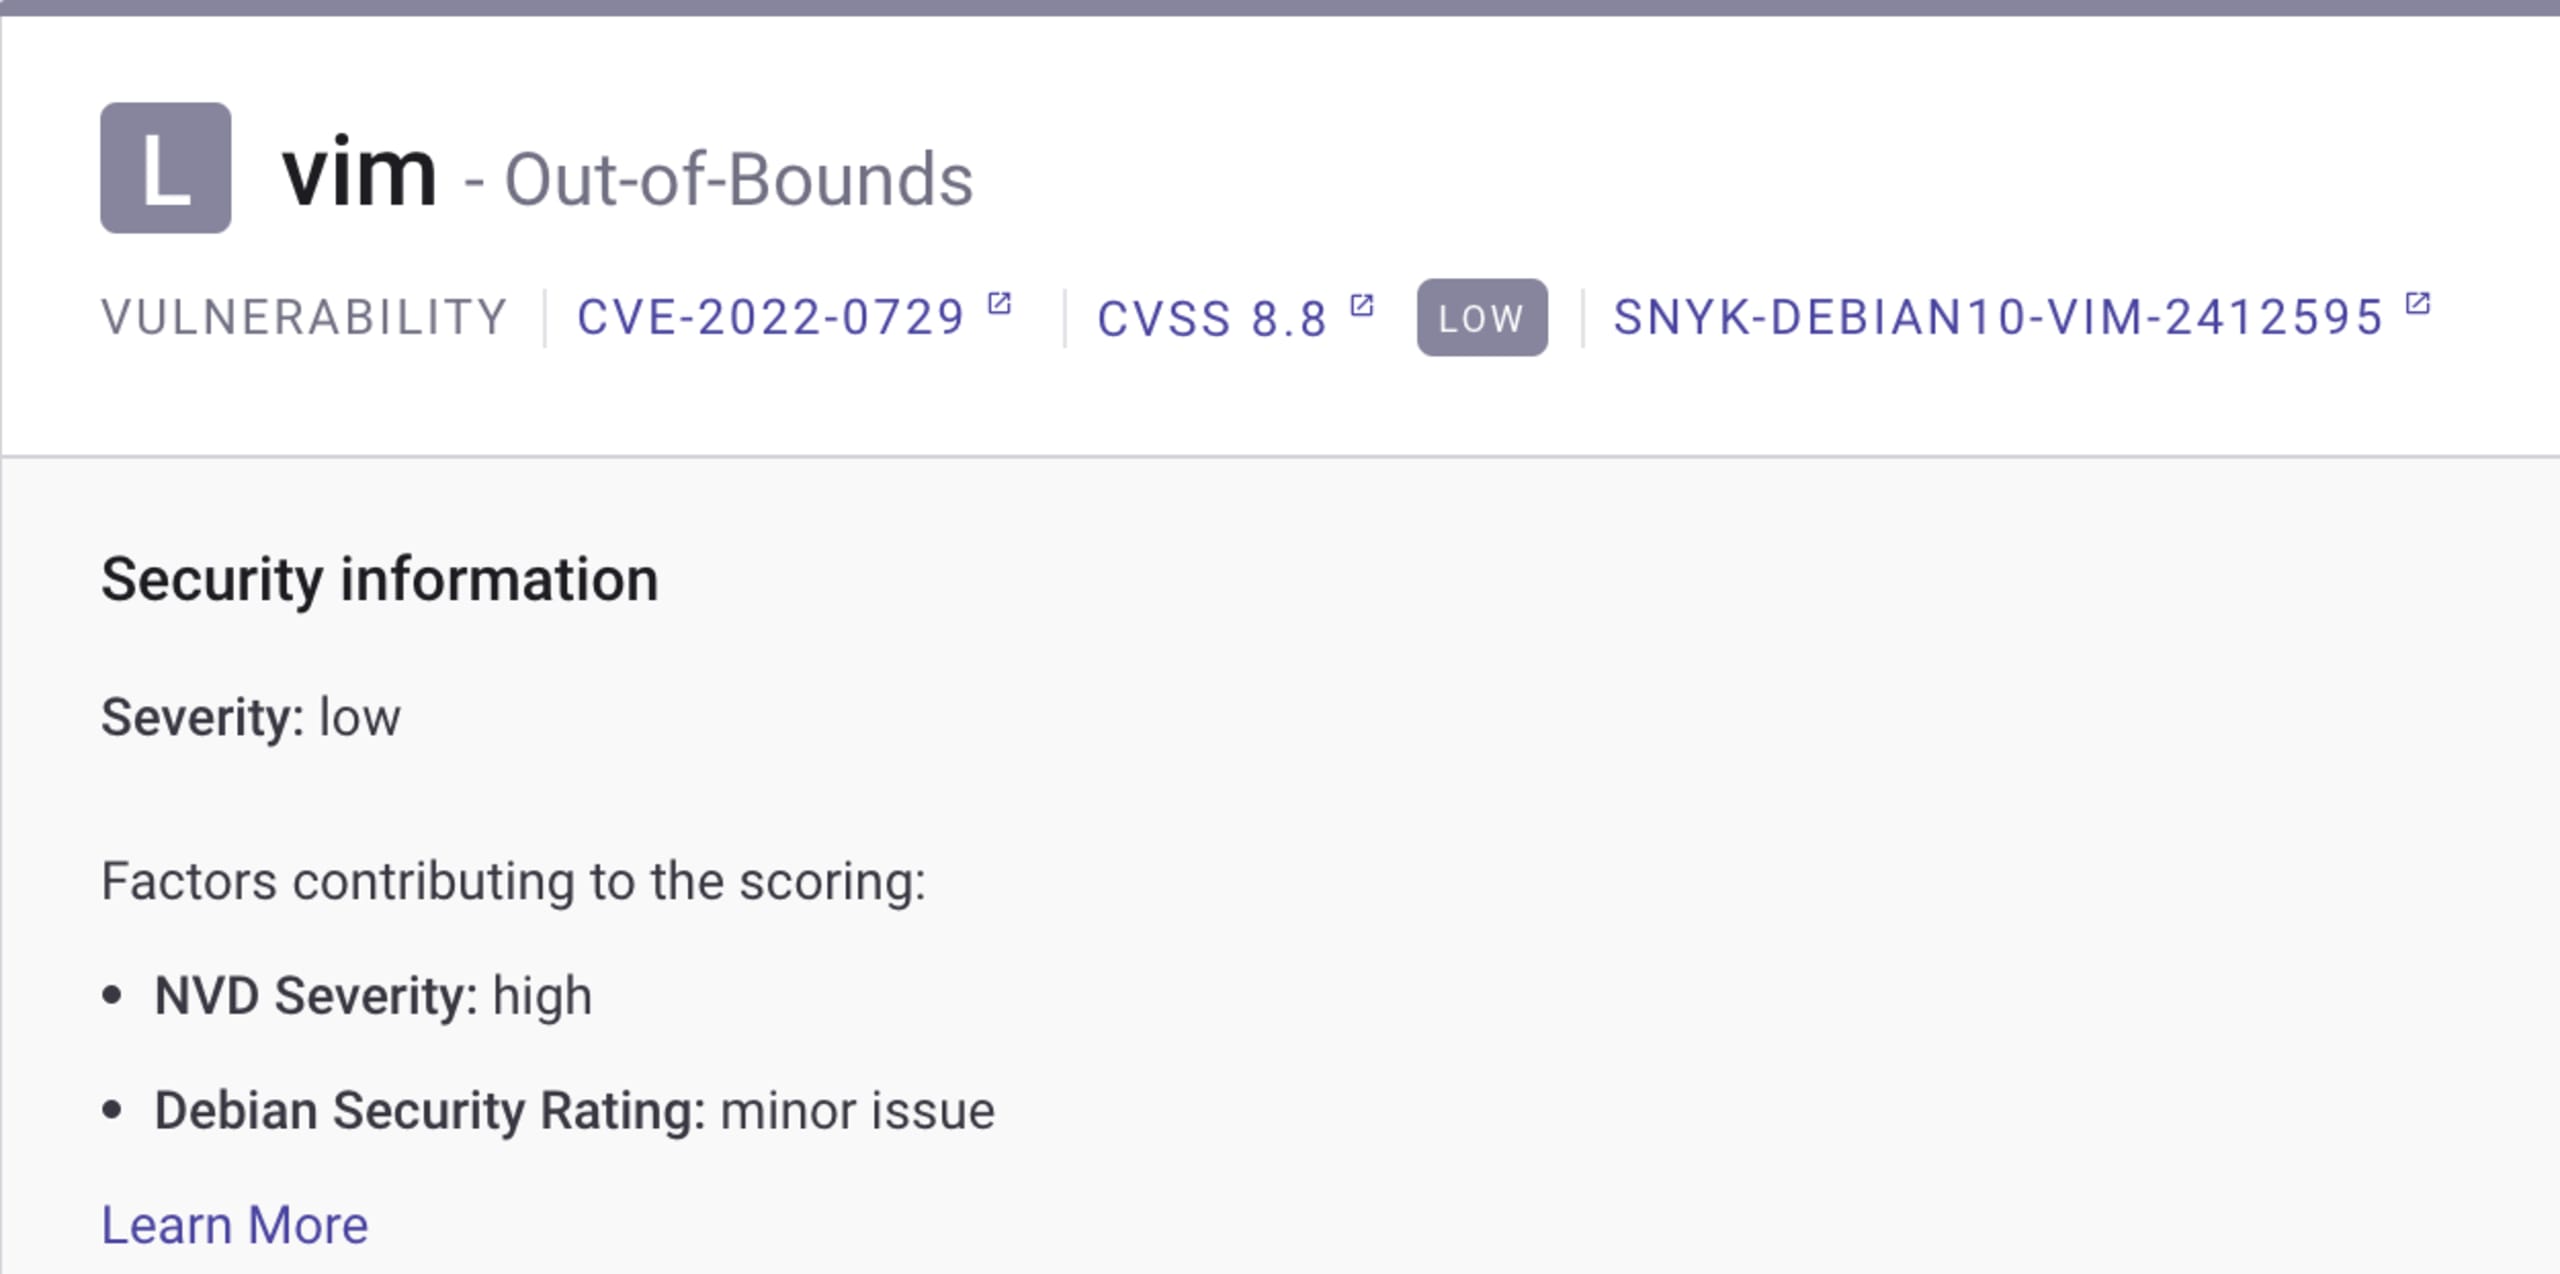
Recopilamos de forma independiente datos de seguridad de las distintas fuentes de las distribuciones de Linux. Esto significa que hacemos seguimiento de las nuevas versiones y avisos, tanto de paquetes como de versiones completas de las distribuciones, en cuanto se actualizan. Para ello, debemos actualizar inmediatamente nuestros datos sobre vulnerabilidades con cualquier información nueva que provenga de las fuentes de las distribuciones de Linux. Un ejemplo de este tipo de actualización que puedes ver directamente en los resultados de Snyk Container es la importancia relativa de la vulnerabilidad, que determina su gravedad en el contexto de una imagen específica. En el ejemplo siguiente, la puntuación CVSS original es 8.8, considerada de gravedad «alta», pero los responsables de Debian analizaron la vulnerabilidad en Debian 10 (la versión que se usa en este contenedor) y determinaron que era un «problema menor». Por eso, Snyk le asignó una gravedad general «baja». Estos datos son muy importantes para priorizar y evaluar correctamente la vulnerabilidad, porque ayudan a decidir cuáles de los muchos problemas se deben resolver primero.
Colaboración y conocimiento profundo de los ecosistemas de las distribuciones de Linux
Para comprender los datos de seguridad de cada distribución de Linux, la investigamos, conocemos sus componentes y verificamos que esté completa. Además, identificamos casos excepcionales y cualquier dato adicional que proporcione la distribución y que podamos aprovechar para el triaje. Por ejemplo, al trabajar para mejorar nuestra información de seguridad sobre Red Hat, notamos que sus páginas públicas de vulnerabilidades incluyen más información que sus flujos OVAL. Por ejemplo, indican si la vulnerabilidad está under investigation o not affecting a un producto específico de Red Hat. Se lo comunicamos al equipo de seguridad de Red Hat y, desde entonces, han incluido esta información importante en sus flujos OVAL, la fuente oficial de datos de seguridad que usamos.
Experiencia humana en seguridad
En nuestro proceso, mayormente automatizado y basado en la investigación descrita anteriormente, identificamos situaciones específicas en las que se necesita la decisión de un experto en seguridad. Por ejemplo, cuando la distribución elimina un aviso y queremos verificarlo antes de revocarlo. Nuestro sofisticado proceso de revocación es muy importante para garantizar que nuestros sistemas automatizados no eliminen vulnerabilidades que sí afectan a los usuarios, así como para evitar falsos positivos y facilitar el trabajo de los desarrolladores.
Enriquecimiento y fuentes adicionales
Enriquecemos los datos de vulnerabilidades con fuentes externas que agregamos continuamente. Estas incluyen datos de NVD, información sobre exploits, tendencias de Twitter y, como anunciamos recientemente, señales de ejecución de Sysdig.
Priorización contextual
Con toda esta información, priorizamos las vulnerabilidades mediante nuestro puntaje de prioridad exclusivo, indicamos su severidad, agregamos todos los datos adicionales para brindar más contexto y presentamos cada vulnerabilidad de la forma más útil para analizarla y comprenderla.
Un vistazo al futuro de la investigación de vulnerabilidades de Snyk Container
Tenemos mucho trabajo por delante para abordar las vulnerabilidades en contenedores en el futuro.
Un ejemplo de esto son los insights de seguridad de Snyk. Con ellos, buscamos reducir al máximo el ruido en un entorno que ya tiene demasiado. Ofrecer insights de seguridad para situaciones y condiciones específicas permitirá comprender mejor si una vulnerabilidad es irrelevante en una configuración, un entorno o una aplicación determinados, y nos ayudará a colaborar con los desarrolladores en el triaje de vulnerabilidades.
Un ejemplo de insight de vulnerabilidad de Snyk Container en el que estamos trabajando es recomendar que se ignore una vulnerabilidad si se encuentra en un paquete usado durante la compilación o, incluso, ir más allá y eliminar por completo el paquete afectado usado durante la compilación (lo que eliminará automáticamente las demás vulnerabilidades del mismo paquete). Esto se basa en la investigación que respalda la suposición inicial de que es poco probable aprovechar una vulnerabilidad durante la compilación y que las vulnerabilidades que afectan a las aplicaciones en tiempo de ejecución deben tener mucha más prioridad. Puedes verlo como lo opuesto a la integración de Sysdig: mientras que Sysdig te indica qué se está ejecutando en producción, lo que aumentaría la prioridad para corregir una vulnerabilidad, los insights de compilación de Snyk podrían reducir la prioridad de corregirla (o incluso facilitar que se ignore automáticamente) cuando se trata de una vulnerabilidad en herramientas de compilación que no se ejecutan en producción.
Además, estamos trabajando para agregar metadatos a las vulnerabilidades en contenedores que aporten información más relevante y hagan más eficientes la priorización y el análisis. Estos datos adicionales incluyen, por ejemplo, información sobre el fix state de la vulnerabilidad (¿Llegará a corregirse? ¿Ya se integró una corrección y está pendiente de publicación?), así como notas de seguridad que brindan más contexto sobre la severidad u otros estados de la vulnerabilidad. Y, por supuesto, seguimos explorando y trabajando para ampliar la compatibilidad con otras distribuciones.
Gestionar las vulnerabilidades en tus contenedores es complicado, pero no tienes que hacerlo por tu cuenta. La inteligencia líder en la industria de Snyk mejora y evoluciona constantemente, así que no necesitas ser un experto para mantenerte protegido: solo necesitas una cuenta gratuita de Snyk.
Seguridad de contenedores centrada en los desarrolladores
Snyk encuentra y corrige automáticamente vulnerabilidades en imágenes de contenedores y cargas de trabajo de Kubernetes.