Crear una herramienta automatizada para probar infraestructura en la nube con Terraform y PyTest

27 de marzo de 2020
0 minutos de lecturaNota del editor
Este blog se publicó originalmente en fugue.co. Fugue se unió a Snyk en 2022 y es un componente clave de Snyk IaC.
Hace poco, me encargaron crear una herramienta automatizada de pruebas para Fugue. Fugue monitorea los recursos en la nube para verificar su cumplimiento y seguridad, y necesitábamos una forma de confirmar que los resultados completos de un análisis de Fugue fueran correctos. Mi objetivo era crear un sistema automatizado que se ejecutara localmente o en CI, implementara infraestructura configurable, la analizara con Fugue y verificara los resultados. En esta publicación, explico el proceso de diseño e implementación de lo que se convirtió en autotest, nuestra herramienta interna de pruebas automatizadas.
Aunque este ejemplo usa específicamente Terraform y la API de Fugue, el diseño de los fixtures se puede aplicar a cualquier comando de CLI y API, así que las ideas aquí se pueden adaptar fácilmente a otros casos de uso.
Diseño
Antes de ponerme manos a la obra con el proyecto, dediqué un par de días a investigar e intentar comprender el problema. Después de revisar algunas búsquedas en Google, decidí basar mi herramienta en el framework pytest. Ya había trabajado con pytest para pruebas unitarias, pero esta era la oportunidad perfecta para explorarlo en profundidad y descubrir cómo usarlo como base para una prueba funcional.
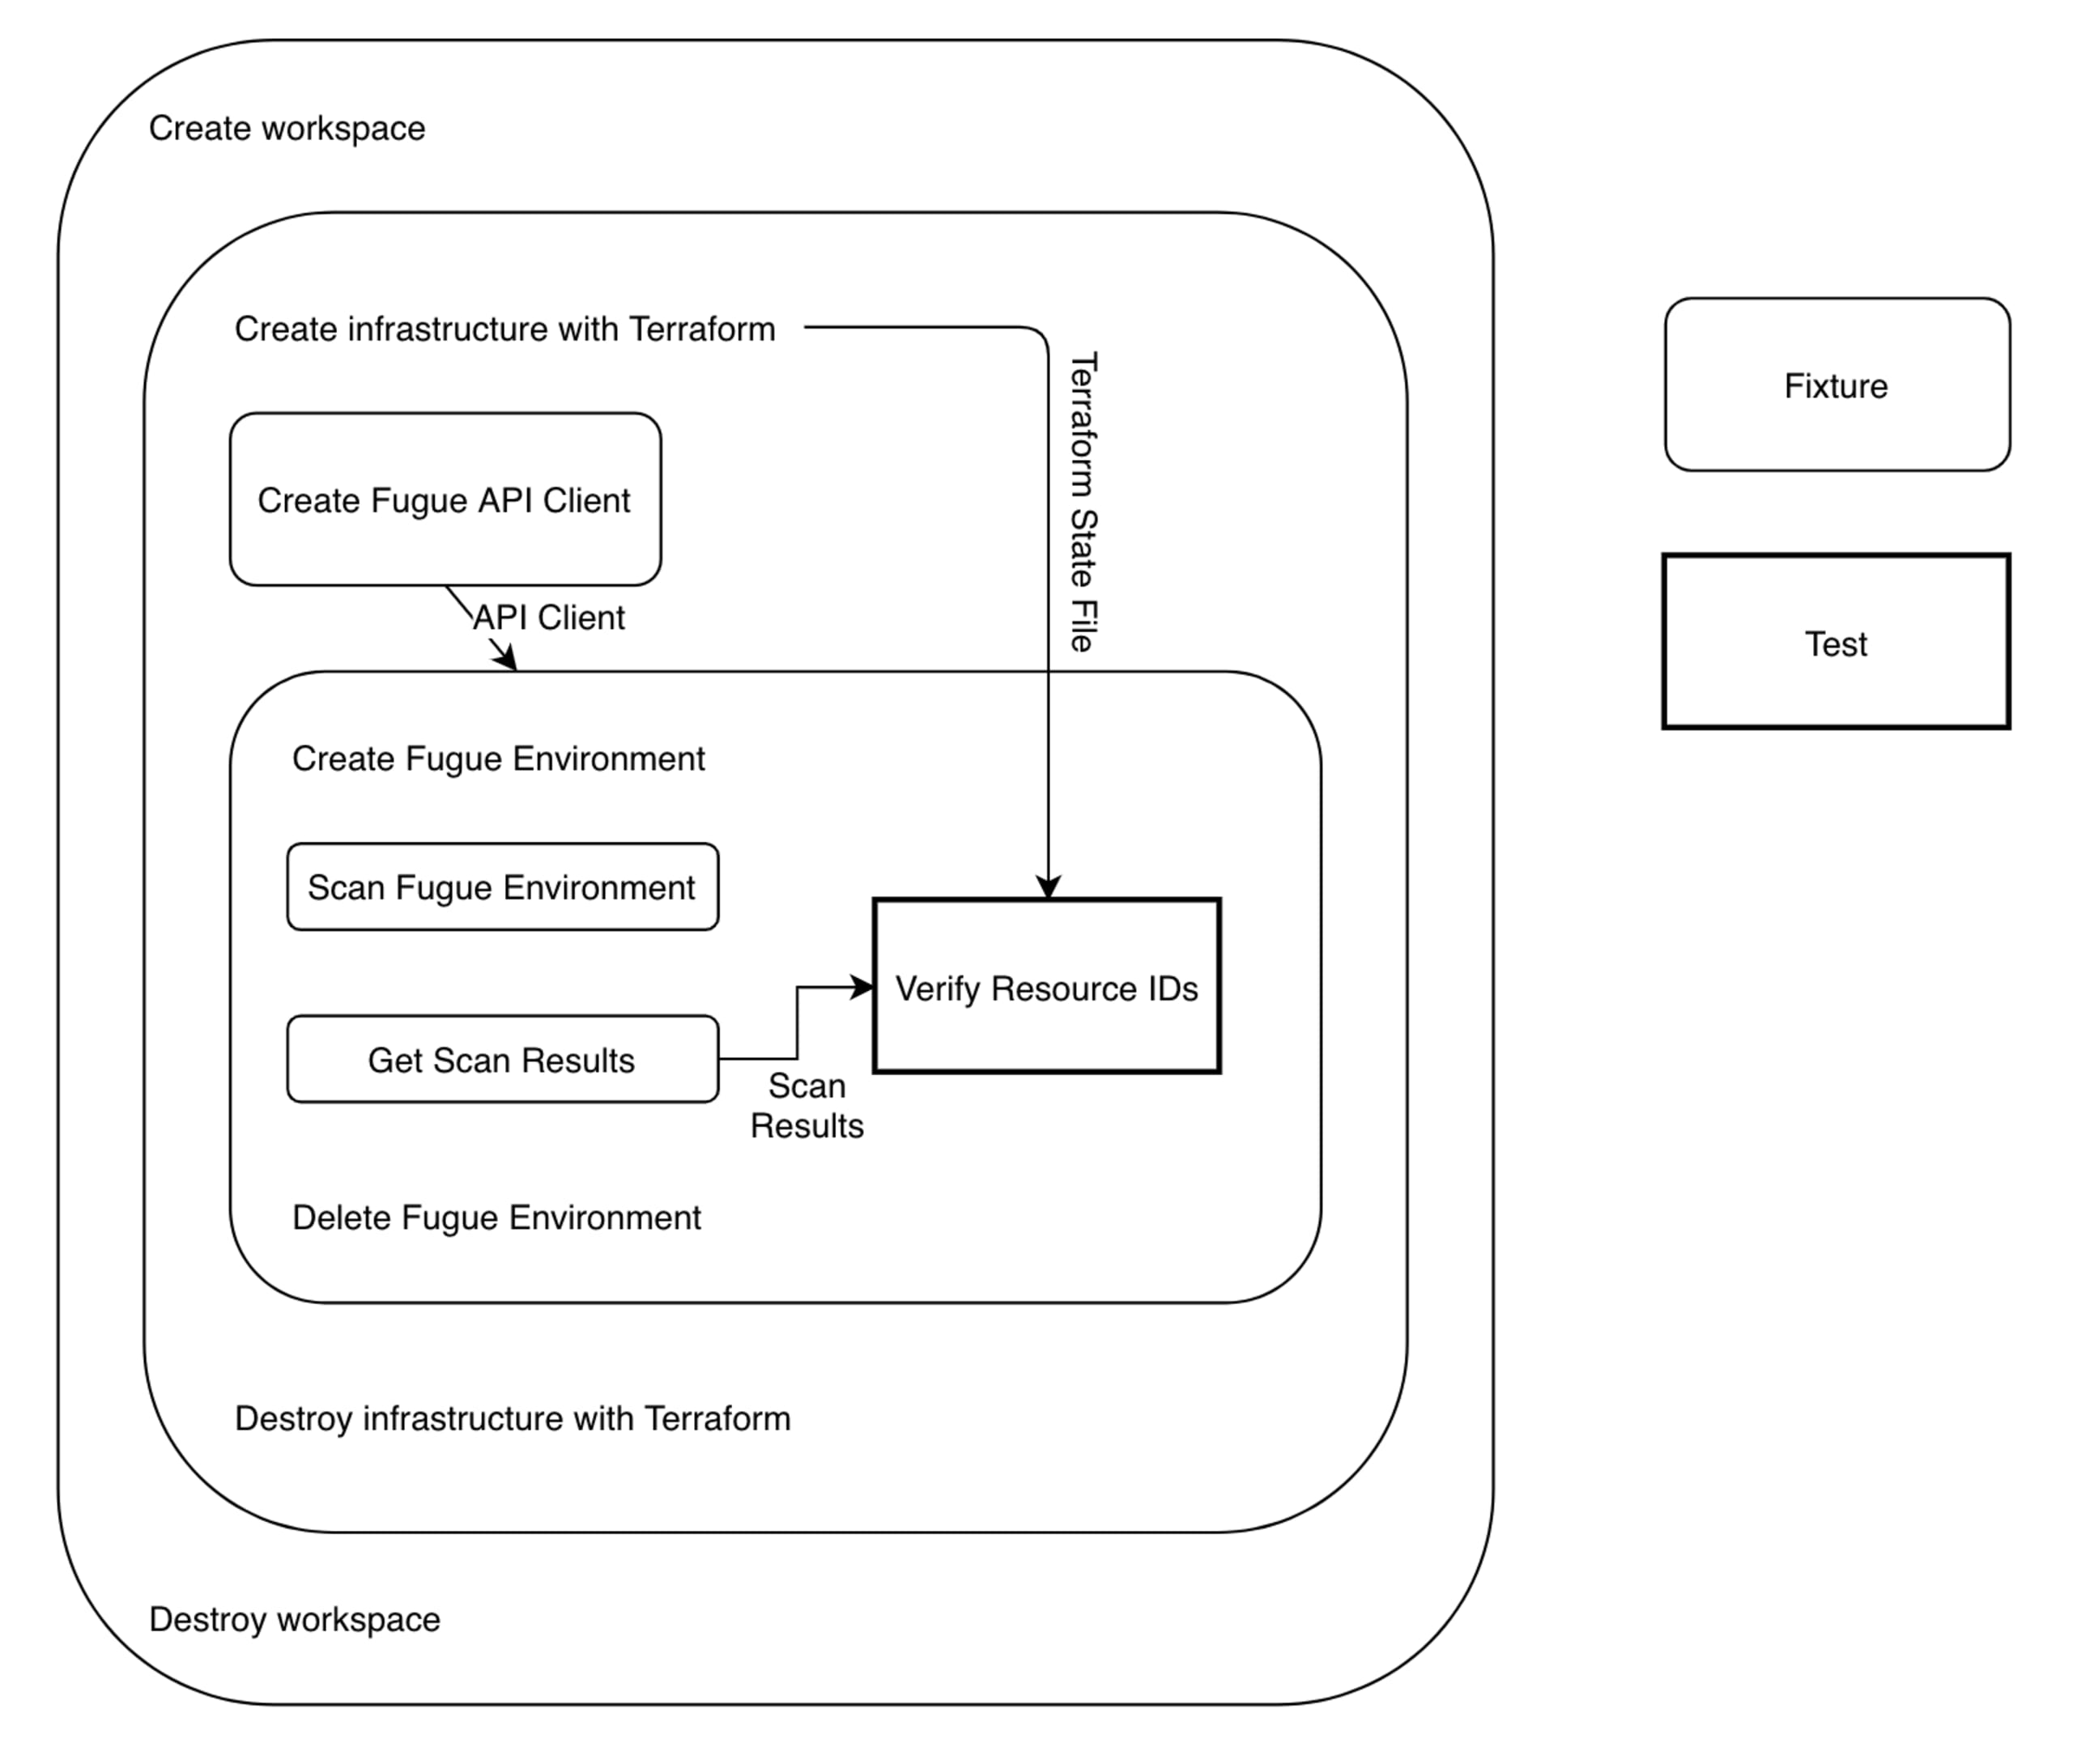
El proceso de prueba se puede dividir en tres pasos:
Usar Terraform para implementar infraestructura modular
Crear un entorno de Fugue que apunte a esta infraestructura y analizarlo
Obtener los resultados del análisis y verificarlos
Sabía que quería usar Terraform para el paso 1 porque ya teníamos varias configuraciones de Terraform para probar infraestructura y porque Terraform es compatible con AWS, Azure y muchos otros proveedores de servicios en la nube. Para el paso 2, sabía que podía usar la API de Fugue para crear el entorno e iniciar un análisis. Por último, podía volver a usar la API de Fugue en el paso 3 para obtener todos los resultados del análisis y verificarlos.
Una vez definido el diseño general, podía empezar a revisar pytest para entender cómo usarlo en su implementación.
PyTest
pytest es un framework de pruebas para Python que incluye detección de pruebas, aserciones mediante la instrucción integrada <código>assert</código> de Python y fixtures para administrar dependencias.
Los fixtures son el secreto mejor guardado de pytest. Son funciones decoradas que administran el ciclo de vida de las dependencias de las pruebas. El código de configuración y limpieza que tradicionalmente iría en los métodos setUp() y tearDown() se coloca en los fixtures. El alcance de un fixture se puede definir para reutilizar sus resultados entre clases, módulos o sesiones.
Veamos un ejemplo. Aquí defino y uso un fixture para acceder a una API. En una prueba unitaria usaría un objeto API simulado, pero en una prueba funcional tengo que usar la API real.
El fixture api_client se declara con el decorador @pytest.fixture, y puedo definir su alcance con el argumento scope del decorador. El cliente de API se puede reutilizar de forma segura en todas las pruebas, así que lo definí con alcance session. Los fixtures se pueden definir en el mismo módulo que las funciones o clases de prueba, o se pueden colocar en conftest.py para que estén disponibles en todos los módulos de prueba.
Puedo usar el fixture con solo incluir su nombre como argumento de una función de prueba. En este ejemplo, usé el fixture api_client en dos pruebas. Como definí el fixture con alcance session, pytest se asegurará de que solo se llame una vez durante cada sesión de pruebas.
Quizás notaste que el fixture api_client recibe un parámetro de entrada llamado creds. Nunca llamamos directamente a la función fugue_api, así que ¿cómo obtiene un valor creds?
Si adivinaste que creds también es un fixture, ¡te ganaste una estrella dorada! ⭐️ Los fixtures pueden llamar a otros fixtures, así que es posible crear dependencias complejas a partir de una cadena de fixtures. Veamos la definición de creds:
Mantengo buenas prácticas de seguridad, así que creds usa credstash para almacenar y recuperar valores secretos. El nombre del secreto se pasa como opción de línea de comandos a pytest. Estas opciones se definen en pytest_addoption y se accede a ellas mediante el fixture request. El fixture creds me permite abstraer fácilmente la implementación para obtener credenciales y centrarme en las entradas que necesita cada prueba o fixture. Si más adelante cambio la forma de acceder a las credenciales, solo tengo que modificar creds.
Ahora que conocemos los conceptos básicos de los fixtures de pytest, veamos cómo podemos usarlos para implementar nuestro diseño.
Paso 1: usar Terraform para implementar infraestructura
El primer paso de nuestra herramienta crea la infraestructura que se analizará y servirá como base para la verificación en los pasos 2 y 3. Sé que usaré Terraform para implementarla, pero ¿cómo funcionará exactamente?
Diseño
Este fragmento muestra la estructura de nuestras configuraciones de prueba existentes. Estas configuraciones se pueden implementar manualmente ejecutando terraform apply desde la raíz aws/ o desde un subdirectorio de servicio, como aws/api_gateway. Quiero conservar esta modularidad para poder elegir qué servicios probar. Podría llamar a Terraform con la estructura existente, pero sería una mala práctica: todo el trabajo con archivos debe hacerse en directorios temporales únicos para que las ejecuciones de pruebas se realicen en entornos controlados. Por eso sé que necesitaré una forma de administrar espacios de trabajo temporales. También necesitaré una forma de llamar a Terraform, registrar sus resultados y comprobar si hay errores. Terraform creará infraestructura real (y costosa), así que es fundamental gestionar los errores y eliminar la infraestructura si algo sale mal.
En resumen, los requisitos para el primer paso son:
Crear y administrar espacios de trabajo temporales
Copiar las configuraciones de prueba a un espacio de trabajo
Llamar a Terraform y gestionar los errores eliminando la infraestructura que ya se haya creado
Está claro que los puntos 1 y 2 se pueden resolver con un fixture, pero ¿algo tan complejo y propenso a errores como crear infraestructura con Terraform también puede funcionar como fixture?
Si respondiste que sí, ¡te ganaste otra estrella dorada! ⭐️ Veamos más de cerca cómo definimos nuestros fixtures de espacio de trabajo y Terraform.
El fixture de espacio de trabajo
En las seis líneas de código de workspace pasan muchas cosas. Primero, observa que workspace se define como un yield_fixture. Esto significa que la función devuelve el control a quien la llamó mediante yield en lugar de return. Mientras tanto, la ejecución del fixture queda suspendida, por lo que los administradores de contexto permanecen abiertos. Cuando el control vuelve al fixture, se ejecuta cualquier código que esté después de la instrucción yield. En este caso, se cierra el administrador de contexto Workspace. pytest se encarga de obtener el valor devuelto por un yield_fixture, así que podemos tratarlos igual que a los fixtures normales. workspace es un fixture con alcance de clase, por lo que se crea un espacio de trabajo nuevo para cada clase de prueba. De esta forma, puedo separar las pruebas de AWS y Azure por clase y asegurarme de que se cree un espacio de trabajo nuevo para cada proveedor.
Luego, vemos que workspace depende de tres fixtures: tmpdir_factory, provider y services. tmpdir_factory es un fixture integrado que devuelve un directorio temporal único. El directorio base se puede establecer manualmente con la opción --basetemp=DIRECTORY, algo útil para depurar. provider y services son fixtures que definí para devolver el proveedor con el que se está probando y la lista de servicios de la entrada.
Uno de mis aspectos favoritos de los fixtures es que fomentan las abstracciones claras. Las entradas de una prueba o fixture se definen mediante una interfaz —la definición de la función—, mientras que las implementaciones quedan ocultas en la definición del fixture. La modularidad de los fixtures me permite crear rápida y fácilmente un fixture independiente para cada entrada de workspace, así no tendré la tentación de construir los valores en workspace.
Por último, observa que Workspace es una clase de administrador de contexto. Esto cierra automáticamente el espacio de trabajo cuando finaliza el propio fixture. Como mencioné antes, la instrucción yield no finaliza el administrador de contexto hasta que el control vuelve al fixture cuando este termina. Usé este potente patrón en todo el diseño de autotest. La copia de las configuraciones de Terraform que quiero usar al espacio de trabajo se realiza en initialize_workspace, y dejo ese paso como ejercicio para el lector.
El fixture de Terraform
El fixture de Terraform en realidad consta de tres fixtures: terraform, infra y terraform_resources. El resultado de esta cadena de fixtures es un diccionario de recursos de Terraform leído desde el archivo de estado de Terraform. terraform inicializa Terraform en un espacio de trabajo, infra ejecuta terraform plan y terraform apply para crear la infraestructura, y terraform_resources extrae el mapa de recursos.
La inicialización y la extracción del mapa de recursos son sencillas, pero cabe señalar que terraform_resources debe ser un yield_fixture porque infra es un yield_fixture. Si terraform_resources devolviera un valor, cerraría el contexto que dejó abierto infra y activaría el código de desmontaje.
En lugar de usar una clase de administrador de contexto, infra usa un administrador de contexto basado en una función, build_infra, que se define a continuación:
build_infra usa el paquete python-terraform para llamar a Terraform y recopilar sus resultados. Comprobamos el código de error de cada operación y generamos excepciones personalizadas si se produce algún error. t.plan y t.apply llaman a terraform plan y terraform apply, respectivamente, para planificar y crear la infraestructura. terraform apply puede fallar después de crear parte de la infraestructura: terraform no elimina automáticamente la infraestructura que ya se haya creado. Por eso, capturamos TerraformApplyError y llamamos manualmente a t.destroy antes de volver a generar la excepción original.
build_infra es un generador: llama a yield en lugar de return, lo que me permite usar el decorador @contextmanager para convertirlo en un administrador de contexto. El bloque try...finally alrededor de yield garantiza que se ejecute el código de desmontaje incluso si se generan excepciones en el contexto que realiza la llamada.
Por último, observa la similitud entre el código del bloque except y el del bloque finally. Ambos hacen lo mismo: se aseguran de que la infraestructura se elimine sin importar lo que ocurra durante la ejecución. Como el código de un bloque finally se ejecuta tanto si se produce una excepción como si no, podemos consolidar los bloques try.
Además, sabemos que t.plan no crea recursos, así que podemos sacarlo del bloque try. En general, es una buena práctica mantener los bloques try tan acotados como sea posible. El administrador de contexto build_infra final queda así:
Paso 2: crear un entorno de Fugue y analizarlo
El siguiente paso de nuestro diseño general es usar la API de Fugue para crear un entorno y analizarlo en la cuenta donde se creó la infraestructura en el paso 1.
Diseño
La API de Fugue es una API REST definida con Swagger. Esto facilita la generación de un cliente que permite acceder a la API con funciones y tipos nativos, en lugar de hacer llamadas HTTP. Una vez que tenga un cliente funcional, podré usarlo para crear un entorno y analizarlo. Puedo dividir el proceso en tres pasos:
Generar y configurar un cliente para la API de Fugue
Usar el cliente para crear un entorno
Usar el cliente para iniciar un análisis y esperar a que termine
El cliente de la API de Swagger
Usé swagger-codegen para generar un cliente a partir de la definición de la API de Fugue:
Esto generó un paquete completo de Python para el cliente de la API, que no necesitaba, así que copié el código del cliente directamente en autotest. Luego inicialicé el cliente como se muestra a continuación:
Aquí, creds es solo un parámetro de entrada, no un fixture, porque initialize_client no es un fixture ni una prueba. Recuerda que initialize_client se llama desde un fixture que depende del fixture creds:
Definir el fixture de la API de entornos es sencillo, ya que no es necesario finalizar los clientes de API. El cliente generado por Swagger tiene un cliente de API base que administra la conexión con la API y clases separadas para cada división de nivel superior de la API. Luego, las acciones de la API están disponibles como métodos en cada clase.
Una nota sobre las abstracciones: oculto los detalles del cliente de Swagger mediante el módulo api. Esto concuerda con el principio de abstraer en ambos lados de una interfaz y me da flexibilidad para adaptarme a cualquier cambio que pueda ocurrir en la interfaz del cliente. Exploraremos esto con más detalle cuando hable sobre la creación de un entorno mediante la API.
Crear un entorno y analizarlo
Mi primer intento de crear un fixture de entorno se veía más o menos así:
Esto es una aplicación sencilla del método create_environment de la API de entornos. Obtengo las credenciales y los parámetros de entrada de los fixtures aws_creds, survey_resource_types y services. El alcance del fixture se limita a las clases porque organizo las pruebas por clase para cada proveedor de nube. Por último, uso yield para devolver el entorno y poder eliminarlo automáticamente cuando termine la prueba.
El diseño de este fixture es sencillo y cumple con lo que necesito. Si quisiera, podría dejarlo tal como está y continuar. Sin embargo, este enfoque tiene algunas desventajas. La entrada de create_environment es engorrosa porque tiene muchos campos, algunos de los cuales dependen del proveedor. Usar la API de entornos directamente en el fixture limita mi flexibilidad para preparar los parámetros de entrada de create_environment sin crear una función enorme y difícil de leer. La dificultad de equilibrar la legibilidad y la reutilización me llevó a renunciar a la reutilización, fijar el proveedor en el código y duplicar el fixture environment para los entornos de Azure, lo cual no era una buena solución. Lo que realmente necesito es otra capa entre el código del fixture y la API de entornos, que encapsule la preparación engorrosa de las entradas y administre la relación entre el fixture y la API. Por suerte, el módulo api cumple exactamente esa función.
Separé la preparación de las entradas y la invocación de la API en una función del módulo api:
Aunque es extensa, esta función maneja tanto AWS como Azure y permite reducir el fixture environment a lo esencial:
Puedo aplicar el mismo enfoque para iniciar análisis en un entorno:
Incluir el fixture terraform_resources, aunque no use su resultado, garantiza que los recursos se hayan creado antes de iniciar un análisis. Luego, en el módulo api:
Ahora tengo fixtures para crear recursos con Terraform y crear un entorno de Fugue y analizarlo, así que casi estoy listo para escribir algunas pruebas.
Paso 3: Recuperar y verificar los resultados del análisis
Antes de escribir pruebas, necesito poder obtener los resultados del análisis desde la API de Fugue. Los resultados están disponibles en la API a través del endpoint custom rules test input. Crear este fixture es una aplicación sencilla de los conceptos que usé anteriormente:
get_scan_resources simplemente pasa los datos:
En funciones sencillas como esta, resulta tentador omitir la capa de abstracción y colocar la llamada a la API directamente en el fixture. De hecho, eso hice en la primera versión de esta función. Sin embargo, esto crea una abstracción con filtraciones: una capa de abstracción que expone parte de la funcionalidad subyacente que debería ocultar. Las abstracciones con filtraciones terminan aumentando, en lugar de disminuyendo, la carga cognitiva de usar una abstracción.
Ahora que tengo un fixture scan_resources, cuento con todas las entradas que necesito para mi prueba. Después de toda la preparación y las abstracciones que describí en las secciones anteriores, la prueba en sí solo requiere unas pocas líneas de código:
check es un fixture del plugin pytest que proporciona aserciones que no provocan fallas. verify_resource_id es una función de verificación sencilla que compara dos recursos y devuelve true si tienen el mismo ID de recurso:
Tengo acceso a todos los detalles del recurso por si quiero escribir pruebas más complejas, pero por ahora es suficiente configurar la infraestructura y verificar que se haya analizado correctamente. Al ejecutar la prueba, se genera este resultado:
Conclusión
Esta publicación describió la creación de autotest, una herramienta automatizada para probar infraestructura, mediante pytest. Hablé sobre el poder de los fixtures modulares de pytest, que facilitan la creación de abstracciones limpias y potentes. También expliqué cómo usar la API de Fugue para crear entornos y análisis, y cómo encapsular esas acciones en fixtures. Después, hablé sobre el uso del endpoint custom rule test input de la API de Fugue para descargar una descripción completa de los recursos de un análisis. Por último, reuní todos estos elementos en una prueba.
Una cosa más…
Fugue es seguridad y cumplimiento en la nube. Creado para ingenieros, por ingenieros. Con Fugue, puedes:
Obtener visibilidad completa de tu entorno de infraestructura en la nube y de su postura de seguridad mediante visualizaciones dinámicas e informes de cumplimiento.
Validar el cumplimiento en cada etapa del ciclo de vida de desarrollo de software para CIS Foundations Benchmark, HIPAA, PCI, SOC 2, NIST 800-53, ISO 27001, GDPR y tus políticas personalizadas.
Protegerte contra las configuraciones incorrectas en la nube mediante la aplicación de una configuración base que permite que la infraestructura crítica para la seguridad se repare automáticamente.
Seguridad de IaC diseñada para desarrolladores
Snyk protege tu infraestructura como código desde el ciclo de vida del desarrollo de software hasta el runtime en la nube con un motor unificado de políticas como código, para que todos los equipos puedan desarrollar, implementar y operar de forma segura.


