Ubicaciones automáticas del código fuente con Rego

12 de febrero de 2024
0 minutos de lecturaEn Snyk, somos grandes admiradores de Rego de Open Policy Agent. Snyk IaC se basa en un amplio conjunto de reglas escritas en Rego, y los clientes también pueden agregar sus propias reglas personalizadas.
Hace poco lanzamos una serie de mejoras para Snyk IaC y, en esta publicación del blog, analizamos en profundidad una función particularmente interesante: las ubicaciones automáticas del código fuente para las infracciones de reglas.
Al comprobar los archivos de IaC en busca de problemas conocidos, el comando actualizado `snyk iac test` mostrará información precisa sobre el archivo, la línea y la columna de cada infracción de regla. Esto también funciona con reglas personalizadas, sin que el usuario tenga que hacer nada.
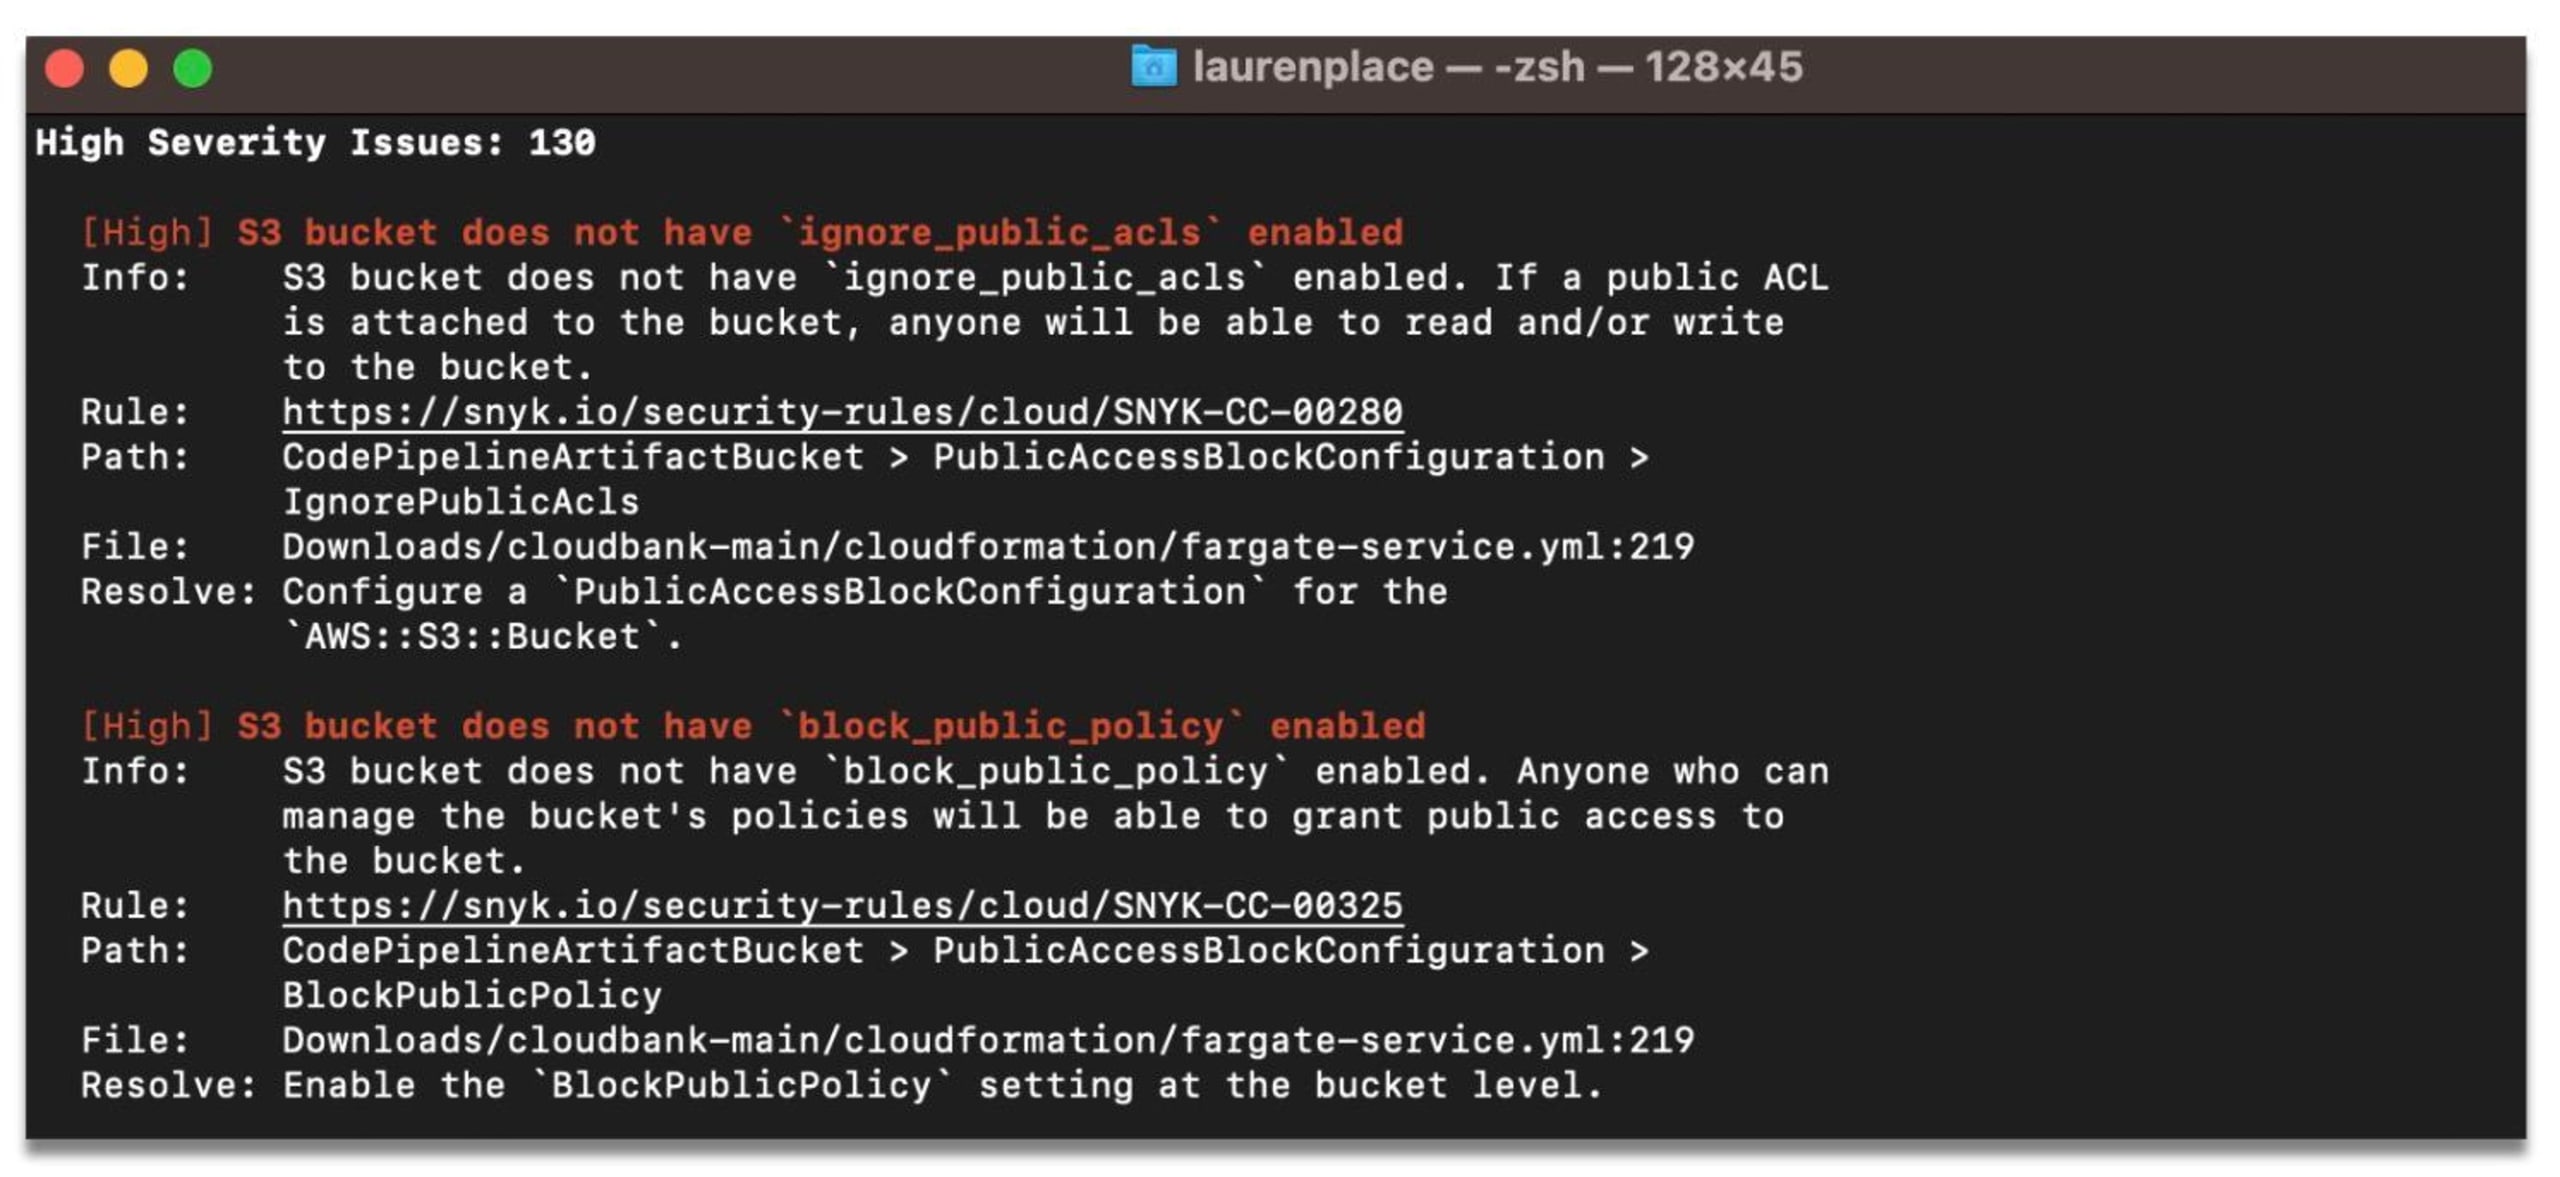
Pero antes de presentar una prueba de concepto independiente para esta técnica, tendremos que hacer algunas simplificaciones. La implementación completa está disponible en nuestro motor de políticas unificado.
Empecemos con un ejemplo de CloudFormation. Aunque nuestro motor de IaC admite muchos formatos y se enfoca especialmente en Terraform, CloudFormation es un buen ejemplo porque podemos analizarlo sin demasiadas dependencias (después de todo, es solo YAML).
Queremos asegurarnos de que ninguna subred use un bloque CIDR mayor que `/24`, así que escribamos una política de Rego para hacerlo:
De esta manera, `deny` generará un conjunto de recursos denegados. No explicaremos en detalle cómo funciona Rego, pero si quieres obtener más información, te recomendamos el excelente curso OPA by Example.
Podemos dividir el problema en dos partes:
Queremos inferir que nuestra política usa el atributo `CidrBlock`
Luego, recuperaremos la ubicación en el código fuente
Empecemos por (2), ya que nos permite familiarizarnos con el código.
Recuperación de la ubicación en el código fuente
Una ubicación en el código fuente se ve así:
También presentaremos un tipo auxiliar para representar rutas en YAML. En YAML, hay dos tipos de documentos anidados: arreglos y objetos.
Si quisiéramos poder hacer referencia a cualquier subdocumento, podríamos usar algo similar a las rutas JSON. En el ejemplo anterior, [`"some_array", 1`] apuntaría a `"word"`. Pero como no admitiremos arreglos en nuestra prueba de concepto, podemos conformarnos con usar un arreglo de cadenas.
Un ejemplo de una ruta sería algo como:
Ahora podemos ofrecer un tipo práctico para cargar YAML e indicarnos la `Location` de ciertas `Paths`.
Para encontrar la ubicación en el código fuente de una `Path`, hay que recorrer un árbol de nodos YAML:
Conjuntos y árboles de rutas
Con esto resuelto, redujimos el problema: en lugar de inferir automáticamente las ubicaciones en el código fuente que se usan en una política, inferiremos automáticamente las rutas de atributos.
Esto también es importante por otros motivos. Por ejemplo, Snyk puede aplicar las mismas políticas tanto a los recursos de IaC como a los recursos detectados mediante análisis de la nube. Estos últimos no tienen ubicaciones significativas en el código fuente, pero sí cuentan con rutas de atributos útiles.
Por lo tanto, queremos definir conjuntos de rutas de atributos. Como las rutas se respaldan con arreglos, lamentablemente no podemos usar algo como `map[Path]struct{}` como conjunto en Go.
En su lugar, tendremos que almacenarlas en un árbol recursivo.
Esta representación tiene otras ventajas. En general, solo nos interesan las rutas más largas que usa una política, ya que son más específicas. Nuestra política de ejemplo usa `Path{"Resources", "PrivateSubnet", "Properties"}` y también `Path{"Resources", "PrivateSubnet", "Properties", "CidrBlock"}`; solo nos interesa esta última.
Definiremos un método recursivo para insertar una `Path` en nuestro árbol:
…y también una manera de obtener una lista de `Paths`. Esto genera algunas asignaciones de memoria innecesarias, pero podemos aceptarlo.
Ahora tenemos una forma práctica de almacenar las `Paths` que usó una política, y podemos convertirlas en ubicaciones del código fuente.
Análisis estático frente a análisis en tiempo de ejecución
La siguiente pregunta es cómo determinar qué `Paths` de una entrada determinada usa una política y luego insertarlas en el árbol.
No es una pregunta sencilla, ya que el código puede manipular la entrada de distintas maneras antes de usar las rutas. Tendremos que revisar tanto las funciones definidas por el usuario ( `has_bad_subnet`) como las funciones integradas ( `object.get`), solo para ilustrar uno de los posibles obstáculos:
Por suerte, no somos los primeros en preguntarnos qué hacen los programas: la gente siente curiosidad por esto desde que se escribió el primero. Por lo general, hay dos maneras de responder una pregunta como esta sobre un fragmento de código:
Análisis estático: Intentar responder examinando el árbol de sintaxis, los tipos y otra información estática que podamos obtener del intérprete de OPA (o agregarle). La ventaja es que no necesitamos ejecutar esta política, lo cual es ideal si no confiamos en quienes la escribieron. La desventaja es que las técnicas de análisis estático suelen generar falsos negativos y falsos positivos.
Análisis en tiempo de ejecución: Rastrear la ejecución de políticas específicas e inferir qué `Paths` se usan a partir de la información en tiempo de ejecución. La desventaja es que tenemos que ejecutar la política, y agregar este análisis puede ralentizar su evaluación.
Probamos ambos enfoques, pero decidimos optar por el segundo porque nos resultó mucho más fácil implementarlo de forma confiable y el impacto en el rendimiento fue insignificante. También vale la pena mencionar que no se trata de una elección excluyente: podrías adoptar un enfoque híbrido y combinar ambos.
OPA ofrece una interfaz Tracer que permite recibir eventos sobre lo que hace el intérprete. Un caso de uso común de los rastreadores es enviar métricas o información de depuración a un registro centralizado. Sin embargo, hoy la usaremos para otra cosa.
Rastrear el uso de términos
Rego es un lenguaje expresivo. Aunque se realizan algunas transformaciones para simplificarlo y reducirlo a un formato más simple para el intérprete, sigue habiendo una cantidad considerable de eventos.
Solo nos interesan dos de ellos. Consideramos que un valor se usa si:
1. Se unifica (puedes pensar en esto como una asignación; no entraremos en detalles) con otra expresión, como:
Esto también incluye `==` y `:=`. Como esta prueba puede fallar, podemos afirmar que usamos tanto el lado izquierdo como el derecho.
2. Se usa como argumento de una función integrada, como:
Aunque Rego toma algunos conceptos de los lenguajes perezosos, los argumentos de las funciones integradas siempre están completamente evaluados antes de invocar la función. Por lo tanto, podemos decir que usamos todos los argumentos que se pasan a la función integrada.
3. Se usa como expresión independiente, por ejemplo:
Esto se usa comúnmente para evaluar booleanos y comprobar que existan atributos.
Ahora es momento de implementar. Buscamos dos eventos y delegamos el trabajo a una función específica para que el código sea un poco más legible:
Más adelante nos encargaremos de insertar elementos en nuestro `PathTree` mediante una función auxiliar llamada `used(*ast.Term)`. Por ahora, marquemos como usados tanto el lado izquierdo como el derecho de la unificación:
`event.Plug` es una función auxiliar que reemplaza las variables por sus valores reales.
Un evento `EvalOp` cubre los casos (2) y (3) mencionados antes. En el caso de una función integrada, tendremos un arreglo de términos: el primer elemento es la función y los demás son los argumentos. Podemos comprobar que se trata de una función integrada consultando `ast.BuiltinMap`.
El caso de una expresión independiente es sencillo.
Anotar términos
Al intentar implementar `used(*ast.Term)`, surge la siguiente pregunta: dado un término, ¿cómo lo vinculamos con una `Path` de la entrada?
Una opción sería buscar términos coincidentes en el documento de entrada. Pero eso produciría muchos falsos positivos, ya que una cadena como `10.0.0.0/24` podría aparecer varias veces en la entrada.
En su lugar, vamos a anotar todos los términos con su ruta. Los términos en OPA pueden incluir metadatos, como la ubicación en el archivo fuente de Rego. Podemos reutilizar este campo para almacenar una `Path` de entrada. Es un poco improvisado, pero, si lo miramos con buenos ojos, no nos estamos desviando demasiado: el campo está pensado para almacenar ubicaciones.
El siguiente fragmento muestra cómo queremos anotar las primeras líneas de nuestra plantilla de CloudFormation:
`annotate` implementa un recorrido recursivo para determinar la `Path` de cada nodo del valor. Para mantener la concisión, solo admitimos objetos y dejamos fuera los conjuntos y los arreglos.
Con esta anotación, es fácil escribir `used(*ast.Term)`. Lo único que hay que tener en cuenta es que no todos los valores están anotados. Solo lo hacemos con los que provienen del documento de entrada, no con, por ejemplo, los literales incluidos en el código fuente de Rego.
Conclusión
¡Eso es todo! Omitimos muchos detalles, como el uso de arreglos y cómo aplicar esto a un lenguaje de IaC más complejo, como HCL.
Además, también marcamos los atributos `Type` como usados, ya que los comprobamos en nuestra política. Esto no es lo ideal y, como alternativa, intentamos ofrecer una API de Rego orientada a los recursos. Pero eso queda fuera del alcance de este ejemplo.
Si te interesa obtener más información sobre cualquiera de estas funciones, te recomendamos consultar snyk/policy-engine para conocer la implementación principal o la versión actualizada de Snyk IaC, que incluye esta función y muchas otras, entre ellas un paquete exhaustivo de reglas.
A continuación, presentamos una función principal que integra todo y muestra información de depuración. En su mayor parte, solo reúne las primitivas que definimos hasta ahora y las ejecuta con un ejemplo. Pero la incluimos para que esta publicación sirva como ejemplo independiente y reproducible.
Puedes encontrar el código completo de esta prueba de concepto en este gist.
Seguridad de IaC diseñada para desarrolladores
Snyk protege tu infraestructura como código desde el ciclo de vida del desarrollo de software hasta el runtime en la nube con un motor unificado de políticas como código, para que todos los equipos puedan desarrollar, implementar y operar de forma segura.