Diseño de una aplicación web sin servidor en AWS
9 de mayo de 2016
0 minutos de lecturaNota del editor
Este blog se publicó originalmente en fugue.co. Fugue se unió a Snyk en 2022 y es un componente clave de Snyk IaC.
Aquí en Fugue, el equipo web es una minoría pequeña pero entusiasta: somos fanáticos de JavaScript, de los 60 fotogramas por segundo y de mantener simple nuestro DevOps. Nos gusta experimentar y probar nuevos enfoques de computación que priorizan la sustancia y la elegancia por encima de las modas y lo llamativo. Desde hace un tiempo usamos AWS Lambda con temas de SNS y votebots, pero no habíamos intentado nada grande con esta tecnología. Hasta ahora. El Serverless framework nos dio el impulso que necesitábamos. ¿Nuestro objetivo? Crear una aplicación útil para una función empresarial mediante una API desarrollada con Lambda y API Gateway, sin afectar ninguna instancia EC2 en el proceso.
Retrocedamos un momento para explicar brevemente AWS Lambda. Al igual que IBM OpenWhisk, Google Cloud Functions y Azure Functions, es un servicio «para ejecutar código en respuesta a eventos específicos, como la carga de un archivo en Amazon S3, un flujo de eventos o una solicitud a una API gateway». Fintan Ryan ofrece una buena descripción general, parcialmente citada, aquí. Tu código se escala automáticamente para atender las solicitudes. Este tipo de computación directa va camino a expandirse de forma acelerada.
La aplicación
La aplicación web de front-end que creamos es sencilla. El usuario inicia sesión y ve contenido sobre nuestras compilaciones de software y URL de descarga segura. La aplicación está en S3. Estamos desarrollando una API REST para ofrecer esta experiencia. Considera la arquitectura de la API:
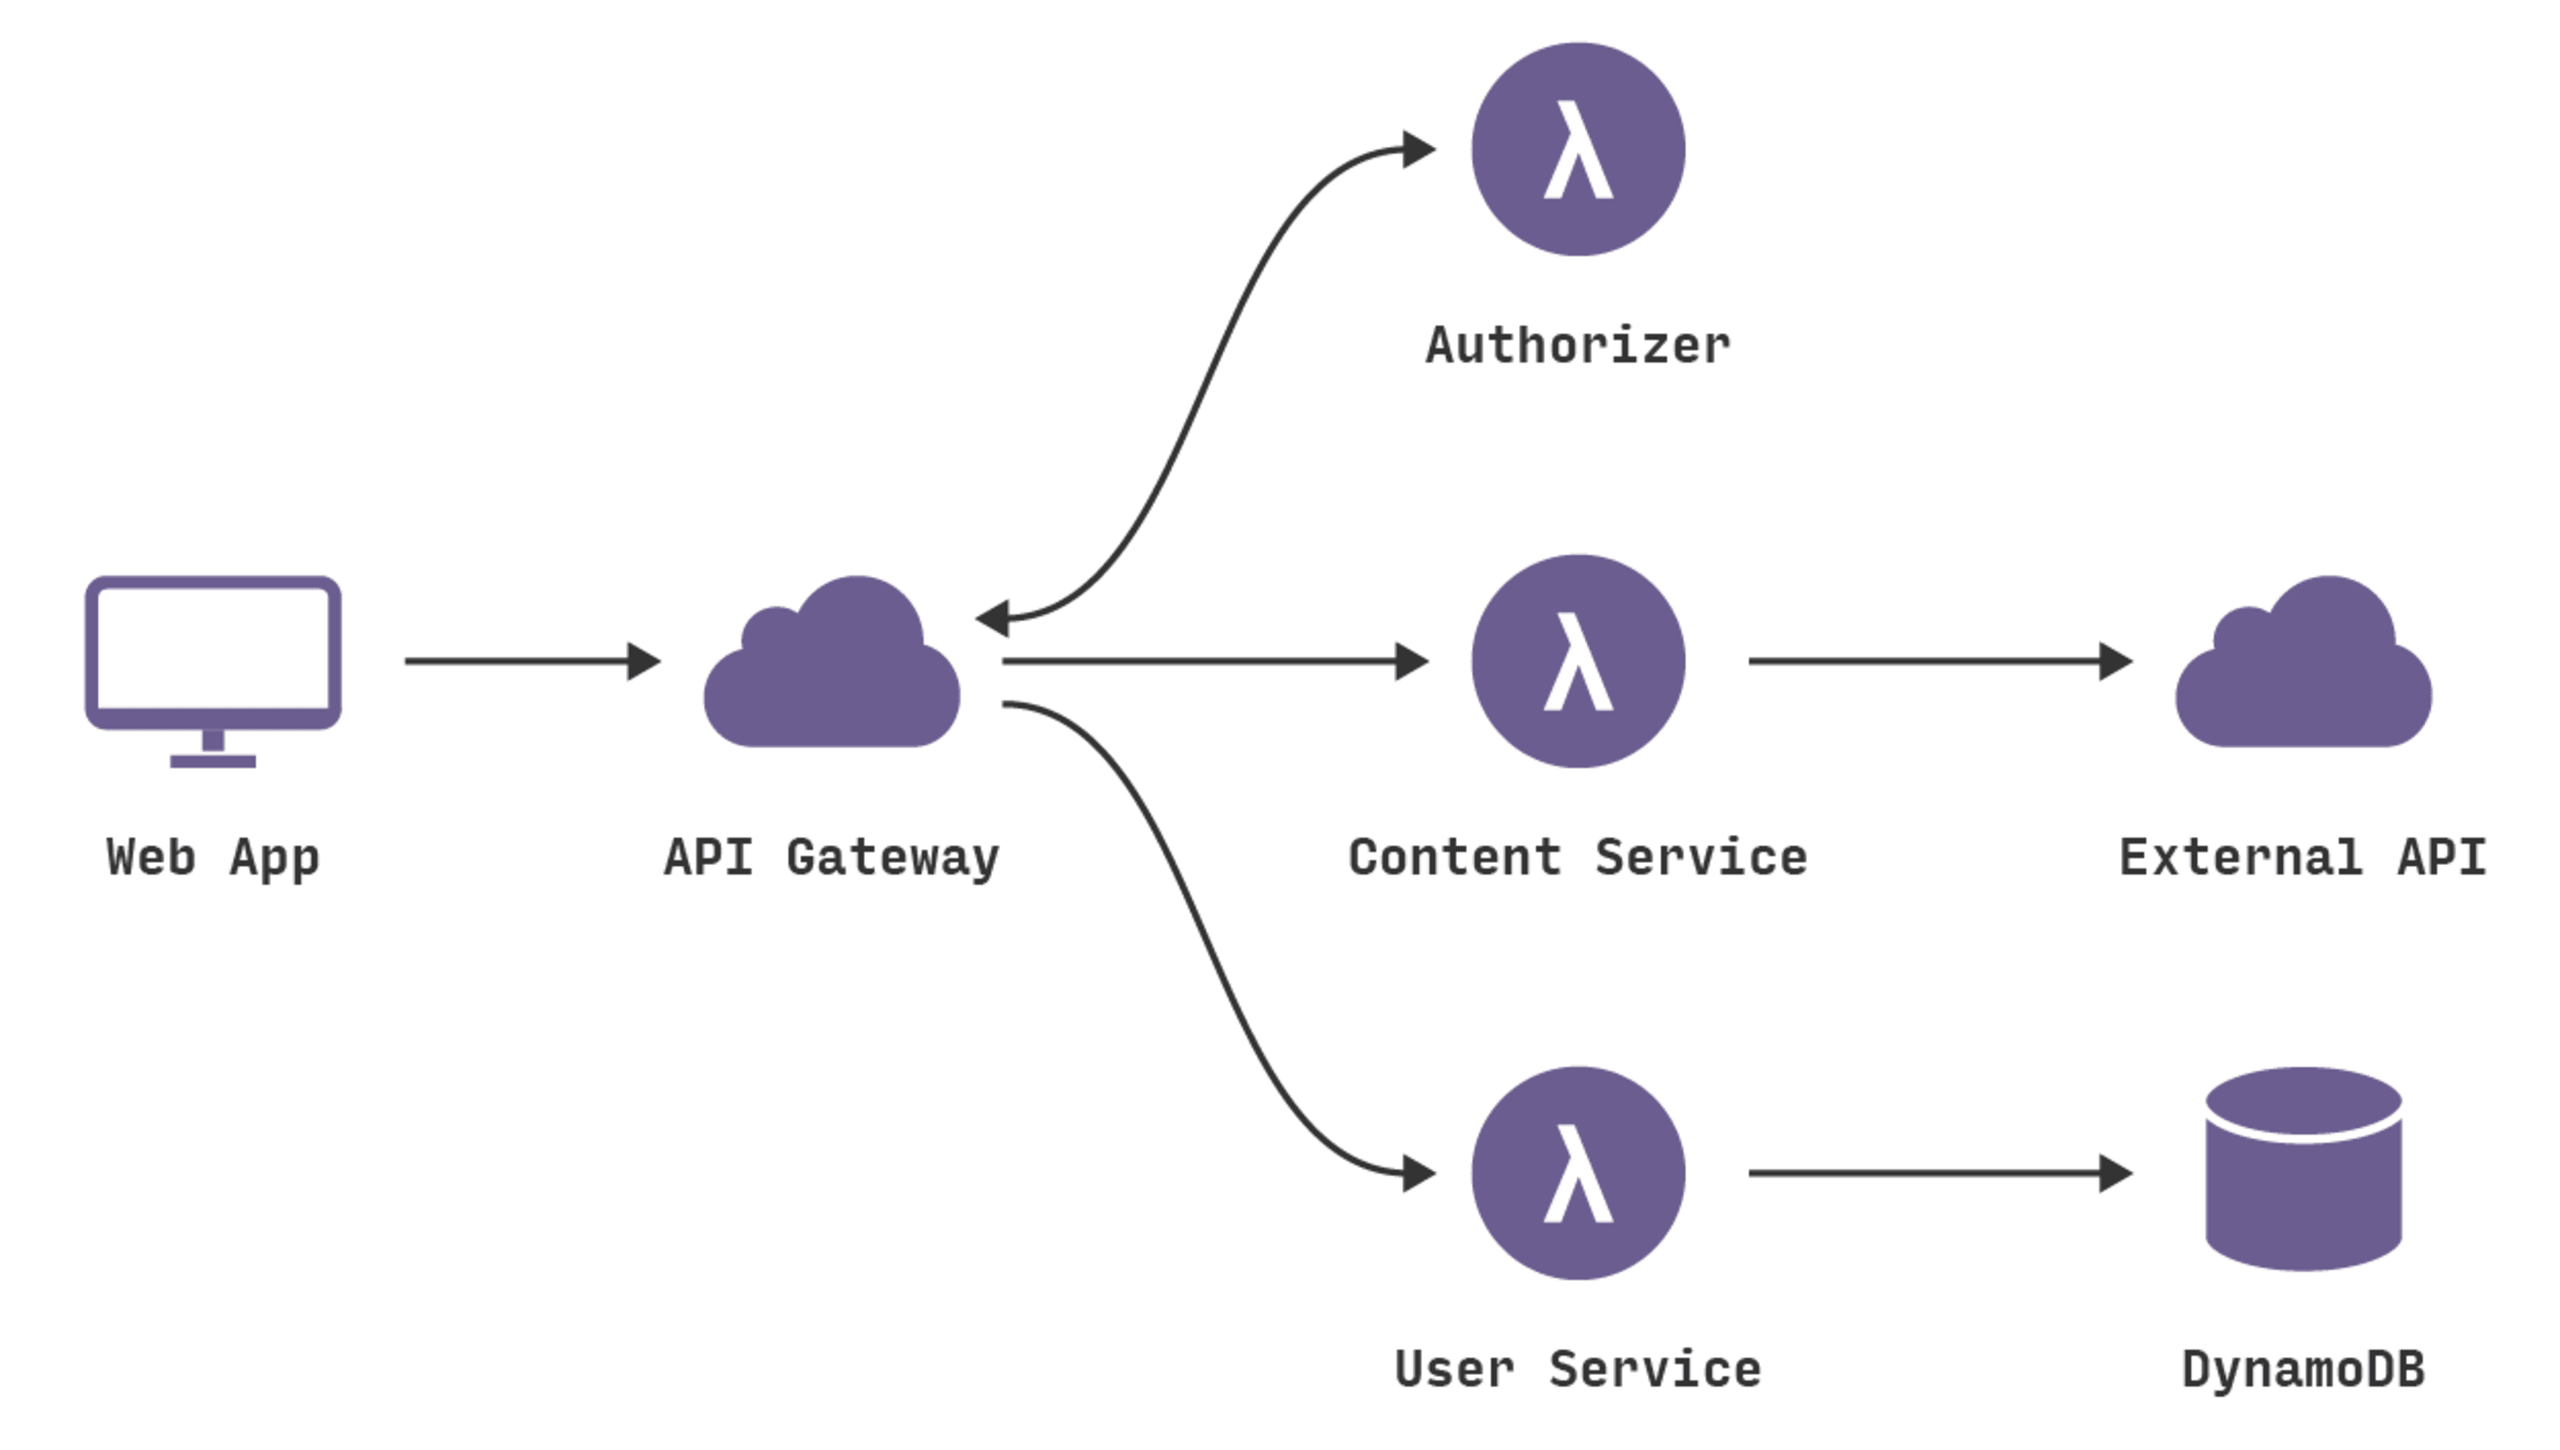
Observa que tenemos un conjunto de endpoints de API Gateway que activan funciones Lambda. La función Lambda User Service almacena datos en DynamoDB. La función Lambda Content Service se conecta a la API de nuestro servicio de distribución para recuperar contenido, le aplica algunas transformaciones visuales y lo envía a la aplicación de front-end. La función Lambda Authorization valida los tokens de sesión de los usuarios y brinda acceso a los endpoints protegidos.
Podrías configurar manualmente todos estos servicios en AWS, pero usamos Serverless framework como herramienta de implementación y para darle cierta estructura a nuestro proyecto.
Presentamos Serverless
Serverless es un framework para crear aplicaciones con Lambda y API Gateway. También permite administrar otros recursos de AWS mediante plantillas de CloudFormation. Se presenta como una CLI de Node.js con buena documentación.
Serverless es potente porque administra tanto tu código como la configuración de AWS. Cuenta con una estructura de proyecto específica y archivos de configuración JSON para tus funciones Lambda. Los archivos de configuración de las funciones incluyen definiciones de los endpoints de API Gateway y otros eventos que pueden activarlas. Para implementar el proyecto, debes crear un usuario de Serverless en tu cuenta de AWS y otorgarle permisos para los servicios que usas. Luego puedes usar la CLI para implementar el proyecto, configurar los servicios de AWS que utilizas y publicar el código de tus funciones Lambda.
Cómo resolver los puntos débiles
Serverless resuelve de forma eficaz algunos de los puntos débiles que encontramos al intentar configurar este tipo de proyecto en AWS sin usar ningún framework:
1) Las funciones Lambda son independientes y no pueden compartir código.
Si trabajas en un proyecto con varias funciones, probablemente quieras compartir código entre ellas, aunque solo sea una biblioteca utils. Las funciones Lambda se implementan en contenedores aislados, por lo que tu función no puede depender de un directorio de biblioteca común. Serverless lo resuelve permitiéndonos configurar el nivel de directorio específico que queremos incluir en el paquete de implementación. Así, puedes incluir en tu función código de una carpeta de un directorio superior, que también podrían usar otras funciones, y los archivos incluidos se comprimirán junto con el paquete de implementación.
2) Las funciones Lambda no admiten variables de entorno.
¿Cómo puedes incluir de forma segura credenciales secretas, como claves de API, en tu función Lambda sin insertarlas directamente en el código y hacerlas visibles para quienes usan tu repositorio de Github? Serverless almacena las definiciones de variables de entorno en archivos JSON dentro de una carpeta _meta ignorada por git e inserta los valores en tus funciones como parte del proceso de implementación. Si trabajas en equipo, el complemento Meta Sync sincroniza de forma segura estas definiciones de variables mediante S3.
3) Es difícil hacer que API Gateway se comunique con Lambda.
Cada endpoint de API Gateway necesita una plantilla de solicitud que especifique qué información de la solicitud estará disponible para la función Lambda que activa. Es probable que tu función Lambda necesite conocer la ruta y el método de la solicitud, los parámetros de URL, los parámetros de consulta y quizá un encabezado personalizado o el cuerpo de una solicitud POST. Nada de eso está disponible sin una plantilla de solicitud. Del mismo modo, API Gateway no interpreta de forma predeterminada la respuesta de una función Lambda. Por eso, si tu función devuelve un error, no hay una asignación automática a los códigos de error HTTP. Tendrás que agregar una plantilla de respuesta para asignar las cadenas de mensaje de error de la función Lambda al código de respuesta correspondiente. Serverless lo facilita al admitir la herencia de plantillas de solicitud y respuesta: puedes definir plantillas universales para todos tus endpoints y luego sobrescribirlas para cada endpoint cuando sea necesario.
Estructura del proyecto
Esta es la estructura de directorios del proyecto Serverless de nuestra aplicación:
s-project.json
Aquí se incluyen el nombre y la descripción del proyecto, además de los complementos personalizados que utiliza.
s-resources-cf.json
Esta es una plantilla de CloudFormation para los recursos que usa este proyecto, aparte de Lambda y API Gateway. En nuestro caso, se trata de una tabla de DynamoDB y un rol y una política de IAM que permiten que la función Lambda lea y escriba en DynamoDB.
_meta
Esta carpeta contiene archivos JSON con variables de entorno para el proyecto, que pueden variar según la etapa de implementación y la región. Esta carpeta está ignorada por git.
functions
Esta carpeta contiene subcarpetas para cada una de nuestras funciones Lambda. Serverless no impone una estructura organizativa, así que puedes anidar las funciones en carpetas como prefieras. La carpeta de una función debe contener un archivo con el código de la función (en este caso, handler.js) y un archivo s-function.json, que contiene la configuración de la función y los endpoints que pueden activarla. También puede contener un archivo event.json, que incluye un objeto de prueba del que hablaremos más adelante. Como mencionamos antes, tenemos una carpeta lib junto a las carpetas de funciones, que cada carpeta de función (es decir, user y content) puede incluir.
Un análisis más detallado de los componentes del proyecto Serverless
Nuestro proyecto Serverless tiene tres componentes arquitectónicos clave: funciones Lambda, una API REST de API Gateway y otros recursos de AWS, como nuestra tabla de DynamoDB y el rol de IAM. Analicemos en detalle cómo usamos estos componentes.
Funciones Lambda
Aparte de la función Lambda authorizer, de la que hablaremos en un momento, dividimos nuestro código en dos funciones: content y user. ¿Por qué?
Técnicamente, puedes dividir el código de Lambda como quieras. Todos tus endpoints podrían activar una sola función, que analizaría la solicitud y decidiría cómo responder. O puedes crear funciones para cada endpoint y evento del proyecto. Optamos por un enfoque híbrido y agrupamos el código en funciones de microservicios tras considerar un par de factores:
Organización del código
Tiene sentido asignar endpoints similares a una misma función. Todo nuestro código relacionado con los usuarios trabaja con la misma tabla de base de datos y usa las mismas bibliotecas externas. Si agrupamos este código similar en una función, podemos asegurarnos de que los cambios en el código se apliquen de inmediato a todos los endpoints.
Rendimiento
La documentación de Lambda indica que las funciones más pequeñas tienen mejor rendimiento. La latencia de una función es mucho mayor si no se ha invocado recientemente; según nuestra experiencia, esto ocurre si no se invoca durante unos cinco minutos. Después de la primera invocación, la latencia disminuye considerablemente. La latencia inicial, o «tiempo de arranque en frío», está directamente relacionada con el tamaño de la función. Las funciones más pequeñas tienen tiempos de arranque en frío más cortos. (También puedes reducir este tiempo si aumentas la memoria asignada a tus funciones, lo que incrementa proporcionalmente la CPU).
Este tiempo lento de arranque en frío no es un problema en los casos de uso asíncrono de Lambda, pero sí lo es para una API que recibe poco tráfico. Nuestra API debe responder rápido o se verá afectada la experiencia del usuario de la aplicación.
Agrupar funcionalidades relacionadas en funciones Lambda más grandes garantiza cierto nivel de preparación. Por ejemplo, cuando un usuario inicia sesión en su cuenta y luego ve su perfil, podrían ser dos llamadas a la API. La primera podría ser lenta si la función no se ha invocado recientemente, pero la segunda será rápida si ambos endpoints activan la misma función.
Nota: Hemos hablado de mantener nuestras funciones preparadas con solo hacer ping a un endpoint cada cinco minutos. Sin duda funcionaría, pero no hemos considerado necesario implementarlo.
Controlador de la función
En nuestro archivo s-function.json, definimos el controlador de la función. En nuestro caso, es una función llamada handler en handler.js. Esta es la función que se llamará cuando se invoque la función Lambda. Así es como se ve el archivo handler.js de la función content:
Como puedes ver, en realidad solo funciona como enrutador de nuestra función. Todo el código importante está abstraído en /lib/download.js, que no sabe que forma parte de una función Lambda. Esto facilita la escritura de pruebas unitarias para nuestro código, ya que /lib/download.js es simplemente un archivo JavaScript sin dependencias especiales de Lambda.
API REST de API Gateway
Los endpoints se configuran en el archivo s-function.json. Este es un ejemplo de configuración de un endpoint:
Este endpoint estará disponible en GET /downloads.
Plantillas de solicitud y respuesta
En la configuración del endpoint anterior viste $${requestTemplate} y $${responseTemplate}. Esto indica que el endpoint downloads heredará las plantillas requestTemplate y responseTemplate que definimos en un archivo global de plantillas para nuestro proyecto.
Las plantillas de solicitud y respuesta se representan en JSON y usan expresiones JSONPath. Puedes manipular expresiones JSONPath con Apache Velocity Template Language (VTL). La sintaxis es un poco complicada.
Serverless agregó recientemente compatibilidad con plantillas de solicitud y respuesta YAML, pero actualmente usamos el formato JSON. Así se ve nuestra plantilla de solicitud:
Sí, se ve un poco descabellado, como suele pasar con JSON escapado dentro de JSON, pero genera un objeto de evento para la función Lambda que contiene todo lo que necesitamos saber sobre la solicitud:
body contiene el cuerpo JSON analizado de la solicitud
path es la ruta del endpoint solicitado
method es el método HTTP usado en la solicitud
headers contiene todos los encabezados HTTP de la solicitud
params contiene los parámetros de ruta de la solicitud
query contiene los parámetros de consulta de la solicitud
authorizedUser es el nombre de usuario del usuario autorizado, si el endpoint requiere autorización
Y esta es nuestra plantilla de respuesta. Si la función Lambda se ejecuta correctamente, la cadena del resultado se envía al usuario como JSON (mediante el fragmento de plantilla response200). Si la función falla, las expresiones regulares intentan encontrar coincidencias en la cadena del resultado. Devolvemos distintos códigos de error HTTP según el mensaje de error.
Gestión de la autorización
Estamos aprovechando dos funciones de API Gateway para administrar los permisos de nuestra aplicación: las claves de API y las funciones de autorización personalizadas. Ambas nos permiten simplificar el código de la aplicación al eliminar las cuestiones de autorización de las funciones principales de Lambda.
Claves de API
API Gateway permite crear una clave de API y asignarla a endpoints específicos. Usamos esta función para proteger ciertos endpoints confidenciales a los que no se debería acceder desde el cliente, como los de administración de usuarios. API Gateway buscará un encabezado x-api-key en las solicitudes a los endpoints seleccionados e intentará hacer coincidir su valor con la clave de API que creamos. Si falta el encabezado o es incorrecto, la solicitud devuelve un error 403 y nunca invoca la función de Lambda.
Autorizadores personalizados
API Gateway agregó recientemente la autorización personalizada, que permite que una función de Lambda controle el acceso a los endpoints. Una solicitud entrante invocará la función de autorización personalizada con un token de autorización incluido en un encabezado de solicitud personalizado especificado. El autorizador personalizado validará el token de autorización (en nuestro caso, un JSON Web Token) y devolverá una política de IAM para autorizar la solicitud. Si la política no es válida para la solicitud o si falla la autorización, API Gateway devolverá un error 403. Si la política es válida, se activa la función de Lambda asignada al endpoint.
Este es un ejemplo de la política de IAM que devuelve nuestro autorizador personalizado:
Como nuestra aplicación web no tiene permisos granulares, damos acceso a todos los endpoints de la API que usan el autorizador personalizado. API Gateway almacenará en caché la política de IAM generada junto con el token de autorización que se usó para crearla. Las solicitudes posteriores a cualquier endpoint protegido que incluyan el mismo token de autorización en el encabezado recibirán esta política automáticamente y omitirán el autorizador personalizado durante el tiempo de vida (TTL) que especifiques.
Flujo de trabajo del proyecto Serverless
Entornos
Como mínimo, nuestro proyecto necesita entornos separados para desarrollo, pruebas y producción.
Serverless tiene el concepto de «stages», que se implementan de distintas maneras en los diferentes servicios de AWS, pero que en conjunto funcionan como un entorno.
Lambda: cada vez que se cambia el código de una función de Lambda, se crea automáticamente una nueva versión. Las funciones de Lambda pueden tener alias para sus versiones, y Serverless usa alias para apuntar a distintas versiones en diferentes stages. Por ejemplo, si se publica el stage dev y se convierte en la versión 1 de la función de Lambda, Serverless también crea un alias dev que apunta a la versión 1. Si después se publica el stage prod de la función, el código de producción se convierte en la versión 2, pero el alias dev sigue apuntando a la versión 1.
API Gateway: una sola API en API Gateway puede tener varios stages. Cada stage de un endpoint de la API puede activar un alias de Lambda diferente, por lo que el stage dev de API Gateway puede usar el alias dev de la función de Lambda, que apuntará a la versión que corresponda. El nombre del stage forma parte de la ruta del endpoint.
Otros servicios de AWS, como las tablas de DynamoDB y los buckets de S3, existen individualmente en cada stage.
Pruebas
La carpeta de cada función de Lambda puede contener un objeto de evento simulado para las pruebas en un archivo event.json:
serverless function run ejecutará la función usando event.json como evento. Esto es útil para probar la función de extremo a extremo.
Hay algunos complementos de Serverless que simulan API Gateway localmente para hacer pruebas, como Offline y Serve. Como API Gateway sigue agregando funciones, descubrimos que esos complementos no siempre eran compatibles con las funciones que queríamos usar, así que terminamos haciendo la mayoría de las pruebas de API Gateway en la consola de AWS.
Usamos Jasmine para las pruebas unitarias de nuestros archivos JavaScript lib.
Implementación
Para que nuestro proyecto esté listo para usarse, es necesario implementar tres elementos: funciones, endpoints y recursos del proyecto (es decir, los recursos de AWS que aparecen en s-resources.json). Podemos implementarlos individualmente con estos comandos de la CLI:
O podemos usar el práctico panel interactivo de implementación con el comando serverless dash deploy:
Con cualquiera de estas opciones, podemos implementar cambios de forma muy granular, por lo que es posible actualizar una función o un endpoint sin cambiar nada más.
El panel interactivo es muy útil para el desarrollo y las pruebas locales, pero usamos el primer conjunto de comandos con las herramientas de integración continua. De forma predeterminada, la CLI te pedirá las opciones que falten, pero puedes desactivar esta interacción configurando en true una variable de entorno llamada CI. Usamos Travis CI para la integración continua y las implementaciones, así que Travis ejecuta nuestras pruebas unitarias y luego usa la CLI en modo CI para implementar nuestro código en AWS.
Consulta la referencia de la CLI de Serverless para obtener más detalles.
Reflexiones finales
Hace unos meses, nuestro CEO, Josh, compartió sus reflexiones sobre AWS Lambda y la evolución continua de la nube. Señaló lo siguiente:
Lambda es un servicio que impone una arquitectura de aplicaciones de una manera que las ofertas tradicionales de PaaS no hacen. No pretende ser una computadora tradicional ni un clúster de computadoras tradicionales. En cambio, Lambda es inherentemente impulsado por eventos e impone la ausencia de estado a nivel de función. Esto significa que tendrás que pensar de otra manera en cómo componer una aplicación. Obtienes escalabilidad casi infinita y un costo muy bajo en comparación con las instancias de cómputo o los contenedores. Como contrapartida, tendrás que dedicar tiempo a aprender, pero es muy posible que inventes nuevos patrones durante la experimentación y la exploración.
Estamos de acuerdo. Vale la pena dedicar tiempo a aprender y ponerlo en práctica. Esperamos que el ejemplo que presentamos aquí te resulte útil. Es probable que surjan más frameworks como Serverless en un futuro cercano, pero este es una buena opción para empezar y crear una aplicación web sólida.
Seguridad de IaC diseñada para desarrolladores
Snyk protege tu infraestructura como código desde el ciclo de vida del desarrollo de software hasta el runtime en la nube con un motor unificado de políticas como código, para que todos los equipos puedan desarrollar, implementar y operar de forma segura.


