VulnBump: Können KI-Agenten anfällige Abhängigkeiten beheben, ohne den Build zu beschädigen?



15. Oktober 2026
0 Min. LesezeitKönnen KI-Agenten anfällige Abhängigkeiten beheben, ohne den Build zu beschädigen? Die eigentliche Behebung ist selten das Rätsel. Über sechs Monate hinweg erfasste Snyk Open Source im Jahr 2026 459 Millionen Schwachstellenbefunde bei rund 300.000 Organisationen. Für 94 % dieser Schwachstellen gab es eine bekannte Version mit Fehlerbehebung, doch nur etwa 10 % waren behoben.
Der Grund: Schwierig ist das sichere Upgrade. Die meisten anfälligen Pakete werden transitiv eingebunden, etwa ein Viertel der Behebungen erfordert ein Major-Version-Upgrade, und selbst Minor- und Patch-Versionen, die eigentlich abwärtskompatibel sein sollten, enthalten oft Breaking Changes.
VulnBump, eine neue bei Snyk veröffentlichte Studie, stellt KI-Agenten mit 307 realen Upgrades anfälliger Abhängigkeiten auf die Probe. Ein Upgrade gilt nur dann als BESTANDEN, wenn die Schwachstellen behoben sind und sich das Projekt weiterhin installieren und bauen lässt und alle Tests besteht.
Was ist neu: Unseres Wissens ist VulnBump der erste Benchmark für KI-Agenten, der sich mit sicherheitsorientierten Upgrades befasst: Jede Aufgabe beginnt mit realen Schwachstellen, die Snyk in einem echten Projekt gefunden hat, und umfasst sechs Paketmanager. Frühere Upgrade-Benchmarks prüfen nur, ob etwas kaputtgeht – nicht, ob die Schwachstelle behoben ist.
Können KI-Agenten also anfällige Abhängigkeiten beheben, ohne den Build zu beschädigen? Meistens ja, aber nicht das Modell allein entscheidet darüber. Mit demselben Modell, Claude Sonnet 5.5, bestand der Evo Remediation Agent von Snyk 90,2 % der Upgrades. Claude Code von Anthropic bestand 77,5 %, wenn Snyks empfohlenes Upgrade und Scan bereitgestellt wurden (Claude Code + Snyk-Scan), und 59,6 % ohne Snyk-Daten (Claude Code ohne Unterstützung). Das ist ein Unterschied von mehr als 30 Prozentpunkten. Zum Vergleich: Das Paketmanager-Upgrade als Basiswert ohne KI, bei dem lediglich die von Snyk empfohlene Version angewendet wird, bestand bereits 46,9 %.
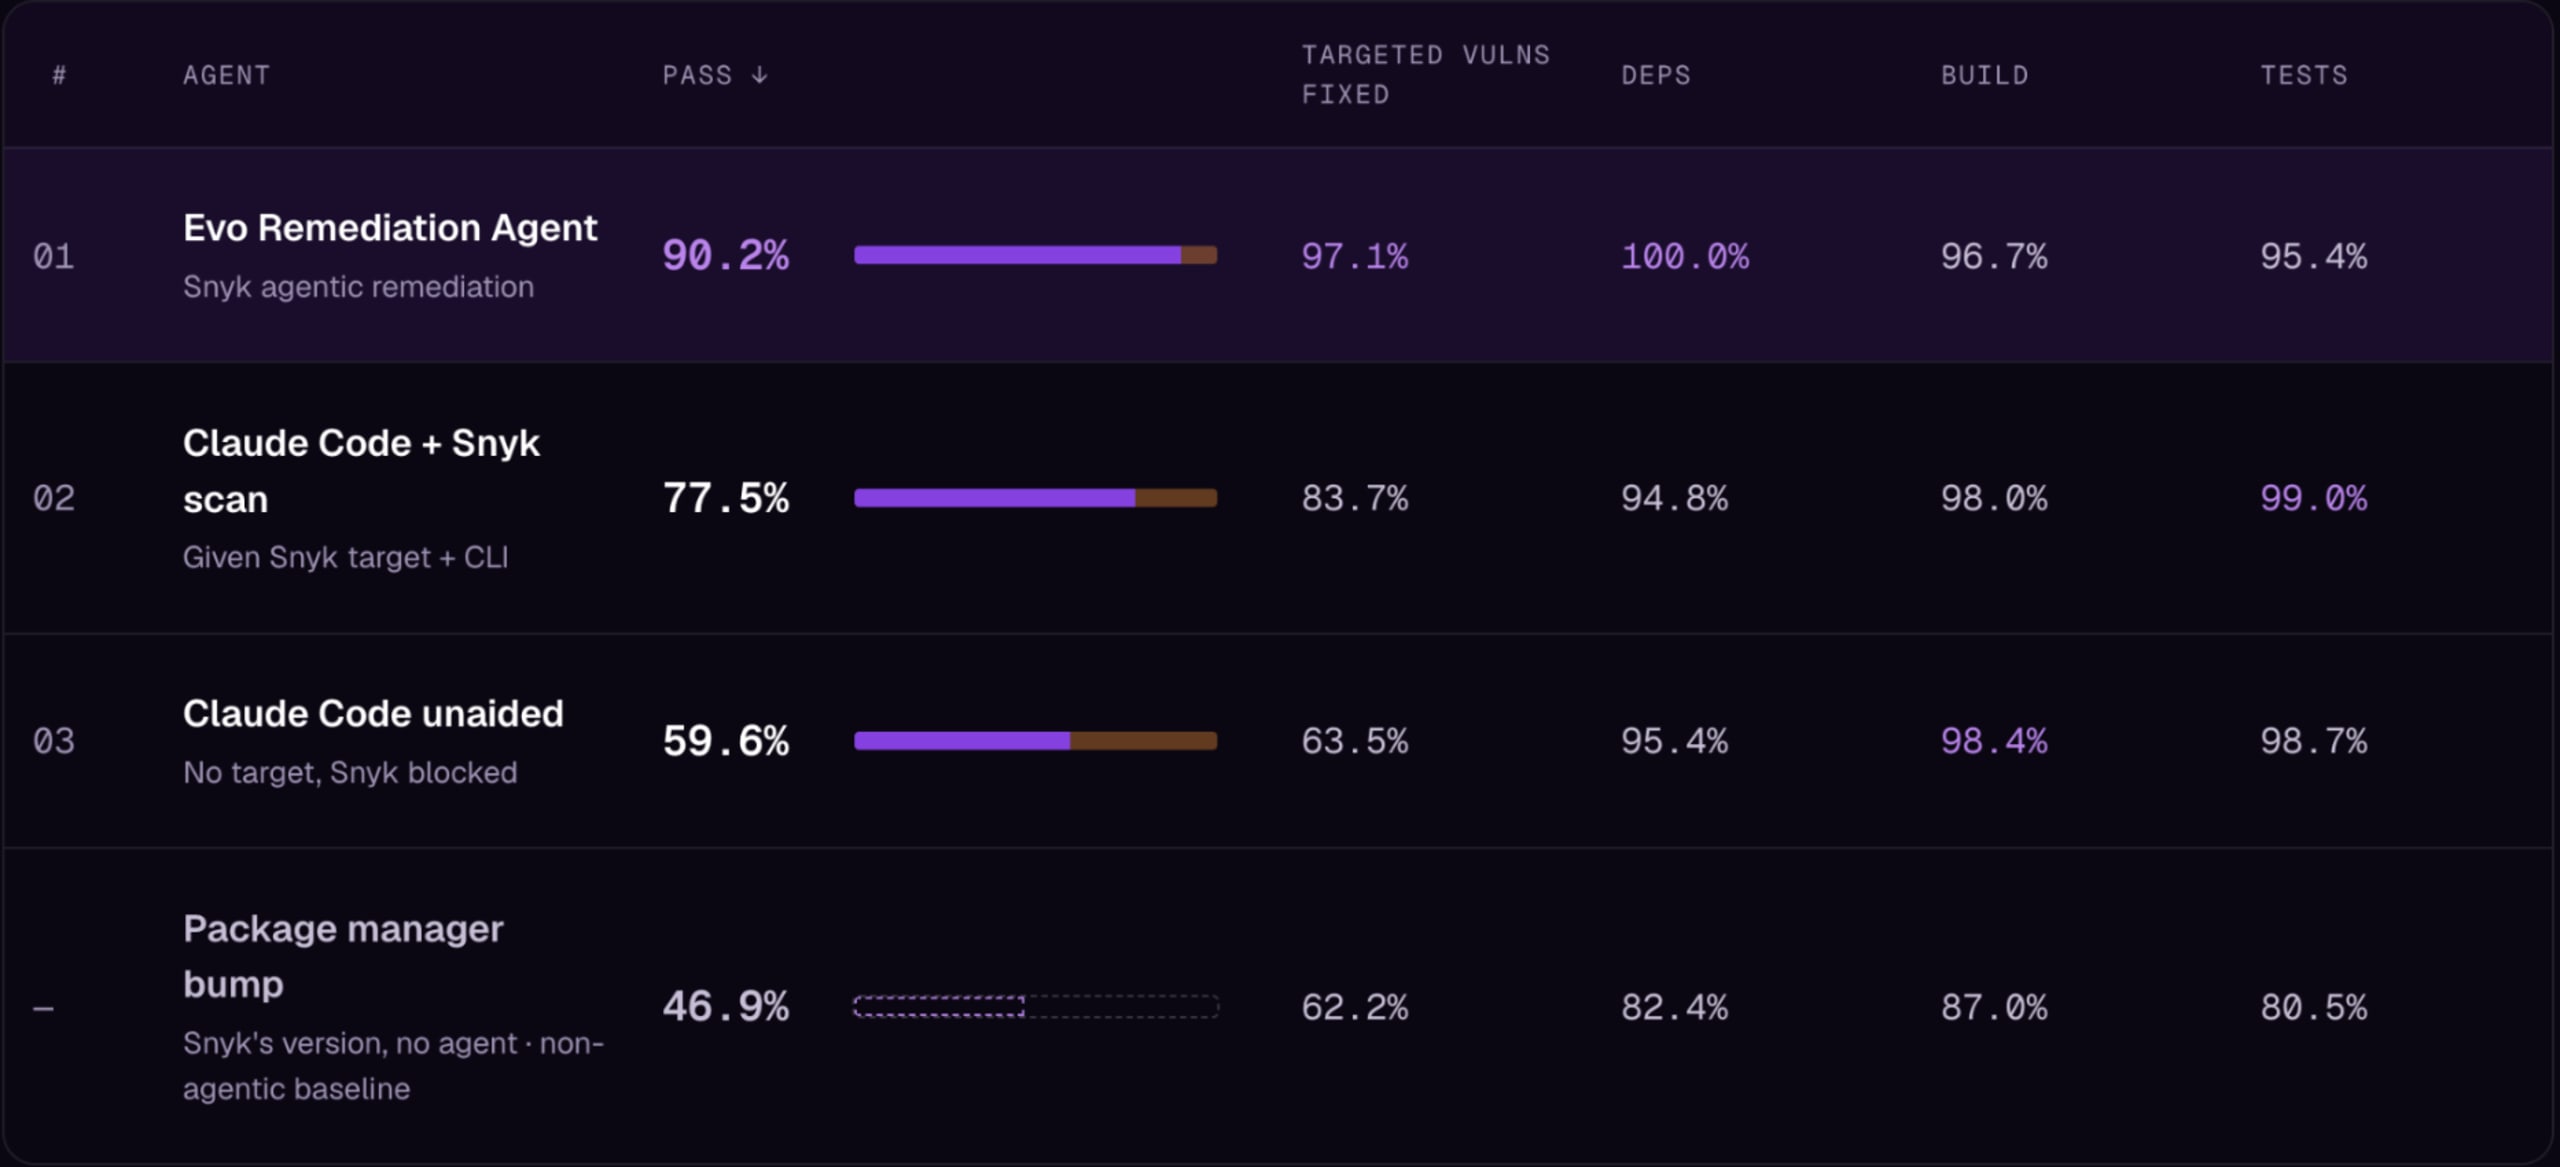
Wichtigste Ergebnisse aus VulnBump
Den Build erfolgreich zu halten, war nicht die Schwierigkeit: Alle drei Agenten schafften das in etwa 93 % der Fälle. Die Schwachstelle zu beseitigen, schon. Bei 70 seiner 124 Fehlschläge behauptete Claude Code ohne Unterstützung, Schwachstellen behoben zu haben, die ein erneuter Scan weiterhin fand.
Unsere Ergebnisse bestätigen VulnBench, unseren Benchmark zur Überprüfung der KI-Sicherheit vom Juni. Er ergab, dass Claude und Snyk Code unterschiedliche Schwachstellen übersehen, und kam zu dem Schluss, dass beide zusammen am besten funktionieren. VulnBump prüft eine andere Aufgabe – das Upgrade anfälliger Open-Source-Abhängigkeiten – und weist in dieselbe Richtung: Mit der von Snyk empfohlenen Version und dem Scan stieg die BESTANDEN-Quote von Claude Code um 17,9 Prozentpunkte. Der Evo Remediation Agent zeigt, wie viel mehr ein speziell entwickelter Agent leisten kann: 12,7 Prozentpunkte mehr als Claude Code mit demselben Snyk-Scan. VulnBump knüpft außerdem an die im Mai veröffentlichten Ergebnisse zur Behebung an – jetzt mit einem neueren Modell und sechs Paketmanagern.
So haben wir VulnBump entwickelt
Wir haben echte, produktionsnahe Projekte ausgewählt. Auf GitHub sammelten wir 767 potenzielle Projekte, darunter beliebte Open-Source-Projekte und Repositories mit festgelegten, bekanntermaßen anfälligen Paketen. Vor jeder Änderung mussten sich die Projekte installieren und bauen lassen sowie mehr als 85 % ihrer Tests bestehen; außerdem musste Snyk mindestens eine Schwachstelle finden. Aus den 99 geeigneten Projekten wählten wir 43 aus, die den Snyk-Produktionsdaten hinsichtlich Ökosystem, Schweregrad der Schwachstellen, direkten und transitiven Abhängigkeiten sowie Größe des Versionssprungs entsprechen.

Vergleich des VulnBump-Datensatzes mit den Snyk Open Source-Produktionsdaten
Wir machten aus jedem empfohlenen Upgrade eine Aufgabe. Jede Aufgabe fordert den Agenten auf, ein von Snyk empfohlenes Upgrade umzusetzen: ein Paket auf eine Version aktualisieren, die seine Schwachstellen behebt. Jede Aufgabe beginnt mit einer frischen Projektkopie und wird einzeln bewertet. Die 43 Repositories ergeben 307 Aufgaben, die 2.066 behebbare Schwachstellen abdecken – mit Maven, Gradle, npm, Yarn, pip und Poetry, den sechs Paketmanagern, auf die rund 92 % der Produktionsbefunde entfallen.
Wir ergänzten einen Verifizierer, der dem Agenten nicht einfach vertraute. Nach Abschluss des Agenten kopierten wir seine Änderungen in einen sauberen Container und prüften sie von Grund auf. Ein Versuch galt dort nur dann als BESTANDEN, wenn er alle vier Prüfungen bestand:
Die Abhängigkeiten lassen sich mit dem Befehl installieren, den CI ausführen würde.
Ein neuer Snyk-Scan bestätigt, dass die Schwachstellen behoben sind.
Das Projekt lässt sich bauen.
Alle zuvor bestandenen Tests bestehen weiterhin.

Die VulnBump-Pipeline
Die getesteten Harnesses. Alle drei Agenten liefen mit Claude Sonnet 5.5, mit einem Limit von 110 Durchläufen pro Upgrade und in einem für jede Sprache identischen Container:
Evo Remediation Agent ist die Agentic-Remediation-Engine von Snyk. Sie nutzt die Snyk-Intelligenz und kann selbst Scans, Builds und Tests ausführen sowie Fehler beheben, bevor sie fertig ist. Wir führten sie im Auto-Approve-Modus aus, sodass sie jede Korrektur anwendete – auch Upgrades, bei denen Snyk ein hohes Risiko für einen fehlerhaften Build sieht.
Claude Code mit Snyk-Scan ist der universell einsetzbare Coding-Agent von Anthropic. Er erhielt die Snyk-Empfehlung für das Upgrade: das zu aktualisierende Paket, die Zielversion und die dadurch behobenen Schwachstellen. Außerdem kann er selbst einen Snyk Open Source-Scan ausführen, um seine Arbeit zu überprüfen.
Claude Code ohne Unterstützung erhält dieselbe Aufgabe, aber ohne Zielversion und ohne Zugriff auf Snyk. Er muss selbst herausfinden, welche Version die Schwachstellen behebt – zum Beispiel durch die Suche in Schwachstellendatenbanken im Internet.
Das Paketmanager-Upgrade ist die Basis ohne Agent: Es wendet die von Snyk empfohlene Version mit dem Paketmanager des Projekts an und ändert sonst nichts.
Wie die Repositories ausgewählt wurden, welche genauen Prompts und Tools die einzelnen Agenten hatten und welche Maßnahmen gegen Data Leakage ergriffen wurden, erfahren Sie im Forschungspapier: VulnBump: Ein Benchmark zur Behebung anfälliger Abhängigkeiten in realen Projekten bei funktionierendem Build und bestandenen Tests. Dort werden auch die Einschränkungen erläutert: Wir haben ein Modell getestet, jedes Upgrade einmal ausgeführt und Snyk Open Source als Bewertungsmaßstab verwendet. Das kann nur Claude Code ohne Unterstützung benachteiligen, da die beiden anderen Agenten mit denselben Snyk-Befunden arbeiten. Außerdem haben wir neu eingeführte Schwachstellen durch ein Upgrade nicht negativ bewertet.
Ergebnis 1: Dasselbe Modell, drei unterschiedliche Ergebnisse
Der Evo Remediation Agent bestand alle Prüfungen bei 90,2 % der Upgrades (und behob 95,9 % der 2.066 Schwachstelleninstanzen). Das sind 12,7 Prozentpunkte mehr als bei Claude Code + Snyk-Scan – ungefähr eine zusätzliche funktionierende Korrektur pro acht Upgrades – und 30,6 Prozentpunkte mehr als bei Claude Code ohne Unterstützung.
Die Rangfolge hängt nicht nur von einigen wenigen großen Repositories ab: Über alle Repositories gemittelt lagen die BESTANDEN-Quoten bei 93,1 % für Evo Remediation Agent, 80,1 % für Claude Code + Snyk-Scan, 68,0 % für Claude Code ohne Unterstützung und 51,3 % für das Paketmanager-Upgrade.
Wichtigste Erkenntnis:
Der Evo Remediation Agent behebt 9 von 10 durch Schwachstellen bedingte Upgrades vollständig und eigenständig.
Ergebnis 2: Agenten müssen wissen, welche Version tatsächlich sicher ist
Mit demselben Modell stieg die BESTANDEN-Quote von Claude Code um 17,9 Prozentpunkte – von 59,6 % auf 77,5 % –, wenn der Snyk-Scan und das empfohlene Upgrade bereitgestellt wurden.
Am deutlichsten zeigt sich der Unterschied bei der ausgewählten Version. Ohne Unterstützung entschied sich Claude Code 64-mal für eine Version, die Snyk weiterhin als anfällig einstuft. Mit Snyks Scan sank diese Zahl auf 13. Schwachstellendatenbanken sind sich nicht immer einig, welche Version eine Schwachstelle behebt. Daher kann eine Version, die in einer Quelle sicher erscheint, in einer anderen weiterhin als anfällig markiert sein.
Die Empfehlungen von Snyk sind besonders bei transitiven Schwachstellen in Paketen wichtig, die das Projekt nicht direkt deklariert. Betrachtet man nur Upgrades, die alle Prüfungen bestanden, hat sich der Anteil der von Claude Code behobenen transitiven Schwachstellen durch Snyks Empfehlungen mehr als verdoppelt – von 28 % auf 59 %.
Wichtigste Erkenntnis:
Der Scan und die Zielversion von Snyk erhöhten die PASS-Rate von Claude Code um 17,9 Prozentpunkte und verdoppelten mehr als die Zahl der behobenen transitiven Sicherheitslücken.
Ergebnis 3: Snyks Empfehlungen allein reichen für etwa die Hälfte – bei den übrigen zeigen sich die Unterschiede zwischen den Agenten
Das Paketmanager-Upgrade teilt die 307 Upgrades in zwei Gruppen: Bei den 144, die es besteht, reicht die von Snyk empfohlene Version aus, und ein Agent kann eine einfache Korrektur nur beibehalten oder zunichtemachen. Für die übrigen 163 braucht es mehr als ein Versions-Upgrade, etwa Anpassungen am Code wegen Breaking Changes oder die Behebung von Abhängigkeitskonflikten.

Agenten bei den 144 Upgrades, für die Snyks Empfehlung ausreicht, und bei den übrigen 163
Mit Snyks Empfehlungen machen Agenten nur selten zunichte, was sich durch das Upgrade beheben lässt. Claude Code ohne Unterstützung verursachte dagegen bei 20 der 144 Upgrades Rückschritte; bei 15 davon wählte es eine Version, die Snyk weiterhin als anfällig markiert. Der eigentliche Unterschied wird bei der schwierigen Hälfte deutlich: Bei den übrigen 163 Upgrades bestand Evo Remediation Agent 82,2 %, Claude Code + Snyk-Scan 61,3 % und Claude Code allein 36,2 %.
Zentrale Erkenntnis:
Von den 163 Upgrades, für die mehr als eine Versionsanhebung nötig ist, bewältigte der Evo Remediation Agent 82,2 % – gegenüber 61,3 % mit Claude Code + Snyk-Scan und 36,2 % mit Claude Code ohne Unterstützung.
Ergebnis 4: Ein erfolgreicher Build kann eine nicht behobene Schwachstelle verbergen
Am einfachsten bleibt ein Build erfolgreich, wenn die Schwachstelle bestehen bleibt – genau daran scheiterte Claude Code meist. Bei 107 der 124 Fehlschläge von Claude Code ohne Unterstützung war der erneute Scan die erste nicht bestandene Prüfung; bei Claude Code + Snyk-Scan war es bei 48 der 69 Fehlschläge der Fall, bei Evo Remediation Agent bei 9 der 30.
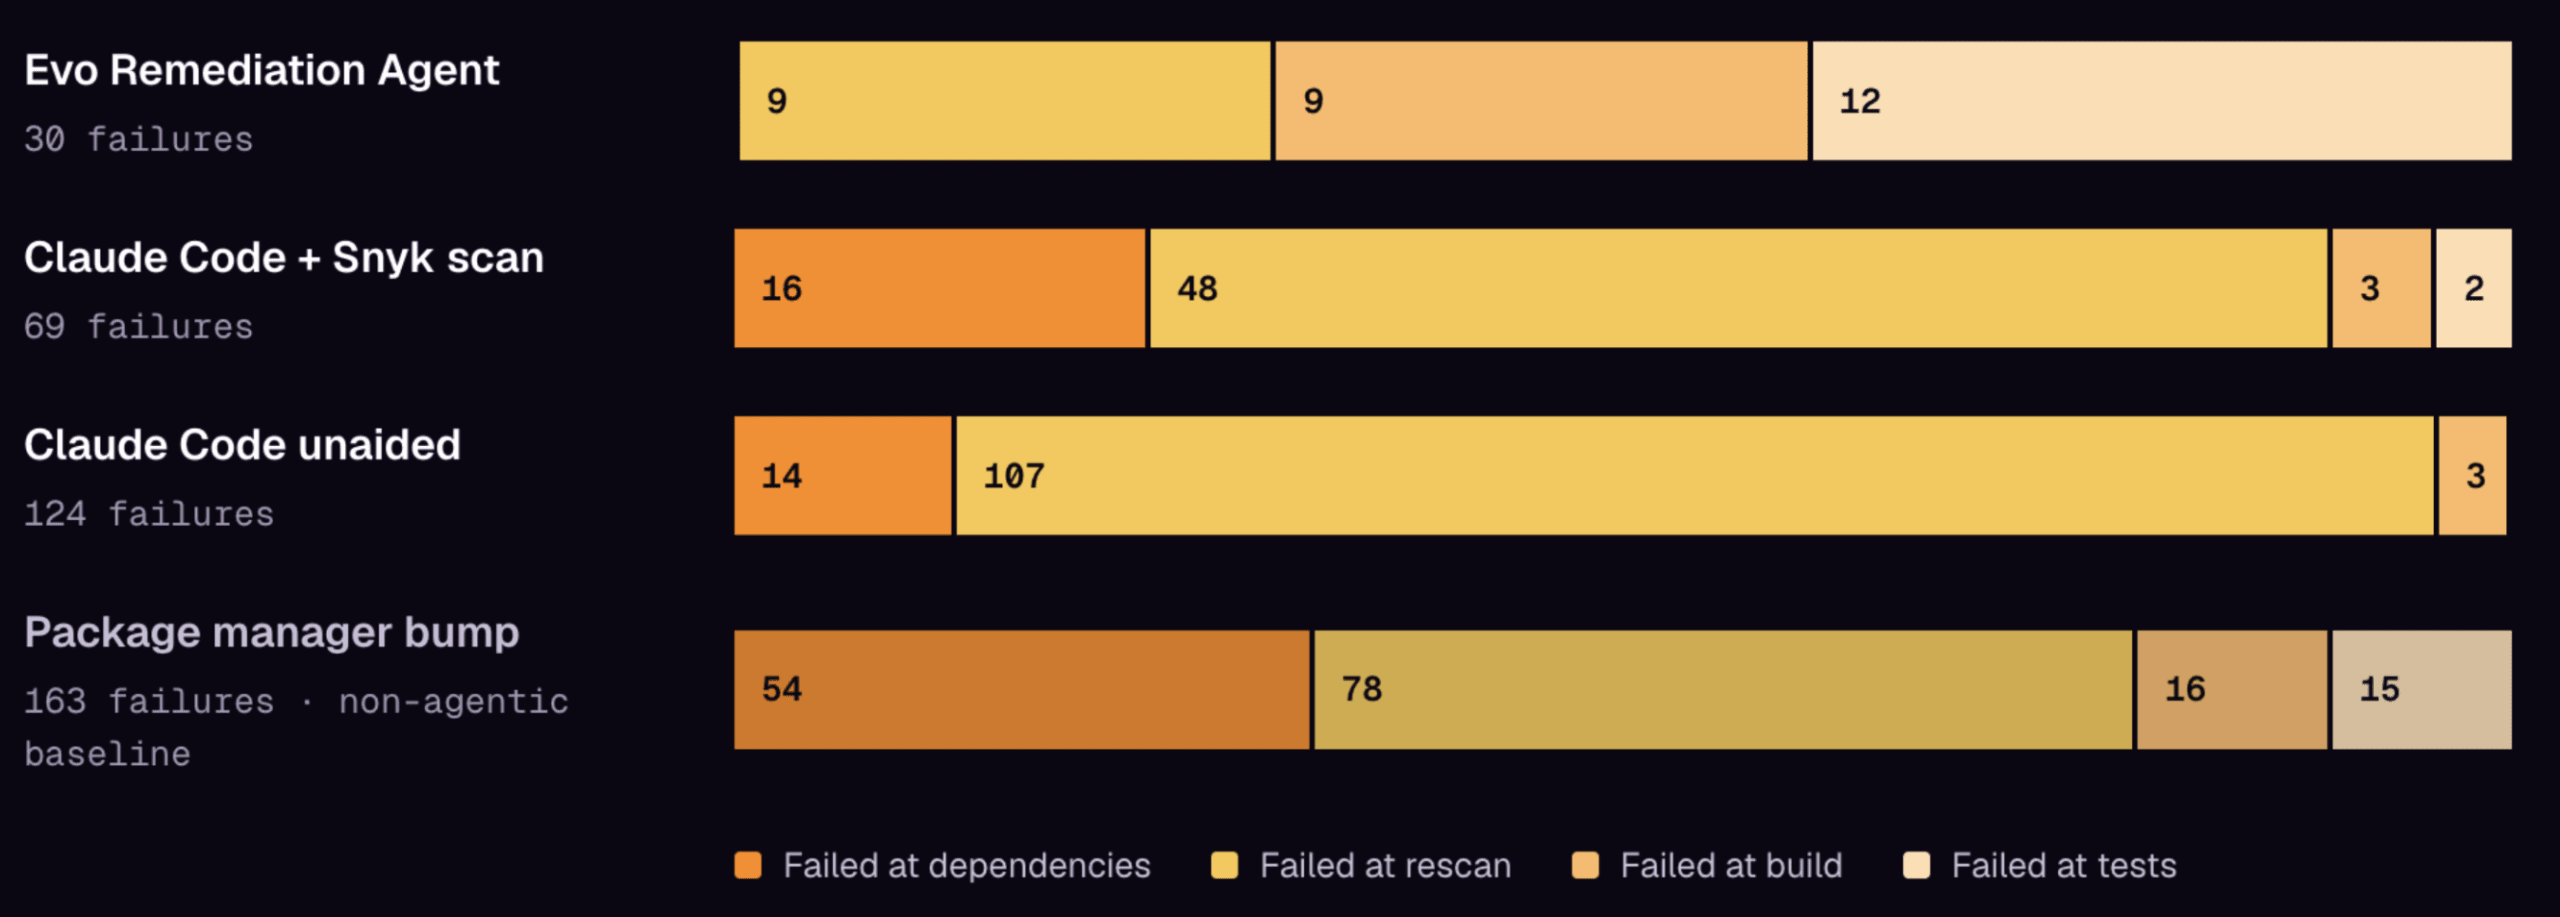
Erste nicht bestandene Verifizierungsprüfung bei jedem fehlgeschlagenen Versuch
Die Fehlschläge von Evo Remediation Agent sind sichtbar – und das ist gut so. 21 seiner 30 Fehlschläge führten zu einem fehlerhaften Build oder nicht bestandenen Tests, meist bei Major-Upgrades, die andere Agenten oft vermieden. Ein deutlich sichtbarer Fehlschlag ist viel sicherer als ein unbemerkter: Wenn ein Upgrade schiefgeht, zeigen es der Build und die Tests des Projekts. Entwickler können das erkennen und schließlich darauf reagieren.
Zentrale Erkenntnis:
Allzweck-Agenten versagen unbemerkt; der Evo Remediation Agent versagt dort, wo die CI den Fehler erkennt.
Ergebnis 5: Die Zielversion zu kennen, reicht nicht aus
Snyks Scan bringt Claude Code deutlich weiter, aber für ein korrektes Upgrade braucht es mehr: Bei identischen Befunden und Zielversionen bestand Evo Remediation Agent 39 Upgrades mehr als Claude Code mit Snyk-Scan, darunter 23 Major-Upgrades.
Evo Remediation Agent kombiniert die Snyk-Intelligenz mit einer Schleife, in der das Projekt vor Abschluss gebaut, getestet und repariert wird. Unser Setup kann zwar nicht isolieren, welche Komponente den Unterschied ausmacht, zeigt aber, wie stark das System rund um ein Modell das Ergebnis beeinflussen kann. Das deckt sich mit DepBench, wo allein eine Änderung am Harness die Ergebnisse um bis zu 16,3 Prozentpunkte veränderte.
Zentrale Erkenntnis:
Gleiches Modell, gleiche Snyk-Ergebnisse: Der Evo Remediation Agent erzielt weiterhin 12,7 Punkte mehr.
Ergebnis 6: Major-Upgrades und transitive Abhängigkeiten bleiben die schwierigsten Aufgaben
Alle Agenten haben weiterhin Schwierigkeiten mit Major-Migrationen von Frameworks: 23 Upgrades – überwiegend Migrationen von Spring, Spring Boot und Dropwizard – überforderten alle drei Agenten.
Bei Major-Upgrades sank die BESTANDEN-Quote im Vergleich zu Nicht-Major-Upgrades bei Evo Remediation Agent von 96 % auf 81 %, bei Claude Code + Snyk-Scan von 88 % auf 61 % und bei Claude Code ohne Unterstützung von 70 % auf 42 %. Bei Major-Upgrades muss außerdem häufig der Code geändert werden: Bei etwa der Hälfte der BESTANDENEN Major-Upgrades von Evo Remediation Agent wurde der Quellcode der Anwendung bearbeitet, verglichen mit 5 % der BESTANDENEN Nicht-Major-Upgrades.
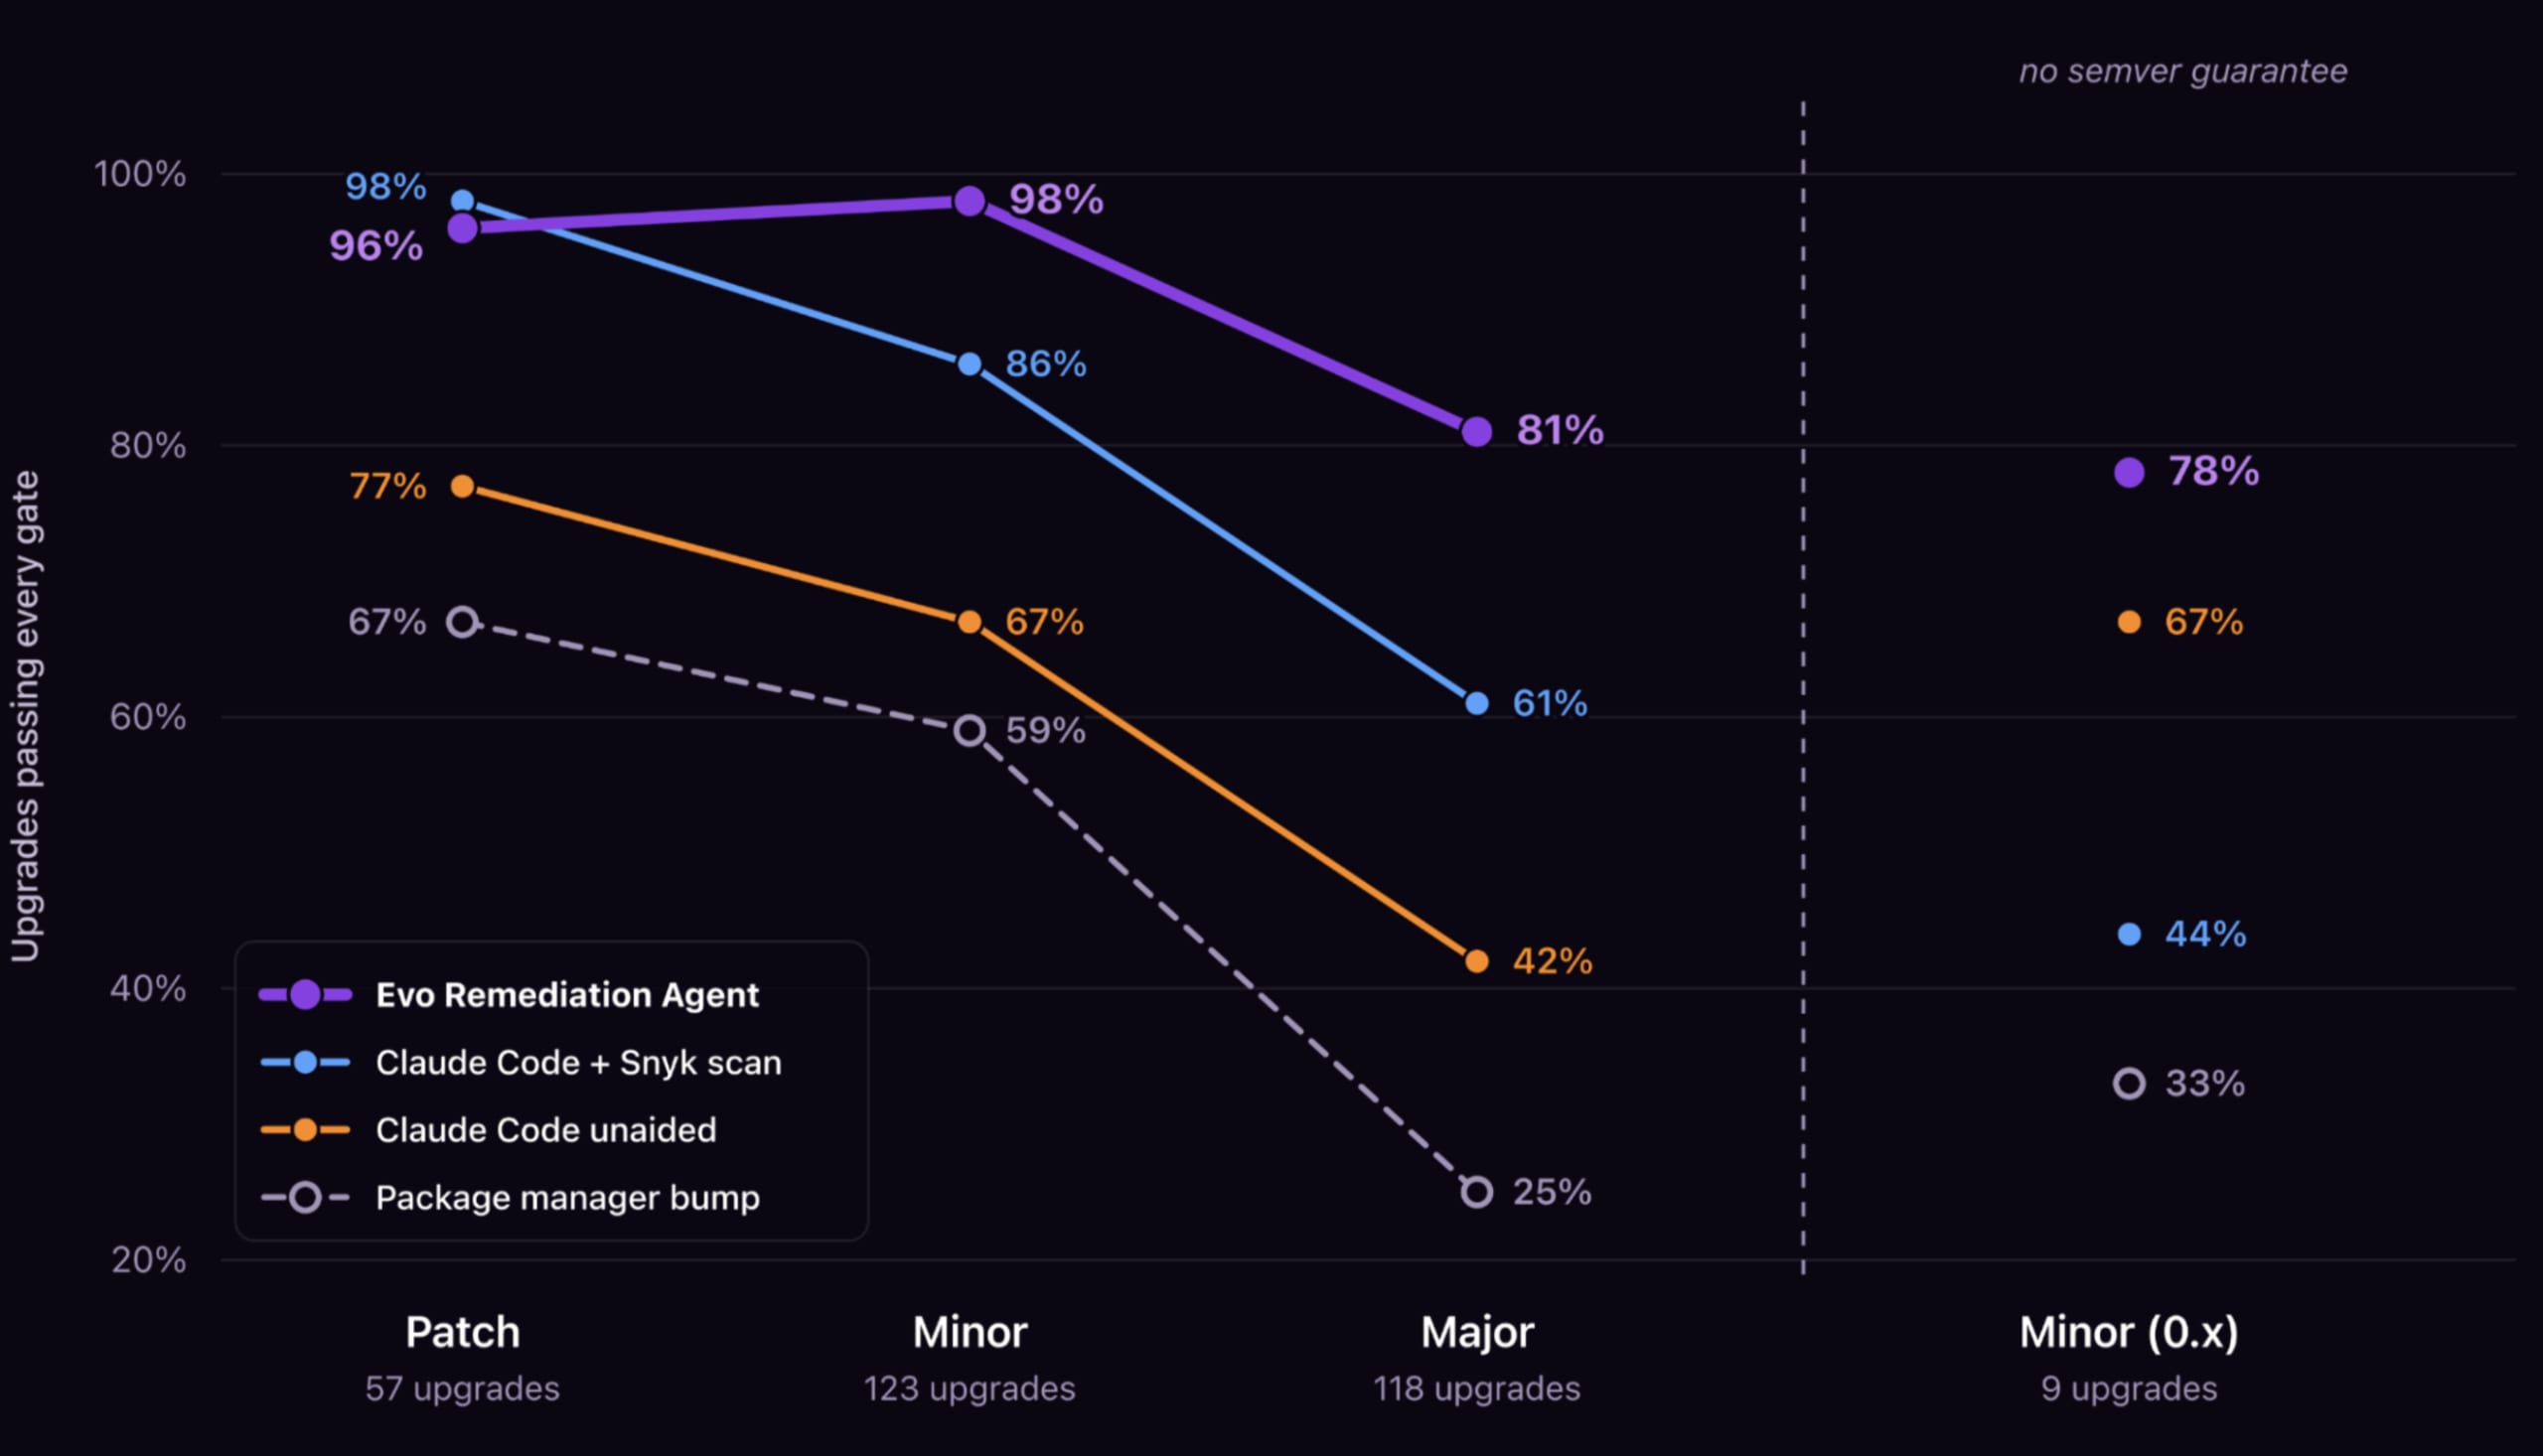
Upgrades, die alle Prüfungen bestanden haben – nach Größe des Versionssprungs
Transitive Schwachstellen – bei denen das anfällige Paket nicht im Manifest deklariert ist – machen 70 % der behebbaren Instanzen aus und sind für jedes getestete Harness schwieriger zu beheben. Betrachtet man nur Korrekturen aus Versuchen, die alle Prüfungen bestanden, behob Evo Remediation Agent 73 % der transitiven Instanzen, Claude Code + Snyk-Scan 59 % und Claude Code ohne Unterstützung 28 %. Bei direkten Abhängigkeiten waren es 91 %, 71 % beziehungsweise 62 %.
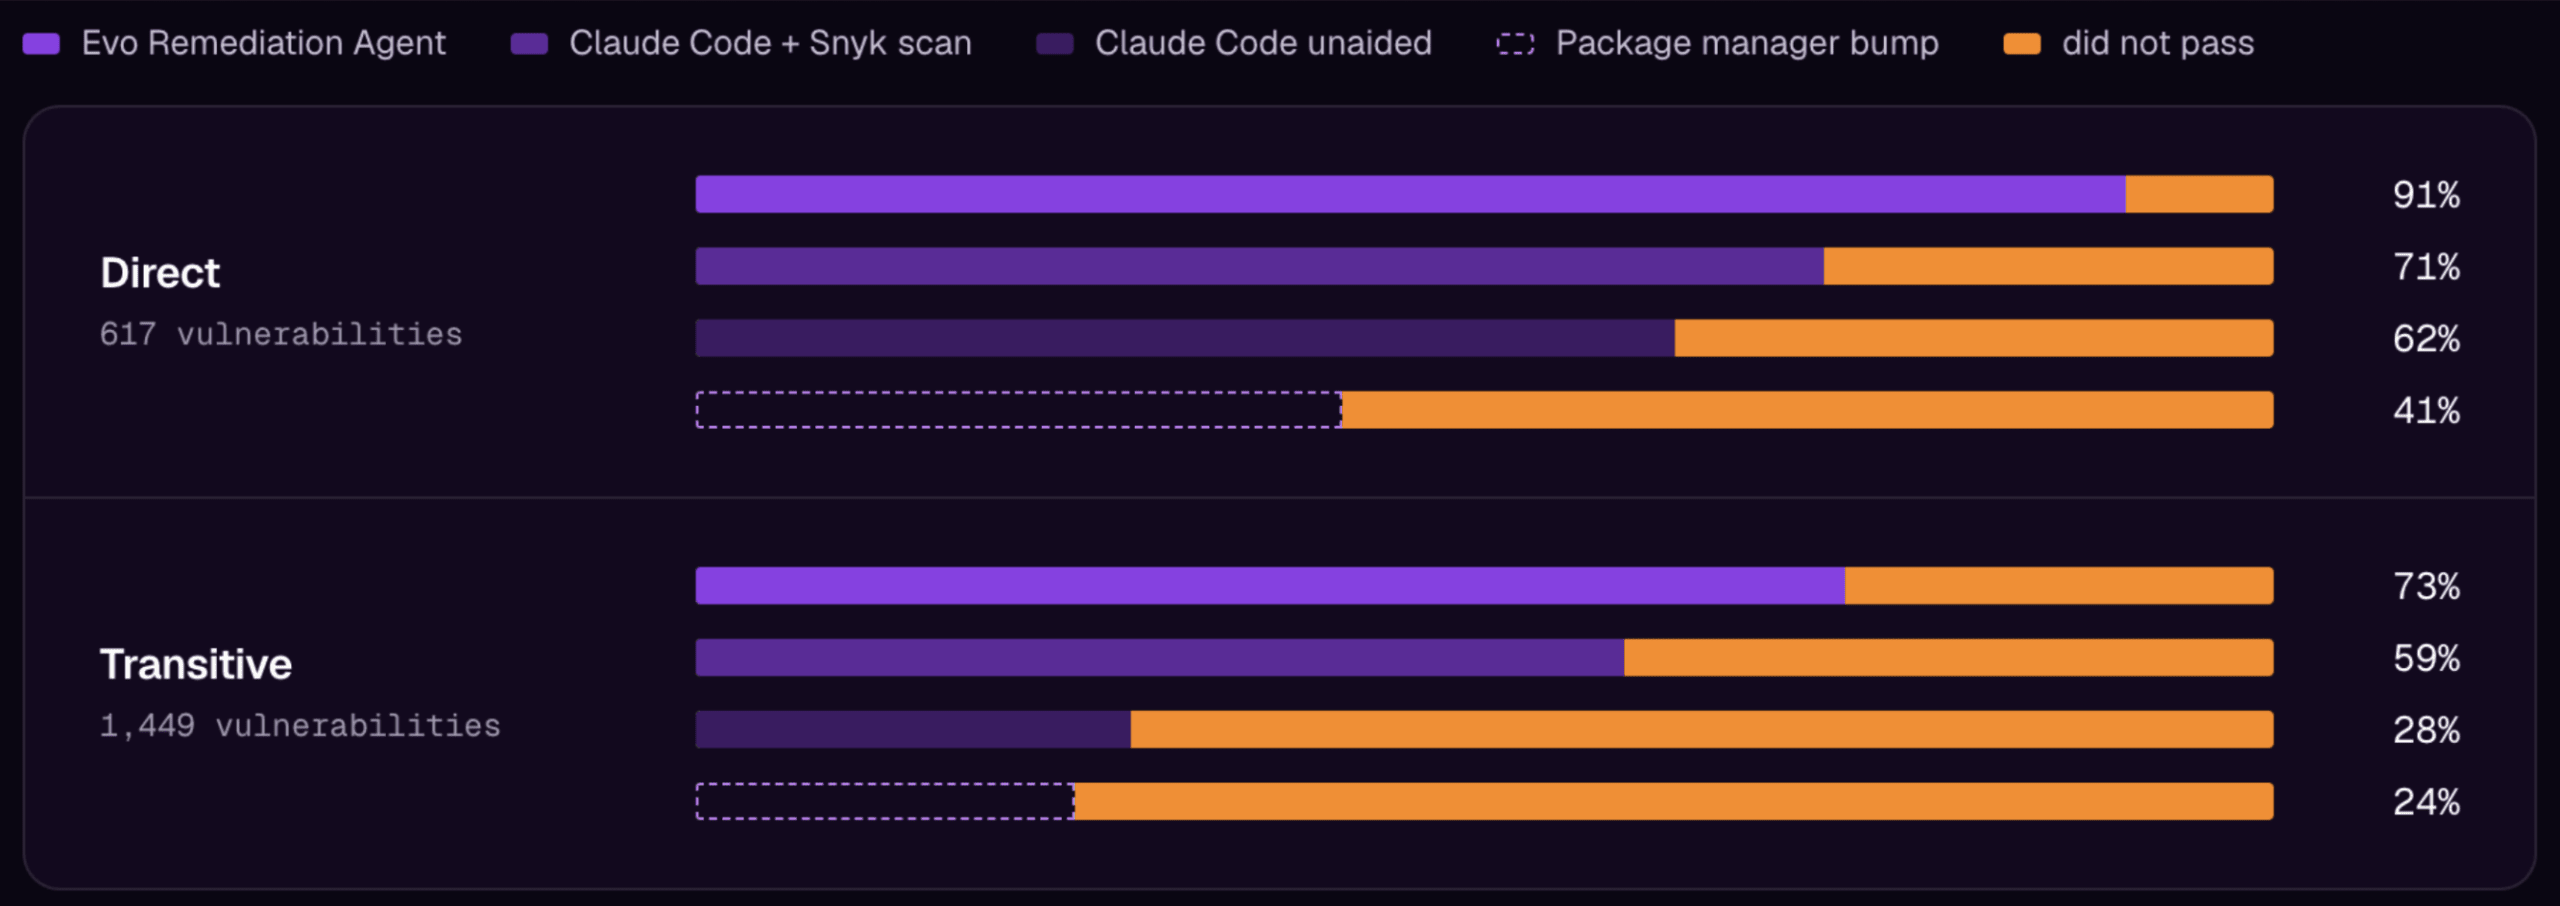
BESTANDEN-Quote nach Abhängigkeitstyp (direkt oder transitiv)
Zentrale Erkenntnis:
Der Evo Remediation Agent ist bei den schwierigsten Upgrades, Hauptversionen und transitiven Abhängigkeiten führend. Doch bei größeren Framework-Migrationen ist jeder Agent überfordert.
Wie ergänzen sich VulnBump und VulnBench?
VulnBench bewertet, wie KI-Coding-Agenten Schwachstellen im von Ihnen geschriebenen Code finden: wie zuverlässig sie dieselben Probleme bei wiederholten Durchläufen erkennen und wie genau ihre Befunde mit einer deterministischen SAST-Baseline übereinstimmen. VulnBump prüft, ob sie Schwachstellen in den Abhängigkeiten beheben können, auf die Sie sich verlassen – also anfällige Open-Source-Abhängigkeiten aktualisieren, ohne Build oder Tests zu beschädigen.
Zusammen betrachtet weisen beide in dieselbe Richtung: Modelle bieten Schlussfolgerungsfähigkeiten, die deterministischen Tools fehlen. Für sich genommen liefern sie bei wiederholten Durchläufen unterschiedliche Befunde und kommen oft nicht bis zur Behebung. Die gemeinsame Erkenntnis für die Plattform lässt sich einfacher ausdrücken: Der Generator kann nicht zugleich der Validator sein.
Was bedeutet das für Teams, die Sicherheitsaufgaben an Agenten delegieren?
Bewerten Sie eine Korrektur anhand von Belegen, die der Agent nicht selbst erstellt hat: Der Bericht eines Agenten über seine eigene Korrektur ist eine Behauptung. Ein erneuter Scan, ein Build und ein Testlauf liefern dagegen Belege. Wenn ein Agent Ihren Backlog abarbeitet, sollten Sie ihn an denselben Prüfungen messen.
Bewerten Sie Schwachstelle und Build gemeinsam: Jede Prüfung für sich allein kann einen Fehler verbergen. Prüfungen, die nur nach Beschädigungen suchen, übersehen Korrekturen, die nie erfolgt sind. Prüfungen, die nur Schwachstellen suchen, übersehen Korrekturen, die das Projekt beschädigt haben.
Geben Sie dem Agenten die Sicherheitsdaten: Snyks Scan und empfohlenes Upgrade verschafften einem Allzweck-Agenten mit demselben Modell einen Vorsprung von 17,9 Prozentpunkten.
Evo Remediation Agent ist Snyks Engine für agentische Behebung und über die Snyk CLI sowie als Cloud-Service verfügbar. Er ist einer der Agenten in Evo Agentic AppSec, das heute startet.
Testen Sie Ihren Agenten mit VulnBump
Das VulnBump-Harness und alle 43 Evaluierungsfälle sind als Open Source verfügbar unter github.com/snyk-labs/snyk-vulnbump.
Die vollständige Methodik, Fehleranalyse und Einschränkungen finden Sie im Forschungspapier. Wenn Sie selbst einen Agenten zur Behebung von Schwachstellen entwickeln, testen Sie ihn mit VulnBump und teilen Sie uns Ihre Erkenntnisse mit.
VulnBump wurde von Gabija Pasiunaite, Ryan McMorrow, Brian Clark, Liran Tal und Luke Tu entwickelt.
FORSCHUNG


