KI vergrößert Ihre Angriffsfläche. Testen Sie sie?

19. März 2026
0 Min. LesezeitDer Markt ist voller Versprechen. Ein Anbieter führt eine Rangliste an. Ein anderer sammelt mit einem Pitch Deck eine dreistellige Millionensumme ein. Währenddessen haben Ihre Entwickler noch vor dem Mittagessen drei KI-generierte Services ausgeliefert. Hier geht es um ein Gespräch, das die Branche nicht führt – und auf das wir uns seit Jahren vorbereiten.
In jedem Security-Team findet gerade eine Version dieses Gesprächs statt.
Jemand führt einen KI-Programmierassistenten vor. Die Geschwindigkeit ist beeindruckend, das Team ist begeistert. Und doch bleibt es vorsichtig, manchmal skeptisch.
Code, für den früher ein Sprint nötig war, entsteht jetzt an einem Nachmittag. Die Führungsebene ist begeistert. Auch die Entwickler, die diese Ära überstehen werden. Und die Security? Wenn sie ehrlich ist, fragt sie sich insgeheim, ob ihre Tools für das gewappnet sind, was kommt.
Erzähler: Das sind sie nicht.
Der Benchmark, über den niemand sprechen will
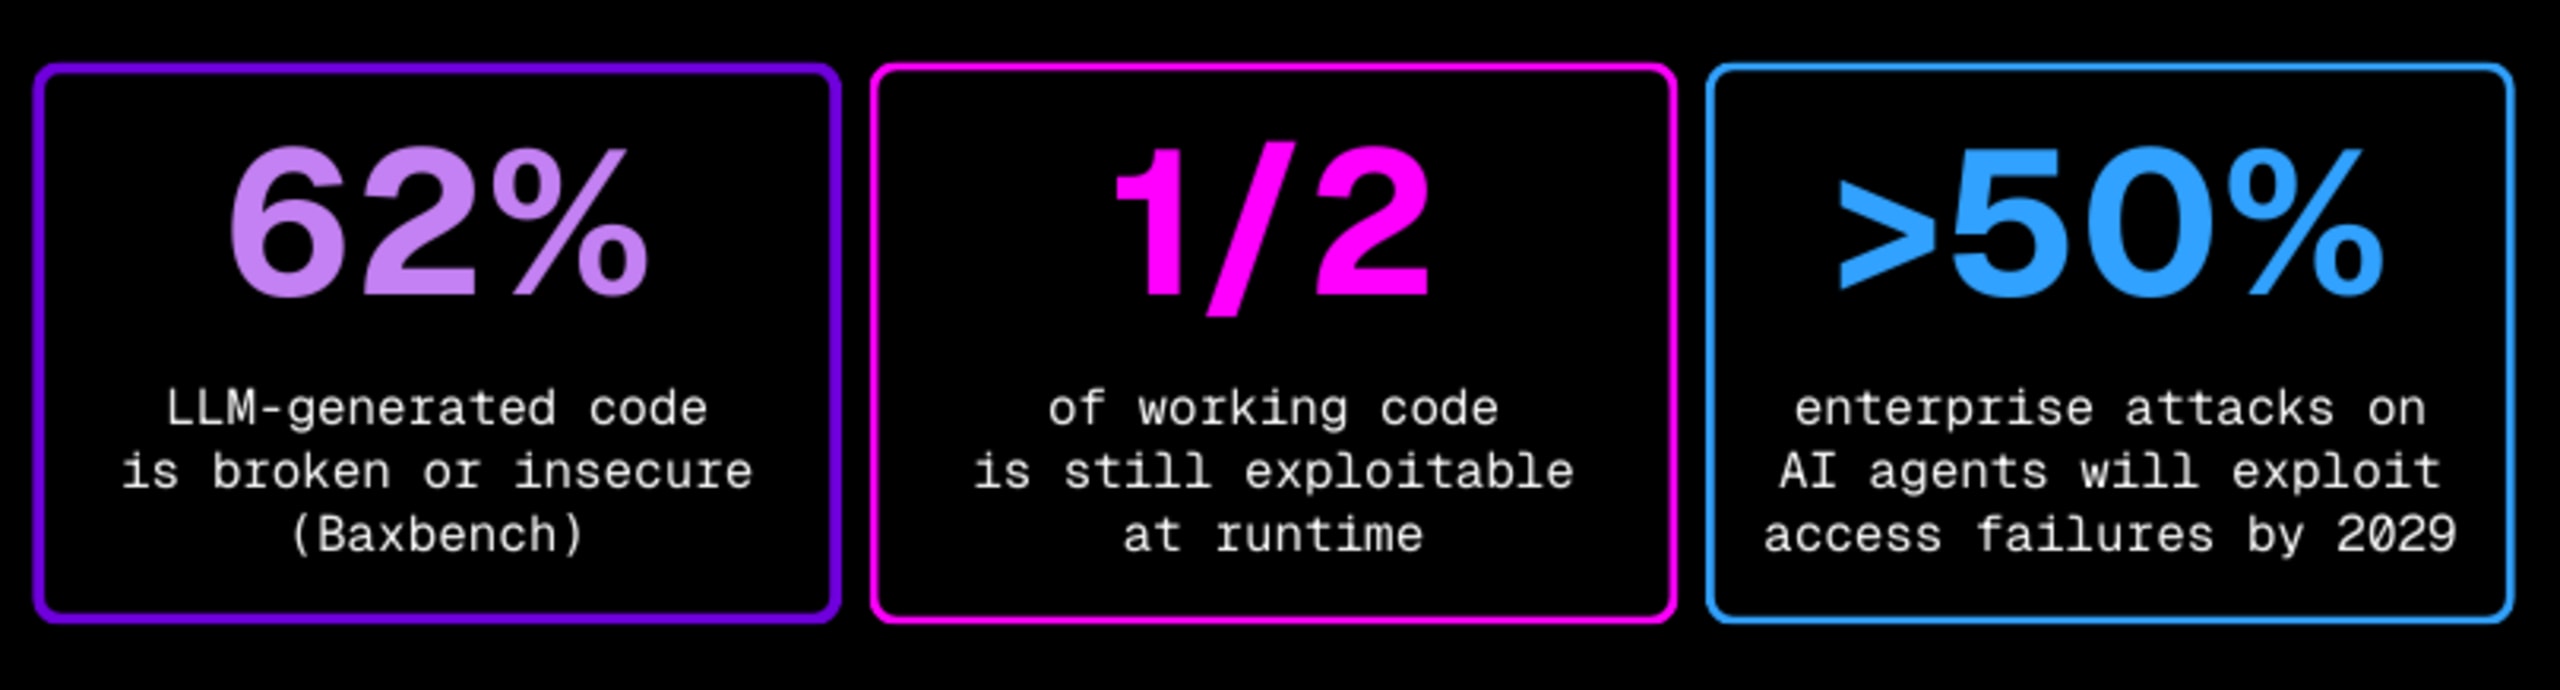
BaxBench ist kein Bedrohungsbericht, sondern eine Messung. Als Forschende LLM-generierten Backend-Code für reale Aufgaben untersuchten, waren 62 % davon fehlerhaft oder unsicher. Von dem Code, der korrekt funktionierte, war etwa die Hälfte dennoch ausnutzbar.
Lesen Sie das noch einmal: KI schreibt funktionierenden Code, und die Hälfte davon ist trotzdem ausnutzbar.
Das ist kein Grund, keine KI-Programmierassistenten mehr zu verwenden – dieser Zug ist längst abgefahren. Es ist ein Grund, genau zu definieren, was sicher bedeutet, wenn die Codegenerierung dauerhaft schneller geworden ist.
Statische Analysen direkt bei der Code-Erstellung – ob als SAST-Tool in der IDE oder als KI-gestützte Security-Hinweise im Entwicklungsprozess – sind ein notwendiger erster Schritt, aber nicht das Ziel. Sie können Ihnen zeigen, was im Code vorhanden ist, aber nicht, ob er tatsächlich so ausnutzbar ist, wie ein Angreifer ihn ausnutzen würde. Selbst die neuesten multimodalen statischen Ansätze, die Taint-Analyse mit LLM-Reasoning verbinden, können nur vorhersagen, was im Code ausnutzbar sein könnte. Sie können das tatsächliche Laufzeitverhalten unter realen Angriffsbedingungen nicht nachweisen.
Dafür müssen Sie von außen zur Laufzeit sondieren – so, wie es ein echter Angreifer tun würde.
Die zweite Angriffsfläche, die niemand erfasst hat
Während die Branche über die Sicherheit von KI-generiertem Code debattierte, entstand unbemerkt eine zweite Angriffsfläche.
KI-Agenten arbeiten nicht isoliert. Sie greifen auf APIs zu, oft auf privilegierte und häufig undokumentierte. Diese APIs wurden entwickelt, bevor jemand damit rechnete, dass sie autonom und in großem Maßstab aufgerufen würden. Gartner prognostiziert, dass KI-Agenten bis 2028 die wichtigsten Nutzer von Unternehmens-APIs sein werden. Bis 2029 werden voraussichtlich über 50 % der erfolgreichen Angriffe auf KI-Agenten Schwachstellen in der Zugriffskontrolle ausnutzen (BOLA/IDOR) – genau die Art von Schwachstellen, deren Validierung statischen Analysen traditionell schwerfällt.
Das ist keine gewagte Prognose, sondern beschreibt Architekturentscheidungen, die Ihre Unternehmen längst getroffen haben.
BodySnatcher machte das Problem greifbar. Bei CVE-2025-12420 konnte ein nicht authentifizierter Angreifer allein mit der E-Mail-Adresse eines Ziels einen ServiceNow-Administrator imitieren, MFA und SSO umgehen, KI-Agenten-Workflows ausführen und Backdoor-Konten mit umfassenden Berechtigungen anlegen. Sozialversicherungsnummern, Finanzdaten, vertrauliches geistiges Eigentum: alles leichte Beute ... alles offengelegt.
Die Technik war nicht ausgefallen: Es gab weder eine Zero-Day-Schwachstelle noch raffinierte Prompt-Injection. Die Schwachstelle blieb ungeprüft hinter einem Agenten verborgen, dem ein Unternehmen uneingeschränkt vertraute. Das Fazit der Forschenden war eindeutig: „KI-Agenten verstärken die Auswirkungen herkömmlicher Sicherheitslücken erheblich.“
Die Auslieferung ist schneller geworden als die Validierung. Die Lösung kann nicht darin bestehen, langsamer zu werden. Wir müssen grundlegend ändern, was Tests tatsächlich bedeuten.
Das sind keine neuen Schwachstellen, sondern dieselben alten, traditionell schwer zu erkennenden Schwachstellen – nur verstärkt durch die neue Architektur, die auf ihnen aufbaut.
Warum es eigentlich um ein und dieselbe Sache geht
Was meiner Meinung nach übersehen wird, wenn diese beiden Probleme getrennt betrachtet werden: Sie haben dieselbe Ursache. Die Auslieferung ist einfach viel schneller geworden als die Validierung. KI-Programmierassistenten generieren Code schneller, als jeder Sicherheitsprozess dafür konzipiert wurde. Und KI-Agenten rufen APIs schneller auf, als jedes Inventar sie erfassen kann. In beiden Fällen läuft etwas in der Produktionsumgebung, das nie systematisch angegriffen wurde: Es wurde weder geprüft noch gescannt, sondern tatsächlich *angegriffen* – so, wie es ein böswilliger Akteur tun würde.
Wir sind überzeugt: Die Antwort kann nicht darin bestehen, langsamer zu werden. Wir müssen ändern, was Tests tatsächlich bedeuten.
Dynamische Tests sind kein Relikt aus der alten Zeit vor der KI. Sie sind genau die Disziplin, auf die das KI-Zeitalter angewiesen ist. In einer Welt nach dem Aufkommen von KI werden sie zum Fundament – zu einem tragenden Fundament.
Die Frage lautet also nicht, ob Sie dynamisch testen sollten, sondern ob Ihre dynamischen Tests intelligent genug sind und mit dem Schritt halten können, was jetzt in der Produktionsumgebung läuft: KI-generierter Code, mit KI-generierter Geschwindigkeit, hinter APIs, die Agenten schneller aufrufen, als ein Mensch sie erfassen kann.
Moderne dynamische Tests müssen selbst KI-gestützt sein: schnell genug für die Pipeline, intelligent genug, um echte Ausnutzbarkeit von Fehlalarmen zu unterscheiden, und speziell für eine Angriffsfläche entwickelt, die es vor gerade einmal zwei Jahren noch nicht gab.
Wichtige Signale statt Rauschen
Das eigentliche Problem mit KI-generiertem Code in großem Maßstab: Es entsteht nicht nur mehr Code, sondern auch mehr Findings, mehr Warnmeldungen und mehr Dinge, die Aufmerksamkeit zu erfordern scheinen. Stellen Sie sich vor, all das läuft durch Security-Tools, die für eine viel langsamere Welt entwickelt wurden.
Entwickler werden von diesem Rauschen überflutet und müssen entscheiden, wofür sie ihre Zeit einsetzen. Meistens verlassen sie sich dabei auf ihr Bauchgefühl, ihre Erfahrung oder den allgegenwärtigen Termindruck.
Alert-Müdigkeit ist nichts Neues, aber im Zeitalter des KI-gestützten Programmierens verschärft sich das Problem: Entwickler prüfen nicht mehr nur die Findings eines Sprints, sondern Ausgaben, für deren Erstellung ein ganzes Team ein Quartal gebraucht hätte. Wenn jedes Finding gleich gewichtet wird, wird nichts behoben. Jedenfalls nicht mit Überzeugung.
Die Situation ändert sich, sobald Sie Findings miteinander in Beziehung setzen. Wenn ein statisches und ein dynamisches Finding dieselbe Ursache haben – wenn der Code auf eine Schwachstelle hindeutet und Laufzeittests ihre Ausnutzbarkeit bestätigen –, müssen Sie nicht mehr zwei Probleme priorisieren. Sie haben eine einzige, hochgradig verlässliche Lösung, der Entwickler tatsächlich vertrauen.
Das Rauschen nimmt ab. Das Signal wird deutlicher.
Diese Präzision ist im KI-Zeitalter wichtiger denn je. Eine False-Positive-Rate von 0,08 % ist keine Produktspezifikation. Sie zeigt, wie Security aufhört, Entwickler auszubremsen, und stattdessen zum Beschleuniger wird. KI schreibt den Code, Sie weisen nach, was tatsächlich fehlerhaft ist, und Entwickler liefern schneller und sicher statt langsamer und verunsichert.
✔️ LLM-gestütztes SAST erkennt heute KI-generierte Code-Muster und die damit verbundenen Risiken – in der IDE und in der Pipeline.
✔️ Intelligentes DAST sondiert laufende Anwendungen und APIs aktiv, um die tatsächliche Ausnutzbarkeit zu bestätigen – insbesondere BOLA, IDOR und agentenspezifische Autorisierungsschwachstellen.
✔️ Korrelierte Findings verknüpfen statische Hinweise mit dynamischen Nachweisen: eine priorisierte Lösung statt einer Warteschlange zur Triage.
✔️ API-Erkennung deckt Endpunkte auf, die Ihre KI-Agenten autonom aufrufen – auch undokumentierte.
✔️ Kontinuierliche Absicherung direkt in der Auslieferungspipeline statt eines vierteljährlichen Engagements.
Was KI-Pentesting tatsächlich ist (oder sein sollte)
Viele Anbieter greifen derzeit zum Label „KI-Pentesting“. Für manche bedeutet das lediglich, dass sie mit LLMs Angriffspayloads erstellen. Andere meinen damit, Findings-Berichte mithilfe von „Agenten“ zu generieren (auch das Agentenkonzept hinterfragen wir). Nur wenige meinen damit etwas deutlich Interessanteres.
Was diese Disziplin tatsächlich erfordert – und was das KI-Zeitalter ganz besonders erfordert –, ist ein Ansatz, der KI-generierten Code auf KI-spezifische Logikfehler testen, die von Agenten aufgerufenen APIs nachverfolgen kann (auch die undokumentierten), dynamische Findings mit Code-Kontext und Informationen korreliert, um Signal von Rauschen zu trennen, und all das kontinuierlich statt punktuell und unkoordiniert leistet.
Das sollte übrigens keine Feature-Liste und keine Roadmap sein, sondern der Standard. Die Branche konnte ihn bislang noch nicht gut formulieren. Genau deshalb ist jetzt der richtige Zeitpunkt dafür. Also werden wir ihn formulieren.
Seit Jahren arbeiten wir auf diesen Standard hin. Die Ergebnisse, die wir bei Kunden in der Produktionsumgebung sehen, bestätigen den Ansatz immer wieder.
Echte Sicherheitstests für das KI-Zeitalter finden nicht einfach nur schneller mehr Probleme. Sie gleichen statische Vorhersagen mit dynamischen Nachweisen ab und liefern Lösungen, die Entwickler sicher statt verunsichert ausliefern können.
Die Diskussion über KI-Sicherheit wurde von zwei vermeintlich unterschiedlichen Fragen beherrscht: Können wir KI-Modelle absichern? Und können wir mithilfe von KI Schwachstellen finden? Beides sind berechtigte Fragen, doch keine von beiden reicht für sich allein aus.
Die dringendere Frage ist einfacher: Wer testet oder greift den Code und die APIs an, die KI erstellt und ausführt?
Wenn Sie es nicht tun, können Sie sicher sein, dass es jemand anderes tun wird – oder etwas anderes.
Für Snyk API & Web anmelden
Nutzen Sie noch heute unsere entwicklerorientierte DAST-Engine
Decken Sie Schwachstellen mit der KI-gestützten DAST-Engine von Snyk automatisch und skalierbar auf. Verlagern Sie Sicherheitstests mit Automatisierung und konkreten Behebungsempfehlungen nach links – nahtlos integriert in Ihren SDLC.


