3 Tipps, um Docker-Images schneller neu zu erstellen (und CI-Sekunden zu sparen!)

28. Dezember 2023
0 Min. LesezeitDocker ist zu einem unverzichtbaren Tool geworden, das das Erstellen, Bereitstellen und Ausführen von Anwendungen vereinfacht. Mit Docker können Entwickler eine Anwendung samt allen Abhängigkeiten in einer standardisierten Einheit bündeln, die als Container-Image bezeichnet wird.
Das Dockerfile ist ein einfaches Dokument mit allen Befehlen, die zum Erstellen eines Container-Images benötigt werden. Dieses Image bildet wiederum die Grundlage für einen Docker-Container, wenn dieser ausgeführt wird.
Diese Container sind schlanke, eigenständige und ausführbare Pakete. Sie enthalten alles, was zum Ausführen einer Software benötigt wird – einschließlich Code, Systemtools, Bibliotheken und Einstellungen.
Der große Vorteil von Containern ist ihre Portabilität. Sie stellen sicher, dass die Anwendung unabhängig von der Bereitstellungsumgebung reibungslos ausgeführt wird. Dadurch wurde der Softwareentwicklungsprozess erheblich optimiert. Container sind heute ein Eckpfeiler des DevOps-Ansatzes und ermöglichen Continuous Integration und Deployment.
Docker-Images schneller erstellen
Container-Images sind zwar grundlegend für das Ausführen von Anwendungen in verschiedenen Umgebungen, doch ihre Erstellung kann mitunter zeitaufwendig sein. Das gilt insbesondere für größere Anwendungen mit zahlreichen Abhängigkeiten.
Im obigen Beispiel liest Docker die Dockerfile im aktuellen Verzeichnis und erstellt ein Image mit dem Namen my-application. Je nach Komplexität und Größe der Anwendung kann das sehr viel Zeit in Anspruch nehmen.
Die Kunst, Docker-Images zu erstellen
Das Erstellen von Docker-Images ist ein grundlegender Bestandteil der Arbeit mit Containern. Docker-Images sind im Wesentlichen eine „Momentaufnahme“ eines Docker-Containers zu einem bestimmten Zeitpunkt und bilden die Grundlage für das Erstellen neuer Docker-Container.
Zum Erstellen eines Docker-Images benötigen Sie eine Dockerfile – eine Textdatei mit allen Befehlen, die zum Erstellen eines Images erforderlich sind. Eine Dockerfile ist wie ein Rezept: Sie gibt Docker vor, was beim Erstellen eines Images zu tun ist.
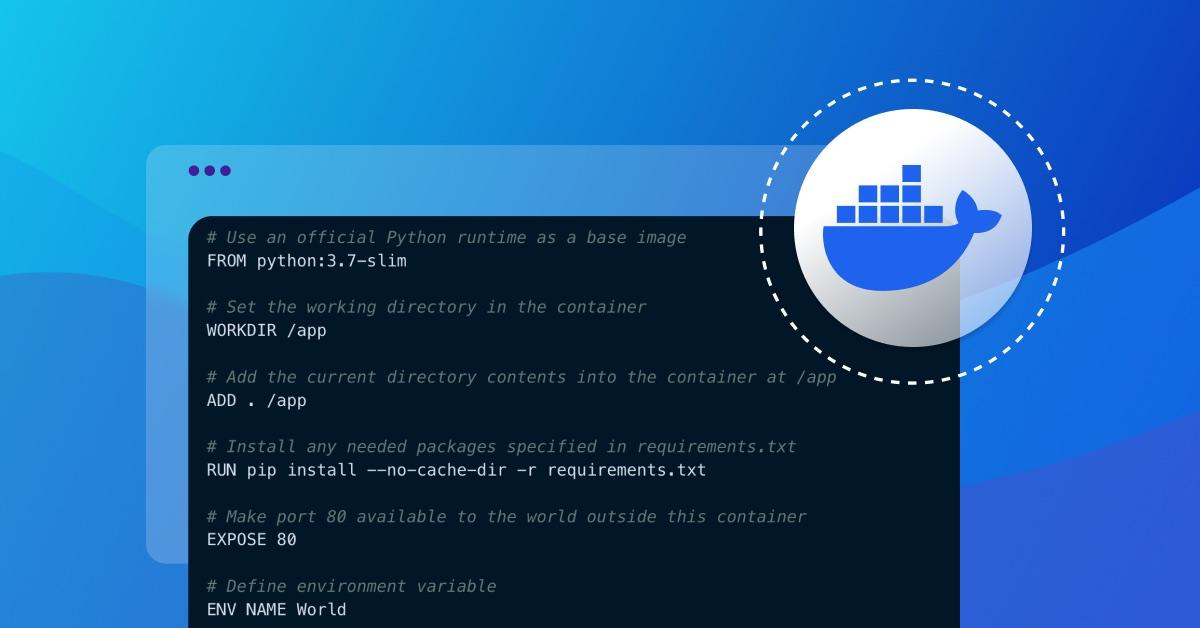
Hier ein Beispiel für eine einfache Dockerfile:
Sobald Sie ein Dockerfile haben, können Sie mit dem Befehl docker build ein Image erstellen. Das könnte so aussehen:
Mit diesem Befehl weisen Sie Docker an, mithilfe der Dockerfile im aktuellen Verzeichnis ein Image zu erstellen (das . am Ende des Befehls) und es mit -t als my-python-app zu taggen.
Hinweis: Wenn Sie Python-Anwendungen entwickeln oder zu einem DevOps-Team gehören, das Python-Anwendungscontainer erstellt, empfehlen wir Ihnen dringend, die Best Practices für das Containerisieren von Python-Anwendungen mit Docker zu lesen und anzuwenden.
Häufige Herausforderungen beim Erstellen von Docker-Images
Das Erstellen von Docker-Images ist nicht immer unkompliziert. Entwickler und DevOps-Teams können mit einigen häufigen Herausforderungen konfrontiert sein:
Abhängigkeiten verwalten: Eine der häufigsten Herausforderungen ist die Verwaltung von Abhängigkeiten. Die Abhängigkeiten Ihrer Anwendung können sich im Laufe der Zeit ändern, sodass es schwierig sein kann, Ihr Docker-Image aktuell zu halten. Ein Paketmanager, der Abhängigkeiten automatisch verwaltet, kann hier hilfreich sein.
Image-Größe: Eine weitere Herausforderung ist, die Größe Ihrer Docker-Images so gering wie möglich zu halten. Große Images benötigen mehr Zeit zum Erstellen und Übertragen in ein Docker-Repository, was Ihre CI/CD-Pipeline verlangsamen kann. Um die Image-Größe zu reduzieren, können Sie ein kleineres Basis-Image verwenden, unnötige Dateien entfernen und Multi-Stage-Builds nutzen, um den Inhalt des endgültigen Images zu minimieren.
Sicherheit: Sicherheit ist ein wichtiges Thema beim Erstellen von Docker-Images. Sie müssen sicherstellen, dass Ihre Images keine Schwachstellen enthalten, die Angreifer ausnutzen könnten. Mit Tools wie Docker Bench for Security und Snyk Container können Sie Ihre Images auf Schwachstellen überprüfen.
Tipp 1: Fügen Sie Ihrem Repository eine .dockerignore-Datei hinzu
In der Welt von Docker und Container-Sicherheit ist Effizienz entscheidend. Wenn Sie Entwickler oder DevOps-Experte sind, wissen Sie, dass bei Continuous-Integration-Prozessen (CI) jede Sekunde zählt.
Eine einfache, aber wirkungsvolle Möglichkeit, Docker-Images schneller zu erstellen, ist eine .dockerignore-Datei in Ihrem Repository. Sehen wir uns an, wie eine .dockerignore-Datei funktioniert, wie Sie damit Docker-Images schneller erstellen können und wie Sie Schritt für Schritt eine .dockerignore-Datei zu einem Repository hinzufügen.
Was ist eine .dockerignore-Datei?
Eine .dockerignore-Datei ähnelt einer .gitignore-Datei. Sie ist eine Textdatei, in der Muster für Dateien und Verzeichnisse angegeben werden, die Docker beim Erstellen eines Images anhand einer Dockerfile ignorieren soll. Damit legen Sie fest, welche Dateien oder Verzeichnisse im Build-Kontext unberücksichtigt bleiben.
Das obige Codebeispiel zeigt eine .dockerignore-Datei, die Docker anweist, das Verzeichnis node_modules, alle Dateien namens npm-debug.log, sämtliche Dockerfiles (unabhängig von der Dateiendung) und alle Markdown-Dateien zu ignorieren.
Wie kann eine .dockerignore-Datei das Erstellen von Docker-Images beschleunigen?
Wenn Docker anhand einer Dockerfile ein Image erstellt, sendet es den gesamten Build-Kontext – also das aktuelle Verzeichnis und dessen Unterverzeichnisse – an den Docker-Daemon. Ohne eine .dockerignore-Datei empfängt der Docker-Daemon unnötige Dateien und Verzeichnisse, wodurch sich die Build-Zeit deutlich verlängern kann.
Wenn Sie Ihrem Repository eine .dockerignore-Datei hinzufügen, weisen Sie Docker an, unnötige Dateien und Verzeichnisse zu ignorieren. Dadurch wird der Build-Kontext kleiner. Docker kann Images schneller erstellen – und Sie sparen wertvolle CI-Sekunden.
Schritt für Schritt: Eine .dockerignore-Datei zu einem Repository hinzufügen
So fügen Sie Ihrem Repository eine .dockerignore-Datei hinzu:
1. Erstellen Sie im Stammverzeichnis Ihres Repositorys eine neue Datei mit dem Namen .dockerignore.
2. Öffnen Sie die neu erstellte .dockerignore-Datei in Ihrem bevorzugten Texteditor.
3. Fügen Sie Muster für Dateien und Verzeichnisse hinzu, die beim Erstellen des Docker-Images ignoriert werden sollen. Sie können beispielsweise alle Protokolldateien und das Verzeichnis node_modules ignorieren, wie unten gezeigt:
4. Speichern und schließen Sie die .dockerignore-Datei. Wenn Sie das nächste Mal ein Docker-Image aus diesem Repository erstellen, ignoriert Docker die angegebenen Dateien und Verzeichnisse – und der Build Ihres Docker-Images ist schneller!
Eine .dockerignore-Datei ist ein einfaches, aber leistungsstarkes Tool, mit dem sich die Build-Zeit von Docker-Images deutlich verkürzen lässt. Wenn Sie sie in Ihre Repositorys aufnehmen, können Sie Ihre Docker- und CI-Prozesse effizienter und sicherer gestalten.
Tipp 2: Verwenden Sie eine Dependency-Lockdatei
Eine Dependency-Lockdatei ist ein wichtiges Hilfsmittel, um Docker-Builds schneller und reproduzierbar zu machen. Sie fixiert die Versionen der Abhängigkeiten Ihres Projekts und stellt sicher, dass bei allen künftigen Builds genau dieselben Versionen verwendet werden. Das steigert nicht nur die Build-Geschwindigkeit, sondern auch die Zuverlässigkeit und Sicherheit Ihrer Docker-Images.
Was ist eine Dependency-Lockdatei und warum ist sie wichtig?
Eine Dependency-Lockdatei wird von Ihrem Paketmanager erstellt und enthält die genauen Versionen und Abhängigkeiten Ihres Projekts zu einem bestimmten Zeitpunkt. Sie ist wie eine Momentaufnahme der Projektabhängigkeiten. Im Docker-Kontext dokumentiert sie, welche Softwareversionen zum Erstellen eines bestimmten Docker-Images verwendet wurden.
Eine Lockdatei ist aus mehreren Gründen wichtig. Sie sorgt dafür, dass Ihre Docker-Builds reproduzierbar und deterministisch sind. Das bedeutet, dass Sie bei jedem Erstellen Ihres Docker-Images dasselbe Ergebnis erhalten. Das ist entscheidend für das Debugging und die Einhaltung von Sicherheitsanforderungen, denn so wissen Sie stets genau, was Ihr Docker-Image enthält.
Darüber hinaus kann eine Dependency-Lockdatei Ihre Docker-Builds deutlich beschleunigen. Da sie die genauen Versionen Ihrer Abhängigkeiten enthält, kann Docker diese Layer zwischenspeichern und bei künftigen Builds den Installationsschritt überspringen. So verkürzt sich die Build-Zeit.
Wie eine Dependency-Lockdatei schnellere und reproduzierbare Builds ermöglicht
Sehen wir uns eine einfache Dockerfile ohne Lockdatei an:
Bei jedem Build ruft npm install die neuesten Versionen der in package.json definierten Abhängigkeiten ab. Das ist zeitaufwendig und führt zu nicht reproduzierbaren Builds, da sich die installierten Abhängigkeiten von Build zu Build unterscheiden können.
Hinweis: Wenn Sie Node.js-Anwendungen mit Docker erstellen, empfehlen wir Ihnen dringend, die 10 Best Practices zum Containerisieren von Node.js-Webanwendungen mit Docker zu lesen.
Verwenden wir nun eine Lockdatei:
Hier kopieren wir die package-lock.json in das Docker-Image und verwenden npm ci statt npm install. Der Befehl npm ci nutzt die Lockdatei, um genau die festgelegten Versionen der Abhängigkeiten zu installieren. So werden reproduzierbare Builds ermöglicht und Docker kann den Dependency-Layer für schnellere Builds zwischenspeichern.
So verwenden Sie eine Dependency-Lockdatei in Docker
Damit Sie eine Dependency-Lockdatei in Docker verwenden können, muss sie im Docker-Build-Kontext enthalten sein. Kopieren Sie sie dazu mit dem Befehl COPY in Ihrer Dockerfile in das Docker-Image.
Hier ein Beispiel mit einem Python-Projekt, das Pipfile.lock verwendet:
In dieser Dockerfile kopieren wir Pipfile und Pipfile.lock in das Docker-Image. Anschließend verwenden wir pipenv install --system --deploy, um genau die in Pipfile.lock festgelegten Versionen der Abhängigkeiten zu installieren. Das sorgt für reproduzierbare Builds und optimiert die Build-Leistung, indem der Docker-Cache genutzt wird.
Eine Dependency-Lockdatei ist ein wichtiges Hilfsmittel für schnellere und reproduzierbare Docker-Builds. Sie sorgt nicht nur für konsistente und zuverlässige Docker-Images, sondern erhöht auch deren Sicherheit, da Sie stets wissen, welche Softwareversionen darin enthalten sind.
Tipp 3: Gruppieren Sie Befehle danach, wie wahrscheinlich sie sich ändern
Effiziente Vorgehensweisen verbessern sowohl die Container-Sicherheit als auch die Softwareentwicklung – und das Erstellen von Docker-Images ist keine Ausnahme. Eine solche Vorgehensweise ist, Befehle danach zu gruppieren, wie wahrscheinlich sie sich ändern. Damit können Sie beim Neuerstellen von Docker-Images viel Zeit und Ressourcen sparen. Sehen wir uns an, wie das funktioniert.
Das Prinzip der Befehlsgruppierung in Docker
In Docker erzeugt jeder Befehl, den Sie in eine Dockerfile schreiben, einen neuen Layer im Docker-Image. Docker nutzt einen Cache für diese Layer, um den Image-Build zu beschleunigen.
Beim Erstellen eines Images verarbeitet Docker die Befehle Zeile für Zeile. Wenn sich ein Befehl seit dem letzten Build nicht geändert hat, verwendet Docker den zwischengespeicherten Layer, statt den Befehl erneut auszuführen. Dadurch verkürzt sich die Build-Zeit erheblich.
Ändert sich jedoch eine einzelne Zeile, kann Docker den Cache für diese Zeile und alle nachfolgenden Zeilen nicht verwenden. Steht also eine Zeile, die sich häufig ändert, am Anfang der Dockerfile, wird der Cache nicht effektiv genutzt und Docker muss das Image bei jedem Build größtenteils neu erstellen. Hier kommt die Gruppierung von Befehlen ins Spiel.
Docker-Images durch Gruppieren von Befehlen schneller neu erstellen
Wenn Sie Befehle danach gruppieren und anordnen, wie wahrscheinlich sie sich ändern, können Sie den Docker-Cache optimal nutzen und das Neuerstellen von Docker-Images erheblich beschleunigen.
Ordnen Sie Ihre Dockerfile so an, dass sich häufig ändernde Befehle am Ende befinden. So kann Docker zwischengespeicherte Layer für unveränderte, selten aktualisierte Befehle verwenden. Nur die Layer der geänderten Befehle müssen dann neu erstellt werden.
Befehle mit der geringsten Änderungswahrscheinlichkeit an den Anfang setzen
Ein weiterer Tipp in diesem Abschnitt für schnelleres Neuerstellen von Docker-Images: Platzieren Sie die Befehle, die sich am seltensten ändern, am Anfang der Dockerfile. So lässt sich der Docker-Cache effektiver nutzen.
In einer Dockerfile-Datei erzeugt jeder Befehl, den Sie schreiben, eine neue Ebene im Docker-Image. Diese Ebenen werden übereinandergestapelt und bilden das endgültige Docker-Image. Docker nutzt einen Caching-Mechanismus für diese Ebenen, um Image-Builds zu beschleunigen. Wenn sich eine Ebene nicht geändert hat (d. h. der Befehl ist derselbe wie bei vorherigen Builds), verwendet Docker die zwischengespeicherte Version, anstatt die Ebene neu zu erstellen.
Dabei gilt: Docker verwirft den Cache für eine Ebene, wenn sich eine der Ebenen geändert hat, von denen sie abhängt. Das bedeutet, dass bei einer Änderung eines Befehls am Anfang Ihrer Dockerfile-Datei alle darunterliegenden Ebenen neu erstellt werden – auch wenn sich ihre Befehle nicht geändert haben.
Wenn Sie die Befehle, die sich am wahrscheinlichsten nicht ändern, am Anfang Ihrer Dockerfile-Datei platzieren, kann Docker den Cache für diese Ebenen bei den meisten Builds verwenden. So muss Docker weniger Ebenen neu erstellen, was den Build-Prozess beschleunigt.
Praktische Beispiele für die Gruppierung von Befehlen
Sehen wir uns eine beispielhafte Dockerfile-Datei an:
In dieser Dockerfile-Datei wird sich der Befehl COPY . /app wahrscheinlich häufig ändern, wenn Sie Ihren Anwendungscode aktualisieren. Verschieben Sie diesen Befehl und den darauf folgenden Befehl RUN pip3 install -r requirements.txt (der sich ebenfalls ändert, sobald sich die Datei requirements.txt ändert) ans Ende der Dockerfile-Datei. So kann Docker den Cache für den Befehl RUN apt-get update && apt-get install -y python3 python3-pip nutzen, der sich seltener ändert.
Die optimierte Dockerfile-Datei würde so aussehen:
Indem Entwickler und DevOps-Teams Befehle danach gruppieren, wie wahrscheinlich sie sich ändern, können sie das Neuerstellen von Docker-Images optimieren, CI-Sekunden sparen und die Container-Sicherheit sowie die Softwareentwicklung verbessern.
Fazit
Der Vorteil schnellerer Docker-Image-Builds geht über die reine Zeitersparnis hinaus. Er wirkt sich maßgeblich auf die Effizienz der CI-Pipeline und den gesamten Softwareentwicklungsprozess aus.
Ein schnellerer Docker-Image-Build-Prozess verkürzt die Build-Zeiten in der CI-Pipeline und sorgt dadurch für schnelleres Feedback für Entwickler. So wird die Softwareentwicklung beschleunigt und Entwickler können Änderungen schneller iterieren.
Darüber hinaus lassen sich Kosten senken, da in der CI-Pipeline weniger Rechenressourcen benötigt werden. Beim Cloud-Computing, wo Kosten oft direkt an CPU-Auslastung und Build-Zeit gekoppelt sind, kann ein schnellerer Docker-Image-Build-Prozess langfristig erhebliche Einsparungen ermöglichen.
Schließlich lässt sich auch die Sicherheitslage Ihrer Anwendung verbessern. Kürzere Build-Zeiten bedeuten schnelleres Feedback zu potenziellen Sicherheitsproblemen in Ihren Docker-Images. So können Sie diese schneller beheben und das Zeitfenster für mögliche Angriffe verkleinern.
Zusammenfassend lässt sich sagen: Diese Strategien für schnellere Docker-Image-Builds sind in der heutigen schnelllebigen Softwareentwicklung kein nettes Extra, sondern eine Notwendigkeit. Sie sind nicht nur entscheidend, um die Geschwindigkeit und Effizienz Ihrer CI-Pipeline zu steigern, sondern auch, um die Sicherheit und Kosteneffizienz Ihres Softwareentwicklungsprozesses zu verbessern.
Container-Sicherheit für DevSecOps
Finden und beheben Sie Container-Schwachstellen kostenlos mit Snyk.