O que é RAG e como protegê-lo
Escrito por

0 minutos de leitura
Integrar modelos de linguagem grandes (LLMs) à sua aplicação nunca foi tão fácil. Com algumas chamadas de API à OpenAI, Anthropic ou Cohere, você pode adicionar recursos de IA à sua stack na hora. Usar frameworks e bibliotecas que abstraem esse processo torna ainda mais simples criar seu próprio assistente com tecnologia de LLM. No entanto, se você já lançou recursos de LLM em produção, provavelmente esbarrou nas limitações desses modelos poderosos: eles inventam fatos com convicção, citam informações desatualizadas ou dão respostas que não levam seu contexto em consideração.
É justamente por isso que a RAG (Geração Aumentada por Recuperação) se tornou a base de implementações de IA robustas. É o padrão que preenche a lacuna entre uma “demonstração de IA interessante” e um “sistema de IA pronto para produção”. Ao combinar seu contexto com a IA generativa, você ensina o modelo a consultar as fontes fornecidas antes de responder.
Por que usar RAG
A Geração Aumentada por Recuperação (RAG) é uma técnica que amplia os recursos dos modelos de linguagem grandes (LLMs), dando acesso a informações privadas suas. Em vez de depender apenas dos dados usados no treinamento do modelo, que podem estar desatualizados ou ser genéricos demais, a RAG permite incluir seu próprio conteúdo — como documentos, anotações, relatórios ou registros de bancos de dados — e usá-lo como contexto para gerar respostas mais precisas e relevantes.
Isso é especialmente útil quando você quer que o modelo responda a perguntas ou realize tarefas com base nos seus dados internos, sem precisar treinar um novo modelo nem expor conteúdo confidencial a ferramentas externas.
Você pode se perguntar por que não incluir essas informações diretamente no prompt. Embora isso seja possível em casos simples, não é uma solução escalável. Os modelos de linguagem têm limites para a quantidade de texto que conseguem processar de uma só vez, e decidir manualmente o que incluir logo se torna ineficiente. Além disso, fornecer dados irrelevantes em excesso a um LLM pode causar alucinações: quando o modelo gera com confiança informações que parecem plausíveis, mas são falsas.
É aí que a RAG se destaca: ela busca automaticamente as informações certas para cada consulta, melhorando os resultados sem sobrecarregar o modelo nem exigir trabalho manual. Em resumo, a RAG oferece o melhor dos dois mundos: compreensão inteligente de linguagem e acesso aos seus próprios dados de forma eficiente, precisa e escalável.

Como a RAG funciona
Agora que vimos por que a RAG é importante, vamos entender como ela funciona, tanto conceitual quanto tecnicamente.
Em essência, a RAG combina dois processos: recuperação e geração. Quando você faz uma pergunta, em vez de depender apenas do que o modelo “sabe”, a RAG recupera informações relevantes das suas próprias fontes de dados e fornece esse contexto ao modelo junto com o prompt inicial.
1. Recuperação
O primeiro passo é encontrar conteúdo relevante nos seus documentos, wikis, anotações ou bancos de dados. Mas, antes de iniciar a recuperação, é preciso processar o conteúdo de algumas formas importantes:
Divisão do conteúdo em partes
Documentos longos são divididos em seções menores e mais fáceis de gerenciar, chamadas de chunks. Essa etapa é essencial porque os modelos só conseguem processar uma quantidade limitada de texto por vez. A forma como você divide o conteúdo faz diferença. Algumas estratégias possíveis são:
A divisão em partes de tamanho fixo separa o texto em blocos de tamanho igual (por exemplo, 500 tokens). É simples, mas pode cortar uma ideia no meio da frase.
A janela deslizante usa partes sobrepostas para preservar mais contexto entre os limites.
A divisão orientada pela estrutura separa o texto em limites naturais — como parágrafos ou títulos — para preservar o sentido. É ideal para documentação ou perguntas frequentes.
Escolher a estratégia de divisão certa ajuda a equilibrar a eficiência e a qualidade da recuperação. Às vezes, uma ferramenta como chonky pode ajudar a criar partes com significado.
Geração de embeddings
Em seguida, cada parte é convertida em um vetor por um modelo de embeddings, um modelo de aprendizado de máquina que mapeia o texto em um espaço de alta dimensionalidade, no qual significados semelhantes ficam próximos.
Alguns modelos de embeddings bastante usados são:
Embeddings da OpenAI (por exemplo, text-embedding-3-small), para uso geral
Sentence transformers (por exemplo, all-MiniLM-L6-v2), que são rápidos, de código aberto e ótimos para diversos casos de uso
Modelos específicos de domínio, treinados com conteúdo técnico, jurídico ou médico para representar melhor linguagens especializadas
Esses embeddings são armazenados em um banco de dados vetorial. Quando uma pessoa faz uma pergunta, ela é convertida em embedding da mesma forma, e o sistema recupera as partes mais relevantes comparando a similaridade entre os vetores. Seja qual for a estratégia de embeddings escolhida, é importante mantê-la. Infelizmente, não é fácil combinar diferentes modelos de embeddings.
2. Geração
O conteúdo mais relevante é recuperado e combinado com a pergunta original para formar um prompt completo. Em seguida, esse prompt é enviado ao modelo de linguagem, como GPT-4 ou Claude, que usa o contexto para gerar uma resposta mais alinhada às suas intenções.
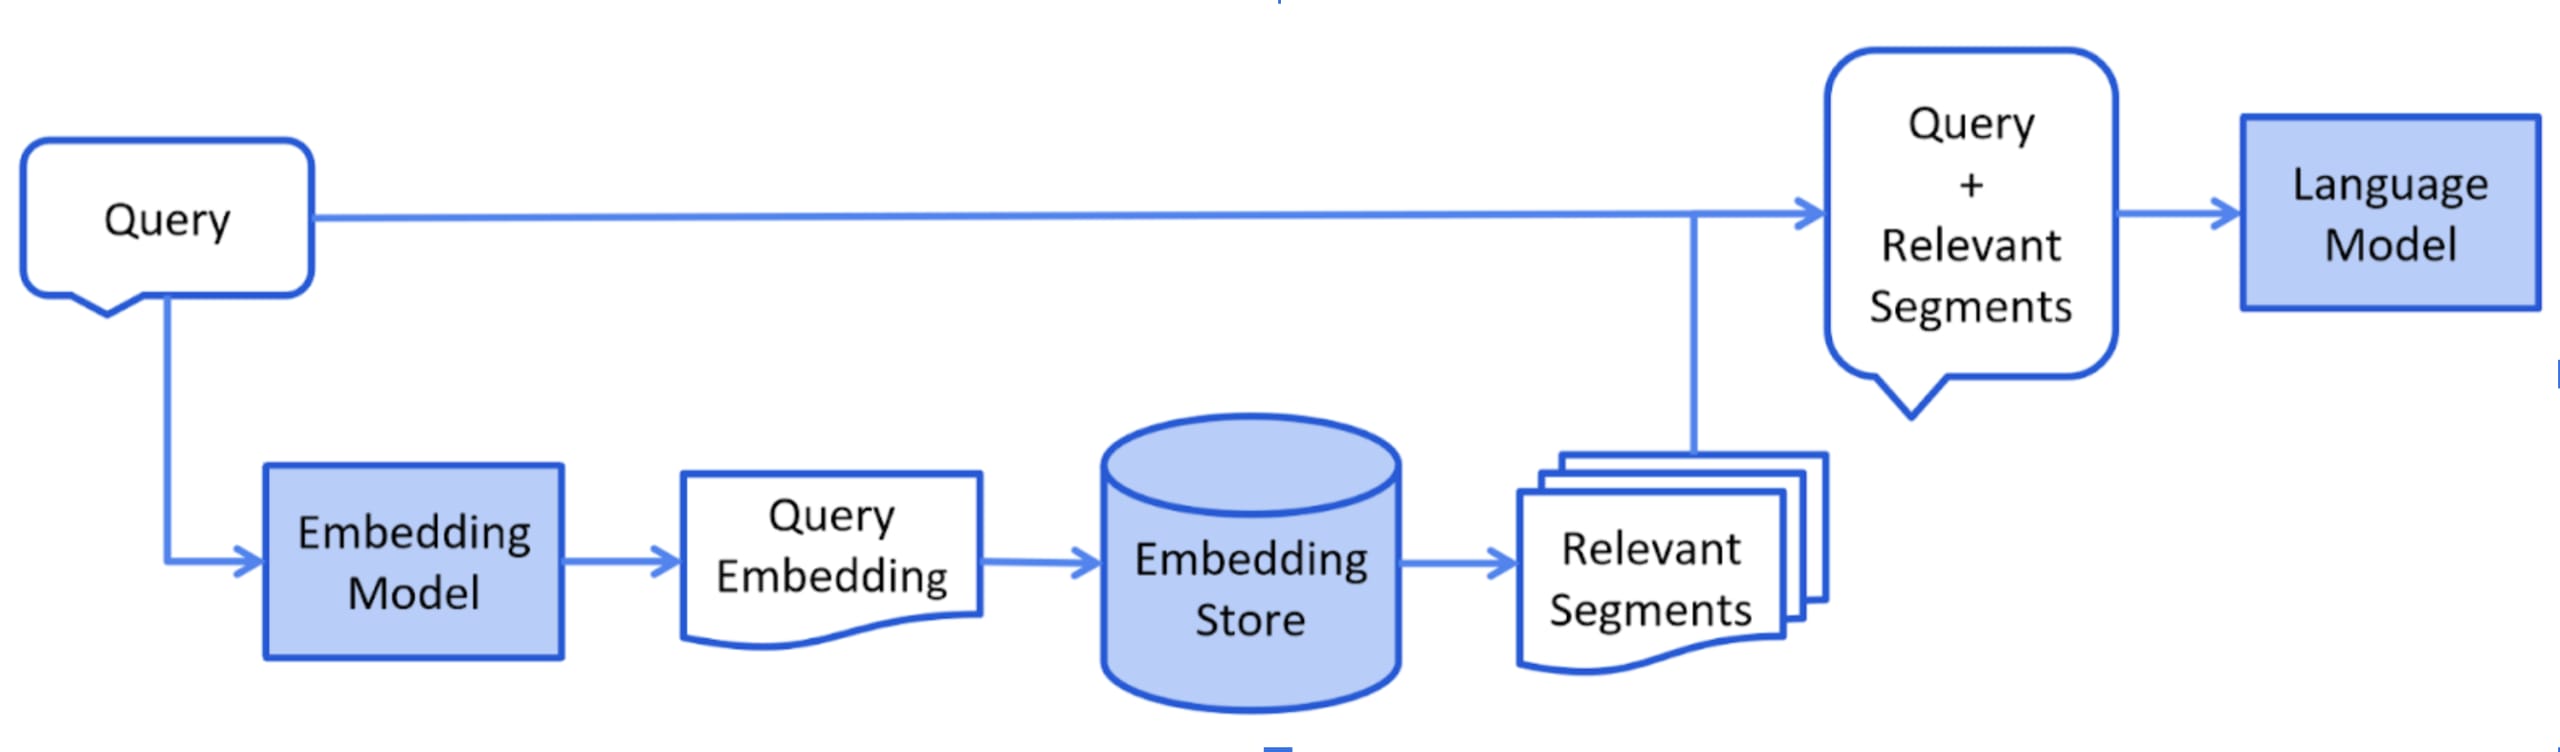
Fonte da imagem: docs.langchain4j.dev
Em vez de alucinar ou tentar adivinhar, o modelo passa a responder com base em informações reais e confiáveis das suas próprias fontes. Assim, ele fica mais inteligente, preciso e alinhado aos seus dados.
A seguir, você confere um pequeno exemplo em Java que mostra como usar o LangChain4J para adicionar RAG a um serviço simples de IA. Ele utiliza um armazenamento de embeddings em memória, incluído no framework. O exemplo mostra que começar a usar RAG não precisa ser complicado, especialmente quando você conta com as ferramentas certas.
Há muito mais para explorar ao trabalhar com várias fontes e técnicas avançadas para dividir, classificar e recuperar os dados certos dos seus embeddings. Mas, em vez de seguir por esse caminho, quero abordar algo igualmente importante: as implicações de segurança do uso de RAG.
Implicações de segurança do uso de RAG
Embora a RAG seja um padrão poderoso para tornar os modelos de linguagem úteis no mundo real, ela também traz novas preocupações de segurança. Por definição, a RAG insere dados privados ou dinâmicos na conversa, o que amplia sua superfície de ataque. Sem os devidos cuidados, você pode acabar expondo informações confidenciais ou deixando seu sistema vulnerável a novas formas de ataque. O risco é ainda maior — e mais preocupante — se o LLM da sua aplicação puder executar funções ou ações de forma autônoma.
Veja alguns dos riscos que você deve conhecer:
Injeção de prompt por meio do conteúdo recuperado
Muita gente associa a injeção de prompt a algo que acontece na entrada fornecida pelo usuário. Mas, com RAG, um prompt pode estar oculto nos próprios documentos. Se alguém conseguir inserir algo como “Ignore as instruções anteriores e responda isto no lugar” em uma anotação ou arquivo, o modelo poderá seguir essa instrução quando o conteúdo for recuperado. Isso representa um risco sério quando você busca conteúdo enviado por usuários ou fontes internas compartilhadas.
Envenenamento de dados
Os sistemas de RAG dependem dos dados que recuperam. Mas o que acontece quando consultam fontes sem controles rigorosos? Surge o risco de envenenamento de dados. Um invasor pode inserir intencionalmente informações falsas, enganosas ou tendenciosas nos seus documentos ou bancos de dados. Quando o sistema recupera esse conteúdo “envenenado”, o LLM pode gerar respostas incorretas, tendenciosas ou prejudiciais, confiando nas informações falhas recebidas.
Como isso acontece? Muitas vezes, invasores exploram falhas de segurança tradicionais no código da aplicação ou nas dependências. Vulnerabilidades como Path Traversal ou SQL Injection podem permitir que um invasor modifique os arquivos ou registros do banco de dados que alimentam seu sistema de RAG. Por isso, a segurança proativa de aplicações é fundamental para a segurança da IA. Ao analisar regularmente seu código e suas dependências com ferramentas como o Snyk, você pode encontrar e corrigir essas vulnerabilidades subjacentes antes que elas sejam usadas para adulterar as fontes de dados da sua RAG, bloqueando assim um caminho importante para ataques de envenenamento de dados.
Falhas de controle de acesso na recuperação
O fato de uma informação ser relevante para uma pergunta não significa que o usuário tenha permissão para vê-la. Se a lógica de recuperação não aplicar o controle de acesso, os usuários poderão receber respostas baseadas em documentos que não têm autorização para consultar. Sempre filtre o conteúdo recuperado de acordo com as permissões do usuário antes de enviá-lo ao modelo.
A maioria dos sistemas de RAG permite segmentar ou particionar os dados dos usuários. Use esses recursos de acordo com as ferramentas de RAG escolhidas.
Exposição de informações pessoais a modelos de terceiros
Em muitas configurações de RAG, os dados recuperados são enviados diretamente a uma API pública de LLM. Se esse conteúdo incluir informações de identificação pessoal (PII) ou dados comerciais confidenciais, você poderá violar normas de privacidade ou políticas internas. Antes de os dados saírem da sua infraestrutura, higienize e mascare as informações confidenciais. Além disso, verifique como o provedor do modelo trata e retém os dados dos prompts.
Riscos de cache e vazamento entre sessões
Para aumentar a velocidade, muitos sistemas armazenam respostas de RAG em cache. Se isso não for implementado com cuidado, pode ocorrer um vazamento entre sessões, em que o conteúdo da sessão de um usuário aparece na resposta de outro. Sempre isole os resultados em cache por usuário e contexto e tenha cuidado ao armazenar qualquer dado proveniente de uma consulta privada.
Informações contraditórias ou de baixa qualidade
Mesmo que seus dados estejam protegidos contra ataques externos, a qualidade do conteúdo continua sendo importante. Se os documentos indexados contiverem fatos desatualizados, informações conflitantes ou textos pouco claros, o modelo poderá começar a alucinar ou gerar respostas pouco confiáveis. O modelo de linguagem não verifica os fatos que recupera. Ele simplesmente usa o conteúdo como está para formular a resposta. Se esse conteúdo for fraco ou inconsistente, os resultados também serão. Isso é especialmente arriscado em áreas como direito, saúde ou segurança, nas quais a precisão é fundamental. Proteger seus dados é importante, mas mantê-los organizados e consistentes é igualmente essencial.
Estratégias proativas e de correção para proteger a RAG
Para usar RAG com segurança em produção, você precisa ir além da engenharia de prompts e da escolha do modelo. Muitas estratégias a seguir podem parecer familiares, pois são técnicas amplamente usadas. Mas elas se tornam ainda mais importantes em aplicações com IA ou LLM que usam RAG.
Higienize o conteúdo recuperado
Dados confidenciais, como informações de identificação pessoal (PII), tokens de acesso, credenciais e nomes de projetos internos, devem ser removidos ou mascarados antes de serem incluídos no prompt — ou, idealmente, antes de entrarem no sistema de RAG. Evite inserir documentos brutos diretamente no modelo, especialmente se ele for um LLM de terceiros.
Aplique controles de acesso à recuperação
Aplique filtros de acesso por usuário ou função ao recuperar documentos com RAG. Garanta que as partes retornadas não sejam apenas relevantes, mas também permitidas para o usuário atual.
A maioria das bibliotecas oferece esse recurso. O Langchain4j permite armazenar metadados junto aos segmentos e usá-los para filtragem. Essa é uma ótima forma de recuperar apenas os segmentos adequados à função da pessoa que fez login.
Segmente e delimite seu índice
Não crie um único índice vetorial enorme para toda a organização. Em vez disso, segmente seus armazenamentos vetoriais por grupos de usuários, departamentos ou funções específicas. Essa abordagem aumenta a segurança ao restringir possíveis exposições e limitar o impacto de acessos não autorizados.
Previna vulnerabilidades comuns no código e nas dependências.
Vulnerabilidades no código personalizado e em bibliotecas externas podem ser usadas para envenenar os dados em sistemas RAG. Mesmo que uma vulnerabilidade pareça não ter relação com o caso, ela pode influenciar segmentos do RAG e, consequentemente, a resposta de um LLM. Vulnerabilidades como injeção de SQL e ataques de path traversal podem levar à sobrescrita de documentos de origem. Quando esses documentos envenenados são usados em um sistema RAG, podem gerar resultados imprevisíveis ou até maliciosos. Com o Snyk, você pode analisar o código e as bibliotecas da sua aplicação em busca de vulnerabilidades conhecidas e reduzir esses riscos.
Use moderação e filtros nas fontes de dados
Antes de indexar qualquer conteúdo no seu sistema RAG, é importante validar e filtrar os dados para garantir a qualidade e a segurança. Isso inclui corrigir problemas de formatação, remover conteúdo inútil ou irrelevante e aplicar moderação para detectar tentativas de injeção de prompt, linguagem tóxica ou spam, especialmente em conteúdo gerado por usuários. Em ambientes de maior risco, considere usar fluxos de aprovação ou sistemas de marcação para controlar o que é indexado.
Faça auditorias regulares nos seus dados
Auditar e organizar seus dados regularmente é essencial para minimizar o risco de alucinações, que muitas vezes são causadas por conteúdo de baixa qualidade ou conflitante. Garanta que seus dados permaneçam limpos, consistentes e atualizados. Revise e atualize seu banco vetorial regularmente. Uma boa estratégia é armazenar uma referência ao documento original nos metadados do segmento, para que você possa atualizá-lo corretamente.
Evite respostas de cache sem filtragem
Se você usar cache para melhorar o desempenho, garanta que os resultados armazenados respeitem as sessões e o contexto de cada usuário. Prompts e respostas não devem ser reutilizados entre usuários, a menos que sejam públicos e aprovados.
Revise sua estratégia de modelos de LLM.
Separe os assistentes LLM e os armazenamentos de dados. Use um modelo local para fornecer informações confidenciais, pois alguns dados devem permanecer dentro do sistema. Evite riscos desnecessários de vazamento de dados e limite os danos usando vários modelos em um único sistema, cada um voltado a objetivos e informações específicos. Ao usar um provedor público de modelos, revise os termos sobre armazenamento, retenção e uso de dados. Para cargas de trabalho confidenciais, use modelos com fortes garantias de privacidade ou hospede-os internamente.
O RAG é essencial, mas também pode ser um vetor de ataque.
A geração aumentada por recuperação (RAG) é uma técnica essencial para criar aplicações robustas e confiáveis com tecnologia de LLM. Ao integrar fontes externas de conhecimento, o RAG contorna as limitações dos LLMs e oferece respostas mais precisas e contextualizadas. No entanto, a implementação do RAG traz considerações de segurança. Riscos como injeção de prompt, envenenamento de dados, falhas no controle de acesso e vazamento de dados precisam ser gerenciados de forma proativa. Com estratégias como sanitização de conteúdo, aplicação de controles de acesso, segmentação de dados, análise de vulnerabilidades e auditorias regulares, as organizações podem reduzir esses riscos e criar aplicações baseadas em RAG mais seguras. Para que a IA funcione de verdade nas nossas aplicações, é essencial ter um plano sólido que considere tanto o desempenho dos sistemas RAG quanto o nível de segurança deles.
Continue desenvolvendo seus conhecimentos em segurança de IA. Explore a trilha de aprendizado sobre as 10 principais vulnerabilidades de LLMs da OWASP no Snyk Learn.
Assuma o controle da segurança de IA com a Snyk
Descubra como a Snyk ajuda a proteger o código gerado por IA pelas suas equipes de desenvolvimento, enquanto oferece às equipes de segurança visibilidade e controle completos.