5 práticas recomendadas para criar servidores MCP
Escrito por

0 minutos de leitura
Criar servidores MCP se tornou uma forma comum de expor recursos de produtos a aplicações de IA e fluxos de trabalho orientados por IA. Se você está começando a criar servidores MCP, como seguir boas práticas e convenções para aproveitar ao máximo seu servidor MCP? Reuni uma lista de práticas recomendadas com base na minha experiência criando alguns deles em Node.js.
Se você acompanhou artigos anteriores no hub de recursos da Snyk, provavelmente já viu nossas análises de 7 servidores MCP para gerentes de produto, conteúdos que ensinam desenvolvedores como adicionar servidores MCP ao Cursor e alertas sobre os riscos de segurança da programação por vibe, que podem resultar em uma vulnerabilidade de segurança em aplicações Node.js.
Este guia reúne algumas nuances e elementos fundamentais de padrões que ajudam os servidores MCP a funcionar bem, além de abordar aspectos da experiência do desenvolvedor com clientes MCP e recursos de depuração.
Prática recomendada 1 para servidores MCP: siga os padrões de nomenclatura de ferramentas
Os servidores MCP expõem ferramentas por nome e descrição e as disponibilizam em uma lista de ferramentas na resposta aos clientes MCP que as consomem.
Veja um exemplo de definição simples de ferramenta, na qual o nome é getNpmPackageInfo:
Aviso de segurança: O código de exemplo acima de um servidor MCP é intencionalmente vulnerável à injeção de comandos como parte de um artigo educativo sobre vulnerabilidades de segurança em servidores MCP.
Você poderia ter escolhido um dos seguintes nomes para a ferramenta:
getNpmPackageInfo(o que usamos no exemplo acima)get-Npm-Package-Infoget.Npm.Package.Infoget Npm Package Information
Descobri que, quando você foge das convenções de fato para nomes de ferramentas — usando hífen (-), sublinhado (_) ou snake case (getNpm…) —, os clientes MCP não conseguem disponibilizar a ferramenta para uso, e a experiência do usuário final acaba sendo a de que ela não é chamada.
Minha recomendação: não use espaços, ponto como separador (.) nem parênteses ou colchetes, como ( ou ), no nome da ferramenta. Isso causa confusão e interrompe completamente a chamada da ferramenta MCP. Use sempre snake case no nome da ferramenta. A tokenização do GPT-4o funciona melhor com essa prática. Como alternativa, use hífen ou sublinhado como separador.
A tokenização do LLM é essencial para o nome da ferramenta
O motivo depende do modelo usado, da implementação dos clientes MCP e dos hosts MCP que os utilizam, mas o processo de tokenização do LLM é um dos fatores.
Por exemplo, veja como os modelos da OpenAI, como o GPT-4o, tokenizam o texto nestes casos:
nodeCryptoé dividido em dois tokens.
node.Cryptoé dividido em três tokens.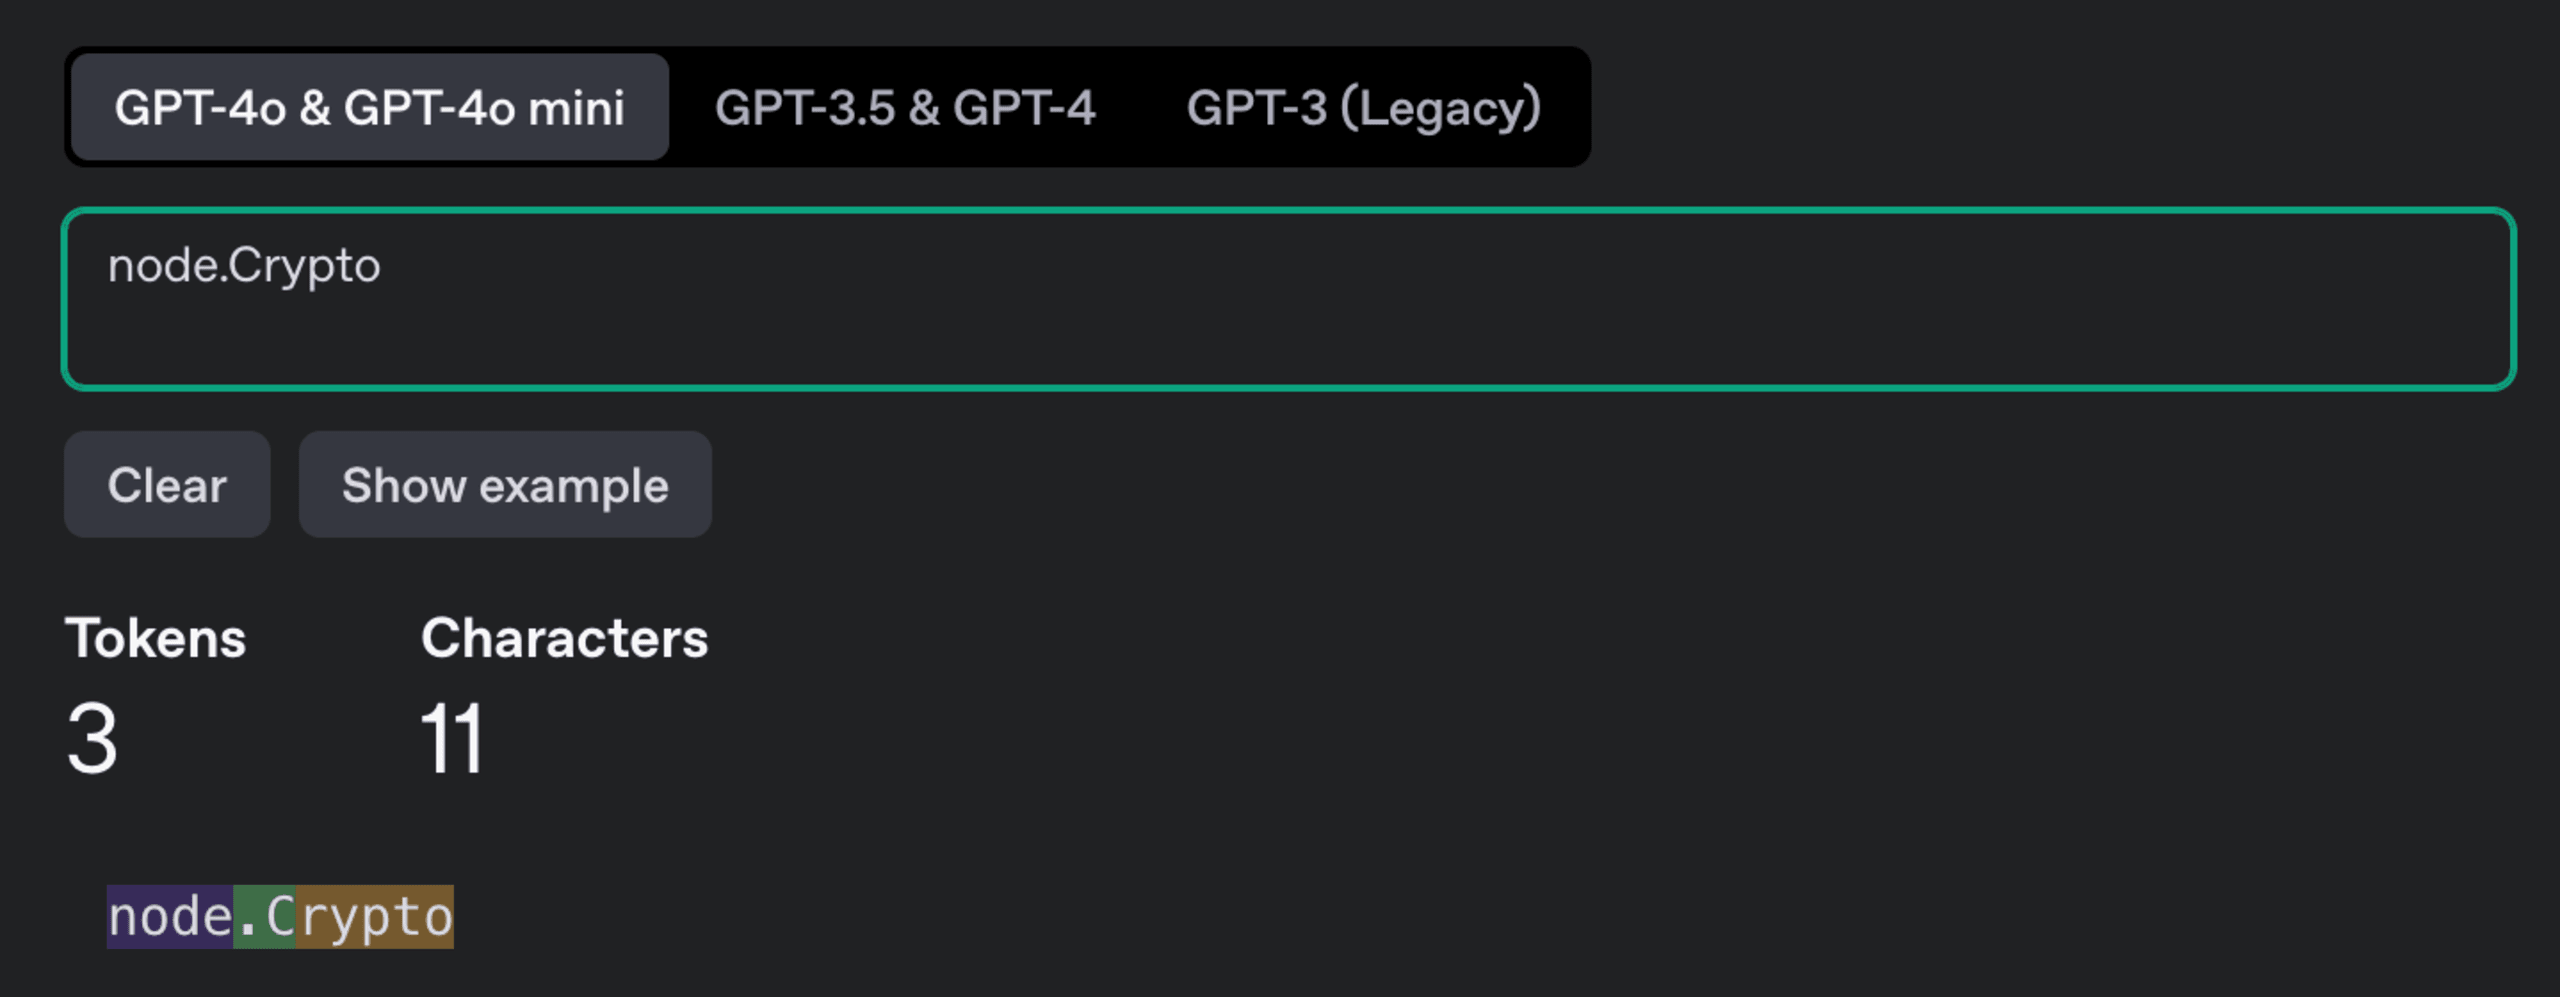
node_cryptoé dividido em dois tokens.
npm_Utilsé dividido em três tokens.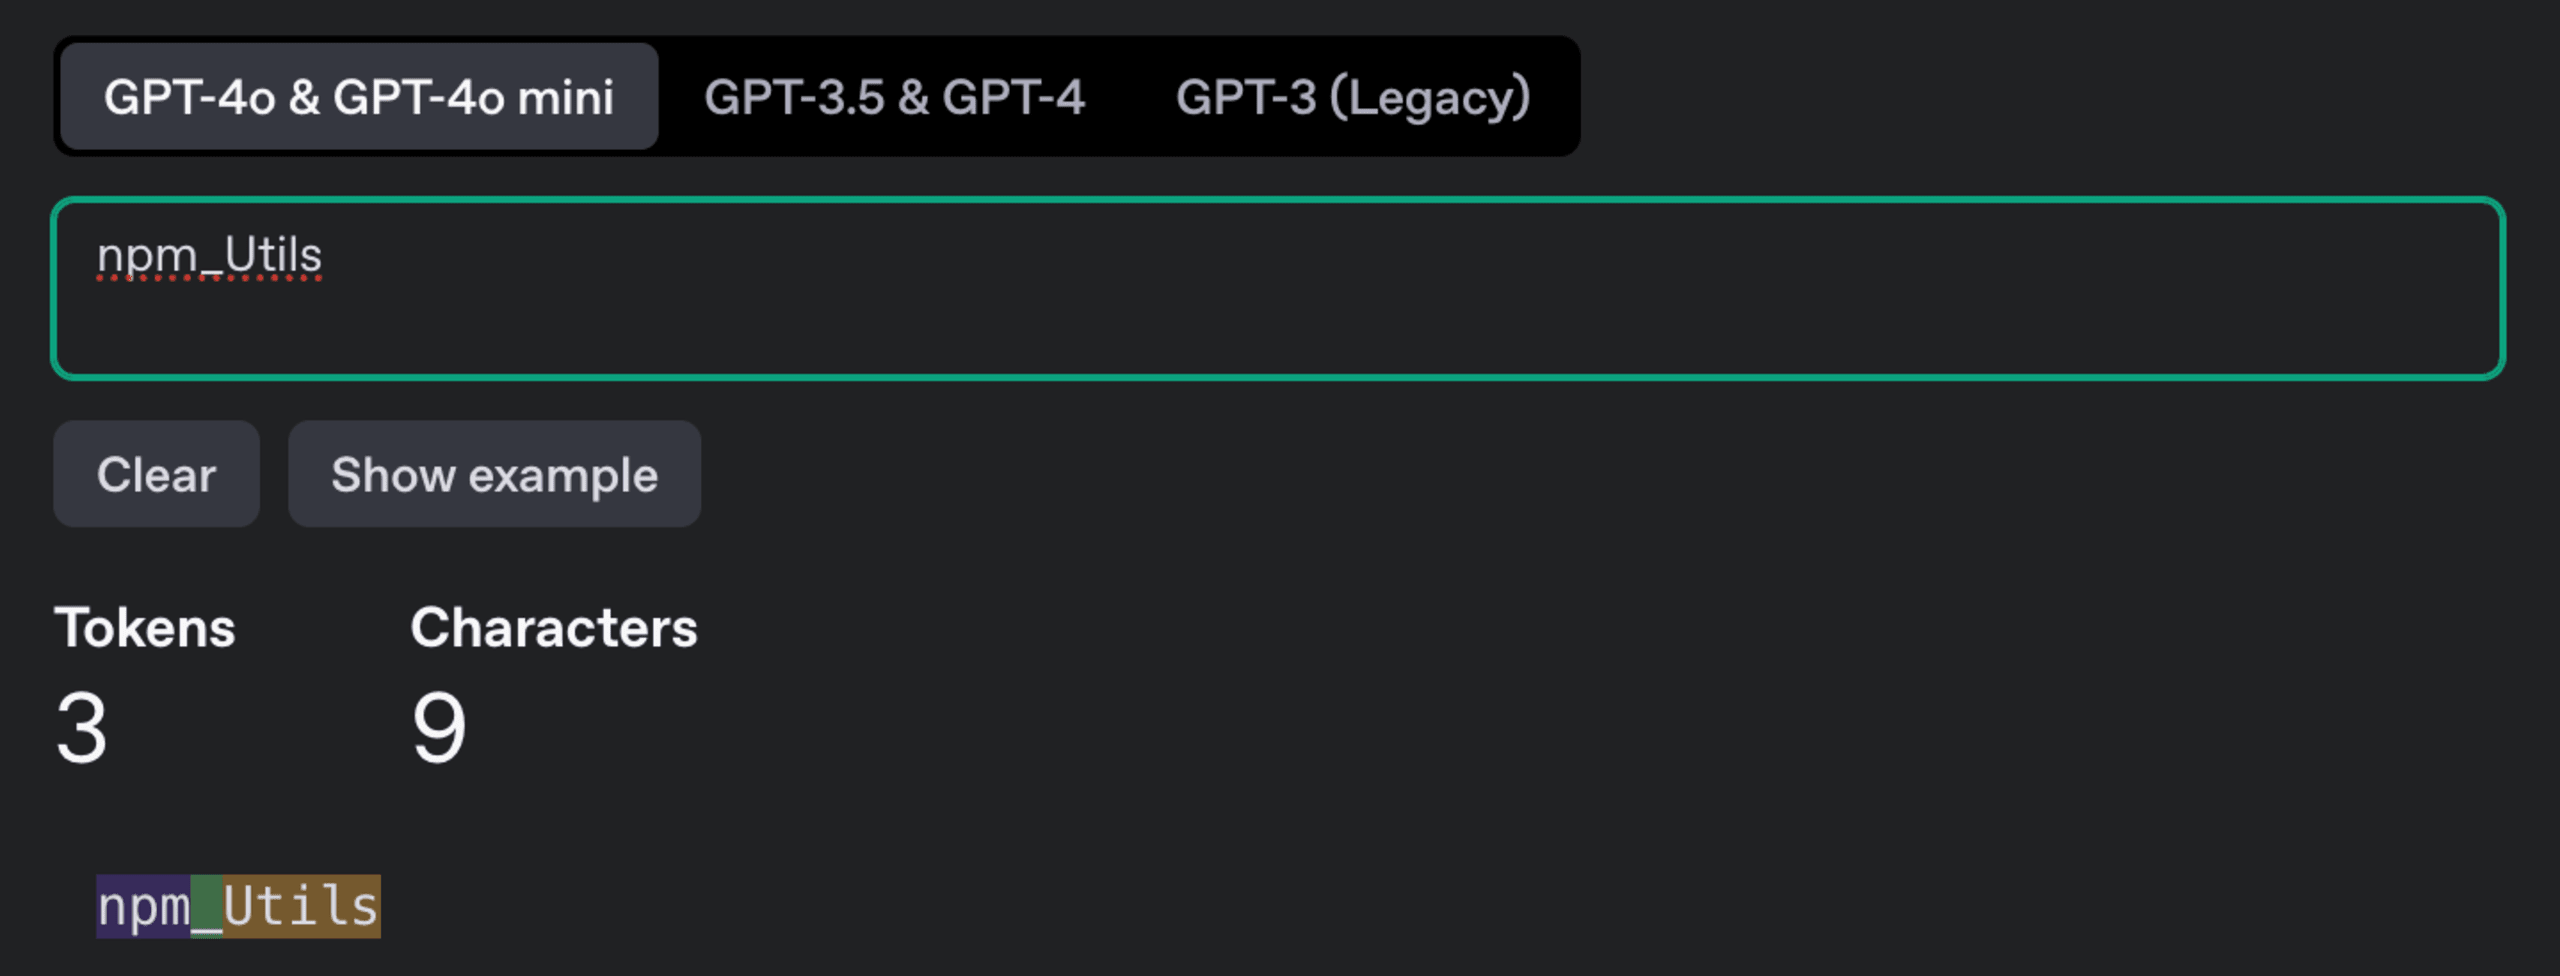
npm_Get_Package_Infoé dividido em cinco tokens.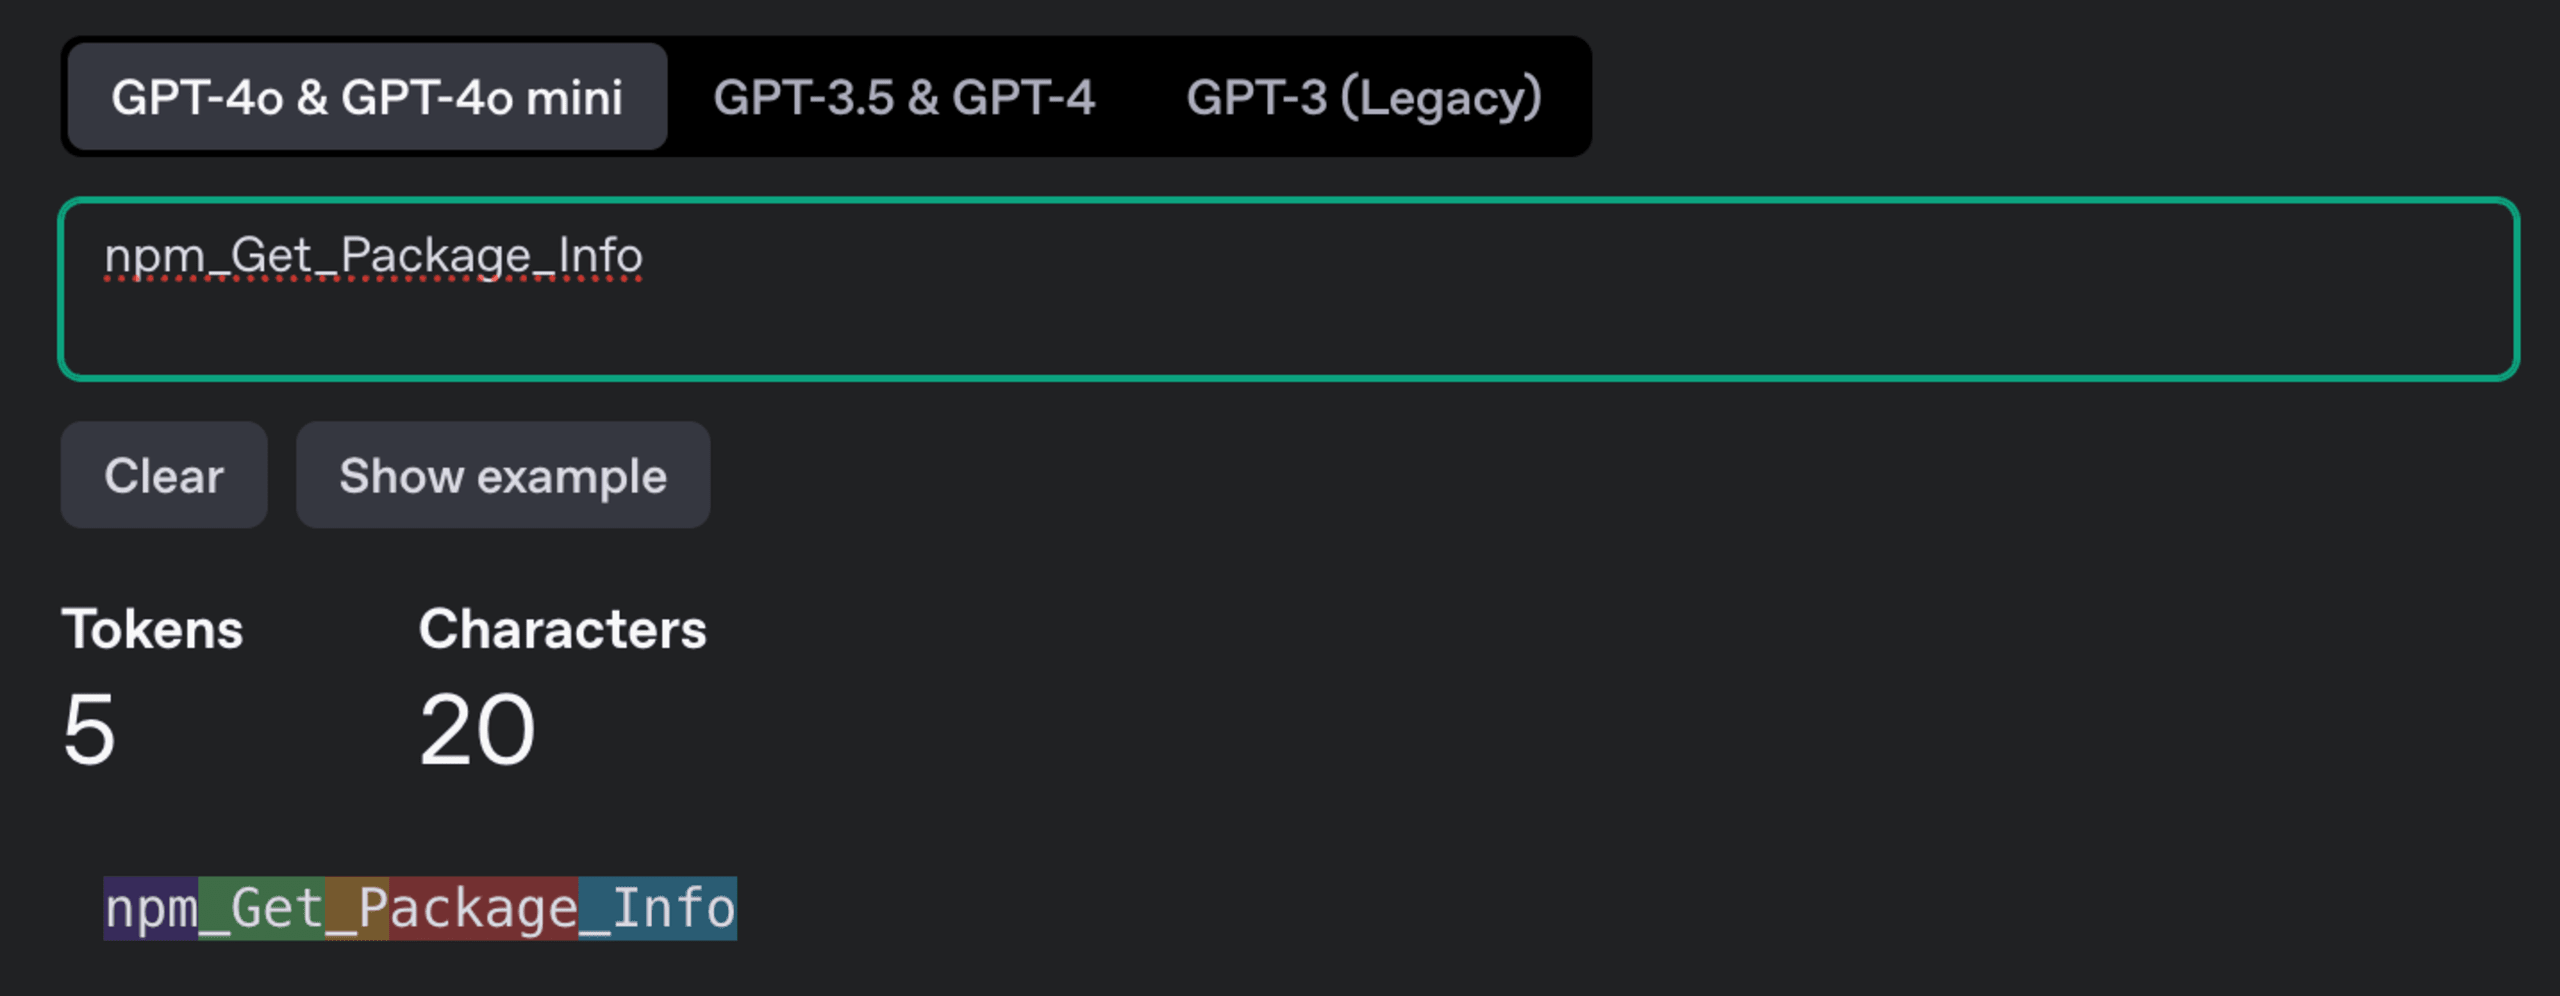
Prática recomendada 2 para servidores MCP: registre logs do servidor MCP
Como saber se a interação entre o cliente e o servidor MCP não está funcionando bem? A ferramenta chega a ser chamada?
Se você já tentou criar um servidor MCP, especialmente um simples que depende do STDIO do processo (entrada/saída padrão), deve ter percebido que console.log() não funciona bem.
Registrar logs no console ou terminal não é simples em servidores MCP que usam STDIO, porque esse canal de comunicação é usado para trocar informações entre o cliente MCP e os servidores MCP.
No entanto, deixar de registrar logs não é uma opção. Um registro eficiente é essencial para os servidores MCP, pois oferece a visibilidade necessária sobre a dinâmica do programa para resolver chamadas de ferramentas e outros processamentos realizados na lógica de definição das ferramentas. Você provavelmente precisará solucionar problemas dos servidores MCP com eficiência e obter visibilidade sobre informações importantes da execução dos fluxos de trabalho de IA.
Por isso, para servidores MCP que seguem o tipo de transporte STDIO do processo, conforme a especificação MCP, a solução mais simples é registrar logs em arquivo. Assim, as mensagens são gravadas em um arquivo designado para análise posterior.
Minha recomendação: use uma biblioteca de registro de logs, como pino, que simplifica a implementação em Node.js. É uma ótima opção, desenvolvida por colaboradores experientes e confiáveis do Node.js e pelos autores de bibliotecas do ecossistema Fastify.
Veja um exemplo de uso de pino:
Esta demonstração mostra como usar pino para criar um logger que grava logs em /tmp/mcp-server.log.
Entradas de log, como a inicialização do logger, podem então ser registradas de forma sistemática. Isso permite monitorar detalhadamente o fluxo de execução de um programa de servidor MCP.
Servidores MCP com transporte HTTP podem lidar com o registro de logs de outra forma, o que não está coberto por esta recomendação de prática recomendada.
Prática recomendada 3 para servidores MCP: evite respostas com o texto “não encontrado”
Esta recomendação diz mais respeito ao texto de resposta e à implementação da lógica para chamadas de ferramentas, e se baseia na minha experiência, ainda que limitada. Mesmo assim, minhas observações e experimentos parecem confirmar essa relação.
A ideia é a seguinte: ao implementar chamadas de ferramentas como “search”, evite responder com o texto “não encontrado”. Em vez disso, forneça ao LLM o máximo possível de dados gerais.
Um exemplo prático disso foi quando criei um servidor MCP para a documentação da API do Node.js e implementei uma ferramenta nodeSearch. Se os usuários perguntarem sobre uma API relacionada a um método do runtime Node.js, talvez não encontrem o que procuram de início, porque a implementação da ferramenta nodeSearch encontra módulos principais do Node.js pelo nome, mas não os métodos da API correspondente.
Inicialmente, eu respondia nesses casos com Module <xyz> not found. <here is everything I have>, mas descobri que, mesmo fornecendo todos os módulos e métodos, o LLM se orientava pelo texto “não encontrado” no início da resposta e não continuava a busca pelo método em um dos módulos principais do Node.js incluídos nos dados.
Minha recomendação: não retorne um texto como “não encontrado”. Em vez disso, forneça outros dados relevantes. É claro que há ressalvas, pois nem sempre é possível retornar todos os dados. Por exemplo, ao pesquisar usuários, isso provavelmente seria incorreto, inseguro e uma violação de privacidade.
Quer ver a prática em ação, antes e depois? Confira abaixo.
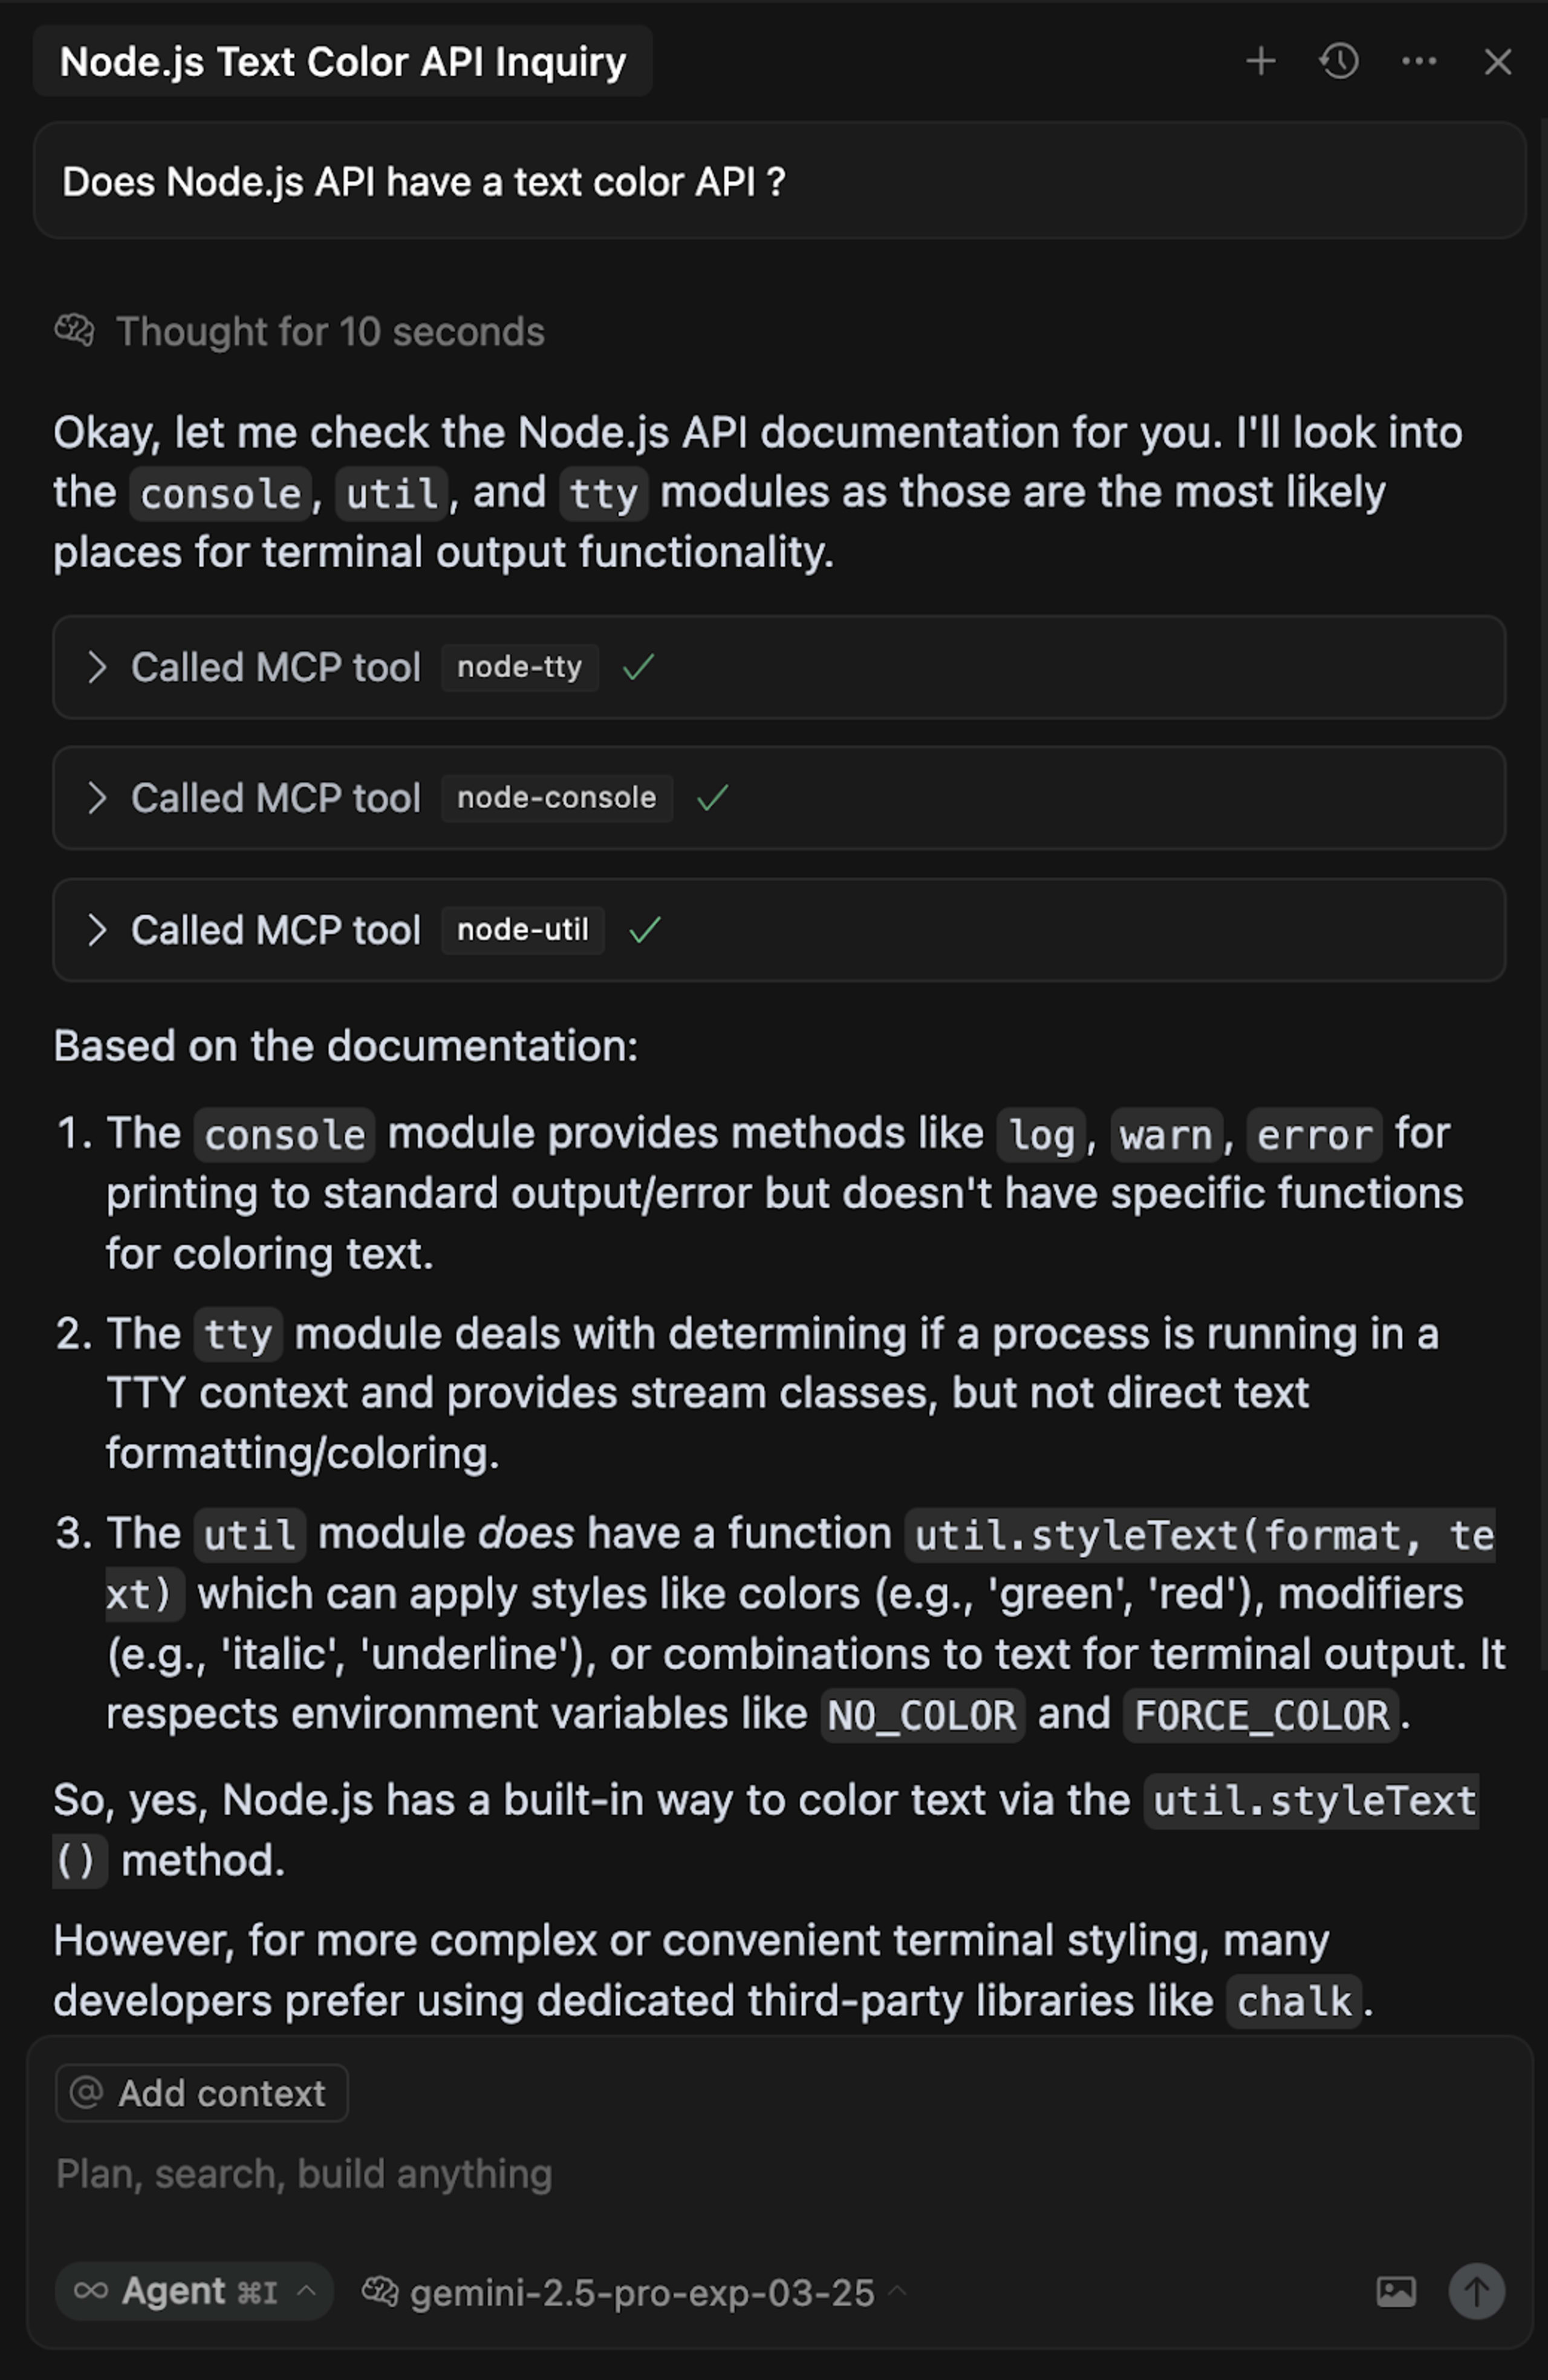
Veja a seguir um exemplo de interação em um chat de IDE que usa um servidor MCP com uma chamada de ferramenta que retorna o texto “não encontrado”. Como você pode ver, ele não consegue identificar a resposta correta:
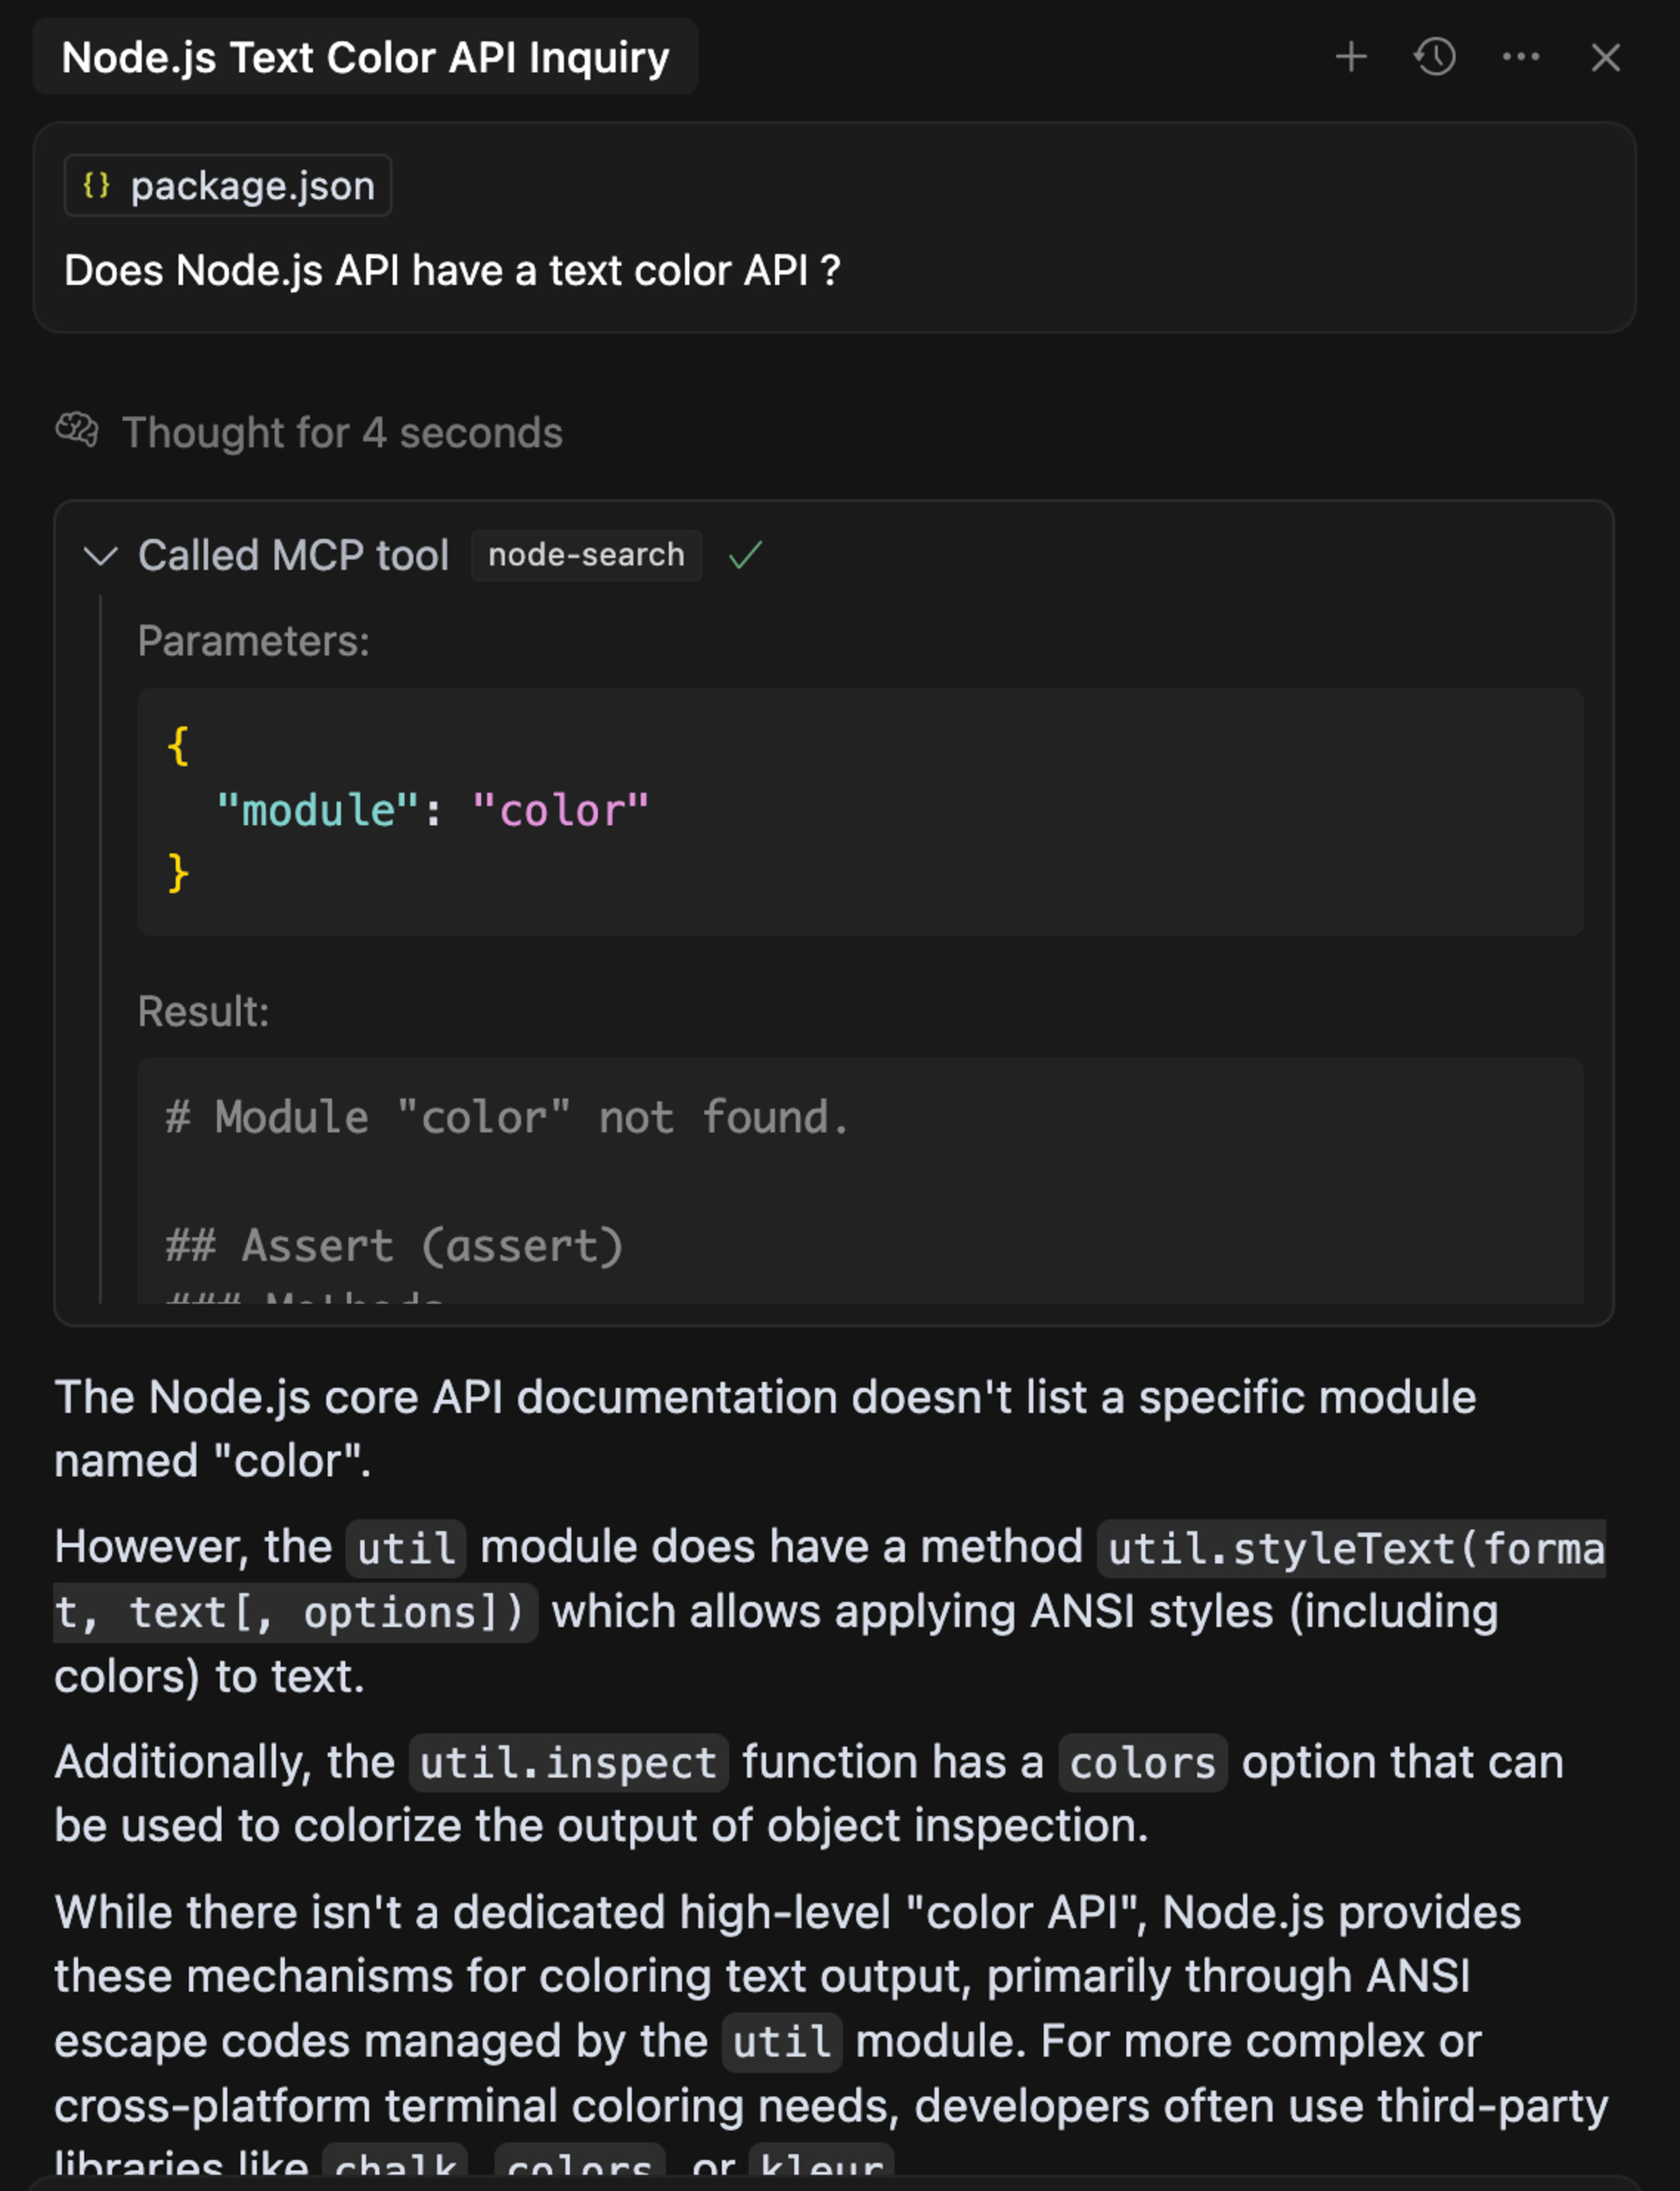
No entanto, quando removemos o # Module “color” not found do início da resposta e retornamos todos os módulos principais do Node.js disponíveis e seus métodos, o LLM pode analisar diferentes módulos e encontrar uma solução melhor.
Funciona:
Prática recomendada 4 para servidores MCP: evite componentes de terceiros vulneráveis
Não podemos deixar a segurança de fora de uma série de práticas recomendadas em uma empresa de segurança de IA como a Snyk, certo?
Para que os servidores MCP sejam amplamente adotados nas organizações e aceitos pelas equipes de infraestrutura interna, eles precisam atender a requisitos rigorosos de segurança e conformidade. As equipes de TI e de segurança de produtos conhecem bem os riscos de adicionar dependências potencialmente vulneráveis aos fluxos de trabalho. Isso não é novidade e faz parte dos requisitos de SBOM estabelecidos pela ordem executiva de Biden após as consequências do ataque à SolarWinds.
É fundamental evitar componentes de terceiros vulneráveis. Qualquer software que dependa de bibliotecas de terceiros ou contenha código com vulnerabilidades conhecidas pode se tornar um ponto de entrada para agentes mal-intencionados. Por sua função, um servidor MCP costuma ter amplo acesso e recursos de integração, o que torna qualquer vulnerabilidade um risco significativo.
Por isso, garantir que seus servidores MCP não tenham vulnerabilidades não é apenas uma prática recomendada: é essencial para uma implementação bem-sucedida.
Minha recomendação é usar a Snyk. Mas como começar a proteger servidores MCP e onde procurar?
Analise o código em busca de vulnerabilidades: a Snyk pode analisar sua base de código em busca de falhas de segurança e padrões de código inseguro, além de sugerir correções no IDE ou em outros fluxos de trabalho de desenvolvimento.
Verifique se há dependências vulneráveis: um dos pontos fortes fundamentais da Snyk é a segurança de software de código aberto. A Snyk analisa as dependências do projeto com base em um banco de dados abrangente de vulnerabilidades conhecidas e alerta você sobre os riscos e as versões para as quais atualizar.
Garanta a conformidade: questões jurídicas podem ser entediantes para desenvolvedores, mas são extremamente importantes para as empresas. A Snyk ajuda você, como desenvolvedor, a evitar problemas de responsabilidade jurídica ao identificar vulnerabilidades que violam padrões de segurança e licenciamento.
Veja uma demonstração prática de como usar a Snyk para encontrar dependências de código aberto vulneráveis:

A Snyk também encontra código vulnerável na sua própria base de código, como injeção de comandos, travessia de diretório e outros tipos de código inseguro que você escreveu ou que talvez o LLM tenha gerado. De qualquer forma, a Snyk analisa o código.
Prática recomendada 5 para servidores MCP: empacote o servidor MCP como um contêiner Docker
Criar servidores MCP é vantajoso, mas implantá-los e gerenciá-los pode trazer complexidades para o usuário final.
Muitas vezes, os servidores MCP exigem um ambiente de execução específico, como Python com uv ou Node.js com npm. Essa dependência de um ambiente de programação específico pode criar obstáculos para os usuários que consomem esses servidores. Eles precisam configurar o ambiente com precisão para executar o servidor MCP corretamente, o que pode gerar inconsistências, conflitos entre versões, erros e um processo de configuração complicado.
Uma solução eficaz para esse problema é empacotar o servidor MCP como um contêiner Docker. Os contêineres Docker oferecem um ambiente padronizado e isolado, com todas as dependências, bibliotecas e componentes de runtime necessários para que o servidor MCP funcione corretamente. Ao distribuir o servidor MCP como uma imagem de contêiner, os usuários precisam apenas ter o Docker instalado para executá-lo.
A Docker criou até mesmo um hub centralizado de servidores MCP como imagens de contêiner para servidores MCP populares:
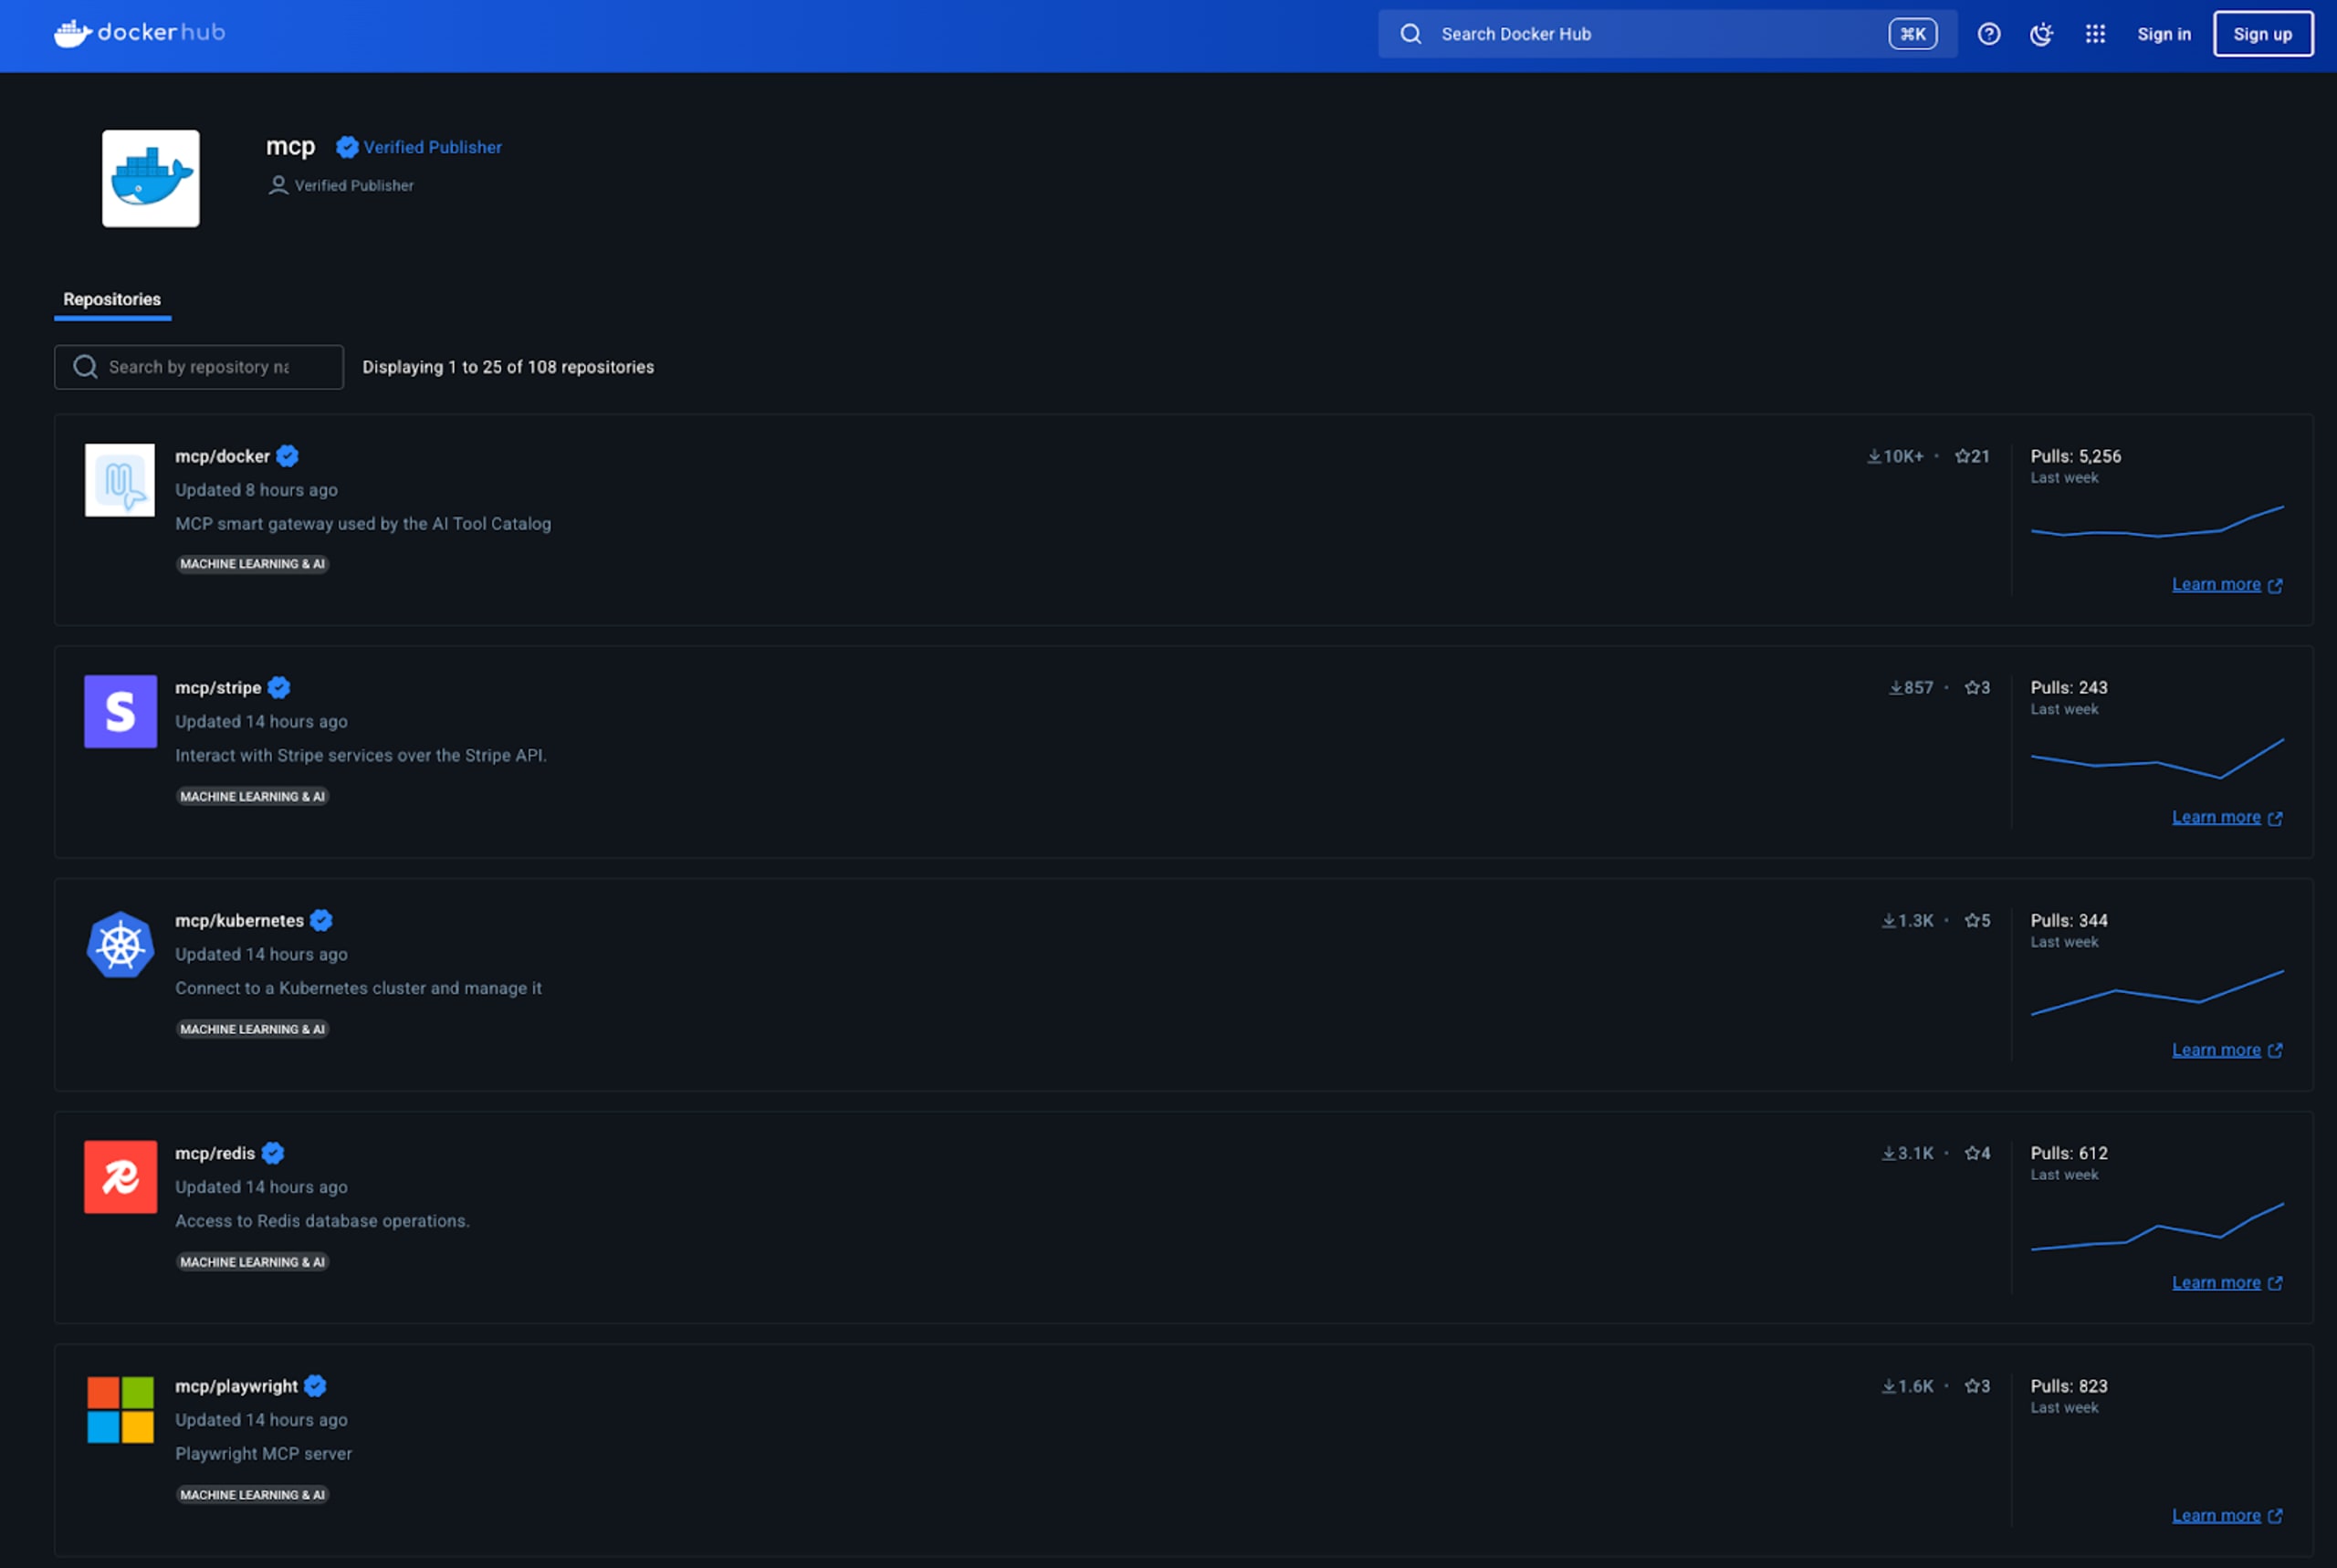
O Docker funciona como uma camada de abstração aceita pelo setor, que empacota aplicações e suas dependências em um contêiner portátil. Essa abordagem simplifica a implantação, garante consistência em diferentes ambientes e elimina o problema de “funciona na minha máquina”.
Veja alguns benefícios de oferecer imagens Docker para os servidores MCP que você criar:
Consistência: garante que o servidor MCP funcione da mesma forma nos ambientes de desenvolvimento, teste e produção.
Isolamento: evita conflitos entre as dependências do servidor MCP e outros aplicativos no sistema host.
Portabilidade: facilita a implantação do servidor MCP em qualquer sistema compatível com Docker.
Implantação simplificada: reduz as etapas necessárias para que os usuários finais coloquem o servidor MCP em funcionamento.
Gerenciamento de recursos: o Docker oferece ferramentas para gerenciar recursos como CPU, memória e rede, garantindo que o servidor MCP funcione com eficiência.
Boas práticas para desenvolver com IA com segurança
10 dicas para ajudar desenvolvedores e profissionais de segurança a mitigar riscos potenciais com eficiência e aproveitar ao máximo os benefícios do desenvolvimento com IA.