到達可能な脆弱性:オープンソースのセキュリティを効果的に優先順位付けする方法

Krysztof Huszcza
2020年8月18日
0 分で読めますお客様からよく寄せられる課題の一つは、脆弱性の多さに圧倒されてしまうことです。
小規模なプロジェクトでも、数十、場合によっては数百ものオープンソースライブラリに依存していることがあります。大規模なエンタープライズアプリケーションでは、依存関係がエコシステムの半分を占めているように感じるかもしれません。サードパーティ製の依存関係が増えるほど、それらに関連する脆弱性も増えていきます。ほとんどの開発者は、プロジェクトが抱えるサードパーティ製コードの規模をやむなく受け入れていますが、既知の脆弱性が数百、数千もある状態でアプリをリリースするのは、通常許容できる範囲を超えています。
アプリに影響する脆弱性の多さに圧倒されたとき、まず考えたいのは、これらの問題がすべて実際に悪用可能なのかということです。サードパーティ製コードに存在する脆弱性の中に、アプリから一度も実行されないものがあるとしたらどうでしょうか。つまり、アプリケーションコードから到達できない脆弱性があるとしたらどうでしょう。そうした脆弱性を把握できれば、到達不可能な脆弱性の修正優先度を下げ、代わりに到達可能な脆弱性、つまり本番環境で現在実際に影響を及ぼしている脆弱性への対応に集中できます。最終的にはすべての脆弱性を解消する必要がありますが、少なくともどこから着手すべきかがわかります。
理想的に聞こえますが、どの脆弱性が到達可能で、どれがそうでないかを実際にどう判断すればよいのでしょうか。Snykは、セキュリティの専門家による調査と自動化された静的解析を組み合わせて、この課題を解決します。このソリューションについて、もう少し詳しく見ていきましょう。
脆弱な関数
まずは、非常に重要な問い、つまり「実際にどのコードが脆弱なのか」に答えるための、セキュリティ調査について見ていきましょう。
それぞれの脆弱性について、対象のライブラリ内でどのコード行、関数、クラス、モジュールがセキュリティリスクとなるのかを把握する必要があります。これは非常に重要です。脆弱なコードを特定しなければ、そのコードに到達可能かどうかを判断できません。残念ながら、一般に公開されている脆弱性データベースには、この情報がありません。
では、脆弱なコードをどう特定すればよいのでしょうか。実際に有効だとわかった方法の一つは、セキュリティの専門家が手作業で精査することです。Snykでは、セキュリティアナリストと研究者のチームが、お客様に影響する脆弱性を継続的に分析しています。データベースに登録する前にそれぞれの脆弱性を調査し、実際に脆弱なコードを示すメタデータを付与しています。
脆弱なコードを示すために、プログラムの関数を用いることにしました。それぞれの脆弱性について、関数名とシグネチャのセットを保存します。これらの関数には、脆弱なコードそのものが含まれている場合もあれば、脆弱な動作を可能にする関数が含まれている場合もあります。脆弱性との実際の関係にかかわらず、これらを「脆弱な関数」と呼びます。個々の脆弱性について、どの関数を脆弱な関数とするかは、ケースごとに判断します。
コールグラフによる到達可能性の解析
各ライブラリの脆弱な関数を特定したら、次にそれらの関数がアプリケーションで使用されているかどうかを判断する必要があります。ここで登場するのが、私たちの解決策を構成するもう一つの要素、静的解析です。静的解析を使って入力プログラムのコールグラフを作成し、そのコールグラフをもとに脆弱な関数への到達可能性を判定します。
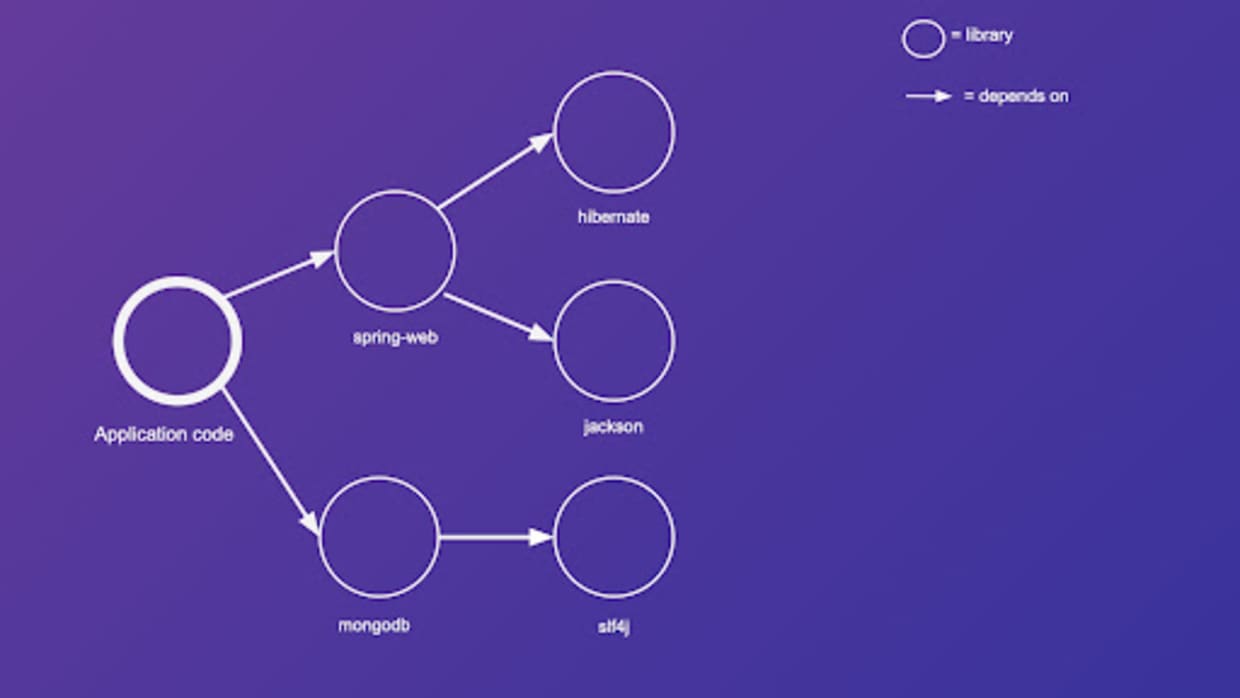
静的解析に入る前に、コールグラフを使って脆弱なコードへの到達可能性を判断する方法を、例を使って説明しましょう。JavaのWebアプリがあり、直接依存するライブラリが2つ、spring-webとmongodbだとします。spring-webはさらに、hibernateとjacksonという2つのライブラリに依存しています。mongodbはslf4jに依存しています。これらの関係は、依存関係グラフで表せます。
次に、関数呼び出しを考慮して、グラフにさらに詳細を加えましょう。アプリケーションコードとすべてのサードパーティ製ライブラリには関数が2つずつあり、spring-webだけは3つあると仮定して、各コンポーネントを大幅に単純化します。すべての関数をグラフのノードとして追加し、関数Aが関数Bを呼び出す場合に限り、AからBへ矢印を引きます。
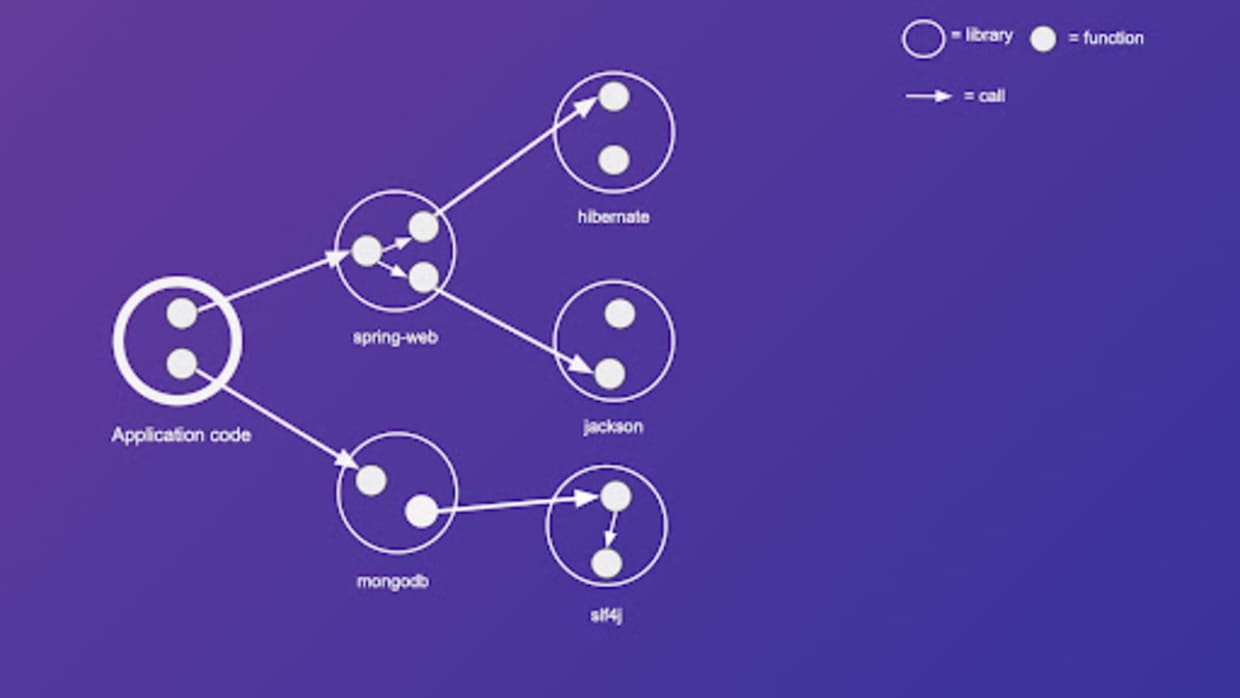
その結果できるのが、広く知られているデータ構造であるコールグラフです。次に、このコールグラフに脆弱な関数を追加しましょう。脆弱な関数は、クッキーモンスターで表します。
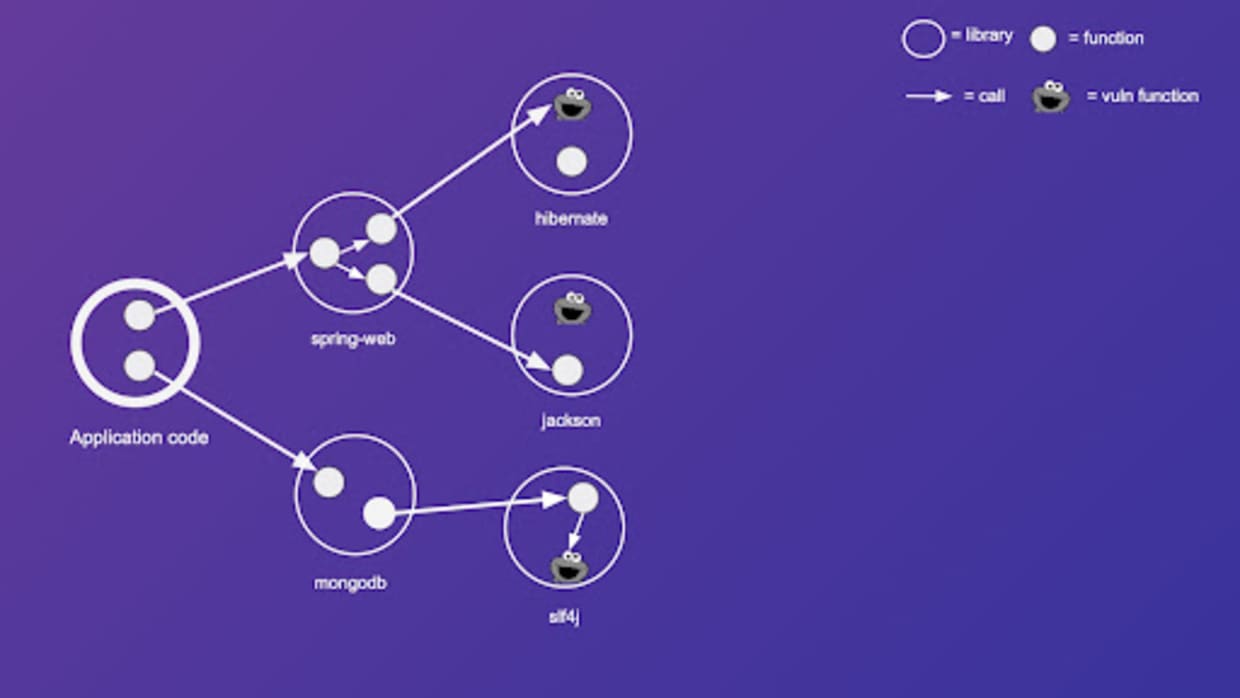
最後に、コールグラフ上でシンプルな到達可能性のルールを定めます。アプリケーションコード内のいずれかのノードから関数Xまで続く経路がコールグラフ上に存在する場合に限り、関数Xはアプリケーションコードから到達可能であるとします。このルールに従って、到達可能な関数を赤、到達不可能な関数を緑で色分けします。
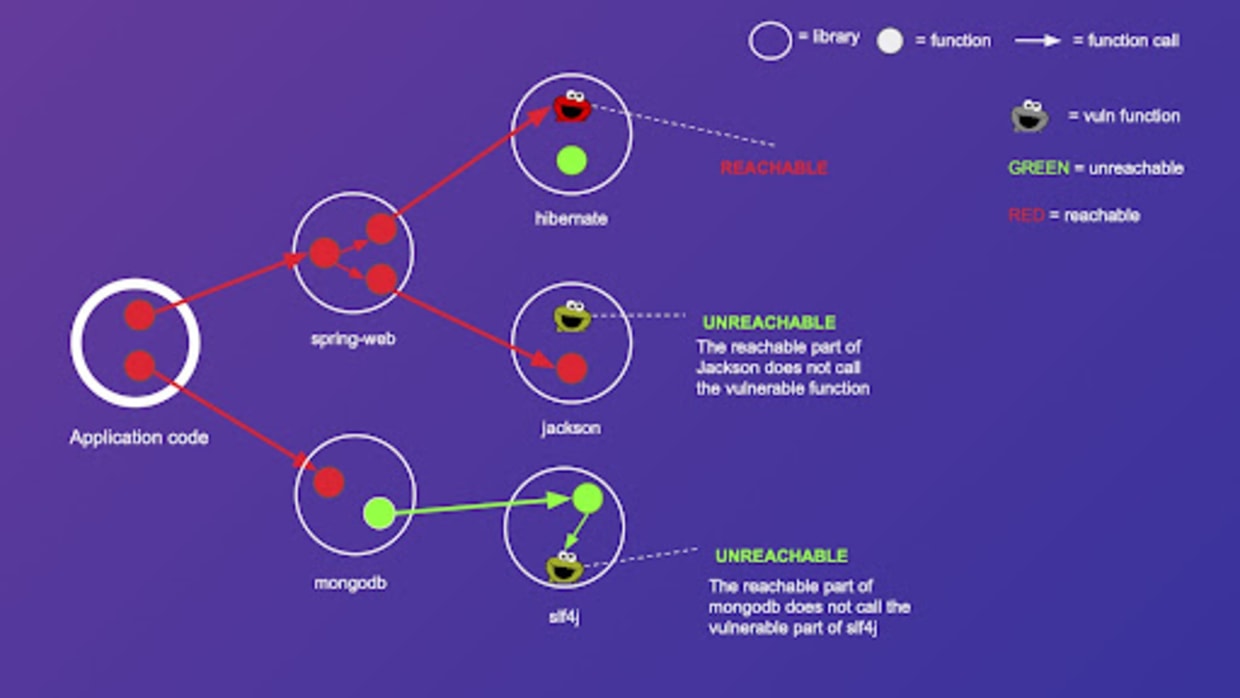
ご覧のとおり、クッキーモンスター(脆弱な関数)の中には到達可能なものも、そうでないものもあります。これにより、アプリのサードパーティ製依存関係にある脆弱性の優先順位付けルールを作成できます。特定の脆弱性に関連する脆弱な関数が1つでも到達可能であれば、その脆弱性の修正を優先します。一方、関連する脆弱な関数に到達できない場合は、その脆弱性の修正優先度を下げることができます。
コールグラフによる到達可能性の解析とは何か、また、脆弱性の優先順位付けにどう役立つのかを説明しました。では、コールグラフはどのように計算するのでしょうか。
アプリを実行してコールグラフを取得する
コールグラフを取得する方法の一つは、アプリを実行し、ランタイムエージェントを使って関数の実行データを収集することです。しかし、この動的(ランタイム)な方法は理想的ではありません。
第一に、実行中のアプリケーションへのアクセスが必要なため、SDLCの「遅い」段階で行うことになります。開発者は常に、到達可能な脆弱性をメインブランチにマージしたり本番環境にデプロイしたりする前に特定して修正したいと考えています。第二に、ランタイムエージェントのセットアップには、通常、アプリケーションごとのカスタム設定が必要で、多くの手間がかかります。最後に、エージェントを追加するとサービス停止やパフォーマンス低下を引き起こすのではないかと懸念し、アプリへの導入に消極的な開発者もいます。
そこで、動的な方法の問題をすべて解決できる、より優れた方法である静的コード解析にたどり着きました。
静的解析によるコールグラフの計算
ランタイム(動的)な方法とは異なり、静的解析では情報を収集するためにプログラムを実行する必要はありません。代わりに、アプリケーションのソースコードを解析します。プログラムの変数、代入、関数呼び出し、ポインターなどを推論するアルゴリズムを作成し、その推論に基づいてコールグラフを導き出します。
実際、セキュリティ分野では、主に静的アプリケーションセキュリティテスト(SAST)によって、静的解析はすでによく知られています。SASTの目的は、たとえばSQLインジェクションなど、アプリケーションコード内のセキュリティ上の問題を見つけることです。
出典:ポーランドのいたずら好きな人が投稿。おそらく実務で使ったことはないでしょう
今回のケースはSASTとは異なることを忘れないでください。自分のコードにあるセキュリティ上の欠陥を見つけるのではありません。サードパーティ製の依存関係にあるセキュリティ上の欠陥を扱います。
つまり、プログラム(ソースコード)とすべての依存関係(それらのソースコード)を入力として受け取り、コールグラフを出力するわけです。簡単そうですよね?
ところが、静的解析は簡単ではありません。活発に研究されている分野ではあるものの、現実のプログラムの解析は、ほとんどのプログラミング言語で、ある程度未解決の問題です。Javaを例に考えてみましょう。Javaは静的型付けで、(たとえばJavaScriptと比べて)動的な性質が少ないため、解析しやすそうに見えるかもしれません。そこで、Javaプログラムのコールグラフを静的解析で作成する方法と、そこに伴う課題を詳しく見ていきましょう。
静的解析の課題その1 — 動的ディスパッチ
動的ディスパッチとは、実行するメソッドが実行時に初めて選択され、その実行コンテキストによって決まることです。Javaのようなオブジェクト指向言語(ポリモーフィズム)から、Haskellのような関数型言語(高階関数やクロージャ)まで、ほとんどのプログラミング言語に存在します。静的解析では、実行時にどの関数が呼び出されるかを決めるコンテキストをモデル化する必要があるため、動的ディスパッチが課題となります。
次のJavaの例を見てみましょう。1つのメソッドAnimalを持つインターフェースmakeSoundと、そのインターフェースを実装する3つのクラスDog、Cat、GoblinSharkがあるとします。次のシンプルなプログラムを考えてみましょう。
このメソッドだけを見ても(つまりcreateAnimal())のコードを考慮しなければ)、animalがDogなのか、Catなのか、それともGoblinSharkなのかを判断できません。
この状況に対処する方法の一つは、あらゆる可能性を考慮することです。実際、まさにそのように動作するコールグラフ作成アルゴリズムがあります。Class Hierarchy Analysis(CHA)と呼ばれる手法です。上記の例では、CHAは次のコールグラフを生成します。
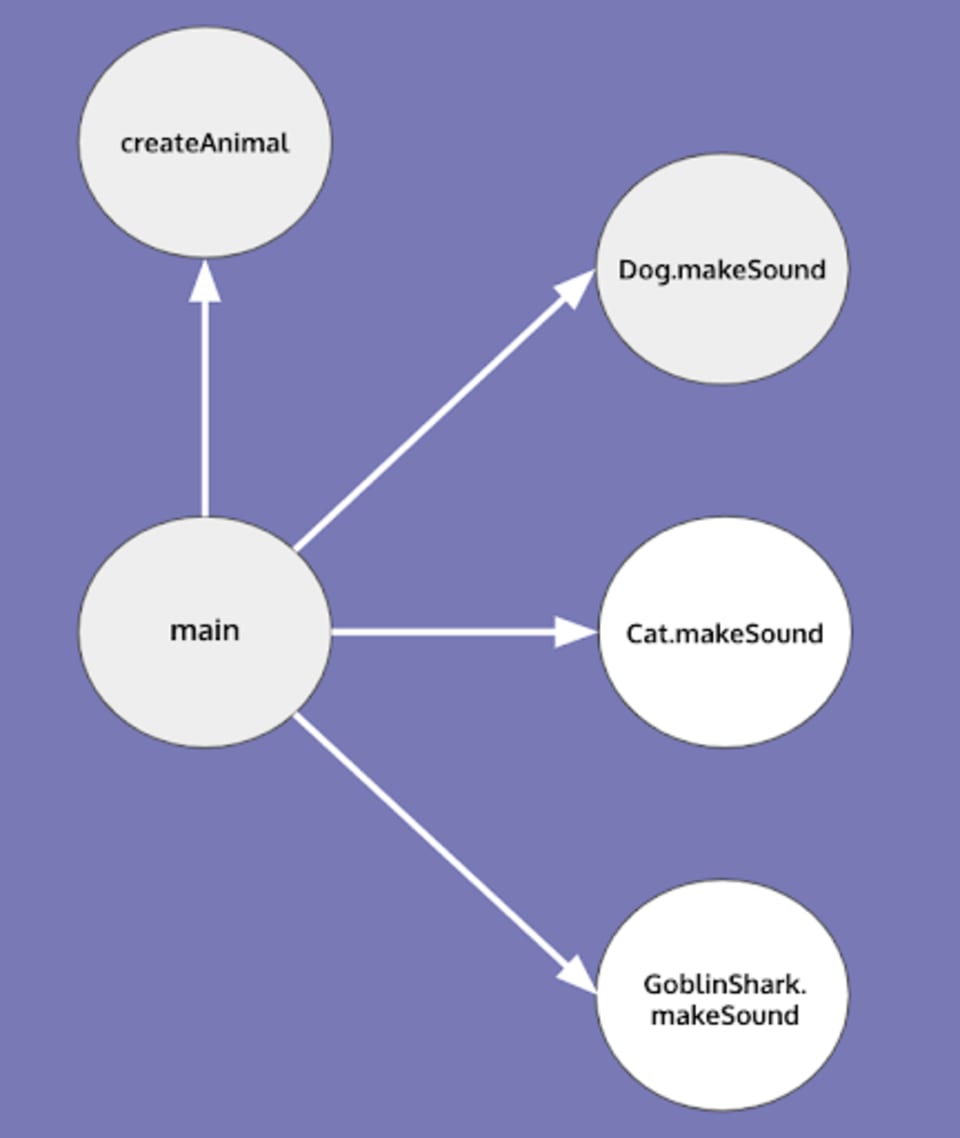
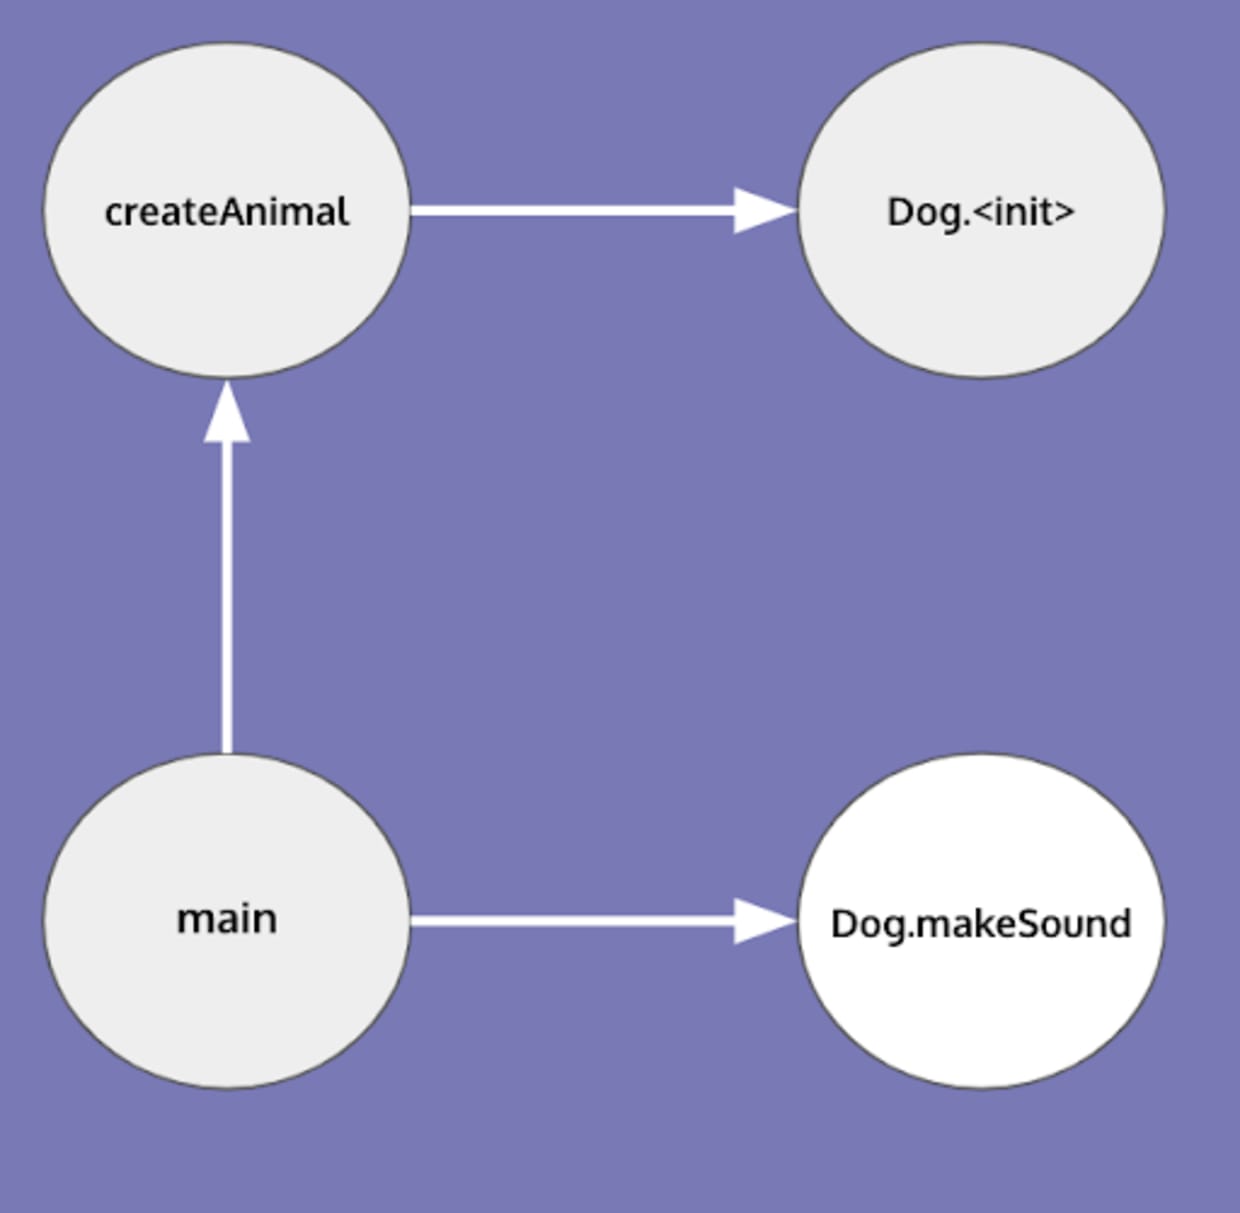
このコールグラフは健全性を保っていますが、精度が低い場合があります。たとえば、先ほど省略したcreateAnimal関数について考えてみましょう。この関数は犬だけを生成します。
CHAはすべての可能性を想定するため、コールグラフは変わらず、精度が低いままです。この問題を解決する解析手法はポイントツー解析と呼ばれ、特定の参照が指し示す可能性のある値を追跡する必要があります。
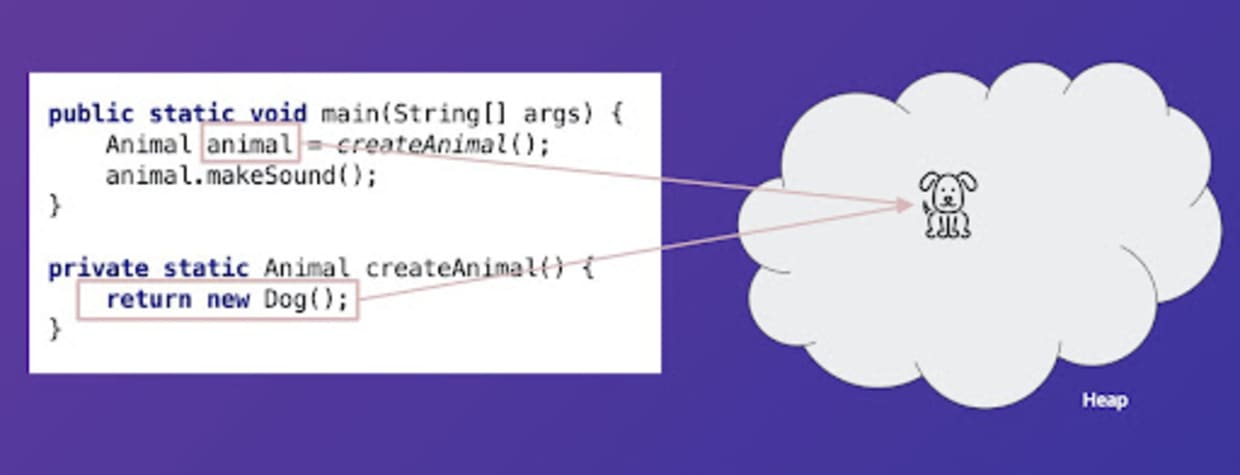
Andersenのポイントツー解析は、上記を実現する解析手法の一例です。Andersenのポイントツー解析を利用するコールグラフ作成アルゴリズムは、次のような結果を出力します。
制御フロー
プログラムの制御フローを考慮すると、ポインターの追跡はさらに難しくなります。最も単純なケースを考えてみましょう。
上記のプログラムでは、犬が音を出すことはありません。しかし、静的解析でそれを正しく判断するには、命令の順序を考慮する必要があります。上記のような単純なプログラムであれば、コンパイラーで古くから使われている手法を用いて、コードを静的単一代入形式(SSA)に変換できます。SSAでは、プログラム内の各変数への代入が1回だけである必要があるため、上記の問題は解消されます。
しかし一般に、命令の順序はプログラムの状態に影響し、その結果、コールグラフにも影響を与えることがあります。たとえば、サードパーティ製ライブラリの公開メソッドを呼び出す前に、そのライブラリのinit関数を呼び出すのは、よくあるパターンです。
initメソッドは、複雑な内部状態を設定する場合があります。その結果、上記のプログラムのコールグラフは、下記のプログラムのコールグラフと大きく異なる可能性があります。
考慮すべきもう一つの重要な要素は、if, while, for, switchなどの制御フロー文です。次のプログラムを考えてみましょう。
ここでは、条件文を無視し、if文の両方の分岐に到達できると想定するのが妥当です。この分岐があるため、実際にはポイントツー解析は、各変数について、参照先の値を1つだけでなく、可能性のある値の集合として追跡します。
その他の考慮事項
現代のプログラミング言語でコールグラフを作成する際には、ほかにも多くの課題があります。上記の例は、実際の問題領域のほんの一部にすぎません。そのほかの課題には、次のようなものがあります。
コレクション:コレクション内のどのインデックスに何が格納されているかを追跡すること。
ライブラリの公開メソッドの解析:Javaのような言語では、クライアントが機能をカスタマイズできるよう、ライブラリの公開メソッドが入力としてインターフェースを受け取ることがよくあります。そのため、こうしたメソッドのポイントツー解析は困難になります。
動的コード実行:特にフレームワークでよく使われるパターンとして、実行時に関数名を組み立てて文字列として保存し、関数名を入力として受け取り、その関数を実行する専用ライブラリを使用する方法があります(例:Javaのリフレクション)。
実際に静的解析を行う場合、すべてに対応するのは計算上現実的ではないため、何をサポートするかを明確に決める必要があります。つまり、静的解析の適用では常に、精度と計算の実現可能性(答えを算出するために必要な時間やリソース)の間でトレードオフが生じます。たとえば、Javaプログラムの呼び出しグラフにおける到達可能性分析では、SSAを用いた標準的なAndersenのポインタ先解析を実行し、条件分岐(例:if文)のすべての分岐を常に想定し、すべてのコレクションをバッグとして解析して(インデックスは考慮せず)、動的コード実行は無視する(Springなどの一般的なフレームワークを除く)というトレードオフが考えられます。
まとめ
このブログ記事では、セキュリティの専門家による調査と自動化された静的解析を組み合わせることで、到達可能な脆弱性を特定する方法をご紹介しました。このような分析の結果は、常に現実を近似したものです。しかし、ビジネスに差し迫ったリスクとなる可能性が最も高い脆弱性を特定しようとしている開発者にとって、有用な近似となります。
Snykは、開発者がセキュリティの課題に取り組めるよう、あらゆる支援を行っています。最近では、脆弱性の優先順位付けを支援する機能をいくつかリリースしました。脆弱性の到達可能性を評価することも、その機能の一つです。利用方法については、こちらのリリースのお知らせをご覧ください。
安全でセキュアな開発を!
CTFを始めよう
オンデマンドのバーチャル入門ワークショップで、CTFチャレンジの解き方を学びましょう。