GPT-4より高精度:SnykのCodeReduceが他のLLMの性能を向上させた方法

2024年5月7日
0 分で読めますSnykは2021年にSnyk Codeをリリースして以来、AIを活用したサイバーセキュリティのパイオニアとして、DeepCode AIエンジンにより、SAST分野で初めて、セキュリティ問題をかつてない精度と速度で特定できるようにしました。この3年間でAIとLLMが台頭するなか、Snykはその最前線に立ち、脆弱性を自動修正する機能のSnyk Agent Fixや、サードパーティ依存関係の到達可能性を判定する機能など、新たなAIベースの機能を導入してきました。
先日、Snyk Codeが特定したセキュリティ問題を自動修正するベータ機能、Snyk Agent Fixの大幅なモデル改善を発表しました。Snyk Agent Fixは、最新のAI技術と社内の専門知識を組み合わせ、信頼性の高い修正を生成します。セキュリティ問題の修正は複雑です。その仕組みを詳しく知るために、Snyk Agent Fixを支えるCodeReduceテクノロジーと厳選されたセキュリティ修正データセットの重要な要素を解説する研究論文を掘り下げます。
セキュリティ修正の自動化 — 複雑な課題
開発者は多くの場合、セキュリティ問題を自力で発見し、修正するために多くの時間を費やしています。DeepCode AIが登場する前、Snyk Codeは問題の特定という最初のステップを支援していました。しかし、その後の修正は依然として困難で時間がかかる場合がありました。開発者はセキュリティに関するトレーニングを受けていないことが多いためです。セキュリティ問題を修正するには、コードを手作業で確認し、意図された動作を把握して、コードの文脈における問題を理解し、実際に修正する前に対処方法を調べる必要があります。
セキュリティ問題の自動修正、いわゆる「自動修正」は、修復作業の負担軽減を目指し、長年多くの企業が注目してきたテーマです。しかし、数多くの試みにもかかわらず、正確に修正できるソリューションを実現するのは困難でした。そのため、ほとんどの自動修正ツールは、限られた種類の問題や、数行のコードに対する単純な変更、あるいは書式の修正だけに対応していました。
LLMの登場により、新世代のAIを活用して、より優れた自動修正機能を構築できる可能性が見えてきました。しかし、望ましい結果を得られるよう適切に構成されていなければ、LLMにもセキュリティ問題の修正には限界があります。多くのLLMは幅広いデータやコードで学習していますが、セキュリティ修正に特化して学習しているわけではありません。そこで、私たちは2つの重要な課題に直面しました。
セキュリティの自動修正のような専門性の高いタスクで、LLMが適切かつ正確なコード修正を生成するには、セキュリティ修正とセマンティックなコード修正に特化したデータセットが必要です。
ハルシネーションが発生すること、そしてLLMが一度に処理できるコンテキストには限りがあることから、「汎用」LLM(セキュリティに特化して学習したモデルではないもの)に、より正確な出力を促すためにプロンプトへコードを追加しても、必ずしも結果が改善するとは限りません。
LLMの限界に対処し、より優れた修正を実現する
特定した課題に対処する労力をかけても、LLMを使うメリットのほうが大きいと判断し、私たちは自ら課題の解決に取り組みました。
修正データセット
最良の結果を得るため、オープンソースのセキュリティ修正を網羅したデータセットを構築しました。まず、オープンソースのコミットに大規模なラベル付けを行い、JavaScriptの問題と修正をまとめた高品質なデータセットを作成しました(その後、Java、Python、C/C++、C#、Go、APEXなど、ほかの言語でも同様の作業を行っています)。次に、ラベル付きデータを手作業で増やす代わりに、DeepCode AIエンジンのSnyk Codeプログラム解析機能を活用し、データへのラベル付けと同等の定量的な効果を効率的に実現して、質の高いデータセットを構築しました。
CodeReduceテクノロジー(特許出願中)
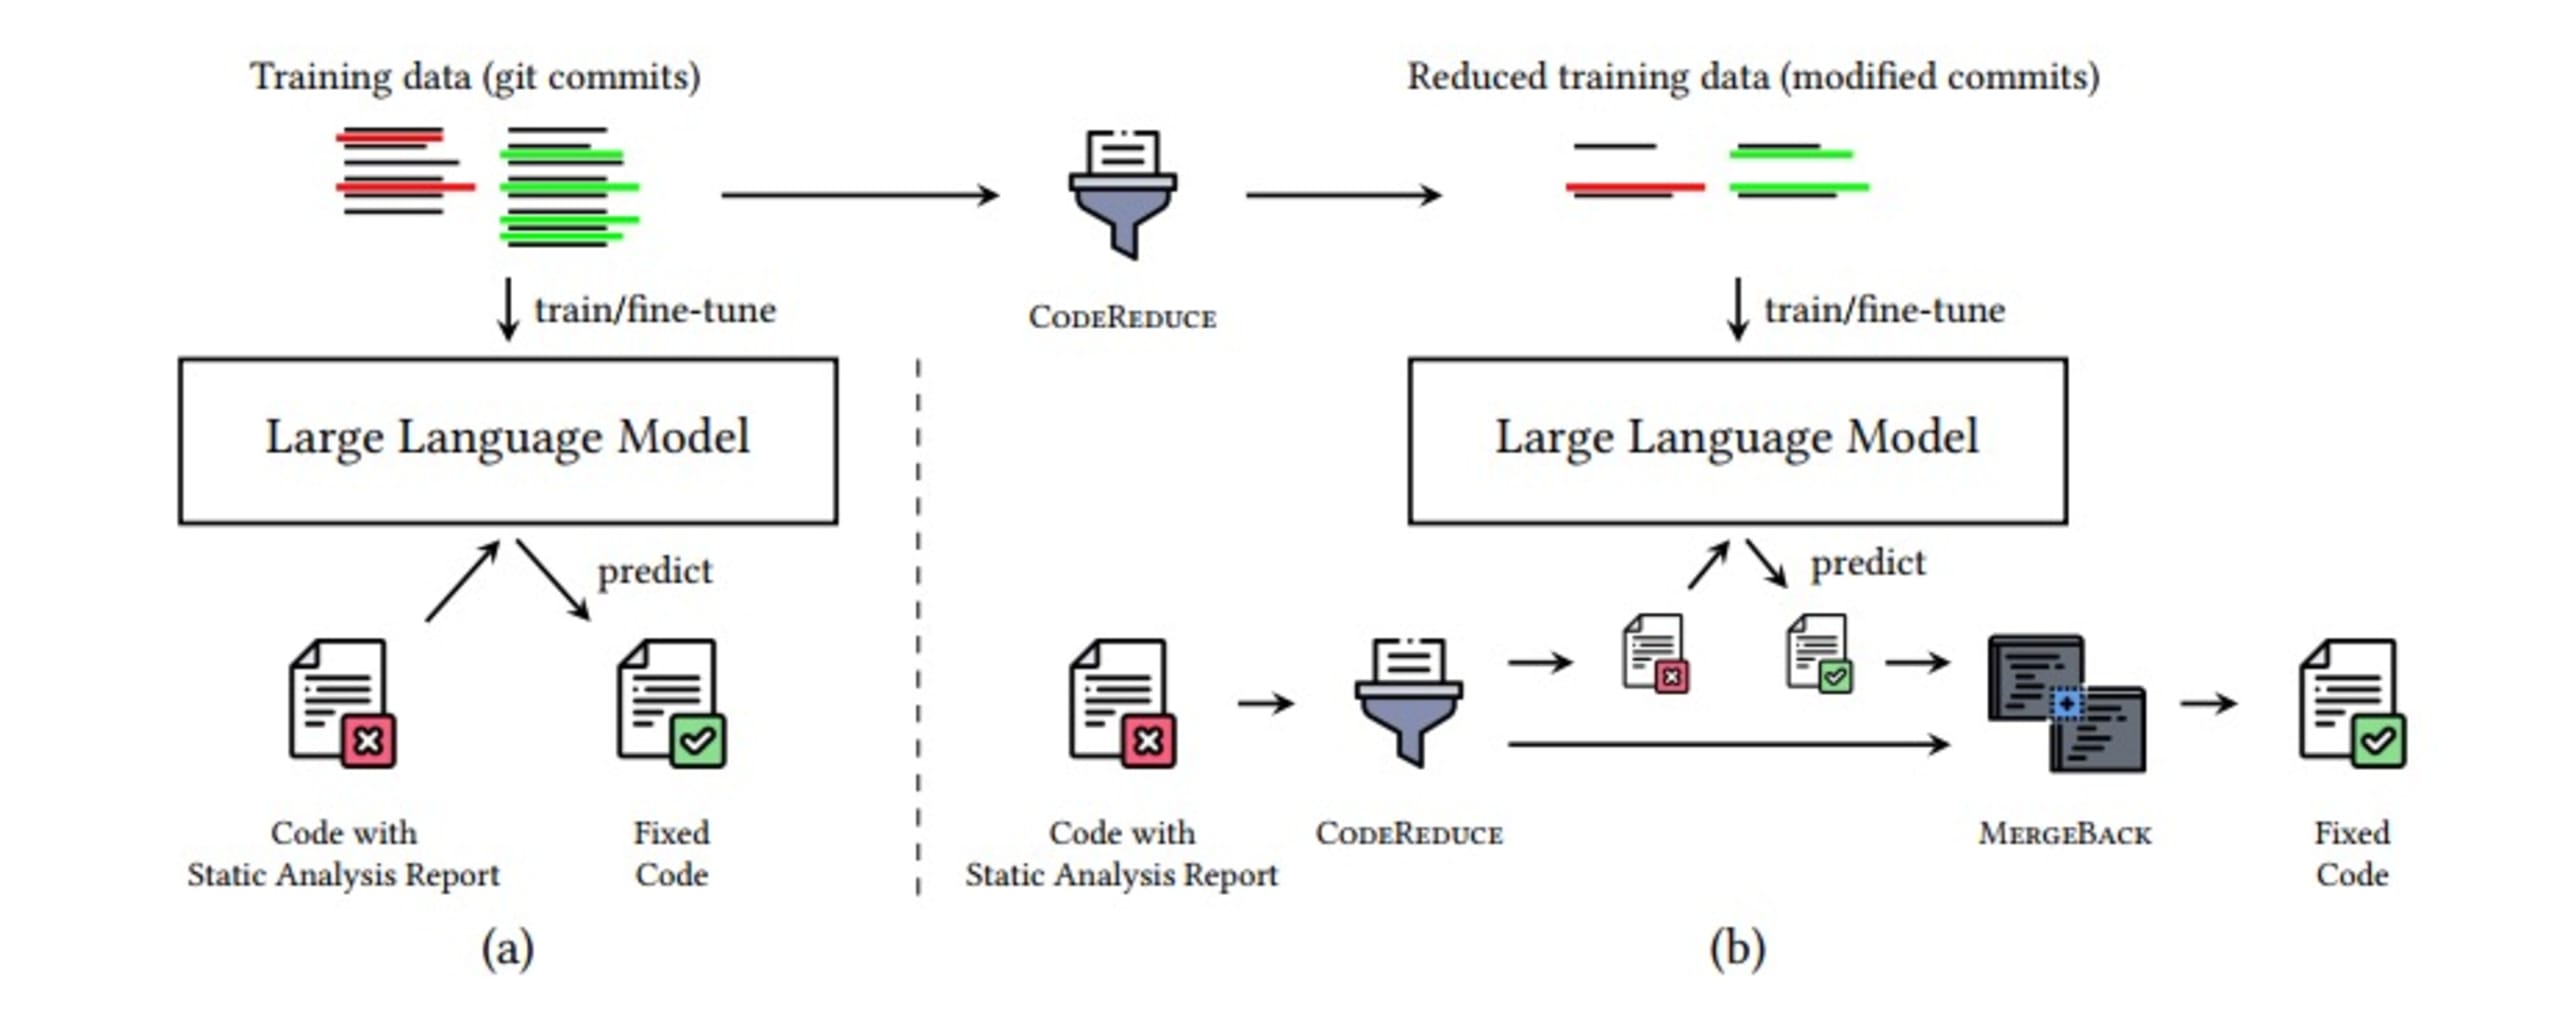
CodeReduceはプログラム解析を活用し、報告された欠陥と必要なコンテキストを含む短いコード断片にLLMの注意を集中させることで、修正に必要なコード部分だけにLLMの注意機構を絞り込みます。これによりLLMが処理するコード量が大幅に減り、テストしたすべてのAIモデルで修正生成の品質が向上するとともに、ハルシネーションも抑制されます。また、モデルに渡す情報量が減ることで処理速度も向上します。リアルタイムで修正を生成できるため、より正確で関連性の高い修正を、より速く得られます。
CodeReduceのプロセスは、次のステップで構成されています。
セキュリティ問題を特定する
必要なコンテキストを保ちながら、コードを最小限まで絞り込む
CodeReduceで絞り込んだコードをLLMのプロンプトに追加し、修正を生成する
修正を適用する
Snyk Codeのスキャン機能で再確認し、Snyk Agent Fixが脆弱性を修正し、修正によって新たな脆弱性が生じていないことを確かめる
修正を元のコードにMergeBackする
これらをまとめた、自動セキュリティ修正のパイプラインを以下の図に示します。すべての処理はわずか数秒で完了します。これを可能にする追加の最適化については、CodeReduceに関する研究論文をご覧ください。
どのような結果が得られたのか?
これらの課題を解決した後、自動セキュリティ修正の効果を検証する必要がありました。そこで、さまざまなLLMで利用できるベンチマークを作成しました。
CodeReduceを使うモデル(下表の‡印)を対象に、「Pass@𝑘」と「ExactMatch@𝑘」の指標で評価し、TFix、ウィンドウベースのモデル、GPT-3.5やGPT-4などの大規模コンテキストモデルをベースラインとして比較しました。
「Pass@k」の「k」は、生成された5つの修正のうちいくつ(少なくとも1つから5つすべてまで)が、関連するセキュリティ問題を解決し、新たなセキュリティ問題を引き起こさないかを測定します。
また、評価対象として、セキュリティ問題を5つのカテゴリーに分類しました。
AST:専用のデータフロー解析は必要とせず、抽象構文木を必要とする脆弱性
Local:受け付けない値がメソッドに渡される問題
FileWide:シグネチャまたは実装に関する問題
SecurityLocal:APIの使用状況やメソッド呼び出しの追跡に関する問題
SecurityFlow:複雑なデータフローを必要とする、複雑な汚染解析
比較対象として、StarCoder、Mixtral、T5、GPT-3.5、GPT-4など、さまざまなLLMも選定しました。結果は次のとおりです。
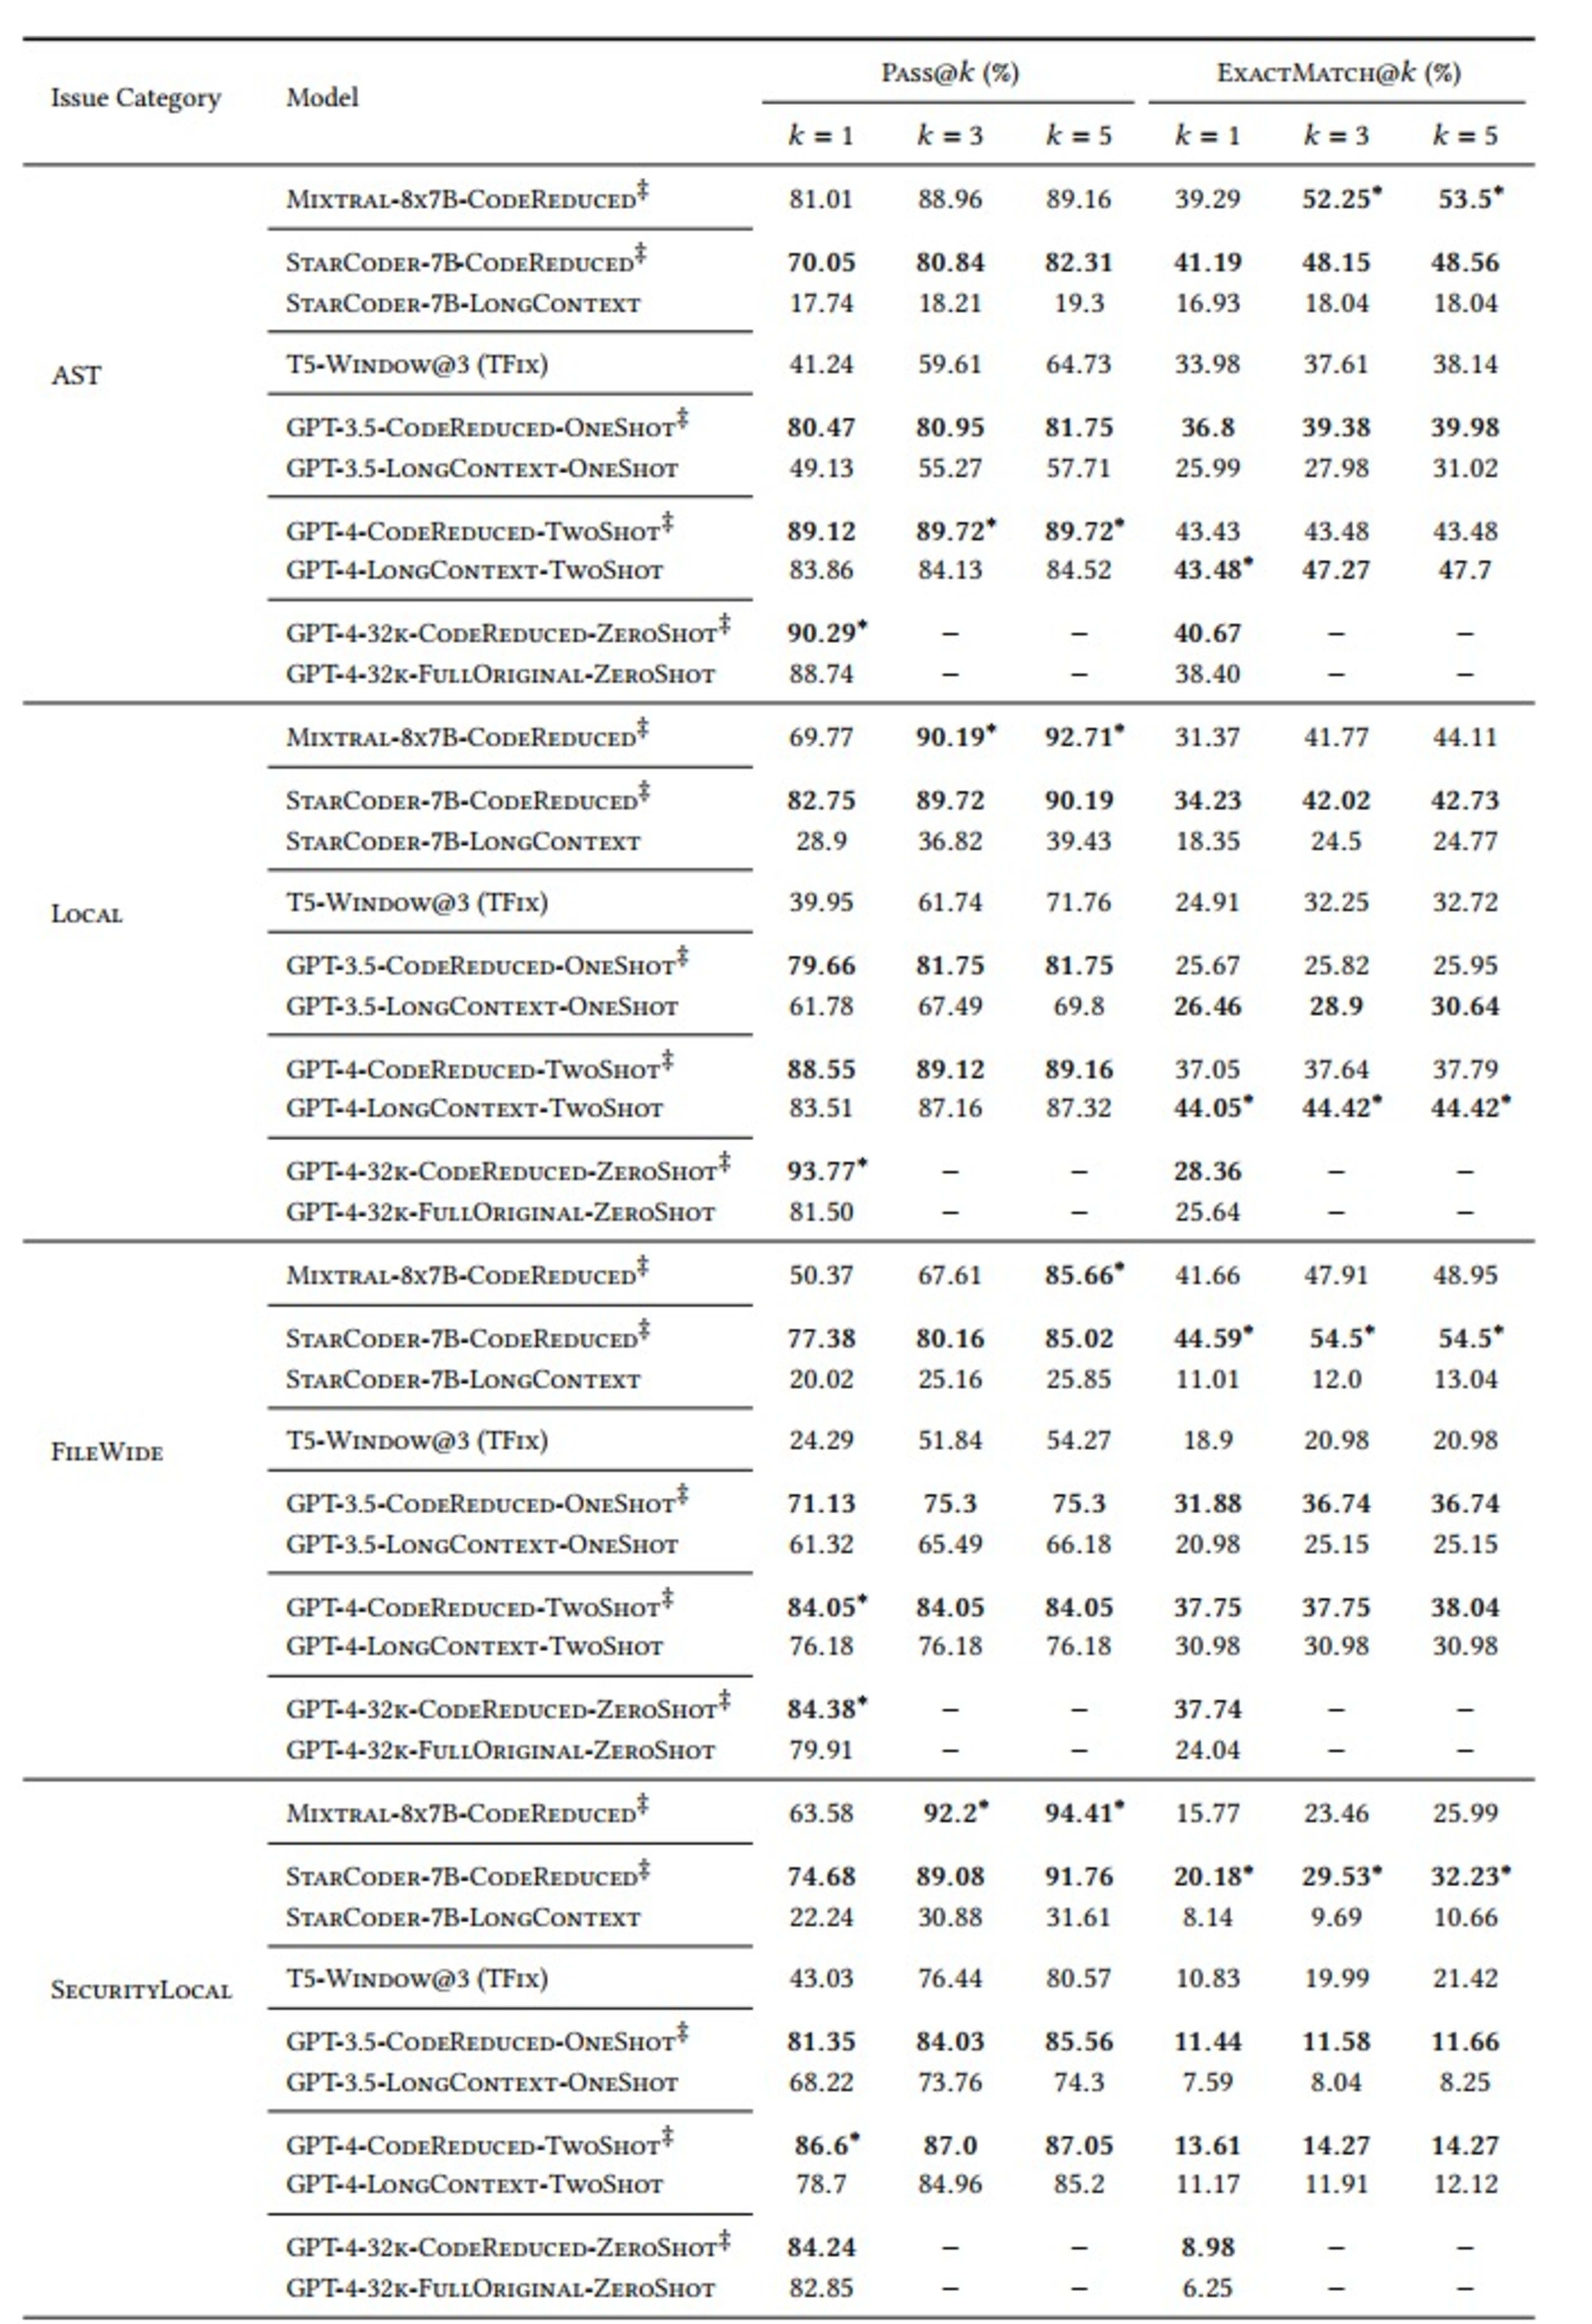
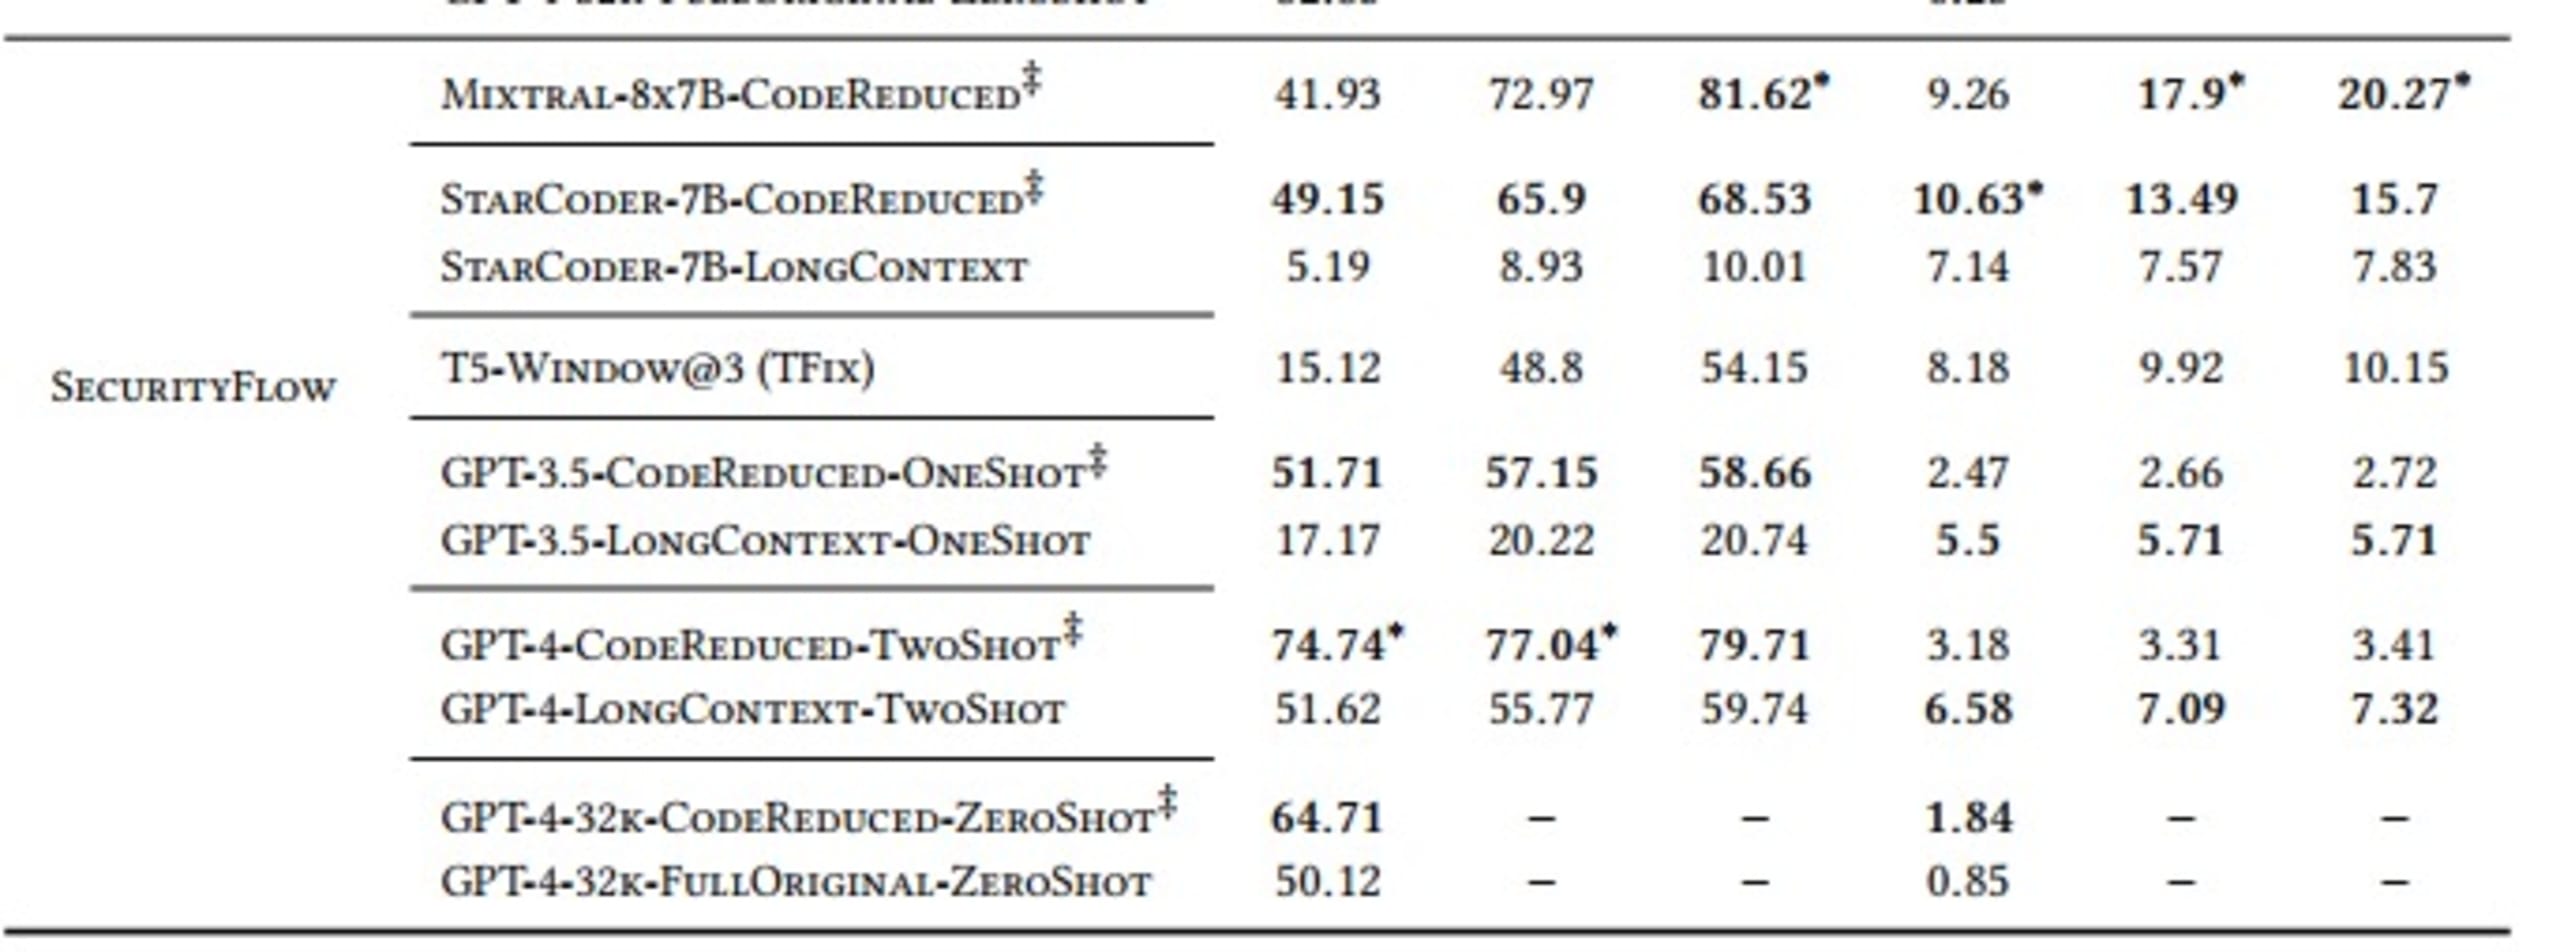
表が示すように、通常なら正確な修正に必要な複雑な長距離依存関係を学習するモデルは、CodeReduceで抽出したコードコンテキストを使うと、CodeReduceを使わずに修正を生成する場合より大幅に高い性能を発揮します。たとえばStarCoderでASTの問題を修正する場合、Pass@5の成功率はCodeReduceなしでは19.3%でしたが、CodeReduceを使うと82.31%に向上しました。
主なポイント
総じて、Snyk Agent FixはTFixが確立した従来の最先端ベースラインを上回り、さまざまな設定で複数の人気AIモデルの性能向上にも貢献しました。これは、Snyk Agent FixがSnyk独自のCodeReduceテクノロジーを通じてプログラム解析を活用し、長距離依存関係やデータフローに対処しているためです。注目すべき範囲を絞ることで、関連するセキュリティ問題を学習するタスクが大幅に簡素化され、より正確で関連性の高い修正を実現します。
Snyk Codeに登録し、Snyk Previewの設定で「Snyk Code Fix Suggestions」を有効にすると、IDEでSnyk Agent Fixの強力な機能をお試しいただけます。詳細はドキュメントをご覧ください。また、Snyk Codeで修正へのフィードバックをお寄せいただくことで、Snyk Agent Fixの今後の開発にご協力いただけます。
Capture the Flagを始めよう
オンデマンドのバーチャル入門ワークショップを見て、Capture the Flagの課題の解き方を学びましょう。