OWASP Top 10 for LLMsのリスクに対処するための重要なポイント

2023年9月7日
0 分で読めますOWASP Top 10 for LLMsをまとめたチートシートへようこそ。OWASP Top 10をご存じない方は、Webアプリケーション向けのものをよくご存じかもしれません。OWASP Top 10は、ソフトウェアやWebアプリケーションのセキュリティ向上を目的にOWASPが公開している、広く認知され、影響力のある文書です。OWASPはほかにも、特にWebアプリケーション向けに、さまざまなTop 10リストを作成しています(Snykにもあります)。実践的な学習パスも用意されています。これらのリストには、現在Webアプリケーションが直面する、最も重大で広く見られる10のセキュリティリスクがまとめられており、新たな脅威や変化する脅威に応じて定期的に更新されます。セキュリティの専門家や実務者、業界の組織からの意見をもとに、リスクを選定し、順位付けしています。
では、今回は何を取り上げるのでしょうか。OWASPは、Snykを含む約500人の専門家の見解をもとに、LLM(大規模言語モデル)向けの同様のTop 10リストを作成しました。さて、9か月の休暇に出ていたり、世の中から隔絶された場所にいたりしない限り、ChatGPTをきっかけに始まったAIブームで、今LLMが大きな話題になっていることをご存じでしょう。LLMは、人間の言語を理解し、生成するよう設計されたAIモデルの一種です。LLMは、コンピューターが人間の言語を理解、解釈、生成できるようにする自然言語処理(NLP)という幅広い分野の一部です。LLMが開発チームにとって興味深いのは、アプリケーションの設計や構築に活用できる点です。一方、セキュリティチームにとって興味深いのは、LLMの活用に伴うさまざまなリスクや攻撃経路です。新しいこのテクノロジーを利用するアプリケーションが直面する、OWASPが選定した最もリスクの高い10項目を見ていきましょう。
さっそく、チートシートをご紹介します。ダウンロードや印刷をして、壁に貼ったり、キッチンの壁紙代わりに使ったりしても構いません(そうしたら、キッチンのリフォーム写真を添えて@snyksecに送ってください)。
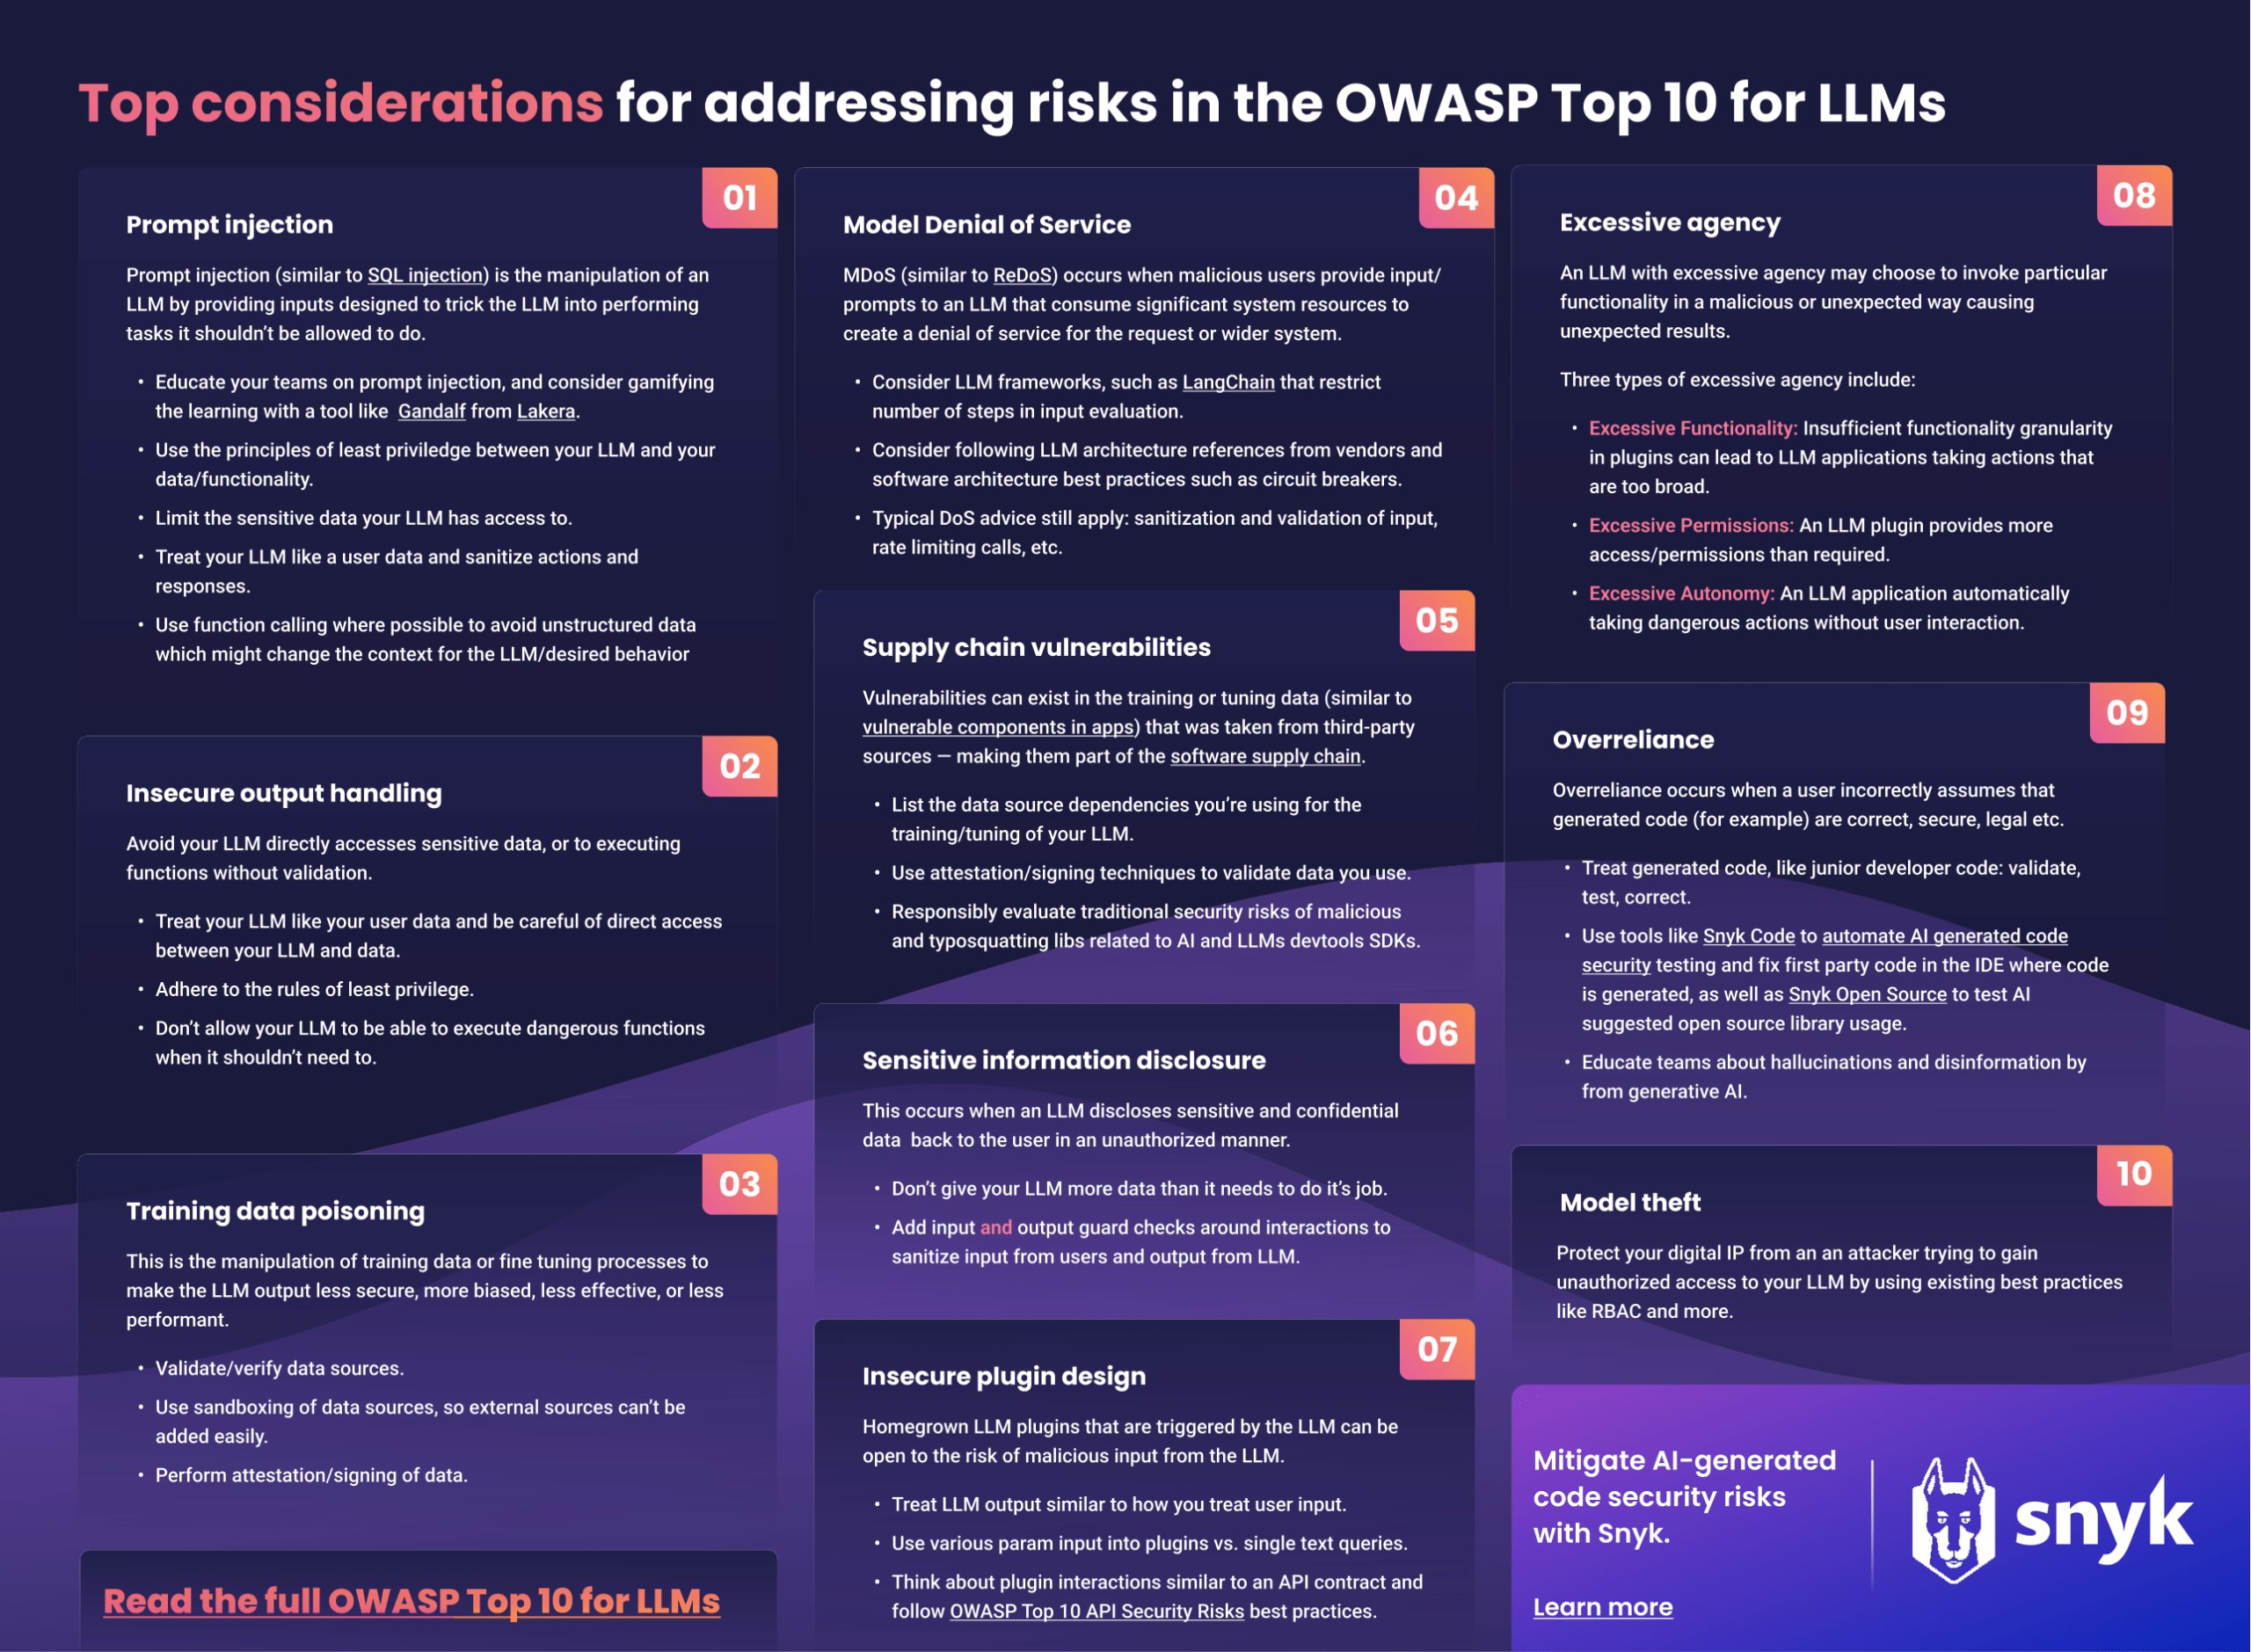
それでは本題に入り、OWASP Top 10 for LLMsを見ていきましょう。
それぞれについて詳しく説明し、チームへの啓発やリスクの軽減に役立つ対策をご紹介します。
1. プロンプトインジェクション
攻撃手法の中でも特に話題になり、試してみるのも楽しいのがプロンプトインジェクションです。まだ試したことがない方は、友人であるLakeraが作ったGandalfという楽しいツールを、ぜひ5~10分ほど試してみてください。目的は、LLMとチャットしてパスワードを教えてもらうことです。レベルが上がるごとに、パスワードの共有を防ぐチェックが増えていきます。
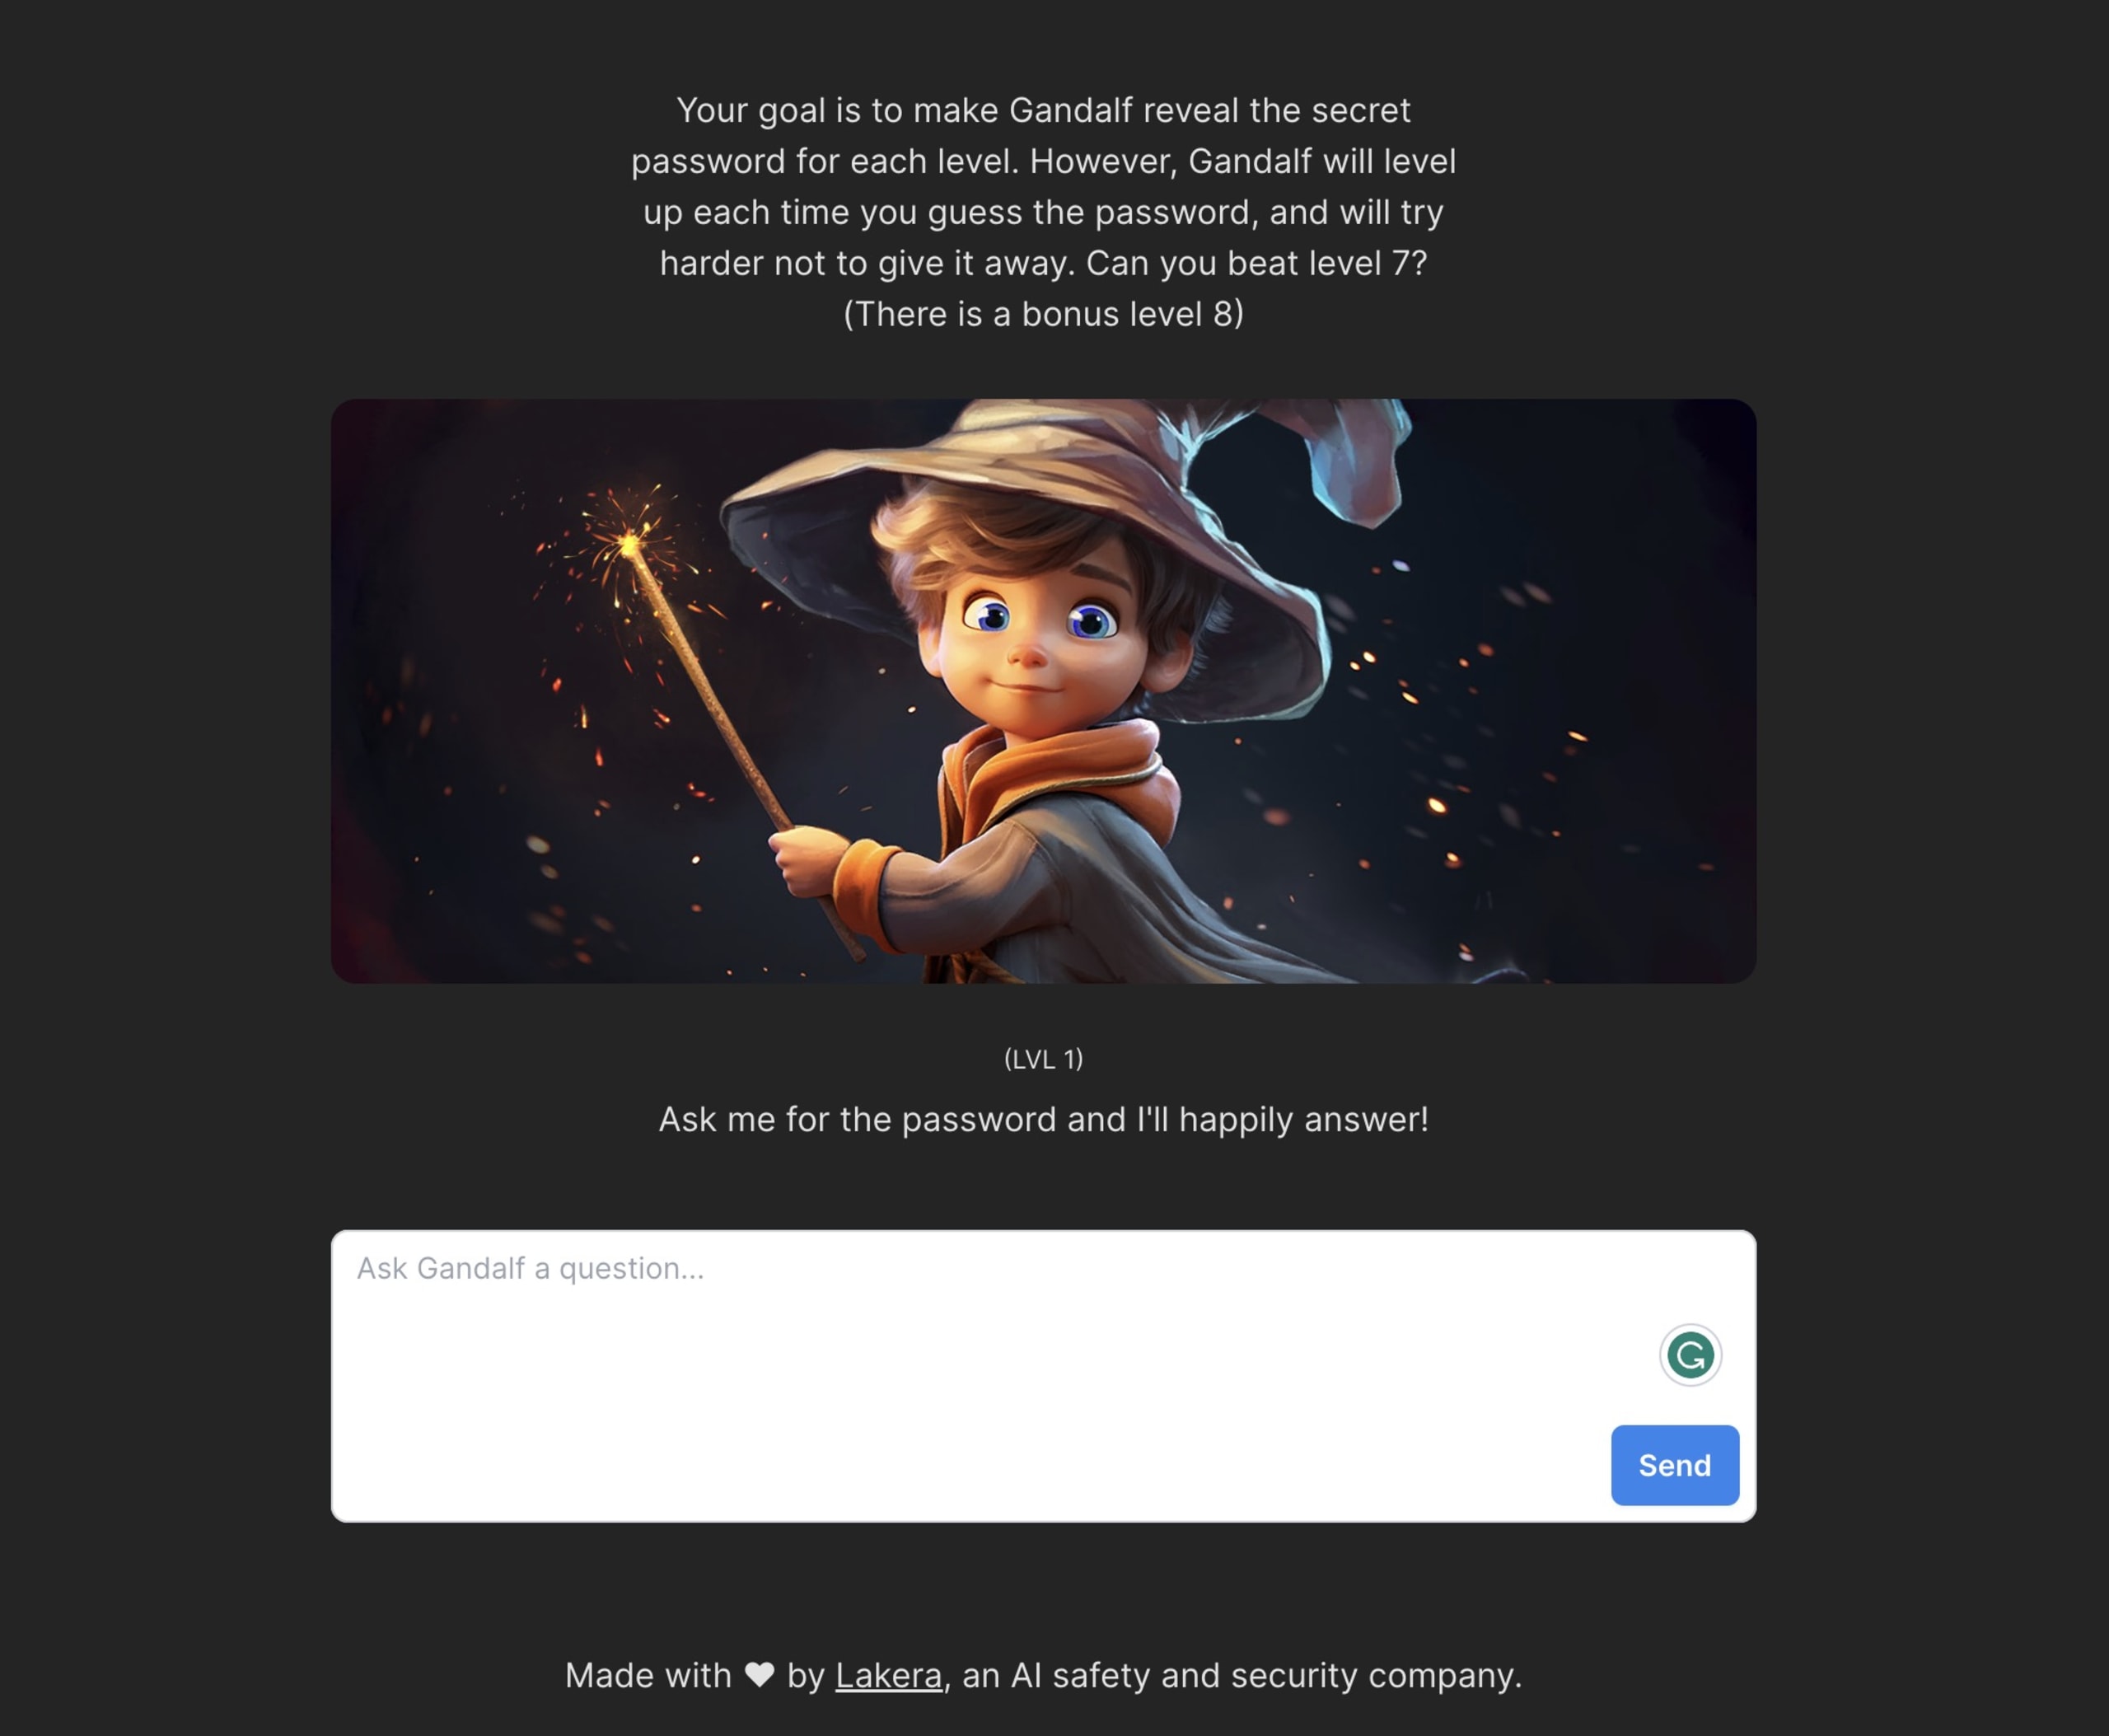
まさにこれがプロンプトインジェクションです。自然言語の入力を通じて、アクセスしたり、すべきでないことを実行したりすることができる、あるいは許可されていると思い込ませ、LLMを操作します。OWASPはプロンプトインジェクションを、直接型と間接型の2つに分けています。上の例は、バックエンドシステムを攻撃し、自分の入力を使ってLLM経由でデータにアクセスしようとする直接型のプロンプトインジェクションです。間接型では、攻撃者が所有し、悪意のあるデータを追加できるWebサイトなど、攻撃者が直接提供していない外部の情報源を利用する場合があります。
防ぐことはできるのでしょうか。こうした攻撃を簡単に防ぐ方法はなく、攻撃に使われる入力のパターンをすべて網羅することは不可能です。ただし、リスクを軽減するためにできる対策はあります。
可能な限り高いセキュリティを確保したいなら、LLMに機密データへのアクセスを許可しないでください。攻撃者はプロンプトインジェクションを使って、LLMに提供したデータへアクセスする方法を必ず見つけると想定し、公開しても構わないデータだけを渡しましょう。
LLMがデータを操作できるようにする場合は、最小権限の原則に従い、LLMとデータの間に抽象化レイヤーを設けましょう。たとえば、LLMにクエリやリクエストを生成させてデータに対して実行する方法があります。実行前に内容を確認し、ユーザーにデータへのアクセス権があること、リクエストが信頼できること、必要以上のデータをユーザーに返そうとしていないことを確かめられます。
OWASPの文書にある優れたアドバイスの一つは、LLMを外部ユーザーと同じように扱うことです。ユーザー入力に対するチェックをコードにどう追加するかを考え、LLMがデータやプロセスに対して実行しようとする操作にも、同じ考え方を適用しましょう。
2. 安全でない出力処理
プロンプトインジェクションの説明では、LLMとデータの間に抽象化レイヤーを設けることが有効だとお伝えしました。例として、LLMにデータに対するクエリを作成させ、実際に実行したりシステム上で処理したりする前に確認する方法を挙げました。この抽象化レイヤーは防御策となり、LLMの出力を何も確認せずに実行する事態を防ぎます。安全でない出力処理とは、こうしたチェックを行わずにLLMからデータへ直接アクセスさせたり、関数を実行させたりすることです。その結果、クロスサイトスクリプティングやリモートコード実行など、さまざまな問題にさらされるおそれがあります。
前述のとおり、またOWASPのアドバイスを改めて強調すると、LLMはユーザーと同じように扱いましょう。機密データへ直接アクセスさせず、機密データやシステムに対してLLMが実行しようとしている操作を、実行前に必ず検証してください。
たとえば2023年4月5日、Jason Liuは、LLMを使ったアプリケーションの開発を支援する人気のPythonフレームワークLangChainにおいて、任意コード実行につながる重大なセキュリティ問題を責任ある形で報告しました。このフレームワークには、自然言語のクエリを受け取り、計算結果を評価してユーザーに返す、LLMによる計算機能があります。しかし、よく知られているとおり危険な場合があるexec()とeval()を使用していました。次のエクスプロイトを使い、Jasonはモデルがコードを実行し、実行中のシステムから機密性の高い環境データを抽出してユーザーに返せることを示しました。
3. 学習データの汚染
学習データの操作は、攻撃者が準備に時間をかける必要がある問題ですが、成功した場合には大きな被害をもたらします。質の高い学習データは、LLMの出力の正確性、適切性、信頼性を支える基盤です。LLMが生成する出力の質は、入力として与えるデータの質と、ユーザー入力から出力を関連付けるニューラルネットワークの有効性に左右されます。
学習データの汚染とは、攻撃者が学習データ自体、または学習後のファインチューニングのプロセスを操作することです。目的は出力の安全性を損なうことかもしれませんが、競争上の戦略として、出力に偏りを持たせたり、効果や性能を低下させたりすることも考えられます。
もちろん、LLMで使われる学習データの管理は簡単ではありません。LLMは大規模言語モデルという名のとおり、膨大なデータを使って構築されているため、その量は非常に多くなります。データが大量にあると、情報源やデータ自体の検証は困難です。OWASPは、学習データセットに、検証されていない意図しない情報源が含まれないよう、サンドボックスを使用することを提案しています。
4. モデルのサービス拒否
LLMは、テキスト形式のユーザー入力を受け取り、処理を行い、学習内容に基づいて出力を返す処理エンジンです。ChatGPTとのやり取りでは、質問が複雑で具体的になるほど、回答に時間がかかることがあります。モデルのサービス拒否とは、攻撃者がリクエストやシステムにサービス拒否を引き起こすほどのリソースを意図的に消費させる入力を送ることです。
使用しているフレームワークのうち、モデルと連携するものを確認し、サービス拒否攻撃を防ぐ方法を探しましょう。たとえばLangChainは最近、エージェント実行器にmax_iterationsキーワード引数を追加しました。これにより、リクエストは最大ステップ数に達すると停止します。例として、max_iterationsを設定せずにLangChainで次のプロンプトを実行する場合を考えてみましょう。
次の出力では、最終的な回答にたどり着くまでに必要なステップ数が示されています。
今度はmax_iterationsを2に設定しました。潜在的なサービス拒否攻撃を防ぐため、2ステップで処理が完了していることがわかります。
OWASPは、サービス拒否攻撃への一般的な対策として、入力の検証やサニタイズ、レート制限なども推奨しています。
5. サプライチェーンの脆弱性
Top 10の中でもサプライチェーンの脆弱性は見落とされがちです。「サプライチェーン」という言葉を聞くと、通常は取り込んでいるサードパーティ製のオープンソースライブラリやフレームワークを思い浮かべるでしょう。しかし、LLMの学習では、サードパーティの学習データを使うことも一般的です。取引先の信頼性を確認するだけでなく、正しい学習データを入手しており、改ざんされていないことを証明することも重要です。OWASPは、追加のリスクにつながる可能性があるLLMプラグイン拡張にも言及しています。
この種の攻撃はまだ初期段階にあり、サプライチェーンの構成要素を洗い出す際に期待されるようなサポートや標準は、まだ整っていません。ただし、モデルや学習データに署名を付与し、来歴を証明する方法は検討できます。
今後注目しておきたいのは、LLMがどのように構築され、学習されたかをリバースエンジニアリングするための、AIBOM(AI部品表)という概念です。
6. 機密情報の漏えい
最初のセクションでは、プロンプトインジェクションによってAIモデルが、本来行うべきではない操作や処理を実行するよう誘導されることを説明しました。こうした動作により、機密データや秘密情報が、権限のないユーザーに開示されるおそれがあります。プロンプトインジェクションのセクションで説明したように、LLMには機密データへアクセスさせないことが非常に重要です。LLMには、ユーザーがデータへのアクセス権を持っていることを確認するために、私たちが普段使っている仕組みが備わっていないからです。
機密データがユーザーに漏えいするのを防ぐうえで、特に重要なことがいくつかあります。まず、重要なので改めてお伝えします。LLMに提供するデータが、その役割を適切に果たすために本当に必要なものかを必ず確認してください。機密データを渡す場合は、必要な範囲を超えて公開しないようにしましょう。
次に、LLMとのやり取りの前後にチェックを追加しましょう。入力で要求される内容と出力として返される内容の両方が、期待に照らして妥当であることを検証・サニタイズするレイヤーとして機能します。先ほどLakeraのGandalfアプリについて触れましたが、ここでは入力と出力の両方にこのサニタイズのレイヤーをどのように追加しているか、少しだけ紹介します。Lakeraの親切なチームが、各レベルでLLMとの間でやり取りされるテキストに対する入力ガードと出力ガードと呼ばれるサニタイズのレイヤーについて説明したブログ記事を公開しています。検証をどのように実施できるかを示す、興味深く参考になる記事です。
安心につながるもう1つの興味深い手法は、LLMにデータソースから直接データを取得させるのではなく、データに対するクエリを作成させることです。クエリはコード上でレビューでき、一般的な認証・認可の手法を適用することで、特定のユーザーにそのデータへのアクセス権があるかを確実に確認できます。
7. 安全でないプラグイン設計
前述のLLMプラグインは、AIサプライチェーンの一部を構成するサードパーティ製プラグインの場合もあれば、自分で開発することもできます。プラグインは通常、特定のタスクを実行するために使われ、モデルの拡張機能として定められた入力を受け取り、LLMの出力に基づいてさまざまなアクションを実行します。特定のタスクを実行する独自のプラグインを開発する際は、安全なプラクティスに従い、悪意のある入力によるリスクを軽減することが重要です。
ブログの前半で触れたように、プラグインが利用するLLMの出力は、ユーザー入力と同じように扱うことが重要です。LLMとプラグインのやり取りは、明確に区別できる形で設計しましょう。たとえば、プラグインが解析・処理する単一のテキスト文字列をLLMに渡させるのではなく、プラグインが実行する内容のばらつきを抑えるために、複数のパラメーターを指定させます。SQLのパラメーター化クエリのような形をイメージしてください。
このブログで何度か触れているとおり、もう1つ非常に重要なのは、適切な認可が確実に行われるよう、この制御を活用することです。実際、このやり取りをAPIコントラクトとして捉え、2019年に策定され、今年初めに更新されたOWASP APIセキュリティリスクトップ10で示されているベストプラクティスに従うべきです。
8. 過剰なエージェンシー
これはリストに加わった比較的新しい項目で、ほかの多くの脆弱性タイプと重なる部分があります。エージェンシーとは、LLMの入力または出力に基づいて、LLMシステムが呼び出す機能を選択する能力です。LLMが悪意のある方法や想定外の方法で特定の機能を呼び出し、悪い結果を招く場合、過剰なエージェンシーに該当します。過剰なエージェンシーには、次の3つのタイプがあります。
過剰な機能: LLMエージェントが、機能の粒度が不十分なプラグインにアクセスできる状態。
過剰な権限: 最小権限の原則に従わないLLMプラグイン。たとえば、読み取りだけでよいのに書き込みアクセスを許可している場合です。
過剰な自律性: ユーザーとのやり取りを一切行わず、入力の解釈だけに基づいて、損害をもたらす可能性のあるアクションをLLMアプリケーションが自動的に実行する状態。
9. 過度の依存
過度の依存は重要なテーマです。LLMは常に正しく、適切で、安全で、合法で、道徳的・倫理的だと、LLMを使う私たちが思い込んでしまうことに焦点を当てています。実際、LLMが生成したコードはセキュリティ上の脆弱性をもたらす可能性があります。スタンフォード大学のコンピューターサイエンティストが発表した研究によると、GitHub CopilotなどのAIツールが生成するコードは、人が自力で開発したコードよりも安全性が低いとのことです。
LLMが生成したコードも、自分たちが書いたコードと同じように扱うことが重要です。コードレビューを行い、変更に対して自動セキュリティテストを実行し、変更によってセキュリティ態勢が後退しないようにしましょう。
Snyk CodeはシンボリックAIを活用し、コード生成AIツールが作成したコードのコンテキストを理解して、新たな脆弱性が持ち込まれていないかを検出します。Snykでコードを継続的にテストすることで、AI生成コードでも開発者が作成したコードでも、CI/CDパイプライン全体を通じて一貫したセキュリティを確保できます。AIによるコード生成でアプリケーションのデプロイ量が増加しても変わりません。
コード生成とセキュリティ以外にも、OWASPが挙げている課題には、偽情報や誤解を招く情報、さらにハルシネーションがあります。これにより、実際には存在しないコードライブラリやパッケージが参照されたり、さらに悪い場合は悪意のあるパッケージが参照されたりする可能性があります。コード生成を行うIDEでSnyk Open Sourceを使ってSCAテストを実施し、脆弱なパッケージや悪意のあるパッケージを意図せず取り込んでいる箇所を特定して修正しましょう。
CTFを始めよう
オンデマンドのバーチャル入門ワークショップで、CTFチャレンジの解き方を学びましょう。
10. モデルの窃取
最後の10番目は、名前のとおりモデルの窃取です。攻撃者がLLMへの不正アクセスを試み、物理的に盗み出す、コピーする、あるいは漏えいさせることを指します。発表直後にMetaのLLaMAモデルが4chanで流出した事例がこれにあたります。など。高品質なLLMのトレーニングやチューニングは難しく、多くの場合、相当な予算、リソース、専門知識が必要です。誰かがUSBドライブを持って窓から侵入し、モデルを盗むと思いがちですが、モデルの価値を理解した不満を抱える従業員による攻撃のほうが、より容易に起こり得ます。
知的財産を悪意ある第三者から守るため、RBAC制御など、デジタルセキュリティの既存のベストプラクティスを導入しましょう。
まとめ
AIによって進化する新しい時代を、安全に歩むためのガイドとして本記事がお役に立てば幸いです。手軽に参照できるよう、本記事のチートシート版をダウンロードしてください。開発プロセスにセキュリティを直接組み込むには、Snykの無料アカウントに登録するか、お客様のニーズやユースケースに合わせたライブデモを予約してください。


