「バイブコーディング」という言葉の広まり

0 分で読めます
Andrej Karpathyは、人工知能(AI)分野で輝かしい経歴を持つスロバキア系カナダ人のコンピューター科学者です。Teslaの元AIディレクターであり、OpenAIの共同創業者でもある彼は、2025年2月に「バイブコーディング」という言葉を初めて使いました。ディープラーニングやコンピュータービジョンにおける豊富な経験に加え、スタンフォード大学初のディープラーニング講座「CS 231n」の主任講師を務めた経歴から、AIコミュニティで信頼される存在となっています。
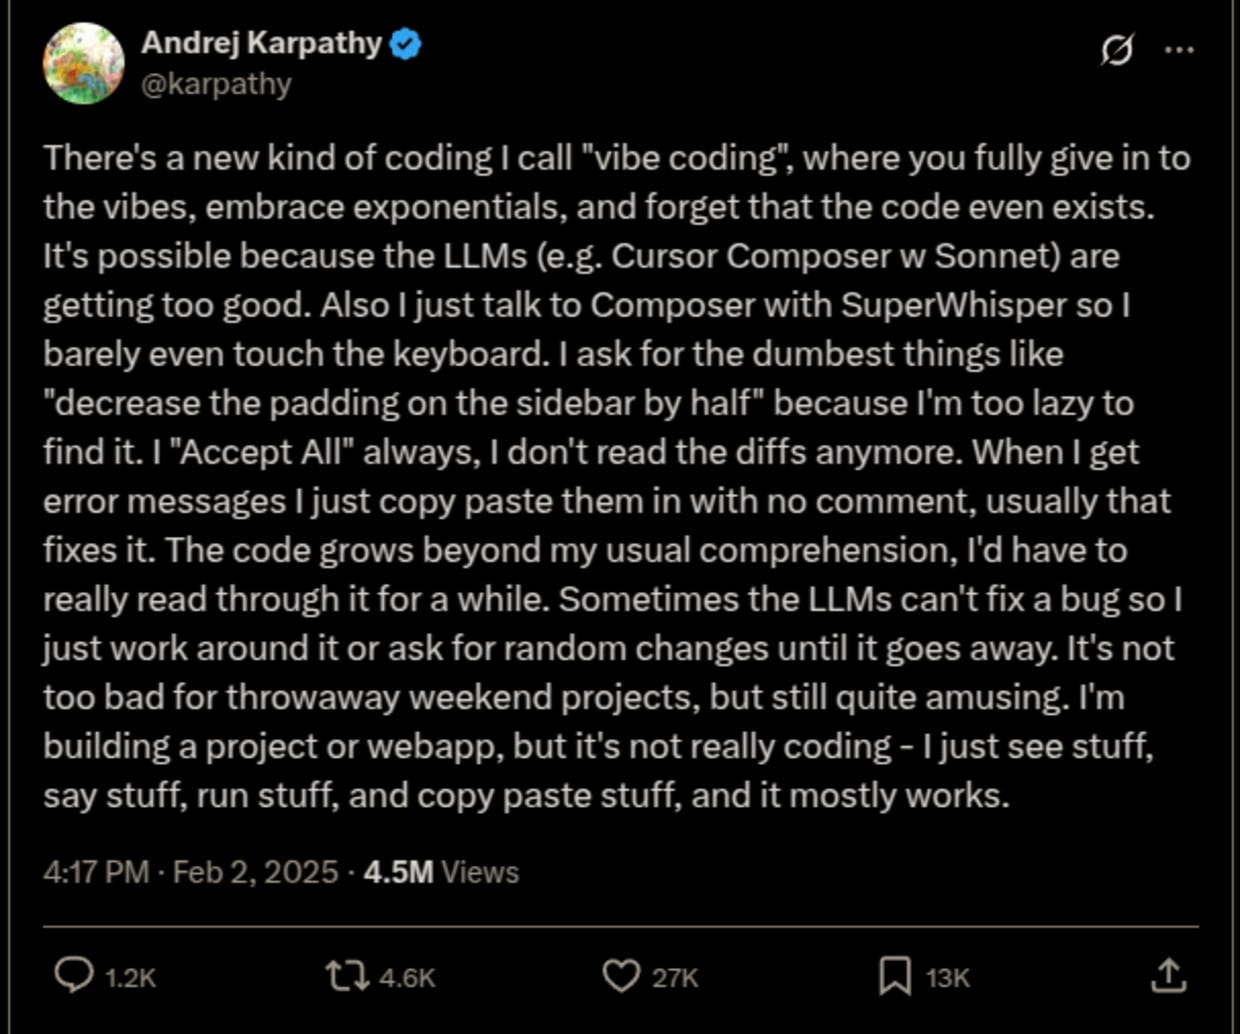
2025年2月2日、KarpathyはX/Twitterに投稿し、「バイブコーディング」と名付けた新しいアプローチについて説明しました。それは、開発者が「完全にノリに身を任せ、指数関数的な進化を受け入れ、コードの存在すら忘れる」というものです。これは、テック業界のリーダーによる単なる目新しい意見ではありません。多くの開発者がすでに経験しながらも、まだ名前のついていなかったことを明確に言い表したものでした。
Karpathyは自身のワークフローを説明しています。SuperWhisperを使った音声指示でキーボード操作を最小限に抑え、UIの調整など簡単なリクエストを行い、提案された変更を差分を精査せずに毎回すべて受け入れます。エラーが起きた場合は、エラーメッセージをそのままAIにコピー&ペーストします。このアプローチでは、コードが「自分の通常の理解を超えて」増えていき、バグ修正も「問題が消えるまで回避策を試したり、何となく変更を加えたりする」ことになる場合があると認めています。
バイブコーディングとは?
バイブコーディングとは、意図的に肩の力を抜いたソフトウェア開発のアプローチです。開発者は(正式な経歴や教育、経験のない人も含めて)AIアシスタントを使い、生成されるコードをほとんど確認したり理解したりせずにコードを書きます。変更を一つひとつ慎重にレビューするのではなく、AIの出力を信頼し、提案された修正をまとめて受け入れ、エラーメッセージを自分でデバッグする課題ではなく、AIに返す入力として扱います。これは本質的に悪いことではありません。より多くのコードが書かれ、技術に詳しくない人にも開発プロセスが開かれていくのは、素晴らしいことです。
コードそのものはほとんど二の次になり、アプリケーションが動いているように感じられるかどうかが重要になります。コードを理解するのではなく「ノリ」でプログラミングし、コードレビュー、テスト、コードベースの全体像を把握することといった従来のソフトウェアエンジニアリングの実践より、スピードと反復を優先します。極端な場合、バイブコーディングでは、コードの大半がどう動くのかを説明できないアプリケーションを作ることになります。自分で書いたわけでもなく、きちんと読んでもいないからです。
あらゆるところに広がる
「バイブコーディング」はインターネットの速さで瞬く間に広まりました。数時間以内にReplitのCEO、Amjad Masadが反応し、Replitのユーザーの約75%がすでに自分でコードを書かずにコーディングしていると指摘しました。Karpathyが新しい手法を発明したというより、すでに広く行われていたことに名前をつけたのだという見方を示したのです。
2月12日までに、「バイブコーディングの15のルール」を紹介する@rileybrown_aiによるXのスレッドが1万件を超える「いいね」を獲得しました。テックコミュニティは一気に盛り上がり、ミームや論考、熱い意見が猛烈な勢いで生まれました。Xユーザーの@IterIntellectusが、バイブコーディングを題材にRick Rubinのヘッドホンのミームを作成すると、3,000件以上の「いいね」を獲得。音楽制作における直感とノリを重視することで伝説的な存在となったRubinは、バイブコーディングの非公式な「顔」となりました。ぴったりの人選です。
2月13日には、Business Insiderが「シリコンバレーの次なる挑戦:「バイブコーディング」を世界へ」を掲載し、この概念を大手テックメディアが初めて取り上げました。The New York Timesも2月27日に続き、Kevin Rooseによる「コーダーでなくても大丈夫?AIがあれば、アイデアだけで十分」という記事を掲載しました。
2月24日、Gitpodは「『バイブコーディング』は楽観的なクリエイターのための革命」を公開。バイブコーディングを「楽観主義の象徴であり、これから押し寄せる大きな波」と呼び、AI Engineering Summit向けに「バイブコーディング」のステッカーを実際に制作したと伝えました。
一般にも受け入れられたことを最もよく示す出来事は、おそらくこれでしょう。3月1日までにMerriam-Websterが「バイブコーディング」をスラングとして掲載し、「AIの支援を受けて、やや不注意にコンピューターコードを書くこと」と定義しました。ツイートから辞書掲載まで、わずか1か月足らず。単なるバイラル現象ではなく、文化的な出来事だったのです。
Y CombinatorのCEO、Garry Tanは、2025年冬のバッチに参加したスタートアップの25%で、コードベースの95%以上がAIによって生成されていたと報告しました。これは単なる遊びではなく、この手法で会社全体が作られていたことを示しています。
しかし、熱狂が高まるにつれて、警鐘を鳴らす話も増えていきました。2月中旬までに、Xユーザーの@Brycicle77が、あるRedditの投稿を再び取り上げました。そこには、「CursorとClaudeだけで作ったプロジェクト」が手に負えなくなったと嘆くユーザーの姿がありました。「Pythonファイルが30個以上、コードは整理されておらず、ループは重複……Claudeはインポート文を何度も忘れる」。投稿には皮肉を込めて「バイブコーディングとその結果」と添えられていました。
でも、本当にノリだけでコードを書けるの?
安全には書けません。
ここでノリは壁にぶつかります。開発者が変更をすべて受け入れ、エラーメッセージをコピー&ペーストしている間に、深刻なセキュリティ脆弱性が本番環境のコードベースに積み重なっていました。
セキュリティ研究者が記録した、よく知られた事例では、ある開発者がAIを使ってSaaSアプリの土台を作りましたが、気づかないうちにOpenAIのAPIキーをクライアント側のコードに露出させていました。攻撃者は数分以内に流出したキーを見つけ、開発者は「請求を免除してもらうためにOpenAIと交渉しなければならなかった」といいます。ノリで作るには、高くつきました。
バイブコーディングで作られた複数のプロジェクトで、認証フローに問題が発生しました。あるレビューでは、AIが生成した認証コードがOpenAIのAPIキーを平文でネットワーク経由で送信しており、開発者ツールを使えば誰でも確認できる状態だったことが判明しました。
特に深刻だったのは、AI生成のウェブゲームがバイラルに広まる一方で、重大なクロスサイトスクリプティング(XSS)脆弱性も抱えており、何千人ものユーザーが危険にさらされたことです。開発者はChatGPTの出力を信頼して、アプリを「バイブコーディング」していました。セキュリティ研究者は、コードを無条件に受け入れると、AIコパイロットによってSQLインジェクションやXSSの脆弱性、データ漏えいが引き起こされるおそれがあると警告しています。
あるバイブコーダーは、コミュニティプラグインのAIが推奨したコードを受け入れました。そのコードには入力サニタイズの不備があり、後にサイトでストア型XSSが発生しました。「保守が不十分なWordPressプラグインで見つかった脆弱性」と同じパターンです。
影響は個人のプロジェクトにとどまりません。2025年3月18日、バイブコーディングで特に人気の高いツール、GitHub CopilotとCursorに影響する「ルールファイルのバックドア」脆弱性が発見されました。バイブコーディングそのものを可能にするインフラに存在した、システム全体に関わる脆弱性でした。
傾向は明らかです。バイブコーディングは開発を大幅に加速させますが、セキュリティ脆弱性の混入も同じように加速させます。Wizの調査によると、バイブコーディングのプラットフォーム上で開発を行う組織の5社に1社が、よくある設定ミスによって意図せずリスクにさらされています。
あるセキュリティアナリストは、次のように指摘しています。「AIは、人間なら気づいたはずの重要な認可チェックを見落としていました」。この認証システムはテストでは動作していましたが、重要なロール検証が欠けていたため、悪用可能な管理者権限のバグにつながりました。
根本的な問題は何でしょうか。デプロイするコードを理解していなければ、そのセキュリティ上の影響を評価できません。ノリは最高でも、脅威モデルは存在しないのです。
誰もが使えるバイブコーディングへ
セキュリティ上の懸念はあるものの、ここでは真に革新的なことが起きています。これまでプログラミングに参加できなかった人たちにも、プログラミングが開かれつつあるのです。
長年、ソフトウェア開発を広く普及させる手段として「ローコード」や「ノーコード」プラットフォームが語られてきました。しかし、制約の多いテンプレート、限られた機能、作れるものの上限などが伴うことも少なくありません。一方、バイブコーディングでは、自然言語を通じてプログラミングの力をほぼそのまま活用できます。
キーボードの代わりに音声を使う音声コーディングも、OpenAIのWhisperなどの音声認識技術の進歩を背景に、バイブコーディングとともに大きく広がっています。この2つの融合は、アクセシビリティの面で特に大きな力を発揮します。
音声コーディングツールは、2024年を通じて着実に進化しました。2024年3月には、Y CombinatorのスタートアップであるAqua Voiceが、音声で操作するテキストエディターを公開。「macOSの音声入力よりエラーが7倍少ない」とうたい、音声コーディングへの関心の高まりを示しました。自然な音声でコードを書けて、VS Codeなどのエディターと連携するオープンソースの音声コード変換エンジン、Serenadeなどのツールも大きく成熟しました。
2025年のCSUN Assistive Technology Conferenceでは、AIを使ったコーディングに関するセッションで、運動障害のあるプログラマーが音声コーディングツールを活用し、ソフトウェア開発により深く参加できることが紹介されました。ある登壇者は、SerenadeとGPT-4を使い、音声だけでウェブアプリを作る様子を実演しました。
これは非常に重要なことです。プログラミングは長い間、何時間もキーボードを打ち、精密な手の動きを制御し、複雑なショートカットを操作する、身体的な負担の大きい活動でした。音声インターフェースとAIアシスタントの組み合わせは、RSI(反復性運動障害)や運動障害、その他の理由で従来のコーディングが困難、または不可能な人たちにも道を開きます。
アクセシビリティは身体的な能力だけにとどまりません。構文やライブラリ、開発パターンを知らなくても、自分の望むことを表現できるという、認知面でのアクセシビリティも重要です。解決したい領域の課題を深く理解していても、プログラミングの知識がない人にとって、バイブコーディングはその橋渡しになります。
プロダクトデザイナーやUXリサーチャーにとっての課題は、技術に詳しくないユーザーが安全かつ効果的に使えるインターフェースをどう実現するかです。MicrosoftのPower Platform Copilotでは、自然言語でアプリを作成できます。また、管理者がCopilotに許可する操作を定義できるため、市民開発者が気づかないうちに機密データを公開してしまう事態を防げます。
Salesforceは、テキストで指示を入力し、管理者が自動化フローを作成できるAI Copilotを導入しました。たとえばSalesforceの管理者が「価値の高いリードが作成されたら、シニア営業担当者に割り当てて、メールで通知する」と入力すると、AIがその機能を実装するFlowを生成します。
こうしたプラットフォームは、根本的な問いに取り組んでいます。技術に詳しくないユーザーがソフトウェアを作れる力を与えながら、存在すら知らない危険からどう守ればよいのでしょうか。
そして今度は、自分のために
バイブコーディングには、注目すべきもう一つの側面があります。それはパーソナライゼーションです。
従来のソフトウェア開発は、企業向けソフトウェア、消費者向けアプリ、オープンソースツールなど、他者のためのアプリケーションを作ることを中心としてきました。しかし、自分に合った体験を最速で手に入れる方法が、その場で会話しながら自分で作ることだとしたらどうでしょうか。
Karpathyは、「Battleship」ゲームと「LLM text reader」アプリを、それぞれ約1時間で作ったと報告しています。指示はすべて音声で行いました。これらは配布するための製品ではなく、自分で使うために、自分の好みに合わせて作った個人用ツールでした。
これは、ソフトウェアが調理済みの食事を買うよりも、料理をすることに近づく未来を示しています。既存のアプリの一覧から選び、設定やカスタマイズで自分のニーズに合わせるのではなく、欲しいものを説明すれば、自分のために作ってもらえるようになるかもしれません。
最新世代のAIモデルには、こうした動きの兆しが見られます。GoogleのGeminiは、検索履歴を使って回答をパーソナライズする実験を行っています。モデルは、文脈を理解し、ユーザーが何を重視しているかを記憶し、一人ひとりのニーズに合わせる能力を高めています。
しかし、興味深い一方で、少し厄介な問題もあります。LLMは、モデルに関連するAPIの使い方について、誤ったコードや古いコードを生成することがあります。これは、モデルが自らの重みやアーキテクチャを知っているかどうかという話ではありません。それとは別の問題です。もっと単純で、よりもどかしいのは、ChatGPTのようなモデルが、ある時点までのドキュメントを含む膨大なデータセットで学習していることです。その日付以降にAPIやSDKが変更されても、後から明示的にファインチューニングされない限り、モデルはその変更を知りません。
私自身もこの問題を経験しています。ChatGPTを使ってOpenAI独自のAPI向けコードを書こうとすると、古い構文や非推奨のメソッドが返ってくることがよくあります。2024年11月、OpenAIの開発者フォーラムでは、あるユーザーが次のように不満を述べていました。「GPT-4は、Node.jsで自社APIを使うための古いコードを一貫して生成します。最新のドキュメントへのリンクを渡しても無視して、同じ古いコードを返してきます。」
皮肉なことに、AI企業は対話型インターフェースを通じて誰もがコーディングできるようにしようと競い合う一方で、自社のモデルは急速に進化する自社APIに追いつけずにいます。あるユーザーによると、ChatGPTは今でも、古いバージョンのopenai Nodeライブラリを使ったコールバックや古いパラメーター名の例を表示したり、新しいChatCompletion.createではなく、Completions.createのような非推奨のエンドポイントを使ったりしているとのことです。
興味深いことに、Anthropicが開発したClaudeは、OpenAIのAPI向けコードの生成で、ChatGPT自身より優れていることがよくあります。Claudeの学習データには、より多様な情報源が含まれ、古いOpenAIのドキュメントに過度に偏っていなかったからかもしれません。
モデルがユーザーに合わせて適応しようとする際の根本的な課題が、ここに表れています。モデルは常に、少し古い情報をもとに動作しているのです。知識のカットオフは大幅に改善され(18か月以上から約6〜8か月に短縮され)ましたが、この遅れによって、急速に進化するフレームワークやAPI向けのコードを生成する際には、依然として大きな盲点が生じます。
結局、頼れるのはお互いだけ
少し視野を広げてみましょう。
2022年末にChatGPTが初めて登場したとき、AIがコードを書けることに、人々は信じられない思いでした。英語でプログラムを説明すれば動くコードが手に入るというのは、まるでSFの世界の話のようでした。それから3年も経たない今では、コードをほとんど読まずにアプリケーション全体を「ノリ」で作り上げることの是非を議論しています。
この変化の速さには、本当に戸惑わされます。セキュリティの脆弱性、技術的負債、保守性を損なう問題など、リスクに目が向きがちです。こうした懸念は現実のものであり、深刻です。
しかし、ここでは称賛に値する別のことも起きています。ものづくりに取り組む人が増えているのです。
Y CombinatorのCEO、Garry Tanは、バイブコーディングによって小規模なチームがより多くの成果を上げられると称賛し、AIコーディングツールを使えば「エンジニア10人で100人分の仕事ができる」と述べました。従来のプログラミングを学ぶことのなかったアーティスト、デザイナー、各分野の専門家が、今では実際に動くソフトウェアを作っています。これまでコーディングから遠ざけられていた障害のある人々も、新たな道を見つけています。
もちろん、こうしたプロジェクトの中にはバグがあるものも、セキュリティ上の問題を抱えるものもあるでしょう。コードが乱雑になることもあります。しかし、それは初期のウェブやモバイルアプリ、そしてソフトウェア開発の新たな波が訪れるたびに同じでした。私たちはそこから学び、よりよいプラクティスを確立し、より優れたツールを作ってきました。
次のような見方が広がりつつあります。バイブコーディングは「チートコードのように感じられる……しかし、おもちゃのようなプロジェクトを超えると、厳しい現実に直面する」。これは健全な見方でしょう。バイブコーディングが力を発揮するのは、迅速なプロトタイピング、個人用ツール、週末のプロジェクト、そして探索的な取り組みです。機密データや重要な機能を扱う本番システムには、より厳格な対応が必要です。
開発者やセキュリティの専門家は、AI生成コードに関するベストプラクティスを確立しつつあります。たとえば、AIをジュニア開発者のように扱ってコードをレビューすること、静的解析やリンターを実行すること、SnykのDCAIFのようなツールを使って脆弱性を自動的に修正すること、そしてコーディングを始める前にセキュリティ要件をAIに明示することです。
Namanyay Goelは3月27日、「Karpathyの『Vibe Coding』ムーブメントは有害」と題した記事を公開し、コード生成を盲目的に信頼することは「エンジニアリング責任の根本的な崩壊」だと述べました。彼の言うとおりです。ただし、AIコパイロットは責任を持って使えば強力なツールだということも認めています。
ソフトウェア開発の未来では、人間の開発者とAIツールが協力し合うことになるでしょう。バイブコーディングは、その協業の初期段階にあり、多少混沌とした形を表しています。粗削りで、わくわくさせられ、ときには無謀でもあります。そして、これまでなら作れなかったものを人々が作れるようにしています。
Simon Willisonは、「AI支援プログラミングがすべてバイブコーディングというわけではない」とわかりやすく説明し、Copilotのようなツールを日常的に使うことと、Karpathyが提唱する極端な「AIを信頼する」アプローチを区別しました。ここには幅があります。私たちの多くは、AIを使って作業を効率化しながら、理解と監督を保つ中間的な使い方に落ち着くでしょう。
バイブコーディングから得られる本当の教訓は、コードそのものとは関係ないのかもしれません。大切なのは、実験すること、参入のハードルを下げること、完全に理解できていなくても試してみてよいと人々に伝えることです。人々は昔から、例をまねたり、試行錯誤したり、壊しては直したりしながら、コードを学んできました。
AIは、そのサイクルを速めているだけです。
ですから、ノリに任せて作ってみましょう。ただし、少しは注意を払ってください。差分を少なくともいくつかは読み、セキュリティスキャナーを実行し、疑問を持ち、学びましょう。そして、バイブコーディングで作ったプロジェクトに問題が起きても、忘れないでください。結局のところ、本当の学びはデバッグの中にあります。
結局、頼れるのはお互いだけです。人間のために、人間と共につくられた人間とAIが、一緒に答えを見つけていくのです。
オンデマンドワークショップ
バイブコーディングを安全に:AI生成コードのセキュリティ課題に対処する
Snykのスタッフ・デベロッパーアドボケイトであるSonya Moissetが、バイブコーディングのセキュリティへの影響を解説し、AI生成コードを大規模に安全にするための実践的な方法をご紹介します。