Vulnerabilidades alcanzables: cómo priorizar eficazmente la seguridad del código abierto

Krysztof Huszcza
18 de agosto de 2020
0 minutos de lecturaUn problema común que nos reportan nuestros clientes es sentirse abrumados por las vulnerabilidades.
En los proyectos pequeños, podrías terminar dependiendo de decenas o incluso cientos de bibliotecas de código abierto. En las grandes aplicaciones empresariales, podrías sentir que tus dependencias incluyen la mitad del ecosistema. La proliferación de dependencias de terceros trae consigo una proliferación de vulnerabilidades asociadas a ellas. Aunque la mayoría de los desarrolladores aceptan a regañadientes el tamaño de la huella de dependencias de terceros de sus proyectos, lanzar una aplicación con cientos o miles de vulnerabilidades conocidas suele ser inaceptable.
Cuando te abruman las vulnerabilidades que afectan tu aplicación, es razonable preguntarte si realmente se pueden explotar todas. ¿Qué pasa si algunas vulnerabilidades están en código de terceros que tu aplicación nunca ejecuta? En otras palabras, ¿qué pasa si algunas vulnerabilidades nunca son alcanzables desde el código de tu aplicación? Si lo supieras, podrías dar menos prioridad a la corrección de las vulnerabilidades inalcanzables y enfocarte, en cambio, en las alcanzables, es decir, las que realmente te afectan en producción en este momento. De todos modos, eventualmente tendrías que resolver todas las vulnerabilidades, pero al menos sabrías por dónde empezar.
Suena perfecto, pero ¿cómo se determina qué vulnerabilidades son alcanzables y cuáles no? En Snyk, resolvemos este problema combinando investigación de seguridad especializada con análisis estático automatizado. Veamos esta solución con más detalle.
Funciones vulnerables
Primero, veamos la parte de investigación de seguridad, cuyo objetivo es responder una pregunta muy importante: ¿qué código es realmente vulnerable?
Para cada vulnerabilidad, queremos saber qué líneas de código, funciones, clases o módulos de una biblioteca determinada representan un riesgo de seguridad. Esto es fundamental: no podemos afirmar si el código vulnerable es alcanzable sin especificar cuál es ese código. Lamentablemente, las bases de datos de vulnerabilidades disponibles públicamente no proporcionan esta información.
Entonces, ¿cómo se identifica el código vulnerable? Un método que, según hemos comprobado, funciona bien en la práctica es la selección y revisión manual por parte de expertos en seguridad. En Snyk, contamos con un equipo de analistas e investigadores de seguridad que analiza continuamente las vulnerabilidades que afectan a nuestros clientes. Investigan cada vulnerabilidad antes de agregarla a nuestra base de datos y la anotan con metadatos que señalan el código vulnerable.
Para describir qué código es vulnerable, decidimos usar funciones del programa. Para cada vulnerabilidad, almacenamos un conjunto de nombres y firmas de funciones. A veces, estas funciones contienen literalmente el código vulnerable; otras veces, incluyen las funciones que permiten el comportamiento vulnerable. Sin importar cuál sea su relación real con la vulnerabilidad, las llamamos «funciones vulnerables». Las funciones que seleccionamos como vulnerables para cada vulnerabilidad se determinan caso por caso.
Análisis de reachability del grafo de llamadas
Una vez que identificamos las funciones vulnerables de cada biblioteca, debemos determinar si la aplicación las usa. Aquí entra la segunda parte de nuestra ecuación: el análisis estático. Usamos el análisis estático para crear el grafo de llamadas del programa de entrada y luego lo usamos para razonar sobre la reachability de las funciones vulnerables.
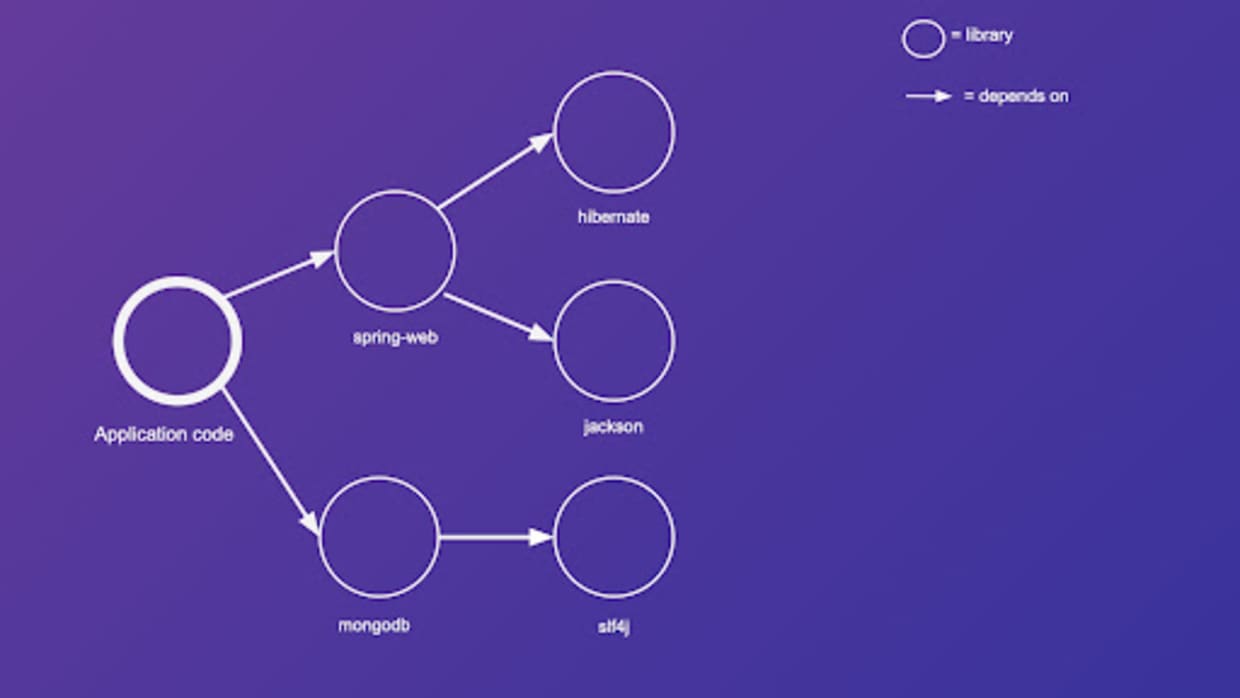
Antes de profundizar en el análisis estático, veamos un ejemplo que ilustra cómo se puede usar un grafo de llamadas para determinar la reachability del código vulnerable. Supongamos que tenemos una aplicación web en Java con dos dependencias directas: spring-web y mongodb. spring-web depende, a su vez, de otras dos bibliotecas: hibernate y jackson. mongodb depende de slf4j. Podemos representar estas relaciones en un grafo de dependencias.
Ahora agreguemos más detalles al grafo considerando las llamadas a funciones. Simplifiquemos mucho nuestros componentes y supongamos que tanto el código de la aplicación como todas las bibliotecas de terceros tienen solo dos funciones, excepto spring-web, que tiene tres. Agreguemos todas las funciones como nodos al grafo y dibujemos una flecha de la función A a la función B si, y solo si, la función A llama a la función B.
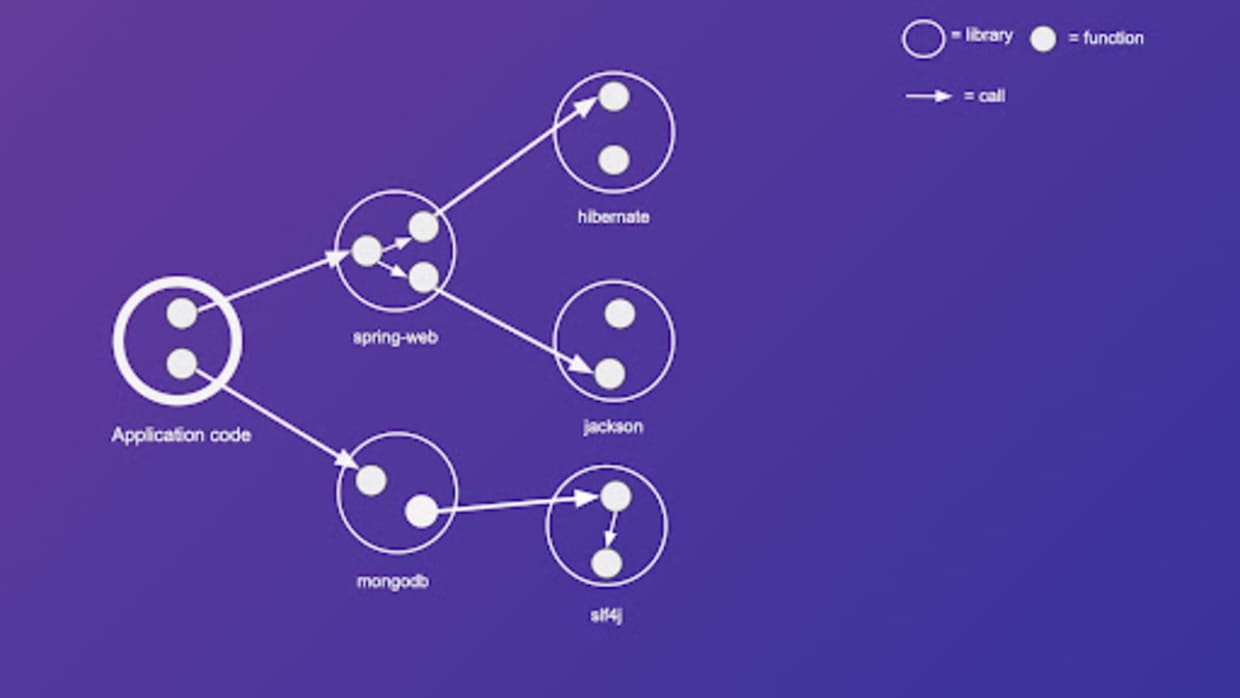
El resultado es una estructura de datos muy conocida llamada grafo de llamadas. Ahora agreguemos las funciones vulnerables al grafo. Para representarlas, usamos un monstruo de las galletas.
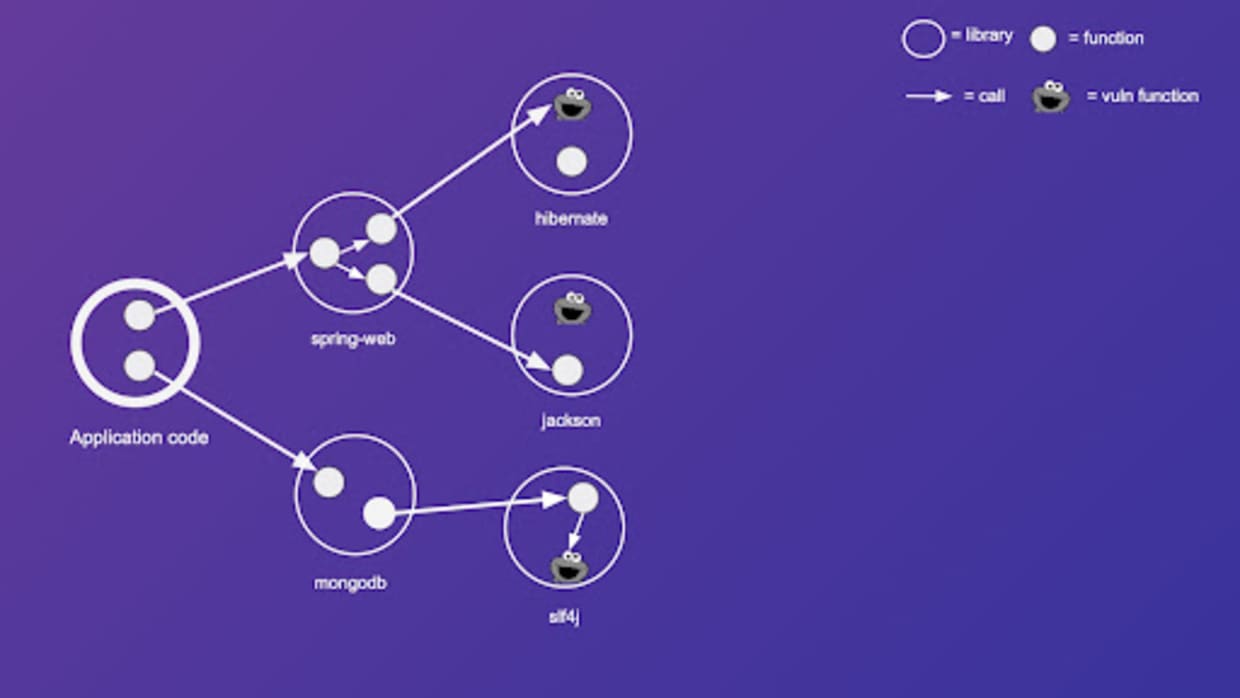
Por último, definamos una regla sencilla de reachability para nuestro grafo de llamadas: decimos que una función X es alcanzable desde el código de la aplicación si, y solo si, existe una ruta en el grafo que empieza en cualquier nodo del código de la aplicación y termina en la función X. Según esta regla, coloreamos de rojo todas las funciones alcanzables y de verde las inalcanzables.
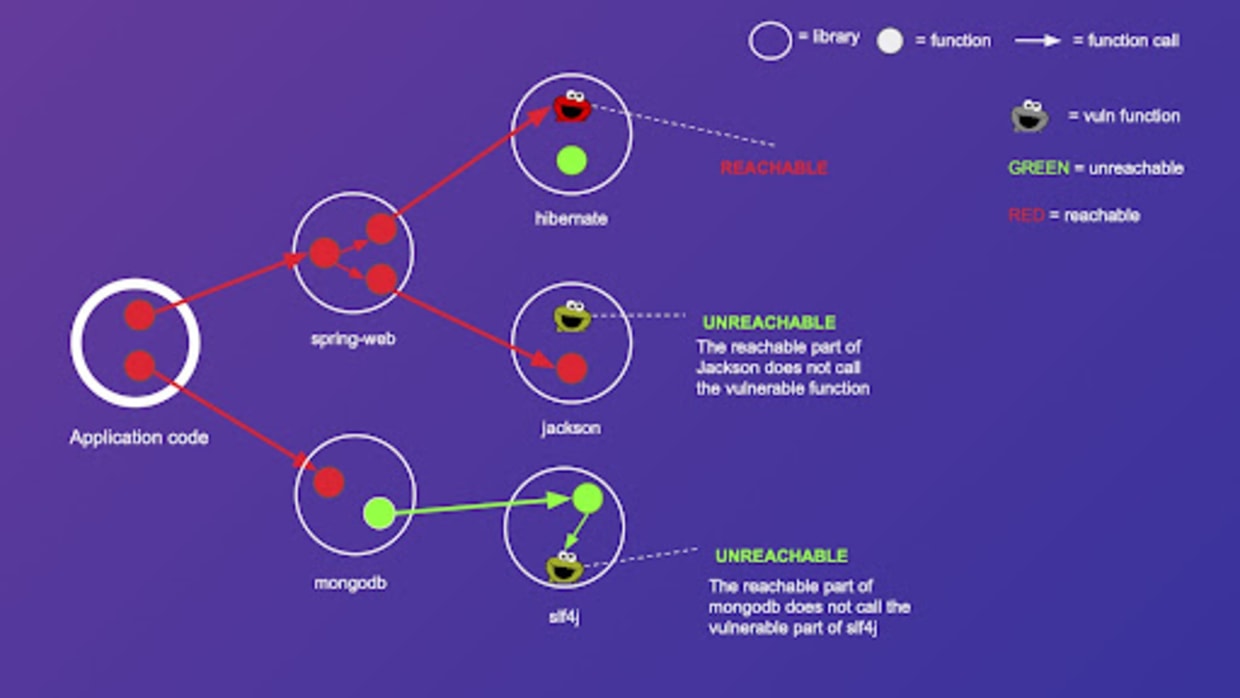
Como podemos ver, algunos monstruos de las galletas (funciones vulnerables) son alcanzables y otros no. Esto nos permite crear una regla para priorizar las vulnerabilidades de terceros de nuestra aplicación. Si al menos una función vulnerable asociada a una vulnerabilidad determinada es alcanzable, priorizamos su corrección. Por otro lado, si ninguna de las funciones vulnerables asociadas a esa vulnerabilidad es alcanzable, podemos dar menos prioridad a su corrección.
Ya definimos qué es el análisis de reachability del grafo de llamadas y cómo puede ayudarnos a priorizar las vulnerabilidades. Pero ¿cómo calculamos realmente el grafo de llamadas?
Ejecutar la aplicación para obtener el grafo de llamadas
Una forma de obtener el grafo de llamadas es ejecutar la aplicación y recopilar datos sobre la ejecución de las funciones mediante un agente en tiempo de ejecución. Sin embargo, esta solución dinámica (en tiempo de ejecución) no es ideal.
En primer lugar, ocurre «demasiado tarde» en el proceso del ciclo de vida de desarrollo de software (SDLC), porque requiere acceso a una aplicación en ejecución, y los desarrolladores siempre prefieren identificar y corregir las vulnerabilidades alcanzables antes de fusionar los cambios en la rama principal o publicarlos en producción. En segundo lugar, configurar agentes en tiempo de ejecución suele requerir una configuración personalizada para cada aplicación, lo que implica mucho trabajo. Por último, los desarrolladores suelen mostrarse reacios a complementar sus aplicaciones con estos agentes, porque temen que puedan causar interrupciones del servicio o reducir el rendimiento.
Esto nos llevó a una mejor solución que resuelve todos los problemas del enfoque dinámico: el análisis estático de código.
Calcular el grafo de llamadas de forma estática
A diferencia de una solución en tiempo de ejecución (dinámica), el análisis estático no ejecuta el programa para recopilar información. En cambio, analizamos el código fuente de la aplicación. Creamos un algoritmo que razona sobre las variables del programa, las asignaciones, las llamadas a funciones, los punteros, etc., y deriva el grafo de llamadas a partir de ese razonamiento.
De hecho, en el ámbito de la seguridad, el análisis estático ya es bastante conocido, principalmente gracias a las pruebas de seguridad de aplicaciones estáticas (SAST). El objetivo de SAST es encontrar problemas de seguridad en el código de tu aplicación, como una inyección SQL.
Fuente: publicación de un bromista polaco; probablemente nunca se llevó a la práctica
Recuerda que nuestro caso es distinto de SAST. No estamos descubriendo fallas de seguridad en tu propio código, sino en tus dependencias de terceros.
Bien, entonces tomamos como entrada un programa (su código fuente) y todas sus dependencias (su código fuente), y generamos un grafo de llamadas. Parece sencillo, ¿verdad?
Pero el análisis estático no es fácil y, aunque es un campo de investigación muy activo, analizar programas del mundo real sigue siendo, hasta cierto punto, un problema sin resolver para la mayoría de los lenguajes de programación. Tomemos Java como ejemplo. Podría parecer un lenguaje fácil de analizar: tiene tipos estáticos y no es muy dinámico (en comparación, por ejemplo, con Javascript). Veamos con más detalle cómo se puede crear un grafo de llamadas mediante análisis estático para programas en Java y qué desafíos implica.
Desafío 1 del análisis estático: despacho dinámico
El despacho dinámico ocurre cuando el método que se debe ejecutar se selecciona en tiempo de ejecución y depende del contexto de la ejecución. Está presente en la gran mayoría de los lenguajes de programación: desde los orientados a objetos, como Java (polimorfismo), hasta los funcionales, como Haskell (funciones de orden superior y cierres). El despacho dinámico representa un desafío para el análisis estático porque este debe modelar el contexto que determina qué funciones se invocarán en tiempo de ejecución.
Veamos el siguiente ejemplo en Java. Supongamos que tenemos una interfaz Animal con un método, makeSound, y tres clases que la implementan: Dog, Cat y GoblinShark. Veamos el siguiente programa sencillo.
Si solo observamos este método (es decir, sin considerar el código de createAnimal()), no podemos determinar si animal es un Dog, un Cat o quizá un GoblinShark.
Una forma de resolver esta situación es suponer que todas las posibilidades son válidas. De hecho, existe un algoritmo para crear grafos de llamadas que hace exactamente eso: se llama análisis de jerarquía de clases (CHA). Para el ejemplo anterior, CHA generaría el siguiente grafo de llamadas:
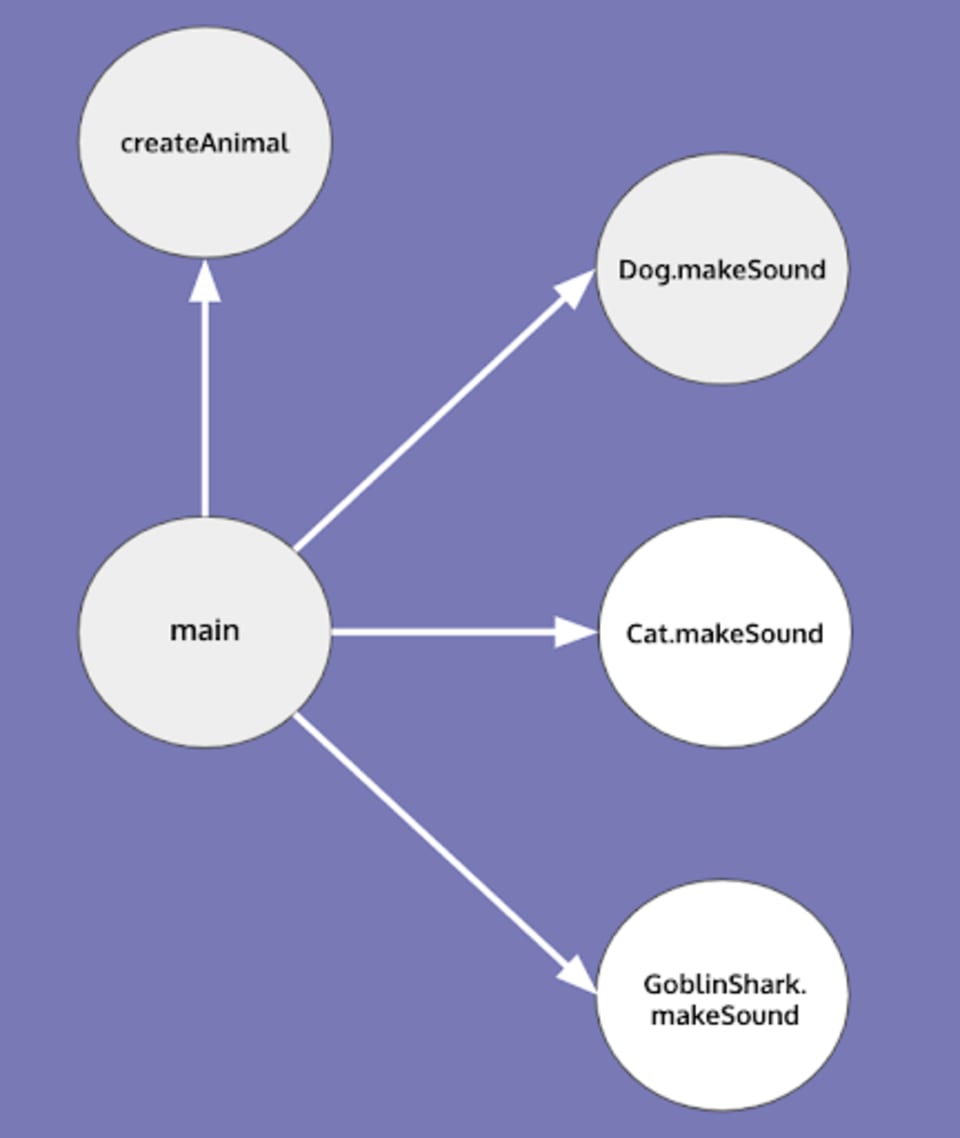
Este grafo de llamadas es correcto, pero quizá no sea preciso. Por ejemplo, consideremos ahora la función createAnimal que habíamos omitido: resulta que solo crea perros.
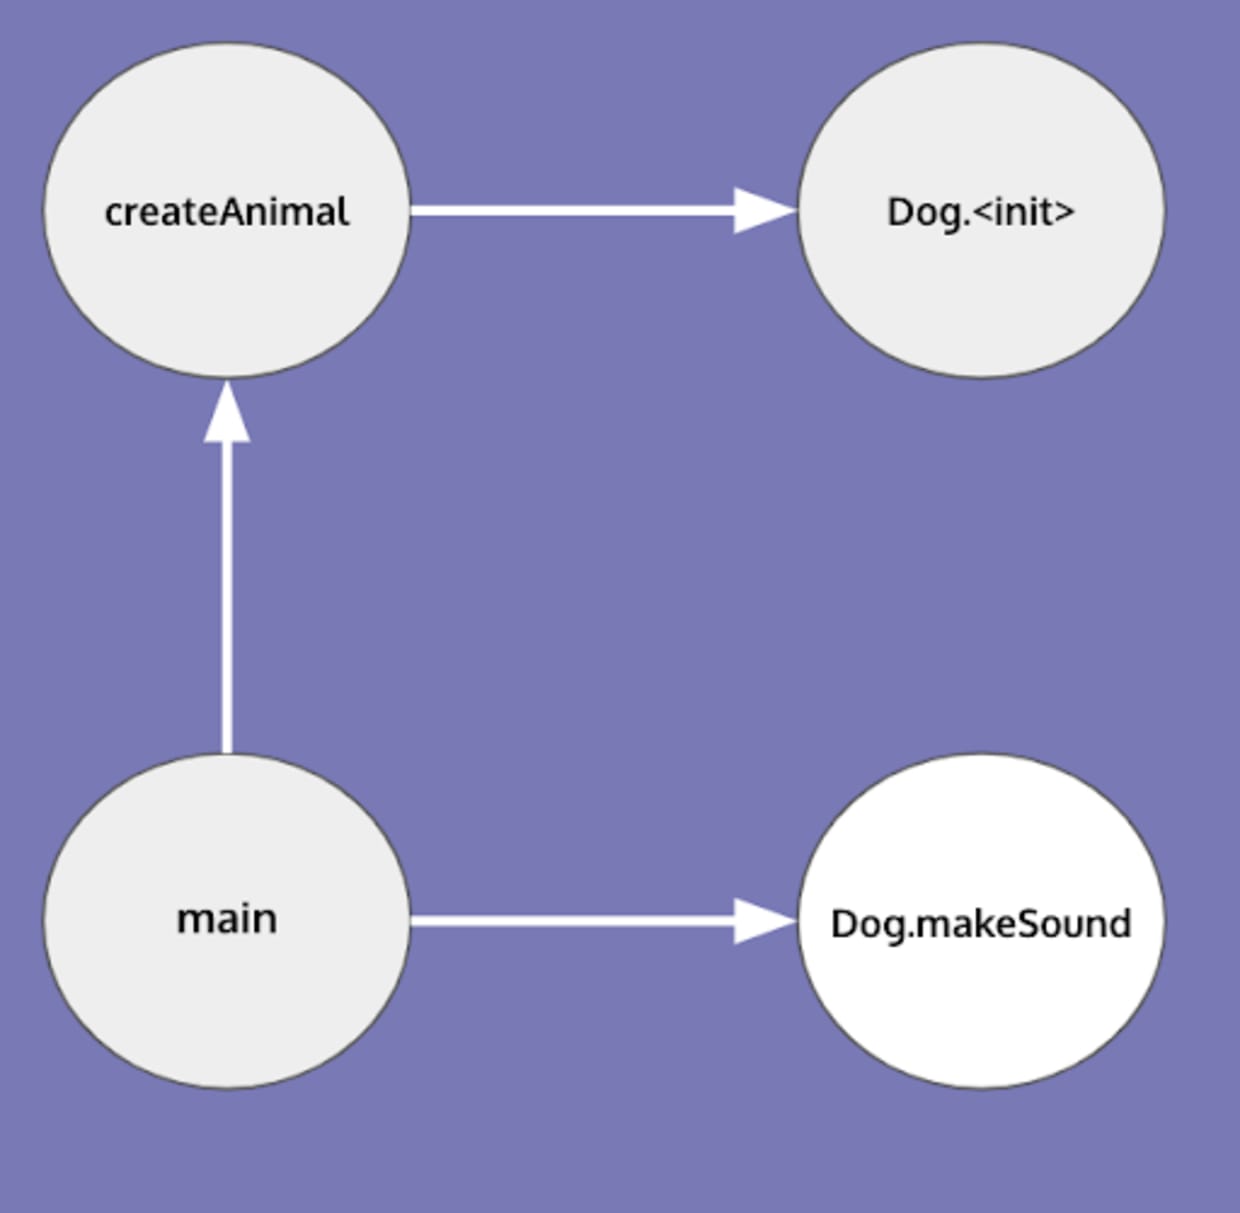
Como CHA supone que todas las posibilidades son válidas, el grafo de llamadas no cambia y resulta impreciso. El análisis que resuelve este problema se llama análisis points-to y requiere llevar un registro de los posibles valores a los que apunta una referencia determinada.
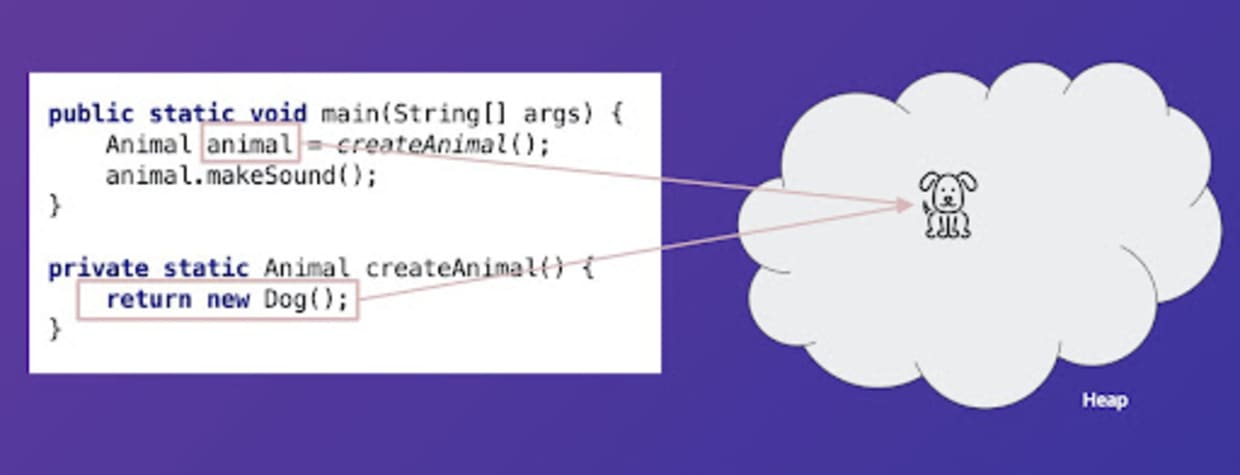
El análisis points-to de Andersen es un ejemplo de análisis que logra lo anterior. Un algoritmo de creación de grafos de llamadas que use el análisis points-to de Andersen generaría el siguiente resultado.
Flujo de control
El seguimiento de punteros se vuelve aún más difícil cuando consideramos el flujo de control del programa. Veamos el caso más sencillo:
En el programa anterior, el perro nunca emite sonidos. Pero, para determinarlo correctamente, el análisis estático debe tener en cuenta el orden de las instrucciones. En programas sencillos como el anterior, podemos usar un antiguo truco de los compiladores y convertir el código al formato de asignación estática única (SSA). SSA exige que cada variable del programa se asigne exactamente una vez, lo que resolvería el problema anterior.
Pero, en general, el orden de las instrucciones sí influye en el estado del programa y, por lo tanto, puede influir en el grafo de llamadas. Por ejemplo, es común llamar a una función init de una biblioteca de terceros antes de invocar los métodos públicos de esa biblioteca.
El método init puede configurar un estado interno complejo. Por consiguiente, el grafo de llamadas del programa anterior podría ser muy distinto del grafo de llamadas del programa siguiente.
Otro aspecto importante que hay que considerar son las instrucciones de flujo de control, como if, while, for, switch, etc. Veamos el programa:
En este caso, una opción razonable es ignorar la condición y suponer que ambas ramas de la instrucción if son alcanzables. Debido a esta ramificación, en la práctica el análisis points-to registra un conjunto de posibles valores señalados para cada variable del programa, en lugar de registrar solo uno.
Otras consideraciones
Hay muchos otros desafíos a la hora de crear grafos de llamadas para los lenguajes de programación modernos; los ejemplos anteriores apenas rozan el problema real. Otros desafíos incluyen:
Colecciones: llevar un registro de lo que se almacena en cada índice de una colección.
Análisis de los métodos públicos de una biblioteca: en lenguajes como Java, los métodos públicos de las bibliotecas suelen recibir interfaces como entrada para que los clientes puedan personalizar su funcionalidad, lo que dificulta el análisis points-to de esos métodos.
Ejecución dinámica de código: un patrón muy popular, especialmente en los frameworks, consiste en construir el nombre de la función en tiempo de ejecución, almacenarlo como una cadena y usar una biblioteca especial que recibe el nombre de la función como entrada y la ejecuta (por ejemplo, la reflexión en Java).
En la práctica, cuando usas análisis estático, debes decidir explícitamente qué quieres admitir, porque admitirlo todo sería computacionalmente inviable. En otras palabras, las aplicaciones del análisis estático siempre implican un equilibrio entre la precisión y la viabilidad computacional (el tiempo y los recursos necesarios para calcular la respuesta). Por ejemplo, para el análisis de reachability del grafo de llamadas en programas Java, un posible equilibrio sería ejecutar un análisis points-to estándar de Andersen con SSA, asumir siempre que se toman todas las ramas de las condicionales (por ejemplo, las instrucciones if), analizar todas las colecciones como si fueran bolsas (los índices no importan) e ignorar la ejecución dinámica de código (excepto en frameworks populares, como Spring).
Conclusión
En esta publicación del blog, mostramos cómo podemos identificar vulnerabilidades alcanzables mediante una combinación de investigación de seguridad experta y análisis estático automatizado. El resultado de este análisis siempre es una aproximación a la realidad. Sin embargo, es una aproximación útil, especialmente si eres desarrollador y buscas identificar las vulnerabilidades con mayor probabilidad de representar un riesgo inmediato para tu negocio.
En Snyk, hacemos todo lo posible para ayudar a los desarrolladores a resolver sus problemas de seguridad. Recientemente, lanzamos varias funciones para ayudar a los desarrolladores a priorizar las vulnerabilidades. Evaluar el reachability de las vulnerabilidades es una de ellas. Para descubrir cómo usarla, consulta el anuncio del lanzamiento aquí.
¡Mantente a salvo y protegido!
Empieza con Capture the Flag
Aprende a resolver desafíos de Capture the Flag viendo nuestro taller virtual introductorio a pedido.