Rendimiento en OPA Rego: de abajo hacia arriba y de arriba hacia abajo

29 de abril de 2021
0 minutos de lecturaEn esta publicación del blog, hablaremos un poco sobre cómo funciona la evaluación de Rego y cómo afecta el rendimiento. Rego es un DSL para crear políticas. No se limita a un solo tipo de política (por ejemplo, RBAC), sino que es muy versátil, lo que permite compartir políticas entre distintos servicios y stacks. Descubrimos que Rego es ideal para la seguridad de la infraestructura en la nube en Fugue y para la seguridad de la infraestructura como código en nuestro proyecto de código abierto, Regula.
Rego se basa en Datalog, un lenguaje declarativo. En términos sencillos, esto significa que el programador especifica los resultados que quiere obtener, pero no necesariamente cómo calcularlos. Esto contrasta con los lenguajes imperativos (como JavaScript y Python), en los que el programador siempre proporciona el algoritmo exacto.
La distinción no siempre es clara: la mayoría de los lenguajes declarativos tienen alguna forma de indicar cómo se debe calcular algo (como mostraremos en esta publicación del blog), y es posible crear DSL declarativos en lenguajes imperativos. En cualquier caso, Rego se inclina claramente hacia el extremo declarativo del espectro.
Como el programador no tiene que especificar cómo se calcula un resultado, el compilador o intérprete tiene más libertad. En lenguajes como Rego, hay dos estrategias importantes: de abajo hacia arriba y de arriba hacia abajo.
Con un ejemplo sencillo, explicaremos ambas estrategias y hablaremos de sus ventajas y desventajas relativas.
Un ejemplo
Imagina que estamos escribiendo una política para garantizar que los permisos de escritura estén configurados de forma granular. Nuestra entrada podría verse así:
Algunos de estos roles tienen lo que llamaremos permisos de escritura peligrosos: write: *. En nuestra política, queremos mostrar un error por cada usuario al que se le haya asignado un rol peligroso.
Definimos dos reglas:
dangerous_roles:un conjunto que contiene todas las políticas conwrite: *deny: un conjunto con todos los mensajes de error
Esta es la política completa:
Podemos verificar que el resultado sea el esperado usando opa eval:
Con este ejemplo en mente, veamos la evaluación de abajo hacia arriba y de arriba hacia abajo.
De abajo hacia arriba
Me resulta más fácil entender la diferencia entre estas dos estrategias de evaluación si visualizo el árbol de dependencias de las reglas:
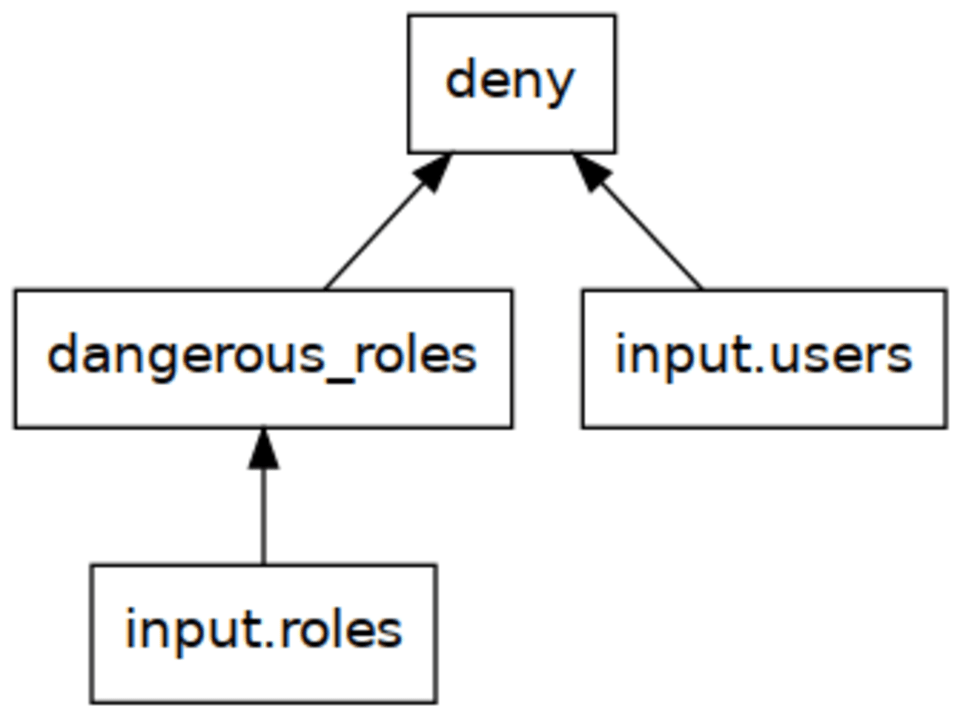
deny depende de dangerous_roles, y ambas dependen del documento de entrada. Una estrategia de abajo hacia arriba empieza a evaluar este árbol desde la base y avanza hacia la cima.
El documento de entrada no necesita más evaluación. Encima está el conjunto dangerous_roles: empezamos por calcularlo. En nuestro ejemplo, será el conjunto {"temporary_hack"}.
Una vez que conocemos dangerous_roles, ya conocemos todas las dependencias de la regla deny, así que seguimos evaluando ese segundo conjunto, que se convierte en {"Please remove role temporary_hack from user bob"}.
Una estrategia de abajo hacia arriba es fácil de implementar, pero tiene una gran desventaja: ¡a menudo calcula demasiado! Supongamos que, en lugar de mostrar todos los mensajes de deny, solo queremos comprobar si temporary_hack es un rol peligroso. Con una estrategia de abajo hacia arriba, dangerous_roles["temporary_hack"] calcularía todo el conjunto (que podría ser muy grande), en lugar de detenerse al descubrir que temporary_hack efectivamente está en él.
Una estrategia de arriba hacia abajo resuelve este problema.
De arriba hacia abajo
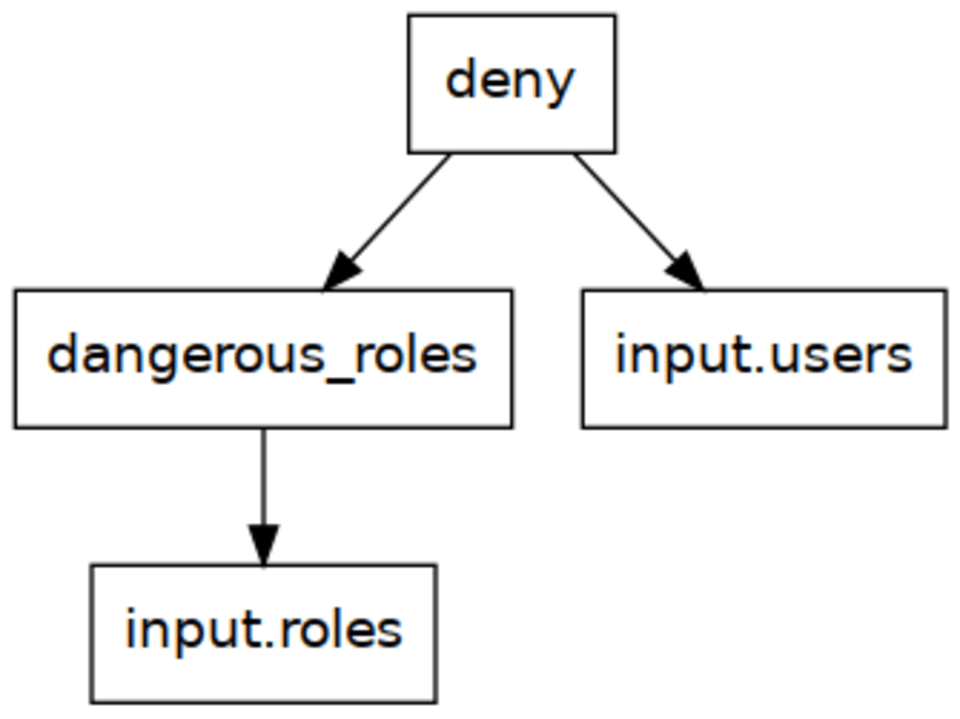
Una estrategia de arriba hacia abajo funciona al revés: evalúa las reglas según se necesitan, empezando desde la cima. Esto es muy parecido a llamar funciones en la mayoría de los lenguajes.
Empezamos por evaluar deny, ya que ese es el valor solicitado. Esta regla recorre los usuarios, asigna un valor a role_name y luego llama a dangerous_roles[role_name]. Si pensamos en términos de funciones, podemos verlo como dangerous_roles(role_name).
dangerous_roles no llama a ninguna otra “función”, sino que recorre las políticas del documento de entrada.
Podemos ver que esto produce el comportamiento deseado al evaluar dangerous_roles["temporary_hack"]: en lugar de construir un conjunto, ahora recorre las políticas de la entrada y devuelve un resultado cuando encuentra el rol peligroso que coincide con ese nombre.
OPA usa una estrategia de arriba hacia abajo para evaluar Rego.
Cuadrático por accidente
Pero este enfoque de arriba hacia abajo también tiene sus desventajas. En pseudocódigo, la evaluación de abajo hacia arriba ejecuta internamente dos ciclos:
Esto es diferente de la evaluación de arriba hacia abajo. Si volvemos a pensar en dangerous_roles como una llamada a función, obtenemos lo siguiente:
¡Esto se parece sospechosamente a algo con un tiempo de ejecución cuadrático!
Y, en efecto, si generamos una entrada con 1000 usuarios y 1000 políticas, opa tarda 3.47 segundos en evaluarla. ¡Si aumentamos esa cantidad a 10000, tarda poco más de 4 minutos!
Puede parecer un ejemplo artificial, pero es análogo a un problema real que encontramos en Fugue. Analizamos grandes cantidades de recursos para verificar el cumplimiento, así que estas evaluaciones pueden acumularse.
De arriba hacia abajo y de abajo hacia arriba
¿Eso es todo? ¿Tenemos que conformarnos con consultas lentas? Por suerte, no.
Hay una solución sencilla: si sabemos que queremos evaluar una regla “de una sola vez”, podemos hacerlo con una comprensión de conjuntos. De esta manera, dangerous_roles se convierte en una regla completa con un solo valor.
Sintácticamente, se ve así:
¡Con este sencillo truco (que los analistas de consultas odian), tardamos menos de 0.4 segundos con 10000 usuarios!
Conclusión
Un lenguaje declarativo facilita que te enfoques en lo que quieres calcular, en lugar de cómo hacerlo. Sin embargo, no podemos olvidarnos por completo del modelo de ejecución real, sobre todo cuando puede aumentar drásticamente el tiempo de ejecución y provocar tiempos de espera agotados.
Por suerte, la solución es fácil y rápida. Al escribir reglas de Rego, conviene preguntarse si una regla debería representarse como una función o como un conjunto que se calcula una sola vez, y usar una comprensión o una regla incremental según corresponda.
En esta publicación del blog hablamos exclusivamente de conjuntos, pero lo mismo se aplica a los objetos.
Una pregunta obvia que aún no hemos respondido es si esto se puede resolver sin tener que cambiar el código, de una manera verdaderamente declarativa.
Almacenar en caché los resultados de las llamadas a dangerous_roles[role] parece una opción interesante, y fue lo primero que exploré. Sin embargo, para evitar volver a calcularlos, también habría que almacenar en caché tanto los elementos que están en el conjunto como los que no. Esto es un problema, porque estos últimos podrían no caber en la memoria; además, en cualquier caso se necesita algún tipo de expulsión LRU, lo que complica el código.
No siempre es posible que un compilador determine si conviene más calcular una regla arbitraria de abajo hacia arriba o de arriba hacia abajo. Sin embargo, eso no debe impedirnos intentarlo. Creé un prototipo de optimización en fregot, nuestro motor experimental de Rego, que identifica las reglas candidatas a evaluarse de abajo hacia arriba mediante el análisis de los patrones de asignación y la comprobación de si el argumento puede usarse para interrumpir la evaluación antes de tiempo. Identificó todos los casos que provocaban tiempos de espera agotados, ¡así que es una opción prometedora!
Seguridad de IaC diseñada para desarrolladores
Snyk protege tu infraestructura como código desde el ciclo de vida del desarrollo de software hasta el runtime en la nube con un motor unificado de políticas como código, para que todos los equipos puedan desarrollar, implementar y operar de forma segura.