Cómo incluso las funciones asíncronas rápidas de Node.js pueden bloquear el bucle de eventos

Michael Gokhman
4 de febrero de 2019
0 minutos de lecturaUna aplicación típica de Node.js es básicamente un conjunto de callbacks que se ejecutan en respuesta a diversos eventos: una conexión entrante, la finalización de una operación de E/S, el vencimiento de un tiempo de espera, la resolución de una Promise, etc. Hay un único hilo principal (también llamado bucle de eventos) que ejecuta todos estos callbacks, por lo que deben completarse rápido, ya que los demás callbacks pendientes esperan su turno. Esta limitación de Node es conocida y difícil de manejar, y también se explica muy bien en la documentación.
Hace poco me encontré con un caso real de bloqueo del bucle de eventos en Snyk. Cuando intenté solucionar la situación, me di cuenta de lo poco que sabía realmente sobre el comportamiento del bucle de eventos y llegué a algunas conclusiones que al principio me sorprendieron a mí y a algunos desarrolladores con quienes las compartí. Creo que es importante que tantos desarrolladores de Node como sea posible también tengan estos conocimientos. Por eso escribí este artículo.
Ya existe mucha información valiosa sobre el bucle de eventos de Node.js, pero me tomó tiempo encontrar respuestas a las preguntas específicas que quería plantear. Haré todo lo posible por compartir las distintas preguntas que me hice y las respuestas que encontré en varios artículos excelentes, además de algunos experimentos y exploraciones divertidos.
¡Primero, bloqueemos el bucle de eventos de Node.js!
Nota:
Los siguientes ejemplos usan Node 10.9.0 en una máquina virtual Ubuntu 18.04 con 4 núcleos, ejecutada en una MacBook Pro de 2017
Puedes probar el código de abajo clonando https://github.com/michael-go/node-async-block
Empecemos con un servidor Express sencillo:
Ahora agreguemos un endpoint que bloquee el bucle de eventos:
Entonces, esperamos que mientras se ejecuta el endpoint /compute-sync, las solicitudes a /healthcheck se queden esperando. Podemos probar /healthcheck con este comando de una sola línea en bash:
Probará el endpoint /healthcheck cada segundo y agotará el tiempo de espera si no recibe respuesta en 5 segundos.
Probémoslo:
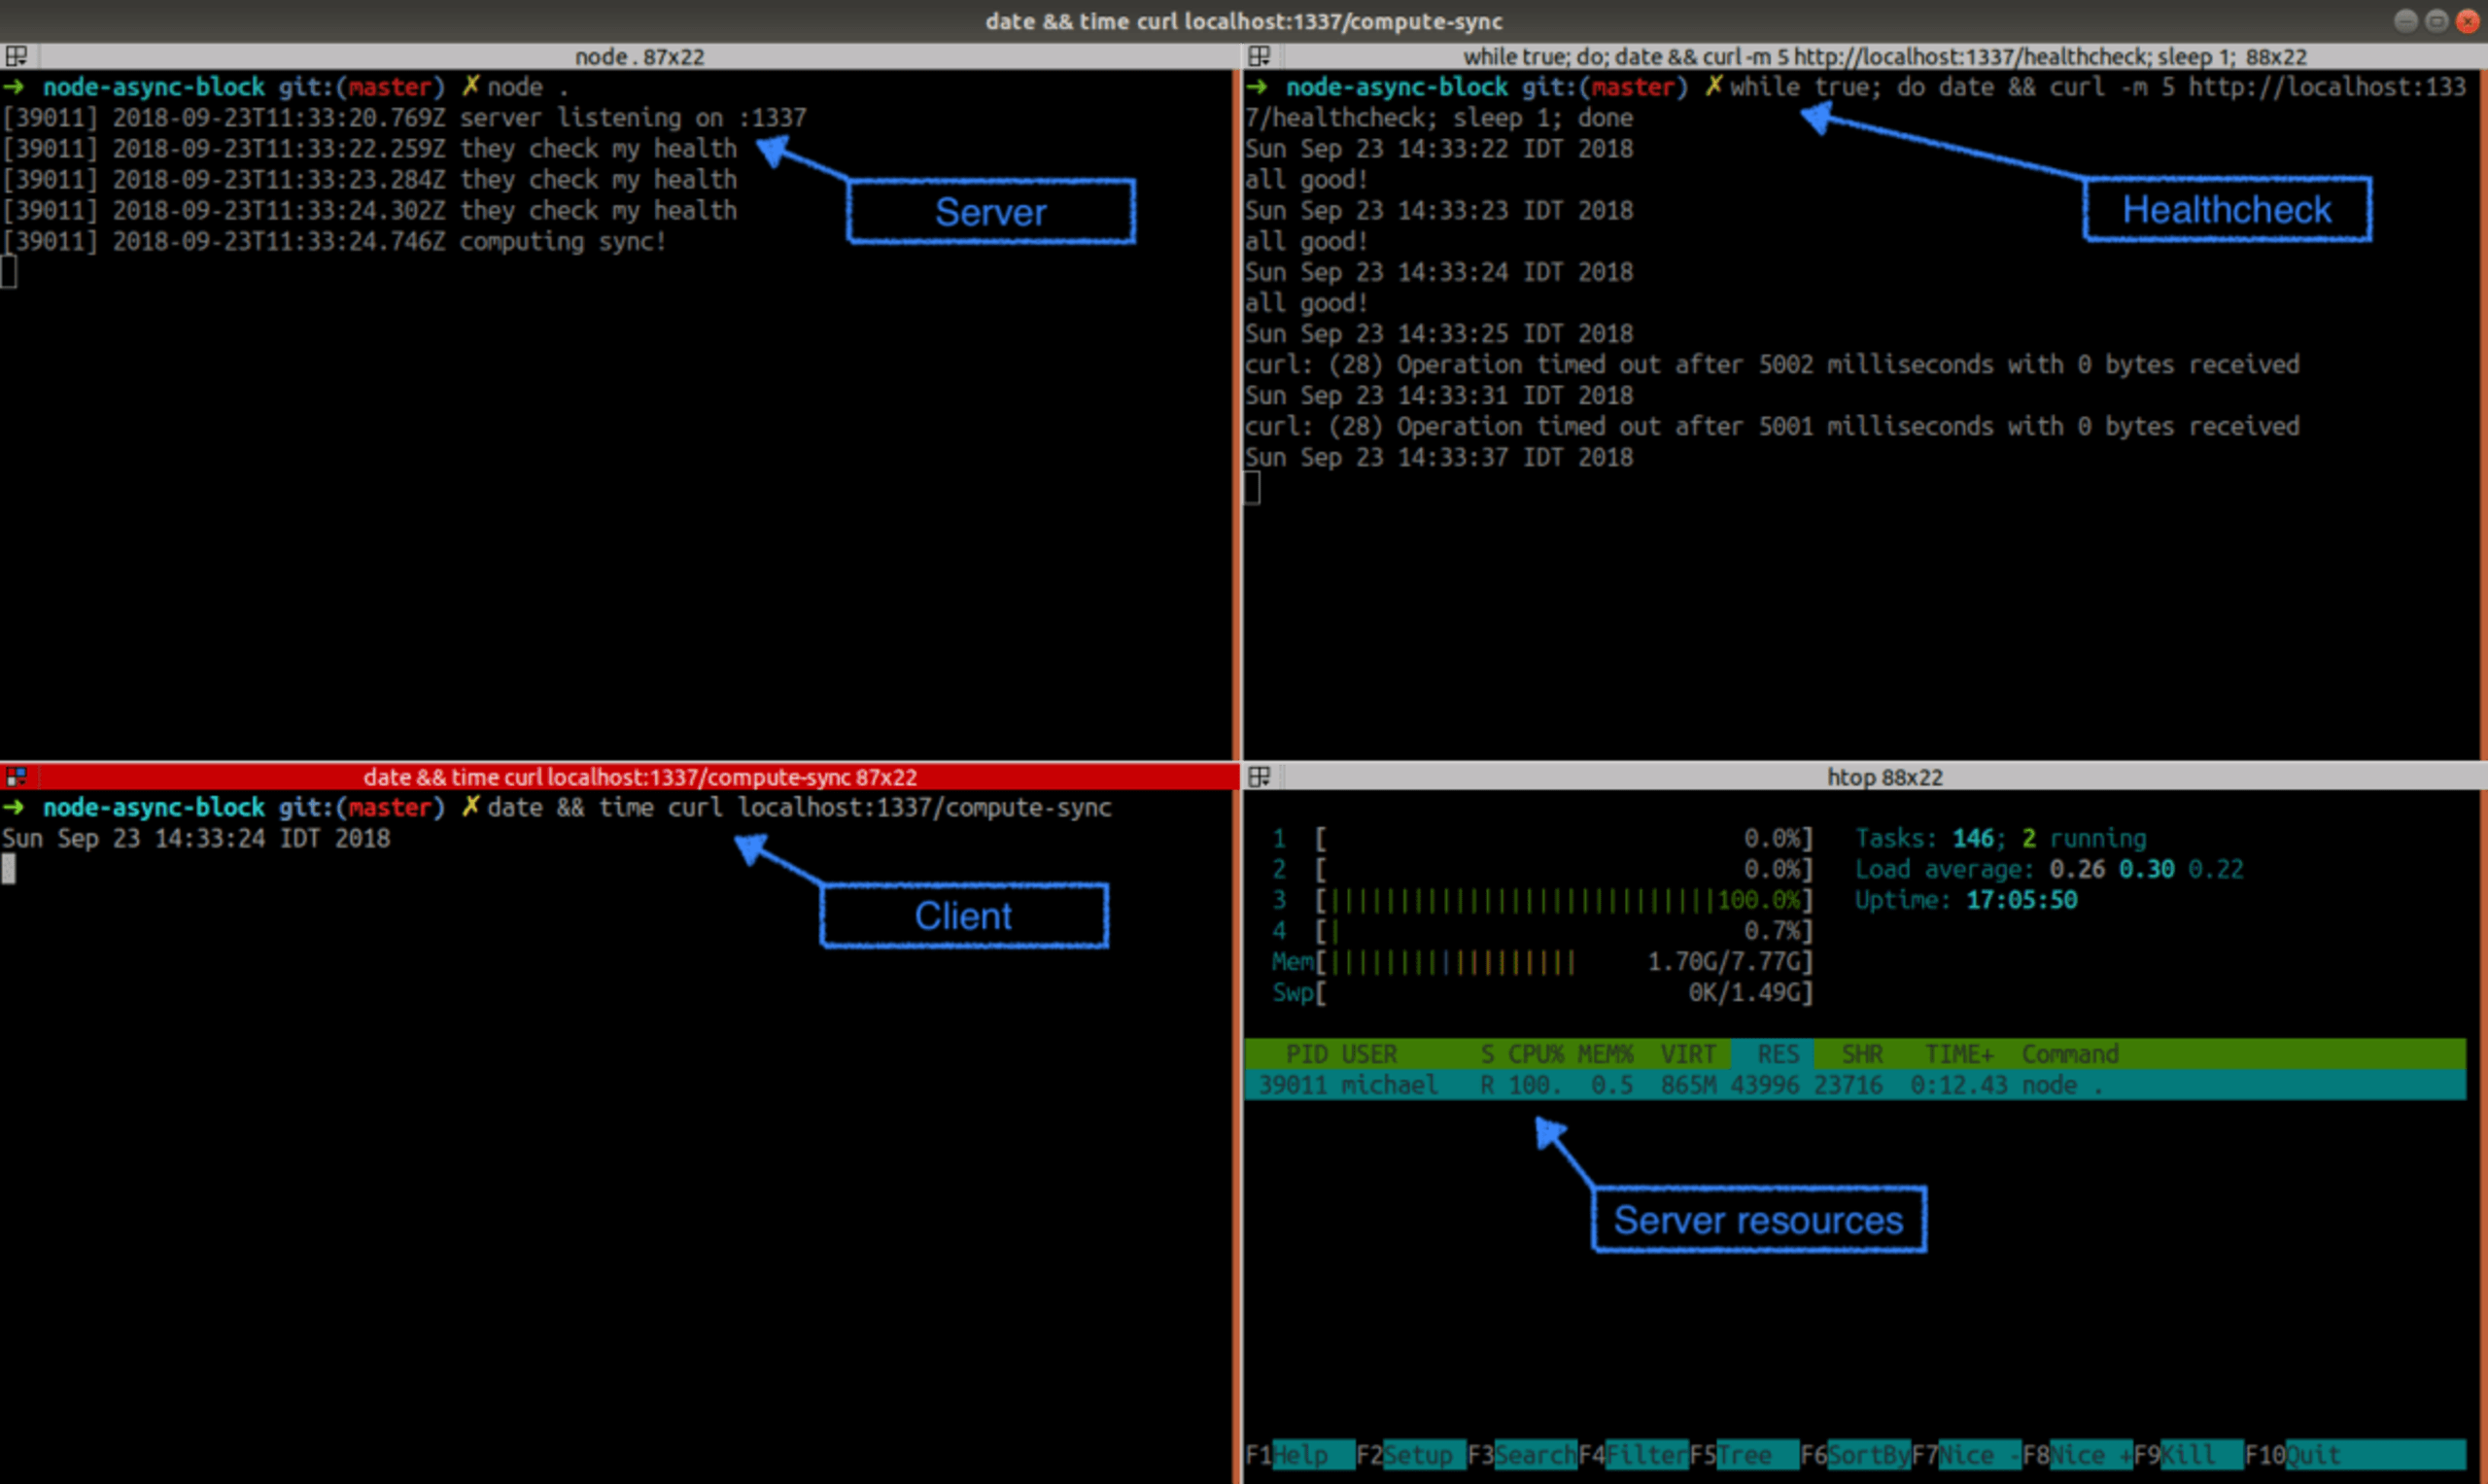
En cuanto llamamos al endpoint /compute-sync, las comprobaciones de estado empezaron a agotar el tiempo de espera y ninguna tuvo éxito. Observa que el proceso node está trabajando intensamente, con un uso de CPU de aproximadamente el 100 %.
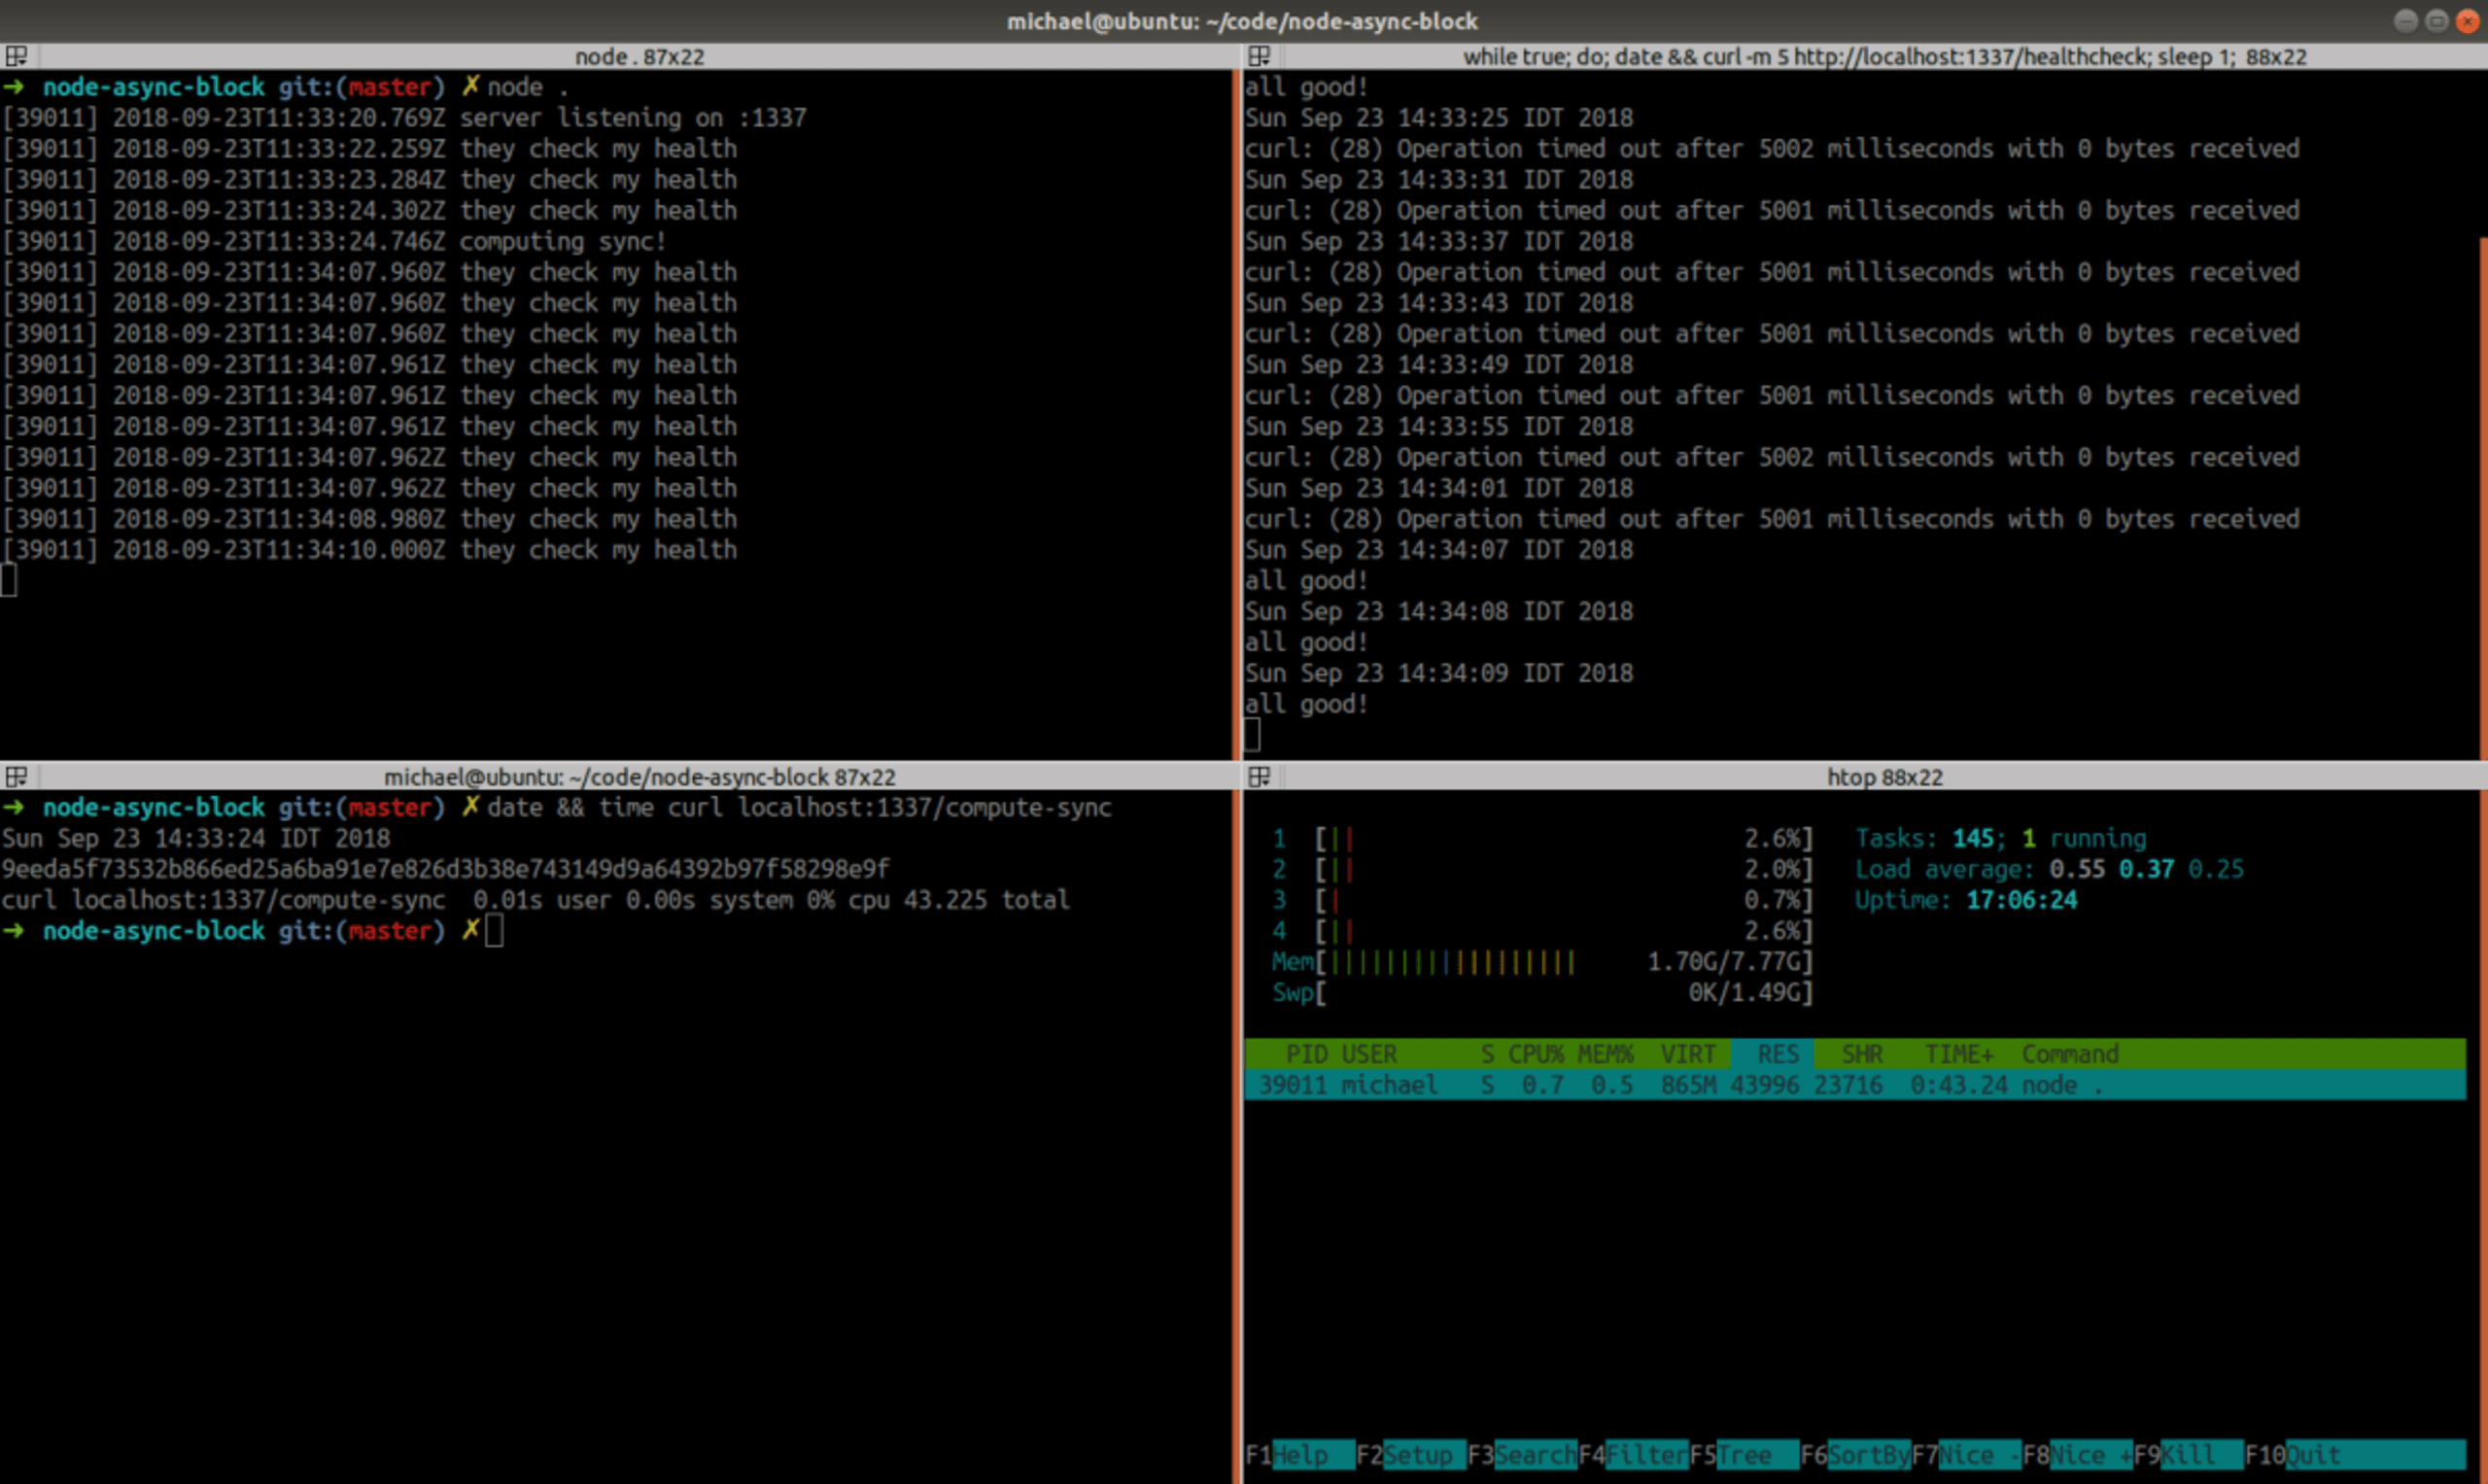
Después de 43.2 segundos, termina el cálculo, se procesan 8 solicitudes pendientes a /healthcheck y el servidor vuelve a responder.
Esta situación es bastante grave: una solicitud problemática bloquea por completo el servidor. Si entendemos el concepto de “bucle de eventos de un solo hilo”, es evidente por qué el código de /compute-sync bloqueó las demás solicitudes: antes de terminar, no devolvió el control al planificador del bucle de eventos, así que el controlador de /healthcheck no tuvo oportunidad de ejecutarse.
¡Desbloqueémoslo!
Agreguemos un nuevo endpoint, /compute-async, donde dividiremos el bucle largo y bloqueante y devolveremos el control al bucle de eventos después de cada paso del cálculo (¿demasiados cambios de contexto? Quizá… podemos optimizarlo más adelante y ceder el control solo cada X iteraciones, pero empecemos con algo sencillo):
Probémoslo:
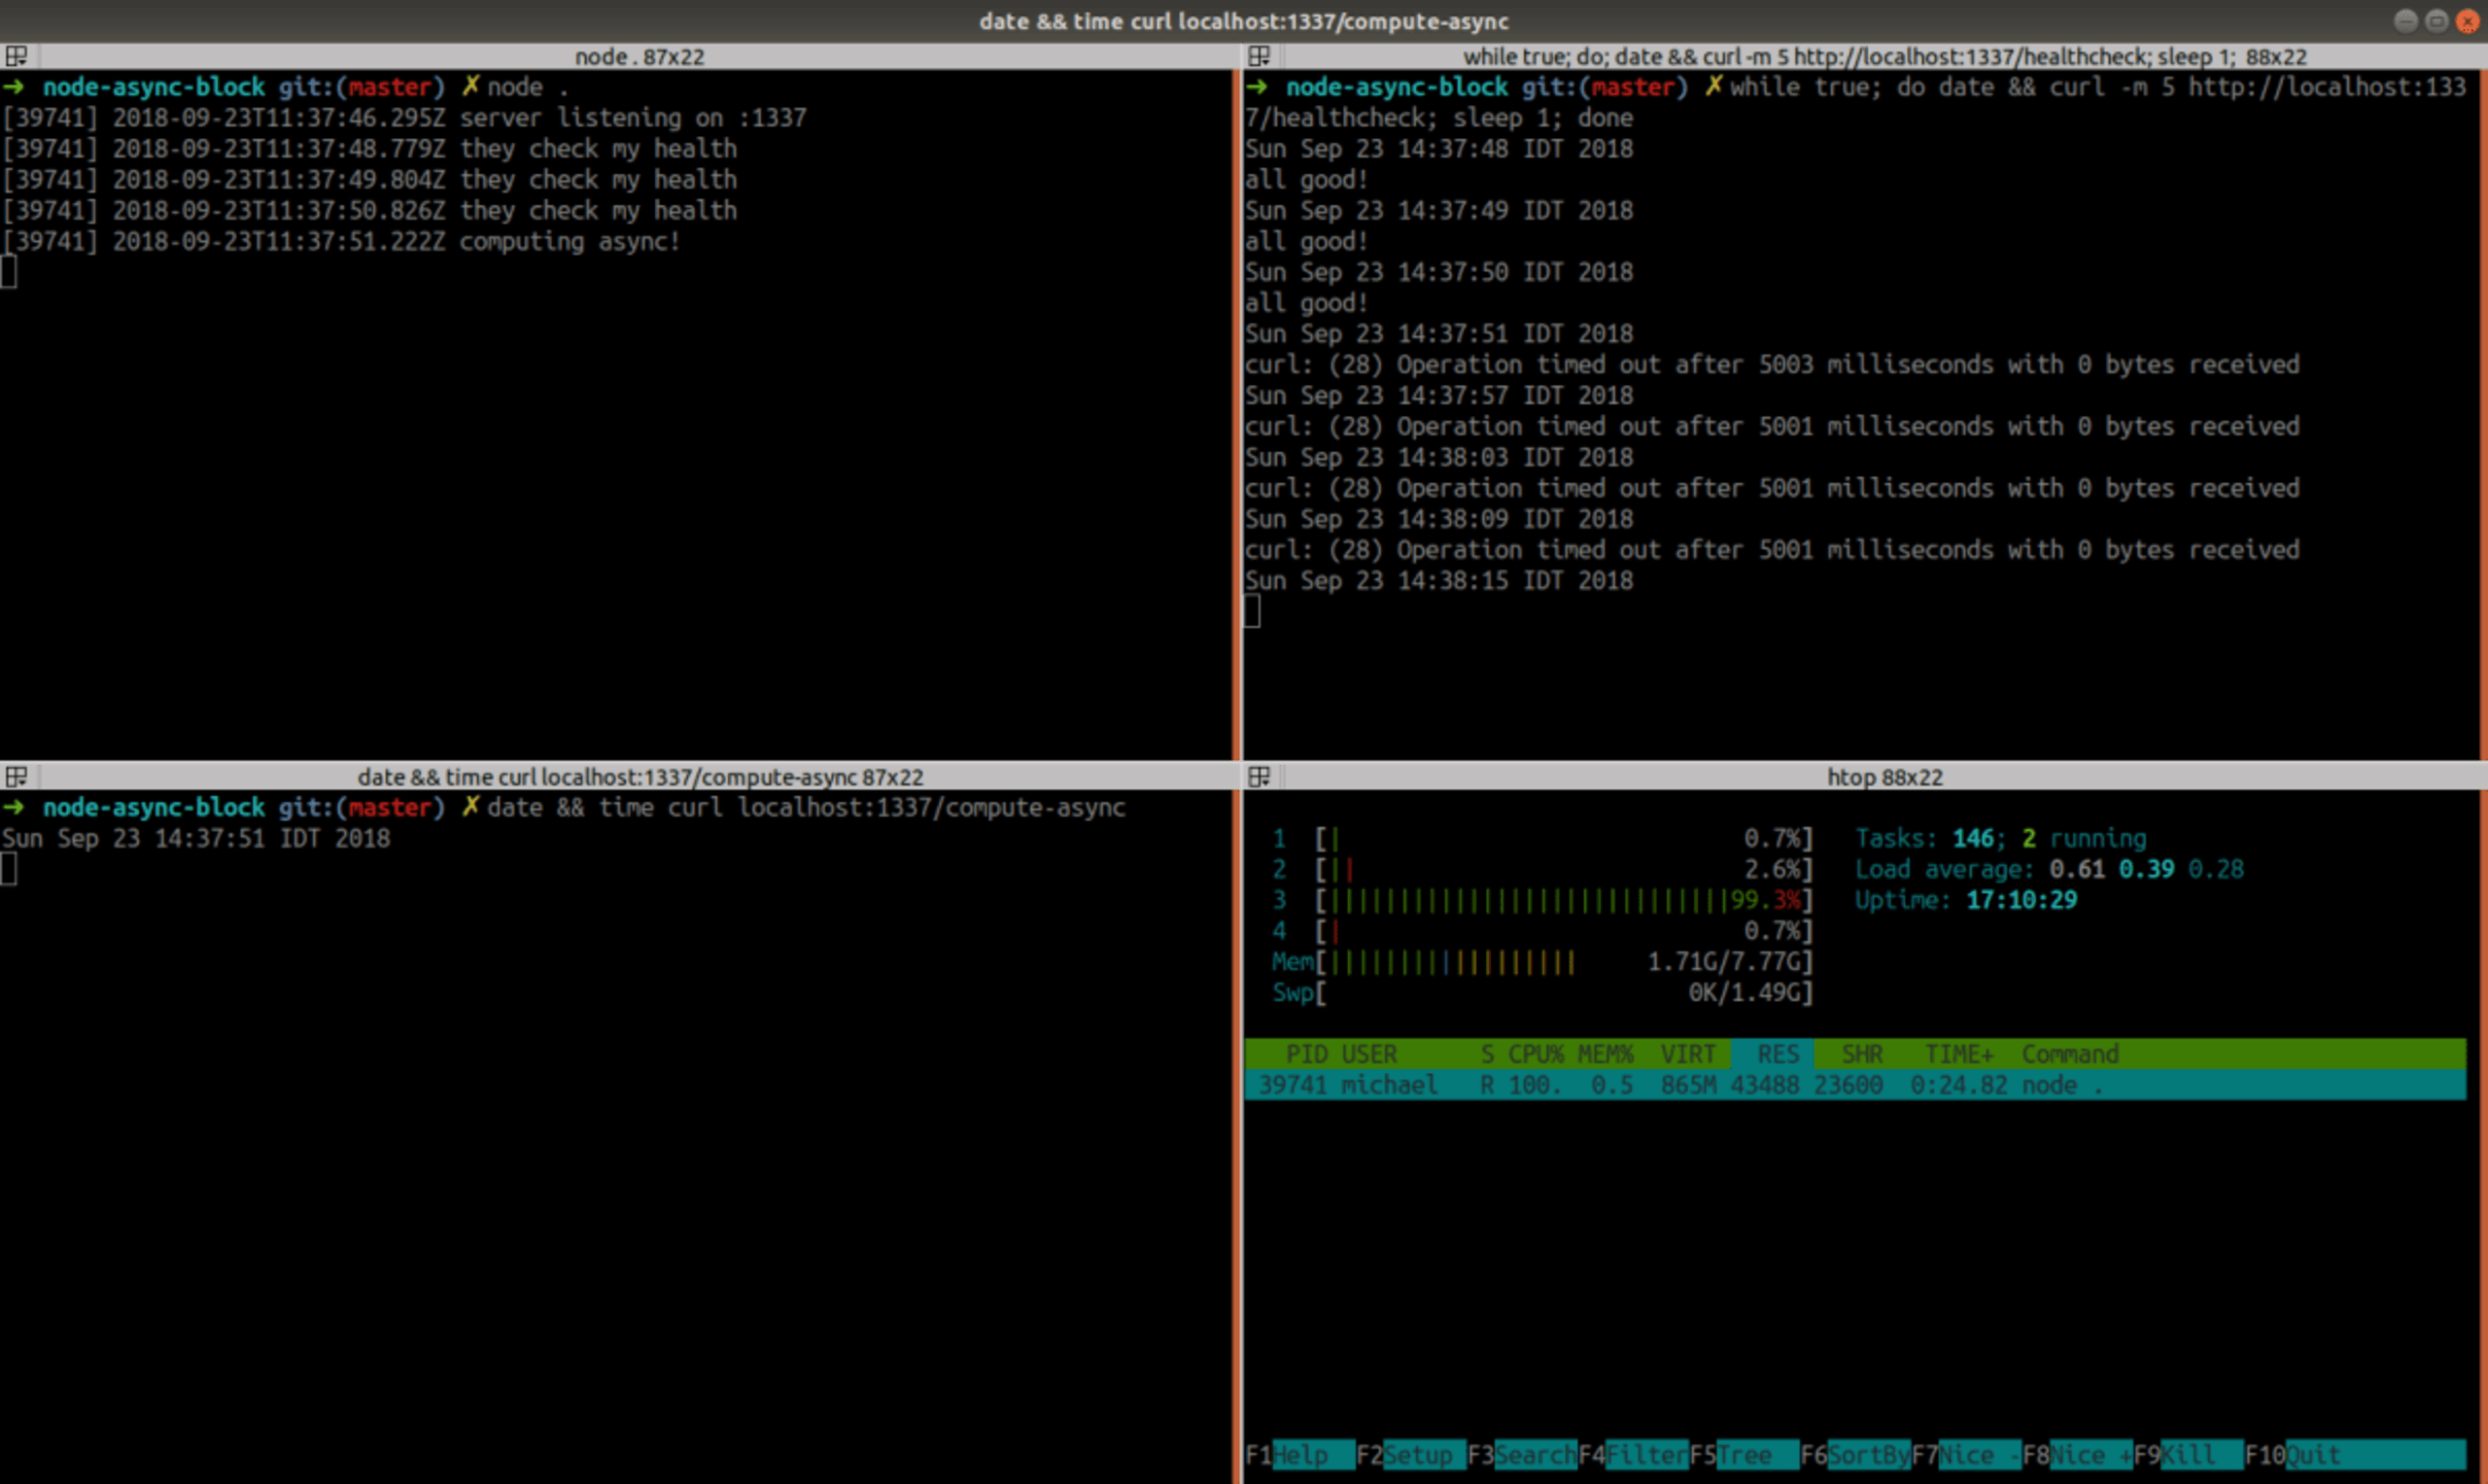
Mmm… ¿sigue bloqueando el bucle de eventos?
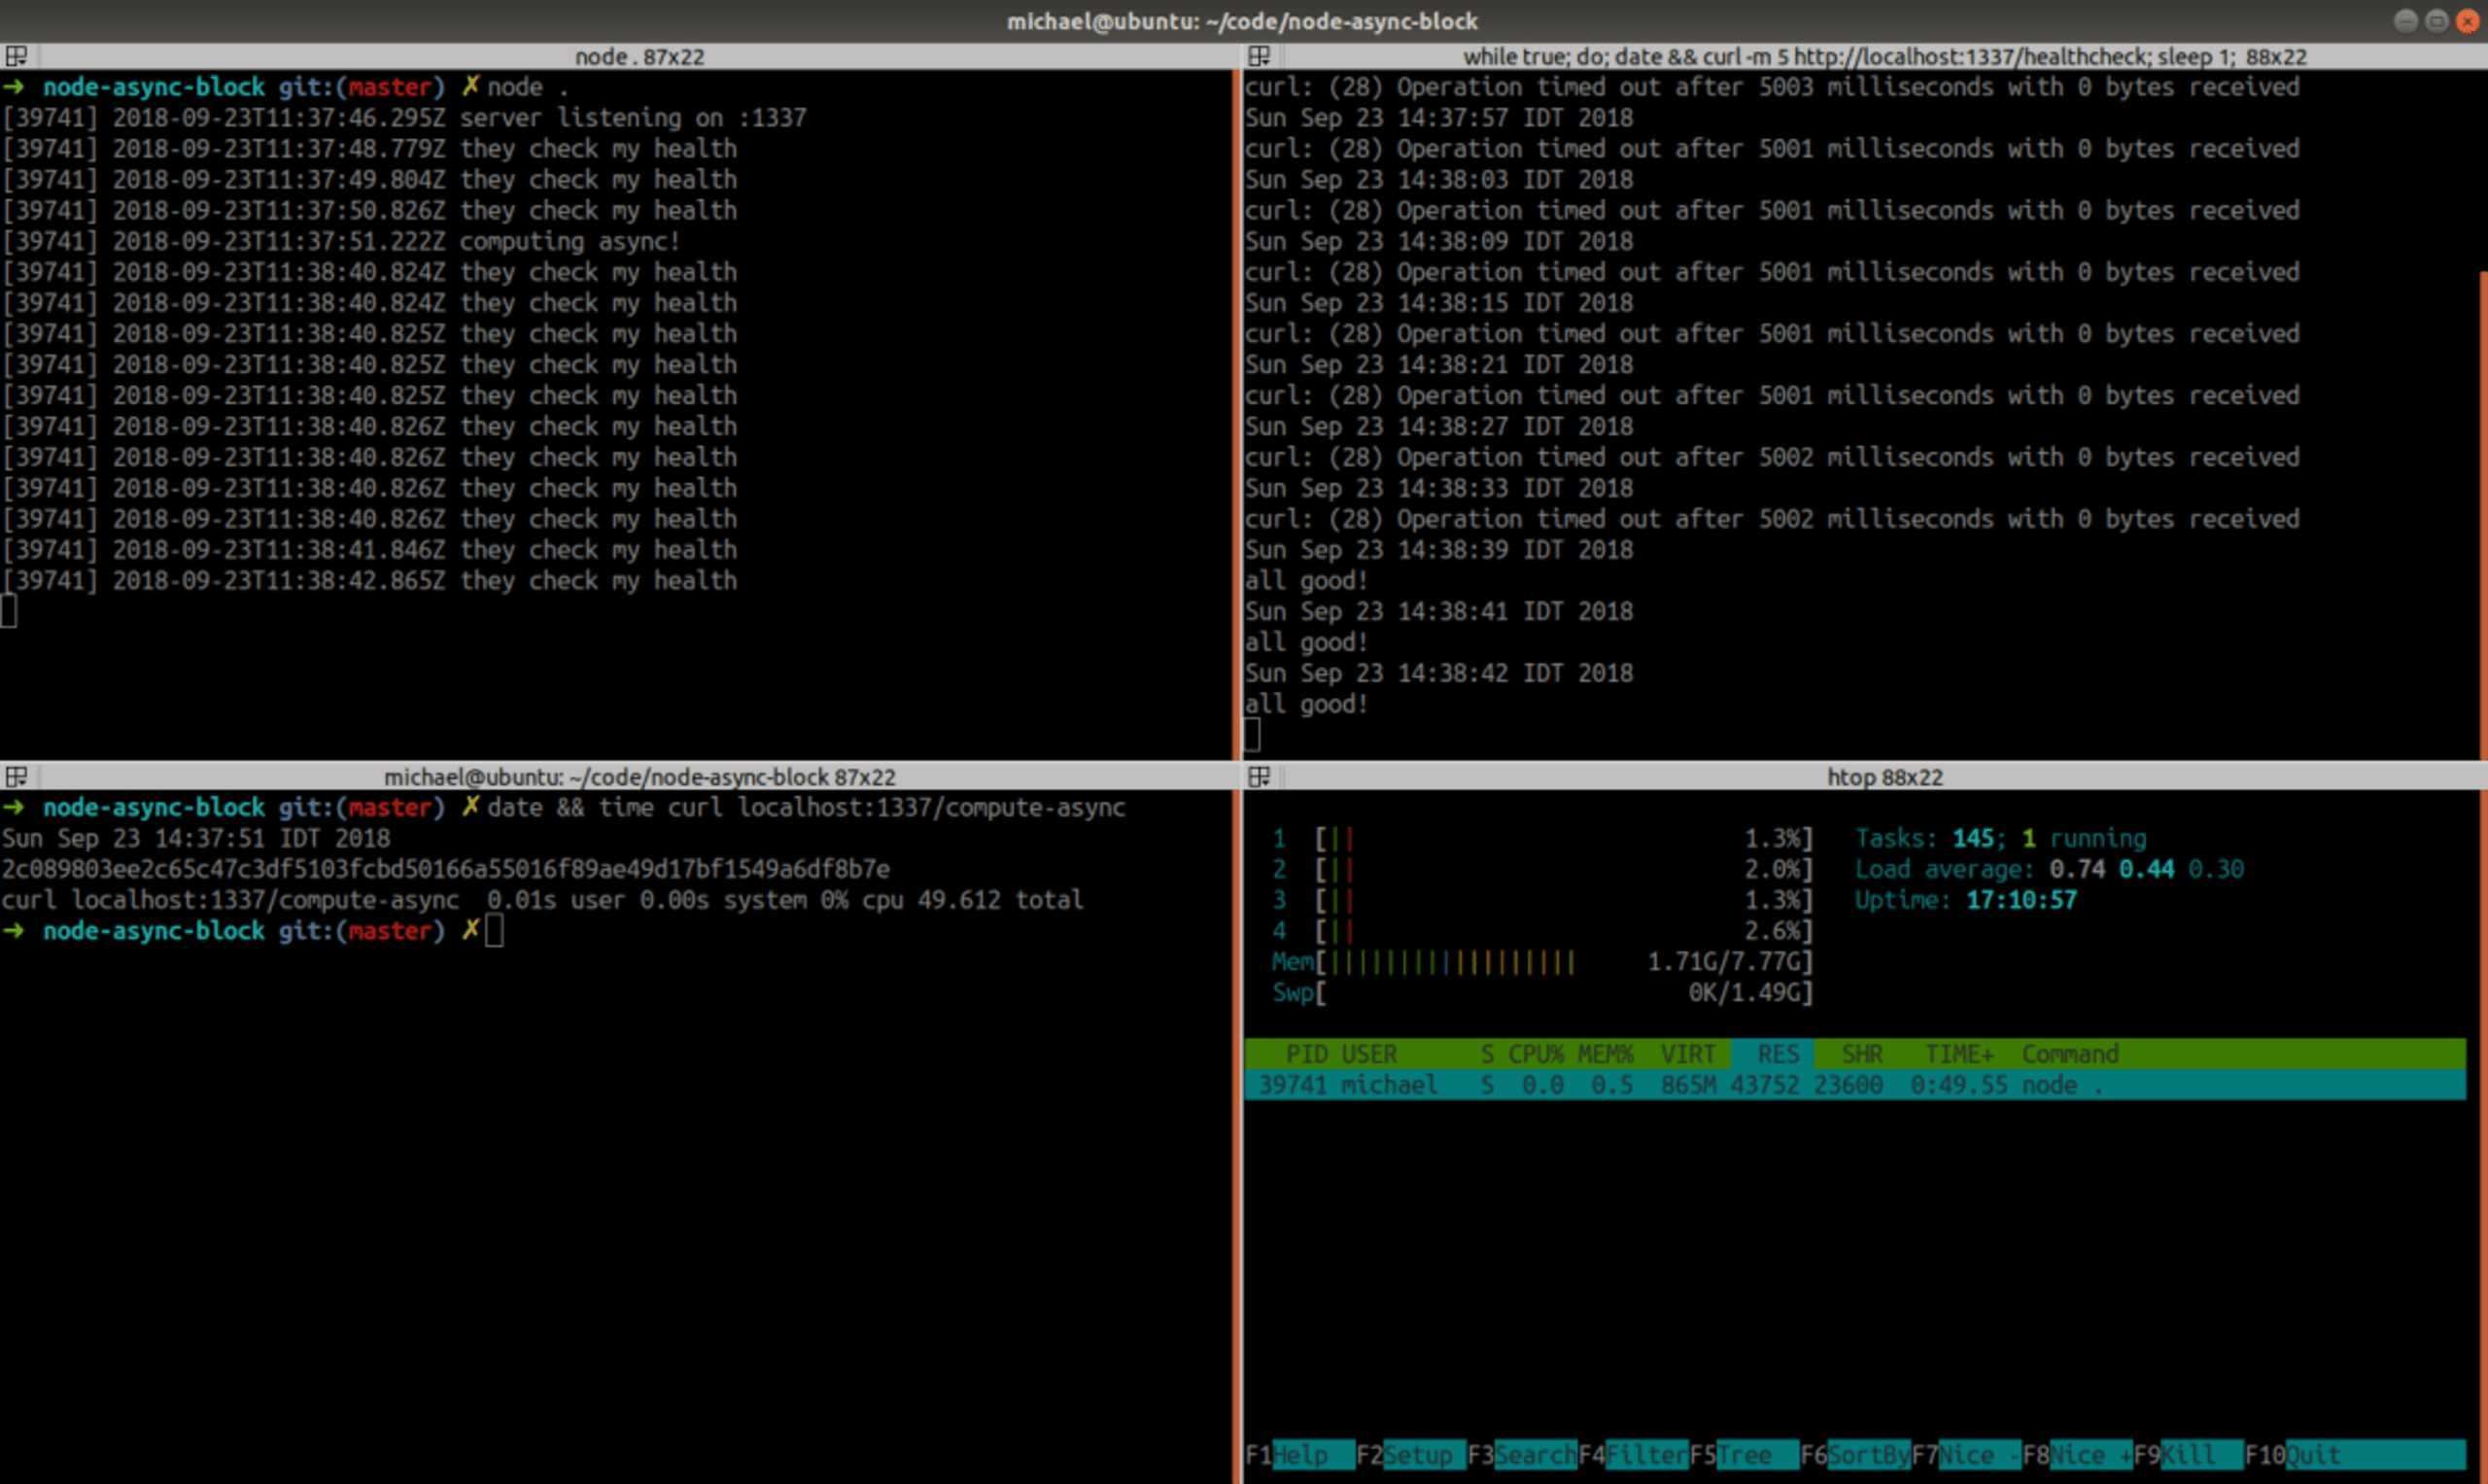
¿Qué está pasando? ¿Node.js optimiza y elimina nuestro ejemplo de juguete con async/await? Tardó unos segundos más en terminar, así que no parece ser el caso… Los gráficos de llamas pueden darnos una pista sobre si async realmente tuvo efecto. Podemos usar este excelente proyecto de GitHub para generar gráficos de llamas fácilmente:
Primero, el gráfico de llamas capturado mientras se ejecutaba /compute-sync:
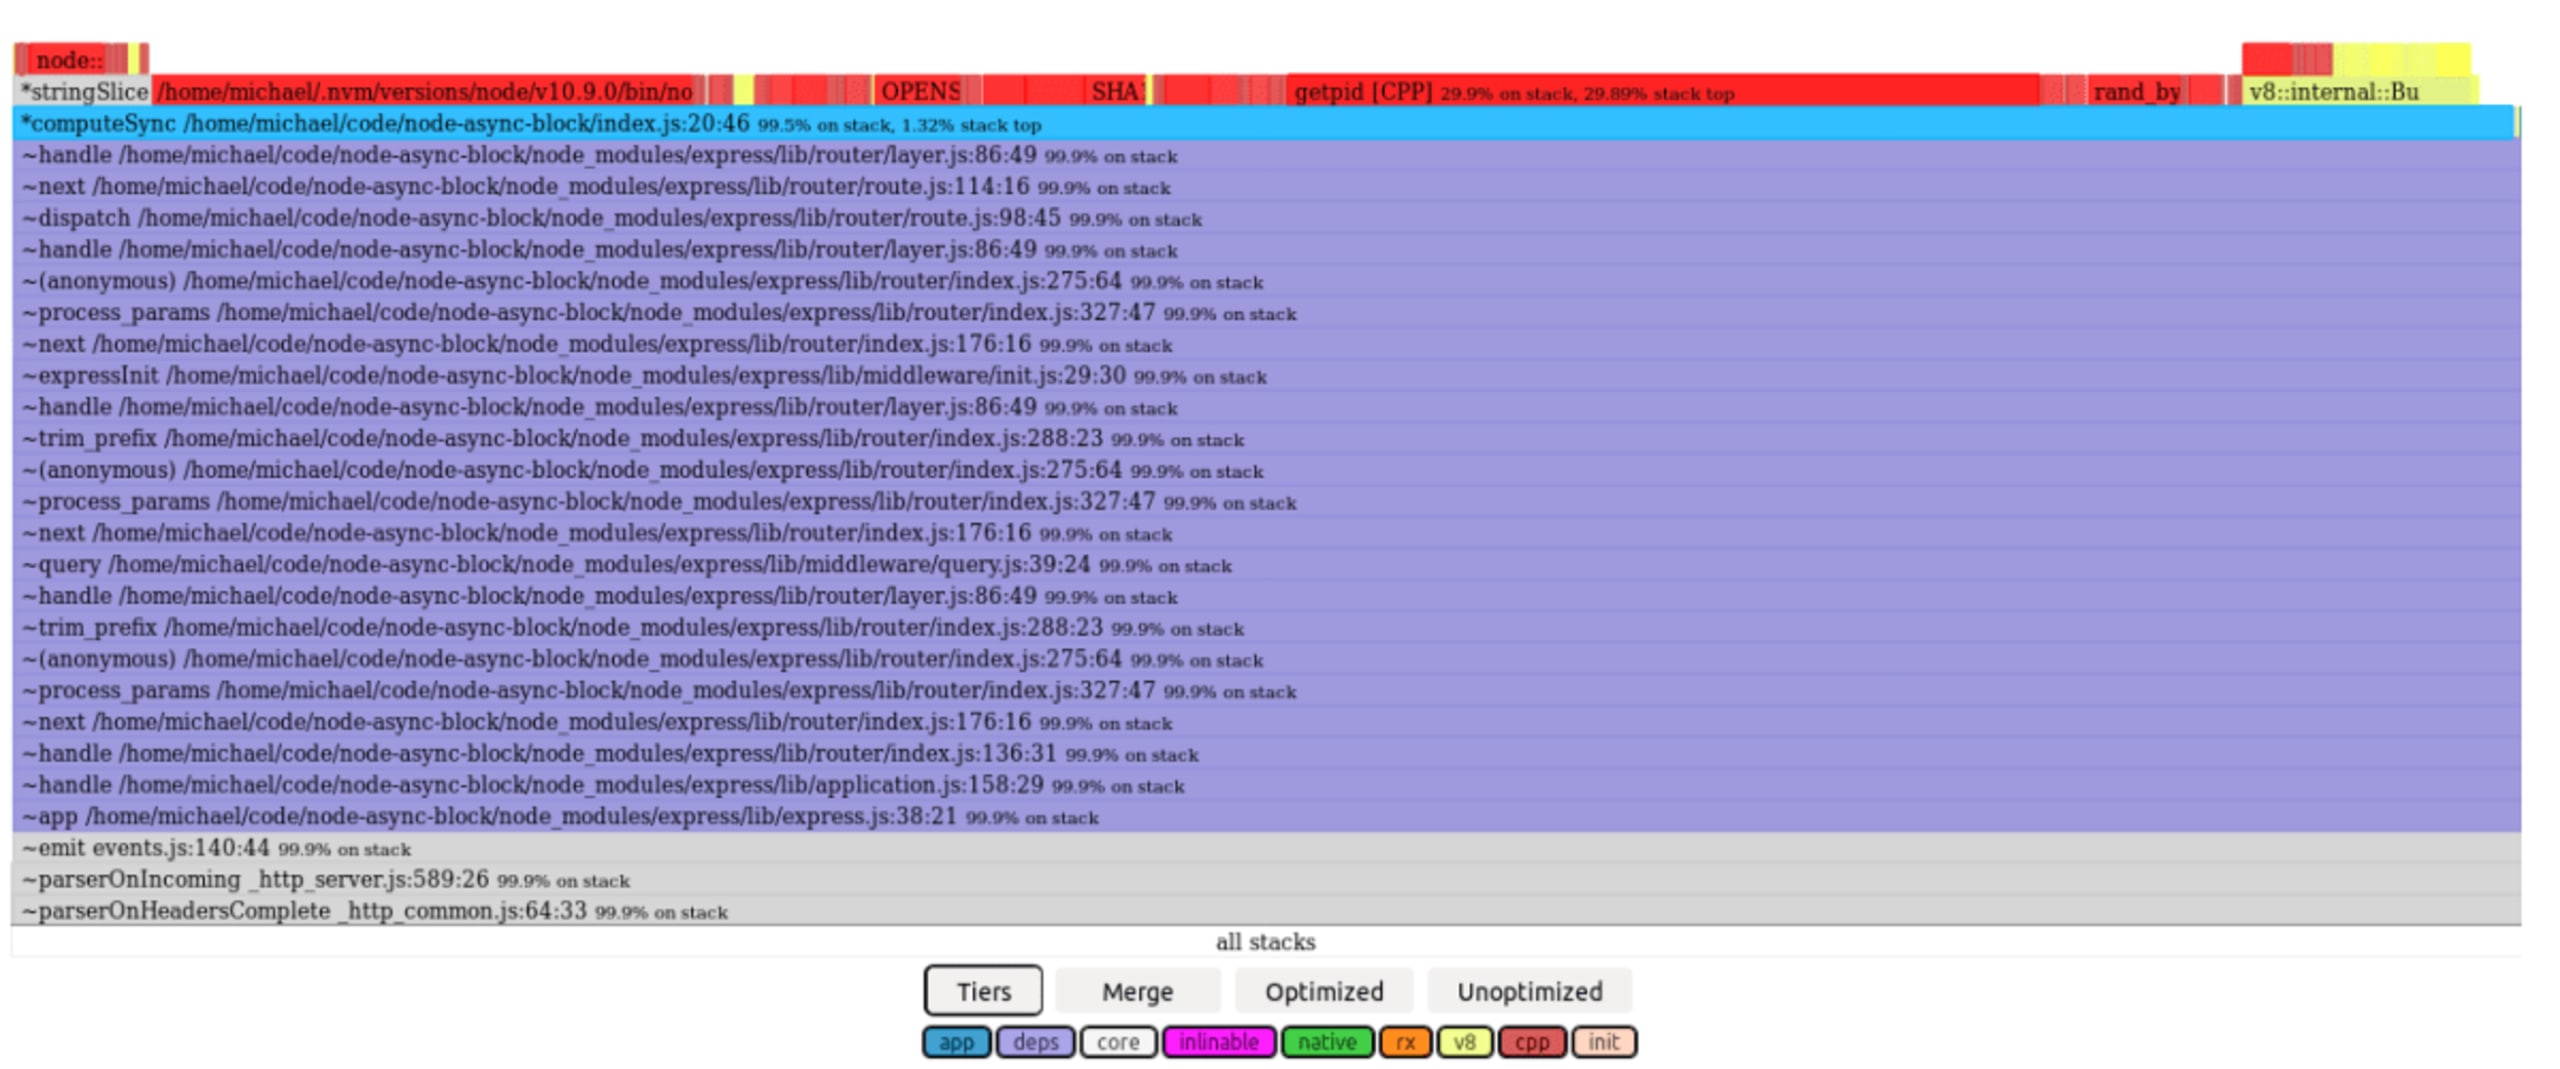
Podemos ver que la pila de /compute-sync incluye la pila del controlador de Express, ya que todo se ejecutó de forma síncrona.
Ahora, el gráfico de llamas capturado mientras se ejecutaba /compute-async:
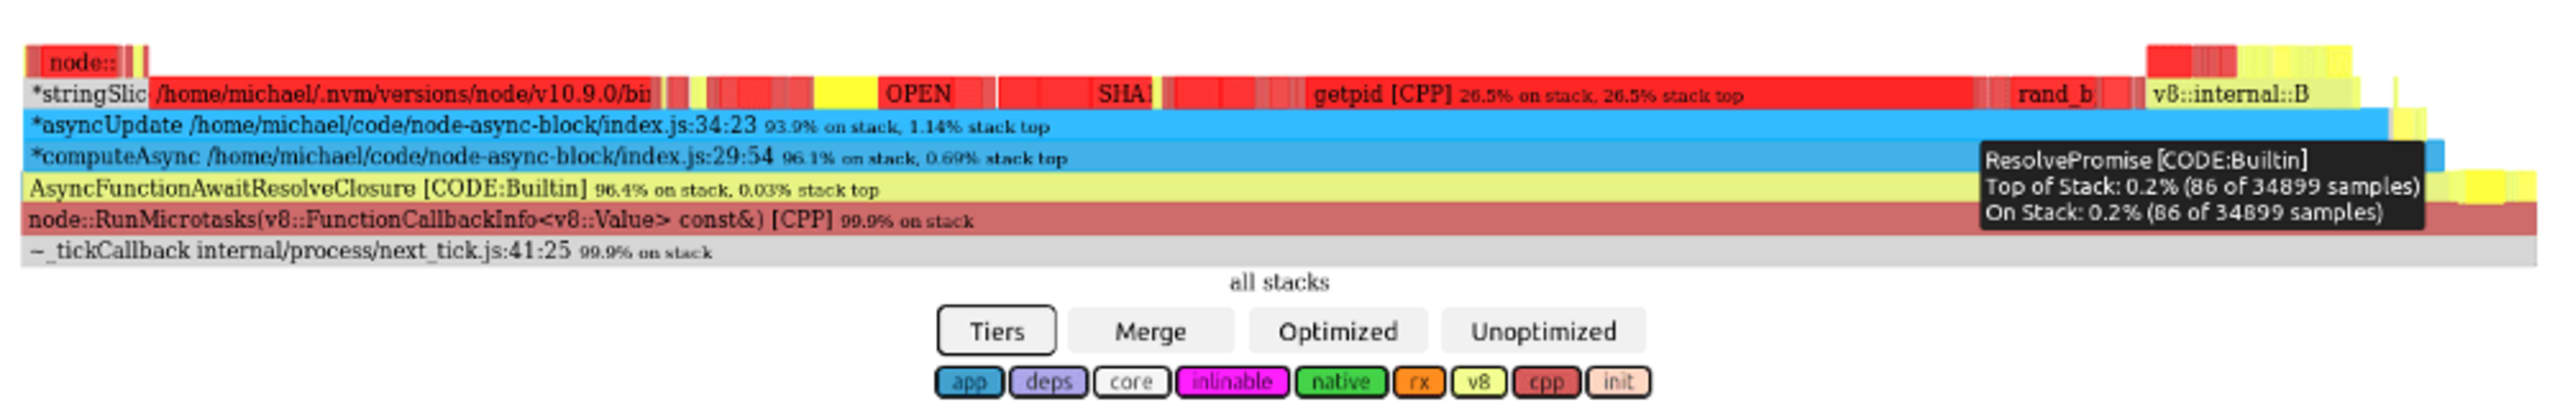
Por otro lado, el gráfico de llamas de /compute-async se ve muy distinto: se ejecuta en el contexto de las funciones RunMicrotask y AsyncFunctionAwaitResolveClosure de V8. Así que no… no parece que se haya “optimizado y eliminado” async/await.
Antes de profundizar más, probemos una última solución desesperada que a veces usamos los desarrolladores: ¡agregar una llamada para dormir!
Ejecutémoslo:
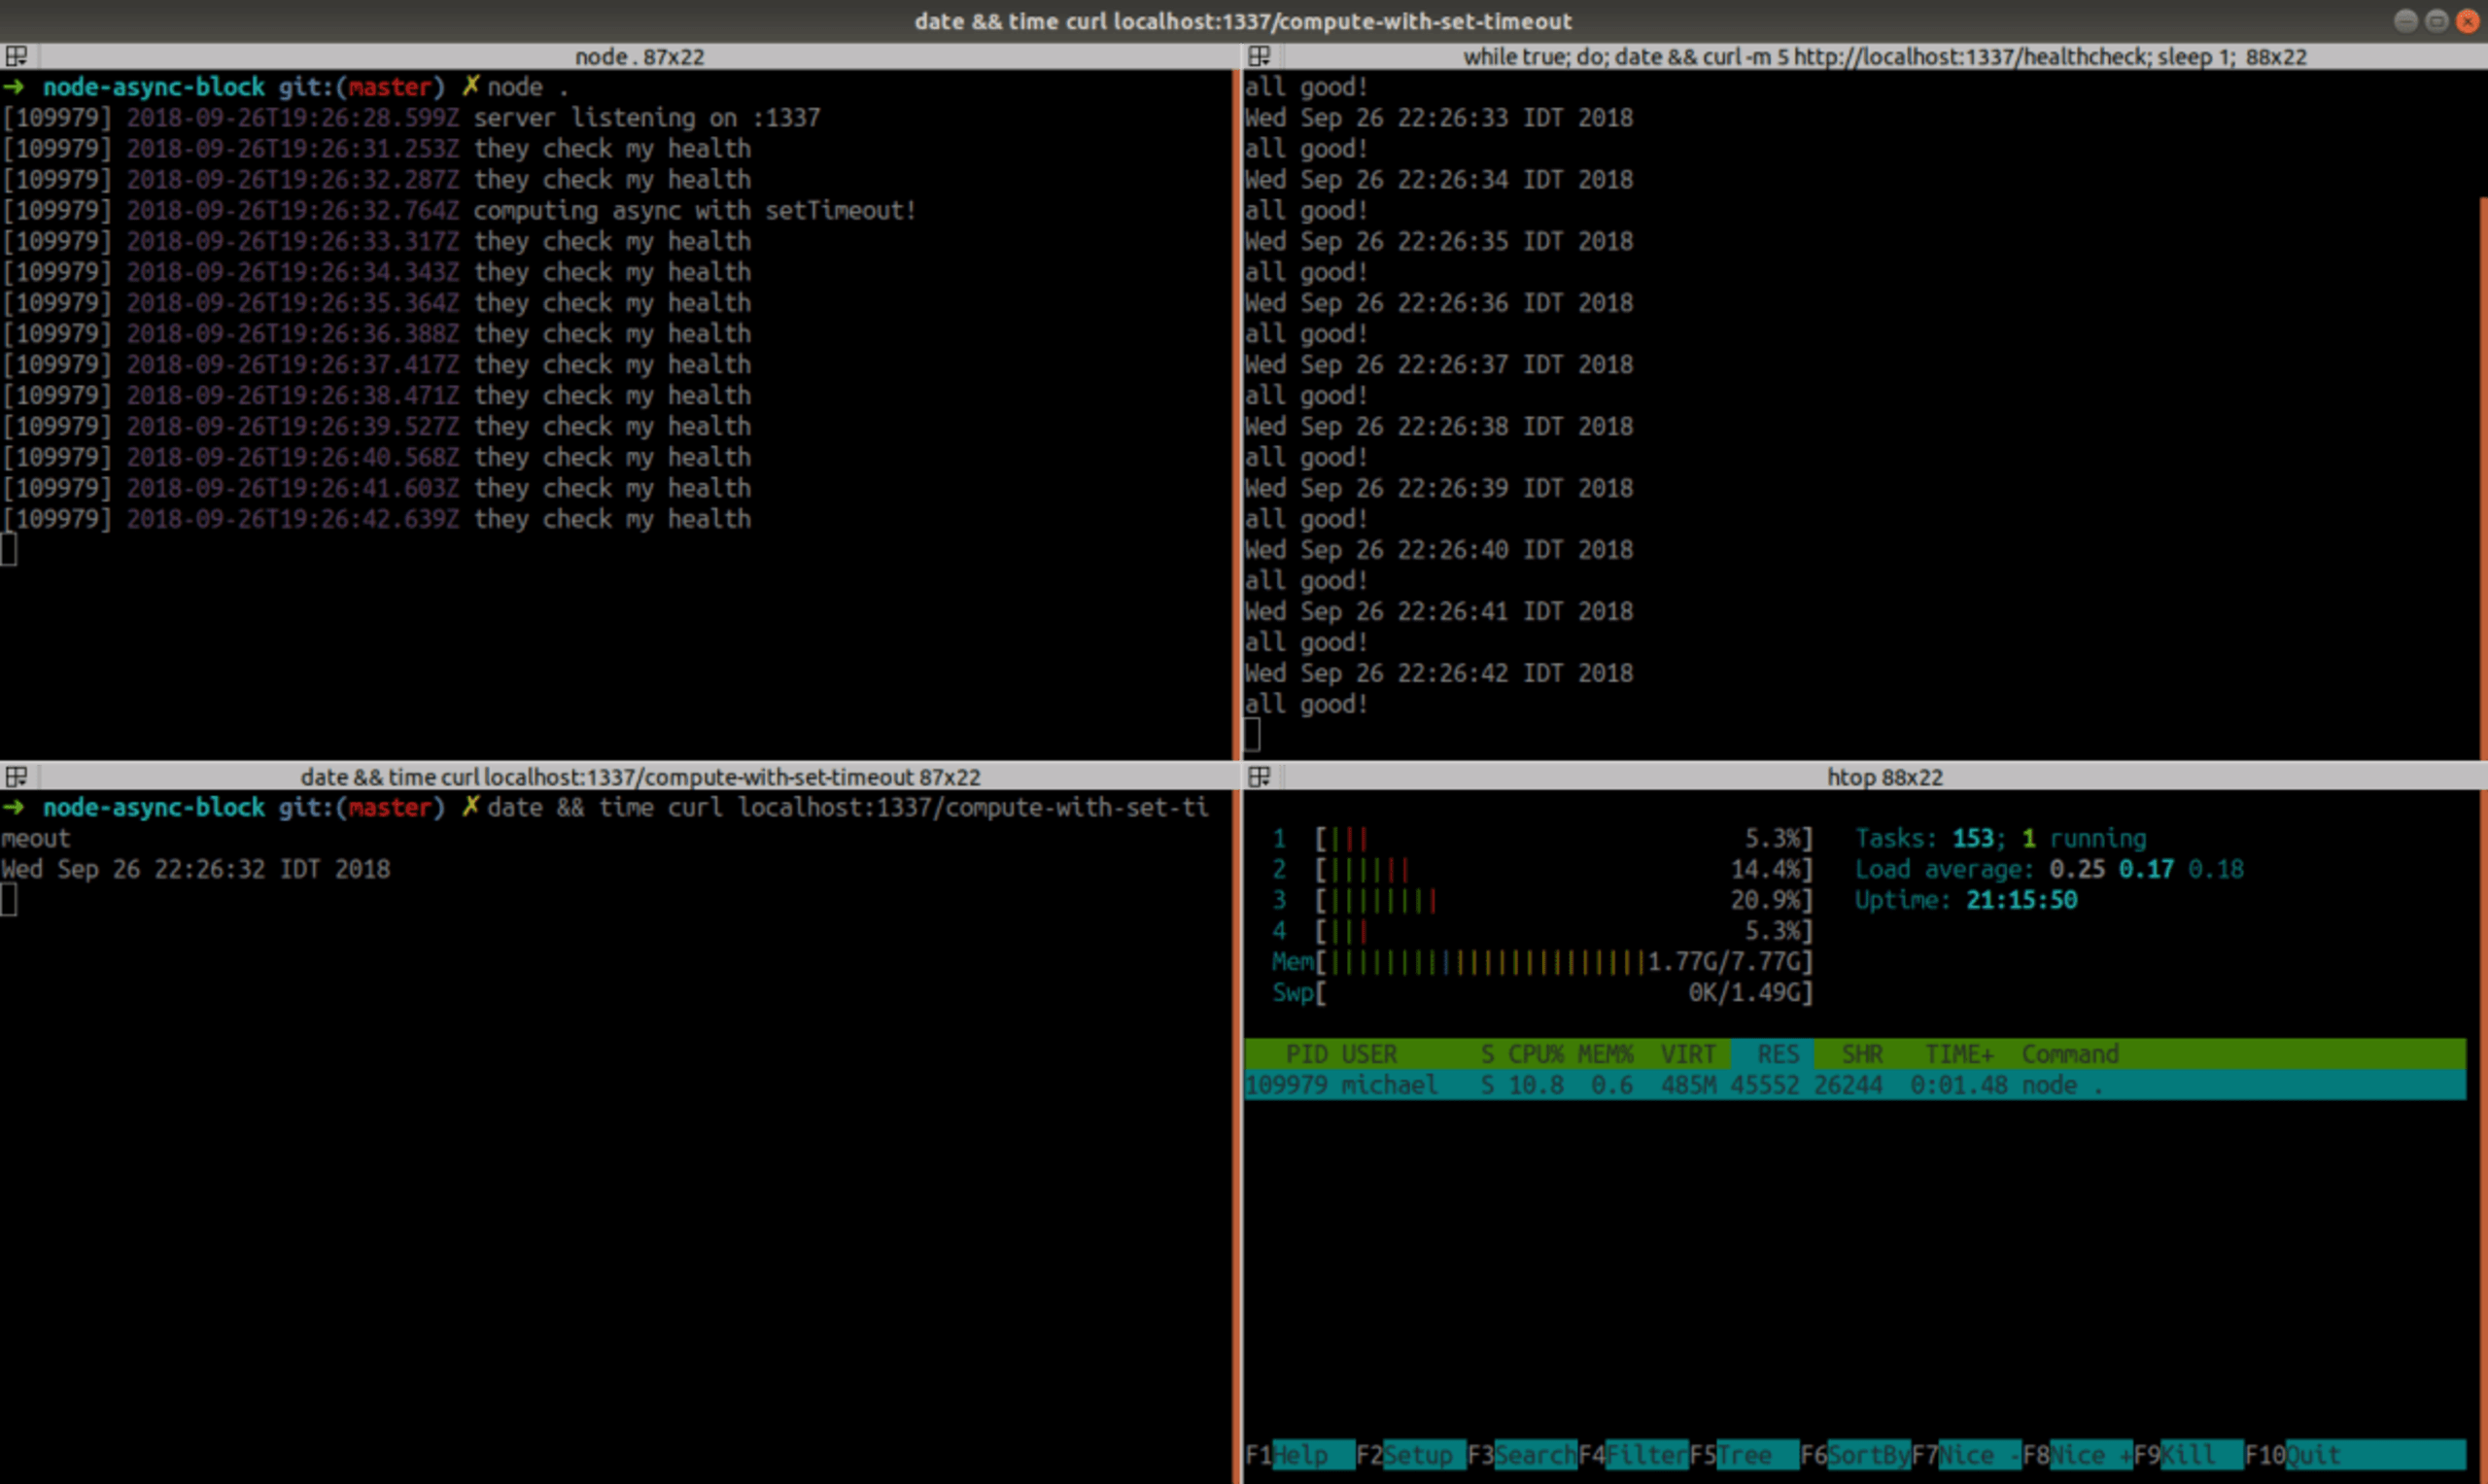
Por fin, el servidor sigue respondiendo durante el cálculo intenso. Por desgracia, el costo de esta solución es demasiado alto: vemos que el uso de CPU es de aproximadamente el 10 %, así que parece que no trabaja lo suficiente en el cálculo, que prácticamente tarda una eternidad en terminar (no tuve paciencia para esperar). Al reducir la cantidad de iteraciones de 10⁷ a 10⁵, terminó en 2:23 minutos. (Por si te lo preguntas, pasar 1 en vez de 0 como parámetro de demora a setTimeout no cambia nada; volveremos a esto más adelante).
Esto plantea varias preguntas:
¿Por qué se bloqueó el código
asyncsin la llamada asetTimeout()?¿Por qué
setTimeout()redujo tanto el rendimiento?¿Cómo podemos desbloquear el cálculo sin esa penalización?
Fases del bucle de eventos
Cuando me pasó algo parecido, recurrí a Google en busca de respuestas. Al buscar algo como “node async block event loop”, uno de los primeros resultados es este recurso oficial de Node.js. Me abrió los ojos.
Explica que el bucle de eventos no es el planificador mágico que imaginaba, sino un bucle bastante sencillo con varias fases. Aquí tienes un buen diagrama ASCII de las fases principales, tomado de la guía:
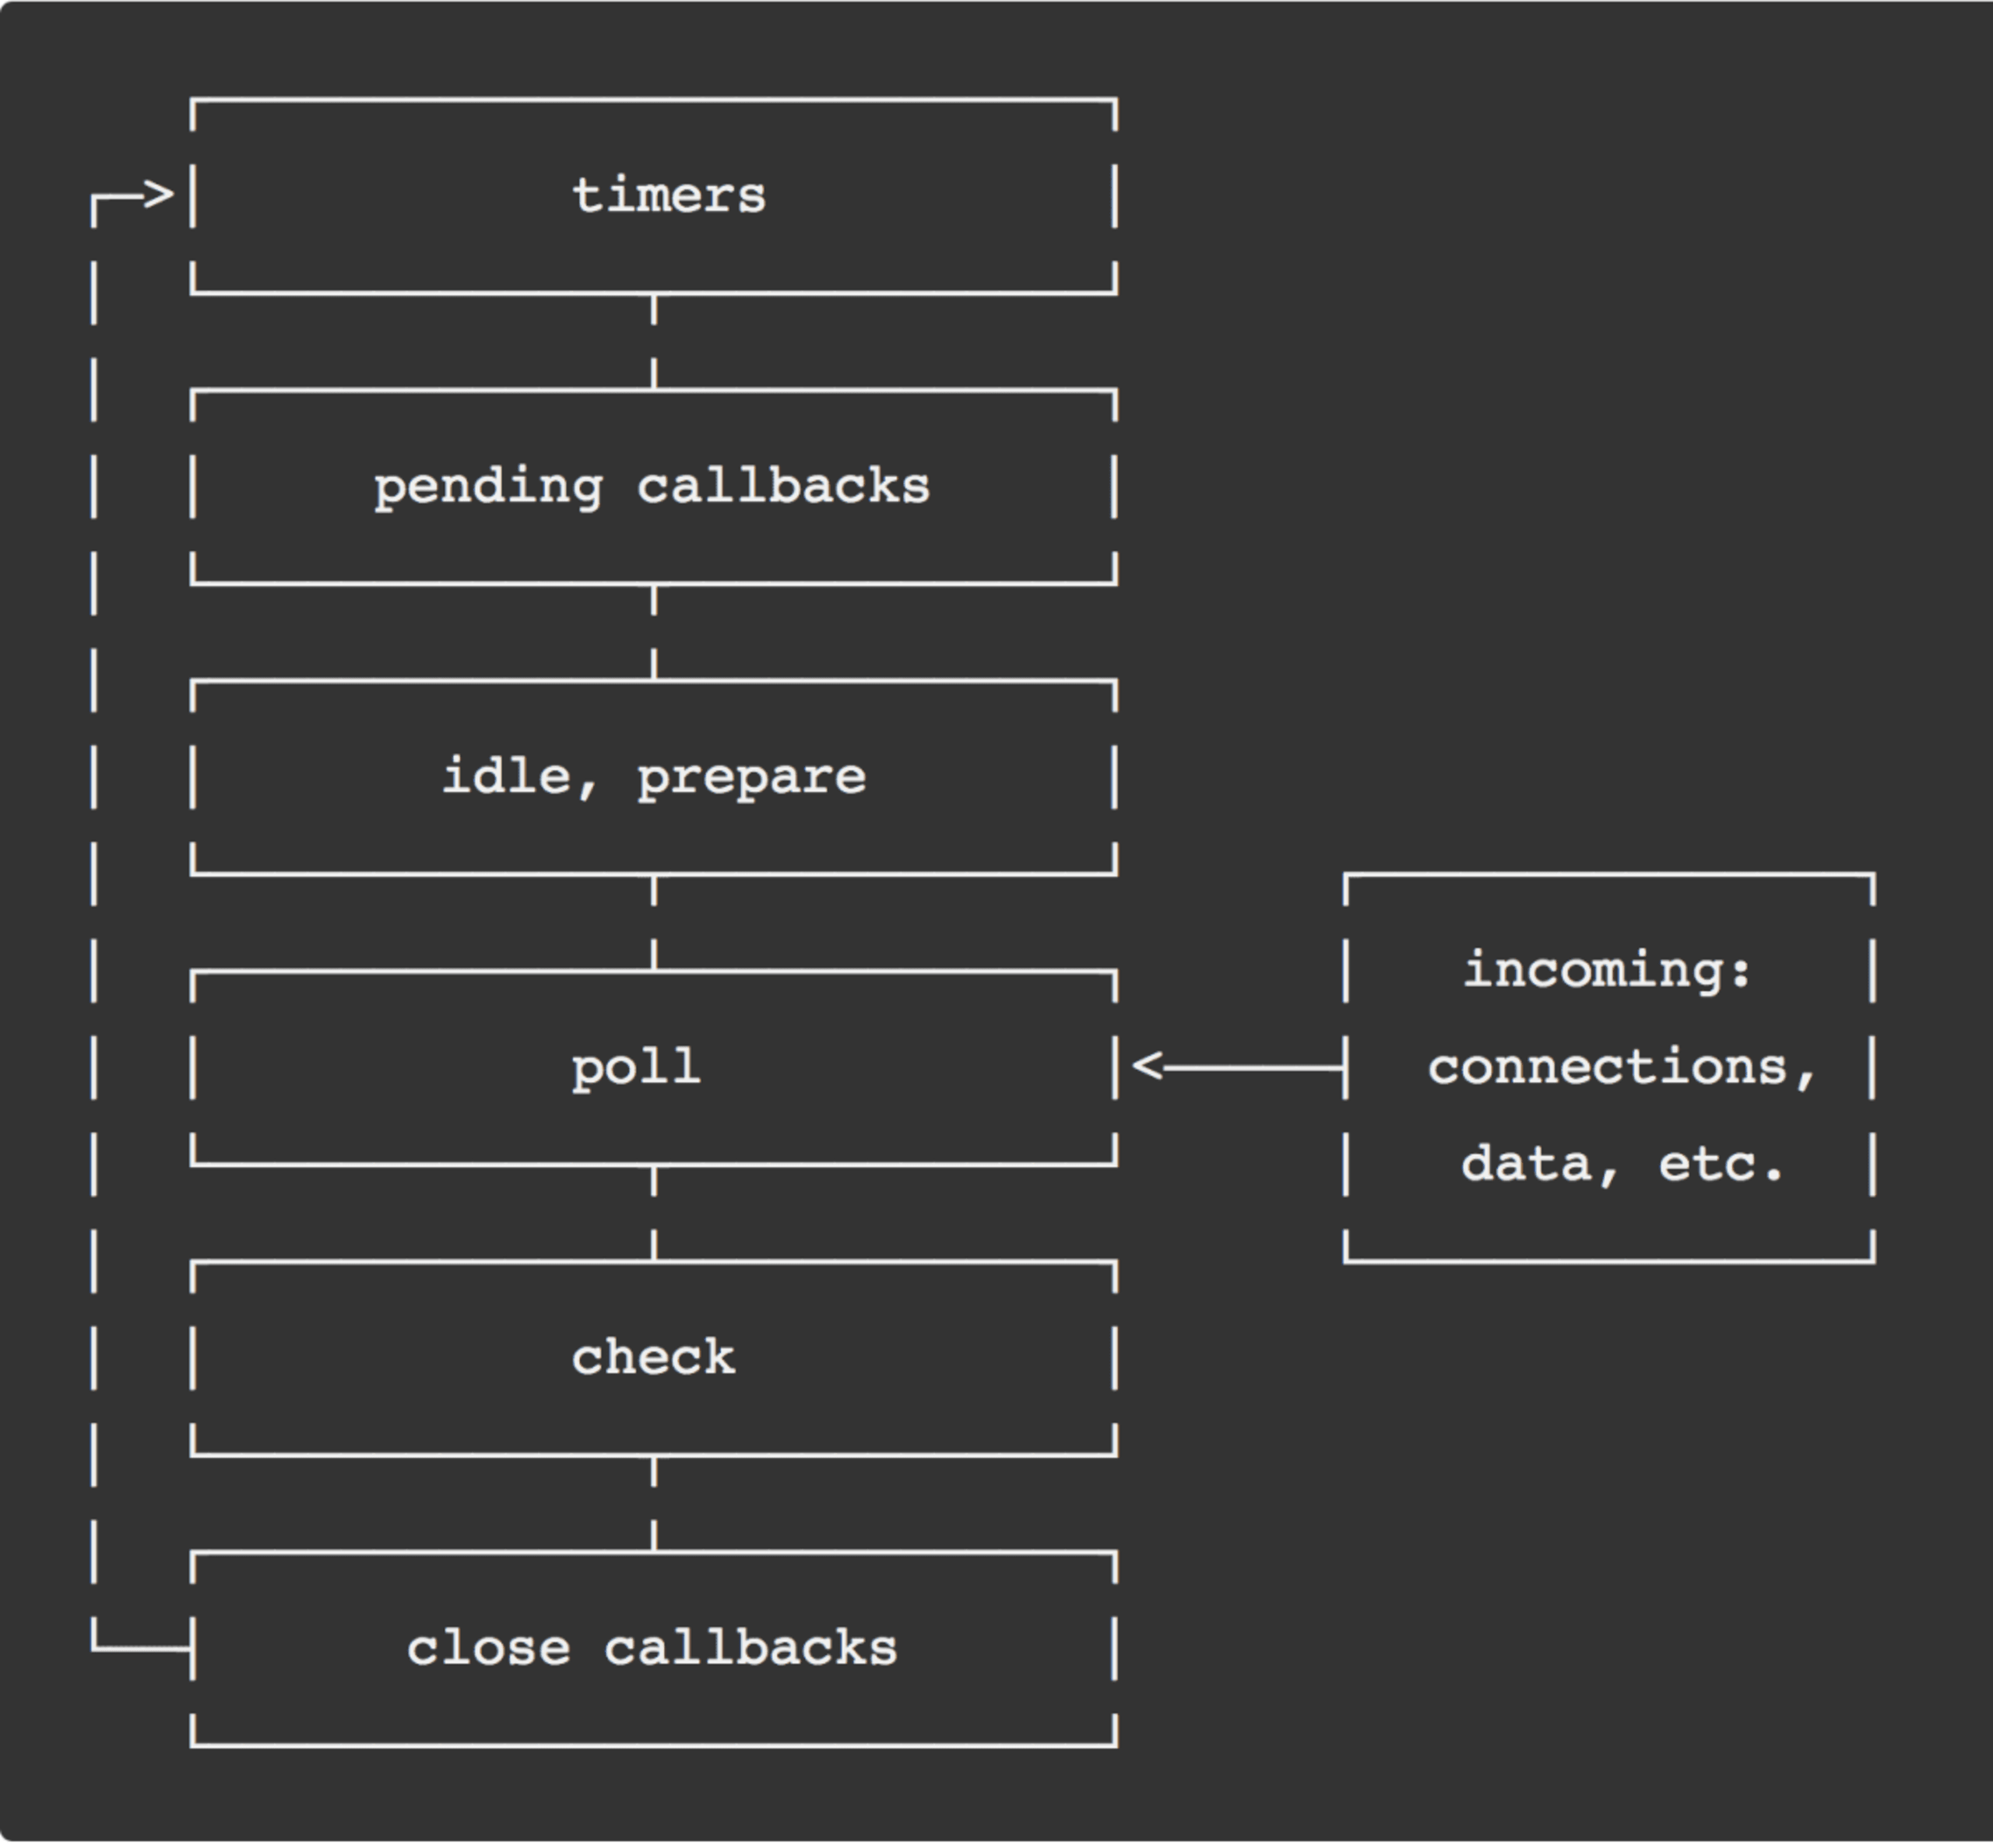
(Más adelante descubrí que este bucle está implementado muy bien en libuv, con funciones cuyos nombres coinciden con los del diagrama: https://github.com/libuv/libuv/blob/v1.22.0/src/unix/core.c#L359)
La guía explica las distintas fases y ofrece el siguiente resumen:
timers: esta fase ejecuta los callbacks programados por
setTimeout()ysetInterval().pending callbacks: ejecuta los callbacks de E/S aplazados a la siguiente iteración del bucle.
idle, prepare: solo se usan internamente.
poll: obtiene nuevos eventos de E/S y ejecuta los callbacks relacionados con E/S.
check: aquí se invocan los callbacks de
setImmediate().close callbacks: algunos callbacks de cierre, por ejemplo,
socket.on('close', ...).
Esta cita empieza a responder nuestra pregunta:
“En general, cuando el bucle de eventos entra en una fase determinada, realiza las operaciones específicas de esa fase y luego ejecuta los callbacks de la cola de esa fase hasta que se agota… Como cualquiera de estas operaciones puede programar más operaciones…”.
Esto sugiere (de manera algo imprecisa) que, cuando un callback agrega otro callback que puede manejarse en la misma fase, este se ejecutará antes de pasar a la siguiente fase.
Node.js solo revisa el socket de red en busca de nuevas solicitudes durante la fase poll. ¿Significa eso que lo que hicimos en /compute-async impidió que el bucle de eventos saliera de cierta fase y, por lo tanto, nunca pasara por la fase poll para recibir siquiera la solicitud /healthcheck?
Tendremos que investigar más para encontrar mejores respuestas, pero ahora está muy claro por qué setTimeout() ayudó: cada vez que agregamos un callback de temporizador y se agota la cola de la fase actual, el bucle de eventos tiene que recorrer todas las fases hasta llegar a la fase “Timers”, pasando por la fase poll y procesando las solicitudes de red pendientes.
Microtareas
Las palabras clave async/await que usamos en /compute-async son azúcar sintáctica alrededor de las Promise. Así que, en realidad, en cada iteración del bucle creamos una Promise (que es una operación asíncrona) para calcular un hash y, cuando se resuelve, el bucle continúa con la siguiente iteración. La guía oficial mencionada no explica cómo se manejan las Promise dentro de las fases del bucle de eventos, pero nuestros experimentos sugieren que tanto el callback de Promise como el callback de resolve se invocaron sin pasar por la fase poll.
Tras seguir buscando en Google, encontré una serie de cinco artículos más detallada y muy bien escrita sobre el bucle de eventos, de Deepal Jayasekara, que también explica cómo se manejan las Promise.
Incluye este útil diagrama:
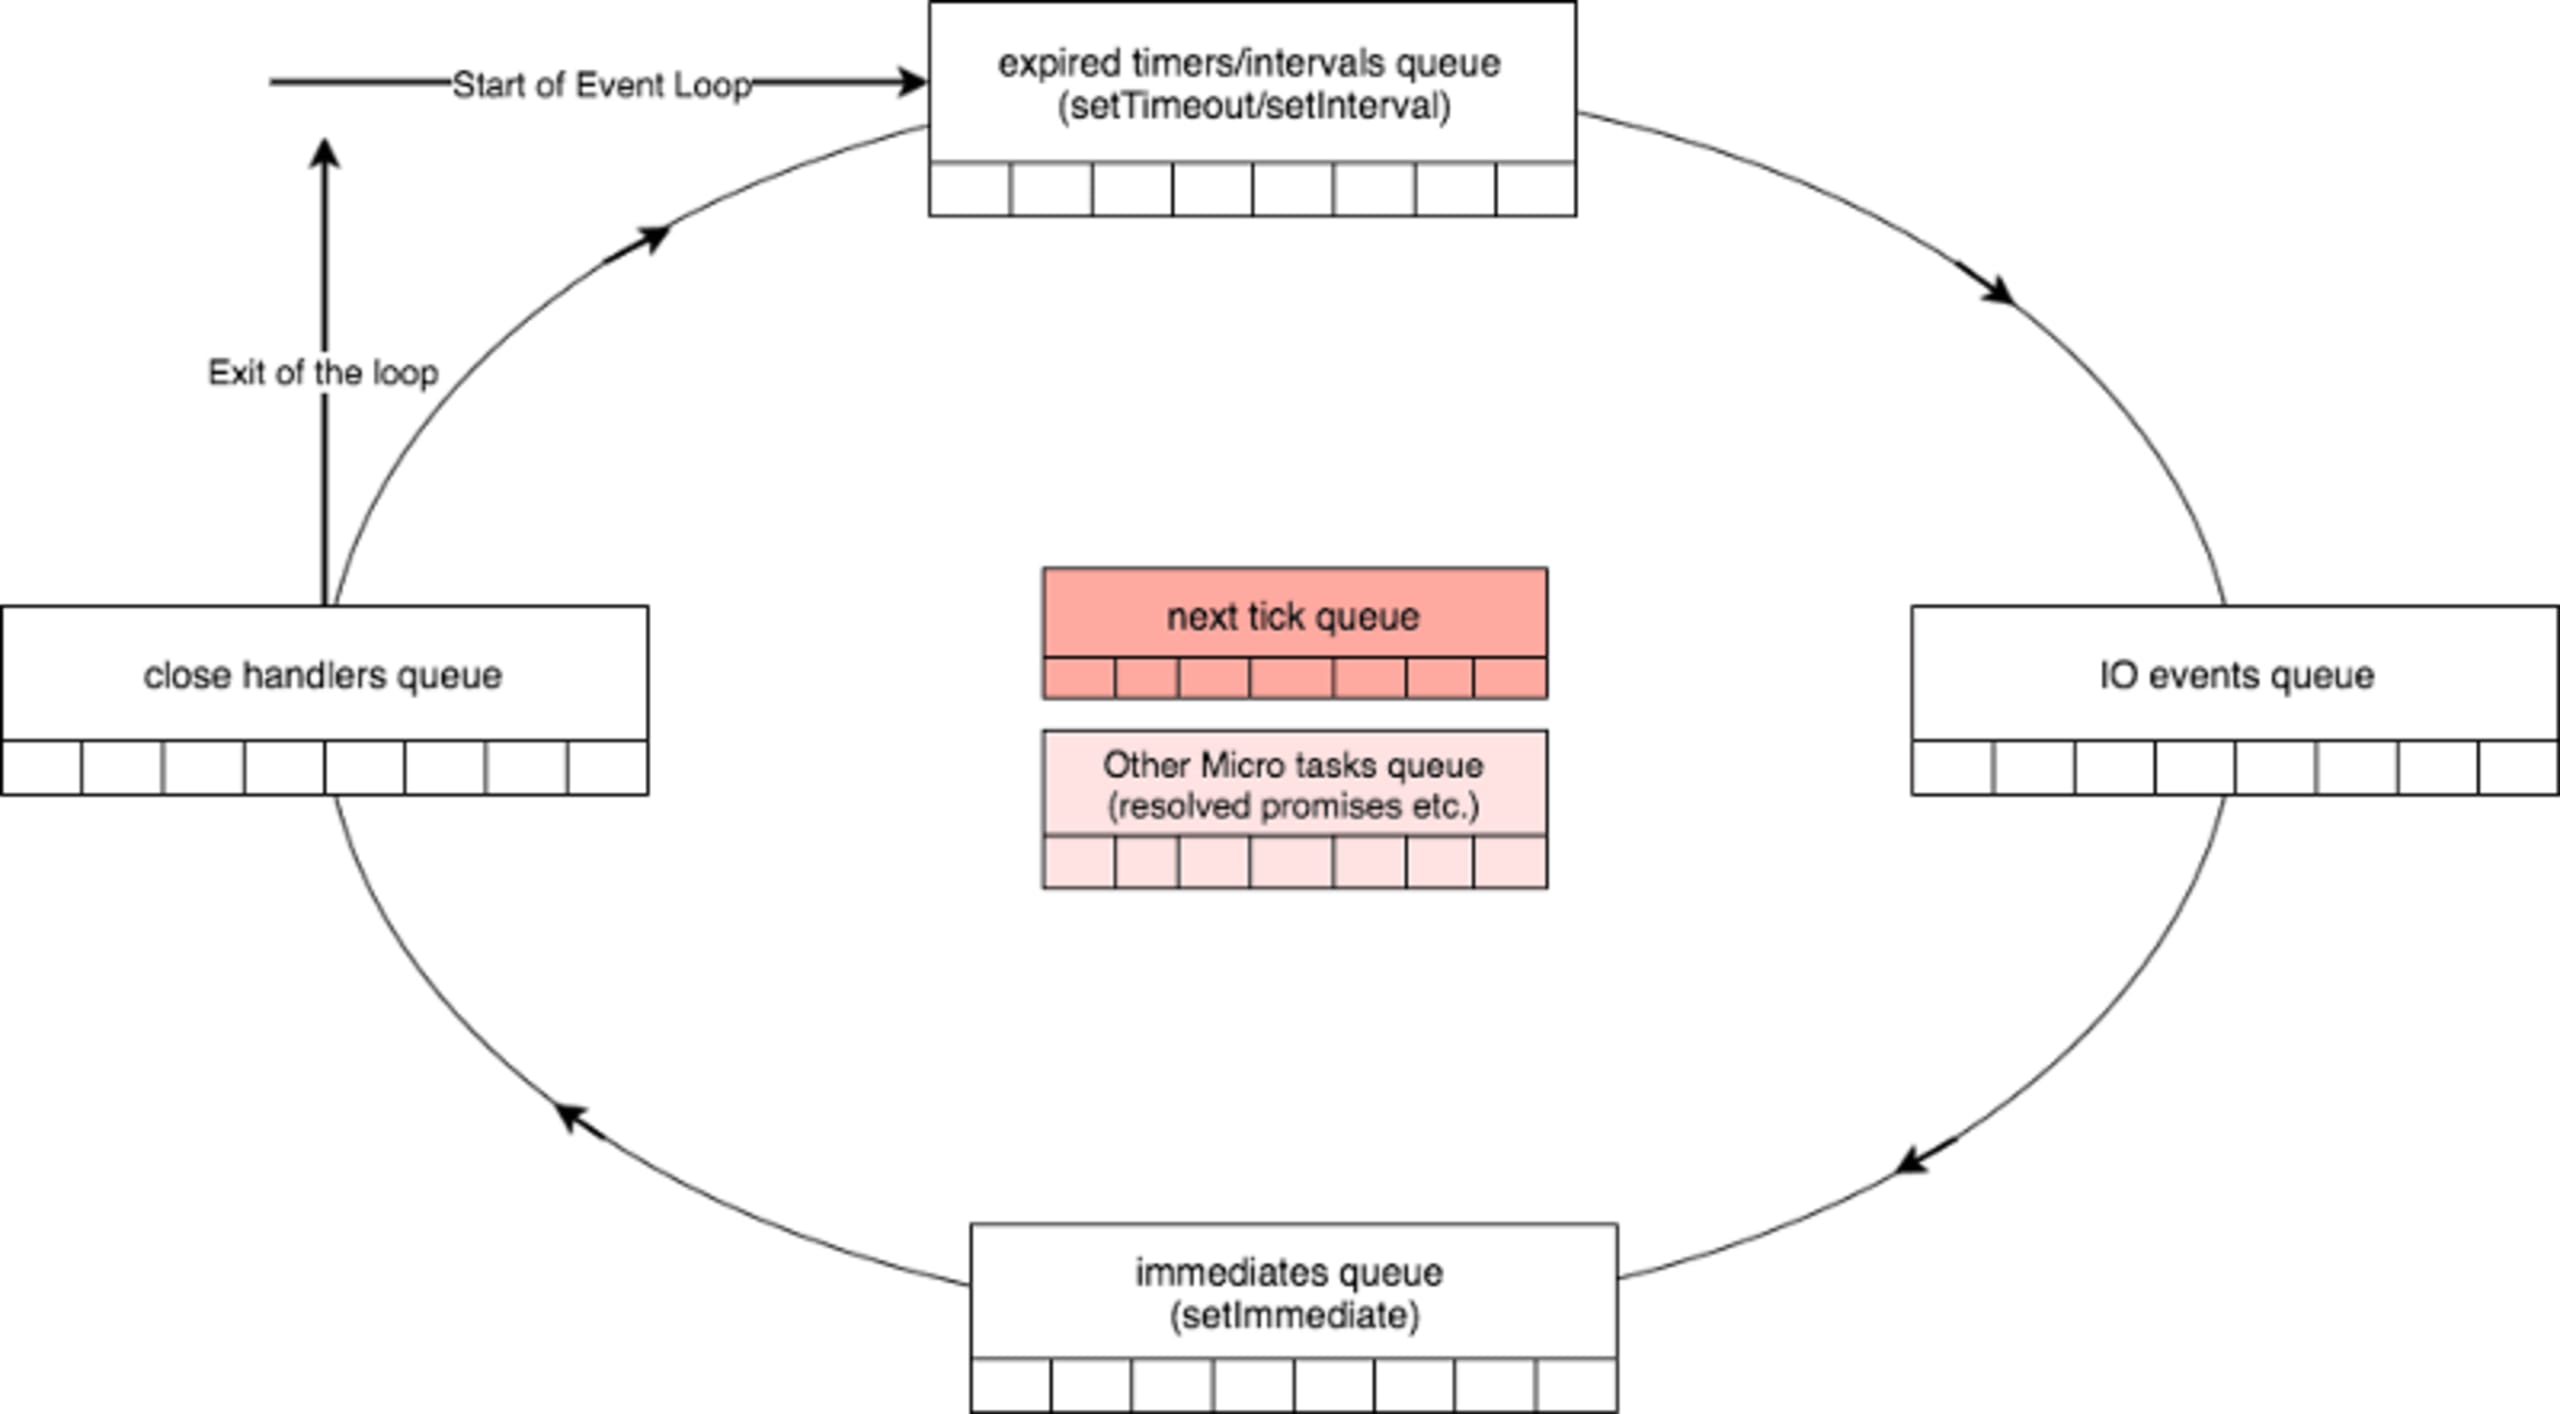
Los cuadros alrededor del círculo representan las colas de las distintas fases que vimos antes; los dos cuadros del centro representan dos colas especiales que deben agotarse antes de pasar de una fase a otra. La “cola del siguiente tick” procesa los callbacks registrados mediante nextTick(), y la “cola de otras microtareas” responde nuestra pregunta sobre las Promise.
Y en nuestro caso, si una Promise resuelta crea otra Promise, ¿se manejará en la misma fase antes de pasar a la siguiente? Como vimos, ¡la respuesta es sí! Puedes ver cómo ocurre en el código fuente de V8. Este enlace lleva a la implementación de RunMicrotask(). Aquí tienes un fragmento con las líneas relevantes:
Este código C se ve extraño y ejecuta bucles mediante las funciones y macros de bajo nivel Goto() y Branch(), que parecen mágicas, porque está escrito con “CodeStubAssembly” de V8, un “ensamblador personalizado e independiente de la plataforma que ofrece primitivas de bajo nivel como una capa ligera de abstracción sobre el ensamblador”.
En el gist podemos ver un bucle externo llamado init_queue_loop y uno interno llamado loop. El bucle externo comprueba la cantidad real de microtareas pendientes; luego, el interno las procesa una por una. Cuando termina, como se ve en la línea 62 del gist anterior, vuelve a iterar el bucle externo, que comprueba otra vez la cantidad real de microtareas pendientes. La función solo retorna si no se agregó ninguna nueva.
Si quieres ver cómo se procesan las microtareas al final de cada fase del bucle de eventos, te recomiendo leer otro excelente artículo de Deepal Jayasekara.
(Por cierto, ¿recuerdas el gráfico de llamas que creamos para /compute-async? Si vuelves a mirar más arriba, reconocerás RunMicrotasks() en la pila).
Ten en cuenta también que las microtareas son una característica de V8, así que esto también aplica a Chrome, donde las Promise se manejan de la misma manera, sin hacer avanzar el bucle de eventos del navegador.
nextTick() no avanza
La guía de Node.js dice:
los callbacks que se pasan a
process.nextTick()se resolverán antes de que continúe el bucle de eventos. Esto puede generar situaciones problemáticas porque permite “dejar sin recursos” las operaciones de E/S si se hacen llamadas recursivas aprocess.nextTick()
Esta vez el texto es bastante claro, así que te ahorraré otra captura de la terminal. Pero puedes probarlo con una solicitud GET /compute-with-next-tick en node async block.
La cola de nextTick se procesa aquí.
Está claro que, si callback llama a otro process.nextTick(), el bucle procesará el siguiente callback en la misma iteración y solo se detendrá cuando la cola de nextTick esté vacía.
¿setImmediate() al rescate?
Entonces, las Promise son rojas y los temporizadores son azules… ¿qué más podemos hacer?
En los diagramas anteriores, ambos muestran la cola de setImmediate(), que se procesa durante la fase “check”, justo después de la fase “poll”. La guía oficial de Node.js también dice:
setImmediate()ysetTimeout()son similares, pero se comportan de manera diferente según cuándo se los llame…
La principal ventaja de usar
setImmediate()en lugar desetTimeout()es quesetImmediate()siempre se ejecutará antes que cualquier temporizador si se programa dentro de un ciclo de E/S, independientemente de cuántos temporizadores haya.
Suena bien, pero la cita más prometedora es:
Si la fase poll queda inactiva y hay scripts programados con
setImmediate(), el bucle de eventos puede continuar a la fase check en lugar de esperar.
¿Recuerdas que, cuando usamos setTimeout(), el proceso estuvo casi inactivo (es decir, esperando) y usó alrededor del 10 % de CPU? Veamos si setImmediate() lo soluciona:
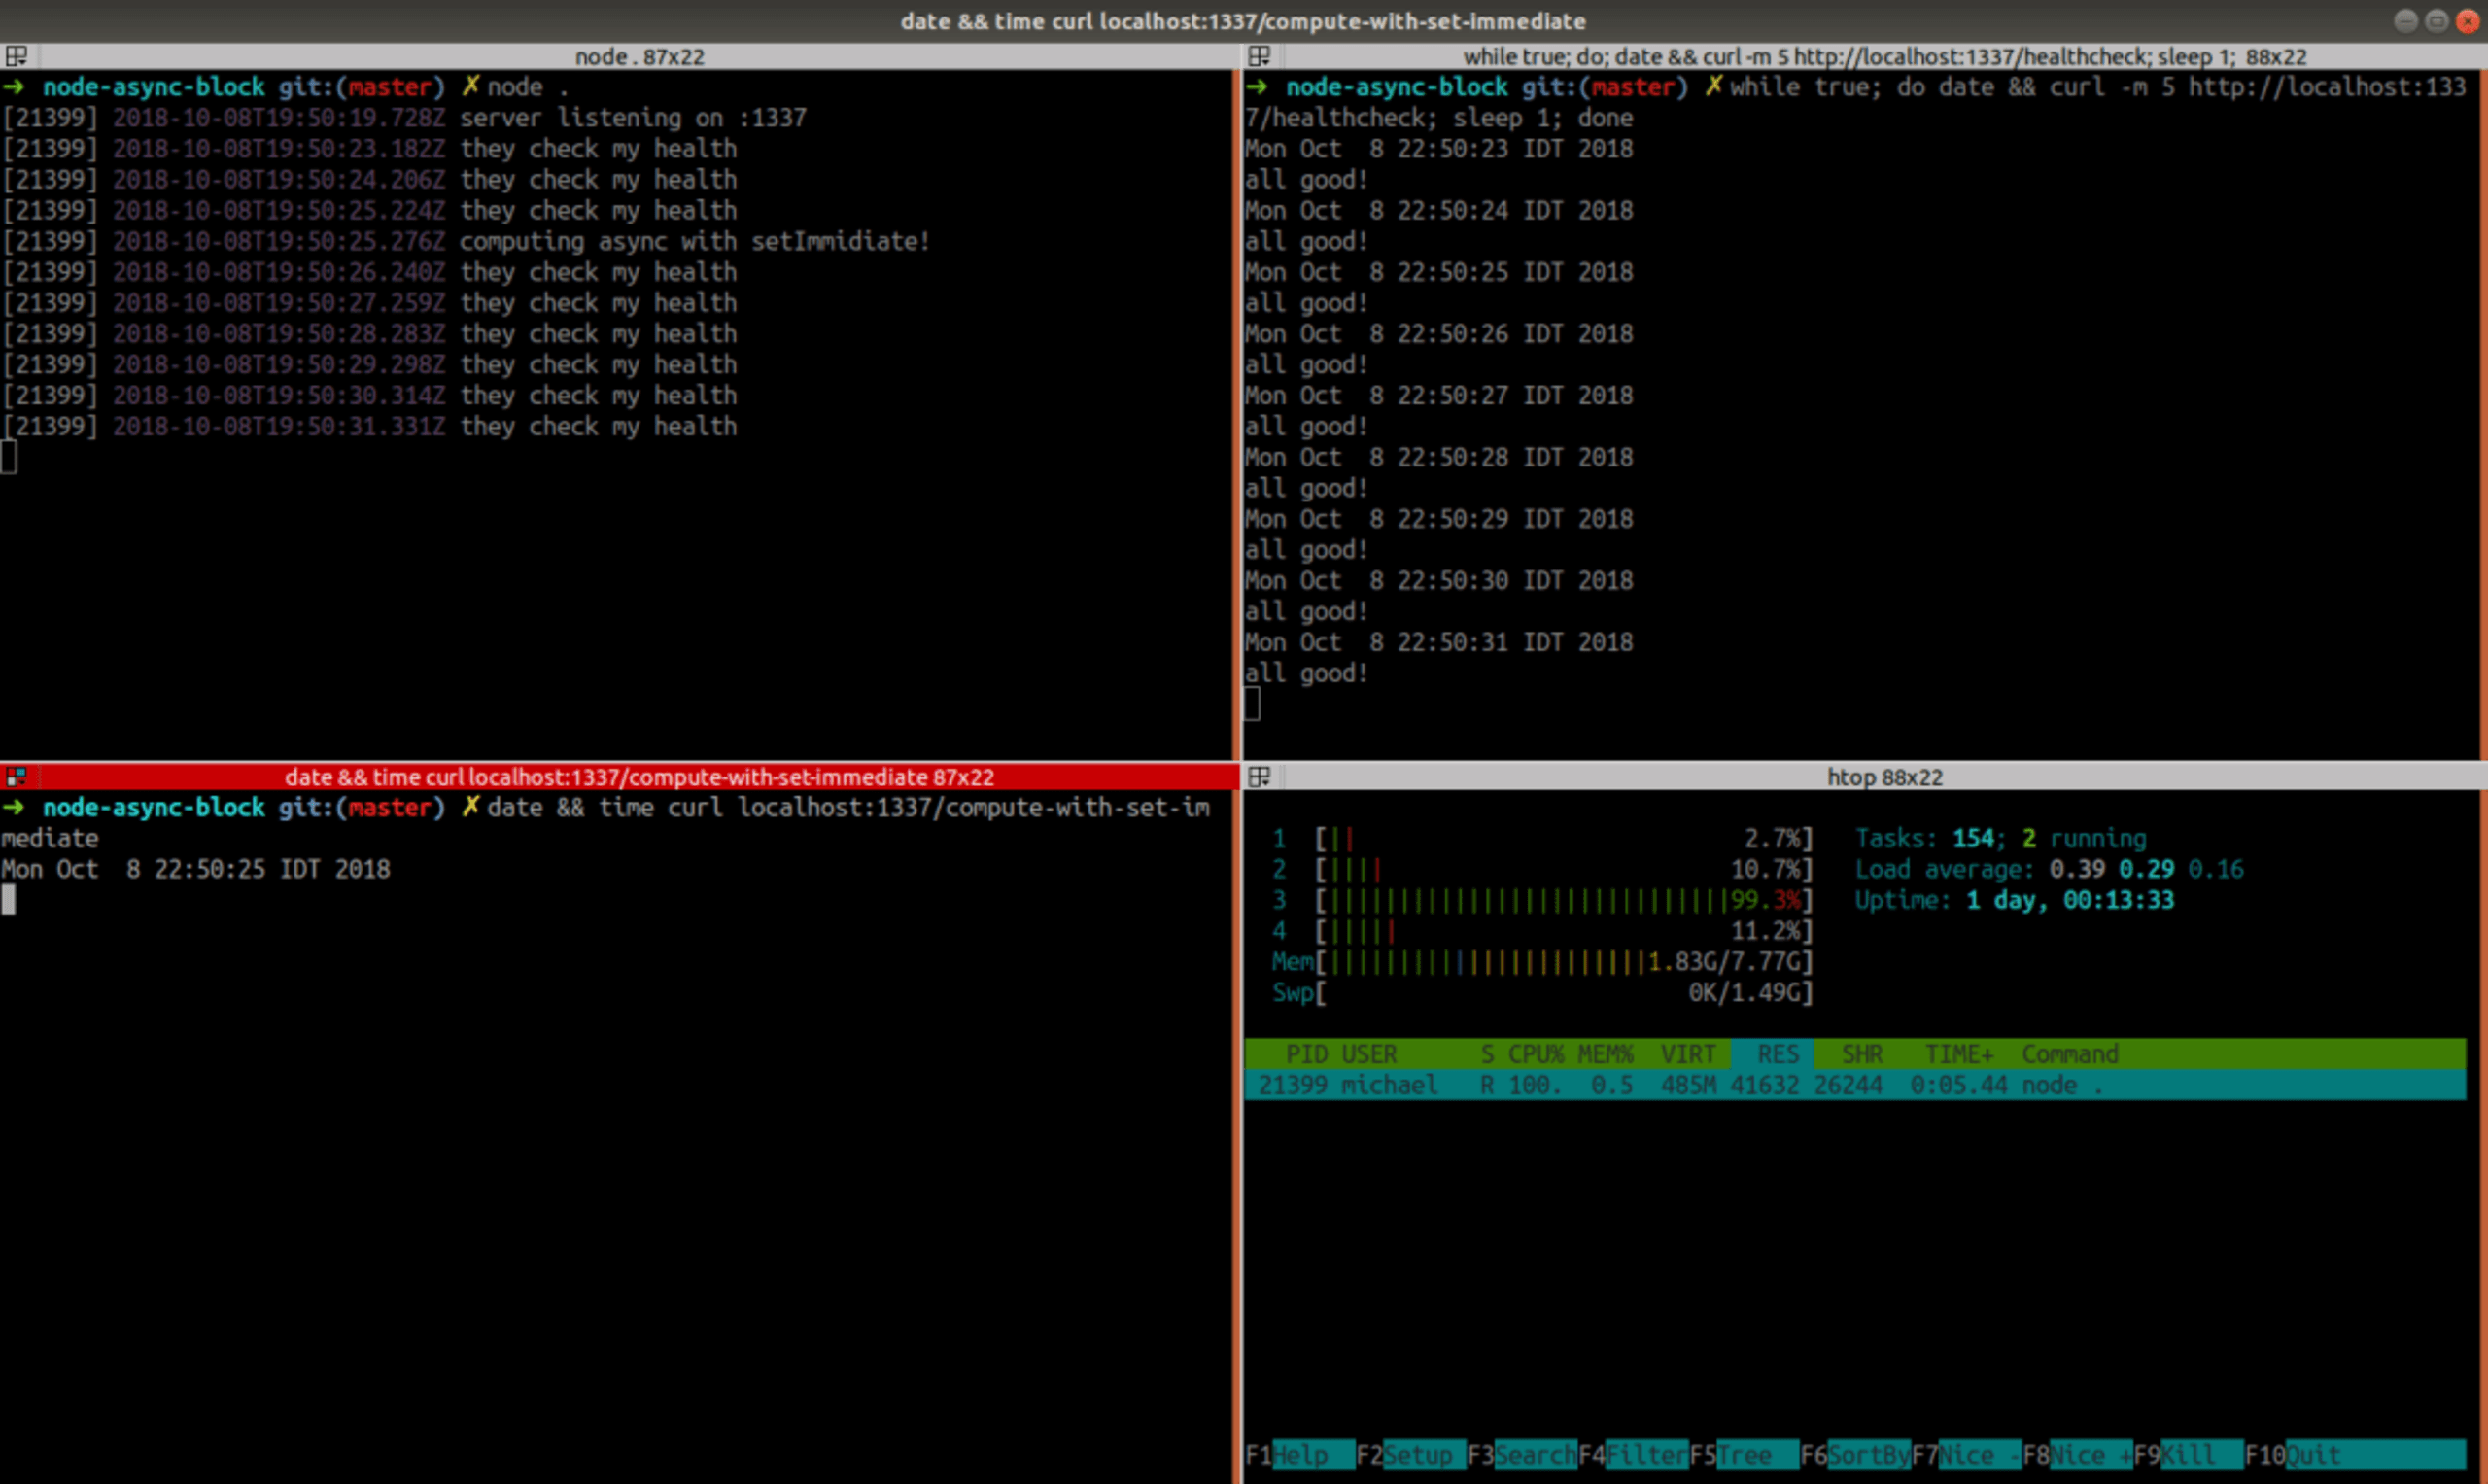
¡Genial! No bloquea el servidor y la CPU está al 100 %. Veamos cuánto tarda en completarse:
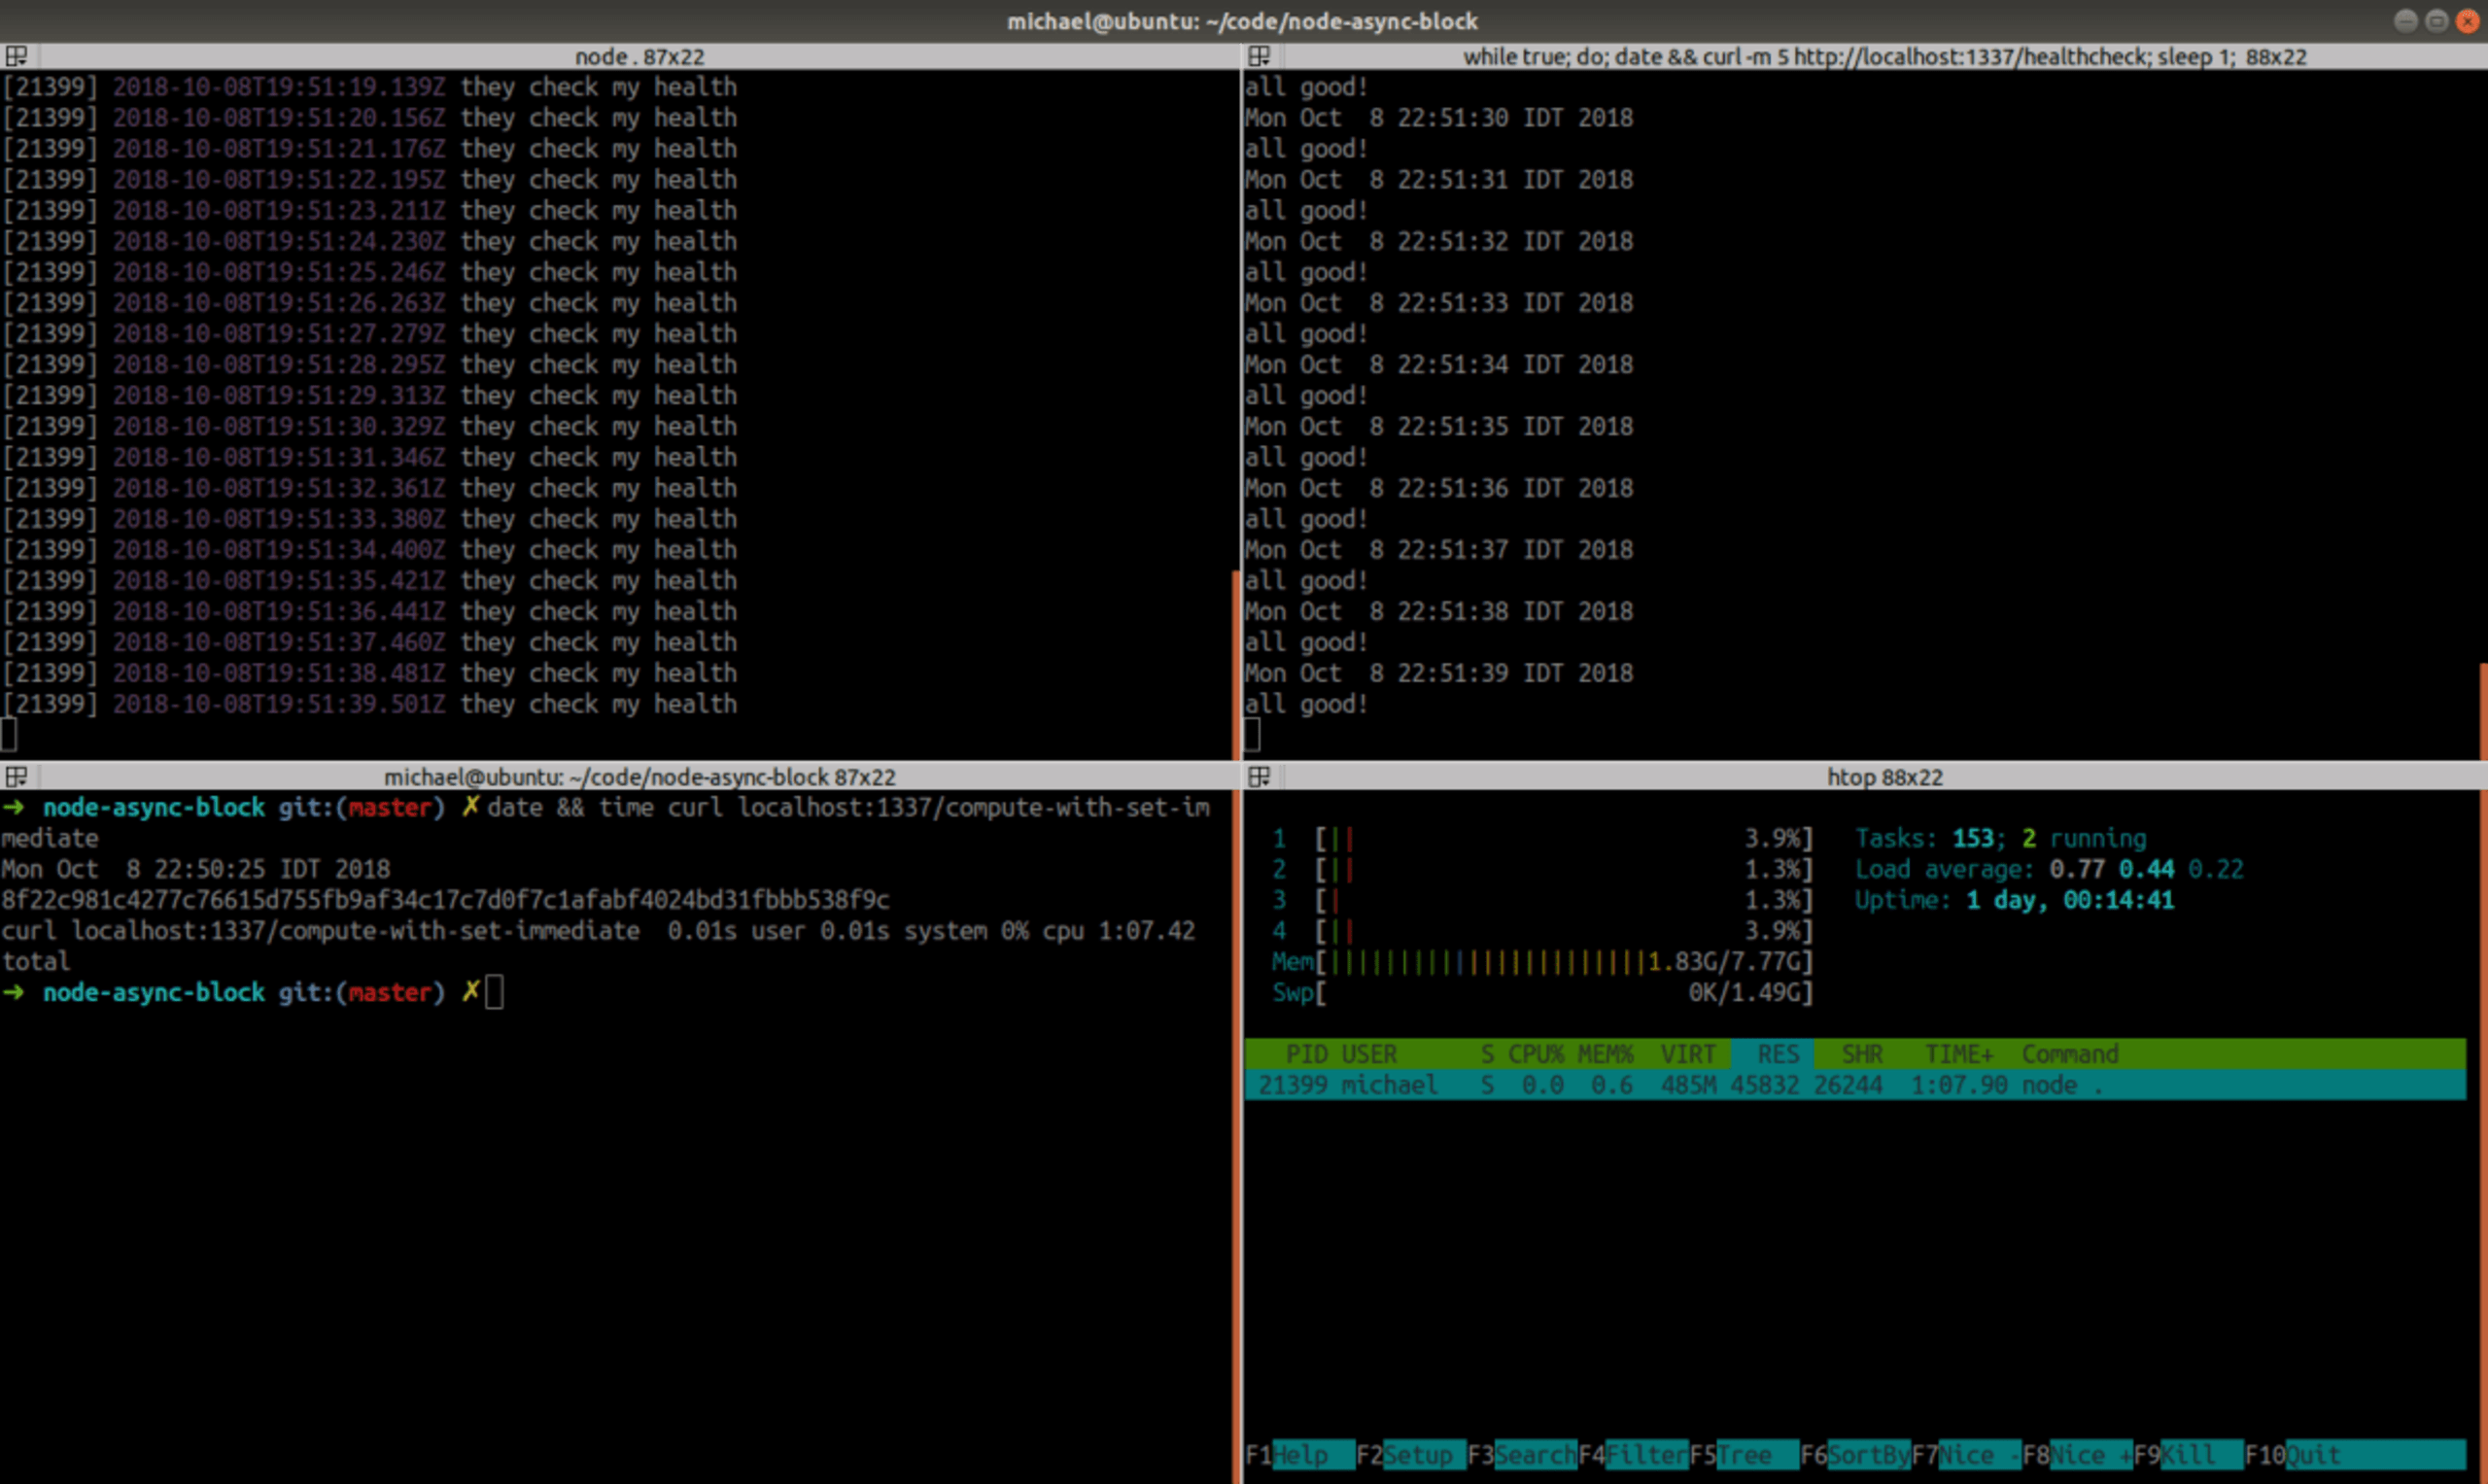
Muy bien. Se completó en 1:07 minutos, aproximadamente un 50 % más que /compute-sync y un 34 % más que /compute-async , pero se puede usar, a diferencia de /compute-with-set-timeout. Dado que es un ejemplo de juguete en el que usamos setImmediate() en cada una de las 10⁷ iteraciones pequeñas, lo que probablemente resultó en 10⁷ ciclos completos del bucle de eventos, esta ralentización es bastante comprensible. Entonces, ¿programar un setImmediate() desde una devolución de llamada de setImmediate() no hace que permanezca en la misma fase? Así es: la documentación de Node.js lo dice claramente:
Si se pone en cola un temporizador immediate desde una devolución de llamada en ejecución, ese temporizador no se activará hasta la siguiente iteración del bucle de eventos.
Al comparar setImmediate() con process.nextTick(), la guía de Node.js dice:
Recomendamos que los desarrolladores usen
setImmediate()en todos los casos…
Ya te acostumbraste a las referencias al código, así que, para no decepcionarte, creo que este es el código que ejecuta las devoluciones de llamada de setImmediate(): por cierto, un dato interesante que se menciona en la parte 3 de la serie de Deepal es que Bluebird, una popular biblioteca no nativa de Promise, usa setImmediate() para programar las devoluciones de llamada de Promise.
Reflexiones finales
(Casi, ya que sigue una sección adicional sobre setTimeout() ) Así que setImmediate() parece ser una solución funcional para dividir código síncrono de larga ejecución. Pero no siempre es fácil hacerlo, ni hacerlo bien. Cada cesión a setImmediate() tiene una sobrecarga, y cuantos más solicitudes estén pendientes, más tardará en completarse la tarea de larga ejecución. Por eso, dividir demasiado el código es problemático, y hacerlo muy poco puede bloquearlo durante demasiado tiempo. En algunos casos, el código que bloquea no es un bucle sencillo como el de nuestro ejemplo, sino una recursión que recorre una estructura compleja, y se vuelve más difícil encontrar el lugar y la condición adecuados para ceder el control. Una posible idea en algunos casos es llevar la cuenta del tiempo que se pasa bloqueando antes de ceder el control a setImmediate(). Este fragmento solo cederá el control si han pasado al menos 10 ms desde la última vez:
En otros casos, el código de terceros sobre el que tienes menos control podría bloquear; incluso funciones integradas como JSON.parse() pueden hacerlo.
Una solución más radical es trasladar el código que podría bloquear a otro servicio (que no sea Node.js), a subprocesos (mediante paquetes como tiny-worker) o a hilos reales mediante paquetes como webworker-threads o la función integrada (aún experimental) de hilos de trabajo de Node.js. En muchos casos, esta es la solución adecuada, pero todas estas opciones de traslado también implican el obstáculo de tener que enviar datos serializados de un lado a otro, ya que el código trasladado no puede acceder al contexto del hilo principal (y único) de JS.
Un desafío común a todas estas soluciones es que la responsabilidad de evitar bloqueos recae en cada desarrollador, en lugar de ser responsabilidad del sistema operativo, como sucede con la mayoría de los lenguajes con hilos, o de la máquina virtual en tiempo de ejecución, como en Erlang. No solo es difícil asegurarse de que todos los desarrolladores siempre estén al tanto, sino que muchas veces tampoco es óptimo ceder el control explícitamente desde el código, que carece del contexto y la visibilidad de lo que sucede con otras rutinas y operaciones de E/S pendientes.
El alto rendimiento que permite Node.js, si no se usa con cuidado, puede hacer que muchas solicitudes pendientes queden en fila debido a una sola operación bloqueante. Para avisar al balanceador de carga lo antes posible que un servidor tiene una larga lista de solicitudes demoradas y lograr que dirija las solicitudes a otros nodos, puedes probar paquetes como toobusy-js en tus endpoints de comprobación de estado (esto no ayudará durante el bloqueo en sí…). También es importante monitorear el bucle de eventos en tiempo de ejecución mediante paquetes como blocked-at o soluciones como N|Solid y New-Relic.
Extra: por qué el 0 de setTimeout(0) no es realmente 0
Me daba mucha curiosidad saber por qué setTimeout(0) había dejado el proceso inactivo el 90 % del tiempo, en vez de realizar nuestros cálculos. Una CPU inactiva probablemente significa que el hilo principal de node invocó una llamada al sistema que hizo que suspendiera su ejecución (es decir, que entrara en reposo) durante el tiempo suficiente para que el kernel lo programara y pudiera continuar; esto nos da una pista sobre setTimeout().
Al leer el código fuente de libuv sobre el manejo de temporizadores, parece que el “reposo” real ocurre en uv__io_poll(), como parte de la llamada al sistema poll() a través de su parámetro timeout.
La página de manual de poll() dice:
El argumento
timeoutespecifica la cantidad de milisegundos que poll() debe bloquear mientras espera que un descriptor de archivo esté listo… especificar un valor negativo entimeoutsignifica que el tiempo de espera es infinito. Especificar un valor detimeoutigual a cero hace que poll() regrese de inmediato.
Así que, a menos que el tiempo de espera sea exactamente 0, el proceso entrará en reposo. Sospechamos que, aunque pasemos 0 a setTimeout(), el tiempo de espera que se pasa a poll() es mayor. Podemos intentar validarlo depurando node con gdb.
Podemos rastrear todas las llamadas a uv__io_poll() con el comando gdb de dprintf:
Imprimamos también la hora actual en cada rastreo:
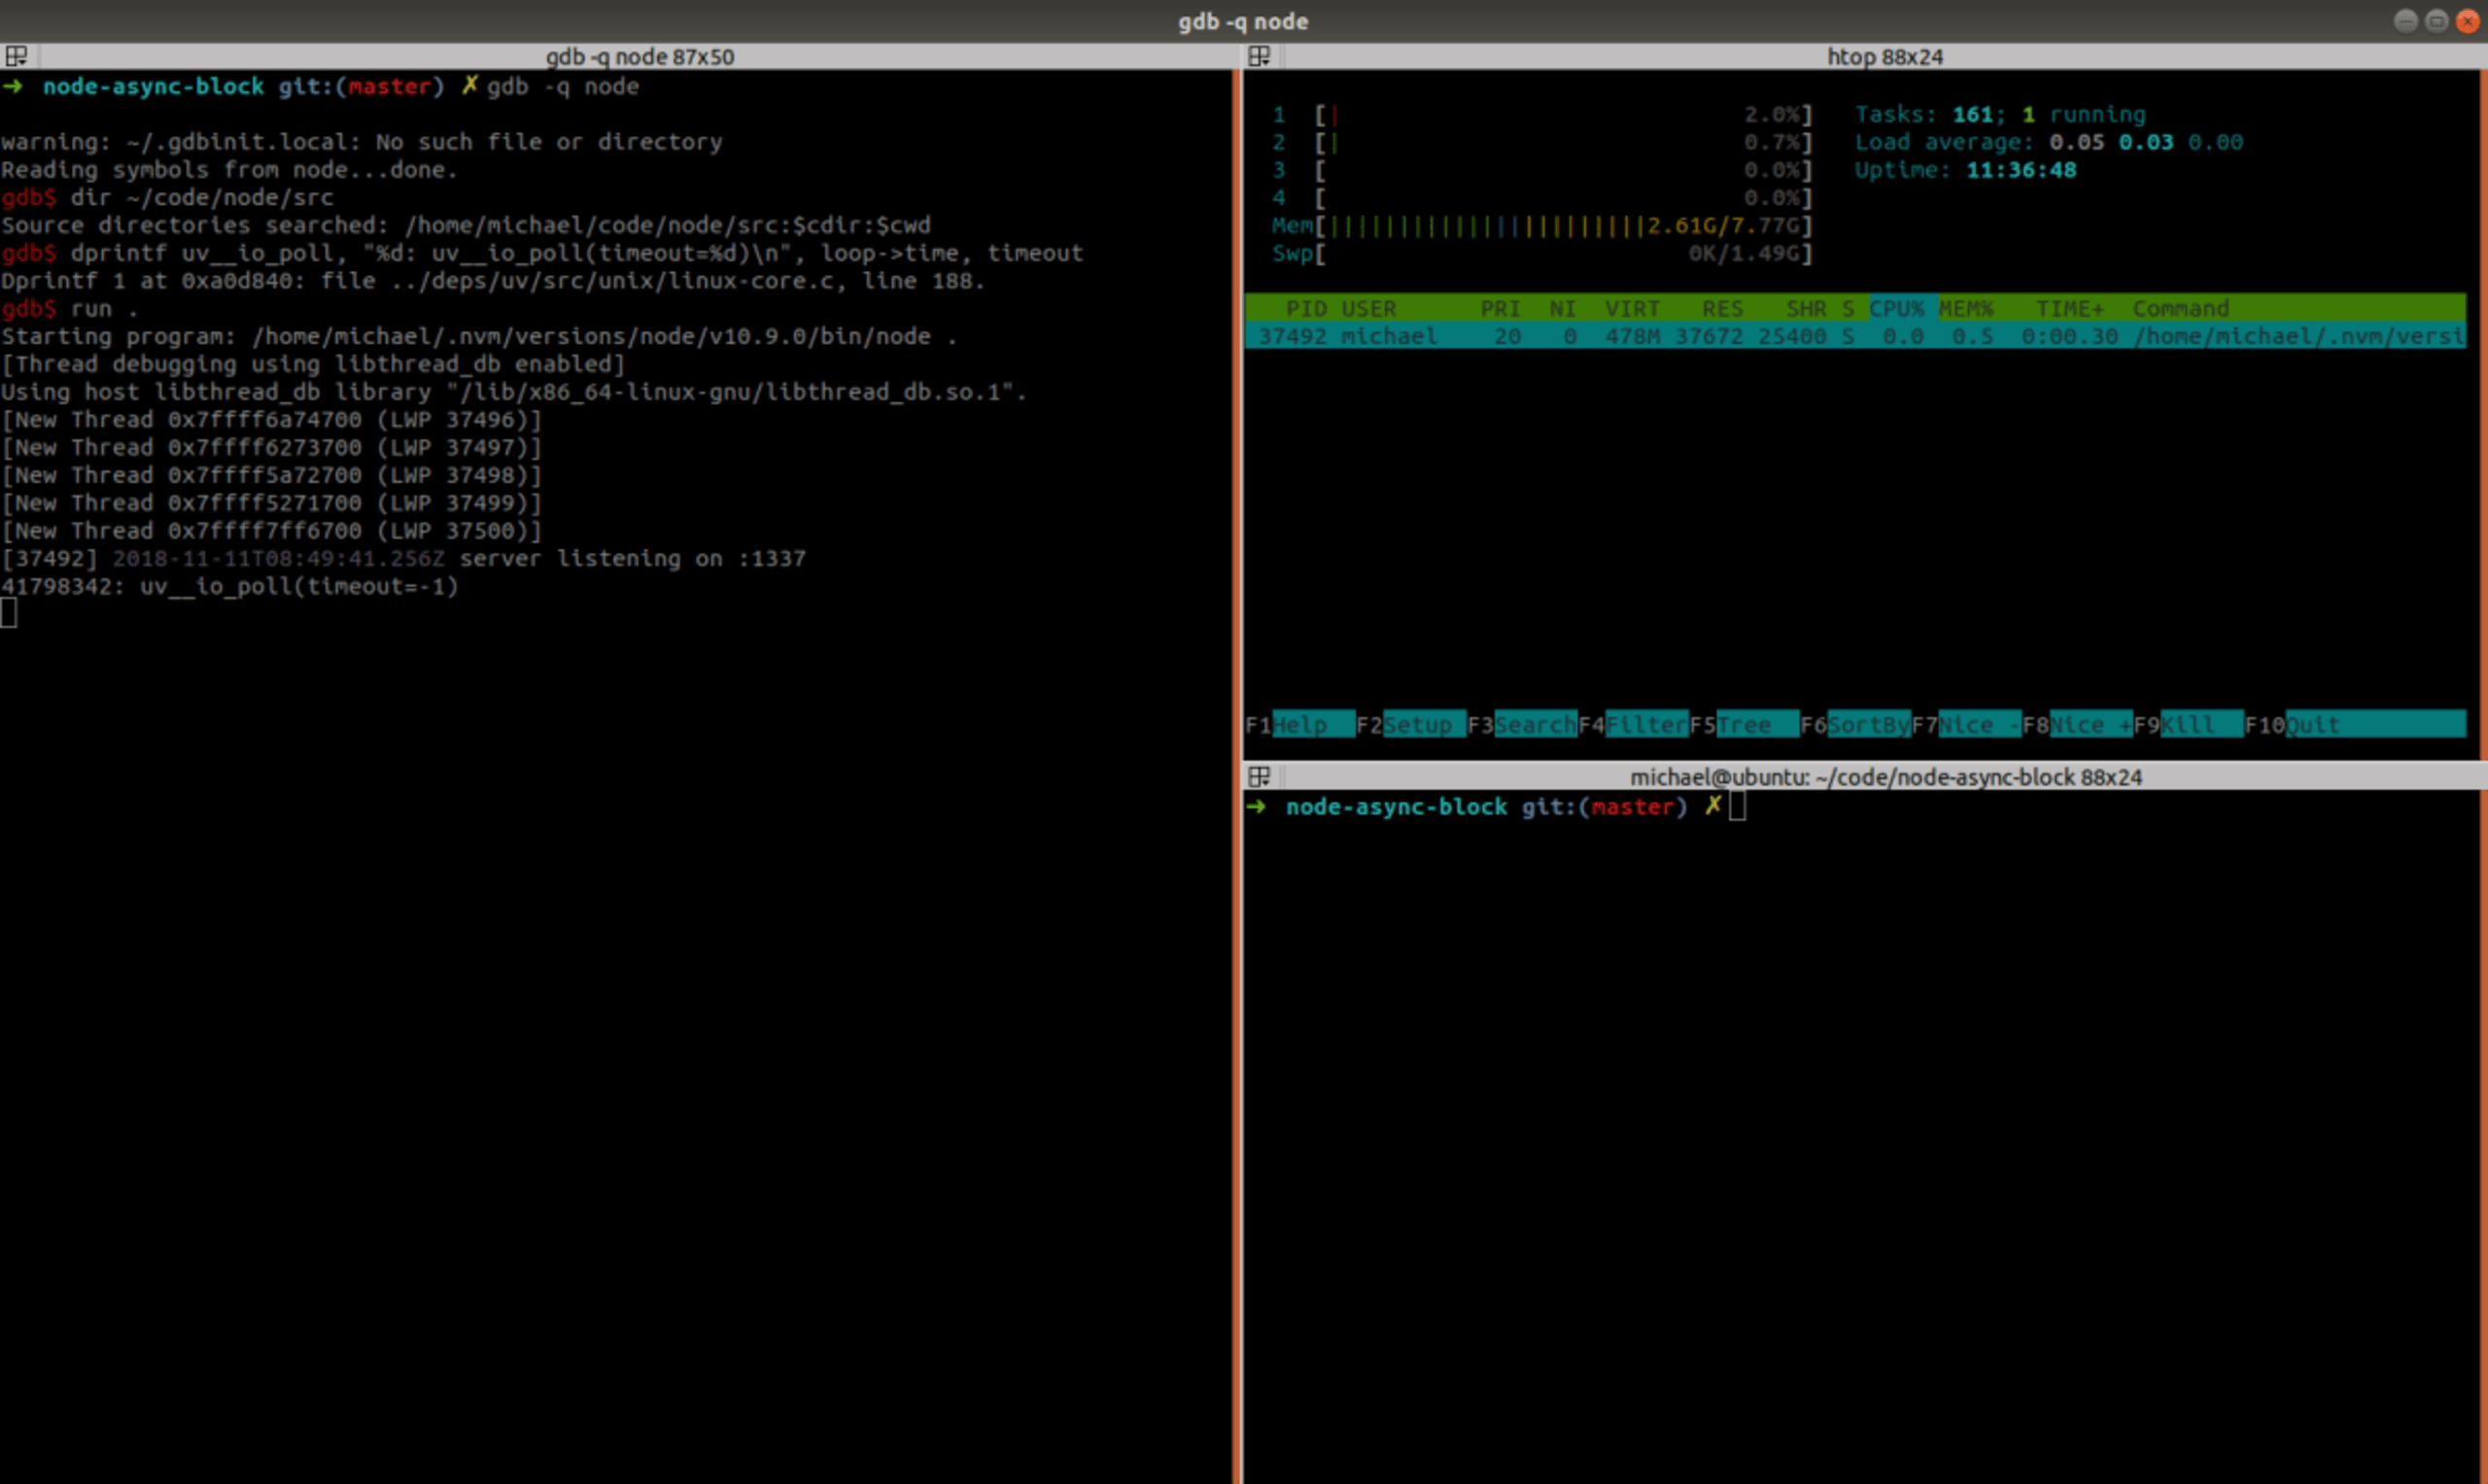
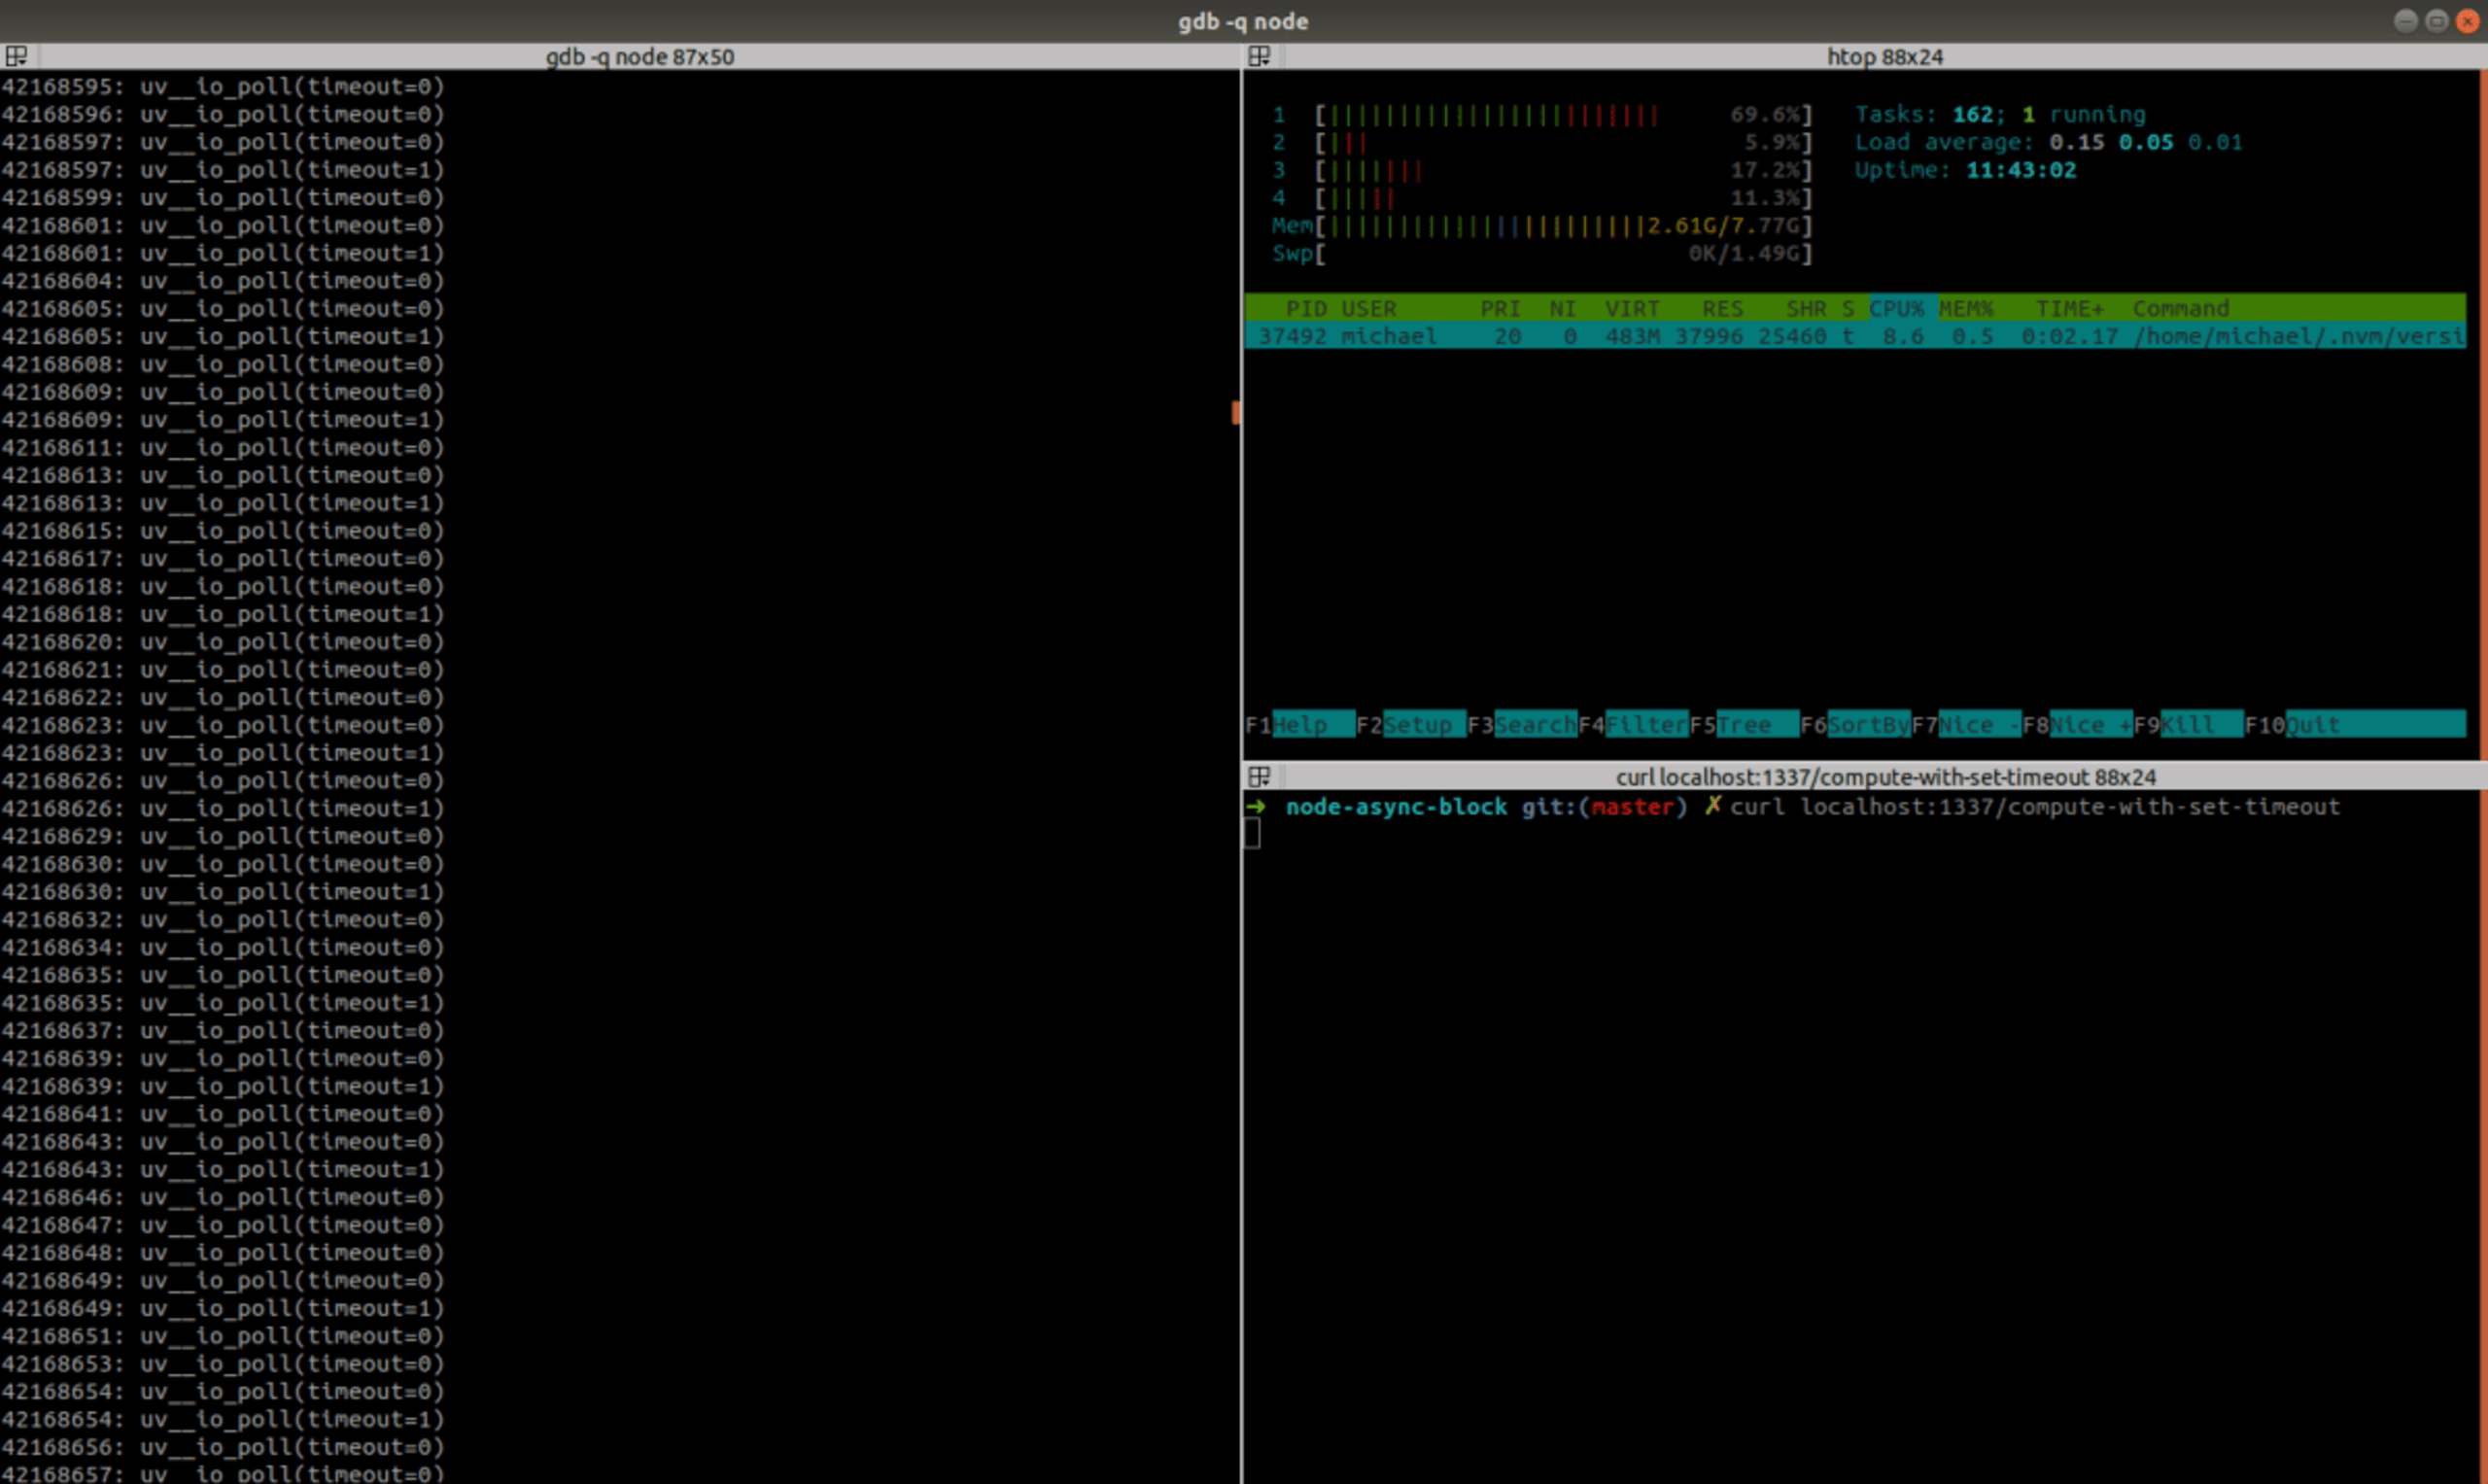
Cuando se inicia nuestro servidor, se llama a uv__io_poll() con un tiempo de espera de -1, lo que significa “tiempo de espera infinito”, ya que no tiene nada que hacer, excepto esperar una solicitud HTTP. Ahora hagamos una solicitud GET al endpoint /compute-with-set-timeout:
Como podemos ver, el tiempo de espera a veces es 1, y aunque también es 0, suele pasar al menos 1 ms entre dos llamadas consecutivas. Si depuramos de la misma manera mientras hacemos una solicitud GET a /compute-with-set-immediate, siempre veremos timeout=0.
Para una CPU, 1 milisegundo es bastante tiempo. El bucle ajustado en /compute-sync completó 10⁷ iteraciones en 43 segundos, lo que significa que realizó unas 233 operaciones aleatorias de cálculo de hash por milisegundo. Esperar 1 ms en cada iteración significa esperar 10 000 segundos = 2 horas y 45 minutos.
Intentemos entender por qué el tiempo de espera que se pasa a uv__io_poll() no es 0. El tiempo de espera se calcula en uv_backend_timeout() y luego se pasa a uv__io_poll(), como puede verse en el bucle principal de libuv. En algunos casos (como cuando hay solicitudes o controladores activos pendientes), uv_backend_timeout() devuelve 0; de lo contrario, devuelve el resultado de uv__next_timeout(), que elige el tiempo de espera más cercano del “montículo de temporizadores” y devuelve el tiempo restante hasta que venza.
La función que se usa para agregar los “tiempos de espera” al “montículo de temporizadores” es uv_timer_start(). Esta función se llama en muchos lugares, así que podemos ponerle un punto de interrupción para ubicar mejor al llamador que pasa un valor distinto de cero en nuestro caso. Al ejecutar el comando info stack en GDB cuando se activa el punto de interrupción, obtenemos:
TimerWrap::Start es solo una envoltura sencilla alrededor de uv_timer_start(), y las direcciones ininteligibles que aparecen en la pila indican que el código que buscamos probablemente esté implementado en JavaScript. Si buscamos usos de TimerWrap:Start en el código fuente de Node o simplemente “entramos” en la implementación de setTimeout() desde JS mediante un depurador de JS, podemos encontrar rápidamente el constructor Timeout en https://github.com/nodejs/node/blob/v10.9.0/lib/internal/timers.js#L53:
Por último, aquí vemos que un tiempo de espera de 0 se convierte en 1.
Espero que este artículo te haya resultado útil. Gracias por leerlo.
Referencias:
https://nodejs.org/en/docs/guides/event-loop-timers-and-nexttick/
https://jsblog.insiderattack.net/event-loop-and-the-big-picture-nodejs-event-loop-part-1-1cb67a182810 (serie de 5 artículos)
https://github.com/libuv/libuv (también incluido en nodejs/node)
https://github.com/v8/v8 (también incluido en nodejs/node)
Más lecturas sobre el tema:
https://javabeginnerstutorial.com/node-js/event-loop-and-asynchronous-non-blocking-in-node-js/
https://stackoverflow.com/questions/34824460/why-does-a-while-loop-block-the-event-loop
https://stackoverflow.com/questions/46004290/will-async-await-block-a-thread-node-js
https://stackoverflow.com/questions/51694299/node-js-socket-io-async-and-blocking-event-loop
http://voidcanvas.com/setimmediate-vs-nexttick-vs-settimeout/
http://dtrace.org/blogs/brendan/2012/11/14/dtracing-in-anger/
https://developer.mozilla.org/en-US/docs/Web/JavaScript/EventLoop
https://jakearchibald.com/2015/tasks-microtasks-queues-and-schedules/ - navegadores
https://blog.risingstack.com/node-js-at-scale-understanding-node-js-event-loop/
https://humanwhocodes.com/blog/2013/07/09/the-case-for-setimmediate/