Presentamos el nuevo Risk Score de Snyk para priorizar según el riesgo


17 de agosto de 2023
0 minutos de lectura¡Nos complace anunciar la disponibilidad de la beta abierta del nuevo Risk Score de Snyk! El nuevo Risk Score reemplaza al Priority Score actual y se diseñó para ayudarte a priorizar con mayor eficacia, brindándote una comprensión precisa e integral del riesgo que representa cada problema de seguridad.
Risk Score se basa en un nuevo modelo de evaluación de riesgos que aprovecha varios factores de riesgo objetivos y contextuales para medir tanto la probabilidad de que se aproveche una vulnerabilidad como el impacto que podría tener si se aprovechara. El nuevo Risk Score considera más factores de riesgo que antes —como reachability, la madurez del exploit, EPSS, las tendencias sociales, CVSS, la profundidad transitiva, la criticidad para el negocio y otros— para brindarte información de seguridad más completa y precisa.
Una vez habilitado, el nuevo Risk Score aparecerá en las tarjetas de problemas de Snyk, donde encontrarás una explicación detallada de cómo se calculó la puntuación y cómo usarla para comprender el riesgo que representa el problema. La puntuación también está disponible en los informes de Snyk y a través de nuestra API.
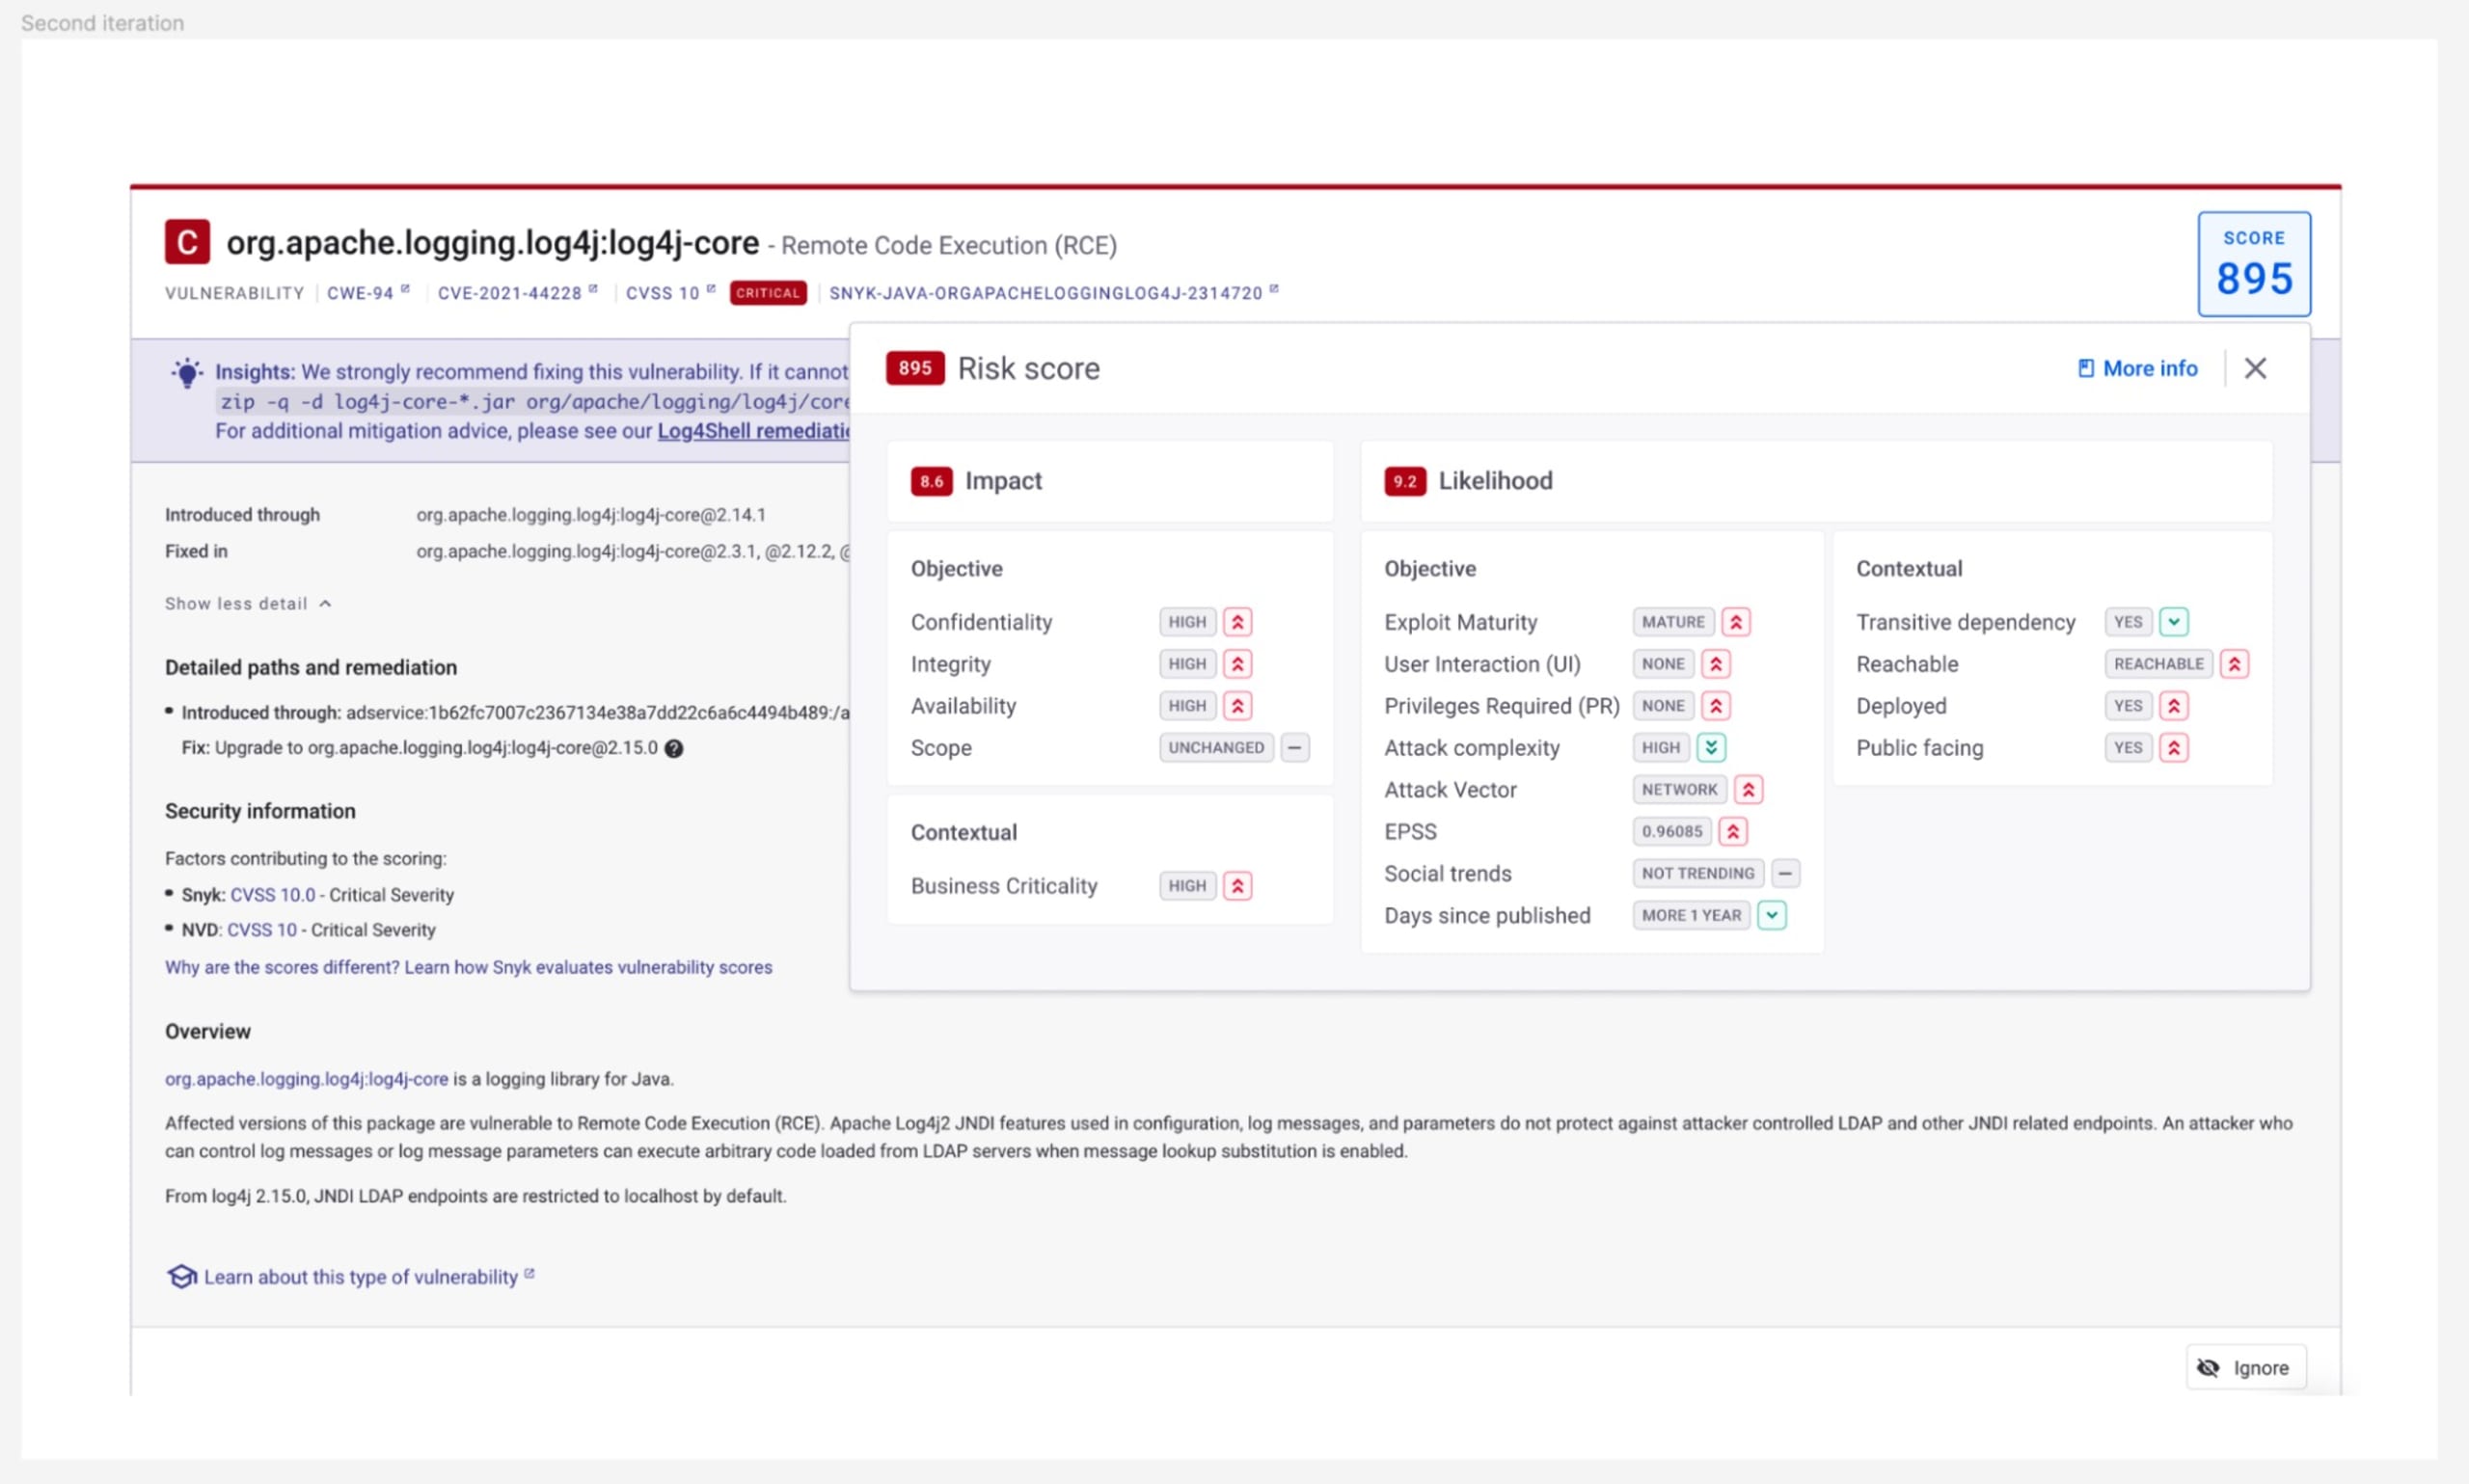
Risk Score se puede habilitar a través de Snyk Preview y está disponible en beta abierta para problemas de Snyk Open Source y Snyk Container en todos los planes de Snyk, incluido el plan gratuito. Para obtener más información sobre Risk Score y cómo usarlo, consulta nuestra documentación en línea.
El problema: acumulaciones de alertas de seguridad con demasiado ruido
Uno de los mayores problemas que enfrentan hoy los equipos de seguridad y desarrollo que buscan proteger su software a lo largo de la cadena de suministro de software es la relación entre señales y ruido.
Por un lado, la cantidad de vulnerabilidades descubiertas en su código parece no tener fin:
Las herramientas de seguridad se han vuelto prácticamente omnipresentes a lo largo de la cadena de suministro de software. Esto amplía considerablemente la superficie de ataque que hay que proteger y genera más problemas que nunca.
Cada día se descubren nuevas vulnerabilidades en bibliotecas populares de código abierto y software de terceros, lo que aumenta constantemente la cantidad de amenazas que hay que clasificar, priorizar y corregir.
La complejidad del software no deja de crecer, y no siempre es posible automatizar las actualizaciones o correcciones sin introducir cambios incompatibles en el código, lo que dificulta la clasificación y resolución de los problemas.
Por otro lado, los usuarios descubren que no todas las amenazas son iguales y que la gran mayoría de los problemas identificados representan mucho menos riesgo del que esperaban inicialmente. Un ejemplo de ello es el sistema de modelado de amenazas EPSS de FIRST, que busca predecir la probabilidad de que se aproveche en la práctica una CVE específica identificada:
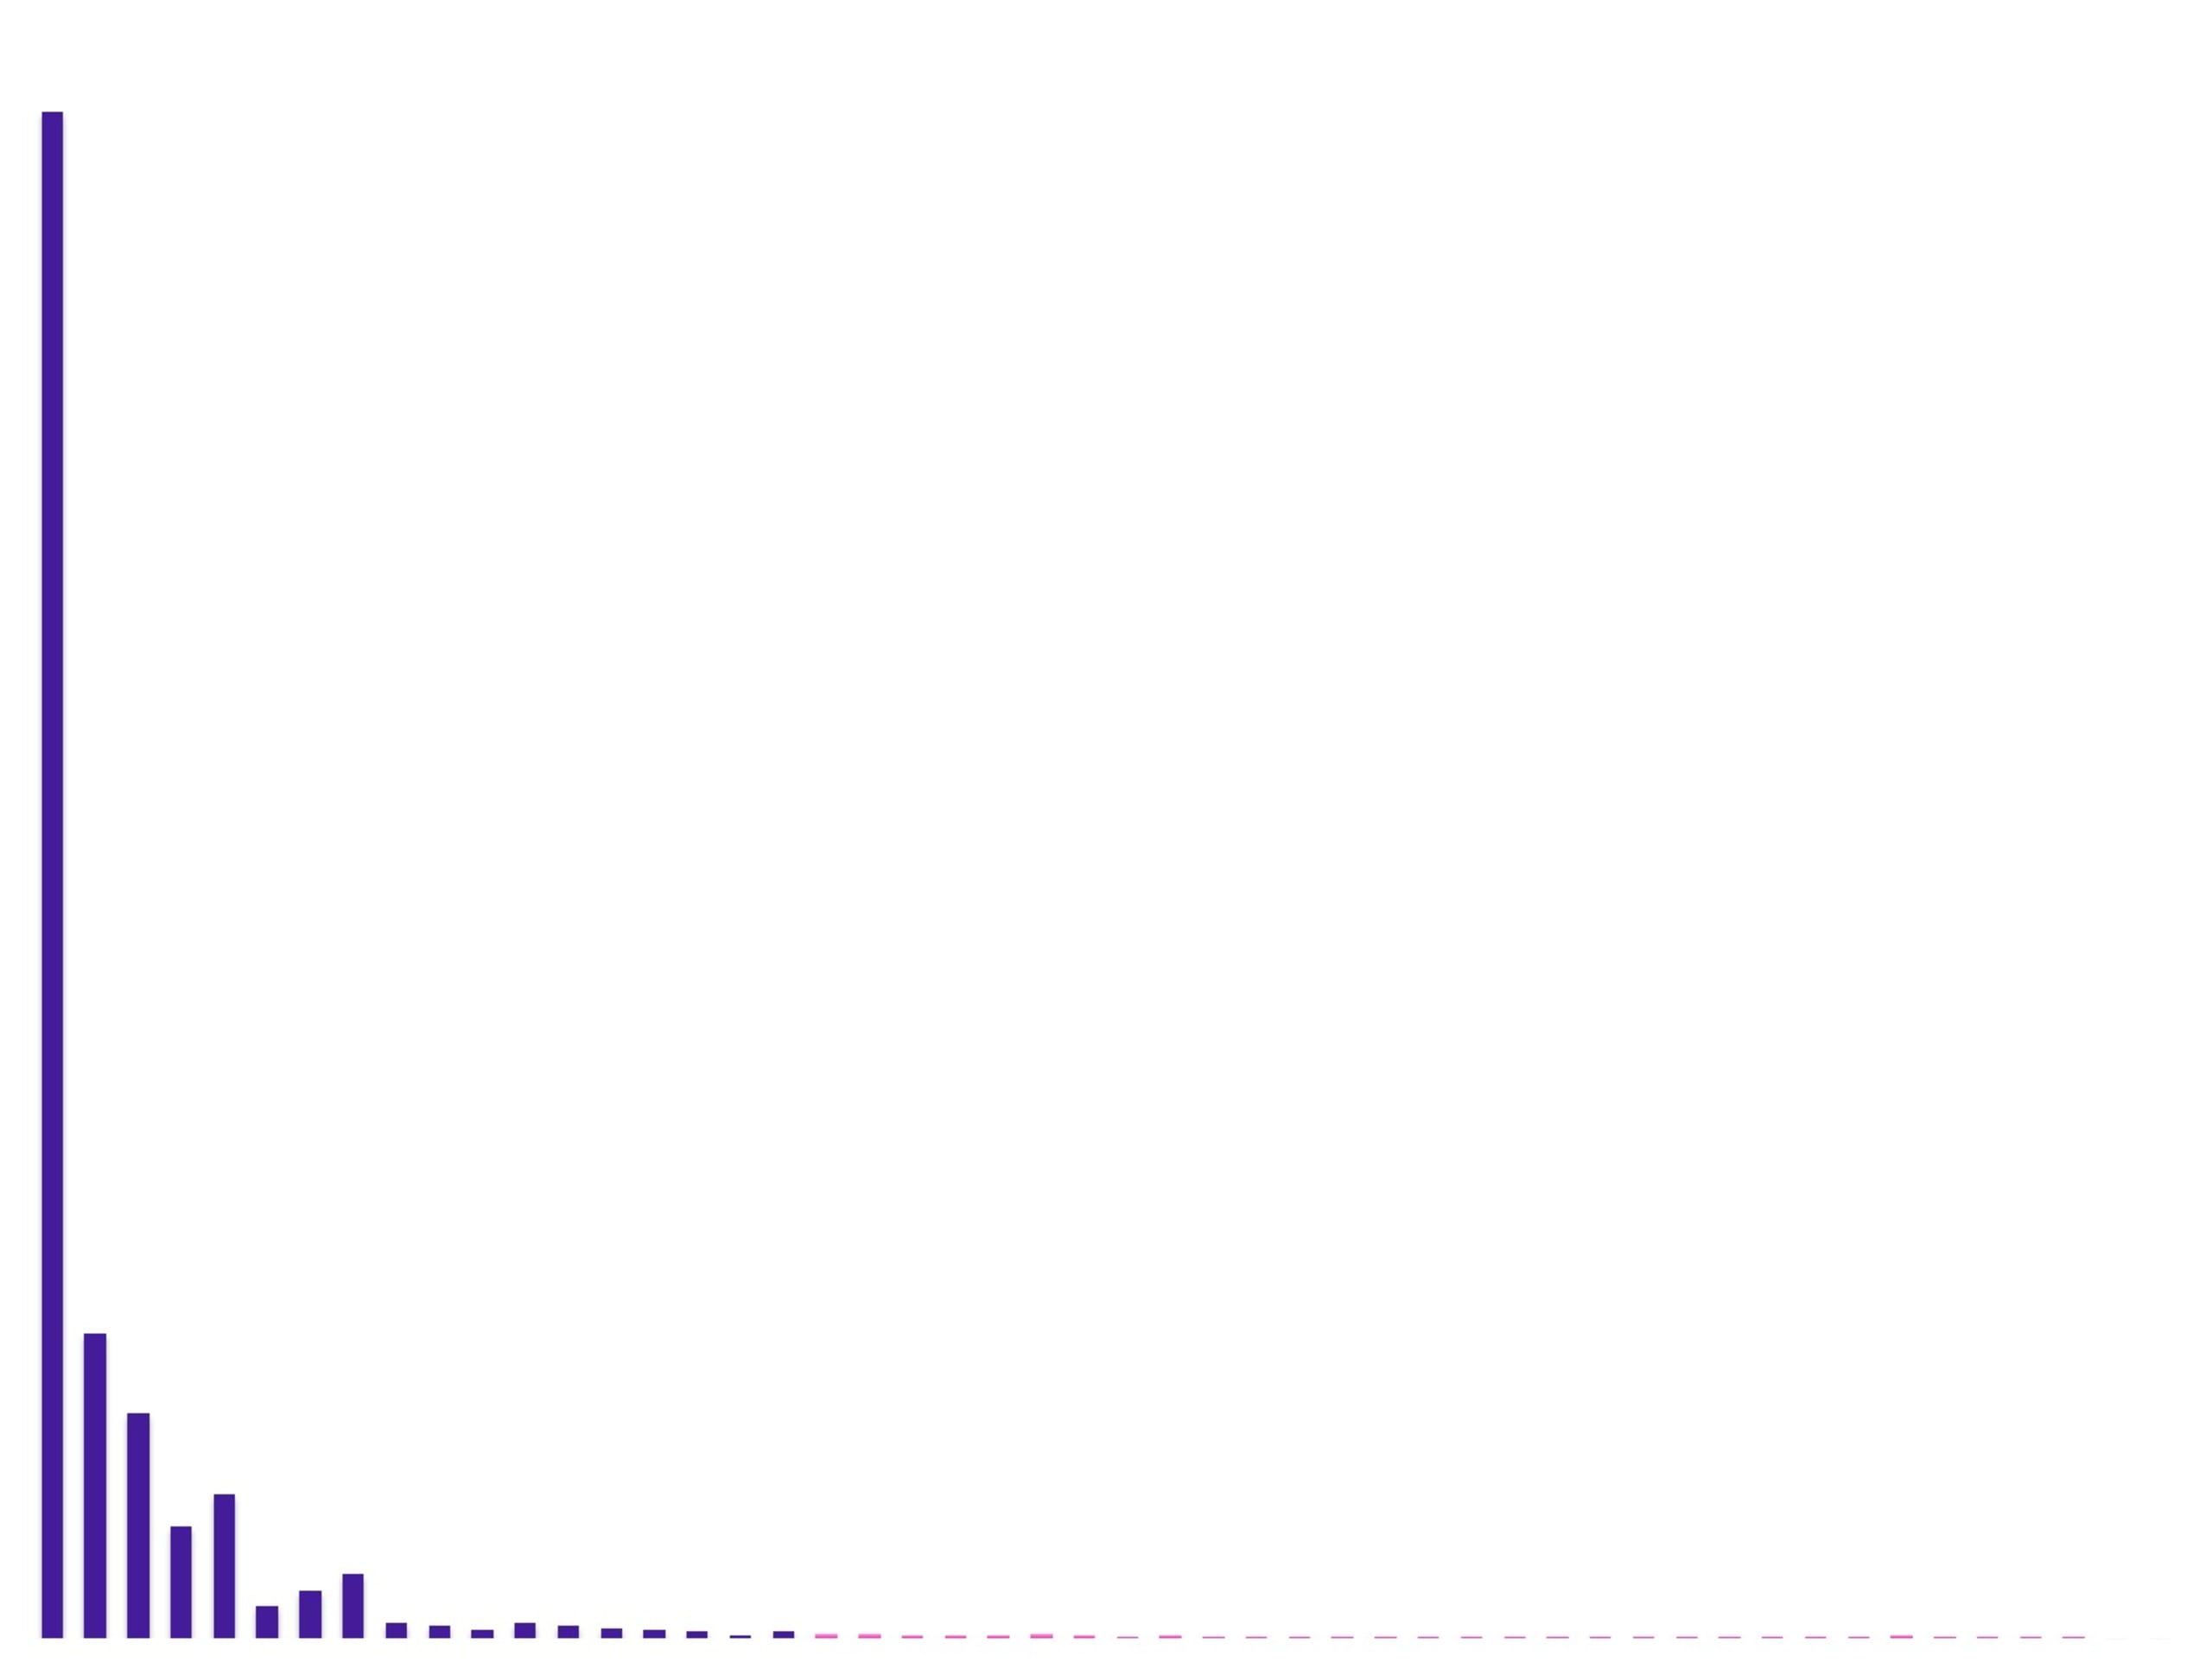
Podemos ver que es muy poco probable que alguna vez se aproveche más del 95 % de las vulnerabilidades; las amenazas verdaderamente peligrosas se concentran alrededor del percentil 99.
Comparemos esto con el desglose de las vulnerabilidades según la gravedad CVSS 3.1, la escala más utilizada por los profesionales de seguridad para medir el riesgo, donde un porcentaje mucho mayor de vulnerabilidades se concentra en el rango de gravedad alta a crítica:
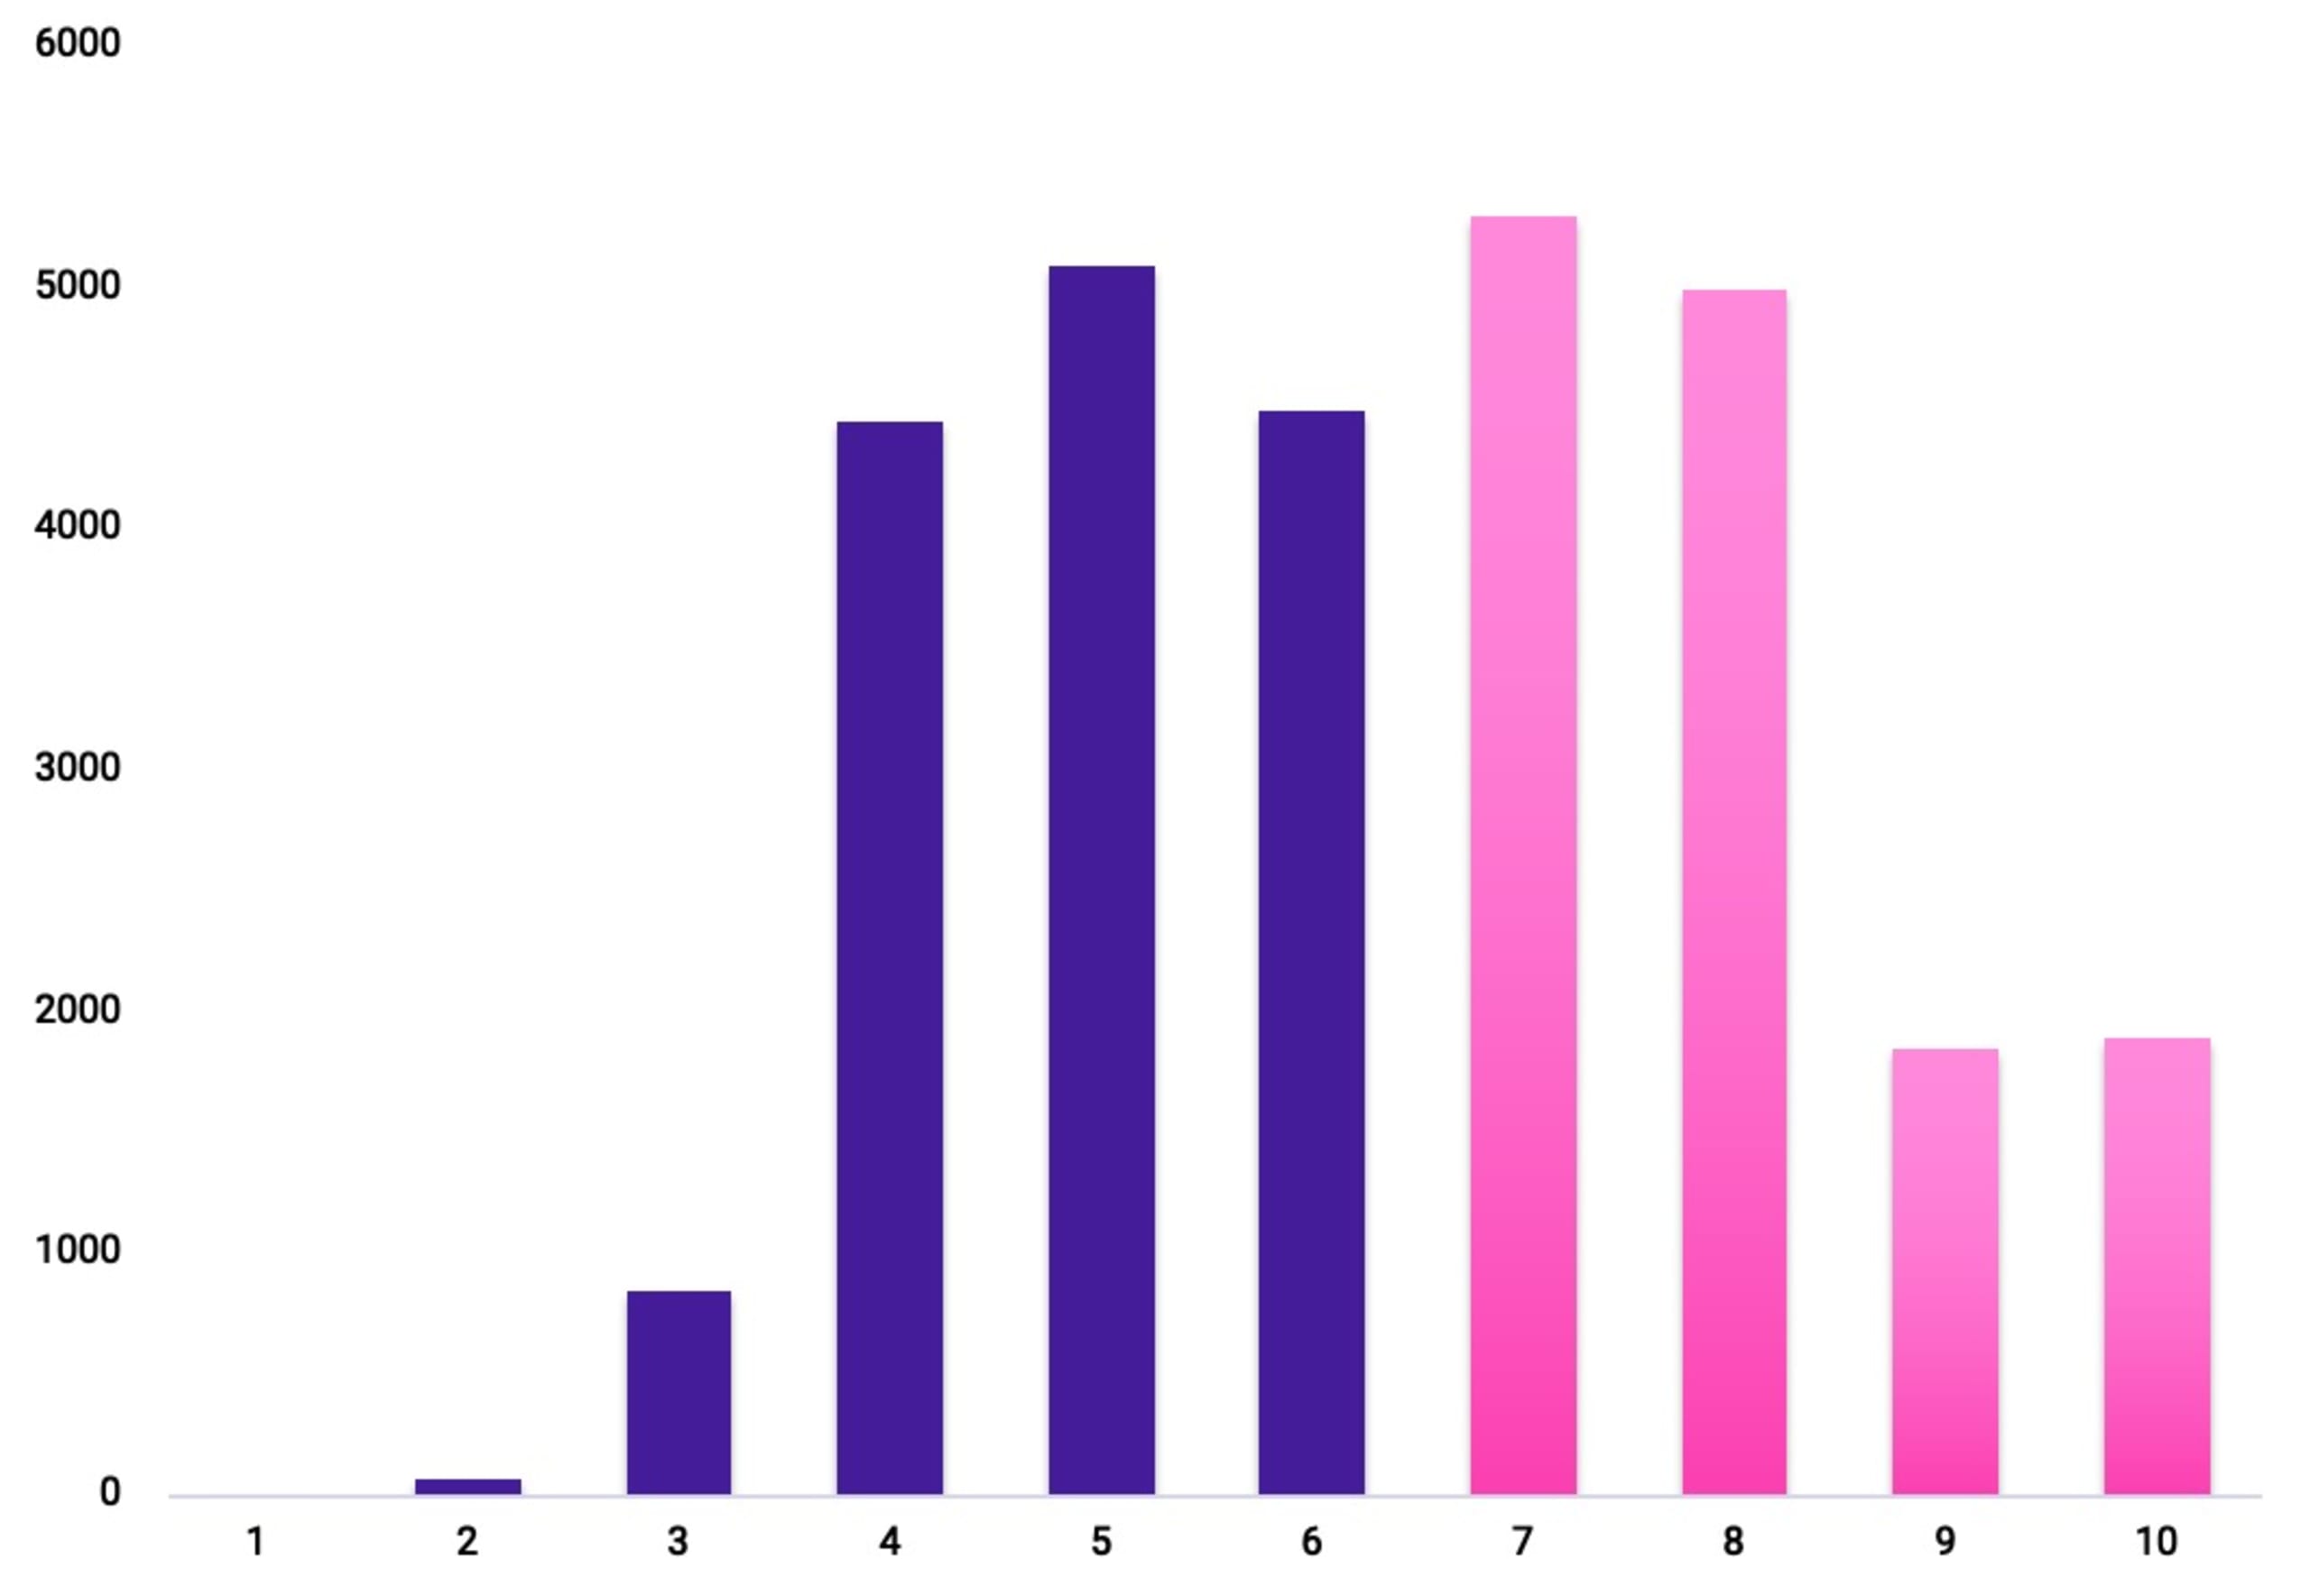
Tampoco ayuda mirar hacia CVSS v4.0. Por definición, el marco CVSS sigue exigiendo que analices manualmente los problemas en el contexto de tu entorno, lo que te deja con demasiado trabajo.
Priorización de riesgos: la búsqueda de una solución mágica
La pregunta obvia es cómo pasar de un mundo en el que intentamos clasificar y abordar miles de riesgos muy improbables a otro en el que podamos concentrar la mayor parte del tiempo en los problemas más riesgosos. En este ámbito se han propuesto varias soluciones mágicas: un único factor de riesgo que permita descartar de inmediato todo riesgo asociado a ciertas vulnerabilidades, por ejemplo:
Madurez del exploit o EPSS: intenta predecir objetivamente si un ataque se intentará y tendrá éxito. Es un método predictivo que no toma en cuenta tu entorno.
Reachability estática del código: intenta distinguir entre los componentes que se usan y los que no. Es útil para destacar los que sí se usan, pero no para ignorar el resto. Basarse únicamente en este factor de riesgo tampoco es suficiente, ya que no considera otros contextos, como la reachability de red y otras condiciones que permitirían aprovechar una vulnerabilidad.
Transitividad: existe una corriente de pensamiento que sostiene que no es necesario tener en cuenta los problemas en las dependencias transitivas. Log4Shell (y muchas otras vulnerabilidades) demostró que esta premisa es incorrecta.
Es evidente el atractivo de un modelo de riesgo binario y sencillo de entender; si realmente funcionara, reduciría muchísimo nuestro trabajo. Por desgracia, la seguridad y el código no son tan simples como para clasificarlos en términos binarios. Estos modelos simplistas nos dejan peligrosamente expuestos a riesgos que descartan y, a la vez, nos mantienen enfocados en un subconjunto de vulnerabilidades, muchas de las cuales no son amenazas reales. Usar exclusivamente uno o una combinación de estos modelos exige confiar plenamente en la información que ofrecen y en la que omiten.
Desarrollo de un nuevo modelo de evaluación de riesgos para Risk Score
Al comprender el desafío de priorización que enfrentan nuestros clientes, nos propusimos crear un nuevo modelo de evaluación de riesgos con tres objetivos principales:
Crear un modelo de riesgo verdaderamente probabilístico, en lugar de uno binario.
Crear un modelo que tuviera en cuenta y reflejara las complejidades inherentes a la evaluación del riesgo, sin dejar de permitir que las personas comprendan y verifiquen sus resultados.
Incorporar información contextual proporcionada por cada usuario y permitirnos ampliar aún más ese factor contextual.
El modelo de evaluación incluido en el nuevo Risk Score de Snyk tiene en cuenta dos vectores de riesgo:
Probabilidad: ¿Qué probabilidad hay de que se materialice un riesgo determinado? En otras palabras, ¿qué probabilidad hay de que se aproveche una vulnerabilidad en el código de un usuario?
Impacto: Si se aprovechara la vulnerabilidad, ¿qué impacto tendría para nuestros usuarios?
Cada uno de estos vectores se divide en dos categorías de factores de riesgo:
Objetivos: factores de riesgo definidos objetivamente para el problema en cuestión y relevantes para cualquier entorno vulnerable.
Contextuales: factores de riesgo definidos en el contexto del entorno de la aplicación vulnerable.
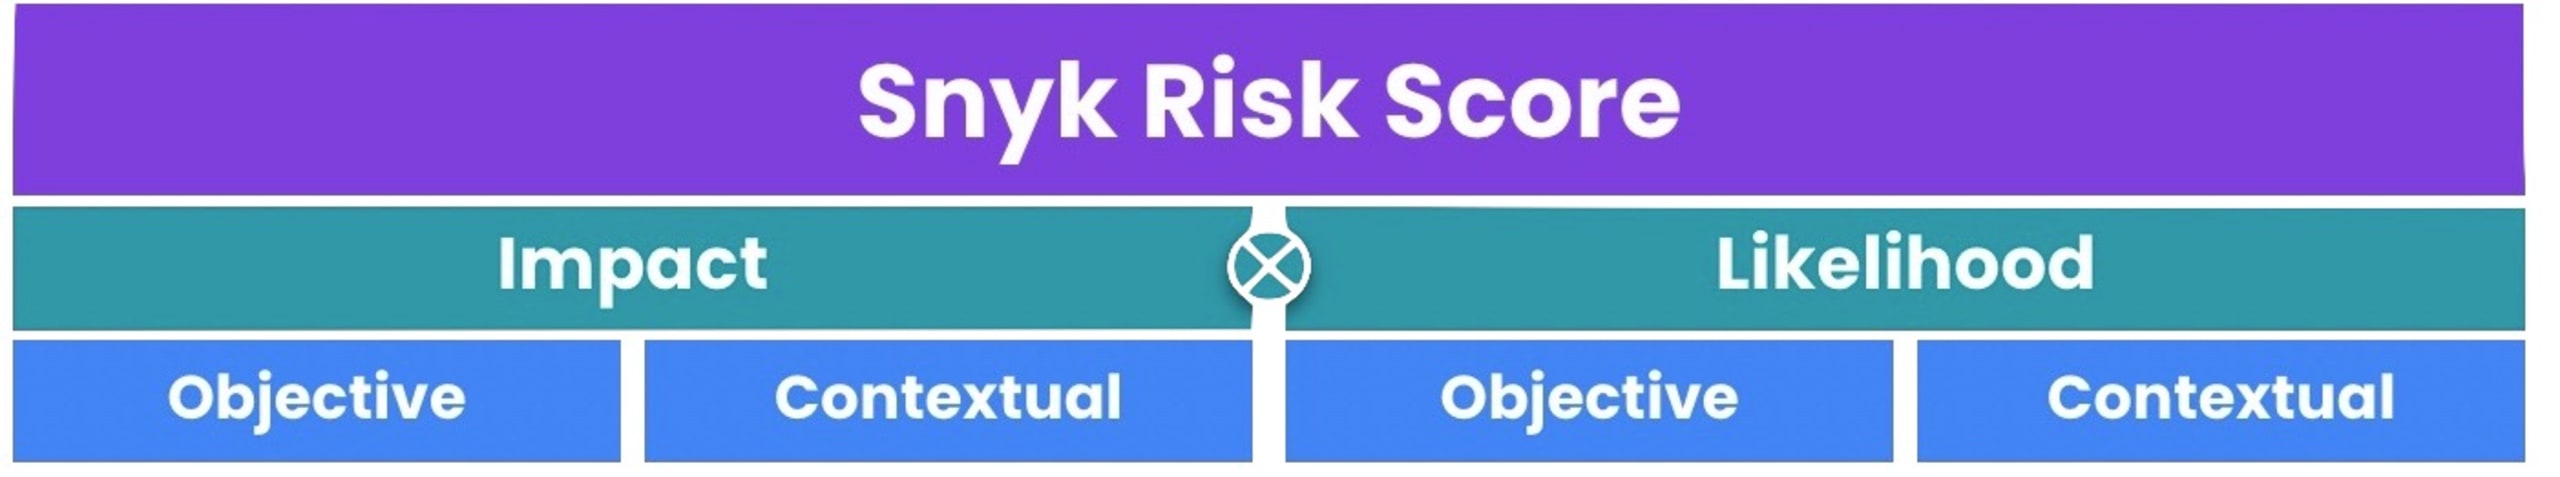
A continuación, los algoritmos de nuestro modelo de evaluación de riesgos calculan estos factores en conjunto para generar una puntuación de riesgo para cada problema.
¿Cómo evaluar objetivamente la posibilidad de explotación?
Para cada factor de riesgo que incorporamos al modelo, realizamos dos experimentos a fin de verificar su utilidad en nuestro algoritmo y su peso predictivo relativo. Primero, establecimos una referencia de la probabilidad de que se aprovechara una vulnerabilidad aleatoria, usando la propia base de datos de vulnerabilidades de Snyk y comparándola con las vulnerabilidades aprovechadas en la práctica que publicó CISA. Luego, comprobamos la correlación relativa entre cada factor de riesgo que, según nuestra hipótesis, podría afectar la probabilidad de explotación y esa referencia.
Sin embargo, correlación no significa causalidad. En esta etapa, empezamos a experimentar con varios modelos de aprendizaje automático para identificar correctamente qué factores de riesgo eran realmente útiles para predecir la posibilidad de explotación. Tras varias rondas de pruebas, usamos un modelo de regresión para identificar los factores de riesgo con un impacto estadísticamente significativo en la posibilidad de explotación e incorporamos los resultados de este modelo a nuestro algoritmo.
Por último, usamos los resultados de nuestros modelos para analizar cientos de proyectos anonimizados y comprobar si el desglose de la posibilidad de explotación de nuestro modelo coincidía con lo que esperaríamos a partir de datos reales sobre filtraciones, como mencionamos anteriormente.
Todo depende del contexto
Aunque nos complace que, al parecer, podamos predecir con precisión la posibilidad de explotación a nivel global, los riesgos contextuales asociados a la configuración de cada usuario siguen siendo fundamentales. Para investigarlos, analizamos nuestra investigación de seguridad interna y exclusiva e intentamos aprovechar vulnerabilidades específicas en distintas condiciones. De este modo, pudimos incorporar condiciones aparentemente «binarias», como la reachability o la transitividad, no para hacer afirmaciones contundentes (e inexactas), sino como datos probabilísticos para nuestro algoritmo.
En Snyk, la transparencia y la confianza son fundamentales para nuestro trabajo. Por eso, mostramos todos los factores y razonamientos que llevan a la puntuación, tanto en los problemas que encuentras como en nuestra documentación pública.
El futuro de la puntuación de riesgos en Snyk
En Snyk, creemos que los equipos de AppSec y desarrollo deberían poder definir sus propios métodos de priorización. Hemos visto que distintas empresas abordan este tema desde diferentes perspectivas:
Enfoque en el riesgo: filtra y ordena los problemas según una puntuación basada en un modelo de análisis de riesgos, como Snyk Risk Score.
Enfoque en el cumplimiento: si el cumplimiento normativo es una prioridad, debes atender cada problema de gravedad alta o crítica, según la definición de CVSS. Como mencionamos, esto genera muchos problemas que atender; por eso, puedes usar la puntuación de riesgos para ordenar y filtrar los más importantes.
Enfoque en la facilidad de acción: organiza los problemas según el esfuerzo necesario para corregirlos. Las puntuaciones de riesgo no deberían incluir este factor, pero puedes usarlo como otra dimensión para entender por qué es importante considerar el esfuerzo que requiere corregir un problema.
También puedes tener tus propias preferencias y aportar tus conocimientos sobre el riesgo. Por eso, en el futuro, Risk Score de Snyk permitirá a los usuarios personalizar la puntuación e incorporar sus conocimientos sobre el entorno, aprovechando el modelo predictivo para priorizar los problemas en lugar de descartarlos.
¡Para empezar con Risk Score, habilítalo hoy mismo a través de Snyk Preview!