10 configuraciones de Kubernetes Security Context que debes conocer



10 de marzo de 2021
0 minutos de lecturaEjecutar cargas de trabajo de forma segura en Kubernetes puede ser difícil. Muchas configuraciones afectan la seguridad de la API de Kubernetes, y se necesita un conocimiento considerable para implementarlas correctamente. Una de las herramientas más potentes que Kubernetes ofrece en este ámbito son las configuraciones de securityContext, que se pueden usar en los manifiestos de cada Pod y Container. En esta hoja de referencia, veremos las distintas configuraciones de securityContext, qué significan y cómo debes usarlas.
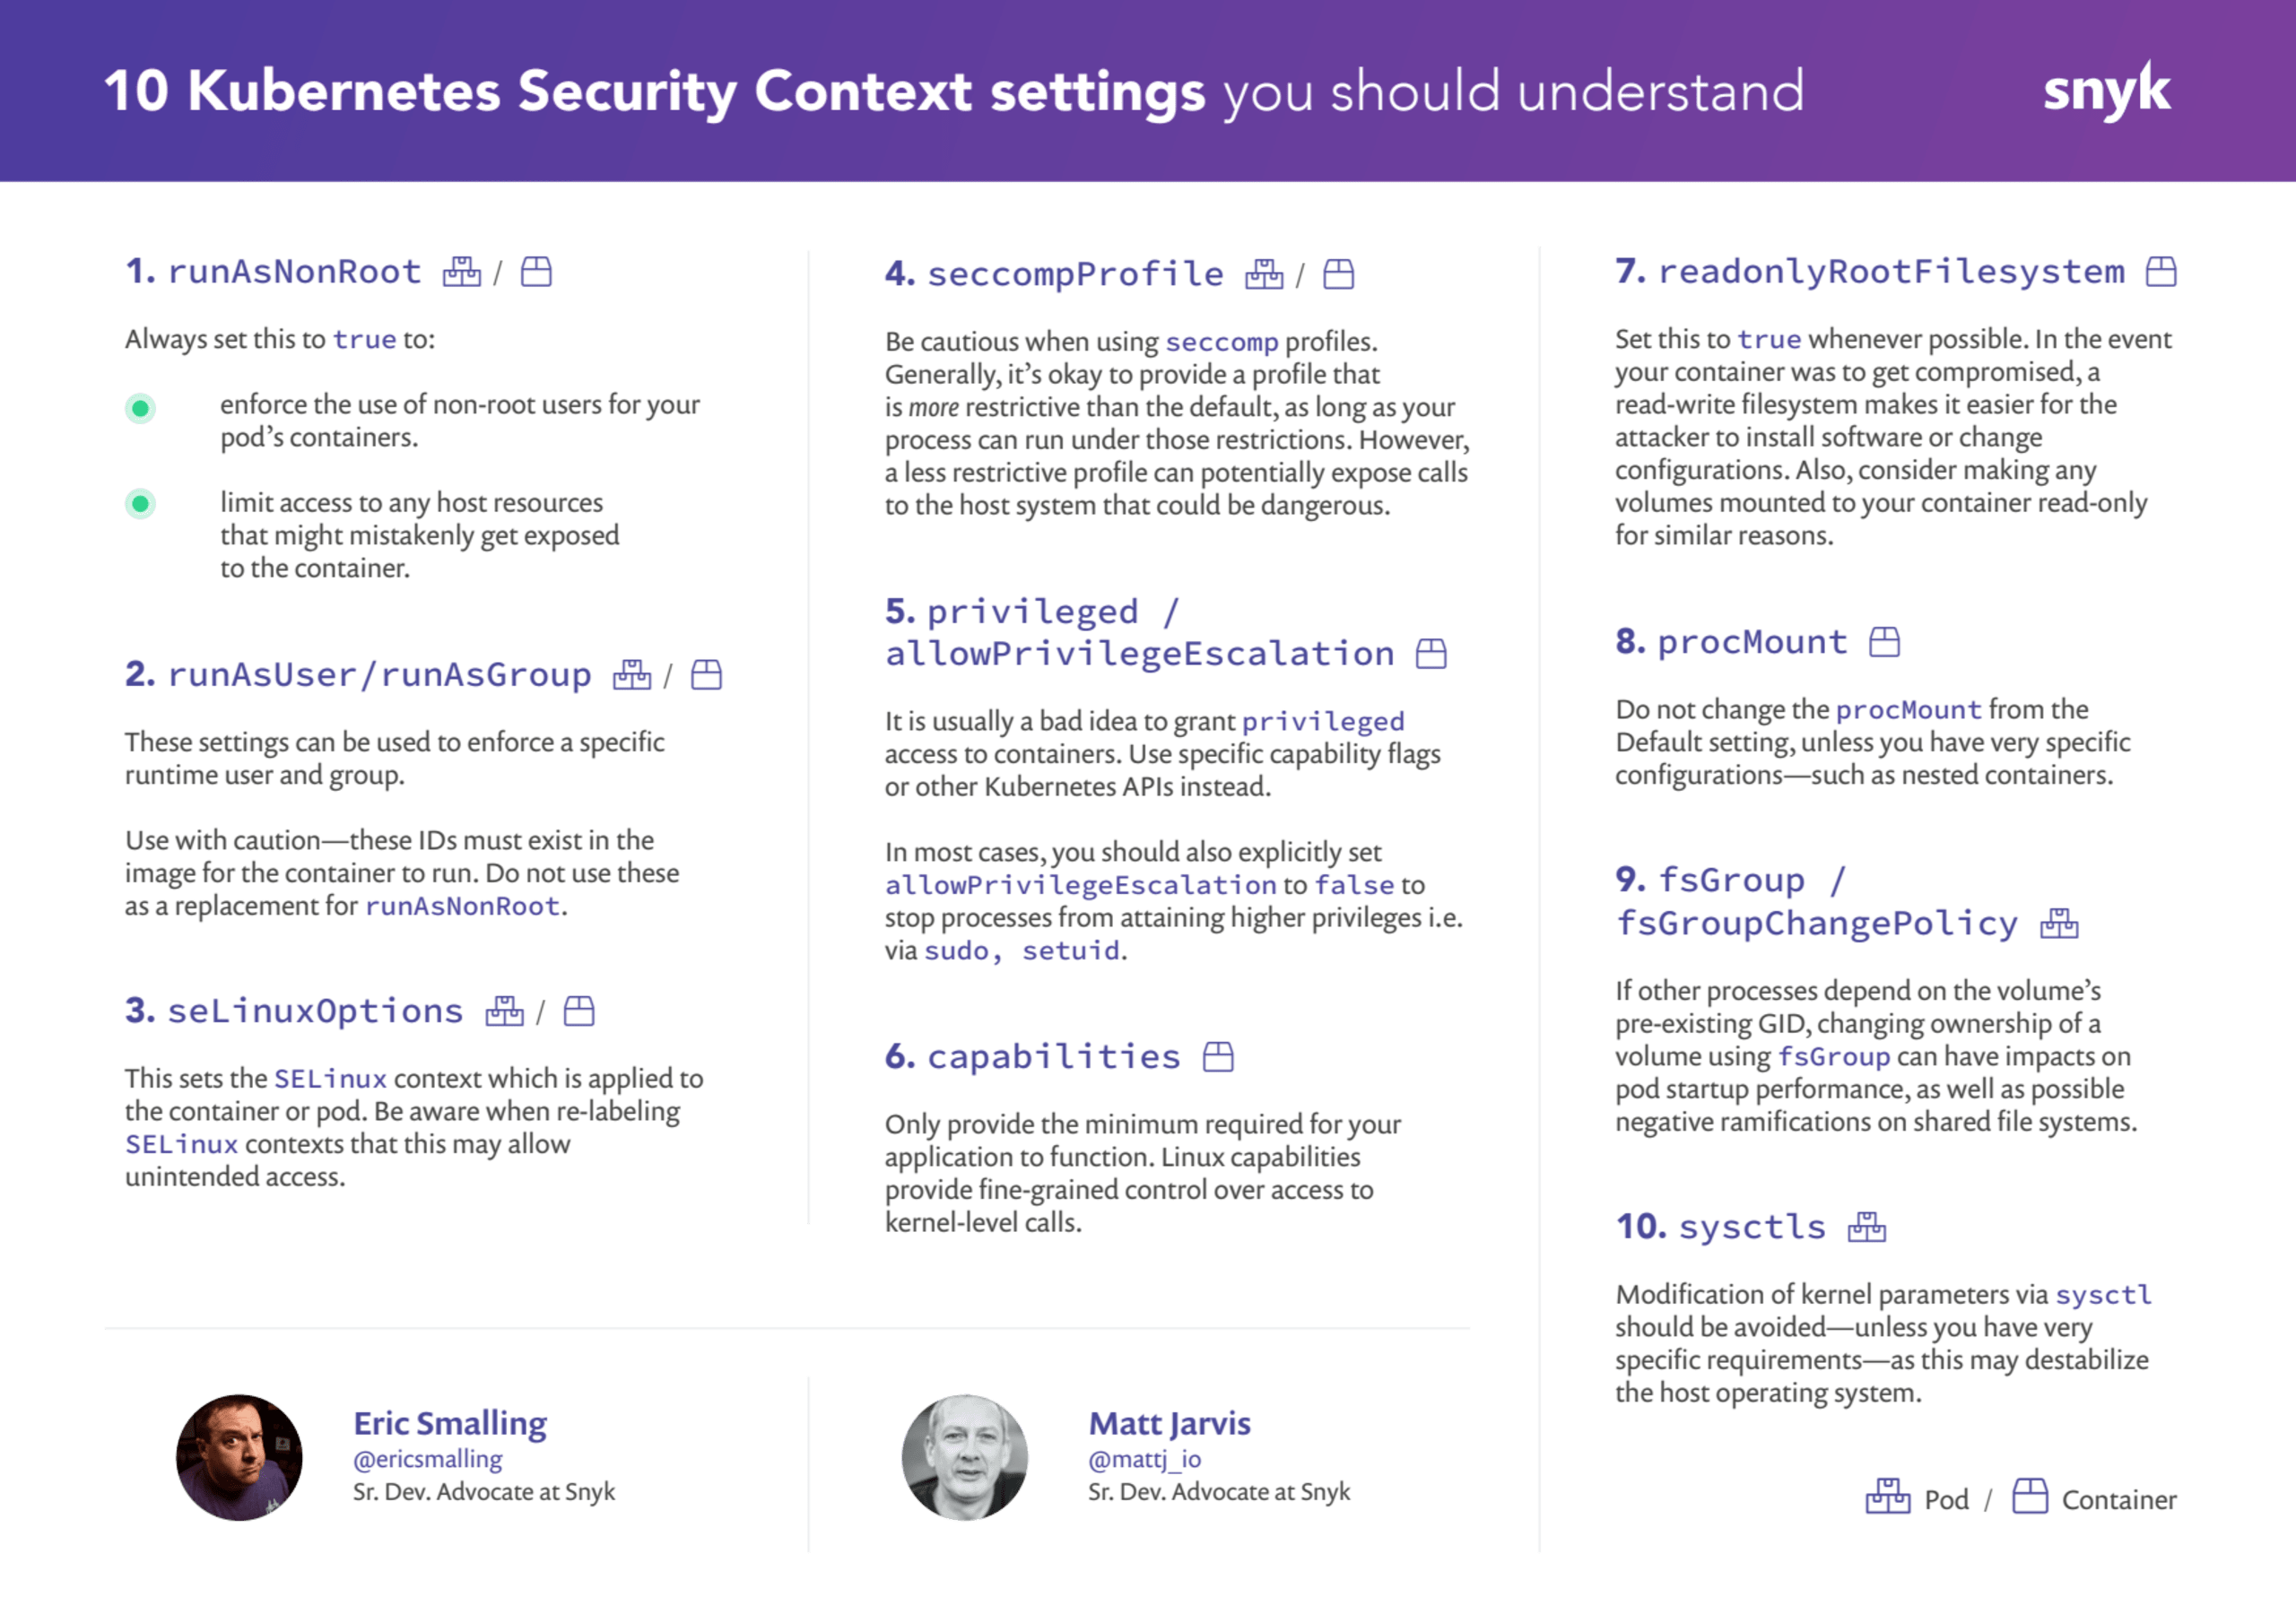
Descarga la hoja de referencia.
runAsNonRoot
runAsUser / runAsGroup
seLinuxOptions
seccompProfile
privileged / allowPrivilegeEscalation
capabilities
readonlyRootFilesystem
procMount
fsGroup / fsGroupChangePolicy
sysctls
Configuraciones de Pod y Container
Las configuraciones de Kubernetes securityContext se definen en las API PodSpec y ContainerSpec, y el alcance se indica en este documento mediante las anotaciones [P] o [C] junto a cada una. Ten en cuenta que, si una configuración está disponible y se establece en ambos alcances, prevalecerá la configuración del contenedor.
Ahora, sin ningún orden en particular, veamos las configuraciones de securityContext:
1. runAsNonRoot [P/C]
Aunque un contenedor usa namespaces y cgroups para limitar sus procesos, basta con una sola configuración incorrecta en los ajustes de implementación para que esos procesos accedan a los recursos del host. Si el proceso se ejecuta como root, tendrá el mismo acceso a esos recursos que la cuenta root del host. Además, si se usan otras configuraciones de Pod o Container para reducir las restricciones (por ejemplo, procMount o capabilities), tener un UID root agrava los riesgos de cualquier explotación de estas configuraciones. A menos que tengas una muy buena razón, nunca ejecutes un contenedor como root.
Entonces, ¿qué puedes hacer si tienes una imagen para implementar que sí usa root?
Opción 1: Usar el usuario incluido en la imagen base
A menudo, las imágenes base ya incluyen un usuario creado y disponible, pero dejan en manos de los equipos de desarrollo o implementación la decisión de usarlo. Por ejemplo, la imagen oficial de Node.js incluye un usuario llamado node con UID 1000 que puedes usar, pero no lo configura explícitamente como el usuario actual en su Dockerfile. Tendremos que configurarlo en tiempo de ejecución con el ajuste runAsUser o cambiar el usuario actual de la imagen mediante un Dockerfile derivado. La primera opción supone que el UID 1000 puede leer los archivos del directorio de la aplicación. Veamos un ejemplo con un Dockerfile derivado para crear nuestra propia imagen.
Sin profundizar demasiado en la creación de imágenes, supongamos que tenemos una aplicación npm ya compilada. Este es un Dockerfile mínimo para crear una imagen basada en [**node:slim**](https://hub.docker.com/_/node) y ejecutarla como el usuario node incluido.
La línea clave comienza con USER, que convierte a node en el usuario predeterminado dentro de cualquier contenedor iniciado desde esta imagen. Usamos el UID en lugar del nombre de usuario porque Kubernetes no puede asignar el nombre del usuario predeterminado de una imagen a su UID antes de iniciar el contenedor y, si se especifica runAsNotRoot: true, devolverá un error al implementar.
Opción 2: La imagen base no incluye ningún usuario
¿Qué haríamos si la imagen base de node no incluyera un usuario que pudiéramos usar? Para muchos procesos, basta con crear uno en un Dockerfile derivado y usarlo. Ampliemos el ejemplo anterior para hacerlo:
Como puedes ver, la única adición es la línea RUN, que crea un usuario (la sintaxis puede variar según la distribución de la imagen base). Después, cambié las referencias al usuario y a la ruta para que coincidan.
NOTA: Esto funciona bien con node.js y npm, pero es posible que otras herramientas requieran cambiar la propiedad de otros elementos del sistema de archivos. Si tienes algún problema, consulta la documentación de la herramienta.
2. runAsUser / runAsGroup [P/C]
Las imágenes de contenedor pueden tener configurado un usuario o grupo específico para ejecutar el proceso. Esto se puede anular con los ajustes de configuración runAsUser y runAsGroup. A menudo, se configuran junto con montajes de volúmenes que contienen archivos con los mismos ID de propiedad.
Usar estos ajustes conlleva un riesgo, ya que estás tomando decisiones en tiempo de ejecución para el contenedor que podrían no ser compatibles con la imagen original. Por ejemplo, la imagen oficial del servidor de CI jenkins/jenkins se ejecuta como el grupo:usuario jenkins:jenkins y todos los archivos de la aplicación pertenecen a ese usuario. Si configuramos un usuario diferente, no podrá iniciarse porque ese usuario no existe en el archivo /etc/passwd de la imagen. Aunque existiera, es muy probable que tenga problemas para leer y escribir los archivos que pertenecen a jenkins:jenkins. Un simple comando docker run puede comprobarlo:
Como mencionamos antes, es muy recomendable asegurarse de que los procesos del contenedor no se ejecuten como el usuario root, pero no dependas de los ajustes runAsUser o runAsGroup para garantizarlo. Alguien podría eliminarlos en el futuro. Asegúrate también de configurar runAsNonRoot como true.
3. seLinuxOptions [P/C]
SELinux es un sistema basado en políticas que controla el acceso a aplicaciones, procesos y archivos en un sistema Linux. Implementa el marco Linux Security Modules en el kernel de Linux. SELinux se basa en el concepto de etiquetas, que aplica a todos los elementos del sistema para agruparlos. Estas etiquetas se conocen como contexto de seguridad (no debe confundirse con securityContext de Kubernetes) y constan de user, role, type y un campo opcional level, con el formato user:role:type:level.
Luego, SELinux usa políticas para definir qué procesos de un contexto determinado pueden acceder a otros objetos etiquetados del sistema. SELinux puede aplicarse de forma estricta, en cuyo caso se deniega el acceso, o configurarse en modo permisivo, en el que se registran los accesos. En los contenedores, SELinux suele etiquetar el proceso y la imagen del contenedor de modo que el proceso solo pueda acceder a los archivos dentro de la imagen.
El entorno de ejecución del contenedor aplica las etiquetas SELinux predeterminadas al instanciar un contenedor. El ajuste seLinuxOptions de securityContext permite aplicar etiquetas SELinux personalizadas. Ten en cuenta que cambiar las etiquetas SELinux de un contenedor podría permitir que el proceso en contenedor escape de la imagen y acceda al sistema de archivos del host.
Ten en cuenta que esta funcionalidad solo se aplica si el sistema operativo del host es compatible con SELinux.
4. seccompProfile [P/C]
Seccomp significa secure computing mode y es una función del kernel de Linux que puede restringir las llamadas que un proceso determinado puede realizar desde el espacio de usuario al kernel. Un perfil seccomp es una definición JSON que suele constar de un conjunto de llamadas al sistema y de la acción predeterminada que se ejecuta si se produce una de ellas.
Kubernetes ofrece un mecanismo para usar perfiles personalizados mediante el ajuste seccompProfile en securityContext.
Hay tres valores posibles para el campo type:
Localhost: el ajustelocalhostProfileproporciona una ruta dentro del contenedor a un perfil seccomp.Unconfined: no se aplica ningún perfil.RuntimeDefault: se usa el valor predeterminado del entorno de ejecución del contenedor. Este es el valor predeterminado si no se especifica el tipo.
Puedes aplicar estos ajustes en PodSecurityContext o securityContext. Si se configuran ambos, se usan los ajustes de nivel de contenedor en securityContext. Ten en cuenta que la API de configuración securityContext se lanzó en Kubernetes v1.19. Si implementas en versiones anteriores, la sintaxis es diferente; consulta el sitio de documentación de Kubernetes para ver detalles y ejemplos.
Como ocurre con la mayoría de los ajustes relacionados con la seguridad, aquí se aplica el principio de privilegio mínimo. Dale a tu contenedor únicamente los privilegios que necesita. Comienza creando un perfil que simplemente registre las llamadas al sistema que se realizan y luego prueba la aplicación para compilar una lista de llamadas al sistema permitidas. Puedes encontrar más información sobre este proceso en los tutoriales de Kubernetes.
5. Evita los contenedores privilegiados y la escalada de privilegios [C]
Otorgar privilegios a un contenedor es peligroso y suele usarse como una forma más sencilla de obtener permisos específicos que, de otro modo, se podrían controlar mediante el acceso a capabilities. El entorno de ejecución del contenedor controla la implementación exacta de la marca de privilegios, pero, en la práctica, otorga todos los privilegios al contenedor y elimina las limitaciones aplicadas por el controlador cgroup de dispositivos. También puede modificar la configuración de Linux Security Module y permitir que los procesos dentro del contenedor escapen de este.
Los contenedores aíslan los procesos en el host, por lo que, incluso si el contenedor se ejecuta como root, hay capabilities que el entorno de ejecución no le otorga. Cuando se activa la marca de privilegios, el entorno de ejecución otorga todas las capabilities de root del sistema. Esto es extremadamente peligroso desde el punto de vista de la seguridad, ya que permite el acceso total al sistema host subyacente.
Evita usar la marca de privilegios. Si tu contenedor necesita capabilities adicionales, agrega solo las que necesites mediante los ajustes de capabilities. A menos que tu contenedor necesite controlar ajustes del sistema en el kernel del host (como acceder a hardware específico o reconfigurar redes) y acceder al sistema de archivos del host, no necesita la marca de privilegios.
Para profundizar en los contenedores privilegiados, consulta el artículo de Matt: Contenedores Docker privilegiados: ¿realmente los necesitas?
6. Capabilities del kernel de Linux [C]
Las capabilities son permisos a nivel del kernel que permiten controlar de forma más granular los permisos de las llamadas al kernel, en lugar de ejecutar todo como root. Entre otras cosas, permiten cambiar los permisos de archivos, controlar el subsistema de red y realizar funciones de administración de todo el sistema. En securityContext, Kubernetes permite configurar la eliminación o incorporación de capabilities. Puedes especificar capabilities individuales o una lista separada por comas como un arreglo de cadenas. También puedes usar la abreviatura -all para agregar o eliminar todas las capabilities. Esta configuración se transmite al entorno de ejecución del contenedor, donde se configura el conjunto de capabilities al crearlo. Si no hay una sección de capabilities en securityContext, el contenedor recibe el conjunto predeterminado que proporciona el entorno de ejecución.
La práctica recomendada es eliminar todas las capabilities y luego agregar únicamente las que realmente necesita tu aplicación. En muchos casos, las aplicaciones no necesitan ninguna capability durante el funcionamiento normal. Compruébalo eliminándolas todas y depura cualquier falla mediante la supervisión de los registros de auditoría para ver qué capabilities se bloquearon.
Ten en cuenta que, al enumerar las capabilities que quieres agregar o eliminar en securityContext, debes quitar el prefijo CAP_ que usa el kernel para nombrarlas. Para depurar, la herramienta capsh muestra en un formato legible exactamente qué capabilities están habilitadas en tu contenedor y está disponible para la mayoría de las distribuciones. No la dejes disponible en contenedores de producción, ya que facilitaría mucho que un atacante averigüe qué capabilities están habilitadas. Si prefieres leer mapas de bits, también puedes consultar las capabilities habilitadas en el archivo /proc/1/status.
Aprende a mejorar la seguridad de Kubernetes eliminando las capabilities predeterminadas de un contenedor.
7. Ejecuta el contenedor con un sistema de archivos de solo lectura [C]
Si tu contenedor se ve comprometido y tiene un sistema de archivos de lectura y escritura, un atacante puede cambiar su configuración, instalar software y, potencialmente, lanzar otros exploits. Tener un sistema de archivos de solo lectura ayuda a prevenir este tipo de escaladas al limitar las acciones que puede realizar un atacante. En general, los contenedores no deberían necesitar escribir en su sistema de archivos. Si tu aplicación tiene datos con estado, deberías usar un método de persistencia externo, como una base de datos, un volumen u otro servicio. Además, asegúrate de que todos los registros se escriban en stdout o en un reenviador de registros, donde puedan recopilarse de forma centralizada.
8. procMount [C]
De forma predeterminada, los entornos de ejecución de contenedores ocultan ciertas partes del sistema de archivos /proc desde el interior de un contenedor para prevenir posibles problemas de seguridad. Sin embargo, hay ocasiones en que se necesita acceder a esas partes de /proc, en particular cuando se usan contenedores anidados, como suele hacerse en los procesos de compilación dentro del clúster. Solo hay dos opciones válidas para esta entrada: Default, que mantiene el comportamiento estándar del entorno de ejecución de contenedores, o Unmasked, que elimina todo el enmascaramiento del sistema de archivos **/proc**.
Obviamente, solo deberías usar esta opción si realmente sabes lo que haces. Si la estás usando para compilar imágenes, revisa la versión más reciente de tu herramienta de compilación, ya que muchas ya no la necesitan. Actualiza la herramienta y vuelve al valor predeterminado de procMount que corresponda a la herramienta que estés usando.
Por último, si descubres que necesitas usar esta opción, hazlo únicamente para un contenedor anidado; nunca expongas el sistema de archivos /proc de tu sistema host a un contenedor.
9. fsGroup / fsGroupChangePolicy [P]
La configuración fsGroup define un grupo al que Kubernetes asignará la propiedad de todos los archivos de los volúmenes cuando estos se monten en un pod. El comportamiento también está controlado por fsGroupChangePolicy, que puede configurarse como onRootMismatch o Always. Si se configura como onRootMismatch, los permisos solo cambiarán si aún no coinciden con los permisos de la raíz del contenedor.
Ten cuidado al usar fsGroup. Cambiar la propiedad de grupo de todo un volumen puede retrasar el inicio de los pods en sistemas de archivos lentos o grandes. También puede perjudicar a otros procesos que compartan el mismo volumen si no tienen permisos de acceso al nuevo GID. Por este motivo, algunos proveedores de sistemas de archivos compartidos, como NFS, no implementan esta funcionalidad. Además, estas configuraciones no afectan a los volúmenes efímeros.
10. sysctls [P]
Los sysctl son una función del kernel de Linux que permite a los administradores modificar la configuración del kernel. En un sistema operativo Linux completo, se definen mediante /etc/sysctl.conf y también pueden modificarse con la utilidad **sysctl**.
La configuración sysctls en securityContext permite modificar sysctl específicos en el contenedor. Solo un pequeño subconjunto de los sysctl del sistema operativo puede modificarse por contenedor, aquellos cuyo espacio de nombres está aislado en el kernel. De este subconjunto, algunos se consideran seguros. Un conjunto mucho más amplio se considera no seguro, según el posible impacto en otros pods. Los sysctl no seguros suelen estar deshabilitados en los clústeres y el administrador del clúster debe habilitarlos explícitamente.
Debido al riesgo de desestabilizar el sistema operativo subyacente, deberías evitar modificar los parámetros del kernel mediante sysctls, salvo que tengas requisitos muy específicos. También deberías revisar estos cambios con el operador de tu clúster.
Una nota sobre securityContext en tiempo de ejecución
En muchos casos, la configuración de seguridad descrita aquí se combina con el control de admisión basado en políticas para garantizar que los ajustes necesarios estén configurados antes de iniciar contenedores en el clúster. Al combinar la configuración de securityContext con una PodSecurityPolicy, puedes asegurarte de que solo se inicien los contenedores que cumplen la política, mediante la aplicación de ajustes específicos de securityContext. La configuración de securityContext también puede agregarse a la configuración del contenedor al momento del inicio mediante Dynamic Admission Control y el uso de webhooks mutables.
Conclusión
Hay muchos aspectos que debes tener en cuenta al reforzar la seguridad de las implementaciones de tus aplicaciones con la configuración de securityContext. Si se usan correctamente, son una herramienta muy eficaz, y esperamos que esta lista ayude a tus equipos a elegir las opciones adecuadas para sus cargas de trabajo y entornos. Snyk puede ayudarte a tomar estas decisiones mediante el análisis de tus archivos YAML de Kubernetes para detectar errores de configuración comunes. Regístrate para obtener una cuenta gratis con el botón de abajo.
Protege la infraestructura desde el origen
Snyk automatiza la seguridad y el cumplimiento de IaC en los flujos de trabajo, y detecta recursos con desviaciones de configuración y recursos faltantes.