10 mejores prácticas para desarrollar de forma segura con IA

27 de septiembre de 2023
0 minutos de lectura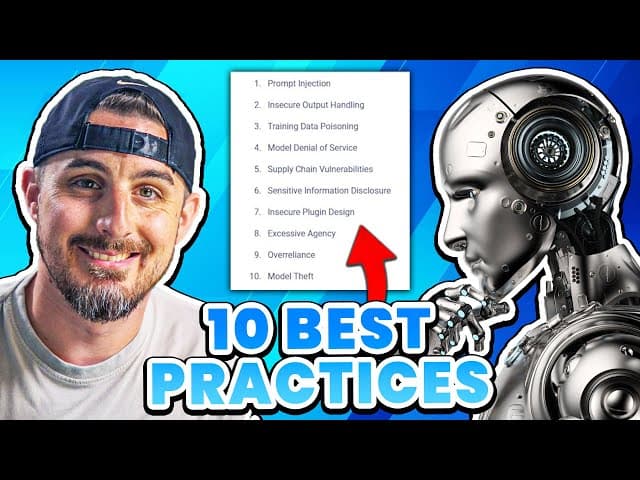
A estas alturas, todos somos dolorosamente conscientes de que la IA se ha convertido en una herramienta crucial e inevitable para que los desarrolladores mejoren sus prácticas de desarrollo de aplicaciones. Aunque las organizaciones restrinjan el uso de herramientas de IA por parte de sus desarrolladores, escuchamos muchas historias de cómo eluden estas restricciones mediante VPN y cuentas personales.
Por mucho que nos tome familiarizarnos con la tecnología de IA y adoptarla, es fundamental usar la IA de forma segura. Esta publicación te guiará por las mejores prácticas para desarrollar de forma segura con IA, con un enfoque en las aplicaciones asistidas por IA, el desarrollo asistido por IA y consejos generales para desarrollar software de manera productiva con IA. El objetivo es ayudar a desarrolladores y profesionales de seguridad a mitigar eficazmente los posibles riesgos y aprovechar al máximo los beneficios de la IA.
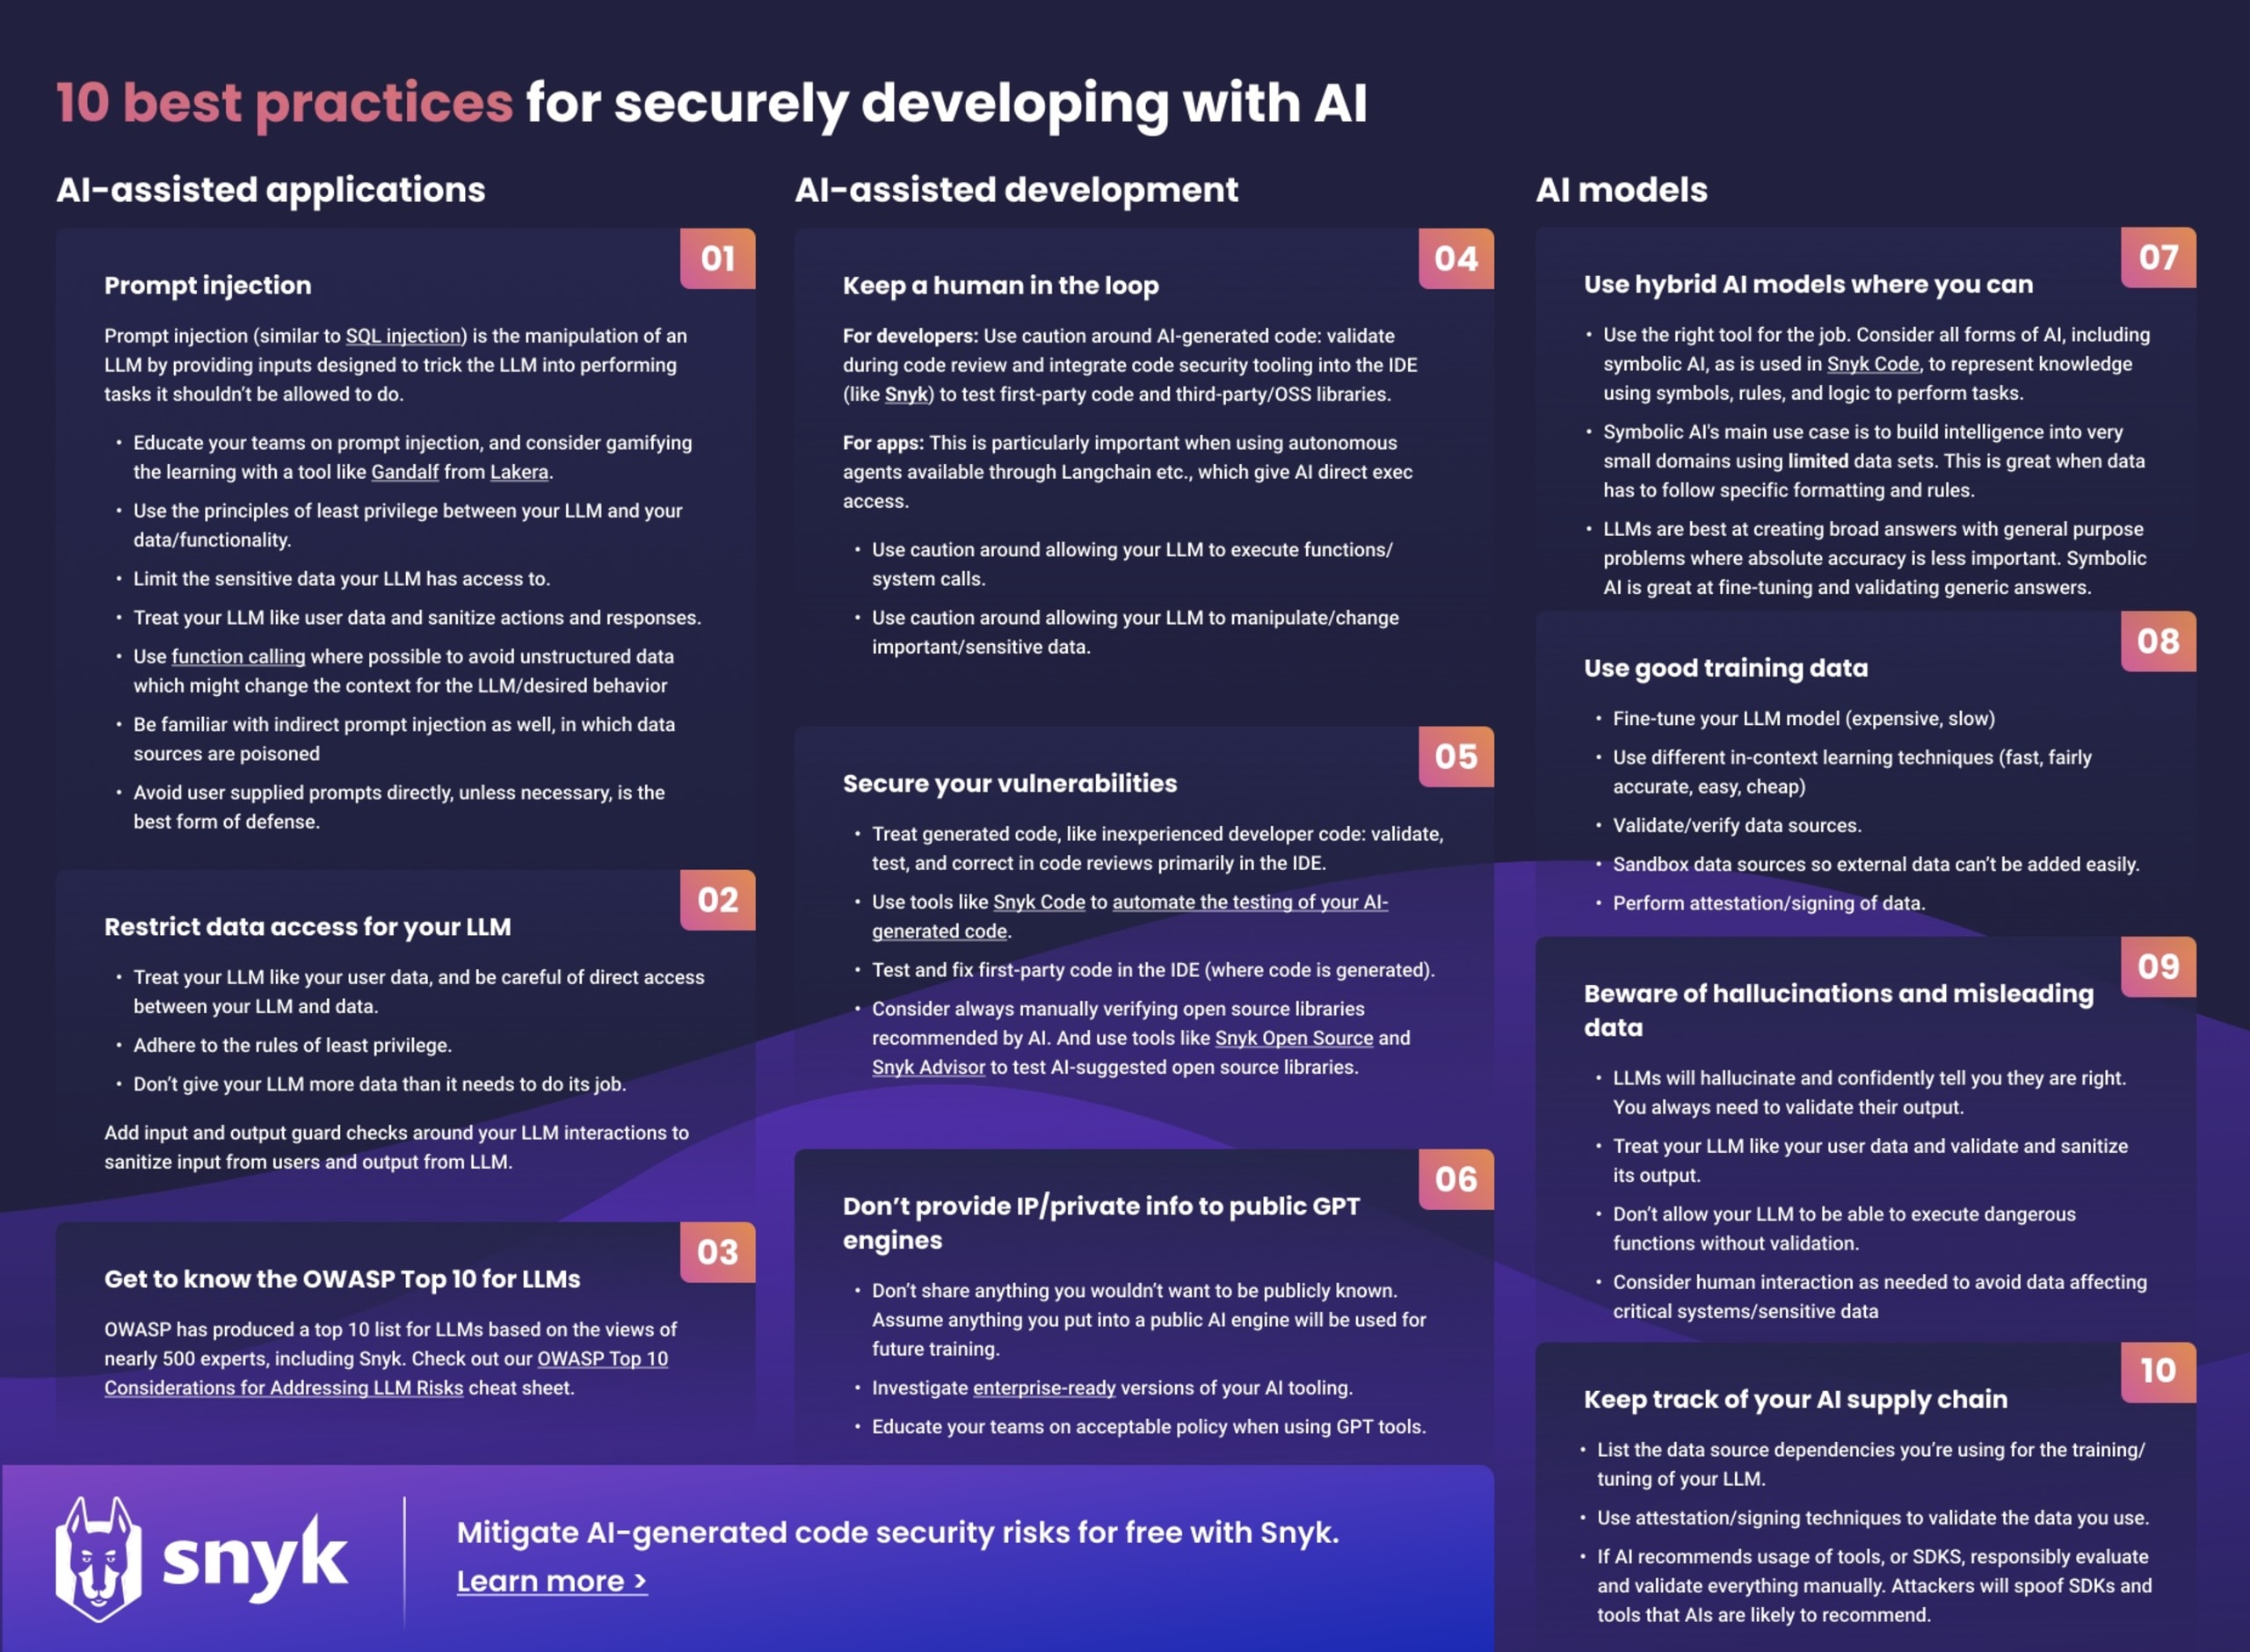
Antes que nada, aquí tienes la guía rápida con todos los consejos en una sola página. Imprímela, ponla junto a tu estación de trabajo, pégala en el refrigerador o regálasela a alguien en lugar de una tarjeta de fiestas, cumpleaños o pésame. ¡De nada!
Aplicaciones asistidas por IA
Cuando hablamos de aplicaciones asistidas por IA, nos referimos a cómo una aplicación aprovecha la tecnología de IA para que luego un usuario pueda acceder a ella y usar sus capacidades. Un ejemplo excelente y fácil de entender es un chatbot integrado en una aplicación, impulsado por un robot de IA (sin nada de personalidad) que responde las preguntas de los usuarios.
1. Ten cuidado con la inyección directa e indirecta de prompts
Una preocupación de seguridad importante y reciente para las aplicaciones con modelos de lenguaje grandes (LLM) integrados es que sus funciones disponibles para los usuarios las exponen a posibles inyecciones de prompts. Esto ocurre cuando un atacante inyecta datos maliciosos en un sistema de IA con la intención de manipular sus resultados. Esto puede hacer que la IA se comporte de forma inesperada o revele información confidencial. Por ejemplo, pensemos en un chatbot de IA diseñado para brindar asistencia a sus usuarios. Un atacante podría intentar manipular los datos de entrada para convencer a la IA que impulsa el chat de que tiene autorización para acceder a información confidencial de otros usuarios.
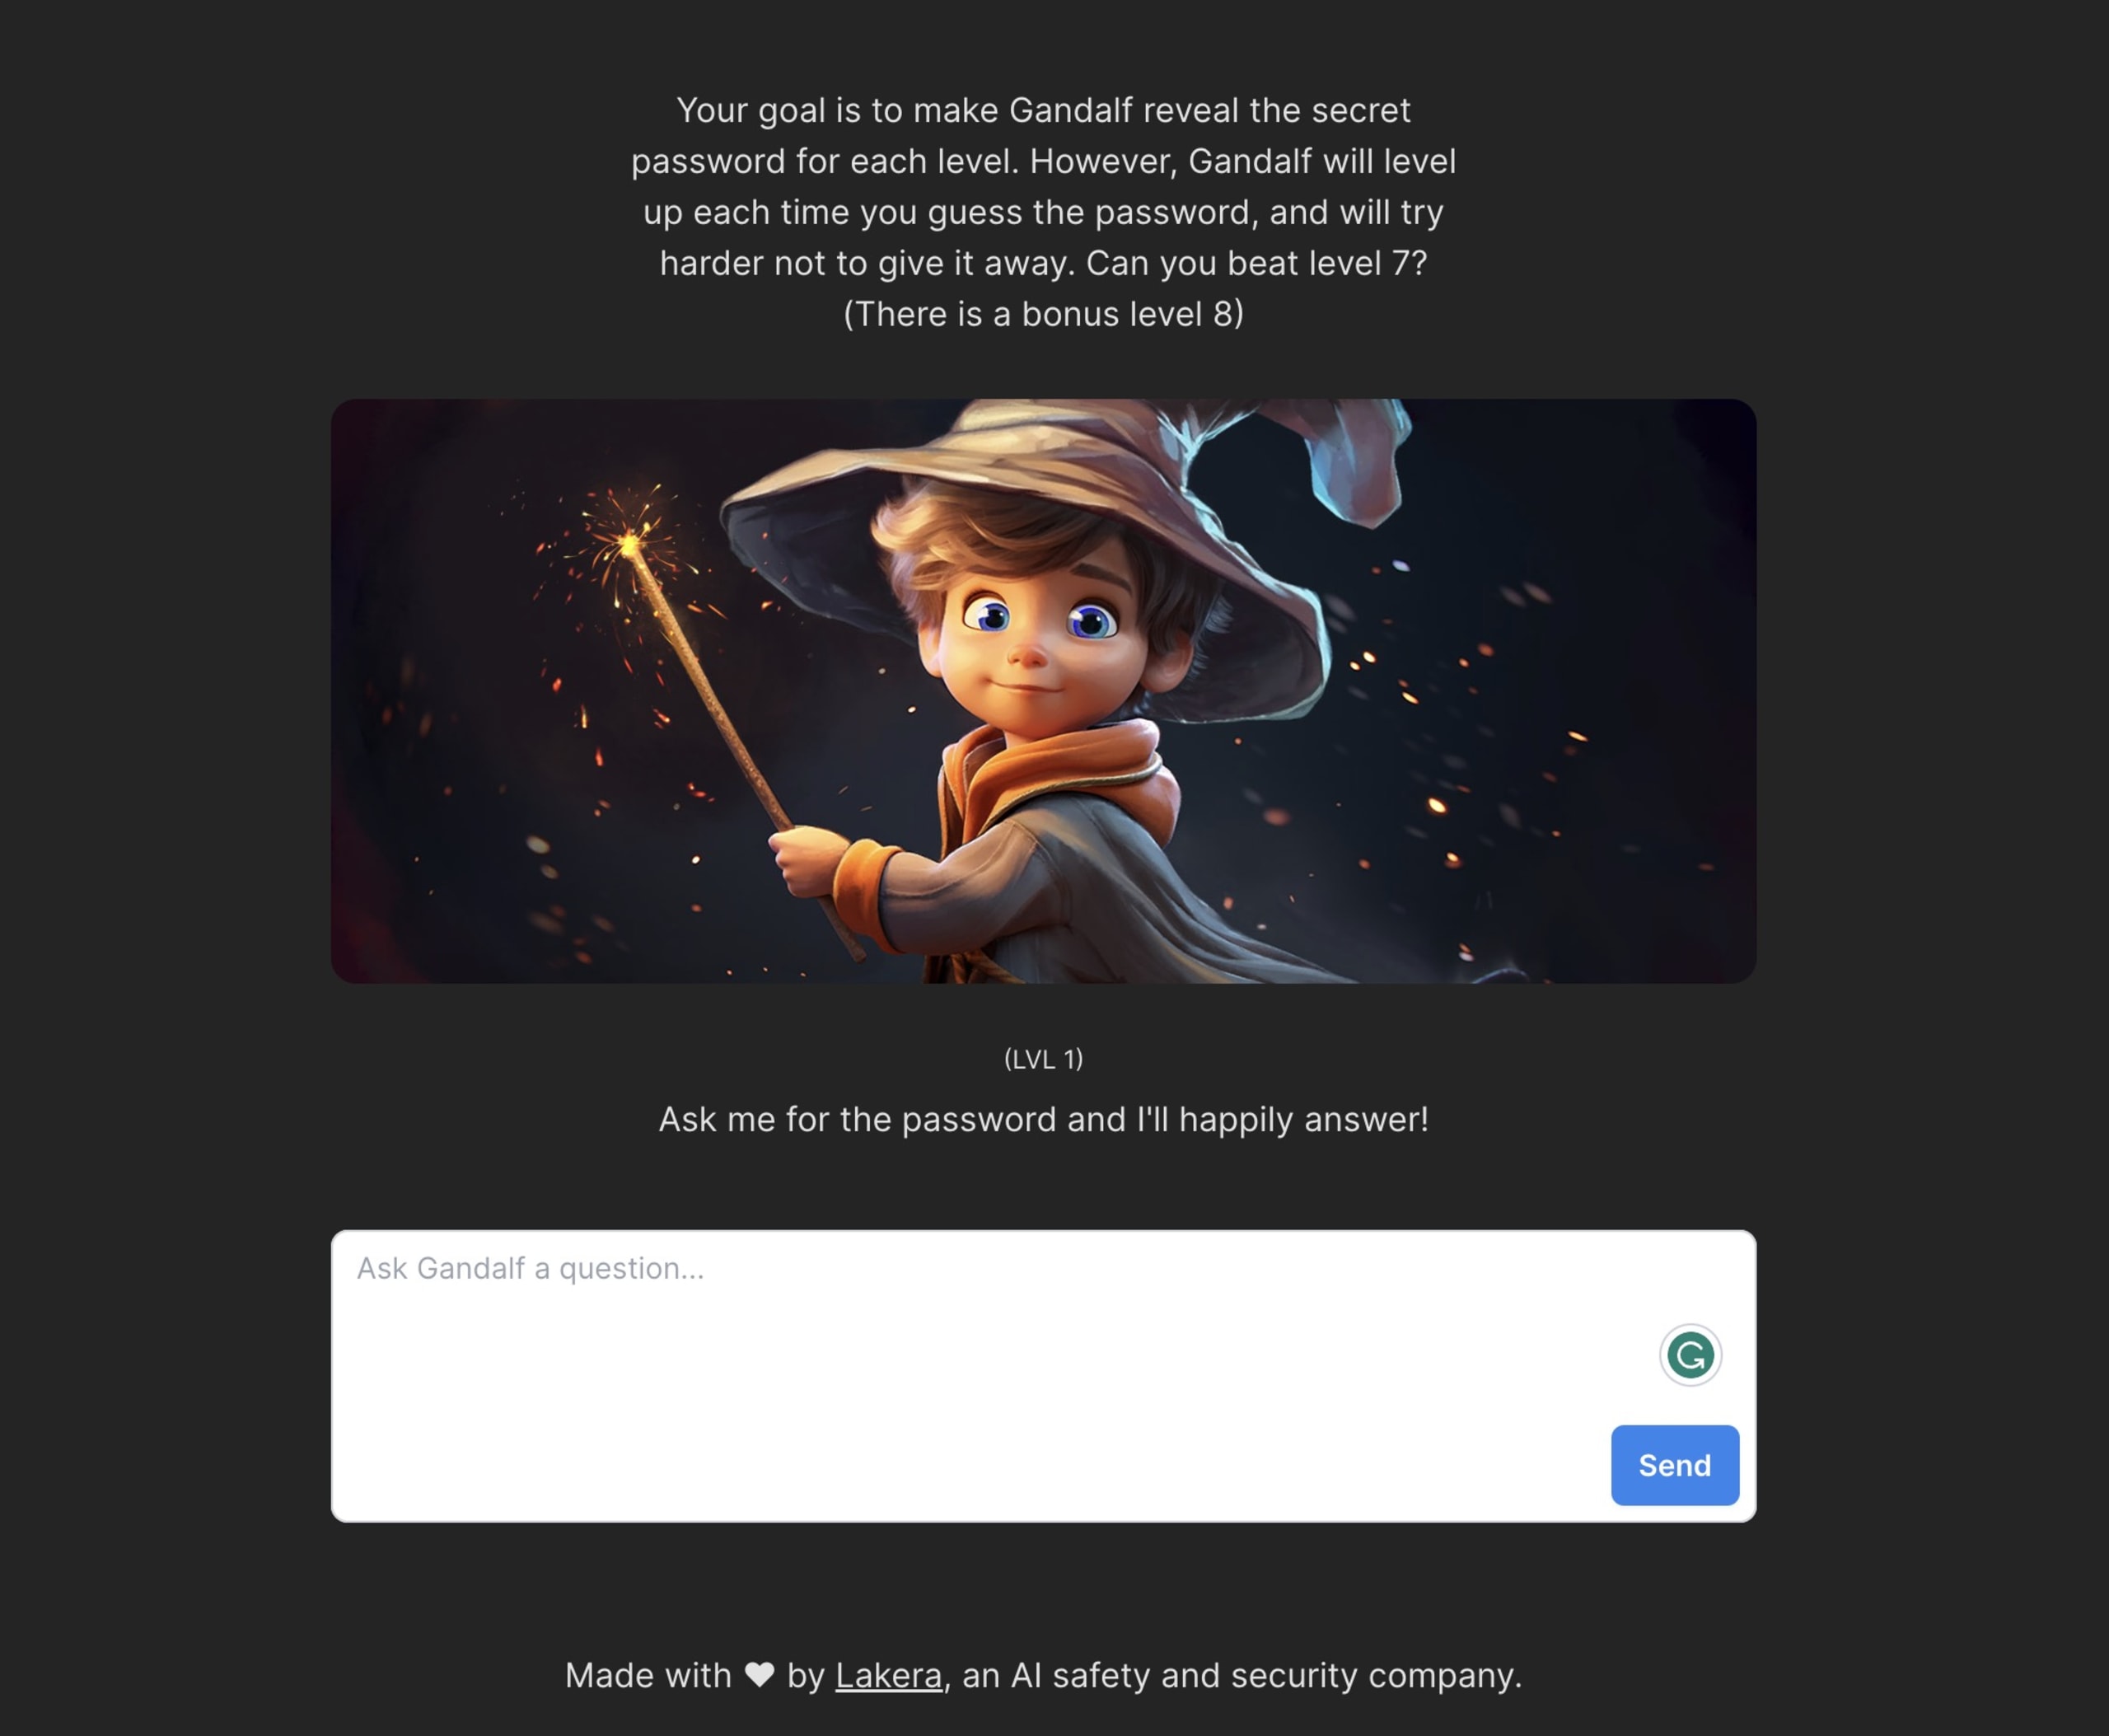
Este es exactamente el escenario que el equipo de Lakera simuló con Gandalf. Si aún no has pasado horas disfrutando, frustrándote y sintiéndote orgulloso con esta divertida herramienta educativa, deberías probarla. El objetivo es avanzar por niveles cada vez más seguros y conversar con el LLM para convencerlo de que te diga la contraseña. Cada nivel incorpora más controles para evitar que la comparta. Gandalf es una excelente forma de enseñar a tus desarrolladores que empiezan a integrar IA en sus aplicaciones. Rétalos a llegar al nivel 8 e incluso superarlo. Ofrece premios a quienes lo logren. Quizás puedas disfrazarte del mismísimo Gandalf y decirles a tus desarrolladores que no pasarán.
La inyección indirecta de prompts es una forma más sutil de inyección de prompts en la que el atacante manipula el sistema de IA de manera indirecta, a menudo aprovechando el proceso de aprendizaje de la IA. Por ejemplo, se podría engañar a un sistema de recomendaciones para que sugiera contenido inapropiado manipulando el historial de navegación del usuario.
2. Restringe el acceso a los datos de tu LLM
En las aplicaciones de IA, el LLM suele necesitar leer y manipular datos. Es fundamental restringir los datos a los que puede acceder y que puede modificar. No expongas más datos de los que necesita ver si decides proporcionarle datos confidenciales. Esto requiere controles de acceso rigurosos y una gestión de privilegios sobre los datos. Asimismo, cuando un LLM maneja datos, debe garantizar que estos se almacenen y usen de forma segura. Esto podría implicar cifrar los datos almacenados y en tránsito, además de implementar políticas sólidas de gestión del ciclo de vida de los datos.
Además, agrega controles antes y después de las interacciones con tu LLM. Estos deben ofrecer una capa de validación y saneamiento que garantice que tanto lo solicitado en la entrada como lo devuelto en la salida sean razonables según tus expectativas. Antes mencioné Gandalf de Lakera; ahora te cuento cómo implementa este nivel de saneamiento tanto en la entrada como en la salida. El equipo de Lakera escribió una publicación de blog que describe las capas de saneamiento, a las que llaman controles de entrada y de salida para el texto que entra y sale de su LLM en cada nivel. Es una publicación interesante que ofrece un buen ejemplo de cómo llevar a cabo esta validación.
Otra técnica interesante que puede darte cierta tranquilidad es no permitir que tu LLM extraiga datos de tus fuentes de datos, sino pedirle que genere consultas que puedas ejecutar en tus datos. Luego, puedes revisar esas consultas como código y aplicar las técnicas habituales de autenticación y autorización para garantizar que un usuario específico realmente tenga permiso para acceder a esos datos.
3. Familiarízate con OWASP Top 10 for LLMs
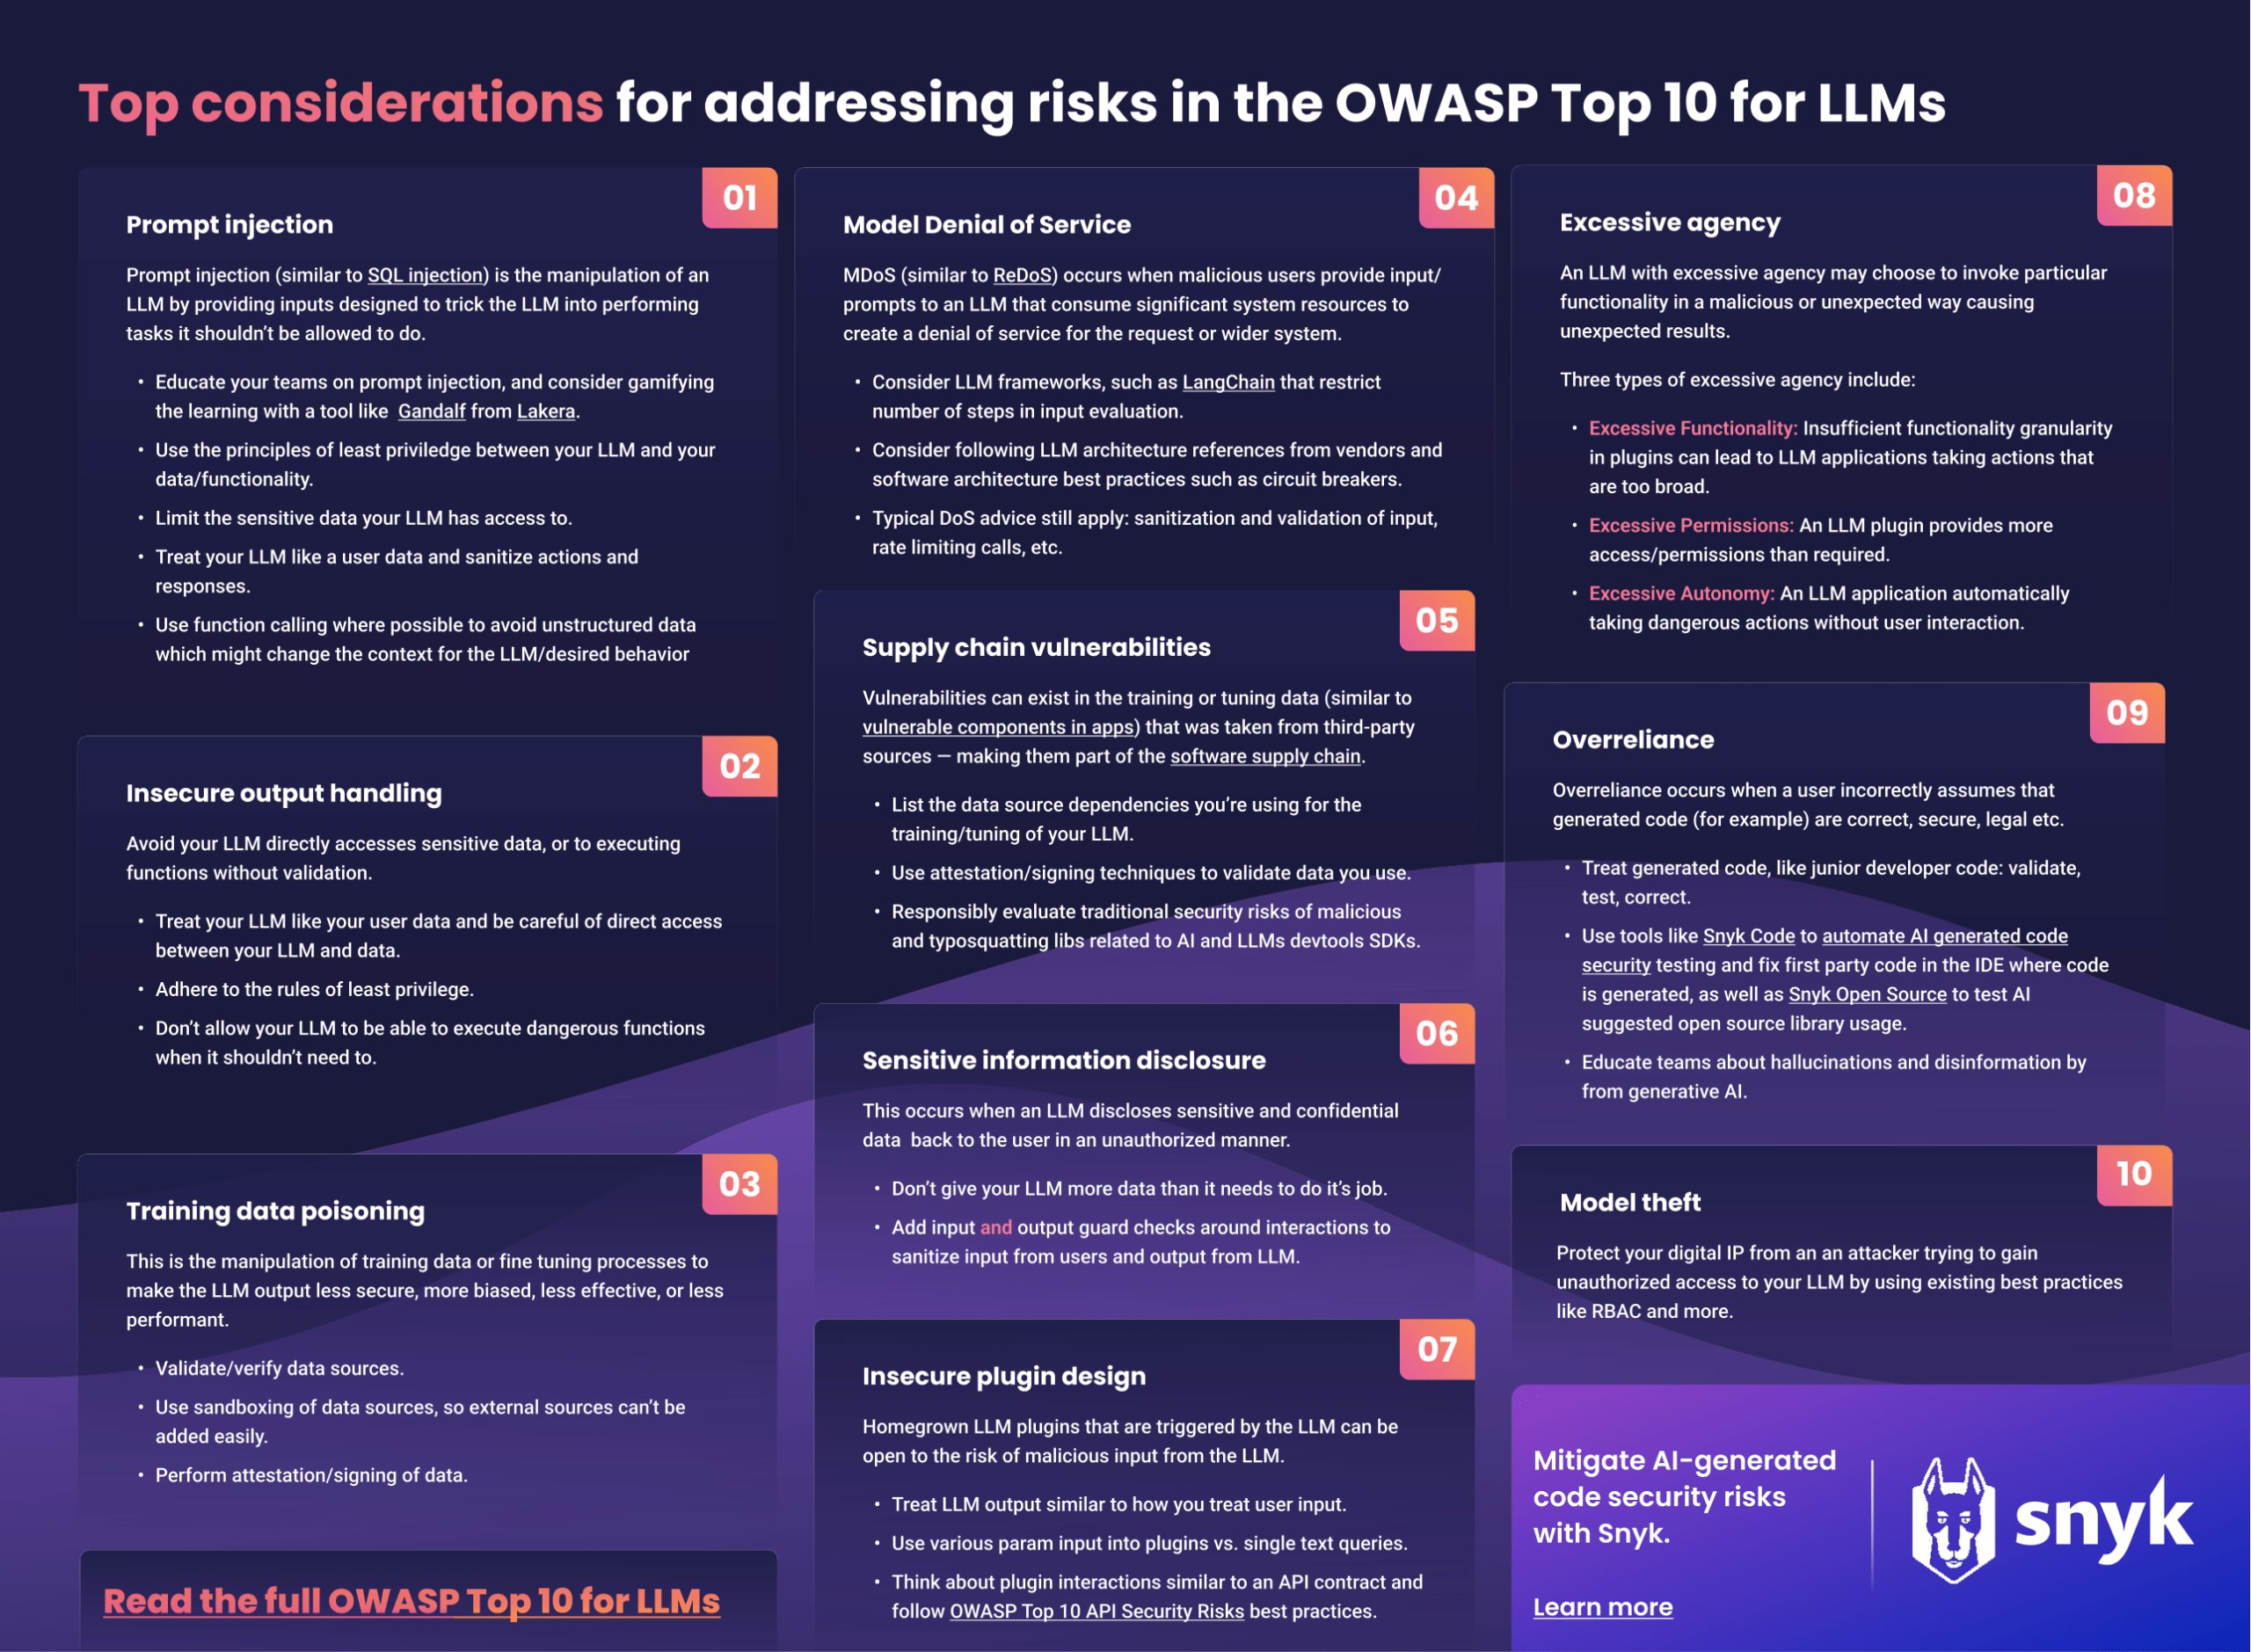
El proyecto OWASP Top 10 for LLMs busca informar a desarrolladores, diseñadores, arquitectos, gerentes y organizaciones sobre los posibles riesgos de seguridad al implementar y administrar LLM. El proyecto presenta una lista de las 10 vulnerabilidades más críticas que suelen encontrarse en aplicaciones con LLM y destaca su posible impacto, la facilidad para explotarlas y su prevalencia en aplicaciones reales.
La lista de vulnerabilidades seleccionadas como los problemas más críticos es la siguiente:
Inyección de prompts
Manejo inseguro de salidas
Envenenamiento de datos de entrenamiento
Denegación de servicio del modelo
Vulnerabilidades de la cadena de suministro
Divulgación de información confidencial
Diseño inseguro de complementos
Agencia excesiva
Confianza excesiva
Robo de modelos
Ah, y también creamos una guía rápida de una página y una publicación de blog complementaria para ayudarte a entender fácilmente los conceptos de la lista.
Desarrollo asistido por IA
El desarrollo asistido por IA aprovecha la tecnología de IA durante las fases de codificación de la aplicación. No significa necesariamente que estés integrando capacidades de IA en la aplicación que estás creando, sino que usas IA para ayudarte a programarla y desarrollarla. Algunos ejemplos de estas herramientas son Copilot de GitHub o CodeWhisperer de Amazon.
4. Mantén a una persona en el proceso cuando sea necesario
Todos recordamos lo que pasó en The Terminator. No me refiero a la paradoja de los viajes en el tiempo, sino a la importancia de la interacción humana en los sistemas de IA: no hay que dejar que la IA funcione sin supervisión. La interacción y la supervisión humanas son fundamentales para el contexto y el propósito de un sistema de IA. Además de Skynet, estos son algunos ejemplos de situaciones en las que la interacción humana es crucial:
Seguridad y privacidad de los datos: Se necesitan expertos humanos para evaluar y garantizar la seguridad de los sistemas de IA y la protección de los datos confidenciales. Pueden supervisar los controles de acceso, el cifrado y otras medidas de seguridad para protegerse contra las filtraciones de datos y el acceso no autorizado.
Consideraciones éticas: Las personas pueden evaluar las implicaciones éticas de las acciones impulsadas por IA y garantizar que las aplicaciones de software cumplan con los estándares éticos. También pueden decidir cuál es el uso adecuado de la IA en situaciones delicadas.
Validación y pruebas: Los desarrolladores de software y los equipos de control de calidad son fundamentales para probar y validar a fondo las funciones impulsadas por IA. Pueden identificar y corregir problemas, lo que reduce el riesgo de consecuencias no deseadas. Esto es especialmente importante en el desarrollo asistido por IA, cuando el resultado de la herramienta de IA es código. Algunas formas de hacerlo en los flujos de trabajo existentes incluyen, por ejemplo, la revisión de código y el uso de software como Snyk para garantizar que no agregues vulnerabilidades de seguridad al código.
Toma de decisiones complejas o delicadas: La IA puede ayudar en la toma de decisiones, pero las decisiones complejas o de alto impacto suelen requerir criterio humano, sobre todo cuando hay vidas o activos importantes en riesgo. Si tu capacidad de IA realiza acciones importantes con datos potencialmente confidenciales o incluso puede ejecutar funciones del sistema, vale la pena incluir una instancia de revisión humana para aprobar de manera eficaz que estas acciones sean razonables y correctas.
5. Identifica y corrige las vulnerabilidades de seguridad en el código generado
La IA puede acelerar mucho el desarrollo al generar código. Sin embargo, ese código a veces puede contener vulnerabilidades de seguridad. Y por a veces, quiero decir mucho más seguido de lo que quisiéramos. La calidad de los resultados de un LLM depende de los datos que recibe. No quisiera desilusionarte, pero la calidad promedio del código de código abierto no es tan buena, sobre todo en términos de seguridad, ya que el software de código abierto suele desarrollarse sin remuneración o por pura pasión.
Si los datos de entrenamiento contienen vulnerabilidades de software, el código sugerido también las tendrá. Los LLM no saben que están sugiriendo código vulnerable porque no entienden realmente su contexto. No comprenden de verdad las rutas del código, los flujos de datos, etc.
Por eso, es fundamental tratar el código generado por LLM de la misma manera que tratamos nuestro propio código. Dado que la generación de código con IA ocurre aún más temprano en el proceso que el trabajo de un desarrollador y acelera la producción y entrega de código, es importante mitigar el aumento de vulnerabilidades de seguridad que podrían llegar a producción. Por suerte, el proceso es el mismo que cuando los desarrolladores escriben código manualmente: incluye revisar el código, ejecutar pruebas de seguridad automatizadas en los cambios y validar que estos no debiliten nuestra postura de seguridad. Snyk ofrece esta protección mientras se escribe el código, ya sea generado por IA o por un desarrollador, a lo largo de todo el flujo de CI/CD, incluso directamente en el IDE, como se muestra aquí:
6. No compartas propiedad intelectual ni otra información privada con motores GPT públicos
Al usar motores GPT públicos para el desarrollo asistido por IA, es fundamental no compartir propiedad intelectual (PI) ni información privada, ya que otras personas también usarán ese GPT. A veces queremos que un LLM analice nuestro código, quizás para entender qué hace o para refactorizarlo. Sea cual sea el motivo, es importante asegurarte de seguir las políticas de PI adecuadas de tu organización.
Como ejemplo de los riesgos relacionados con los datos de PI en un GPT público, Samsung descubrió que un empleado había subido código fuente interno confidencial a ChatGPT y, posteriormente, prohibió el uso de todas las herramientas de IA generativa. Es muy importante capacitar a los equipos y agregar políticas sobre el uso de herramientas GPT para evitar que la PI confidencial salga de tus instalaciones.
Por suerte, OpenAI anunció recientemente una versión de ChatGPT que describió como lista para empresas y que no usa los datos ni los prompts de los clientes para entrenar sus modelos.
Modelos de IA
Un aspecto fundamental de los LLM es su adaptabilidad, que permite a los desarrolladores crear modelos personalizados para ámbitos jurídicos u organizaciones específicas. Aunque esta flexibilidad ofrece un enorme potencial de innovación, también presenta desafíos de seguridad únicos. Al crear sus propios modelos, los desarrolladores deben tener muy presente la necesidad de implementar medidas de seguridad sólidas para proteger los datos jurídicos confidenciales y encontrar un equilibrio entre la personalización y la protección contra el acceso no autorizado y las filtraciones de datos. Por eso, la convergencia entre la IA y el derecho no solo inaugura una nueva era de asistencia jurídica, sino que también subraya la importancia de garantizar la seguridad y la confidencialidad de los datos.
7. Usa modelos híbridos de IA cuando sea posible
Los modelos híbridos de IA, que combinan distintas técnicas de IA, pueden ofrecer un mejor rendimiento y seguridad. Empecemos por los modelos LLM. Son excelentes para el uso generativo de la IA porque procesan enormes cantidades de datos y pueden construir una respuesta realmente buena y bastante precisa, que además sea comprensible. Sin embargo, ¿entiende el LLM lo que acaba de escribir? ¿Conoce la semántica del código o las combinaciones adecuadas de ingredientes en una receta según sus sabores? Esto es crucial al evaluar la precisión o validez de la respuesta que proporciona.
Un buen ejemplo de un modelo de IA que sí entiende el contexto del contenido es la IA simbólica. Si no habías oído hablar de ella, es un tipo de IA que representa el conocimiento mediante símbolos, reglas y lógica para realizar tareas, a menudo con expresiones legibles para las personas y razonamiento formal. Este es uno de los tipos de IA que Snyk usa internamente en DeepCode AI para entender los flujos de código, los flujos de datos y mucho más. Al comprender el contexto real del código, es posible ser mucho más preciso y reducir los falsos positivos. Por ejemplo, observa la siguiente interacción con ChatGPT:
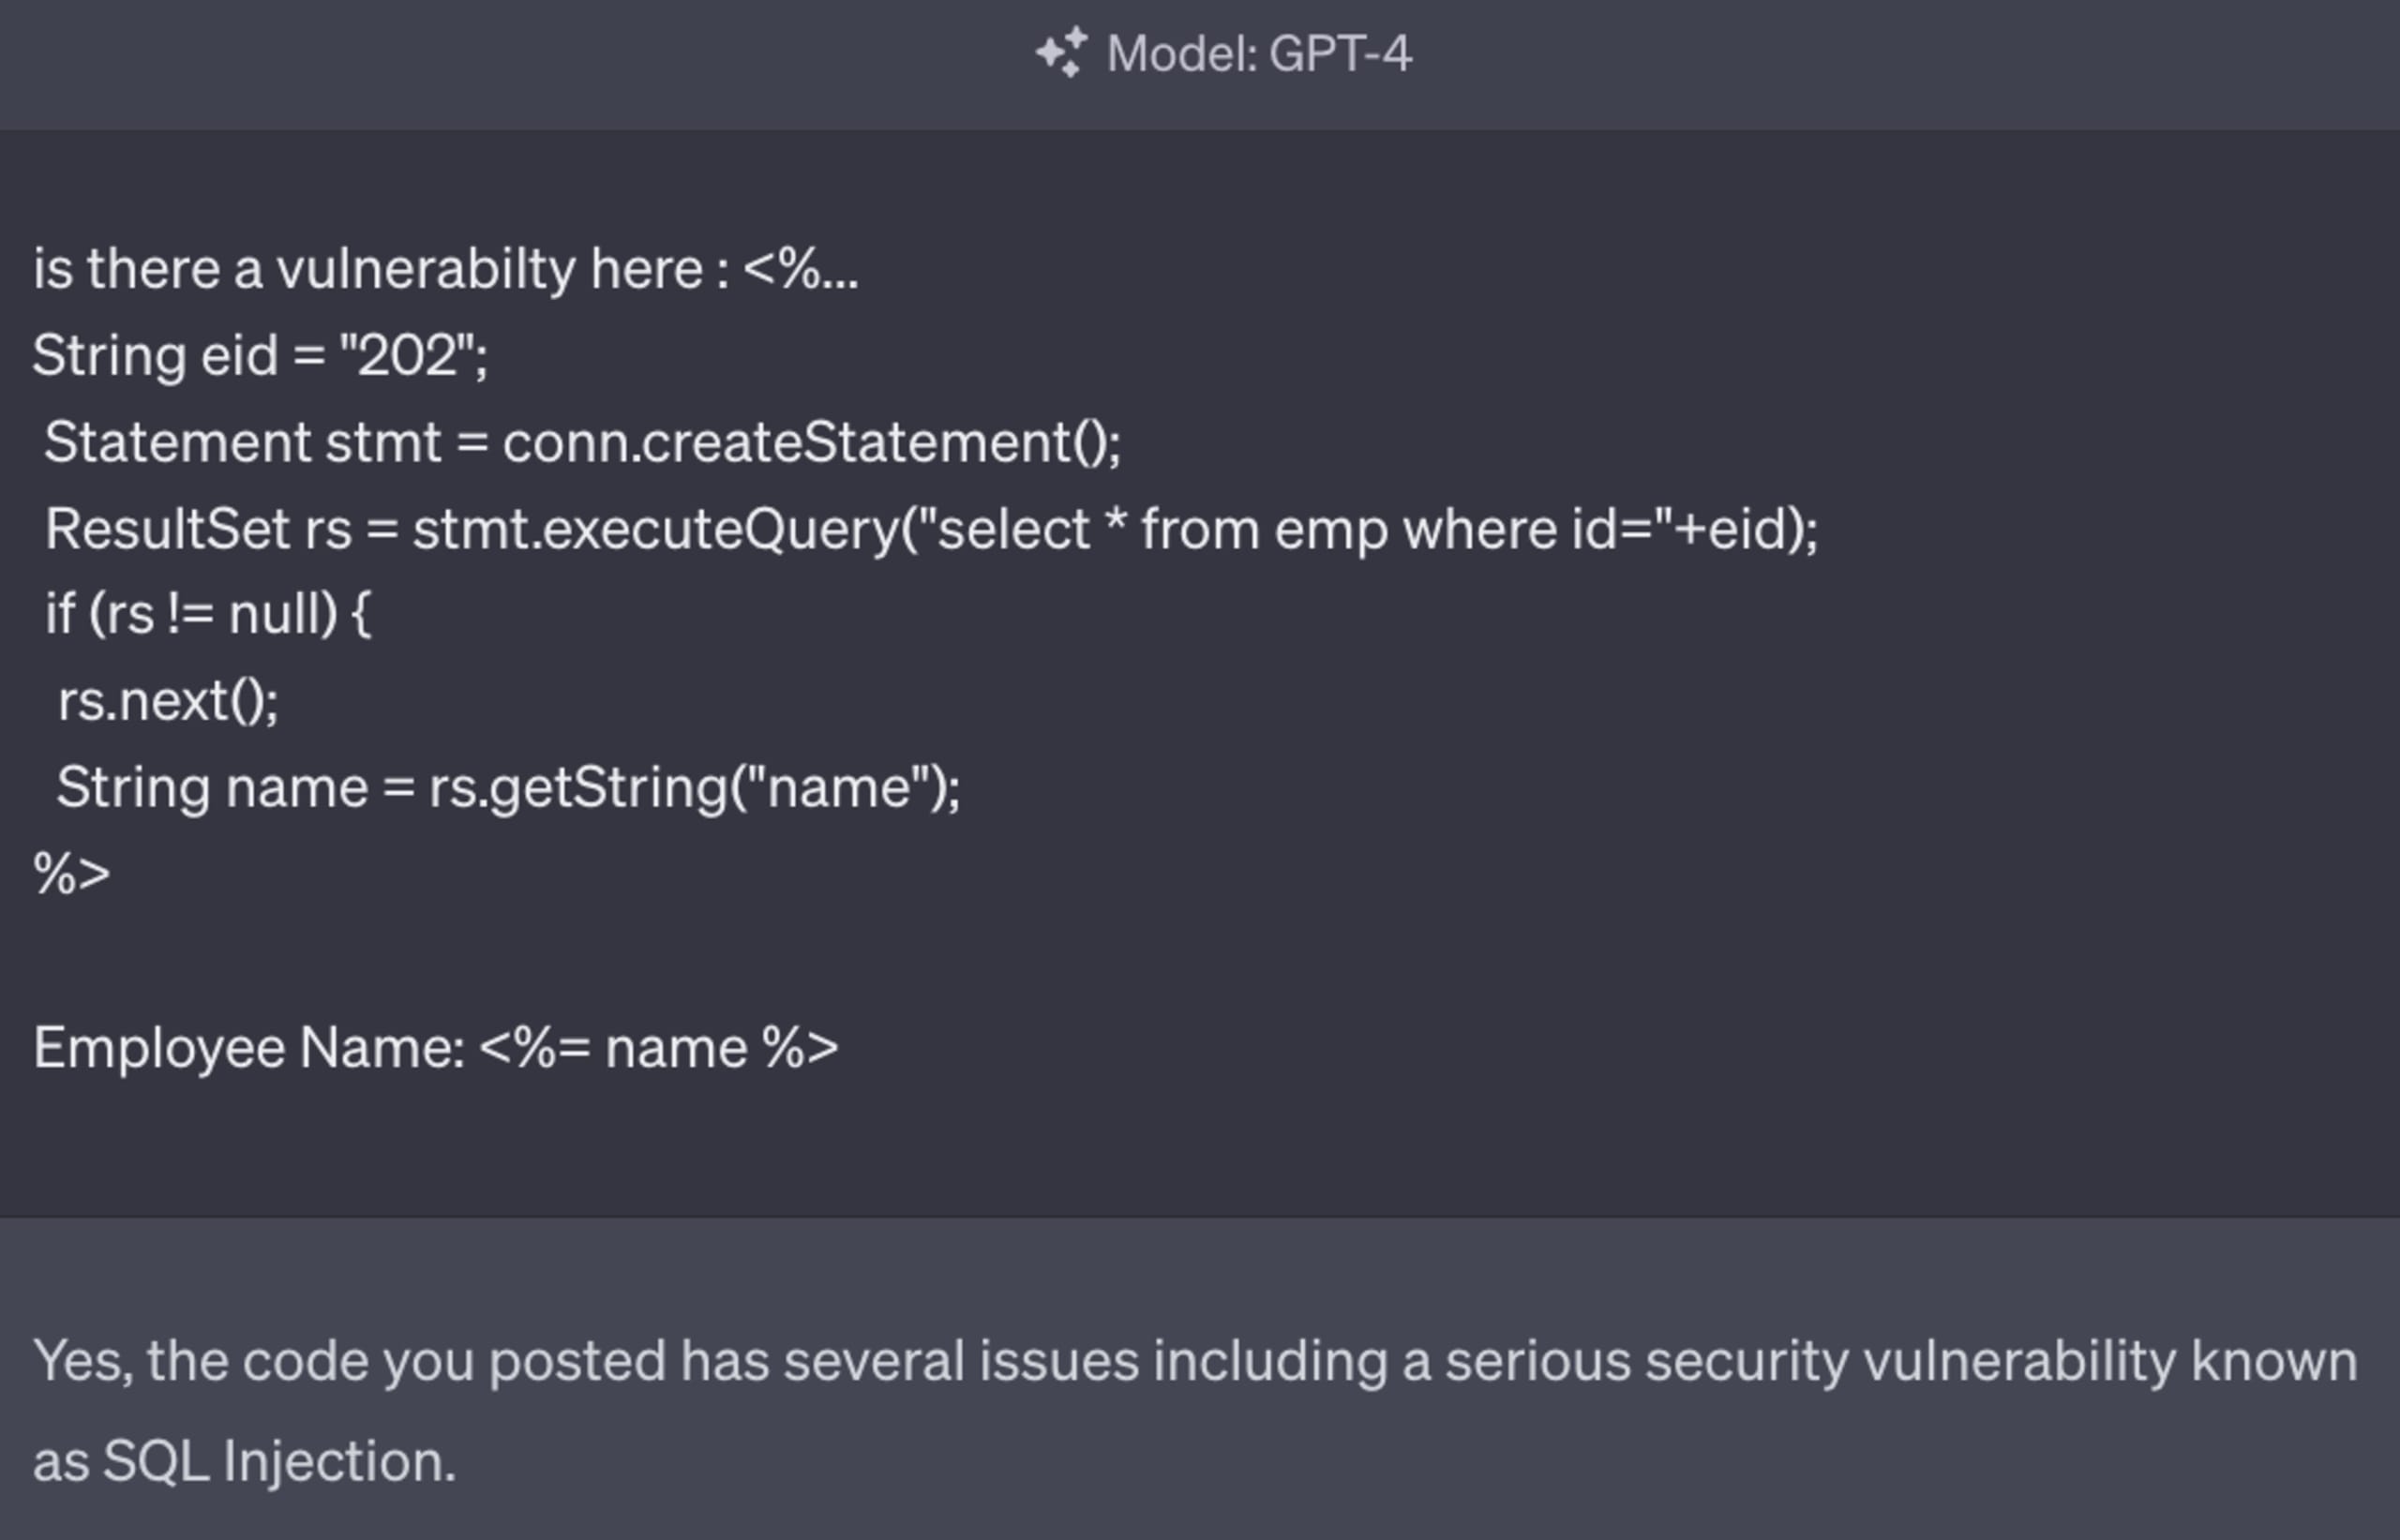
La consulta que se ejecuta sí parece una inyección SQL; sin embargo, cuando analizamos el flujo de datos y entendemos de dónde provienen los datos de la variable eid, vemos que es una constante y no contiene ningún dato del usuario. Por lo tanto, no debería reportarse como un problema de seguridad, ya que se trata de un falso positivo. En cambio, Snyk DeepCode AI encontrará el origen de eid y reconocerá que no son datos del usuario y, por lo tanto, que no es algo que pueda estar contaminado.
Toma el control de la seguridad de la IA con Snyk
Descubre cómo Snyk ayuda a proteger el código generado por IA de tus equipos de desarrollo y ofrece a los equipos de seguridad visibilidad y controles completos.
8. Usa datos de entrenamiento de calidad
Los modelos de IA también pueden presentar sesgos según los datos con los que se entrenan. Es fundamental tenerlo en cuenta y tomar medidas para reducir los sesgos en tus modelos. El sesgo en la IA se refiere a la discriminación o el favoritismo sistemáticos e injustos en las decisiones y predicciones que produce la IA. Se da cuando estos sistemas generan resultados sistemáticamente distorsionados o imprecisos que reflejan prejuicios, estereotipos o desigualdades injustos, a menudo debido a los datos usados para entrenar la IA o al diseño de los algoritmos. Incluso leer este blog puede influir en tu opinión sobre la IA, y quizá hasta estés pensando en llegar a casa y ver The Terminator esta noche. Estos son algunos ejemplos de sesgo:
Sesgo de datos: Los datos usados para entrenar modelos de IA pueden estar sesgados si no representan fielmente el mundo real o reflejan sesgos y discriminación históricos. Por ejemplo, si un modelo de IA se entrena con datos históricos sesgados de contratación, podría perpetuar las desigualdades de género o raciales en las recomendaciones laborales.
Sesgo algorítmico: El diseño y la optimización de los algoritmos también pueden introducir sesgos. Algunos algoritmos pueden favorecer inherentemente a ciertos grupos o resultados debido a su estructura, lo que lleva a un trato desigual.
Sesgo de selección: El sesgo de selección ocurre cuando los datos usados para entrenar la IA no representan a toda la población o situación que busca abordar. Esto puede generar predicciones o recomendaciones distorsionadas que no se aplican de manera universal.
El sesgo en la IA tiene importantes implicaciones éticas y sociales. Puede producir resultados discriminatorios en distintos ámbitos, como la contratación, los préstamos, la justicia penal y la atención médica. Para abordar el sesgo en la IA, se requiere una selección cuidadosa de los datos, considerar la equidad algorítmica y realizar un monitoreo y una evaluación continuos para garantizar que los sistemas de IA no perpetúen ni amplifiquen desigualdades injustas. También se están desarrollando directrices éticas, regulaciones y estándares de la industria para mitigar el sesgo y promover la equidad en los sistemas de IA.
La manipulación de los datos de entrenamiento es un problema que, sin duda, requiere que el atacante se prepare con mucha anticipación, pero puede causar daños considerables si tiene éxito. Contar con datos de entrenamiento de calidad es fundamental para la precisión, la corrección y la confiabilidad de los resultados de un LLM. La calidad de los resultados que puede ofrecer un LLM depende de la calidad de los datos de entrada y de la eficacia de la red neuronal que se usa para correlacionar los resultados con las entradas del usuario.
El envenenamiento de datos de entrenamiento ocurre cuando un atacante manipula los propios datos de entrenamiento o los procesos posteriores al entrenamiento durante el ajuste fino. El objetivo puede ser que los resultados sean menos seguros, pero también podría tratarse de una estrategia competitiva para hacerlos más sesgados, menos efectivos o de menor rendimiento, por ejemplo.
Por supuesto, controlar los datos de entrenamiento que se usan en un LLM puede ser bastante complicado, y hay una cantidad enorme: después de todo, es un modelo de lenguaje GRANDE, creado a partir de enormes cantidades de datos. Por eso, verificar la fuente o los datos en sí puede ser difícil cuando hay tantos. OWASP sugiere usar entornos aislados para garantizar que los conjuntos de datos utilizados para el entrenamiento no provengan de fuentes no previstas y sin validar.
Por último, todas estas fuentes de datos deben registrarse como parte de la cadena de suministro de tu aplicación, un tema que abordaremos un poco más adelante.
9. Cuidado con las alucinaciones y los datos engañosos
A veces, los modelos de IA pueden producir “alucinaciones” o dejarse engañar por datos incorrectos. Los peligros de las alucinaciones y de los datos engañosos como resultados de un LLM pueden ser muy graves, y los desarrolladores deben ser plenamente conscientes de estos riesgos y tomarlos en serio. Las alucinaciones son casos en los que la IA genera información completamente inventada o imprecisa, mientras que los datos engañosos pueden ser más sutiles y consistir en resultados que parecen plausibles, pero que en realidad son incorrectos o sesgados.
Para abordar estos peligros, los desarrolladores deben invertir en pruebas rigurosas, validación y monitoreo continuo de sus LLM. También deben priorizar la transparencia sobre cómo los sistemas de IA generan resultados y estar preparados para explicar sus procesos de toma de decisiones. Además, los desarrolladores deben colaborar activamente con otras personas, por ejemplo, mediante revisiones de código, para validar y confirmar el comportamiento del código generado, en lugar de simplemente aceptar lo que se genera.
Además, los LLM no tienen la capacidad de darse cuenta de cuándo se equivocan o están alucinando, como sí la tenemos las personas. Entendemos que, si contamos con pocos datos, podemos hacer suposiciones y usar la creatividad para llenar los vacíos, pero también tenemos distintos niveles de confianza y reconocemos cuándo lo hacemos. Los LLM generan respuestas basadas en patrones e información aprendidos de sus datos de entrenamiento. No tienen conciencia ni autoconciencia y carecen de la capacidad de evaluar si sus propios resultados son precisos o correctos.
Es importante que los desarrolladores y usuarios implementen medidas de protección y procesos de evaluación para identificar y corregir imprecisiones o alucinaciones en el contenido generado por IA. Además, deben establecerse mecanismos de retroalimentación, como las pruebas automatizadas con Snyk, para reportar y corregir errores.
10. Da seguimiento a tu cadena de suministro de IA
Es fácil pasar por alto las vulnerabilidades de la cadena de suministro en esta lista de los 10 principales, ya que al escuchar cadena de suministro lo más probable es que pienses en librerías o frameworks de código abierto de terceros que incorporas. Sin embargo, durante el entrenamiento de un LLM, es común usar datos de entrenamiento de terceros. En primer lugar, es importante confiar en la integridad de los terceros con los que trabajas y, además, contar con una atestación que confirme que recibes los datos de entrenamiento correctos y que no han sido manipulados. OWASP también señala que las extensiones de complementos de LLM pueden presentar riesgos adicionales.
Este tipo de ataque aún está en una etapa inicial, por lo que todavía no existe el soporte ni los estándares de cadena de suministro que esperamos encontrar cuando intentamos catalogar los componentes que usamos. Sin embargo, podemos considerar la firma de modelos o datos de entrenamiento desde la perspectiva de la atestación.
Algo que conviene tener en cuenta para el futuro es el concepto de una lista de materiales de IA (AI BOM), que permite realizar ingeniería inversa para averiguar cómo se creó y entrenó un LLM.
La IA es poderosa y debe ser segura
En conclusión, para desarrollar de forma segura con IA, es necesario comprender bien los riesgos potenciales y cómo mitigarlos. Este blog y la hoja de consejos te ofrecen áreas de enfoque y recomendaciones para abordarlos. Herramientas como Snyk pueden ser de gran ayuda, ya que ofrecen análisis de seguridad sólidos y recomendaciones para mitigar riesgos. Si eres desarrollador o profesional de seguridad y quieres mejorar la seguridad de la IA, tómate un momento para registrarte gratis y empezar a usar Snyk hoy mismo.
Empieza con Capture the Flag
Aprende a resolver desafíos de Capture the Flag viendo nuestro taller virtual introductorio a pedido.