Aspectos clave para abordar los riesgos del OWASP Top 10 para LLM

7 de septiembre de 2023
0 minutos de lecturaTe damos la bienvenida a esta guía práctica sobre el OWASP Top 10 para LLM. Si nunca habías oído hablar del OWASP Top 10, probablemente lo conozcas sobre todo por su edición sobre seguridad de aplicaciones web. El OWASP Top 10 es un documento ampliamente reconocido e influyente, publicado por OWASP, que se centra en mejorar la seguridad del software y las aplicaciones web. OWASP ha creado otras listas de los 10 principales riesgos (Snyk también tiene algunas, además de una ruta de aprendizaje práctica), sobre todo para aplicaciones web. Estas listas reúnen los diez riesgos de seguridad más críticos y frecuentes que enfrentan actualmente las aplicaciones web, y se actualizan con regularidad según las amenazas nuevas o cambiantes. Los riesgos se seleccionan y clasifican según los aportes de expertos en seguridad, profesionales y organizaciones del sector.
Entonces, ¿de qué estamos hablando? OWASP creó una lista similar de los 10 principales riesgos para los LLM (modelos de lenguaje grandes), basada en las opiniones de casi 500 expertos, entre ellos Snyk. Bueno, a menos que hayas estado viviendo bajo una roca o te hayas ido de vacaciones por nueve meses, sabrás que los LLM están en boca de todos gracias al auge de la IA que inició ChatGPT. Un LLM es un tipo de modelo de IA diseñado para comprender y generar lenguaje humano. Los LLM son un subconjunto del campo más amplio del procesamiento del lenguaje natural (PLN), que se centra en permitir que las computadoras comprendan, interpreten y generen lenguaje humano. Lo que hace interesantes a los LLM para los equipos de desarrollo es su uso en el diseño y la creación de aplicaciones. Y lo que los hace interesantes para los equipos de seguridad es la variedad de riesgos y vectores de ataque que vienen asociados. Analizaremos cuáles son, según OWASP, los 10 problemas de mayor riesgo que enfrentan las aplicaciones que usan esta nueva tecnología.
Sin más preámbulos, aquí tienes la guía práctica, que puedes descargar, imprimir, colgar en la pared o incluso usar para empapelar tu cocina (si lo haces, @snyksec quiere ver fotos de la remodelación).
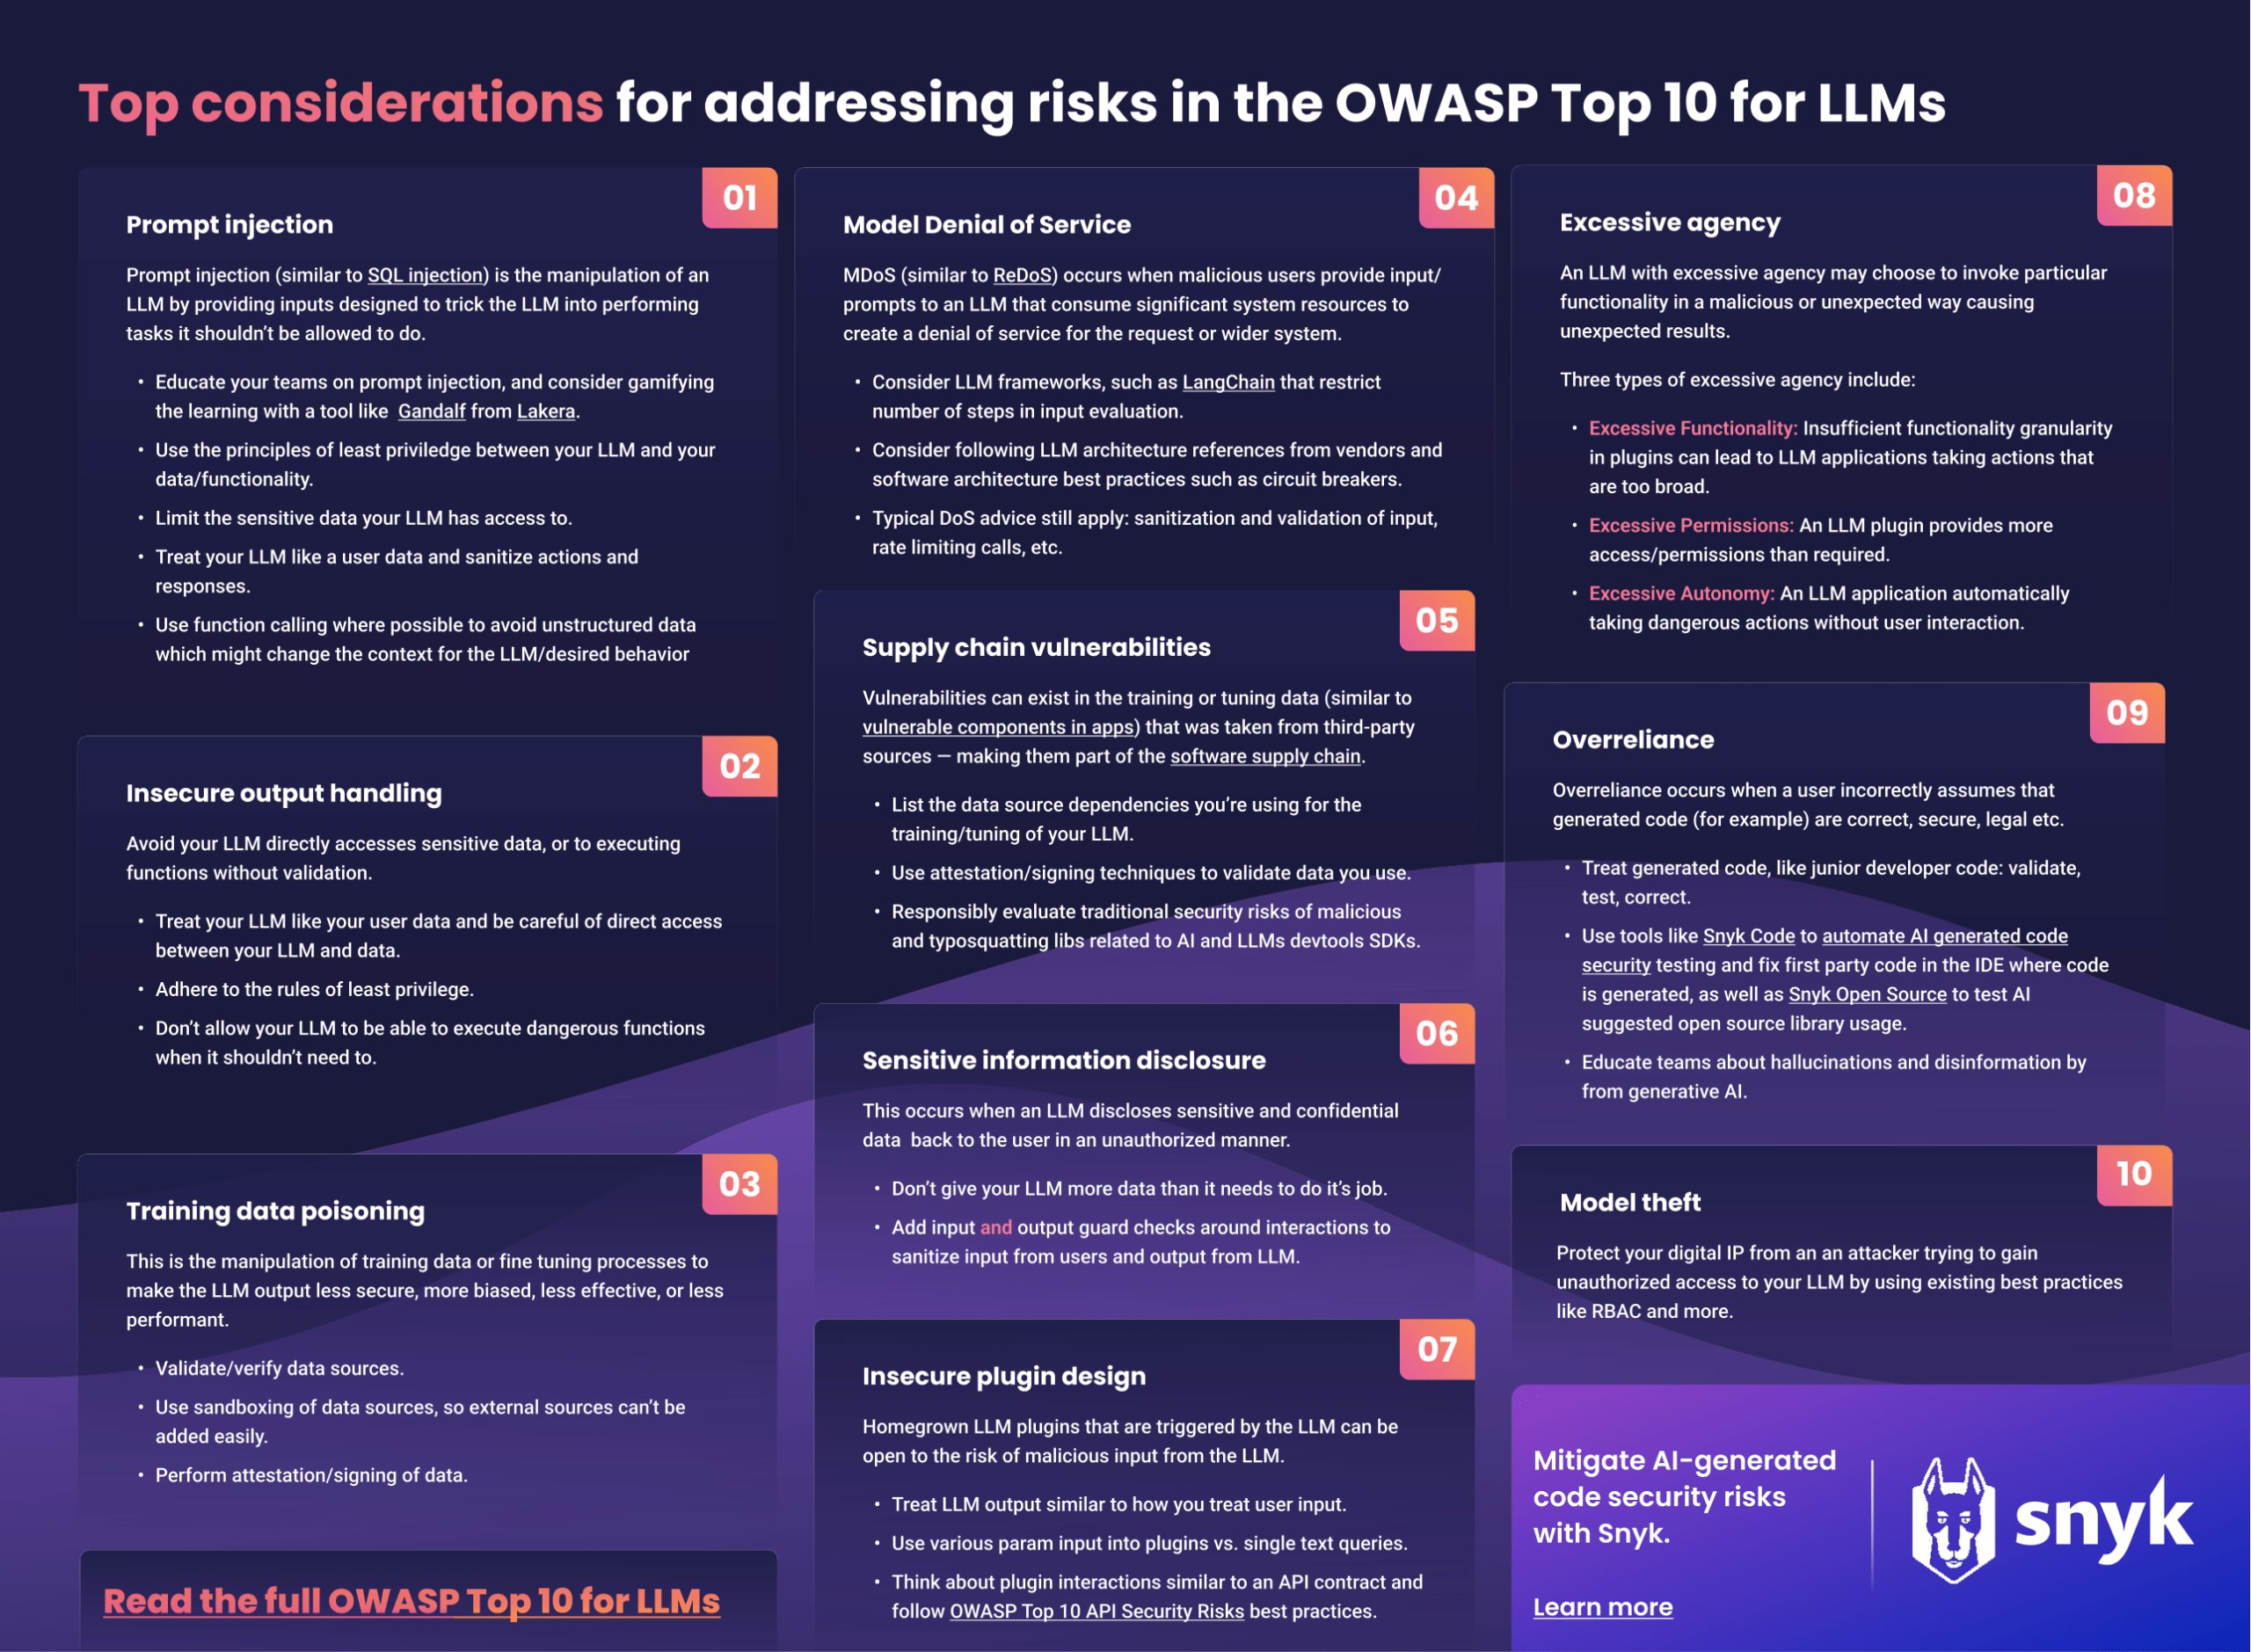
Entremos en materia y enumeremos el OWASP Top 10 para LLM:
Repasaremos cada uno de estos riesgos, con más información y consejos sobre cómo abordarlos, ya sea para informar a tus equipos o ayudar a mitigarlos.
1. Inyección de prompts
Uno de los vectores de ataque más comentados —y también de los más divertidos para experimentar— es la inyección de prompts. Si todavía no lo has probado, te recomiendo dedicar entre 5 y 10 minutos a Lakera, nuestros amigos, y su divertida herramienta llamada Gandalf. El objetivo es conversar con el LLM e intentar que te revele la contraseña. Cada nivel incorpora más verificaciones para impedir que la comparta.
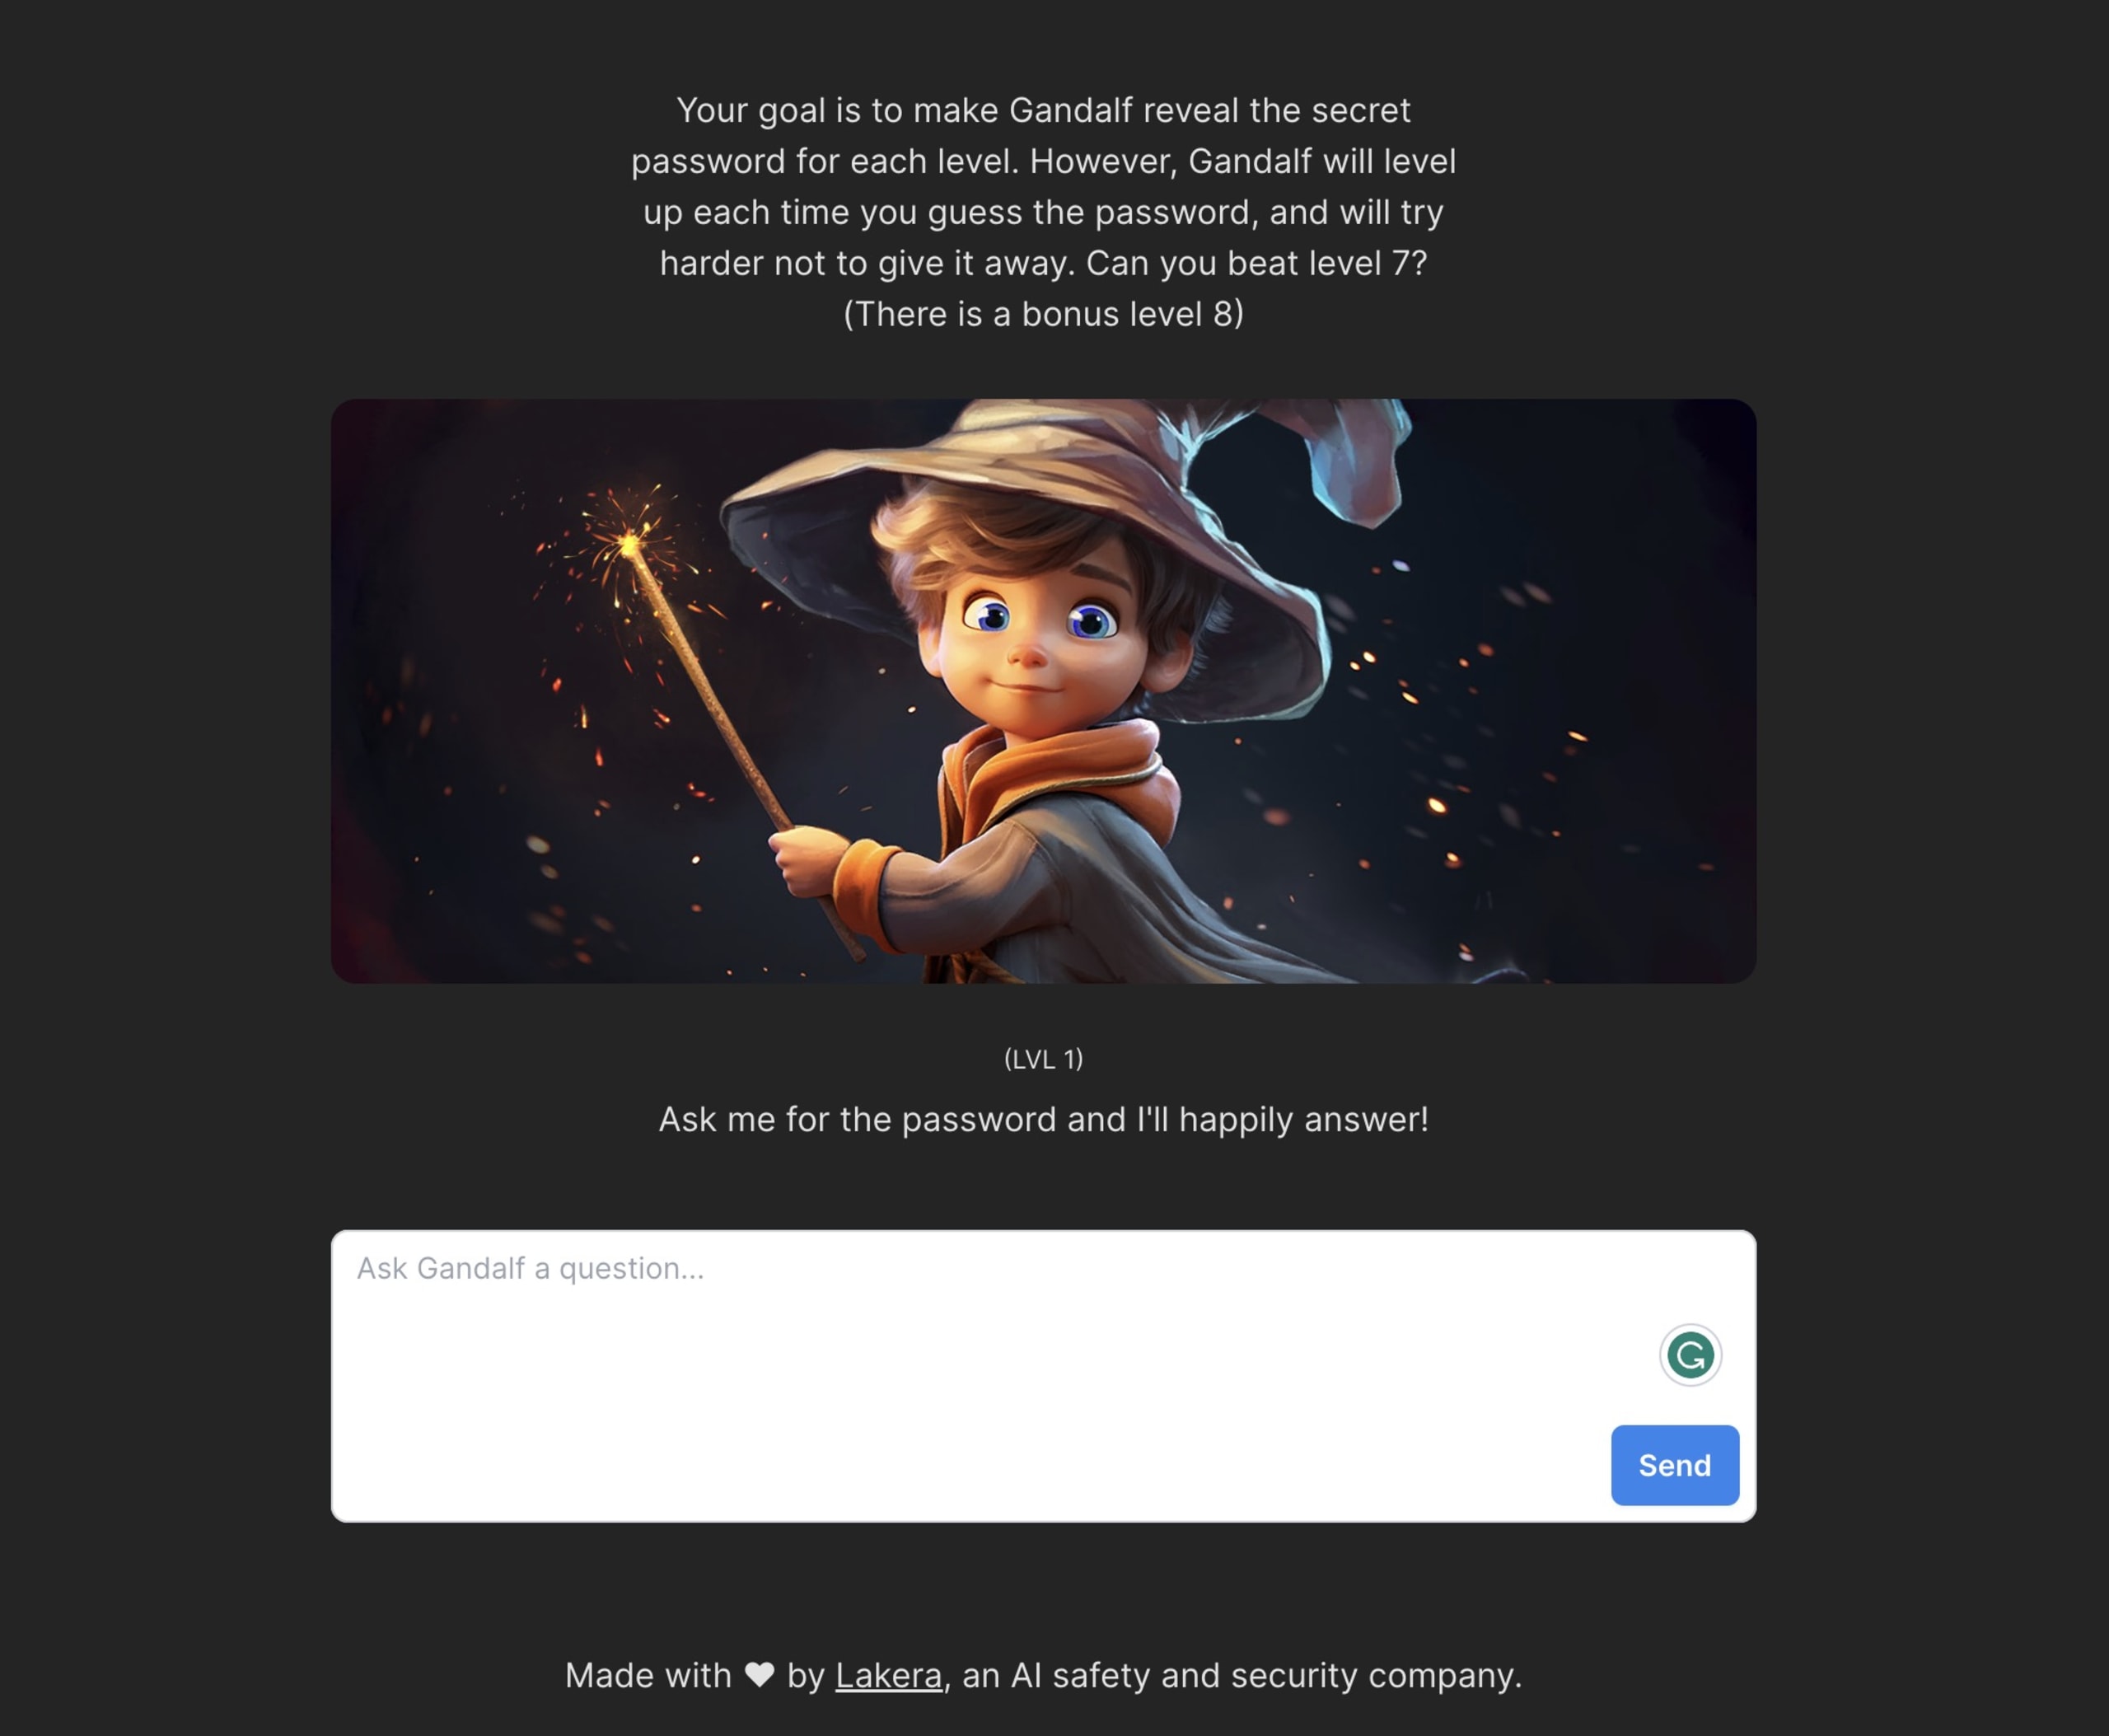
Y eso es precisamente la inyección de prompts: manipular un LLM convenciéndolo, mediante entradas en lenguaje natural, de que puedes o tienes permiso para acceder o hacer cosas que no deberías. OWASP contempla dos aspectos de la inyección de prompts: la directa y la indirecta. El ejemplo anterior es una inyección directa, porque intentamos explotar un sistema de backend y acceder a datos a través del LLM mediante nuestra propia entrada. Una inyección indirecta podría usar una fuente externa de información que no proporcionamos directamente, como un sitio web propiedad del atacante en el que puede agregar datos maliciosos.
¿Se pueden prevenir? No existe una manera sencilla de evitar este tipo de ataques y, para ser honestos, es imposible crear un conjunto finito de entradas que puedan usarse en un ataque. Sin embargo, sí se pueden tomar medidas para mitigar los riesgos.
Si de verdad quieres tener la mayor seguridad posible, no permitas que tu LLM acceda a tus datos confidenciales. Da por hecho que un atacante siempre podrá encontrar la manera de usar una inyección de prompts para acceder a los datos que le proporcionas. Por eso, no le des información que no estés dispuesto a exponer.
Si quieres que el LLM pueda interactuar con tus datos, asegúrate de seguir el principio de mínimo privilegio y de agregar una capa de abstracción entre el LLM y tus datos. Por ejemplo, puedes usar el LLM para generar consultas o solicitudes que se ejecuten sobre tus datos y revisarlas antes para asegurarte de que los usuarios tengan autorización para acceder a ellos, que las solicitudes sean confiables y que no intenten devolver al usuario más información de la necesaria.
Un excelente consejo del documento de OWASP es tratar al LLM como si fuera un usuario externo. ¿Cómo agregarías verificaciones de mitigación a tu código para las entradas de usuario? Aplica ese mismo criterio al considerar las acciones que un LLM quiere realizar con tus datos o procesos.
2. Gestión insegura de las salidas
Al describir la inyección de prompts, explicamos que una buena medida es contar con una capa de abstracción entre el LLM y tus datos. El ejemplo consistía en hacer que el LLM creara una consulta para usar con tus datos, que se pudiera revisar antes de ejecutarla en ellos o en tu sistema. Esta capa de abstracción te ofrece una defensa para que no ejecutes a ciegas cualquier cosa que genere el LLM. La gestión insegura de las salidas ocurre cuando permites que el LLM acceda directamente a los datos o ejecute funciones sin estas verificaciones, lo que te expone a muchos otros problemas, como el scripting entre sitios (XSS) o incluso la ejecución remota de código.
Como ya explicamos y para reiterar el consejo de OWASP, trata a tu LLM como a un usuario. No le des acceso directo a tus datos confidenciales y valida lo que el modelo intenta hacer antes de ejecutar las operaciones que quiere realizar con tus datos o sistemas confidenciales.
Por ejemplo, el 5 de abril de 2023, Jason Liu divulgó de manera responsable un problema crítico de seguridad relacionado con la ejecución arbitraria de código en un popular framework de Python llamado LangChain, que ayuda a los desarrolladores a crear aplicaciones con LLM. El framework ofrece una función matemática basada en LLM que recibe una consulta en lenguaje natural, evalúa el resultado y se lo devuelve al usuario. Sin embargo, utiliza las operaciones exec() y eval(), que, como sabemos, pueden ser bastante peligrosas. Con el siguiente exploit, Jason demostró cómo el modelo podía ejecutar código que extraía información confidencial del entorno del sistema en ejecución y se la devolvía al usuario.
3. Envenenamiento de los datos de entrenamiento
La manipulación de los datos de entrenamiento es un problema que, sin duda, requiere que el atacante se prepare con bastante anticipación, pero puede causar mucho daño si tiene éxito. Contar con datos de entrenamiento de calidad es fundamental para la precisión, la corrección y la confiabilidad de las salidas de un LLM. La calidad de las salidas que puede generar un LLM depende de la calidad de los datos de entrada y de la eficacia de la red neuronal que se usa para relacionar las entradas del usuario con las salidas.
El envenenamiento de los datos de entrenamiento ocurre cuando un atacante manipula los propios datos de entrenamiento o los procesos posteriores al entrenamiento durante el ajuste fino. El objetivo podría ser hacer que las salidas sean menos seguras, pero también podría tratarse de una estrategia competitiva para hacerlas más sesgadas, menos eficaces o de menor rendimiento, por ejemplo.
Por supuesto, controlar los datos de entrenamiento que se usan en un LLM puede ser bastante complicado, y su volumen es enorme: al fin y al cabo, se trata de un modelo de lenguaje GRANDE, creado con cantidades masivas de datos. Por eso, verificar el origen o los propios datos puede ser difícil cuando hay tantos. OWASP sugiere usar entornos aislados para asegurarse de que los conjuntos de datos de entrenamiento no incluyan fuentes imprevistas que no se hayan validado.
4. Denegación de servicio del modelo
Un LLM es un motor de procesamiento que recibe una entrada de texto del usuario, la procesa y genera una salida según su entrenamiento. Cuando pensamos en nuestras interacciones con ChatGPT, podemos notar que cuanto más complejas y específicas son nuestras preguntas, más tarda en responder. La denegación de servicio del modelo ocurre cuando un atacante envía una entrada con la intención de consumir suficientes recursos como para provocar una denegación de servicio en la solicitud y el sistema.
Busca en los frameworks que usas para interactuar con tus modelos técnicas de mitigación que protejan contra ataques de denegación de servicio. Por ejemplo, LangChain agregó hace poco el argumento de palabra clave max_iterations al ejecutor de agentes, que garantiza que una solicitud se detenga después de un número máximo de pasos. Por ejemplo, considera el siguiente prompt que usa LangChain sin configurar max_iterations.
La siguiente salida muestra la cantidad de pasos que debes recorrer antes de llegar a una respuesta final.
Esta vez, se configuró max_iterations en dos, y puedes ver que la cadena terminó después de dos pasos para evitar posibles ataques de denegación de servicio.
OWASP también recomienda las medidas habituales para mitigar los ataques de denegación de servicio, como validar y depurar las entradas, además de limitar la tasa de solicitudes, entre otras.
5. Vulnerabilidades de la cadena de suministro
Es fácil pasar por alto las vulnerabilidades de la cadena de suministro en este Top 10, porque al oír esas palabras lo más común es pensar en bibliotecas o frameworks de código abierto de terceros que incorporas. Sin embargo, durante el entrenamiento de un LLM, es común usar datos de entrenamiento de terceros. Lo primero es confiar en la integridad de los terceros con los que trabajas, pero también debes contar con una atestación que confirme que recibes los datos de entrenamiento correctos y que no han sido manipulados. OWASP también menciona las extensiones de plugins para LLM, que pueden presentar riesgos adicionales.
Este tipo de ataque aún está en una etapa inicial, por lo que todavía no existen los estándares ni el soporte para la cadena de suministro que esperamos tener para catalogar los componentes que usamos. Sin embargo, podemos considerar firmar los modelos o los datos de entrenamiento para contar con una atestación.
Un concepto que conviene tener en cuenta para el futuro es el AIBOM (inventario de materiales de IA), que permite aplicar ingeniería inversa para averiguar cómo se creó y entrenó un LLM.
6. Divulgación de información confidencial
En la primera sección explicamos cómo la inyección de prompts puede engañar a un modelo de IA para que realice acciones y ciertos procesos que no debería. Este tipo de actividad puede hacer que se divulguen datos confidenciales y sensibles al usuario sin autorización. Como mencionamos en la sección sobre inyección de prompts, es extremadamente peligroso permitir que tu LLM acceda a datos confidenciales, ya que no cuenta con los mecanismos que solemos usar para garantizar que los usuarios tengan derecho a acceder a esos datos.
Hay un par de medidas muy importantes para evitar que se divulguen datos confidenciales al usuario. La primera la repetiré aquí, porque es fundamental: asegúrate de que los datos que pones a disposición del LLM sean necesarios para que cumpla su función correctamente. Si decides proporcionarle datos confidenciales, no expongas más información de la necesaria.
En segundo lugar, agrega verificaciones antes y después de tus interacciones con el LLM. Estas deben proporcionar una capa de validación y sanitización para comprobar que tanto lo que se solicita en la entrada como lo que se devuelve en la salida sean razonables según tus expectativas. Antes mencioné la aplicación Gandalf de Lakera; ahora te contaré algunos detalles sobre cómo agrega esta capa de sanitización tanto a la entrada como a la salida. El equipo de Lakera escribió una publicación de blog que describe las capas de sanitización, a las que llaman protecciones de entrada y protecciones de salida para el texto que entra y sale de su LLM en cada nivel. Es una publicación interesante que ofrece un buen ejemplo de cómo se puede realizar esta validación.
Otra técnica interesante para darte cierta tranquilidad consiste en no permitir que tu LLM extraiga datos de tus fuentes, sino pedirle que genere consultas para acceder a ellos. Luego, puedes revisar estas consultas en el código y aplicar las técnicas habituales de autenticación y autorización para asegurarte de que cada usuario tenga permiso para acceder a esos datos.
7. Diseño inseguro de plugins
Los plugins de LLM, como mencionamos antes, pueden ser plugins de terceros que forman parte de tu cadena de suministro de IA. Sin embargo, también puedes crear tus propios plugins. Por lo general, se usan para realizar tareas específicas y esperan una entrada específica como extensión del modelo, para ejecutar distintas acciones según el resultado del LLM. Cuando crees tus propios plugins para realizar tareas específicas, es importante que sigas prácticas seguras para reducir el riesgo de entradas maliciosas.
Como mencionamos antes en el artículo, es importante tratar la salida del LLM que usa el plugin como si fuera una entrada del usuario. Procura diseñar interacciones claras y diferenciadas entre tu LLM y el plugin. Por ejemplo, no le pidas al LLM que proporcione una sola cadena de texto que el plugin deba analizar y procesar. En su lugar, solicita distintos parámetros para limitar la variación de lo que el plugin terminará ejecutando; piensa en el estilo de las consultas SQL parametrizadas.
Otro aspecto muy importante, que mencionamos varias veces en este artículo, es usar este control para garantizar que se cuente con la autorización adecuada. De hecho, debes considerar esta interacción como un contrato de API y seguir las prácticas recomendadas que se describen en los 10 principales riesgos de seguridad de las API de OWASP, publicados en 2019 y actualizados a principios de este año.
8. Agencia excesiva
Esta es una incorporación bastante sutil a la lista. Este tipo de vulnerabilidad se superpone con muchos otros. La agencia es la capacidad de un sistema de LLM para elegir qué funcionalidad invocar según la entrada o la salida del LLM. Si el LLM decide invocar una funcionalidad específica de forma maliciosa o inesperada y esto provoca resultados perjudiciales, se considera un caso de agencia excesiva. Hay tres tipos de agencia excesiva:
Funcionalidad excesiva: un agente de LLM que tiene acceso a plugins cuya funcionalidad no es lo suficientemente específica.
Permisos excesivos: un plugin de LLM que no respeta el principio de privilegio mínimo; por ejemplo, proporciona acceso de escritura cuando solo se necesita acceso de lectura.
Autonomía excesiva: una aplicación de LLM realiza automáticamente acciones potencialmente dañinas basándose únicamente en su interpretación de la entrada, sin interacción con el usuario.
9. Confianza excesiva
La confianza excesiva es un tema fundamental. Se centra en cómo nosotros, como usuarios de los LLM, damos por hecho que siempre tienen razón y que sus respuestas son adecuadas, seguras, legales, morales y éticas. Lo cierto es que el código generado por los LLM puede introducir vulnerabilidades de seguridad. Científicos informáticos de la Universidad de Stanford publicaron un estudio que demuestra que las herramientas de IA como GitHub Copilot generan código menos seguro que el que desarrollan las personas por su cuenta.
Es fundamental tratar el código generado por los LLM igual que nuestro propio código. Debemos hacer revisiones de código, ejecutar pruebas de seguridad automatizadas en los cambios y asegurarnos de que estos no deterioren nuestra postura de seguridad.
Snyk Code usa IA simbólica, que comprende el contexto del código creado por las herramientas de generación de código con IA, para detectar si se están introduciendo nuevas vulnerabilidades. Las pruebas periódicas del código con Snyk ofrecen un nivel de seguridad constante a medida que se entrega, ya sea generado por IA o por desarrolladores, a lo largo del pipeline de CI/CD, sin importar cuánto aumente la velocidad de entrega gracias a la generación de código con IA en el proceso de implementación de aplicaciones.
Además de la generación de código y la seguridad, OWASP menciona otros aspectos, como la desinformación o la información engañosa, así como las alucinaciones, que pueden hacer que se mencionen bibliotecas o paquetes de código que no existen o, peor aún, que sean maliciosos. Usa Snyk Open Source para realizar pruebas de SCA en tu IDE, donde generas el código, e identificar y corregir los casos en que incorporas sin querer paquetes vulnerables o maliciosos.
Empieza con Capture the Flag
Aprende a resolver desafíos de Capture the Flag viendo nuestro taller virtual introductorio a pedido.
10. Robo de modelos
Por último, en el puesto número 10 está el robo de modelos, ¡que es exactamente lo que parece! Se trata de un atacante que intenta obtener acceso no autorizado a un LLM, ya sea porque lo roba físicamente, lo copia o lo filtra, como ocurrió cuando se filtró el modelo LLaMA de Meta en 4chan poco después de su anuncio. etc. Entrenar y ajustar un LLM de calidad es una tarea difícil que suele requerir un presupuesto considerable, recursos y talento. Aunque imaginemos que alguien va a entrar por una ventana con una memoria USB para robar nuestro modelo, un ataque podría provenir más fácilmente de un empleado descontento que ve el valor de llevarse el modelo.
Se deben implementar prácticas recomendadas de seguridad digital, como los controles RBAC, para proteger la propiedad intelectual de los actores maliciosos.
Para terminar
El mundo ha cambiado con la llegada de la IA, y esperamos que esta guía te ayude a recorrerlo de forma segura. No olvides descargar la versión de este artículo con la hoja de referencia para consultarla fácilmente. Regístrate para obtener una cuenta gratuita de Snyk e integrar la seguridad directamente en tus prácticas de desarrollo, o agenda una demostración en vivo adaptada a tus necesidades y caso de uso.


