Unter der C-Oberfläche: Ein Blick auf C/C++-Schwachstellen in der Python-Welt

Aviad Hahami
28. April 2022
0 Min. LesezeitDie meisten Entwickler – mich eingeschlossen – schreiben überwiegend in höheren Programmiersprachen wie Python oder JavaScript. Manchmal sind jedoch native Elemente erforderlich, um die Leistung oder andere Aspekte eines Projekts zu verbessern. Da diese nativen Erweiterungen in der Regel in C oder C++ geschrieben sind, müssen Projekte, die hauptsächlich JavaScript oder Python verwenden, plötzlich auch potenzielle transitive C/C++-Abhängigkeiten berücksichtigen.
Im Mai 2021 übernahm Snyk FossID, ein Unternehmen, das auf die Erkennung von Lizenzen und Schwachstellen im C- und C++-Open-Source-Ökosystem spezialisiert ist. Anschließend wurde FossID in die Snyk CLI integriert, die dadurch C- und C++-Abhängigkeiten scannen kann.
Als Mitglied des Sicherheitsteams von Snyk untersuchte ich die Ergebnisse von Snyks C-Datei-Scans in npm- und PyPI-Projekten und stieß dabei auf einige interessante – und potenziell beunruhigende – Entdeckungen.
In diesem Beitrag sprechen wir über die Vorteile, die Entwickler dazu bewegen, native C- und C++-Erweiterungen in ihre Projekte mit höheren Programmiersprachen zu integrieren. Anschließend nutzen wir Python und das PyPI-Register, um verborgene C-bezogene Schwachstellen in solchen Projekten aufzuspüren und zu zeigen, wie Schwachstellen auf niedriger Ebene scheinbar sicheren Code auf höherer Ebene beeinträchtigen können.
Warum C/C++-Dateien in ein Projekt mit einer höheren Programmiersprache aufnehmen?
C-Dateien in einem Kontext mit höheren Programmiersprachen zu verwenden, ist nicht immer ganz unkompliziert. Es gibt jedoch viele gute Gründe, C-Code in Ihre Anwendung aufzunehmen.
Laufzeit und Leistung
Betrachten wir eine interpretierte Sprache wie Python. Jedes Mal, wenn wir ein Python-Programm ausführen, müssen wir den Code vor der Ausführung zunächst parsen und interpretieren. Durch die Einbindung von C bietet uns Cython – eine Obermenge von Python und C – die Möglichkeit, Python-Code in C-Code zu transpilieren, der anschließend kompiliert werden kann und schneller läuft.
Hardware, Ressourcen und Speicherverwaltung
Manchmal schreiben wir Programme, die umfangreiche Berechnungen erfordern und mit spezieller Hardware interagieren. Dazu gehören beispielsweise Grafik-Engines oder Kryptowährungssoftware, die auf die GPU zugreifen können. Auch Echtzeitkomponenten mit möglicherweise begrenzten Ressourcen müssen berücksichtigt werden. In solchen Fällen sind nicht deterministische Vorgänge wie die Garbage Collection problematisch; gefragt ist eine deterministische Speicherverwaltung. Deshalb setzen wir hier auf C.
Lemmata und Hypothese
Unsere Forschungshypothese lautet:
Lemmata:
Es gibt viele gute Gründe, C/C++-Dateien in Quellcode und Laufzeitumgebungen von Projekten mit höheren Programmiersprachen aufzunehmen.
Es gibt kein allgegenwärtiges Paketverwaltungssystem für C/C++-Dateien.
Hypothese:
Wenn wir Pakete für höhere Programmiersprachen untersuchen, die C-Dateien integrieren, können wir darin Schwachstellen in C oder aus C stammende Schwachstellen finden.
Um unsere Hypothese zu testen, haben wir Python und das PyPI-Ökosystem als ersten Kandidaten und Machbarkeitsindikator ausgewählt.
Das PyPI-Register: C in Python
Zum Zeitpunkt der Veröffentlichung sind auf PyPI rund 367.755 Bibliotheken öffentlich verfügbar.
Unser erster Scan sollte alle Pakete (und ihre Versionen) finden, die C-Dateien enthalten.
Wir fanden rund 6.200 Bibliotheken mit mindestens einer C-Datei – ungefähr 1,7 % des gesamten Ökosystems.
Im Vergleich zum gesamten Ökosystem ist diese Zahl zwar gering, für unsere Forschungszwecke jedoch ideal. Mit einer kleinen Ergebnismenge können wir falsch positive Ergebnisse relativ einfach erkennen und ausschließen.
Kriterium 1: Inhaltsidentität
Zunächst prüften wir die im vorherigen Schritt extrahierten Bibliotheken auf Dateiidentität. Dazu untersuchten wir jede C-Datei in der Bibliothek darauf, ob sie für uns bekannte CVEs anfällig ist oder war.
Dank der beeindruckenden FossID-Technologie, die inzwischen Teil des Snyk-Produkts ist, können wir jede Datei bis zu ihrem ersten Auftreten zurückverfolgen und feststellen, wo ein Codeausschnitt ursprünglich gefunden wurde.
Bei der Anwendung unseres ersten Kriteriums fanden wir rund 64 verschiedene Paketversionen, die mindestens eine originale, anfällige Quelldatei unverändert enthalten**. Zählen wir die verschiedenen Versionen nicht separat, kommen wir auf 143 identische Vorkommen anfälliger Dateien**.
Kriterium 2: Inhaltsähnlichkeit
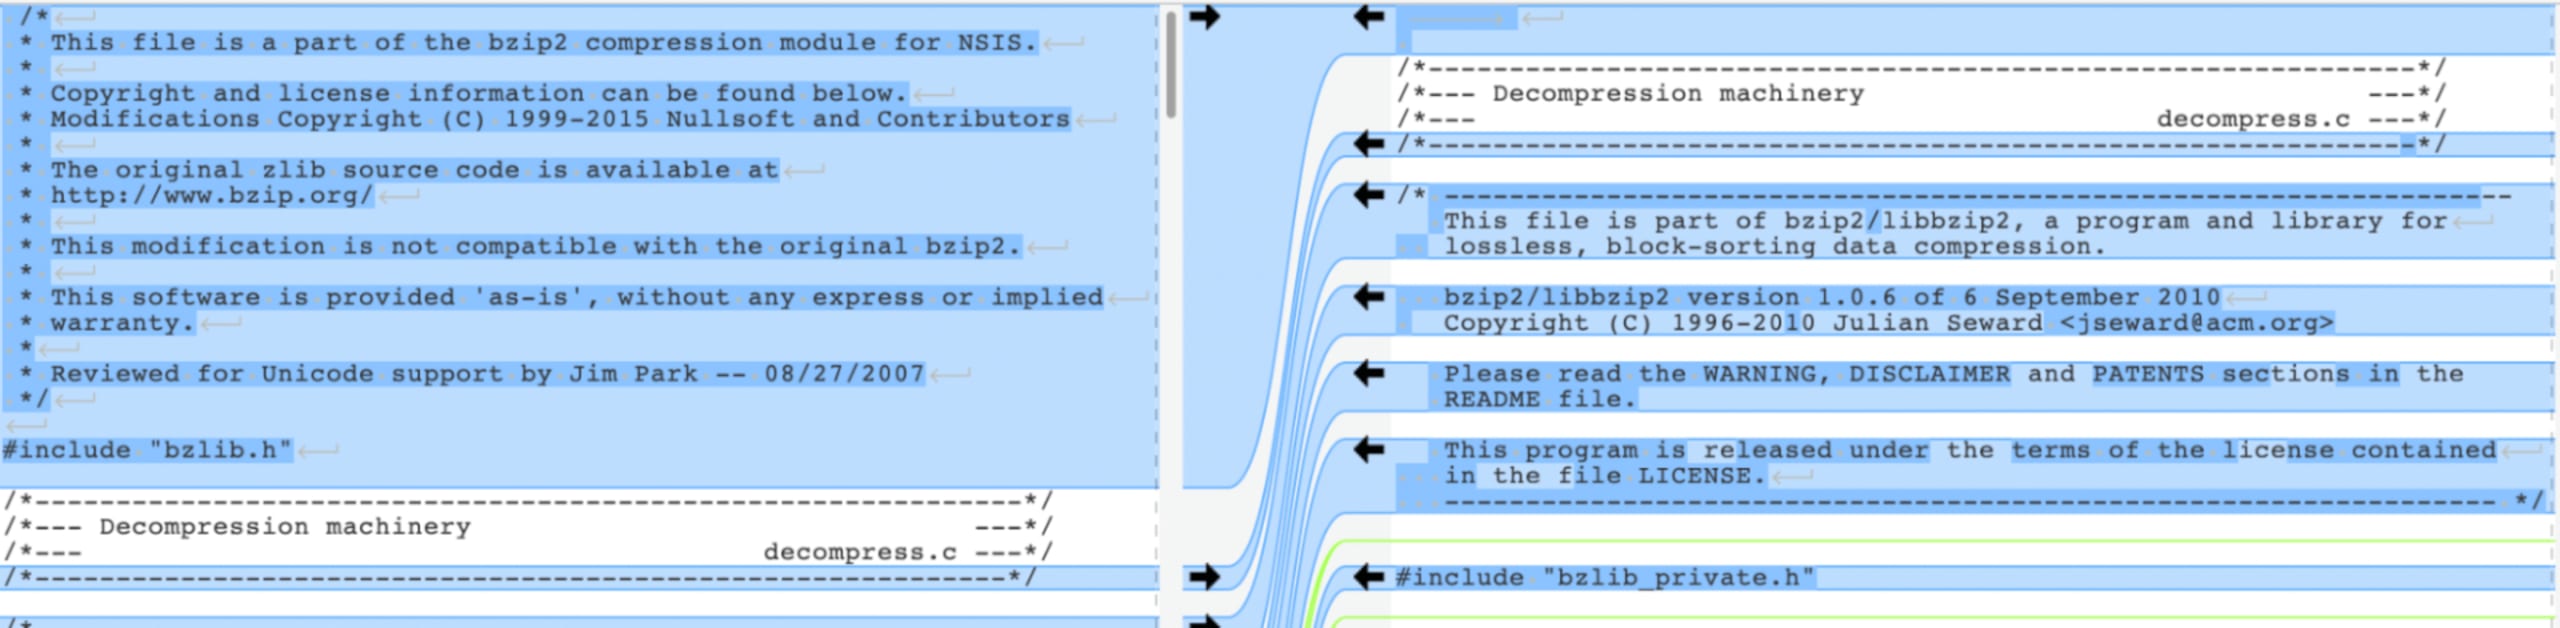
Als zweites Kriterium untersuchten wir die Dateiähnlichkeit. Für diese Studie bedeutete Ähnlichkeit, dass der dateiinhalt zwar nicht identisch sein musste, der sicherheitskritische, mit der Schwachstelle verbundene Code jedoch schon.
Bei der Prüfung (ohne Kriterium 1) fanden wir rund 231 verschiedene Paketversionen mit mindestens einem bekannten anfälligen Codeausschnitt. Ohne die unterschiedlichen Versionen separat zu zählen, fanden wir 1.931 identische anfällige Codeausschnitte.
Die Zahlen im Überblick
Fassen wir die obigen Zahlen zusammen, finden wir rund 2.074 Treffer für unsere Kriterien in PyPI-Paketen. Da C-Code typischerweise für komplexere Entwicklungsaufgaben eingesetzt wird, überraschte es uns nicht, in den Ergebnissen Bibliotheken mit niedrigem Abstraktionsniveau zu finden, darunter:
gevent (5,7 Tsd.)
pycrypto (2,4 Tsd.)
selectolax (rund 500)
Die folgende Grafik zeigt eine Aufschlüsselung der Python-Bibliotheken mit C-Dateien. Sie umfasst die Gesamtzahl (den gesamten Kreis), den Anteil, der als anfällig markiert wurde (einschließlich nicht ausnutzbarer Schwachstellen oder falsch positiver Ergebnisse), sowie den Anteil, der mit sehr hoher Wahrscheinlichkeit anfällig ist.
C-Dateien in Python-Bibliotheken – Aufschlüsselung des Schwachstellenstatus
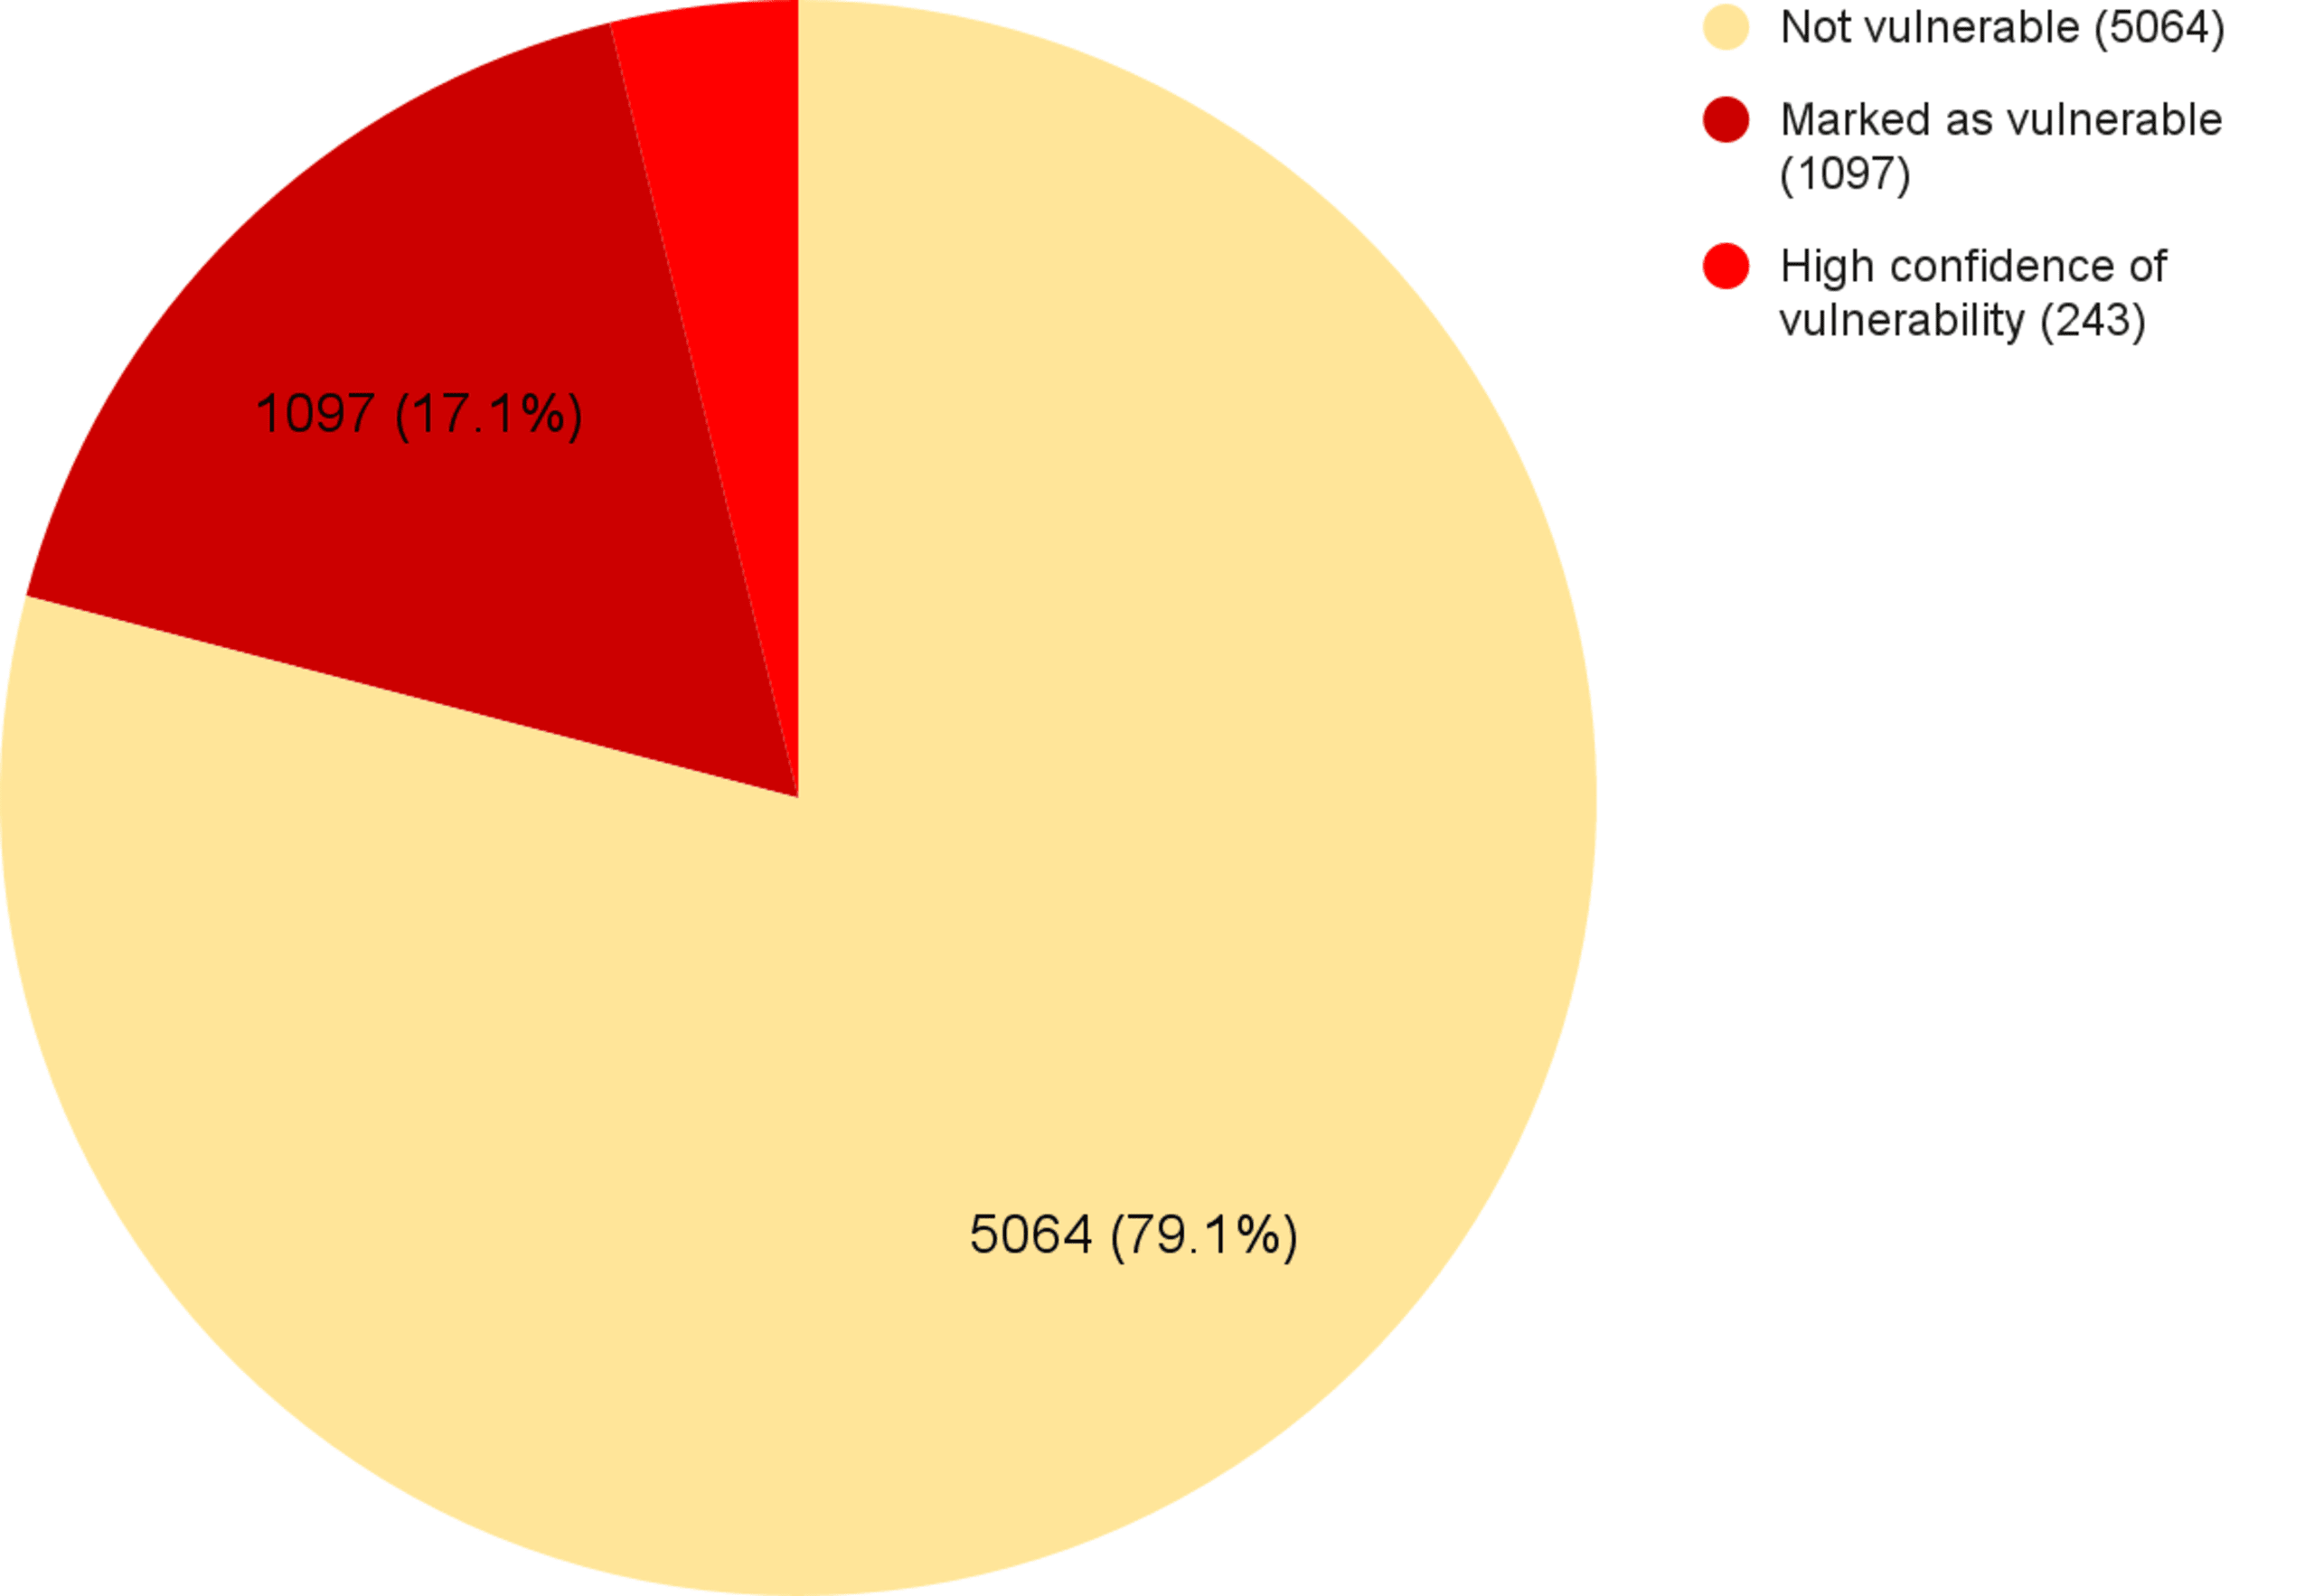
Die Ausnutzbarkeit von Schwachstellen in Bibliotheken nachzuweisen, ist weder trivial noch automatisiert – alle gemeldeten Schwachstellen müssen manuell überprüft werden. Um jedoch zu veranschaulichen, dass das hier behandelte Problem wichtige Auswirkungen in der Praxis hat, beschreibt der nächste Abschnitt eine Schwachstelle und die Schwere ihrer Ausnutzung.
Eine 20 Jahre alte verborgene Schwachstelle – python-libsbml
Eine der von unserem Tool gemeldeten Bibliotheken war python-libsbml, eine Bibliothek zum Lesen, Schreiben und Bearbeiten der Systems Biology Markup Language (SBML). Da diese Auszeichnungssprache auf XML basiert, überraschte es uns nicht, libxml2 unter den Projektabhängigkeiten zu finden.
Unser Tool markierte eine der Dateien (parser.c) als anfällig für den Billion-Laughs-Angriff – eine 20 Jahre alte DoS-Schwachstelle, die als CVE-2003-1564 erfasst ist. Der Billion-Laughs-Angriff ist ziemlich einfach. Sie müssen lediglich genügend selbstreferenzierende Entitäten in einem XML-Dokument erzeugen und es dem Parser übergeben.
Hier ist unser PoC für diese Schwachstelle.
Erstellen Sie die bösartige Payload und speichern Sie sie unter payload.xml.
Wenn Sie python-libsbml installiert haben, erstellen Sie die folgende Python-Datei:
Führen Sie abschließend die Python-Datei mit folgendem Befehl aus:
„Wenn Sie die Schritte korrekt ausführen, sollte die CPU-Auslastung auf 100 % steigen und der Speicherverbrauch so lange zunehmen, bis der Arbeitsspeicher erschöpft ist (OOM). Damit haben wir einen DoS-Angriff auf dem Computer ausgeführt.“
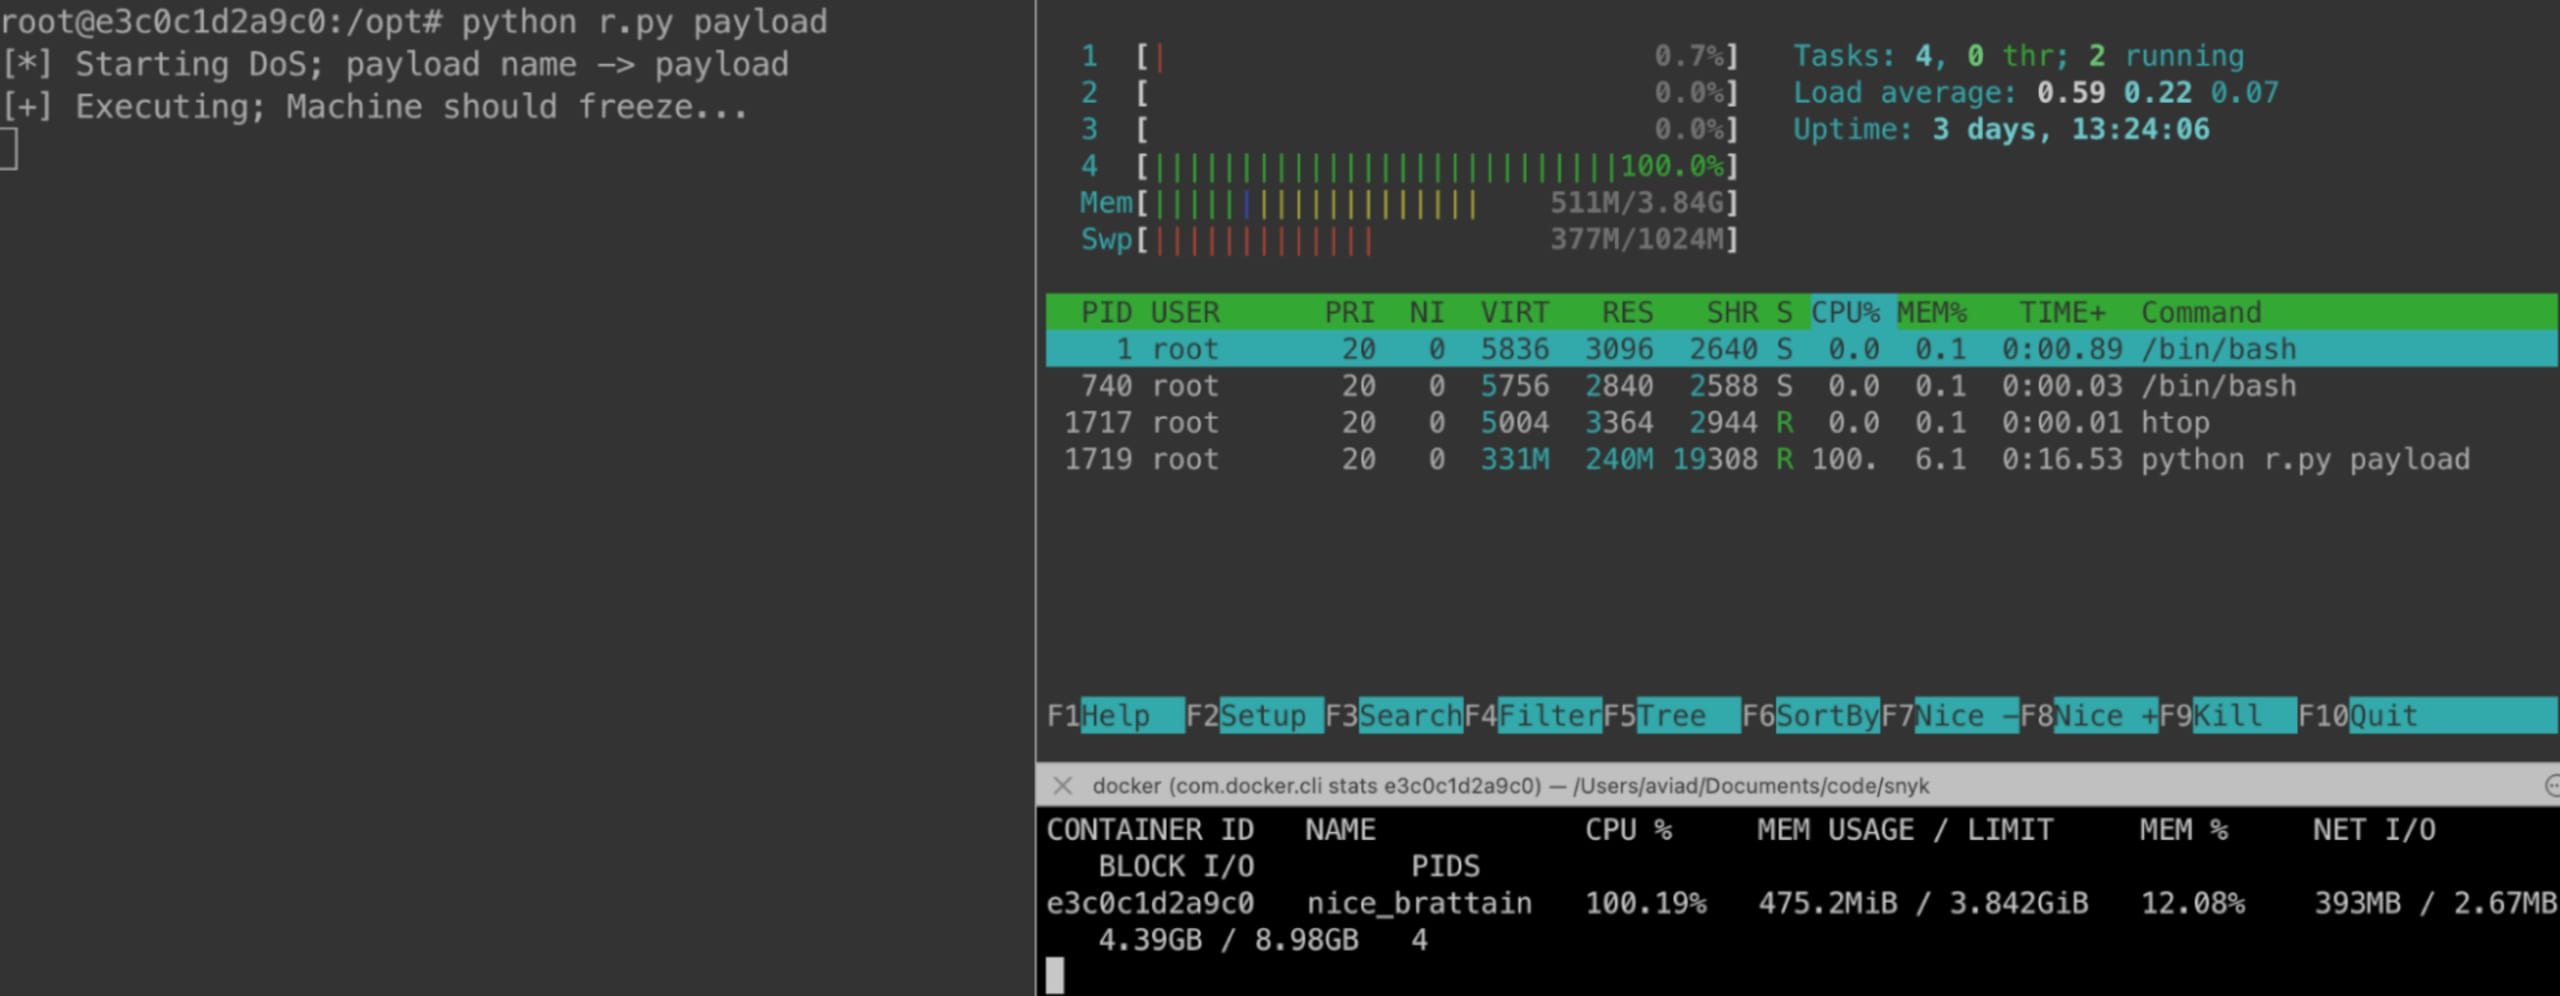
Auch wenn diese Schwachstelle in der Entwickler-Community vielleicht keine großen Wellen schlägt: Stellen Sie sich vor, eine aus C-Code stammende Schwachstelle wie BoF, UaF, PE/RCE oder eine andere würde sich in Ihrem Python- oder NodeJS-Code verbergen. Haben Sie schon einmal danach gesucht?
Diese Bibliothek wird rund 20.000-mal pro Monat heruntergeladen und ist eine direkte Abhängigkeit von rund 115 öffentlichen Projekten. Da es sich um eine bekannte, 20 Jahre alte Schwachstelle handelt, haben bemerkenswert viele Abhängige, ohne es zu wissen, anfällige Software an ihre Kunden und Nutzer ausgeliefert.
Wie geht es weiter?
Während wir weiterhin Schwachstellen finden und an Maintainer von Open-Source-Projekten melden, möchten wir Entwickler dazu ermutigen, in ihren Projekten außerhalb von C nach C-Dateien zu suchen.
Da für diese C-Dateien oft keine Paketverwaltungssysteme verfügbar sind, bleiben sie meist lange unverändert (oder werden kopiert und eingefügt) und können später veraltet und anfällig sein – hoffentlich entdecken das nicht böswillige Akteure zuerst.
Melden Sie sich noch heute bei Snyk an und nutzen Sie unsere neue CLI-Funktion, um nicht verwaltete C/C++-Abhängigkeiten in Ihren Projekten zu scannen.
Starten Sie mit Capture-the-Flag
Erfahren Sie in unserem virtuellen On-Demand-Workshop für Einsteiger, wie Sie Capture-the-Flag-Challenges lösen.


