実際に悪用されるURL混乱の脆弱性:パーサー間の不整合を探る

Snyk Security Research Team
Claroty Team82
2022年1月10日
0 分で読めますURLは、コンピューターとの関わり方を大きく変えてきました。1992年に考案され、1994年に定義されたUniform Resource Locator(URL)は、今もインターネットに欠かせない要素です。人が理解しやすい説明的なアドレスを使って、ウェブ上を移動できるようにします。しかし、人が読みやすい形式にするには、機械が利用できる構成要素に分解する必要があります。それを担うのがURLパーサーです。
URLが何十年にもわたって広く使われてきたことを考えると、現在使われているURLパーサーは、類似した(あるいはまったく同じ)URLの解析方法について、すでに合意に達していると思うかもしれません。そうなれば理想的ですが、実際はそうではありません。この合意の欠如が、URLの混同と呼ばれる脆弱性につながっています。この記事では、その仕組みを解説します。
注:インターネットプロトコル(HTTP、HTML、URLなど)の開発では、Request for Comments(コメント募集文書)、略してRFCと呼ばれる文書が使われます。この記事では、これらの文書にたびたび言及します。
ClarotyとSnykの共同調査では、さまざまなプログラミング言語の多数のURL解析ライブラリを調べ、それぞれがURLを基本的な構成要素に分割する方法に一貫性がないことを確認しました。こうした不一致を4つのカテゴリに分類し、Webアプリケーションとオープンソースライブラリの両方で問題のあるコードフローを探しました。その結果、多数の脆弱性が見つかり、その大半には次のいずれかの根本原因がありました。
複数のURLパーサーが使われている
URL関連のRFCが時代とともに複数作成され、パーサーごとに異なるRFCを実装していた
この記事では、URLの歴史を振り返り、URLパーサーの混同を引き起こす可能性のある要因を探り、エクスプロイトの概念実証(POC)を確認したうえで、URLの混同を利用した攻撃から身を守るための推奨事項を紹介します。以下の目次から、読みたい項目に移動できます。
ClarotyとSnykのセキュリティリサーチチームによるこの調査は、Orange Tsai氏の先行研究「A New Era of SSRF」と、cURLの開発者Daniel Stenberg氏によるWHATWGとRFC 3986の比較に着想を得ています。革新的な研究に感謝します。
URLとは何か、どのようにして現在の形になったのか
URLと聞いて思い浮かぶのは、https://snyk.ioのようなものです。最も基本的には、どこにアクセスするか(my-site.com)と、どのようにアクセスするか(HTTPS経由)を示します。これらに加えて、パス(https://my-site.com/about)、文字列が続くハッシュ記号(フラグメント。例:https://my-site.com#contact)、パラメーターが続く疑問符(クエリ。例:https://my-site.com?source=li&device=mobile)なども含まれます。
上記を一般化してまとめると、URL文字列は次の基本要素に分解できます。
scheme://authority/path?query#fragment
たとえば、URLは次のようになります。https://example.com:8042/over/there?name=ferret#nose
調査では、さまざまなパーサーが各種RFCをどのように実装しているかを調べました。上記のURL形式は比較的単純に見えますが、その定義となるRFCは1994年以降、大きく変化しています。追加や全面的な改訂を重ね、現在おなじみのURLの形に至りました。
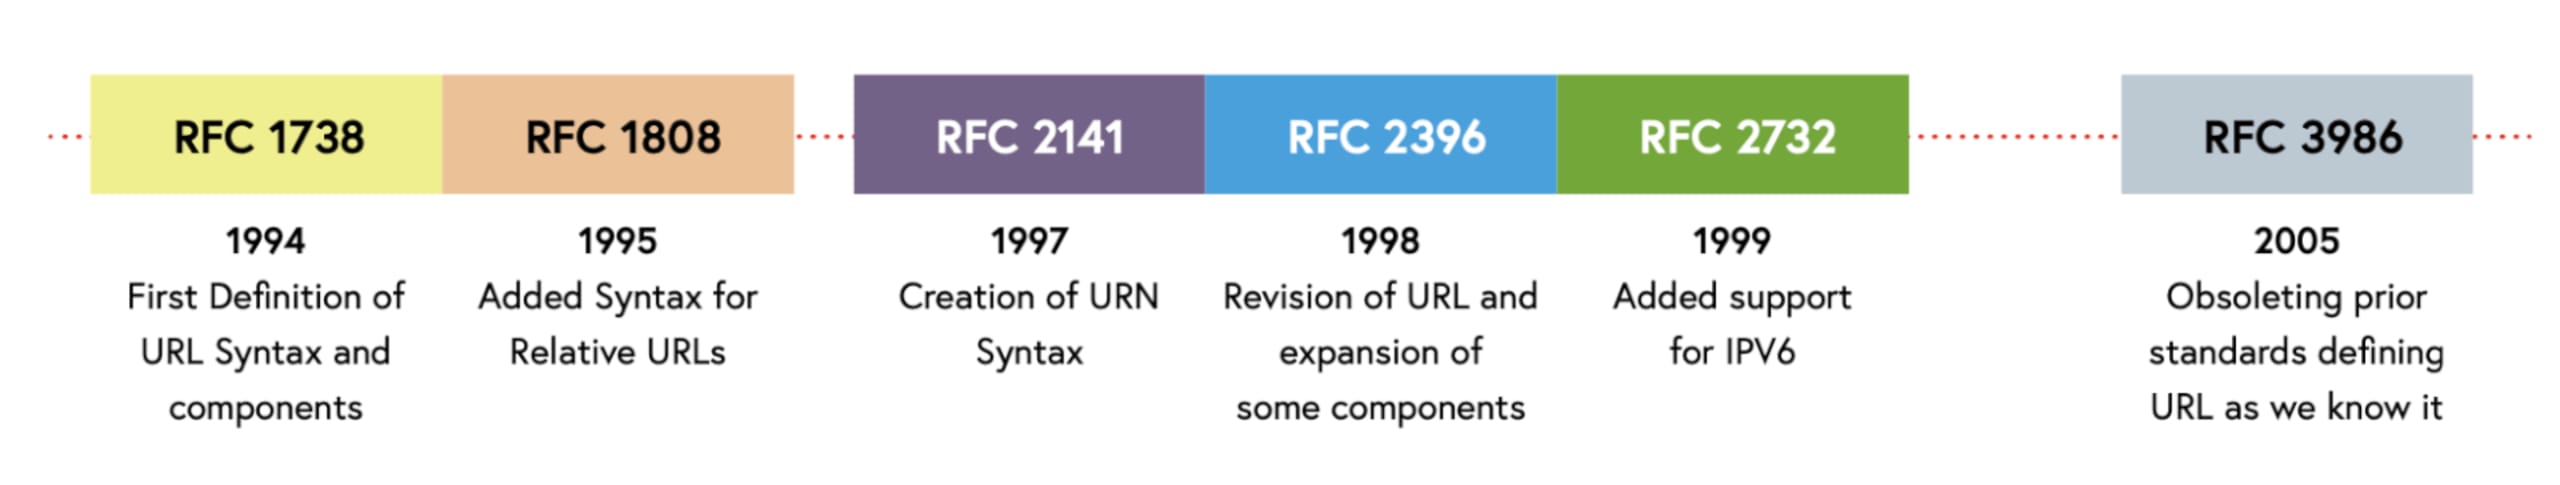
詳しくはこちら:RFC 1738、RFC 1808、RFC 2141、RFC 2396、RFC 2732、RFC 3986
パーサーがどこで混乱するのかを理解するには、まず完全なURLを構成する各要素の意味と定義を簡単に確認する必要があります。
スキーム
スキームの部分では、プロトコル(HTTP、HTTPS、FTP、Gopherなど)を定義します。RFCでは、この要素に使用できる文字と、現在のスキームがALPHA *( ALPHA / DIGIT / "+" / "-" / "." )というパターンに従うことが定められています。詳しく見てみましょう。
先頭の文字:
a–Z先頭以外の文字:
a–Z、0–9、+、-、.
つまり、1httpは数字で始まるため有効なスキームではありませんが、h2ttpは先頭が文字なので有効です。また、URLの他の構成要素とは異なり、必須なのはスキームだけです。
Authority(以前のNetloc)
この要素は以前「Netloc」(network-location)と呼ばれていましたが、Authorityに改称されました。userinfo、host、portという3つの内部要素で構成されます。Authorityの一般的な形式は次のとおりです。authority = [ userinfo "@" ] host [ ":" port ]。userinfoの要素は、さらに主要な部分に分けることができます。username[:password]。これは、scheme://user:password@domain:port/という形式のURLを扱います。RFC-2396以降、平文のuser:passwordの使用は推奨されなくなり、RFC-3986で非推奨になった点に注意してください。
パス
この要素は、リクエスト元がサーバー上でアクセスしようとするリソースを示します。/、;、=、?を除く任意の文字列を指定でき、/で区切られたセグメントに分かれます。
最も単純な要素のように見えますが、長年にわたって最も多く変更されてきた要素でもあります。RFC-1738とRFC-1808では、パス要素の構造とルールがスキーム要素に結び付けられていました。その後、RFC-2396では、各パスセグメントでセミコロン(;)を使ってパラメーターを定義できるとされました。しかし、RFC-2396の発行から間もなくRFC-3986が登場し、セミコロンによるパラメーター構文は非推奨になりました。
混乱しましたか?パーサーも同じです!
クエリ
クエリは、リクエストされたリソースにURL経由で渡されるキーと値のペアです。クエリパラメーターは最初の疑問符(?)の後にあり、番号記号/ハッシュ記号(#)で終わります。
クエリ要素では、セミコロン(;)、スラッシュ(/)、疑問符(?)、コロン(:)、アットマーク(@)、アンパサンド(&)、等号(=)、プラス記号(+)、カンマ(,)、ドル記号($)はすべて予約文字であり、使用時にはURLエンコードされます。
特殊文字をURLエンコードする例を見てみましょう。
フラグメント
フラグメントは、パス要素で指定された最初に取得したリソース内の別のリソースを特定し、アクセスするために使われます。フラグメント要素はハッシュ記号(#)で始まり、URIの末尾で終わります。
これで構成要素の説明は終わりです!
相対URL
このセクションの最後に、URLの相対参照について説明します。URLは階層構造になっているため、あるURLを別のURLに対する相対URLとして指定できます。たとえば、ベースURLがhttps://example.com/で、/foo/barのようにパスから始まるURL文字列が与えられた場合、パーサーはこれらをhttps://example.com/foo/barに解決します。ただし、その前にベースURLを指定する必要があります。
つまり、パーサーは相対参照の解析方法を理解している必要があります。RFC-3986では、相対参照を次の3種類に定義しています。
ネットワークパス参照:
//で始まる。例://example.com絶対パス参照:
/で始まる。例:/etc/passwd相対パス参照:
/で始まらない。例:foo/bar
参照の種類 | 例 |
|---|---|
ネットワークパス | //snyk.io |
絶対パス | /etc/passwd |
相対パス | app/login.js |
後の2種類を解決するにはベースURLが必要ですが、ネットワークパス参照ではスキームだけがあれば十分です。そのため、パーサーがスキームをHTTPSに設定している場合、//example.comはhttps://example.comになります。
URLパーサーはどこで混乱するのか
URL文字列を構成する各要素と、長年にわたるRFCの変更を確認したうえで、URLパーサーに注目し、誤った、あるいは予期しない解析結果を引き起こすエッジケースを探すことにしました。
調査では、さまざまなプログラミング言語で書かれた15のライブラリ、URL取得ツール(curl、wgetなど)、およびブラウザーを調べました。
パーサー間には多くの不一致があることがわかりました。これらを4つの主要カテゴリに分類しました。以下のカテゴリを利用すれば、ほとんどのパーサーを欺き、予測不能なさまざまな動作を引き起こして、幅広い脆弱性につなげることができます。
分類したカテゴリは次のとおりです。
さっそく、それぞれ見ていきましょう!
スキームの混同
スキーム要素がない場合、ほぼすべてのURLパーサーが混乱します。RFC 3986ではスキーム要素がURLの唯一の必須要素とされていますが、RFC 2396以前ではそうではなかったためです。こうした違いを考慮しながら後方互換性を保つパーサーを実装するのは簡単ではなく、その結果、混乱が生じます。
その様子を示すため、URL google.com/abcを与えたときの、4つの異なるPythonライブラリの動作を見てみましょう。

上の例のように、大半のパーサーは文字列google.com/abcに対して、host要素は空だと判断します。しかしUrllib3は、hostがgoogle.com、pathが/abcだと判断します。一方、httptoolsは、このURL自体が無効だと主張します。つまり、RFCの仕様に従っていないこのURLを、ほとんどのパーサーは正しく解析できません。
一方、ここでのcurlのように、デフォルトのスキームにフォールバックするパーサーもあります。

この場合、パーサーの違いを悪用して、攻撃者が検証を回避する可能性があります。URLパーサーが特定のホストを検証しようとしても、URLを正しく解析してホストを抽出できず、同時に基盤となるライブラリがURLを正しく解析する(またはフォールバックする)場合、検証を回避できます。たとえば次のようなケースです。

上の例では、urllib(具体的にはurlsplit関数)はURLにnetlocがないと解析するため、チェックを通過します。しかしurllib3はデフォルトのhttpプロトコルを補って、アクセス禁止のリソースを取得します。
スラッシュの混同
次の混同の手法は、URL内のスラッシュの数が標準と異なる場合に発生します。RFC 3986では、URLのAuthority要素はコロンと2つのスラッシュ://の後に置き、行末(EOL)または区切り文字が読み込まれるまで続くとされています。ここでの区切り文字は、スラッシュ(パス要素を示す)、疑問符(クエリ要素)、またはハッシュ記号(フラグメント要素)です。
調査では、上記の構文に従わないURLを解析する際に、パーサーがさまざまな動作をすることがわかりました。次のURLhttp:///google.comを与えると、パーサーは興味深い動作を示しました。

ご覧のとおり、大半のパーサーはこのURLにホストがないと判断し、代わりに/google.comをホストのないURLのパスとして解析しました。これはRFC 3986に沿った動作です。スキームの後にスラッシュを何個置いても、同じ結果を再現できました。しかし、余分なスラッシュや不足しているスラッシュをある程度無視して、URLを「修正」しようとするパーサーもありました。たとえば、JavaScript標準のfetch関数は、このようなURLを正しいものとして扱います。

curlも同様です。

解析結果のこうした違いは、広い攻撃対象領域を生み出します。先ほどの攻撃(スキームの混同)と同様に、最初のパーサーと取得処理でURLの解析結果が異なることを利用して、チェックを回避できるとしたらどうでしょうか。次の例を考えてみましょう。

ここでも、ブロック対象ドメインに対するnetlocのアサーションが確認できます。さらに、パースの結果netlocが空になるため、チェックを通過してしまいます。その後、コード内でcurlがURLを異なる方法で解釈し、予期せずリソースを取得しようとします。その結果、SSRFや、許可されていない他のホストへのアクセスにつながる可能性があります。
バックスラッシュの混同
スラッシュの混同の一種に、バックスラッシュの混同があります。URLでスラッシュ(\)の代わりにバックスラッシュ(/)を使うと、不正な形式のURLが生成され、この混同が起きる可能性があります。RFC 396によると、バックスラッシュはスラッシュとは異なり、別のものとして解釈されるべきです。そのため、http://google.comとhttp:\\google.comは異なるURLです。RFCに従い、ほとんどのプログラム上のURLパーサーは、実際にこの2つのURLを異なるものとして扱います。

しかしChromeは、バックスラッシュをスラッシュとして解釈します。

有効なURLであるかのように、そのURLへアクセスします。極端な例では、この動作はhttps:/\google.comでも起こり、Chromeは(予想に反して)リソースを提供します。
URLエンコードの混同
最後の混同カテゴリは、URLエンコードの混同です。URL内の、本来は想定されていない箇所にURLエンコードされた部分文字列が含まれると、この混同が起こります。
URLエンコードとは一般に、印字できない文字をURL文字列に含めるための方法です。文字の16進数値の前に%を付けて表します。たとえば、gはURLエンコードすると%67になります。この方法により、どのような文字が含まれていても、URL文字列をテキストとして表示できる状態に保てます。本来は印字できない文字を扱うための方法ですが、印字可能な文字もURLエンコードできます。ここで混同が生じます。
RFC 3986では、スキームを除くすべてのURLコンポーネントをURLエンコードできると定めています。しかし実際には、多くのパーサーがnetlocコンポーネントをパースしません。
URLhttp://google.comをURLエンコードした形式でパーサーに渡したときの解析結果は次のとおりです。

上記の結果は予想どおりに見えますが、PythonのurllibとrequestsにURLエンコードされたURLを渡したところ、興味深い動作が確認されました。

上記のどちらの場合も、予期せず127.0.0.1にリクエストが送信されました。
このような不一致により、新たな攻撃対象領域が生まれます。単純なRegexパターンではこのような文字列を検出できないため、再びチェックを回避される可能性があります。
エクスプロイトの概念実証(および報告されたCVE)
混同が生じる理由がわかったところで、これらの問題や発見された脆弱性を悪用する方法を見ていきましょう。ここでは1つのCVEを詳しく説明します。CVEの全リストは以下をご覧ください。
Clearance(Ruby):CVE-2021-23435:オープンリダイレクトの脆弱性
オープンリダイレクトの脆弱性は、Webアプリケーションがユーザー制御の入力を受け取り、ログインなどの操作後にユーザーをリダイレクトするURLとして使用すると発生します。攻撃の仕組みを視覚的に示すため、図をご覧ください。
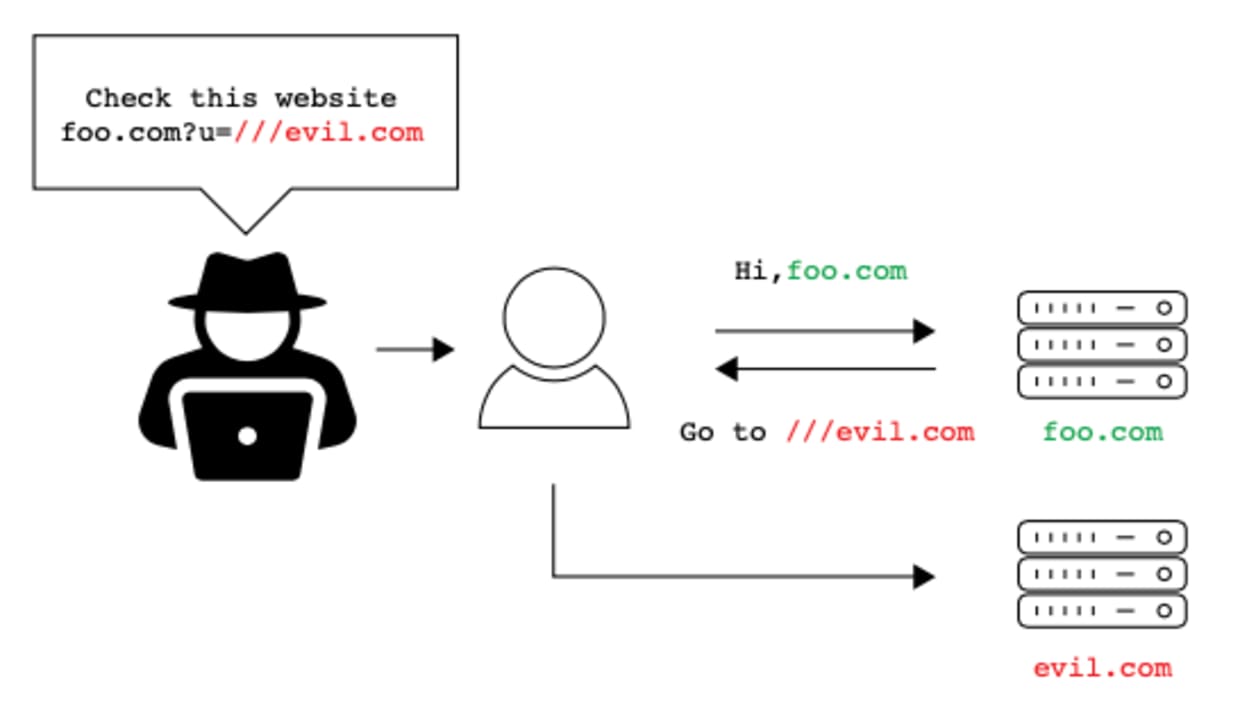
ご覧のとおり、攻撃者は被害者に使用させるURLを渡します。適切な条件がそろうと、サーバーはユーザーを攻撃者が制御するサイトにリダイレクトします。
Clearanceは、email-and-password認証を追加してRailsフレームワークの認証機能を拡張するRuby gemです。ログインまたはログアウトの後、以前のユーザーリクエスト(つまり、ログインページを開く前にリクエストしたリソース)から取得したURLを使って、ユーザーをリダイレクトします。
脆弱なコードは、return_to関数(ログイン/ログアウト後のコールバック)にあります。
オープンリダイレクトを防ぐため、return_toではユーザーが任意のreturn_to URLを指定できません。しかし、ログインしていないユーザーがauth-requiredリソースをリクエストすると、システムはstore_locationを呼び出し、ブラウザーをログインページにリダイレクトします。攻撃者が被害者にhttp://target.com/////evil.comのようなリンクをクリックさせることができれば、脆弱性が発動します。
なぜオープンリダイレクトが起きるのでしょうか?複数のパーサーが使われるためです!
見てきたように、store_locationはURLのフルパスを保存します(これもRubyがURL内の連続するスラッシュを無視するためです)。つまり、キャッシュには/////evil.comが保存されます。URI.parseが呼び出されると、余分なスラッシュが2つ削除され、///evil.comになります。ブラウザー(Chromeなど)がこのURLを受け取ると、ネットワークパス参照として扱い、クライアントをhttp://evil.comにリダイレクトします。
現在のブラウザーがこのようなURLの誤りを「許容」し、修正を試みる傾向にあるのは、ブラウザーが長年にわたり、不完全なURLやRFCに準拠しないURLに対処してきたためです。ブラウザーはクライアントや開発者のミスに対応できるよう、よくある間違いについて、時間をかけてスラッシュを省略または追加するようになりました。
以下は、Chromiumプロジェクトのソースコードの一部です。
その他の脆弱性
パーサー間の違いによって発生したその他の脆弱性をいくつか紹介します。
Flask-security(Python、CVE-2021-23385)
Flask-security-too(Python、CVE-2021-32618)
Flask-User(Python、CVE-2021-23401)
Flask-unchained(Python、CVE-2021-23393)
BelledonneのSIP Stack(C、CVE-2021-33056)
Video.js(JavaScript、CVE-2021-23414)
Nagios XI(PHP、CVE-2021-37352)
Clearance(Ruby、CVE-2021-23435)
URLの混同を防ぐための推奨事項
この記事で取り上げた問題の根本的な原因は、複数のパーサーとそれぞれの処理方法にあります。そのため、アプリケーション内でどのパーサーが使われているかを把握することが重要です。現在のアーキテクチャ(マイクロサービスやメッシュなど)では状況がさらに複雑になり、アプリケーション内にどのようなパーサーが存在するのか、またリクエストがどのように処理されるのかを完全に把握するには、時間がかかる場合があります。
パーサーの一覧を作成したら、開発者はそれぞれのパーサーの解析ロジックの違いを十分に理解する必要があります。そうすることで、アプリケーションの安全性を損なうことなく開発を進められます。
一般的には、次のことをおすすめします。
使用するパーサーの種類をできるだけ少なくする。そうすることで「混同」が生じる範囲を最小限に抑え、発生しうる解析上の問題を減らせます。
分散システムでは、解析を1か所で行う。システム内のさまざまなコンポーネント間でリクエストが何度も渡される場合、異なる言語で書かれたサービスなどで、異なるパーサーが呼び出される可能性があります。これを防ぐには、システムのリクエスト受け付け時にURLを一度だけパースし、解析済みのリクエストを渡します。こうすれば、リクエスト処理全体で使用するパーサーを1つにできます。
ビジネスロジックで使うパーサーの違いを把握する。コードやビジネス上の要件の一部としてURLをパースする必要がある場合もあるため、機能を開発する担当者は、前述のようなパーサー間の違いを理解することが重要です。
URL Confusionのホワイトペーパーを読む
ホワイトペーパーを読んで、URL Confusionの種類についてさらに詳しく知りましょう。