Cの裏側:Pythonの世界に潜むC/C++の脆弱性を探る

Aviad Hahami
2022年4月28日
0 分で読めます私を含む多くの開発者は、PythonやJavaScriptなどの高級言語を主に使ってコードを書いています。しかし、パフォーマンスやプロジェクトのほかの要素を改善するために、ネイティブ要素を追加する必要が生じることもあります。こうしたネイティブ拡張の呼び出しは通常CまたはC++で書かれているため、JavaScriptやPythonを主に使うプロジェクトでも、C/C++の推移的依存関係を考慮しなければなりません。
2021年5月、SnykはFossIDを買収しました。FossIDは、CおよびC++のオープンソースエコシステムにおけるライセンスと脆弱性の検出を専門としています。その後、FossIDはSnyk CLIに統合され、CおよびC++の依存関係をスキャンできるようになりました。
Snykのセキュリティチームの一員として、npmおよびPyPIのプロジェクトに対するSnykのCファイルスキャン結果を調査したところ、興味深い、そして少々不安になる発見がありました。
この記事では、開発者が高級言語のプロジェクトにネイティブなC/C++拡張を組み込む理由と、そのメリットについて説明します。続いて、PythonとPyPIレジストリを使って、高級言語のプロジェクトに潜むC関連の脆弱性を検出し、一見安全に見える高級言語のコードに低レベルの脆弱性がどのような影響を及ぼすかを明らかにします。
高級言語のプロジェクトにC/C++ファイルを含める理由
高級言語の環境でCファイルを使うのは、必ずしも簡単ではありません。それでも、アプリにCコードを含めることには多くのメリットがあります。
実行時間とパフォーマンス
Pythonのようなインタープリター言語を考えてみましょう。Pythonプログラムを実行するたびに、コードを解析して解釈してから実行する必要があります。Cを組み合わせると、PythonとCのスーパーセットであるCythonを使って、PythonコードをCコードにトランスパイルし、後からコンパイルすることで実行を高速化できます。
ハードウェア、リソース、メモリ管理
高負荷な計算処理を必要とし、特殊なハードウェアとやり取りするプログラムを書くことがあります。たとえば、GPUを使用するグラフィックエンジンや暗号資産関連のソフトウェアなどです。また、リソースが限られる可能性のあるリアルタイムコンポーネントも考慮する必要があります。こうしたケースでは、ガベージコレクションのような非決定的な処理が問題となり、決定論的なメモリ処理が求められるため、Cが最適な言語となります。
補題と仮説
今回の調査における仮説は次のとおりです。
補題:
高級言語のソースコードやランタイム環境にC/C++ファイルを含めるのには、十分な理由が数多くあります。
C/C++ファイルに対応する、広く普及したパッケージ管理システムはありません。
仮説:
Cファイルを組み込んだ高級言語のパッケージを調べれば、そのパッケージ内にC由来の脆弱性を見つけられる。
仮説を検証するため、最初の候補としてPythonとPyPIエコシステムを選び、実現可能性を探るための試金石としました。
PyPIレジストリ:PythonにおけるC
この記事の執筆時点で、PyPIには約367,755個のライブラリが公開されています。
最初のスキャンでは、Cファイルを含むすべてのパッケージとそのバージョンを特定することを目指しました。
Cファイルを1つ以上含むライブラリは約6,200個見つかりました。これはエコシステム全体の約1.7%にあたります。
エコシステム全体と比べると少ない数ですが、今回の調査には最適です。結果の数が少ないため、誤検知を比較的簡単に検出して除外できます。
基準1:コンテンツの同一性
まず、前のステップで抽出したライブラリを対象に、ファイルの同一性を検証しました。この確認では、ライブラリ内のすべてのCファイルを調べ、既知のCVEに対して脆弱か、または過去に脆弱だったファイルがないかを確認しました。
現在Snykの製品に組み込まれているFossIDの優れたテクノロジーのおかげで、あらゆるファイルを最初に見つかった場所まで追跡し、コードスニペットの出典を特定できます。
最初の基準で調べた結果、オリジナルの脆弱なソースファイルをそのまま1つ以上含む、約64の異なるパッケージバージョン**が見つかりました。バージョンの違いを区別せずに数えると、同一の脆弱なファイルが143件見つかりました**。
基準2:コンテンツの類似性
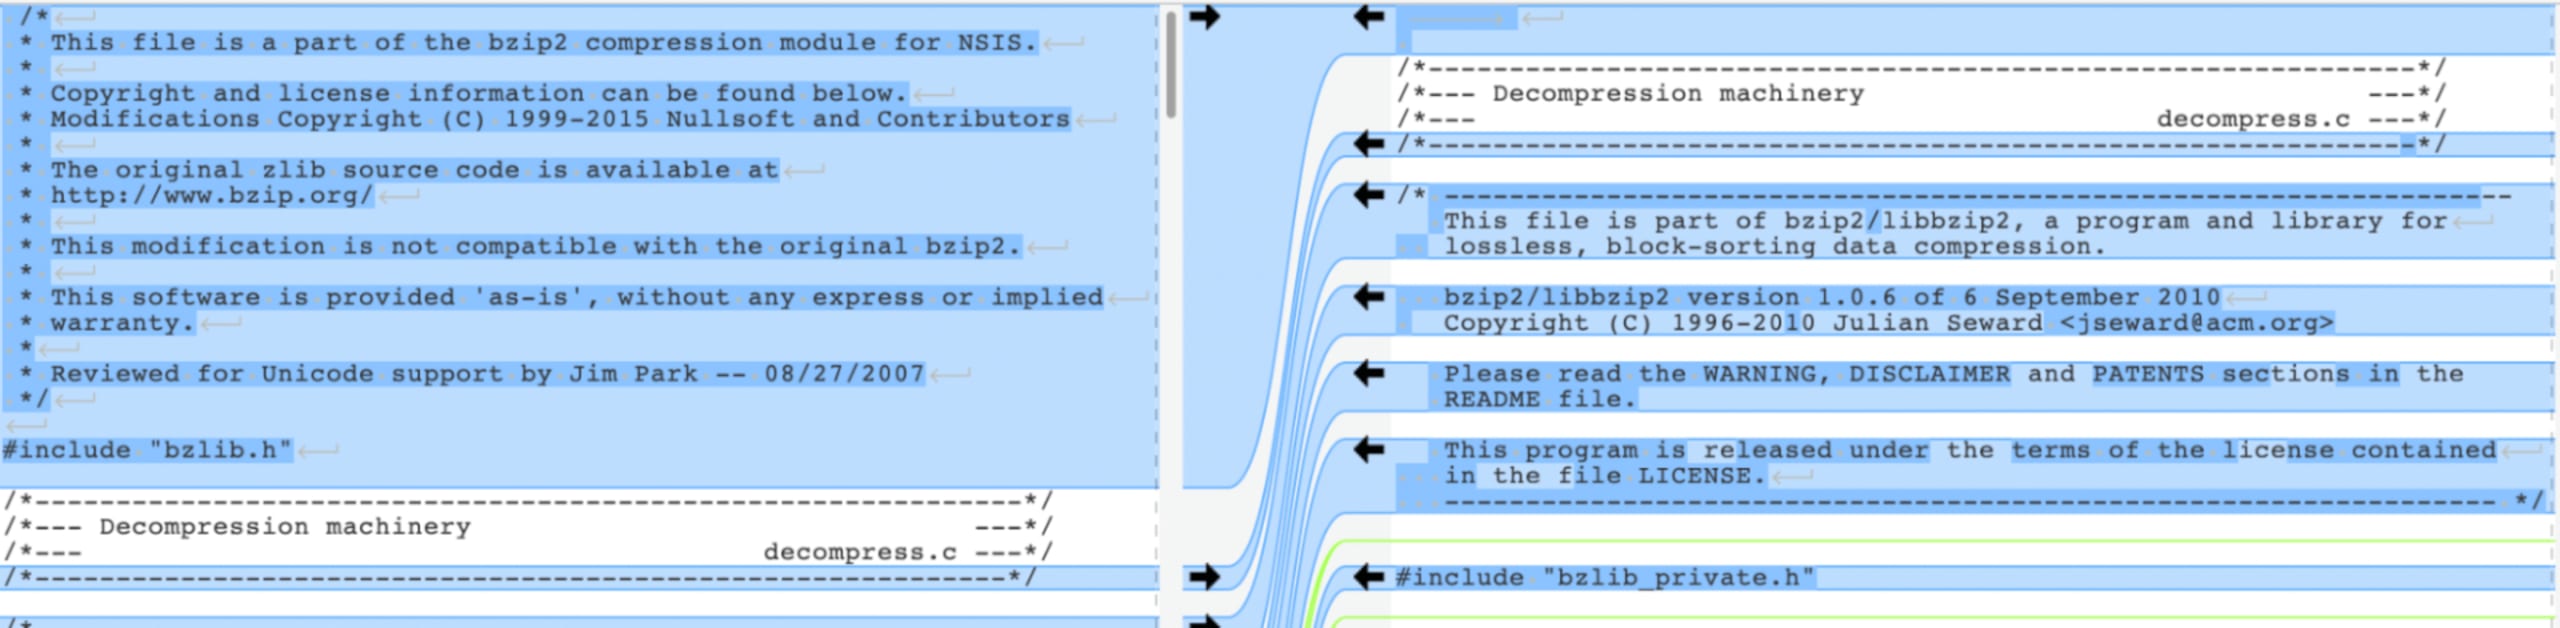
次に検証した基準は、ファイルの類似性です。今回の調査では、ファイルの内容そのものは同一でなくても、脆弱性に関係する重要なコードが同じであれば、類似していると判断しました。
上記の内容を検証したところ(基準1を除く)、既知の脆弱なスニペットを1つ以上含む、約231の異なるパッケージバージョンが見つかりました。異なるバージョンを区別せずに数えると、脆弱な同一スニペットが1,931件見つかりました。
数字を整理する
上記の数値をまとめると、PyPIパッケージで基準に該当するものが約2,074件見つかりました。Cコードは通常、より複雑なエンジニアリングタスクに使われるため、結果の中に次のような低レベル処理関連のライブラリが含まれていたのは予想どおりでした。
gevent(5.7k)
pycrypto(2.4k)
selectolax(約500)
以下のグラフは、Cを含むPythonライブラリの内訳を示しています。円グラフ全体が総数を表し、そのうち脆弱と判定された割合(悪用不可能なものや誤検知を含む)と、非常に高い確率で脆弱な割合を示しています。
Pythonライブラリ内のCファイル:脆弱性の内訳
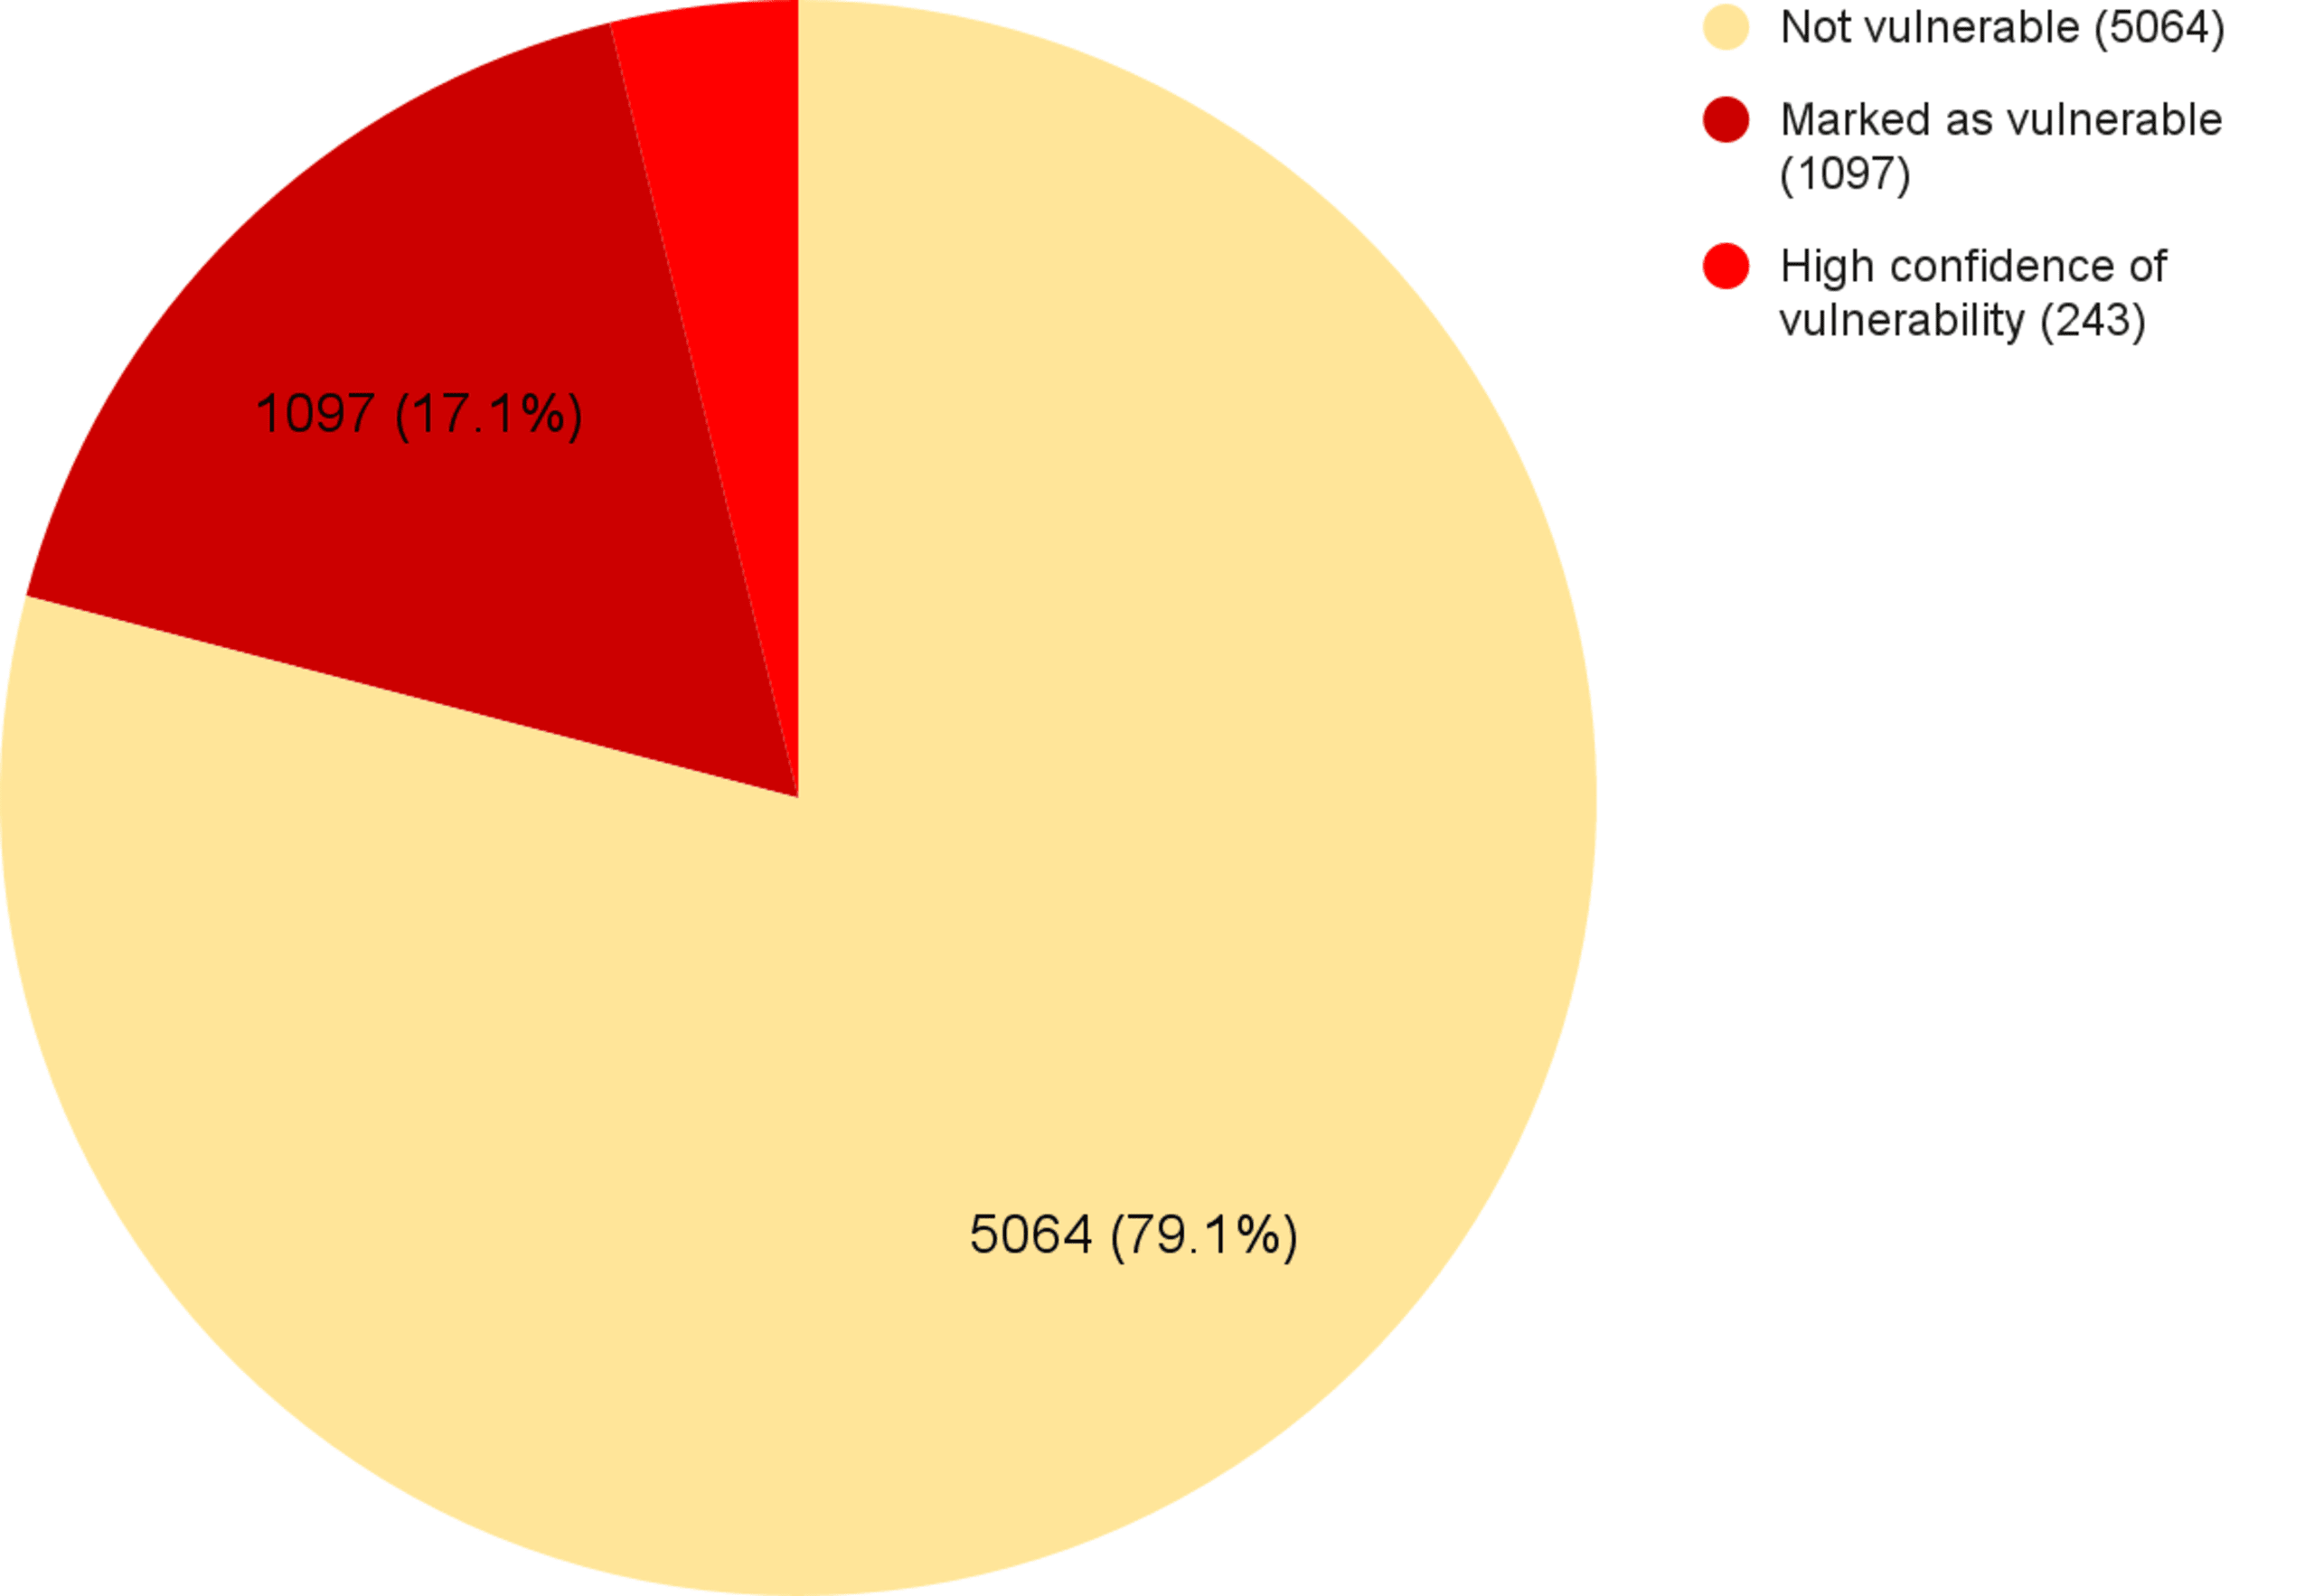
ライブラリの脆弱性が悪用可能であることを証明するのは簡単でも自動的でもありません。報告された脆弱性はすべて手作業で検証する必要があります。しかし、今回取り上げる問題が現実世界で重要な意味を持つことを示すため、次のセクションでは脆弱性の内容と、悪用された場合の深刻度を説明します。
20年前から潜んでいた脆弱性 - python-libsbml
ツールが報告したライブラリの1つがpython-libsbmlです。これは、システム生物学マークアップ言語(SBML)の読み取り、書き込み、操作に使うライブラリです。このマークアップ言語はXMLに関連しているため、プロジェクトの依存関係にlibxml2が含まれていても不思議ではありませんでした。
ツールはファイルの1つ(parser.c)をBillion Laughs Attackに対して脆弱と判定しました。これはCVE-2003-1564として追跡されている、20年前から存在するDoS脆弱性です。Billion Laughs攻撃の仕組みはとても単純です。XML文書内に十分な数の自己参照エンティティを生成し、それをパーサーに読み込ませるだけです。
この脆弱性を再現するためのPoCを紹介します。
悪意あるペイロードを作成し、payload.xmlとして保存します。
python-libsbmlをインストールした状態で、次のPythonファイルを作成します。
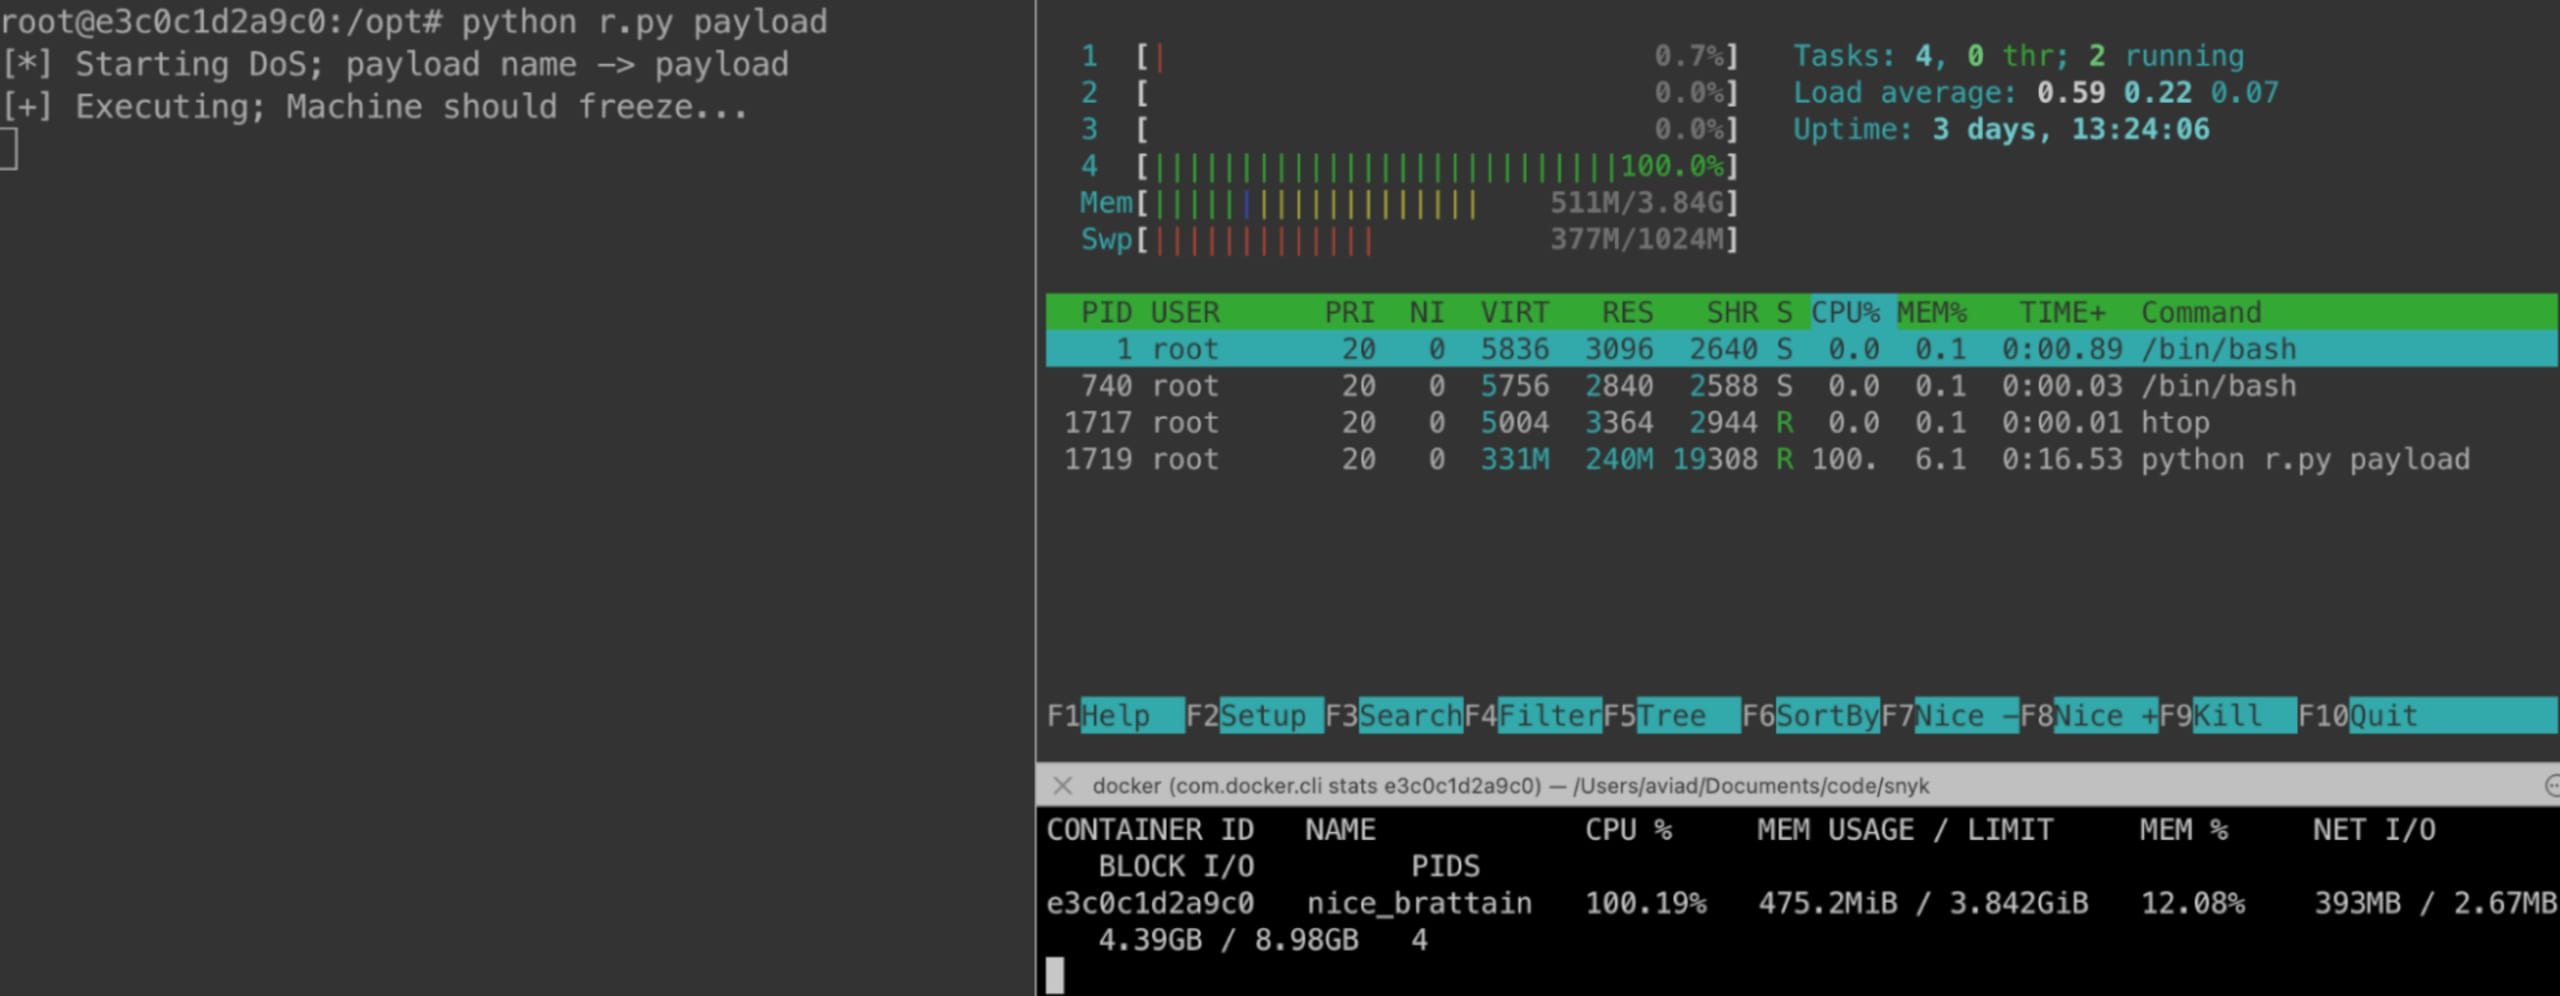
最後に、次のコマンドでPythonファイルを実行します。
「手順どおりに実行すると、CPU使用率が100%まで上昇し、メモリが増え続けてマシンがOOM(メモリ不足)になるはずです。これでマシンに対するDoS攻撃を実行できました。」
この脆弱性は開発コミュニティに大きな衝撃を与えるものではないかもしれません。しかし、BoF、UaF、PE/RCE、あるいはその他のCコード由来の脆弱性が、PythonやNodeJSのコードに潜んでいたとしたらどうでしょうか。こうした脆弱性を確認したことはありますか?
このライブラリは月に約2万回ダウンロードされ、約115の公開プロジェクトが直接依存しています。これは既知の20年前から存在する脆弱性であるにもかかわらず、気づいていない非常に多くの依存プロジェクトが、これを顧客やユーザーに届けてきました。
次にすべきこと
オープンソースのメンテナーと連携しながら脆弱性の発見と開示を続ける一方で、開発者の皆さんにも、C以外のプロジェクトにCファイルが含まれていないか確認することをお勧めします。
こうしたCファイルにはパッケージマネージャーがないことが多く、そのまま、あるいはコピー&ペーストされた状態で長期間残りがちです。その結果、古くなって脆弱性を抱えていることが後になって判明する場合があります(悪意のない第三者によって発見されることを願います)。
今すぐSnykに登録して、新しいCLI機能を使い、プロジェクト内のパッケージマネージャーで管理されていないC/C++依存関係をスキャンしましょう。
CTFを始めよう
オンデマンドのバーチャル入門ワークショップを視聴して、CTFの課題の解き方を学びましょう。


