セキュリティ脆弱性のスコアリング入門:CVEのCVSSを解説

2019年5月16日
0 分で読めますソフトウェアのバグを深刻度に応じてトリアージするのと同様に、セキュリティ脆弱性も影響とリスクを評価する必要があります。これにより、脆弱性管理に役立てることができます。
Forum of Incident Response and Security Teams(FIRST)は、信頼されるセキュリティ分野のコンピューター研究者や科学者による国際組織です。インシデント対応チーム向けのベストプラクティスやツールの作成に加え、セキュリティポリシーや方法論の標準化を担っています。
FIRSTの取り組みの一つに、Special Interest Group(SIG)があります。セキュリティ脆弱性の深刻度を理解し、優先順位を付けられるよう、Common Vulnerability Scoring System(CVSS)の仕様の策定と維持を担っています。
脆弱性のスコアリング
CVSSは、脆弱性の影響を正確かつ一貫して評価する必要がある業界、組織、政府機関にとって、標準的な測定システムとして認められています。
CVSSの定量モデルにより、再現性と正確性の高い測定が可能になります。また、スコアの算出に使用された脆弱性の特性を確認できます。
CVSSは一般に、脆弱性の修正作業の優先順位付けや、自社システムで見つかった脆弱性の深刻度の算出に利用されます。
CVSSの課題
適用状況のコンテキスト不足
脆弱性スコアでは、組織が脆弱なコンポーネントをどのような状況で使用しているかが、必ずしも考慮されるとは限りません。Common Vulnerabilities and Exposures(CVE)システムでは、組織のスコアを判断する際にさまざまな変数を考慮できます。しかし、CVEが割り当てたスコアにかかわらず、脆弱性への対応方法に影響する要素はほかにもあります。
たとえば、テストハーネスなどテスト目的で使われているコンポーネントにCVSSで高深刻度と分類される脆弱性が見つかっても、セキュリティチームやIT部門、研究開発部門がほとんど、あるいはまったく対応しない場合があります。その理由の一つは、コンポーネントが内部ツールとして使用されており、公開インターフェースにさらされていたり、誰でもアクセスできたりするわけではないことです。
さらに、脆弱性スコアでは、医療機器、自動車、電力網などに脆弱性が及ぼす重大な影響まで考慮できません。各組織は、自社製品の脆弱なコンポーネントにおける該当状況に照らして、固有の影響をトリアージし、考慮する必要があります。
不正確なスコアリング
脆弱性スコアは十数個以上の主要な特性から構成されます。適切な指針や経験、補足情報がなければ、簡単に誤りが生じます。最近の学術研究[1]では、参加者に提示されたCVE脆弱性のスコアリングに関する質問のうち、正しく回答されたのはわずか57%でした。この研究では、精度を高めるうえで重要な情報の手がかりや、スコアリングの混乱を招き精度を下げる要因についても詳しく述べています。
CVEに誤検知が含まれていたり、いずれかの指標グループに割り当てられたスコアが不正確だったりすることは珍しくありません。その結果、CVEへの信頼を損なったり、組織に不要なパニックを引き起こしたりするリスクがあります。
CVSSのスコア範囲は0~10で、低から高、重大までの深刻度レベルに対応します。変数の評価が不正確だと、誤ったCVSSレベルに対応するスコアになる可能性があります。カーネギーメロン大学による別の研究[2]でも、スコアリングの精度について同様の結果が報告されました。レポートには、「調査回答者の半数以上が、CVSSスコア4ポイント分の精度範囲内に一貫して収まっていない」とあります。4ポイントの差だけでも、深刻度は高または重大から、より低いレベルへと変わります。
[1] Allodi, Luca & Banescu, Sebastian & Femmer, Henning & Beckers, Kristian. (2018). Identifying Relevant Information Cues for Vulnerability Assessment Using CVSS. 119-126. 10.1145/3176258.3176340.
[2] Spring, J.M, Hatleback, E. Householder, A. Manion, A. Shick, D. "TOWARDS IMPROVING CVSS" Carnegie Mellon University, December 2018
Snykの取り組み
Snykでは、CVSS v3.1を使用して、セキュリティ脆弱性の特性とその影響を評価し、伝えています。
Snykの専任Security Researchチームは、さまざまなエコシステムにおける新たな脆弱性の発見に取り組んでいます。さらに、CVEスコアをトリアージし、深刻度が正しく反映されているかを確認することで、CVEを発行する他の機関による前述のスコアリングの不正確さを補っています。
Snykの脆弱性データベースでは、各脆弱性について、CVEの詳細に加えて補足メタデータを提供しています。Security Researchチームは、脆弱なコンポーネントの概要や脆弱性の種類の詳細など、各脆弱性の情報を精選します。さらに、コミットや修正、脆弱性に関連するその他の情報への参照リンクや例も掲載しています。
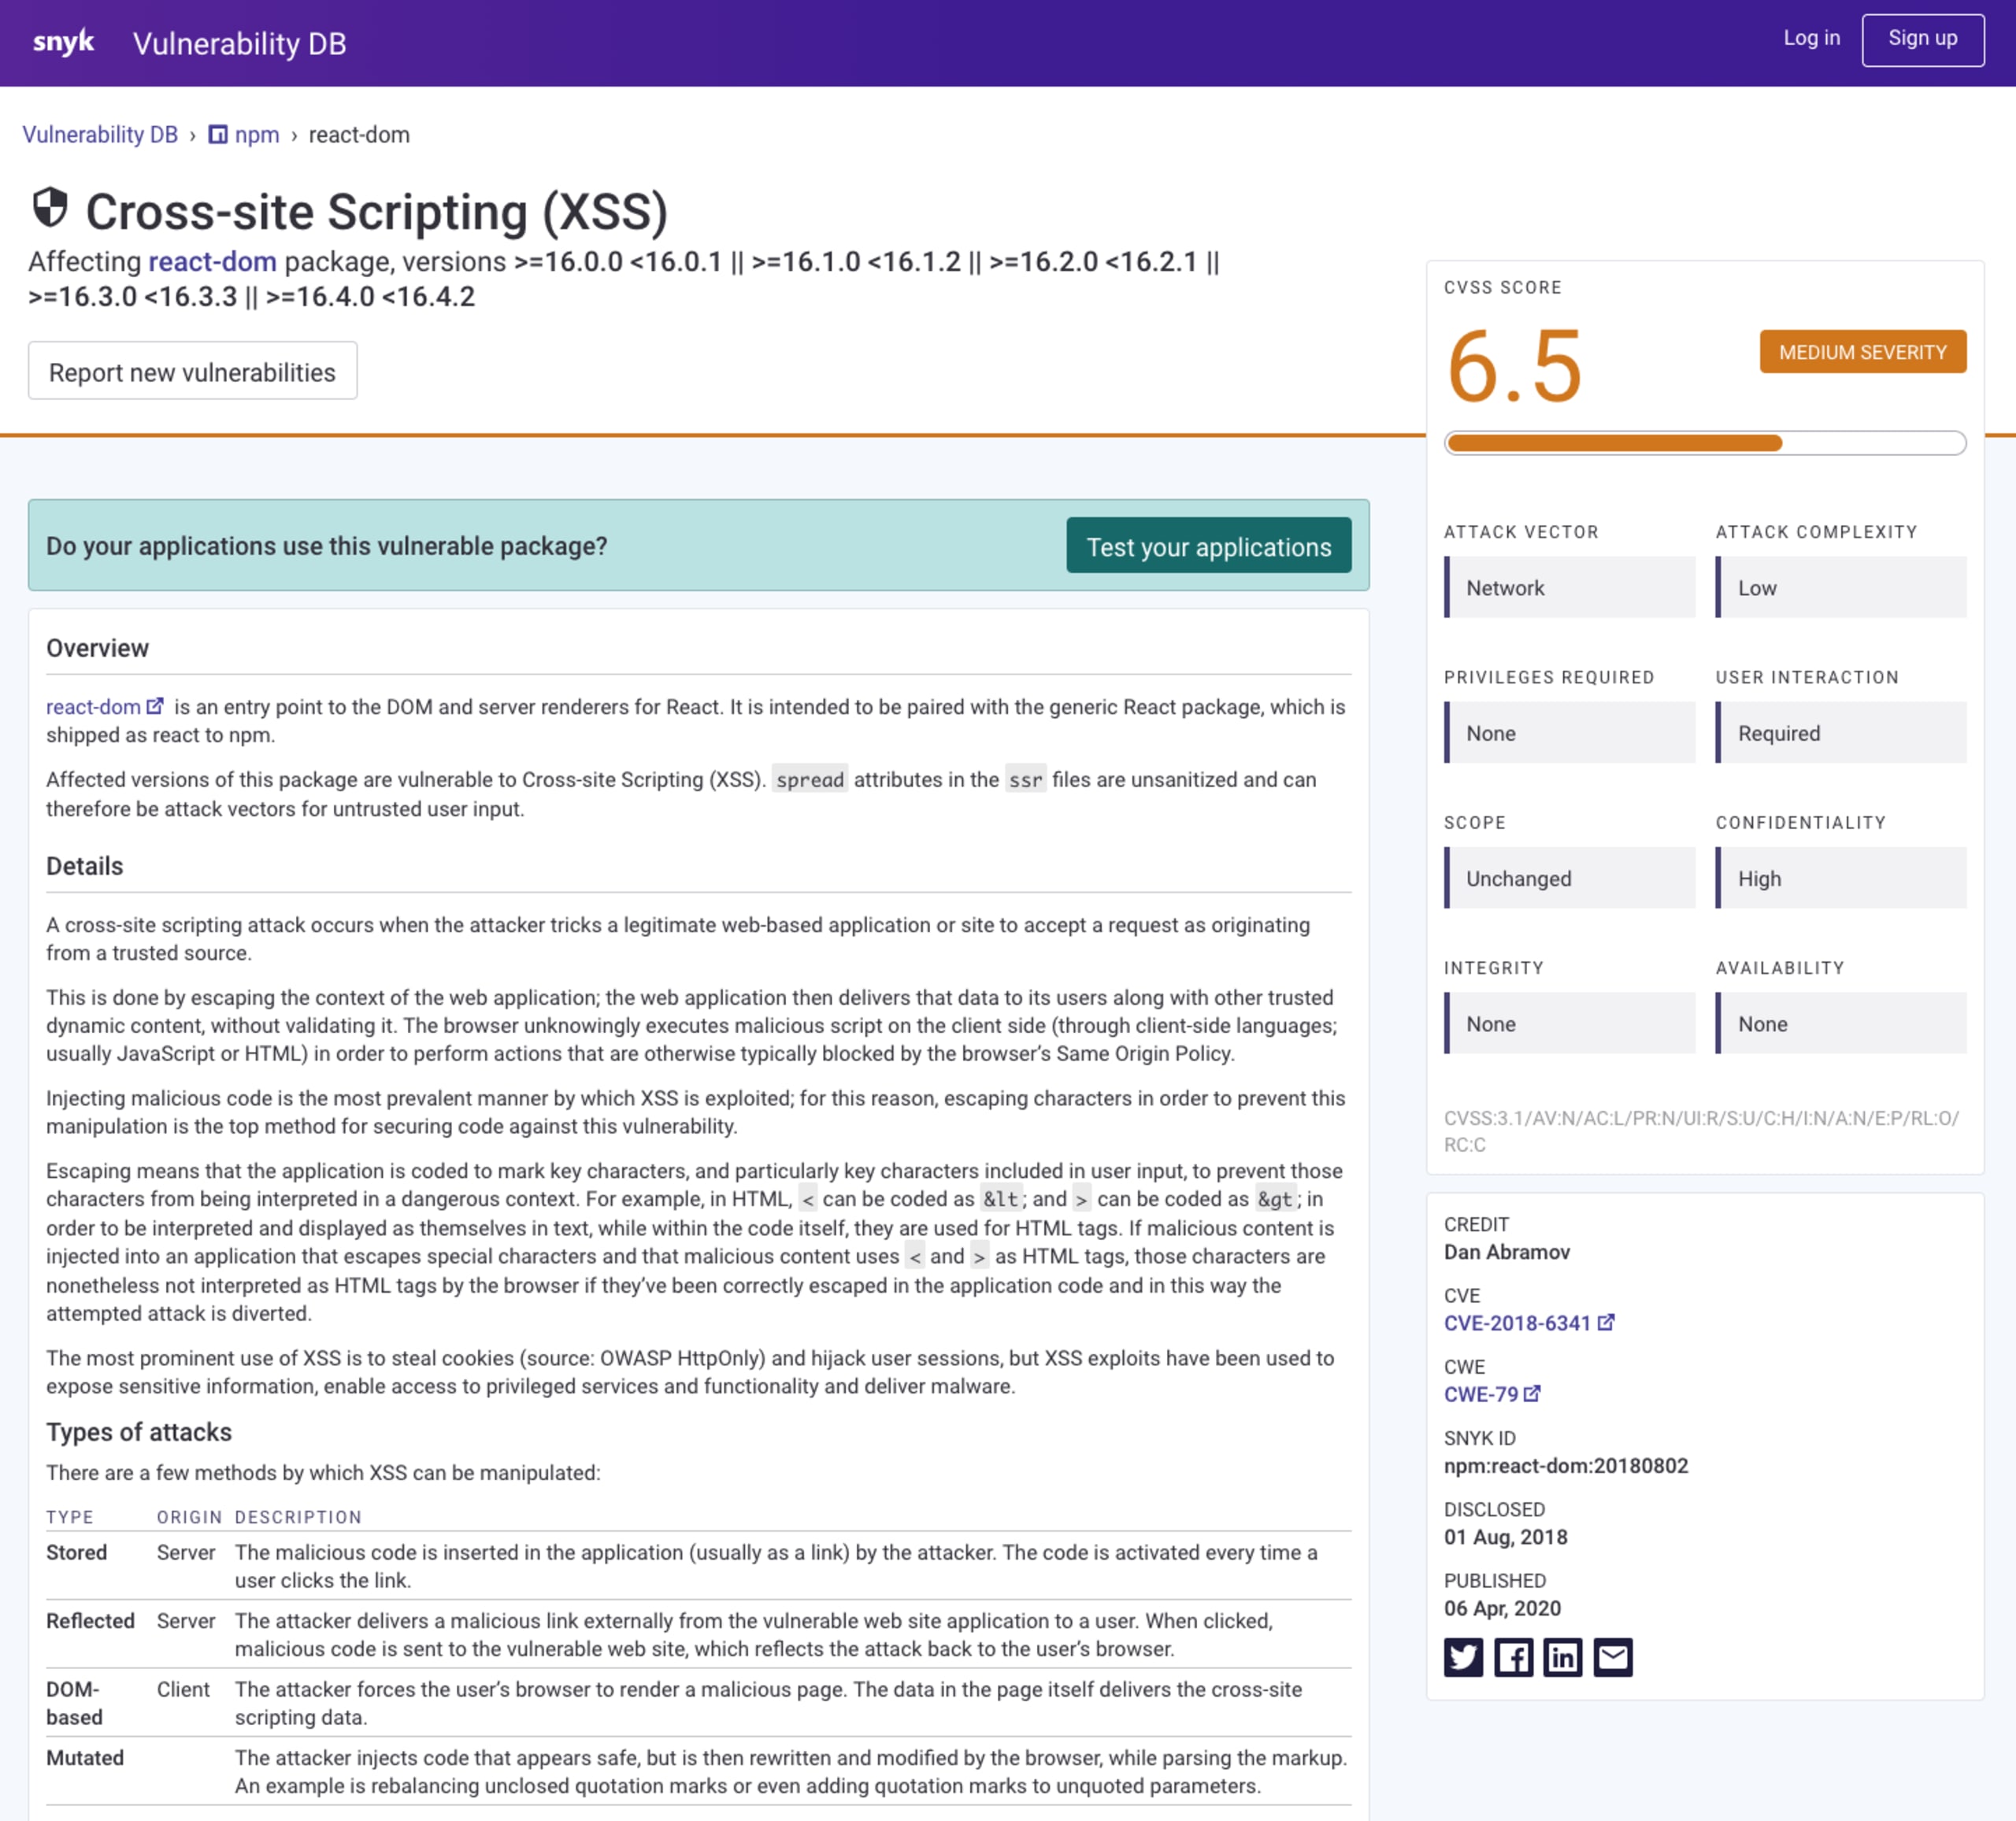
次の画像は、フロントエンドのReactフレームワークで見つかったクロスサイトスクリプティング(XSS)脆弱性を示しています。React DOMモジュールの16.x系の複数のバージョンに影響します。
この画像では、CVSS v3.1の基本スコアと、各指標の詳細な内訳も確認できます。
CVSSの仕組み
CVSSにはこれまでに3つのバージョンがあります。2004年の初回リリースから、CVSS v2.0の広範な採用を経て、現在の仕様であるCVSS v3.1に至ります。この記事では、CVSS v3.1に焦点を当てます。
この仕様は、脆弱性が懸念される個々の領域を反映するよう分類し、脆弱性のスコアリング方法を標準化するフレームワークを提供します。
CVSSスコアの指標は、次の3つのグループに分かれています。
基本(Base)—脆弱性の発生時期やユーザーの環境に左右されない、影響評価と悪用可能性の指標です。脆弱性を悪用する難易度などが該当します。たとえば、脆弱性によって脆弱なコンポーネントへのアクセスが完全に拒否される場合、可用性への影響は高く評価されます。
時間的(Temporal)—脆弱性スコアに影響する状況を考慮する指標です。たとえば、脆弱性の既知のエクスプロイトがある場合はスコアが上がり、パッチや修正が公開されている場合はスコアが下がります。
環境的(Environmental)—ユーザーや組織の特定の環境に対する影響に合わせて、スコアを調整できる指標です。たとえば、組織が脆弱なコンポーネントの可用性を非常に重視する場合、可用性要件を高く設定してCVSSの総合スコアを上げることができます。
基本指標グループは、CVSSベクトルの基盤となります。時間的指標や環境的指標がある場合は、CVSSの総合スコアに反映されます。
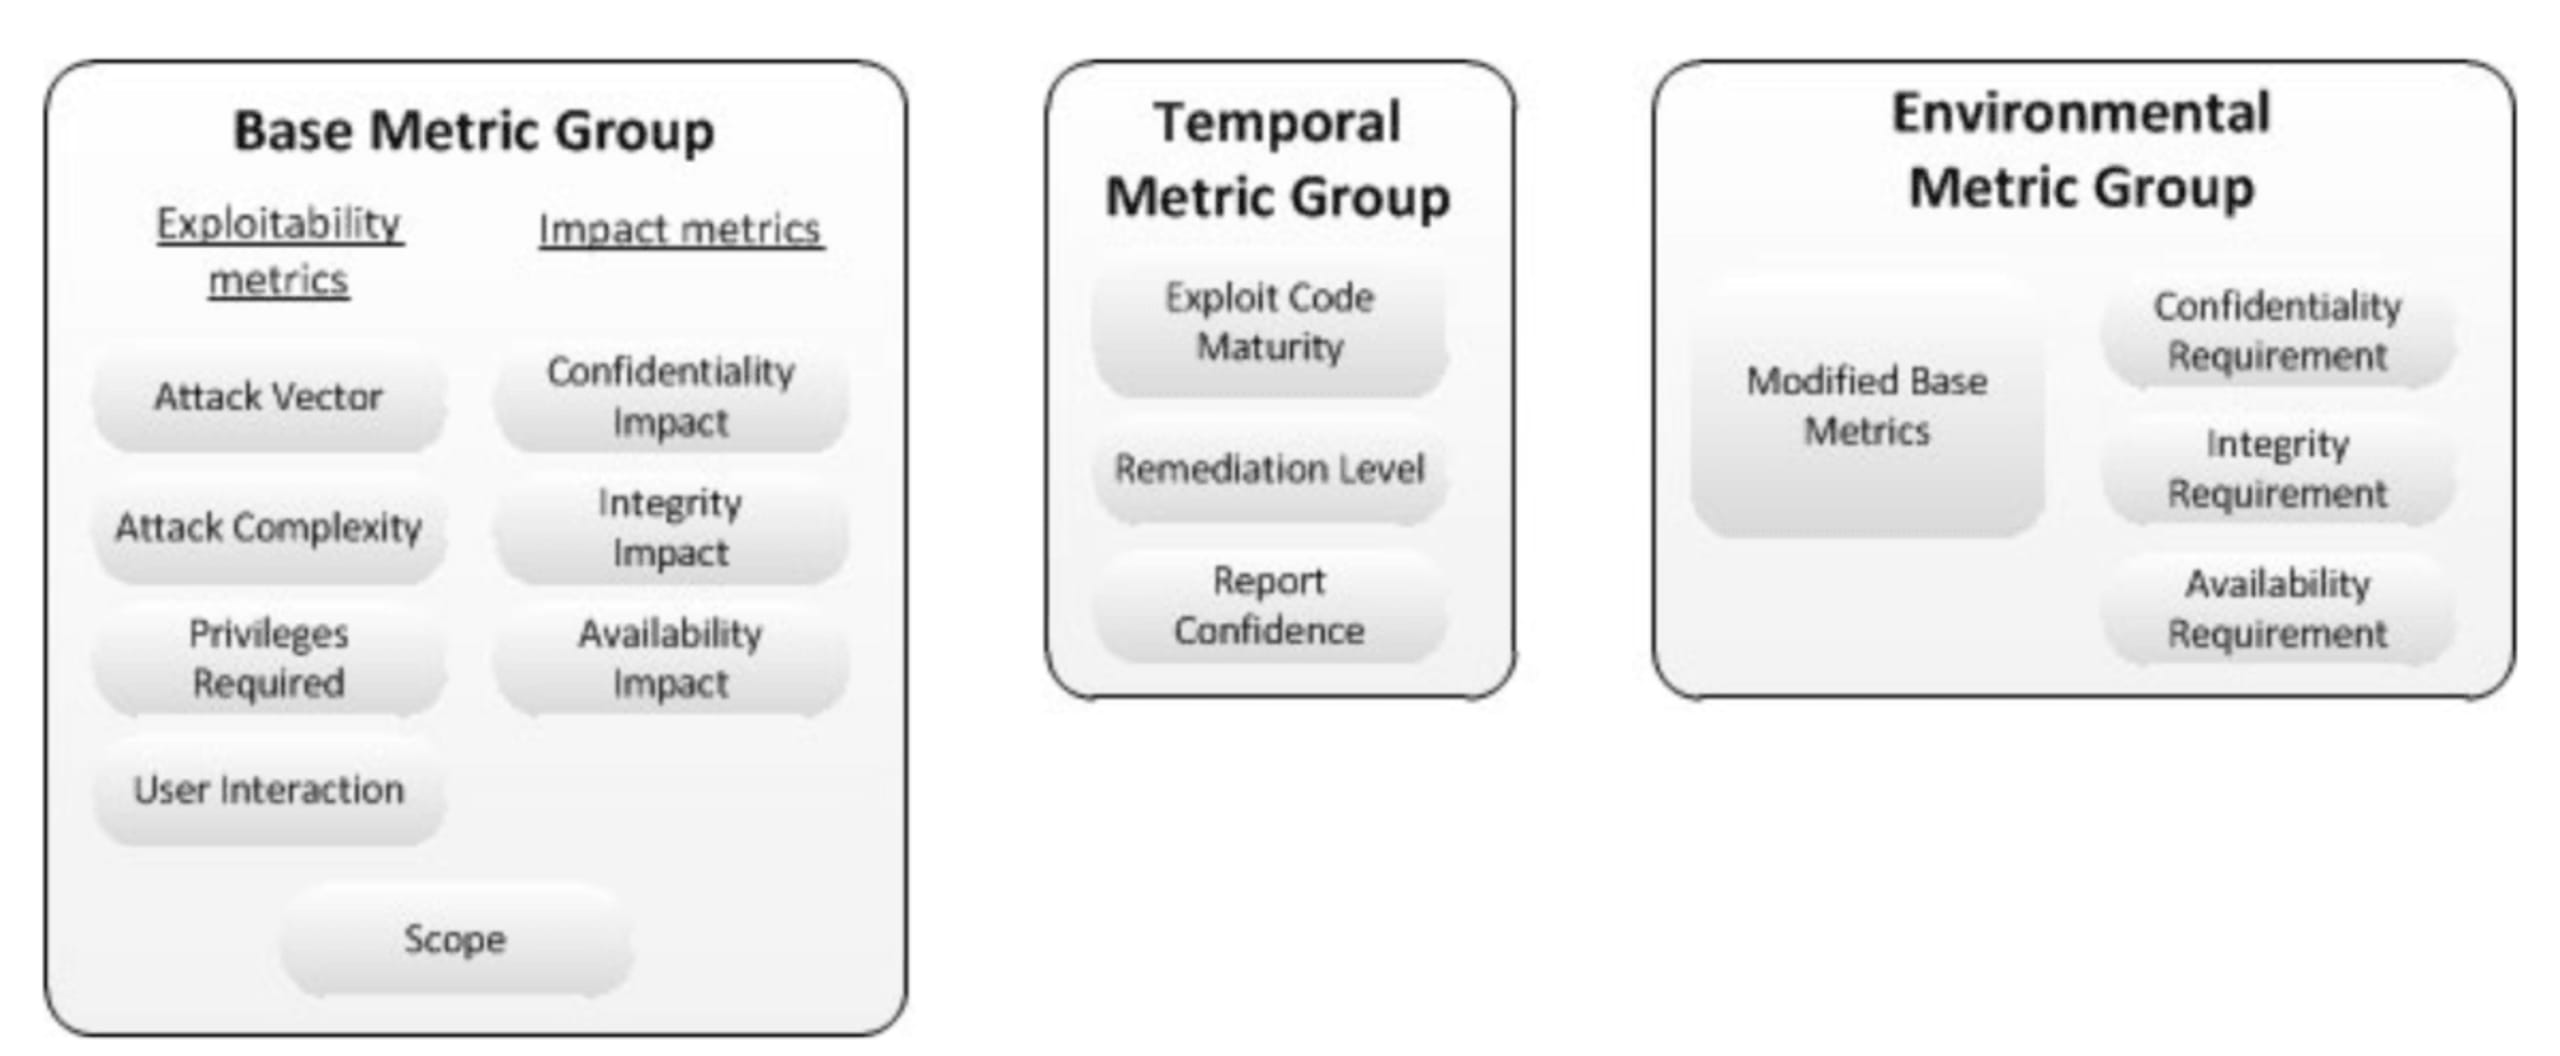
CVSS 3.0の指標グループ:FIRST / CC-BY-SA-3.0
基本スコア
CVSSの基本指標は、悪用可能性と影響のサブグループで構成されます。ソフトウェアコンポーネントへの適用可能性を評価し、他のコンポーネント(ソフトウェア、ハードウェア、ネットワーク機器)への影響も考慮します。
悪用可能性は、セキュリティ脆弱性を悪用するために必要な労力や手段を表し、次の指標で構成されます。
攻撃元区分(AV)—悪用が可能な4種類の経路を表します。物理、ローカル、隣接ネットワーク、ネットワークです。アクセスしやすい経路ほどスコアが高くなります。
たとえば、公開Webサイトで悪用される可能性のあるjQueryのクロスサイトスクリプティング(XSS)脆弱性は、ネットワーク攻撃としてスコアリングされます。
攻撃条件の複雑さ(AC)—攻撃を成功させるために、事前条件として特別な状況や構成が必要かどうかに応じて、低または高のスコアを示します。たとえば、比較的簡単に実行でき、2018年と2017年にNext.jsパッケージで見つかったパストラバーサルは、攻撃条件の複雑さが低いと評価されます。攻撃条件の複雑さが高い例は、Apache Tomcatで見つかったタイミング攻撃です。
必要な特権(PR)—「なし」「低」「高」のいずれかのスコアを示します。これらのレベルは、脆弱性を悪用するために攻撃者が取得する必要のある特権のレベルに対応しています。たとえば、WordPress MUの任意コードインジェクションでは、認証済みユーザーが悪意のあるファイルをリモートからアップロードして実行できました。WordPressアプリケーションの役割や権限にかかわらず、認証済みユーザーであれば誰でも攻撃を実行できるため、スコアは低と評価されます。
ユーザー関与(UI)—攻撃を成功させるためにユーザーの操作が不要な場合は高いスコア、何らかのユーザー操作が必要な場合は低いスコアを示します。たとえば、インストールすると環境を侵害する悪意のあるモジュールでは、まず悪意のあるパッケージをインストールする操作が必要です。npmエコシステムでは、悪意のあるパッケージが数十件確認されています。その一つが、crossenvというパッケージ名でタイポスクワッティング攻撃を仕掛け、環境変数の窃取を試みた事例です。ユーザーの操作が必要なため、これらは低いスコアの例です。
影響の指標サブグループは、脆弱なコンポーネントが悪用に成功した場合の機密性、完全性、可用性への影響を表し、次の指標で構成されます。
機密性(C)—権限のないユーザーへの情報開示など、影響を受けるコンポーネントの機密性がどの程度損なわれるかを測定します。たとえば、Angularアプリケーション(正確にはAngularJS)で任意のスクリプトインジェクション脆弱性が悪用されると、機密性が大きく損なわれます。DOMイベントとして発生したユーザー入力が適切にサニタイズされていない場合、コード実行につながる可能性があります。
完全性(I)—脆弱なコンポーネントの悪用に成功した場合にデータを変更できるかなど、影響を受けるコンポーネントの完全性がどの程度損なわれるかを測定します。たとえば、オープンソースフレームワークのApache Struts 2では、不適切なデシリアライズによって任意のコマンドが実行され、完全性が大きく損なわれました。この脆弱性はEquifaxの情報漏えいに関与し、2017年に大きく報道されました。詳しくはブログをご覧ください。
可用性(A)—攻撃によってユーザーがサービス拒否の影響を受けるかなど、影響を受けるコンポーネントのリソースや機能がどの程度利用できなくなるかを測定します。たとえば、lodashのあるバージョンは正規表現によるサービス拒否攻撃に対して脆弱で、可用性に大きな影響を及ぼします。lodashをフロントエンドライブラリとして使用している場合、この脆弱性の悪用はエンドユーザーのブラウザーに影響します。一方、Node.jsのサーバーサイドアプリケーションで使用している場合は、イベントループが応答しなくなり、APIサービスへのすべてのリクエストに影響するため、問題はさらに深刻になります。
スコープが変更されている場合、影響の指標には、脆弱なコンポーネント自体と影響を受けるコンポーネントのうち、より大きな影響が反映される点に注意してください。
最後に、スコープはCVSS v3.0で導入された新しい指標です。スコープは、セキュリティ脆弱性が自身を超えて他のリソースに影響するかどうかを示します。スコープの値は変更なしまたは変更ありです。脆弱なコンポーネントの悪用に成功し、別の認可スコープによって管理されるリソースに影響が及ぶ場合は、スコープが変更されたことを示します。
たとえば、phpMyAdminのクロスサイトスクリプティング(XSS)脆弱性は、脆弱なコンポーネントがサーバーサイドのPHPアプリケーションとして動作するphpMyAdminであるため、スコープの変更に該当します。ただし、影響を受けるスコープはユーザーのブラウザーです。
脆弱なコンポーネントに非常に高い権限が与えられているリモートコマンド実行などのセキュリティ脆弱性は、スコープが変化し、そのコンポーネントだけの認可範囲を超えて、ほかのコンポーネントにまで影響が及ぶ可能性を示す好例です。
時間的スコア
時間的スコアは、CVEの深刻度を評価する際に、時間の経過に関する情報を加味するためのものです。たとえば、脆弱性を悪用する公開エクスプロイトが確認されている場合、攻撃に利用できるリソースへ容易にアクセスできるため、CVEの重大度と深刻度が高まります。
総合CVSSスコアは、時間的スコアを含め、各値の最も高いリスクに基づいて算出されます。時間的リスクがある場合にのみ含まれます。そのため、脆弱性に割り当てられた時間的スコアの値によって総合CVSSスコアが維持されることはあっても、スコアが下がることはありますが、上がることはありません。
時間的スコアの指標は次のとおりです。
エクスプロイトコードの成熟度(E)—公開されているエクスプロイトコードの成熟度に応じて、脆弱性が悪用される可能性を評価します。値は、エクスプロイトコードがない場合は「U」、既知の概念実証コードがある場合は「P」、機能するエクスプロイトコードがある場合は「F」です。「H」は、広く知られているMetasploitフレームワークなどの自動攻撃ツールを利用できる場合や、攻撃の成功に特別なエクスプロイトコードが不要な場合など、悪用される可能性が高いことを示します。
修正レベル(RL)—この脆弱性に対して、緩和策の適用や完全な修正がどの程度可能かを評価します。たとえば、脆弱性が適切に開示され、ベンダーが対応していれば、CVEの公開時には脆弱なコンポーネントをアップグレードできる状態になっているでしょう。値は、ベンダーがパッチまたはアップグレードによる正式な修正を提供している場合は「O」、ホットフィックスのリリースや回避策など、一時的な修正が利用可能な場合は「T」です。「W」は回避策が知られているものの、非公式でベンダーのサポート対象外の場合に適用されます。最後に「U」は、公開されている緩和策や修正がない場合を示します。
報告の信頼度(RC)—脆弱性レポートの信頼度を評価します。開示されたセキュリティレポートには、背景情報や概念実証などの裏付け資料、再現手順が十分に記載されていないことがあります。その場合、レポートの信頼性や影響をトリアージするのが難しくなります。値は、レポートを再現できる確度が高いことを示す「C」、レポートを確認するための妥当な情報が提供されていることを示す「R」、脆弱性の根本原因に関する詳細が不明であることを示す「U」です。
3つの時間的指標はいずれも「X」を割り当てることで、値を設定しないこと、および基本スコアに影響させないことを示せます。
CTFを始めよう
オンデマンドのバーチャル入門ワークショップで、CTFチャレンジの解き方を学びましょう。


