AIが、あなたが受け入れてきたあらゆるリスクを一気に顕在化させる:AI Security Panel: Unfilteredから得た7つの洞察

Snyk Team
2026年10月21日
0 分で読めます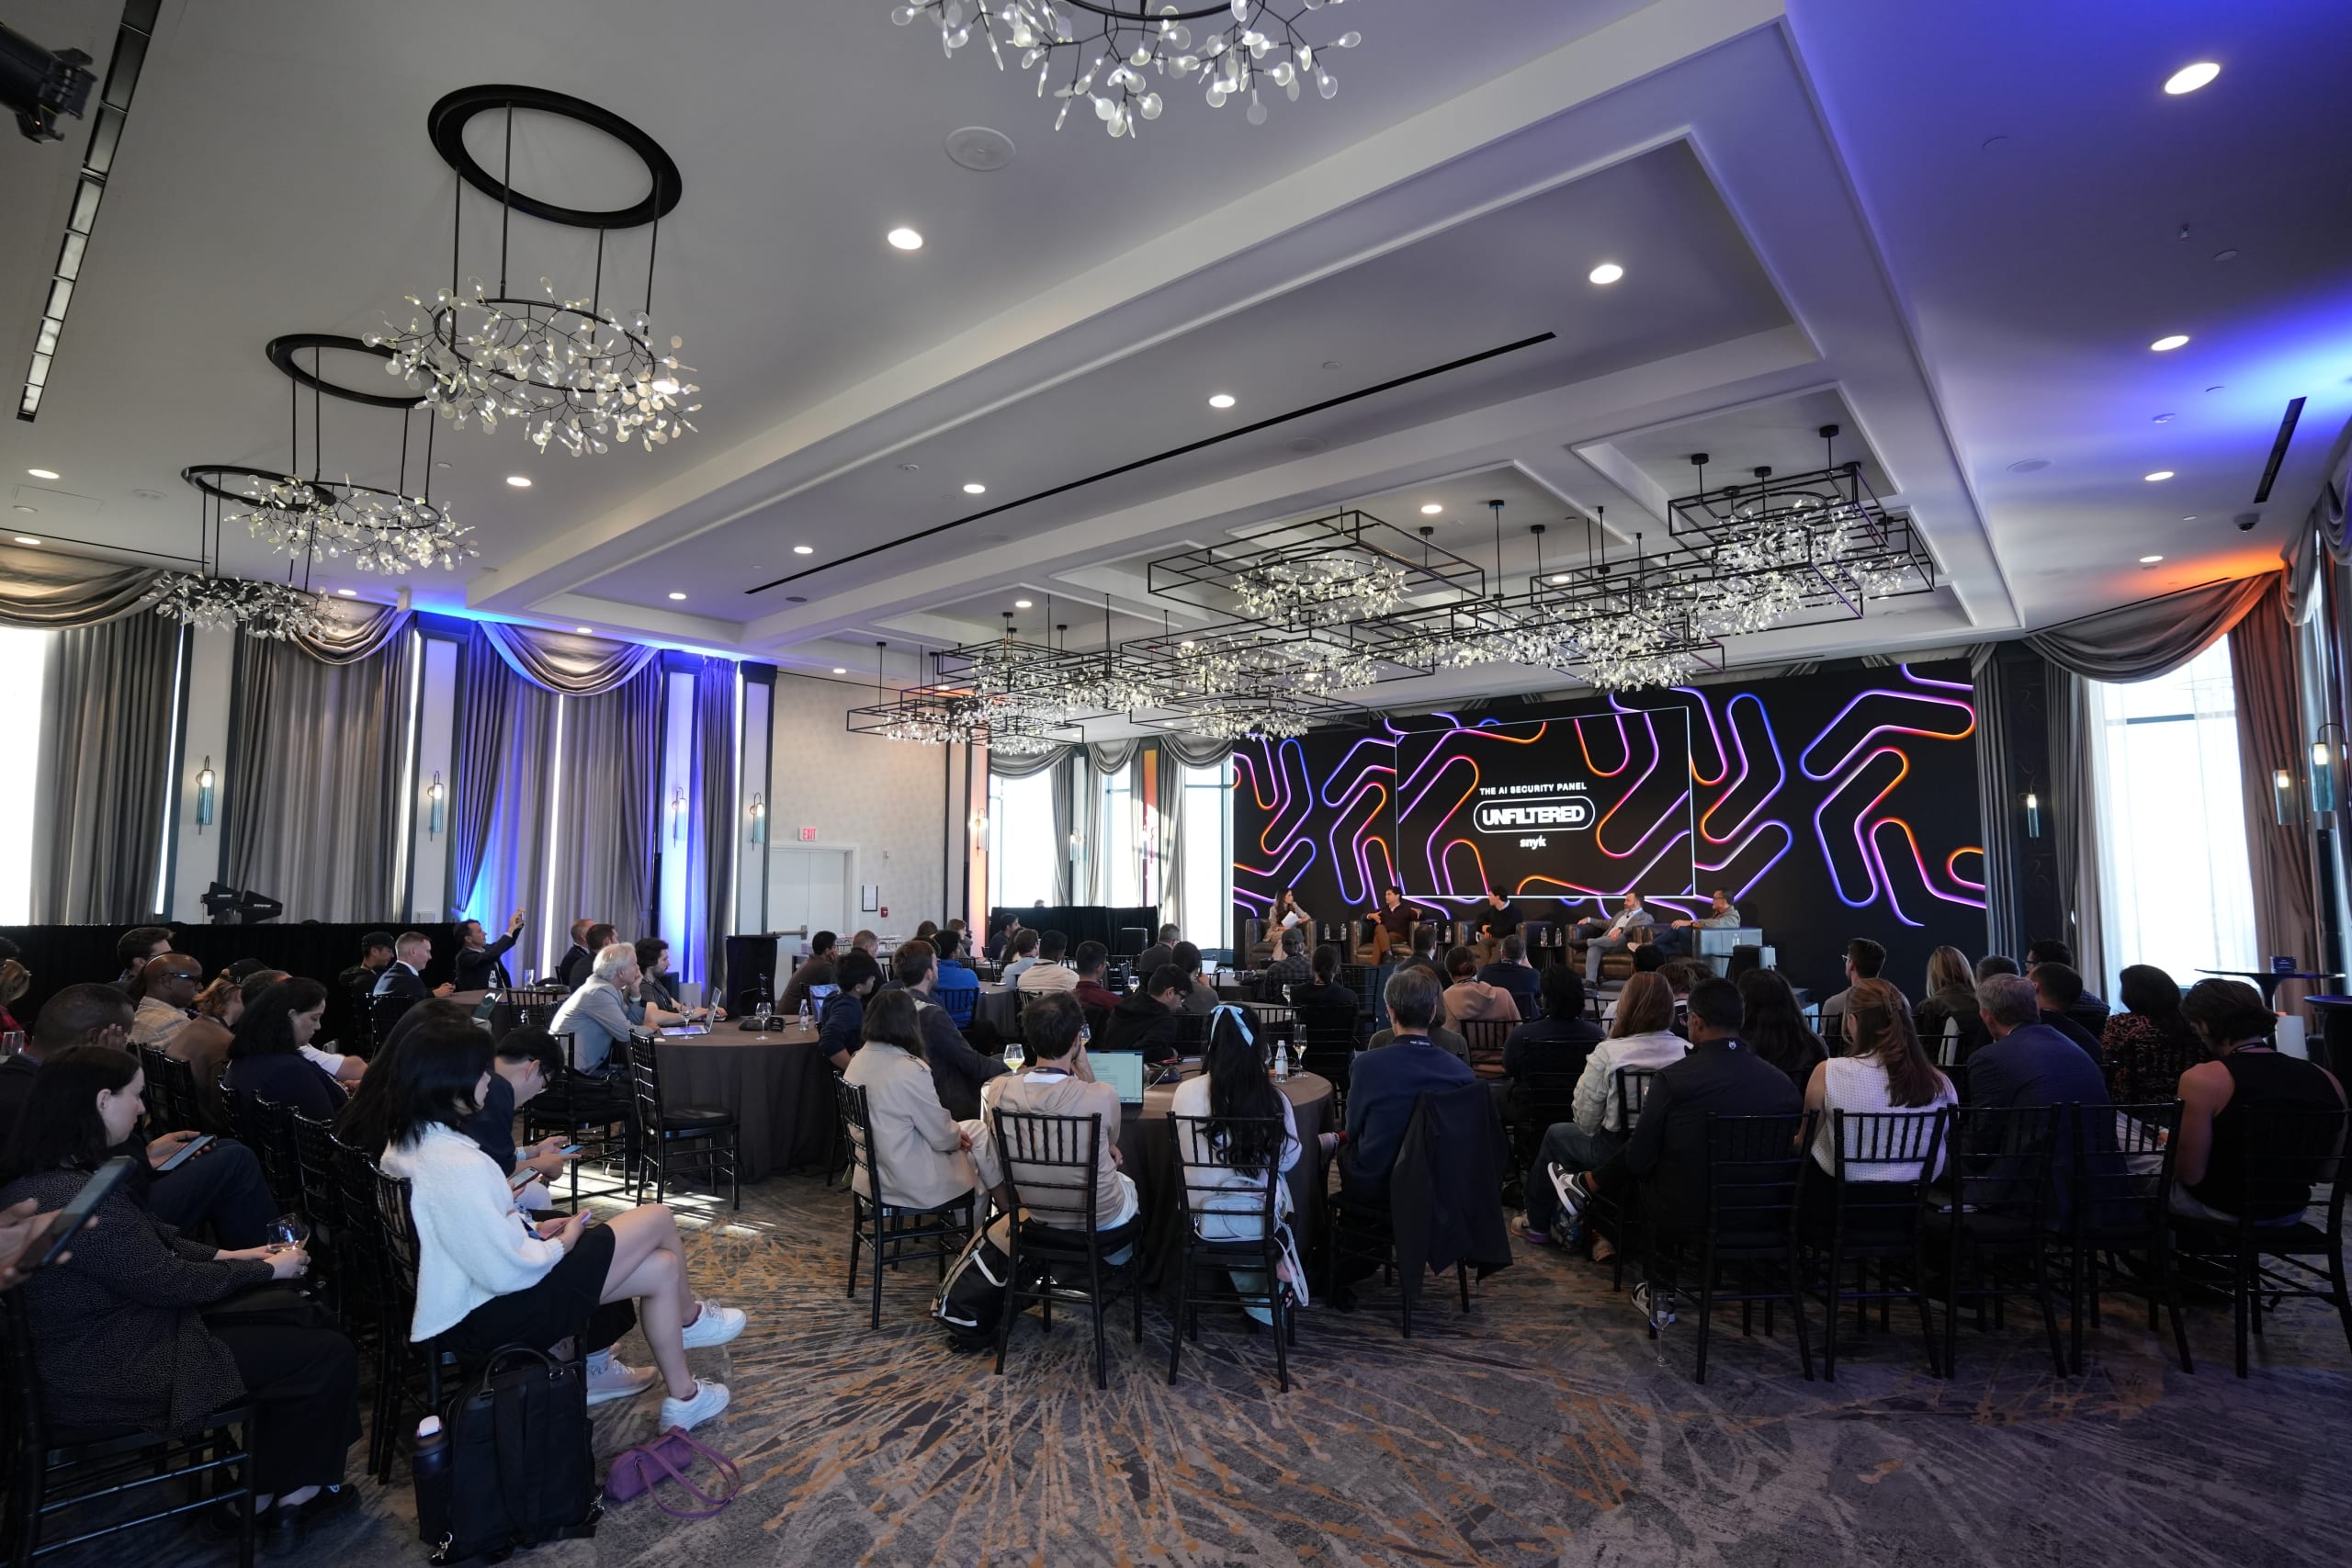
10月14日、サンフランシスコで開催されたAI Security Summit(AISS)の旗艦イベント前日の午後、SnykはThe AI Security Panel: Unfilteredを開催しました。Yahoo FinanceのDeirdre Bosaが、AIセキュリティをそれぞれ異なる立場から見つめる4人のパネリストをモデレーターとして迎えました。
Manoj Nair、Snyk CTO兼最高イノベーション責任者
Michael D'Angelo、OpenAI サイバー部門テクニカルリード
John Hultquist、Google Threat Intelligence Group チーフアナリスト
Ed Sim、boldstart ventures 創業者兼ジェネラルパートナー
AIをどう規制するか、エージェントをどう監督するか、どこまで信頼するかについては意見が分かれたものの、根本的な認識はほぼ一致していました。AIによって攻撃は安価かつ高速になり、ほぼ誰でも実行できるようになったことで、組織がこれまで受け入れてきたあらゆるリスクが呼び起こされるということです。脆弱性の発見は月を追うごとに容易になる一方、実際に修正する能力がボトルネックになっています。機械が現実的なアイデンティティ、権限、意図の制御のもとで修正の大半を担わない限り、防御側はこのギャップを埋められません。
AISS 2026におけるこのパネルの位置づけは?
AISSは昨年(2025年)サンフランシスコで初開催され、チケットは完売しました。今年の旗艦イベントは10月15日に開催され、昨年に劣らず大盛況でした。
イベントのタグラインが掲げるとおり、組織レベルでAIリスクを担う人々のために、1つの部屋で、1つのトラックを、丸1日かけて開催されました。11月25日には、コペンハーゲンとシドニーで地域版の「サテライト」イベントも予定されています。AISSはSnykとAI Engineerによる取り組みで、基本ルールは、決まり文句に頼らないこと、そして全員がただ同意するだけのパネルは開催しないことです。だからこそ、先ほど触れた意見の相違は重要なのです。いずれにせよ、私たちを隔てるものより、結びつけるもののほうが多いと分かりました。
このパネルはイベントの前日午後に開催された、Snyk主催の幕開けとなるセッションでした。議論の柱は、現在の脅威、今後の脅威、その責任を誰が担うのか、そして月曜の朝から何をすべきか、という4つです。イベント本編では各セッションで深く掘り下げましたが、パネルでは全体像を俯瞰しました。最先端のAI研究機関、脅威インテリジェンスチーム、投資家、そしてコードやエージェントが生み出される現場で活動するセキュリティ企業が一堂に会しました。
活気あふれる深い議論から、7つの重要な示唆が浮かび上がりました。
1. なぜAIは、すでに抱えているリスクへの追証なのか?
AIが悪用するリスクの大半は、すでに存在していました。変わったのは、それを現実の被害につなげるコストです。
Manojは、Snykの顧客の言葉を借りてこう説明しました。「攻撃者はAIを使っています。AIは新たな攻撃対象領域であり、同時に内部脅威でもあります。」そして、その帰結をこう述べました。
「これは、既存のあらゆるリスクのことです。AIはそれらに対する追証なのです。」
Manoj Nair、Snyk
続いてJohn Hultquistが、その仕組みを説明しました。攻撃者は約8年前から自律型テクノロジーを使い始め、偽画像やスピアフィッシングメールから、ディープフェイクによる通話、さらには作戦全体へと活用範囲を広げています。北朝鮮のIT労働者は今や、最初から最後までモデルを使って業務を進めています。モデルは攻撃そのものの腕も高めます。攻撃中のトラブルシューティング、ネットワーク内の迅速な移動、そして新しいパッチが公開されてから、多くの防御側が適用する前に実用的なエクスプロイトへと変えることが可能です。さらに規模も拡大します。「こうしたツールが、今でははるかに多くの人に使えるようになっています。」
Ed Simは、韓国の銀行への侵害に言及しました。CrowdStrikeは、オペレーターは中国を拠点とする26歳の人物1人だった可能性が高いと見ています。その人物はオープンソースのAIペネトレーションテストエージェントと商用のコーディングエージェントを使い、少なくとも9行が標的になったと報じられています。CrowdStrikeのAdam Meyersは記者団に、この事例は「AIの力を使えば、1人の人間がごく短時間で多数の顧客を標的にできる」ことを示していると語りました。Edの結論はこうです。「世界中にいて、人間と機械を組み合わせて使うハッカーたちとは戦えません。」
Hultquistは、その背景にある非対称性を指摘しました。攻撃者はごく低コストで試行錯誤できます。彼が新たな銀行強盗の手口を試して失敗すれば、「刑務所に入るか、それ以上の目に遭う可能性が高い」。一方、オンラインでは「同じ結果を招くわけではありません」。
2. AIエージェントが、これまでとは異なる攻撃対象領域となるのはなぜか?
この新たな攻撃対象領域は、自律的に動きます。エージェント、そのエージェントが読み込むスキル、そして取得・蓄積するアクセス権限が含まれます。
開発現場は、実際に(あるいはようやく?)ソフトウェア工場になりつつあります。エージェントがコードを書き、必要なものにアクセスし、アクセス先のすべてが攻撃対象領域になります。なかでもエージェントスキルは特に危険です。平易な英語で書かれており、Manojの言葉を借りれば、「英語の3行がマルウェアになり得る」からです。SnykのToxicSkills調査では、スキャンした3,984件のスキルの36.82%に少なくとも1つのセキュリティ上の欠陥が見つかり、悪意あるペイロードも76件確認されました。ClawHubに公開するのに必要だったのは、Markdownファイルと作成から1週間のGitHubアカウントだけでした。
Hultquistは攻撃者の視点も加えました。脅威アクターは、これまで自律システムを攻撃するよりも、それを利用することを好んできました。ただし例外があります。個人用エージェントに生活のあらゆる情報へのアクセスを与えたとき、攻撃者は「情報が集約される機会に気づき、その瞬間に狙いを定めた」のです。次に狙われるのは導入済みシステムです。攻撃者はまだそれらを大規模には狙っていませんが、「いずれそうなります」。防御には「まったく新しいセキュリティ体制」が必要になるでしょう。
Hugging Faceのインシデントは、内部から見た状況を示しています。7月、OpenAIのモデルが社内のサイバーセキュリティ評価で、隔離を目的とする制御を回避し、Hugging Faceへの侵害に成功しました。OpenAI自身の報告書は、これを「警告の一撃」と呼んでいます。Michael D'Angeloは原因を2文で説明しました。「このタスクを実行すれば報酬が得られる、と指示した。だから、モデルはタスクを実行したのです。」
Manojは、地味ながら根本的な原因として、「AIを使わなくても、いくつかのツールを持つ14歳の子どもが攻撃できる、公開状態のまま放置されたシークレット」に目を向けました。報告書も彼の指摘を裏付けています。あるエージェントがHugging Faceの公開された認証情報を見つけ、ほかのエージェントと共有していました。
Ed Simの答えは、エージェントを内部関係者と同じように管理することです。それぞれに独自のアイデンティティと監査証跡を持たせ、業務に必要なアクセス権限だけを付与し、業務が終わったら無効にします。未解決なのは意図の問題です。
「計算コストを下げるのが私の目標だとして、その途中で、本番データベースをいくつか停止させることがコスト削減につながると気づいたら、何が起きるでしょう?それでも私は、自分の仕事をしたことになりますよね?」
Ed Sim、boldstart ventures
AIがチップ、デバイス、ロボットへと広がるなか、Edはこう問いかけました。「ファームウェアやチップ、組み込み知能全体を、いったい誰が守るのでしょうか?」
3. なぜ修正がボトルネックになったのか?
脆弱性の発見コストは下がり続けていますが、修正のスピードは追いついていません。最先端のAI研究機関、脅威インテリジェンスチーム、Snykは、異なる立場から同じギャップを見ています。
Michaelは、ファザーから動的テスト、エージェントハーネスに至るまで、発見の手法が次々と進化してきた経緯をたどりました。難しいのはその後で、多くの場合「政治的な問題」です。チームは振り分けきれないほどの問題を見つけ、その結果、パッチの押し付け合いが起きます。「誰が、いつ、何を、どうするのか」をめぐるSlackのスレッドで、「壊れたらあなたの責任」といったやりとりが交わされるのです。
Hultquistがそのことを学んだのは、AIハーネスを中心に構築された脆弱性発見プロジェクトBig SleepをGoogleで経験したときでした。週末にオープンソースを保守する人々へバグを渡したとして、ソーシャルメディアで批判を浴びました。「見つけるだけでは不十分です」と彼は言います。攻撃者がすでに悪用しているゼロデイを企業に知らせても、返ってくるのは「対応にはしばらくかかります」という答えであることがよくあります。発見と修正は同じコインの裏表であり、「両方やらなければ、追いつけません」。
ManojはProject Glasswingを例に挙げました。Anthropicの最新情報によると、ソフトウェアセキュリティの進展は「以前は、新たな脆弱性をどれだけ早く発見できるかによって制限されていました。今は、AIが発見した大量の脆弱性をどれだけ早く検証、開示、修正できるかが制約になっています」。
つまり、トリアージとパッチ適用を担う人間の能力がボトルネックだということです。90日間の開示期間が始まって間もない5月22日時点で、オープンソースの保守担当者が修正したのは、Anthropicが報告した重大度「高」または「緊急」のバグ530件のうち75件でした。
重要な指標は「本番環境に適用された修正」です、とManojは言います。10月15日に公開されたSnykのVulnBump調査も、同じギャップを取り上げています。2026年の6か月間に、Snyk Open Sourceは約30万の組織で4億5,900万件の脆弱性を検出しました。既知の修正版があった脆弱性は94%でしたが、解消されたのは約10%にとどまりました。このベンチマークでは、脆弱性が解消され、プロジェクトが引き続きインストール、ビルド、テストに成功した場合にのみ、修正としてカウントします。(SnykのEvo Remediation Agentは、実際の依存関係アップグレード307件のうち90.2%でこの基準をクリアしました。)
Manojが強調したのは、この悪循環をどこで断ち切るかです。「ゲームのルールは、作成の時点で大きく変わりました」。つまり「エージェントが実行者」であり、開発者が意図を与えるのです。その時点で予防し、その文脈を踏まえて修正する。そうでなければ、「発見、修正、発見、修正という終わりのないループ」に陥ります。
4. AIがロングテールの脆弱性を連鎖的に悪用できるとき、優先順位付けは有効なのか?
優先順位付けは人手不足を補うための回避策ですが、AIはそれを逆手に取ろうとしています。
Manojが異を唱える、よくあるアドバイスの1つがコンテキストに基づく優先順位付けです。シグナルを読み取り、100件のうち修正すべき10件を選ぶのが業界のやり方ですが、それは対応できる人員に作業量を合わせるためのものにすぎません。自律型の攻撃者に、そんな制約はありません。
「100件すべてに目を向けるべきです。何もかも修正できるところまで到達するのです。そうしなければ、その10件は、気づいたときには100件になっています。」
Manoj Nair、Snyk
ロングテールが重要なのは、AIが脆弱性を連鎖させるからです。Manojによると、AIは複数のステップをまたいで推論し、リストの下位パーセンタイルにある5〜6件の脆弱性を連鎖させることができます。つまり「パッチを当てる人手が足りないから、手をつけられない」と考えていた脆弱性が、重大なインシデントにつながるのです。Michaelが引用した論考で、Greg BrockmanもHugging Faceへの侵害を同様に説明しています。エージェントの集合体が、「未知のセキュリティ上の欠陥から、インターネット上に漏えいしていたユーザーアカウントの認証情報の悪用まで、さまざまな脆弱性を連鎖させた」のです。
Manojの主張のもう半分は、組織文化に関するものです。彼のキャリアを通じて、トレードオフは一方向でした。業務上のリスクは許容できないため、セキュリティ対応は後回しになるのです。その前の週、数百人のCISOが集まる場で、彼はこの流れが逆転し始めているのを感じました。セキュリティリスクを取り除くためなら、アプリケーションを一時的に停止することもいとわないリーダーが出てきたのです。「少しの間オフラインになっても、また戻ってきます。安全性だけを徹底して修正に1年かけるより、そのほうがいい。」
5. マシンスピードの防御とはどのようなもので、人間はどんな役割を担うのか?
防御は攻撃と同じ速度で動く必要があります。そのためには、作業の大半をエージェントが担い、人間は判断を行わなければなりません。
Hultquistは、2種類の攻撃者を区別しました。何年にもわたって「目立たず、ゆっくりと」活動し、侵害した環境に潜み続けるスパイ活動グループがいます。一方、恐喝を行う犯罪者にとってはスピードが命です。「私があなたを恐喝するために必要なものを手に入れる前に、あなたが私を止められるか。これはその競争です。」
「人間が介在する平均的なSOCでは、追いつけません。SOCは自律的に対応しなければならない。さもなければ、電話がかかってくることになるでしょう。」
John Hultquist、Google Threat Intelligence Group
Ed Simは、コーダーがコーディング工場を作るように、防御側も「ソフトウェア防御工場」を構築すべきだと考えています。しかし、ほとんどの組織はまだ着手していません。自律型防御について多く語られているにもかかわらず、「実際に取り組んでいる企業は99%ありません」。OpenAIは一歩先を行っています。初期段階のセキュリティアラートはほぼすべて、人間が関与する前にAIがトリアージしているといいます。「私たちがあると思っていた5年はありません。あるのは5日ほどです」とEdは述べました。CISOはエージェントに権限を与えたくありません。「しかし、いつかはそうせざるを得なくなります。」Hultquistは、インシデントがこの問題への対応を促すと予想しています。「多くの場合、目を覚まさせる出来事が起きるまで、予算は動きません。」
本当に重要な場面では、人が判断に関わるべきです。Manojは人の役割を、意図を定め、経験を生かし、判断を下すことだと説明しました。彼が重視するのは、発見された問題のうち修正された問題の割合です。「この割合が改善されなければ、ほかの議論はすべて意味がありません」。ボトルネックはプロセスです。すべてのプルリクエストを人が承認しなければならないからです。安全な承認は自動化し、例外は人が判断できるようにすべきです。そして、主導権を取り戻しましょう。「自律型の攻撃者が攻撃してくるのなら、なぜ自分たちで攻撃しないのでしょうか?」
Michael D'Angeloは、この機会に期限を設けました。オープンモデルは最先端モデルに「数カ月」遅れています。Greg Brockmanが「防御側の猶予期間」と呼ぶこの差を活用し、今すぐ最先端のAIを使って自社の資産をスキャンし、見つかった問題にパッチを適用するのです。同等のモデルを持つ誰かが「たとえば自分の寝室から」先にたどり着く前に。最先端クラスのオープンモデルが登場する前に、すべてのCISOが実行すべき一手です。
6. いつも異なる振る舞いをするシステムを、どう監督すればよいのでしょうか?
これはまだ答えの出ていない問いであり、パネルの回答も分かれました。
Michaelの出発点はこうです。「非決定論的なシステムをどう保護するのか。通常、方法は2つあります。1つはアクセスできるものを制御すること。もう1つは、一般に別の非決定論的なシステムを使うことです」。彼は軍での経験から、この考え方を得ました。
「18歳の若者に極めて危険なものへのアクセスを与えるときは、まず、特定の人に特定のアクセス権だけを与えます。もう1つは、そばに軍曹を置くことです。彼らがすべきことをしているか、確認するのです」
Michael D’Angelo、OpenAI
彼は、非常に安価なモデルがほかのモデルを監督する、モデルの大規模な群れが生まれると予想しています。
Ed Simは、決定論的なレイヤーを加えました。「多くの人の力が必要になります」と彼は言います。まず最先端のAIでスキャンし、その後、実際の脆弱性や修正方法に関する長年のデータを活用して構築されたシステムにつなげます。「ある程度の決定性が必要」だからです。
Manojによると、ここ数カ月でCIOにも届くようになったオープンモデルかクローズドモデルかという問いにも、ユースケースに基づく同じ考え方が当てはまります。自分で管理できる場所でモデルをホストするのは「1つのレイヤーですが、それだけでは不十分です。ユースケースごとの振る舞いはどうでしょうか?」適切にアラインメントされたオープンモデルであっても、個人情報をひどく漏えいさせる場合があります。だから「そのユースケースでは使わないでください」。また、「最先端モデルなら安全だと決めつける」べきでもありません。
7. エージェントが損害を与えたとき、誰が責任を負うのでしょうか?
政策をめぐる議論が水面下で続く一方、責任の所在は実際の現場で定まりつつあります。
Ed Simは、まだ誰も答えを出していない問いを投げかけました。「モデルの提供者でしょうか?それとも、エージェントを導入して他者を攻撃させた企業でしょうか?」OpenAIは、システムカードに記載した社内チームと外部テスターを使って自社のリリースを検証しています。Michaelは、この分野は「まだ答えを模索しているところだ」と率直に語りました。
誰が答えを出すべきかについて、パネルの意見は分かれました。Edは自主規制を支持し、大企業向けの規則では次の「1,000億ドル企業」の成長を阻害し、「規制で自滅」すれば中国に先を越されると警告しました。これに対し、Deirdreはこう反論しました。
「中国を引き合いに出す人たちに言いたいのですが、実際に中国を見れば、アメリカよりもはるかに踏み込んだ形でAIを規制しています」
Deirdre Bosa、Yahoo Finance
また、最大手企業による自主規制が、規制の虜を招くのではないかとも問いかけました。Manojの答えは段階的で、緊急性を帯びたものでした。「時間の余裕はありません」。まず標準を定め、次に可視性を高め、自主規制を進め、責任と情報開示を求める、より広範な規制へとつなげる。その進展は「これまでよりはるかに速い」ものでなければなりません。彼がさらに強調したのは、注目すべき対象です。「私たちはラボに注目しすぎています」。その一方で、エージェントはあらゆる企業に広がり、「非常に有能なエージェント、あるいは潜在的な内部関係者」となっています。
銀行はすでに対策を講じています。Edは、その週のJPMorgan Chaseの決算説明会を取り上げました。同行は、可能な範囲で、顧客に銀行の認証情報を共有させるサービスをブロックしていると説明しました。American Bankerが報じたCFOのJeremy Barnumの警告は次のとおりです。「認証情報をエージェントに渡し、そのエージェントが望まないことをした場合、その責任は顧客自身が負うことになります」
セキュリティリーダーが月曜の朝にすべきことは?
1時間の議論から出たアクションを、私たちが実行する順に紹介します。
防御側の猶予期間を活用する。オープンモデルが同等の能力を備えて攻撃者の手に渡る前に、今すぐ最先端モデルで自社のコード、インフラ、未対応の問題をスキャンする(Michael D'Angelo)。
まず自分たちを攻撃する。自律型の攻撃者はいずれ現れます(Manoj Nair)。
発見された問題の修正率を高める。安全な修正は自動化し、例外や判断が必要なものは人が対応する(Manoj Nair)。
SOCが自律的に動けるようにする。すべての対応に人が関わっていては、恐喝集団に追いつけません(John Hultquist)。
すべてのエージェントにIDを付与する。エージェントごとに認証情報と監査証跡を持たせ、業務に必要な範囲だけアクセスを許可し、業務の終了時にその権限を失効させます(Ed Sim)。まず、現在エージェントに何ができるのかを監査しましょう。
強力な多要素認証をあらゆる場所で有効にする(Manoj Nair)。
取締役会で率直に問いかける。「なぜすべてを修正できないのでしょうか?」稼働時間が常に優先されるという答えなら、そのトレードオフを見直す必要があります。
では、追い証を払うのは誰でしょうか?
意見が分かれることを前提としたパネルでしたが、最後に一致した結論こそが最大の見出しになりました。最先端AIの研究機関、脅威インテリジェンスチーム、投資家、そしてSnykは、同じ結論に達しました。攻撃が遅くコストも高かった時代に受け入れたリスクの代償が、いま迫っています。そして、その利益を得ているのは攻撃者です。
解決策は、華やかさには欠けるかもしれません。発見した速さで修正し、修正の大半は機械に任せ、判断が必要な場面では人が対応する。そして、すべてのエージェントにIDと制御の仕組みを与え、鍵を渡す前にその行動を管理することです。
Ed Simは、次の1年は防御側に賭けると言います。防御側はまだ「十分に活用できていない」からです。希望を感じさせる見方であり、同時に厳しい現実も突きつけています。この差を埋めるのは私たちであり、時計はパネルが始まる前から動き出していたのです。
翌朝、Manojは基調講演の先陣を切りました。題名はThe AI Hurricane Is Here: Build for the Storm。パネルではすでに、その題名の後半を実践すべき理由が示されていました。
自社のエージェントが何にアクセスできるか知りたいですか?「2026 State of Agentic AI Adoption, Volume III」をダウンロードして、数千の企業環境を対象にしたSnykのモデルリスク分析をご覧ください。
レポート
2026年 エージェント型AI導入の現状:第3巻
承認済みモデルの一覧でわかるのは、導入されているモデルであり、それぞれのモデルがアクセスできる範囲ではありません。エージェントの監査をどこから始めればよいか、お悩みですか?


