AIが攻撃対象領域を広げています。テストしていますか?

2026年3月19日
0 分で読めます市場には主張があふれています。あるベンダーはランキングで首位を獲得し、別のベンダーはプレゼン資料を武器に巨額の資金を調達しています。その一方で、開発者は昼食前にAI生成のサービスを3つリリースしました。業界で語られていないこと、そして私たちが何年もかけて取り組んできたことについて、お話しします。
今、あらゆるセキュリティチームの中で、こんなやり取りが交わされています。
誰かがAIコーディングアシスタントのデモを見せる。その速さは明らかで、チームは感嘆します。それでも、慎重さや懐疑心は残ります。
以前なら1スプリントかかったコードが、午後のうちに完成します。経営陣は大いに期待を寄せています。この時代を生き抜く開発者たちも同じです。そしてセキュリティチームは、正直に言えば、これから起きることに今のツールが対応できるのか、ひそかに不安を感じています。
ナレーター:対応できません。
誰も語りたがらないベンチマーク
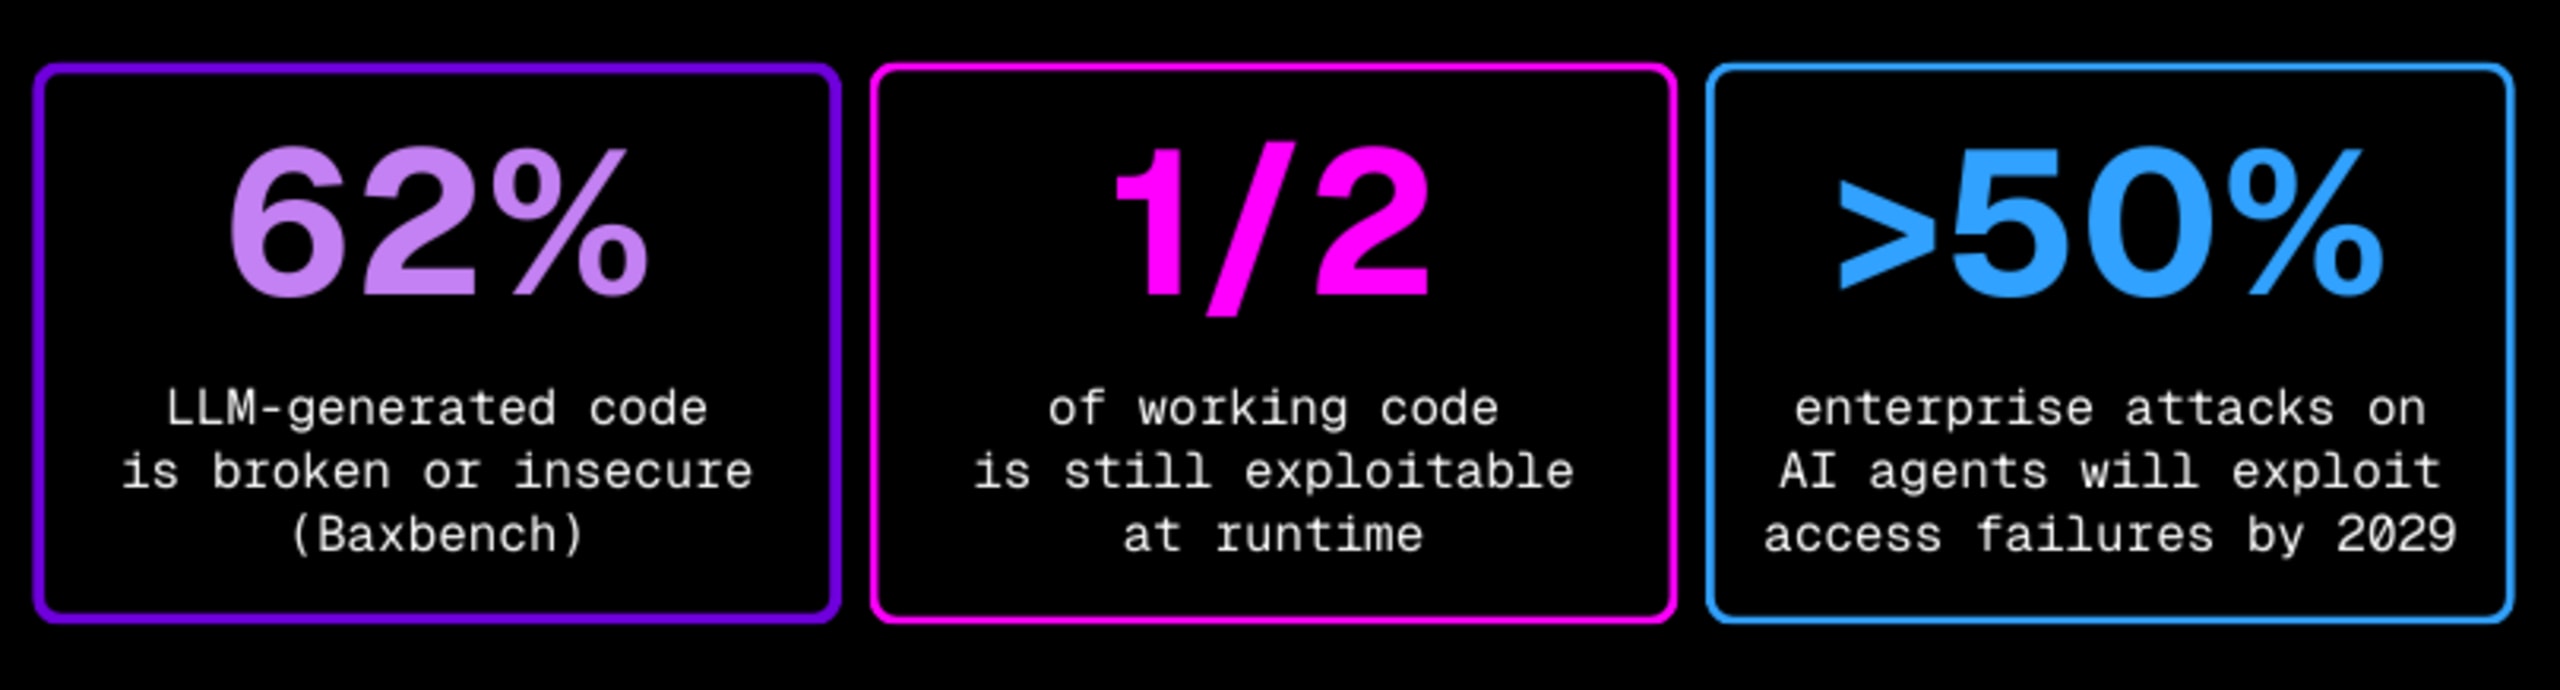
BaxBenchは脅威レポートではなく、測定結果です。研究者が実際のタスクを使ってLLM生成のバックエンドコードを評価したところ、62%が動作しないか、安全ではありませんでした。正しく動作するコードでも、およそ半数には依然として悪用可能な脆弱性がありました。
もう一度読んでください。AIが動くコードを書いても、その半分は依然として悪用可能です。
だからといって、AIコーディングアシスタントの利用をやめるべきだということではありません。もう後戻りはできません。コード生成の速度が恒久的に上がった世界で、「安全」とは何を意味するのかを正確に捉える必要があるということです。
作成時点での静的解析は、IDE内のSASTツールであれ、開発プロセスにおけるAI支援のセキュリティガイダンスであれ、必要な第一歩ですが、ゴールではありません。コードに何が含まれているかはわかっても、悪意ある攻撃者が悪用するように、そのコードが実際に悪用可能かどうかまではわかりません。汚染解析とLLMの推論を組み合わせた最新のマルチモーダルな静的解析手法でも、コードが悪用される可能性を予測することしかできません。実際の攻撃条件下でのランタイムの挙動を証明することはできないのです。
そのためには、実際の攻撃者と同じように、実行時に外部から探りを入れる必要があります。
誰も把握していない第2の攻撃対象領域
業界がAI生成コードのセキュリティについて議論する一方で、もう一つの攻撃対象領域が静かに形作られていました。
AIエージェントは単独では動きません。API、とりわけ高い権限を持つAPIを呼び出します。その中には文書化されていないものも少なくありません。自律的かつ大規模に呼び出されることを誰も想定していなかった時代に構築されたAPIです。Gartnerは、2028年までにAIエージェントがエンタープライズAPIの主要な利用者になると予測しています。2029年までにAIエージェントへの攻撃が成功したケースの50%超で、アクセス制御の不備(BOLA/IDOR)が悪用されると予想されています。これは、静的解析では従来検証が難しかった脆弱性の種類そのものです。
これは大胆な予測ではありません。組織がすでに下したアーキテクチャ上の決定を説明しているにすぎません。
BodySnatcherは、その現実を具体的に示しました。CVE-2025-12420では、攻撃者は認証を受けることなく、標的のメールアドレスだけでServiceNow管理者になりすまし、MFAとSSOを回避し、AIエージェントのワークフローを実行し、すべての権限を持つバックドアアカウントを作成できました。社会保障番号、金融記録、機密知的財産。すべてが格好の標的となり、すべてがさらされていました。
手口は難解なものではありませんでした。ゼロデイ脆弱性も、巧妙なプロンプトインジェクションもありません。組織が全面的に信頼していたエージェントの背後に、未テストの脆弱性が潜んでいたのです。研究者の結論は明快でした。「AIエージェントは、従来のセキュリティ上の欠陥がもたらす影響を大幅に増幅する」。
デリバリーの速度が検証を追い越しました。だからといって、開発を遅らせるわけにはいきません。テストの意味そのものを根本から変える必要があります。
新たな脆弱性が生まれたわけではありません。従来から見極めが難しかった同じ脆弱性が、新しいアーキテクチャによって増幅されているのです。
実は、これは一つの問題です
この2つの問題を別々に扱うと見落とされがちなことがあります。どちらも根本原因は同じです。デリバリーの速度が、検証を完全に追い越してしまったのです。AIコーディングアシスタントは、これまでのどんなセキュリティプロセスでも対応できない速さでコードを生成します。AIエージェントは、どんなインベントリでも追跡できない速さでAPIを呼び出します。どちらの場合も、本番環境で動いているものが体系的な攻撃を一度も受けていません。レビューもスキャンもされていない、実際の悪意ある攻撃者がするような「攻撃」を受けていないのです。
私たちは、開発を遅らせることが答えではないと考えています。テストの意味そのものを変える必要があるのです。
ダイナミックテストは、AI以前の古い時代の遺物ではありません。AI時代がまさに必要とする規律です。AI以後の世界では、土台となる、なくてはならない基盤になります。
ですから、問うべきなのはダイナミックテストを行うべきかどうかではありません。今、本番環境で稼働しているもの、つまりAI生成のコード、AI生成の速度、そして人間のインベントリでは追跡できない速さでエージェントが呼び出すAPIに、ダイナミックテストが十分にインテリジェントで、追いつけるかどうかなのです。
最新のダイナミックテストには、それ自体にAIを活用する必要があります。パイプラインに適した速度を備え、実際に悪用可能な脆弱性とノイズを見分ける知能を持ち、わずか2年前には存在しなかった攻撃対象領域に特化して設計されていなければなりません。
ノイズではなく、有用なシグナルを
AI生成コードが大規模に使われることで生じる本当の問題は、コードが増えるだけではありません。検出事項やアラート、対応が必要に見えるものも増えていきます。それらすべてが、ずっと開発のペースが遅かった時代に設計されたセキュリティツールを通過する様子を想像してみてください。
開発者はノイズに埋もれ、どこに時間をかけるべきかを自分で判断することになります。その判断は多くの場合、直感や経験年数、あるいは常につきまとう納期のプレッシャーに左右されます。
アラート疲れ自体は新しい問題ではありません。しかしAIコーディング時代には、状況がさらに悪化します。開発者はもう、1スプリント分の検出事項をレビューしているのではありません。チームが丸1四半期かけて書く量の成果物をレビューしているのです。すべての検出事項が同じ重要度なら、何も修正されません。確信を持って修正することもできません。
相関付けを導入すると、状況が変わり始めます。静的解析とダイナミックテストの検出結果がまったく同じ根本原因を示したとき、つまりコードが脆弱性を示し、ランタイムテストがその悪用可能性を証明したとき、優先順位付けが必要な問題は2つではなくなります。開発者が信頼できる、確度の高い1つの修正になります。
ノイズは収まり、シグナルは明確になります。
AI時代には、これまで以上にこの精度が重要です。誤検知率0.08%は、製品仕様の数字ではありません。セキュリティが開発者の負担ではなく、開発を加速させる力になったときの姿です。AIがコードを書き、何が本当に問題なのかを検証し、開発者は不安から速度を落とすことなく、確信を持ってリリースできます。
✔️ LLMを活用したSASTで、IDEやパイプライン上でAI生成コードのパターンと関連リスクを今すぐ特定
✔️ 実行中のアプリケーションとAPIを積極的に探査し、実際の悪用可能性を検証するインテリジェントなDAST。特にBOLA、IDOR、エージェント特有の認可不備に対応
✔️ 静的解析のシグナルとダイナミックテストによる確認結果を対応付け、トリアージのキューではなく、優先順位付けされた1つの修正を提示
✔️ 文書化されていないものも含め、AIエージェントが自律的に呼び出しているエンドポイントを明らかにするAPI検出
✔️ 四半期ごとの診断ではなく、デリバリーパイプラインに組み込まれた継続的なカバレッジ
AIペネトレーションテストとは(あるいは、どうあるべきか)
今、多くのベンダーが「AIペネトレーションテスト」という言葉を使っています。LLMを使って攻撃ペイロードを作成するだけのベンダーもあれば、「エージェント」で検出レポートを生成するベンダーもあります(エージェント性という概念には、私たちも疑問を感じています)。その中で、もっと興味深いものを意味しているのは、ごくわずかです。
この分野が実際に求めるもの、特にAI時代がまさに求めるものは、AI生成コードに潜むAI特有のロジック上の欠陥をテストし、エージェントが呼び出すAPI(文書化されていないものも含む)を追跡し、ダイナミックテストの検出結果をコードレベルのコンテキストやインテリジェンスと関連付けてシグナルとノイズを見分け、これらすべてを一度限りの断片的な作業ではなく、継続的に行えるアプローチです。
これは機能一覧やロードマップにすべきものではありません。標準であるべきです。しかし、業界はいまだにその標準をうまく言語化できていません。だからこそ、今がそれを実現する時なのです。私たちは実現します。
私たちは何年もかけてこの標準の実現に取り組んできました。お客様の本番環境で得られている成果が、このアプローチの有効性を裏付け続けています。
AI時代にふさわしいセキュリティテストは、より多くの問題をより速く見つけるだけではありません。静的な予測と動的な検証結果を関連付け、開発者が不安ではなく確信を持ってリリースできる修正を提示します。
AIセキュリティをめぐる議論は、互いに無関係とされる2つの問いに支配されてきました。AIモデルを安全にできるのか。そして、AIを使って脆弱性を見つけられるのか。どちらも正当な問いですが、単独では十分ではありません。
もっと差し迫った問いは、よりシンプルです。AIが構築し、実行しているコードやAPIを、誰がテストし、攻撃しているのか?
その答えがあなたでなければ、誰か、あるいは何かが必ずやるでしょう。
Snyk API & Webに登録
開発者ファーストのDASTエンジンを今すぐ使い始めましょう
SnykのAI駆動型DASTエンジンで、脆弱性を大規模に自動で検出・可視化。自動化と修正ガイダンスにより、SDLCにシームレスに統合し、開発の早い段階からセキュリティを確保できます。


