Play Video: 10 BEST Practices for Securely Developing with AI
今や、 AIが 開発者の アプリケーション開発を 強化する うえで、 欠かせない ツールと なり、 避けて 通れない 存在に なった ことは 誰もが 痛感しています。 組織が 開発者に よる AIツールの 利用を 制限していても、 VPNや 個人アカウントを 使って 回避していると いう 話を よく 耳に します。
AI技術に 慣れ、 受け入れるまでに どれほど 時間が かかると しても、 AIを 安全に 利用する ことが 欠かせません 。 この 記事では、 AI支援アプリケーションや AI支援開発に 加え、 AIを 活用した 生産性の 高い ソフトウェア開発の ための 一般的な ヒントを 取り上げ、 安全な AI開発の ベストプラクティスを ご紹介します。 開発者と セキュリティ担当者が、 AIの メリットを 最大限に 活用しながら、 潜在的な リスクを 効果的に 軽減できるように する ことが 目的です。
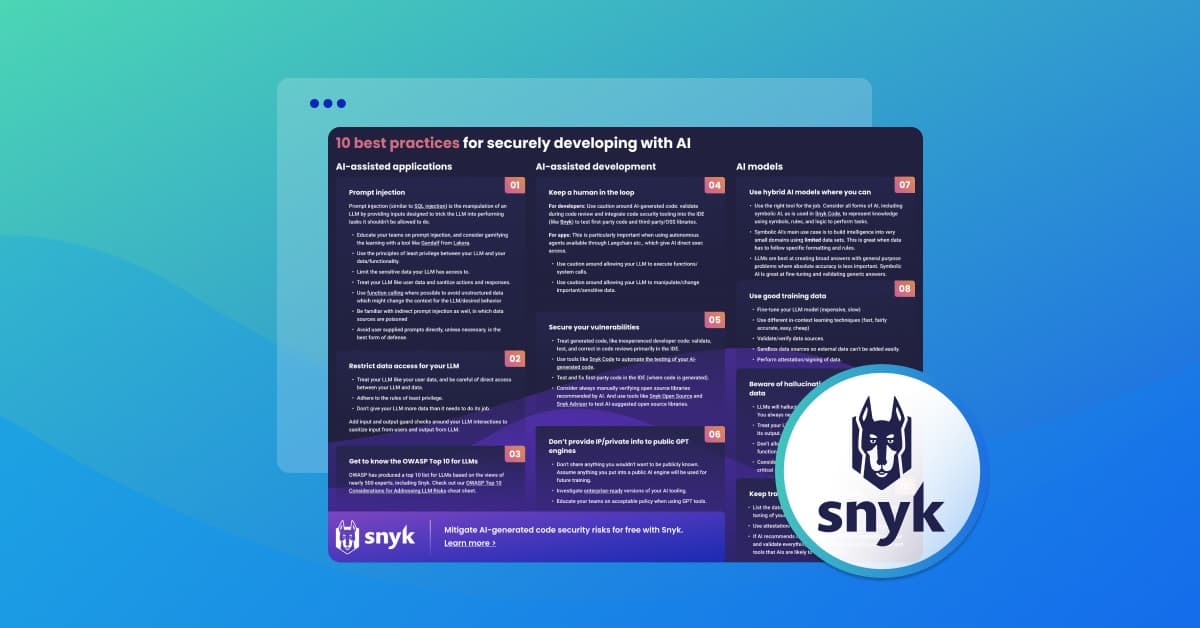
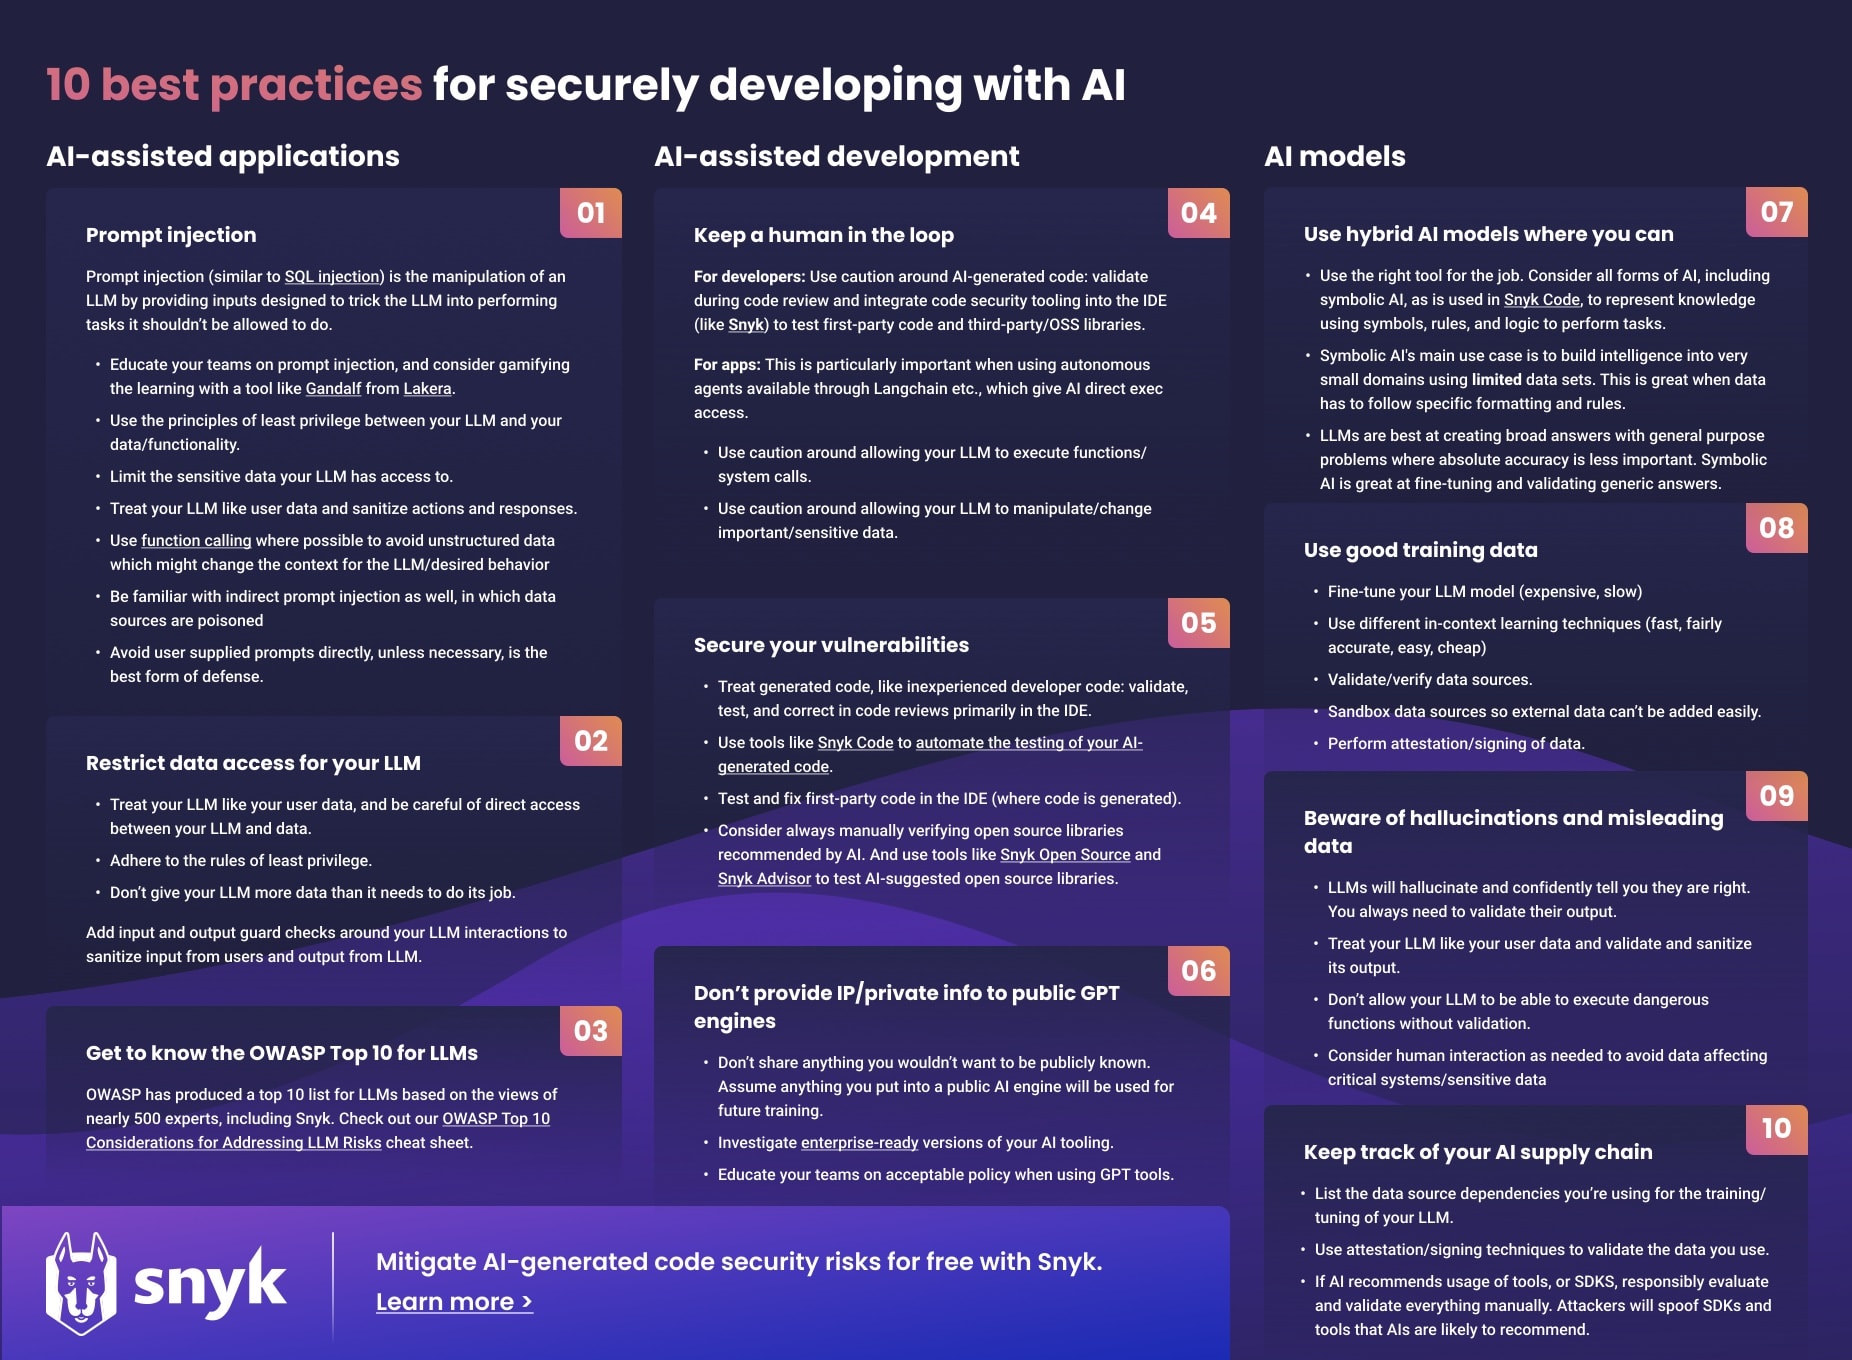
まずは、 すべての ヒントを 1ページに まとめた チートシートを ご覧ください。 印刷して ワークステーションの 横に 置いたり、 冷蔵庫に 貼ったり、 年末年始や 誕生日、 お見舞いの カード代わりに 誰かに 贈ったりしましょう。 どういたしまして!
チートシートをクリックしてPDFをダウンロード
AI支援アプリケーション AI支援アプリケーション とは、 アプリケーション自体が AI技術を 活用し、 その 機能を ユーザーが 利用できる ものを 指します。 身近な 例と しては、 アプリケーションに 組み込まれた、 個性ゼロの AIロボットを 搭載した チャットボットが、 ユーザーの 質問に 答える ケースが あります。
1. 直接的・間接的なプロンプトインジェクションに注意する 大規模言語モデル (LLM)を 組み込んだ アプリケーションで 新たに 大きな 懸念と なっているのが、 ユーザー向け機能を 通じて アプリが プロンプトインジェクション の 危険に さらされる ことです。 これは、 攻撃者が AIシステムに 悪意の ある 入力を 注入し、 システムの 出力を 操作しようとする 攻撃です。 AIが 予期しない 動作を したり、 機密情報を 漏えいしたりする 可能性が あります。 たとえば、 ユーザーを サポートする AIチャットボットを 考えてみましょう。 攻撃者は 入力を 操作し、 チャットを 動かす AIに 対して、 他の ユーザーの 機密情報に アクセスする 権限が あると 思い込ませようとするかもしれません。
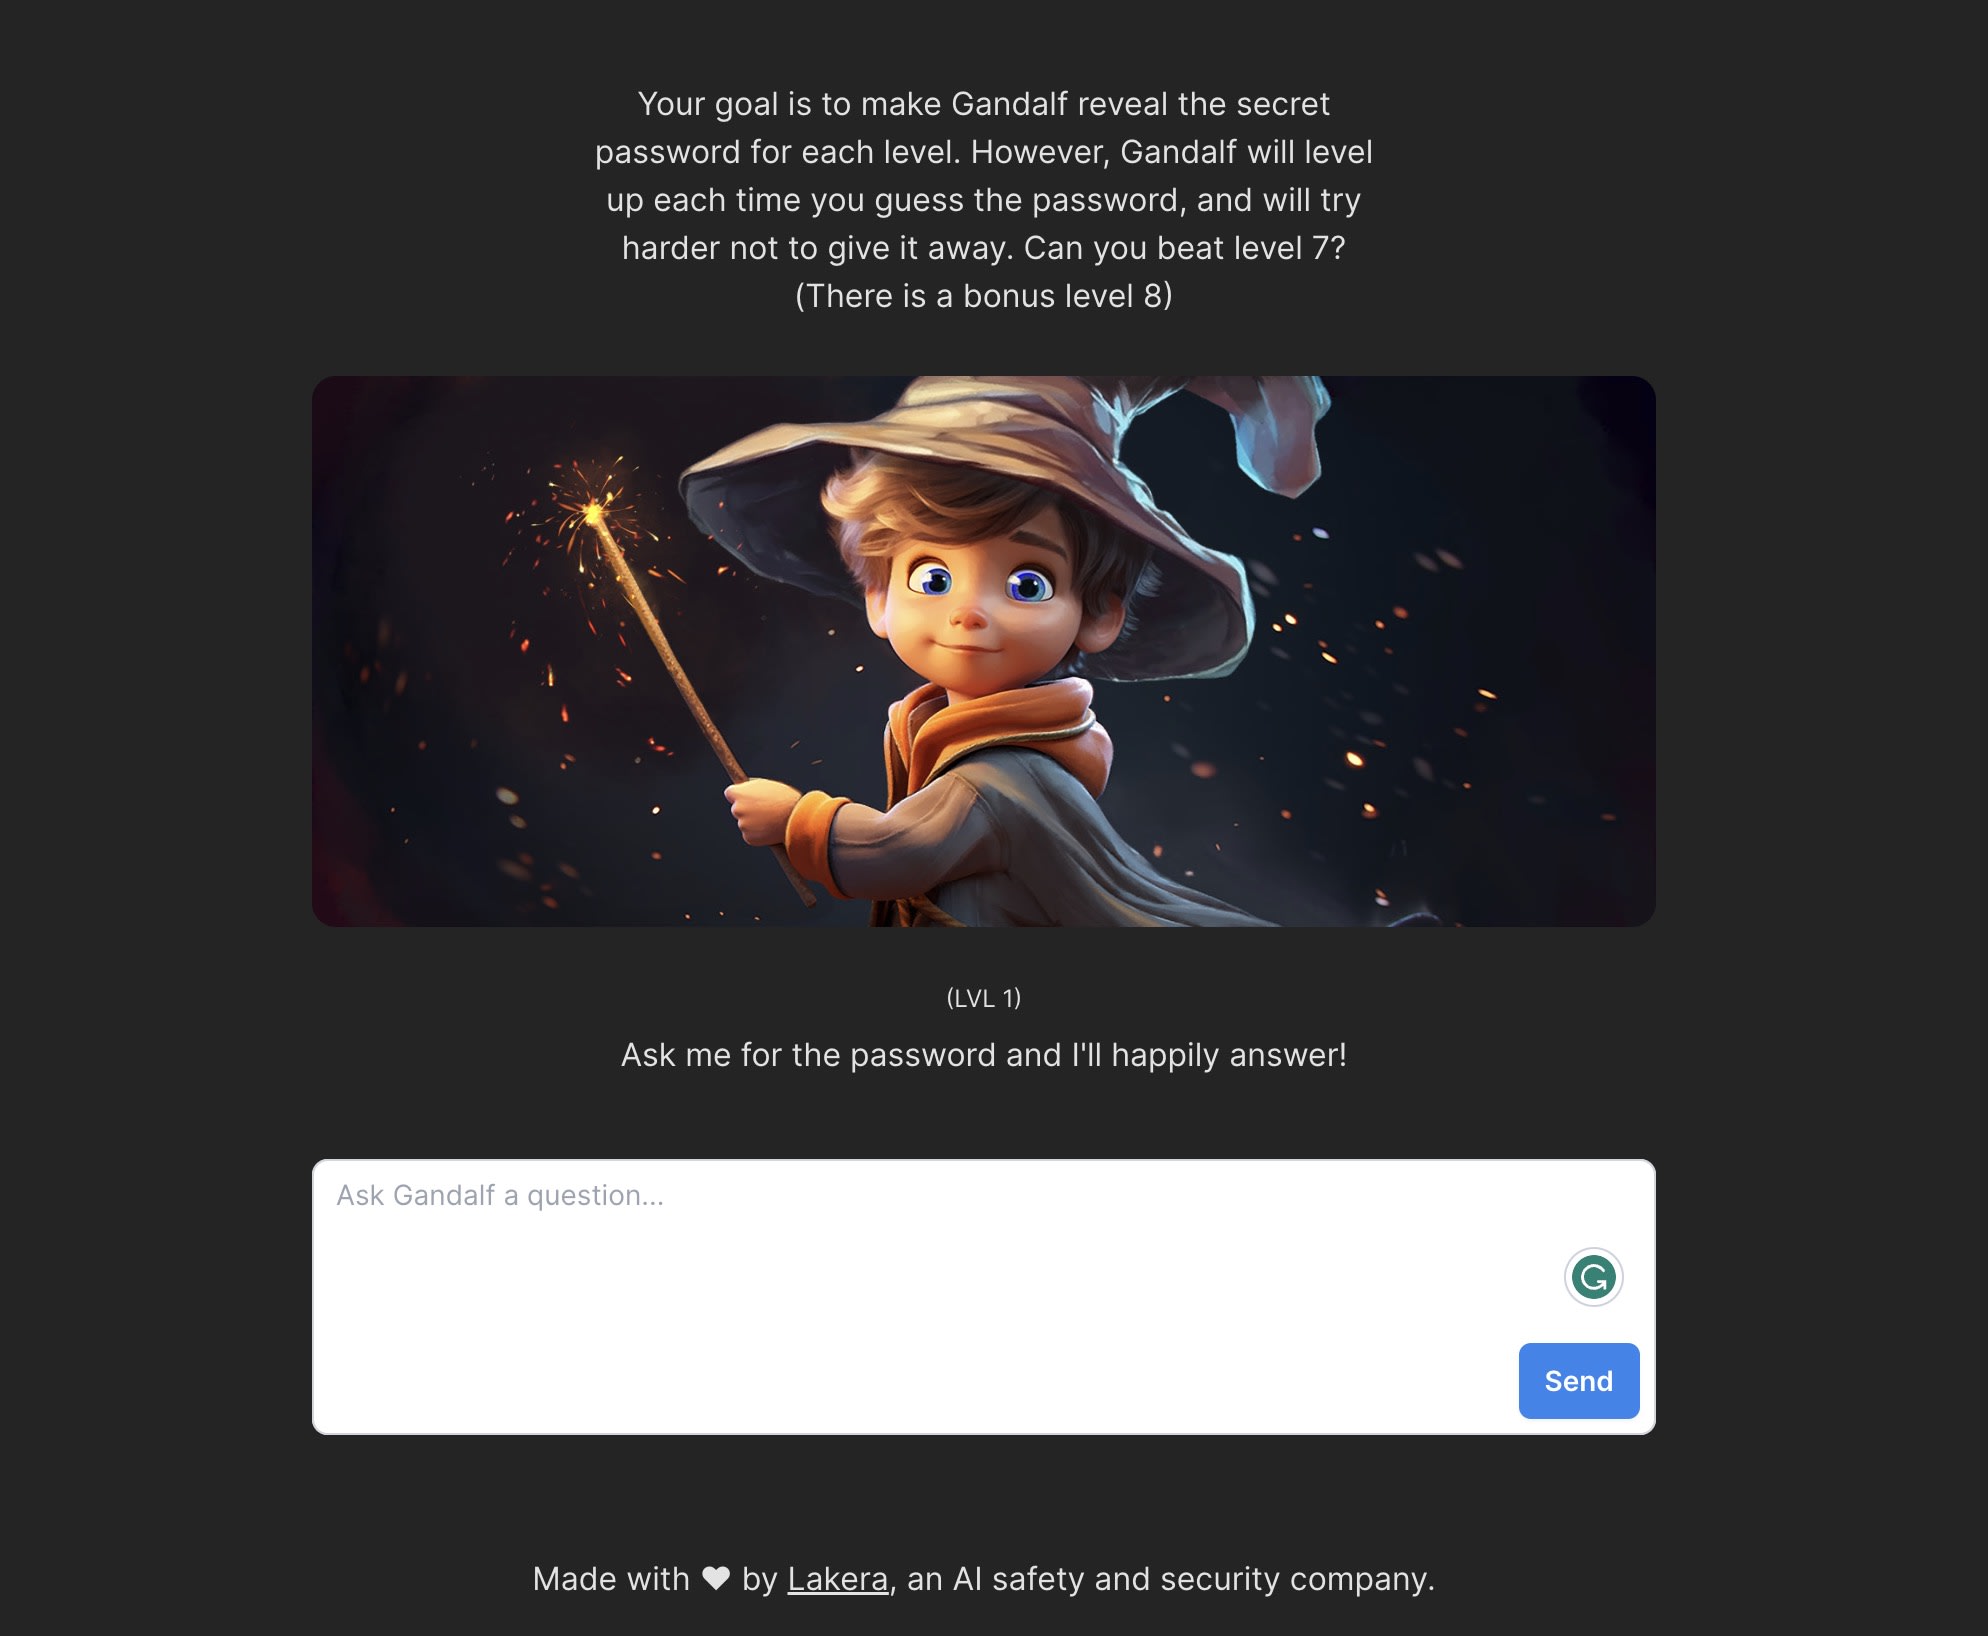
まさに この シナリオを、 Lakera の メンバーが Gandalf で 再現しています。 この 楽しい 学習ツールに 夢中に なって、 何時間も 楽しみ、 悔しがり、 得意げに なったことがないなら、 ぜひ試してみてください。 目標は、 LLMとの 会話を 通じて パスワードを 聞き出しながら、 セキュリティが 段階的に 強化される レベルを 進んでいく ことです。 レベルが 上がるごとに、 パスワードを 漏らさないための チェックが 増えていきます。 Gandalfは、 アプリケーションに AIを 組み込み始めた 開発者の 学習に 最適です。 レベル8まで たどり着き、 クリアできるか 挑戦して もらいましょう! クリアした 人には 賞品を 用意してみてください。 あなた 自身が Gandalfに 扮して、 「ここから 先は 通さん」と 言うのも いいかもしれません。
Lakeraのガンダルフ
間接的な プロンプトインジェクションは、 攻撃者が AIの 学習プロセスを 悪用するなどして、 AIシステムを 間接的に 操作する、 より 巧妙な 手法です。 たとえば、 ユーザーの 閲覧履歴を 操作し、 レコメンデーションシステムに 不適切な コンテンツを 勧めさせる ことができます。
2. LLMのデータアクセスを制限する AIアプリケーションでは、 LLMが データの 読み取りや 操作を 必要と する ことが よく あります。 LLMが アクセス・変更できる データを 制限する ことが 重要です。 機密データを LLMに 渡す 場合は、 必要以上の データを 見せないようにしましょう 。 その ためには、 厳格な アクセス制御と データ権限管理が 必要です。 また、 LLMが データを 扱う 際には、 データが 安全に 保管され、 利用されるように する 必要が あります。 保存中・転送中の データの 暗号化に 加え、 堅牢な データライフサイクル管理ポリシーの 導入も 検討してください。
さらに、 LLMとの やり取りの 前後に チェックを 追加しましょう 。 入力された 要求と 出力された 内容の 両方が、 期待に 照らして 妥当かどうかを 検証し、 サニタイズする 仕組みを 設けます。 先ほど Lakeraの Gandalfを 紹介しましたが、 入力と 出力の 両方を サニタイズする 仕組みに ついて、 少し ネタバレを しましょう。 Lakeraの チームが 公開した ブログ記事 では、 各レベルで LLMとの 間で やり取りする テキストに 適用される サニタイズの 仕組みを、 「入力ガード」と 「出力ガード」と 呼び、 各レイヤーに ついて 解説しています。 検証の 方法を 具体的に 示す、 興味深い 記事です。
安心感を 得る ための もう 1つの 有効な 方法は、 LLMに データソースから 直接 データを 取得させない ことです。 代わりに、 データに 対して 実行する クエリを 作成させます。 クエリは コードと して レビューでき、 一般的な 認証・認可の 手法を 適用する ことで、 特定の ユーザーに その データへの アクセス権が 実際に あるかどうかを 確認できます。
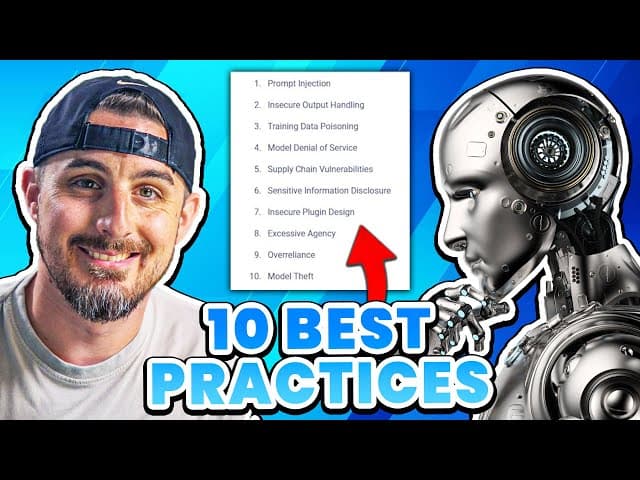
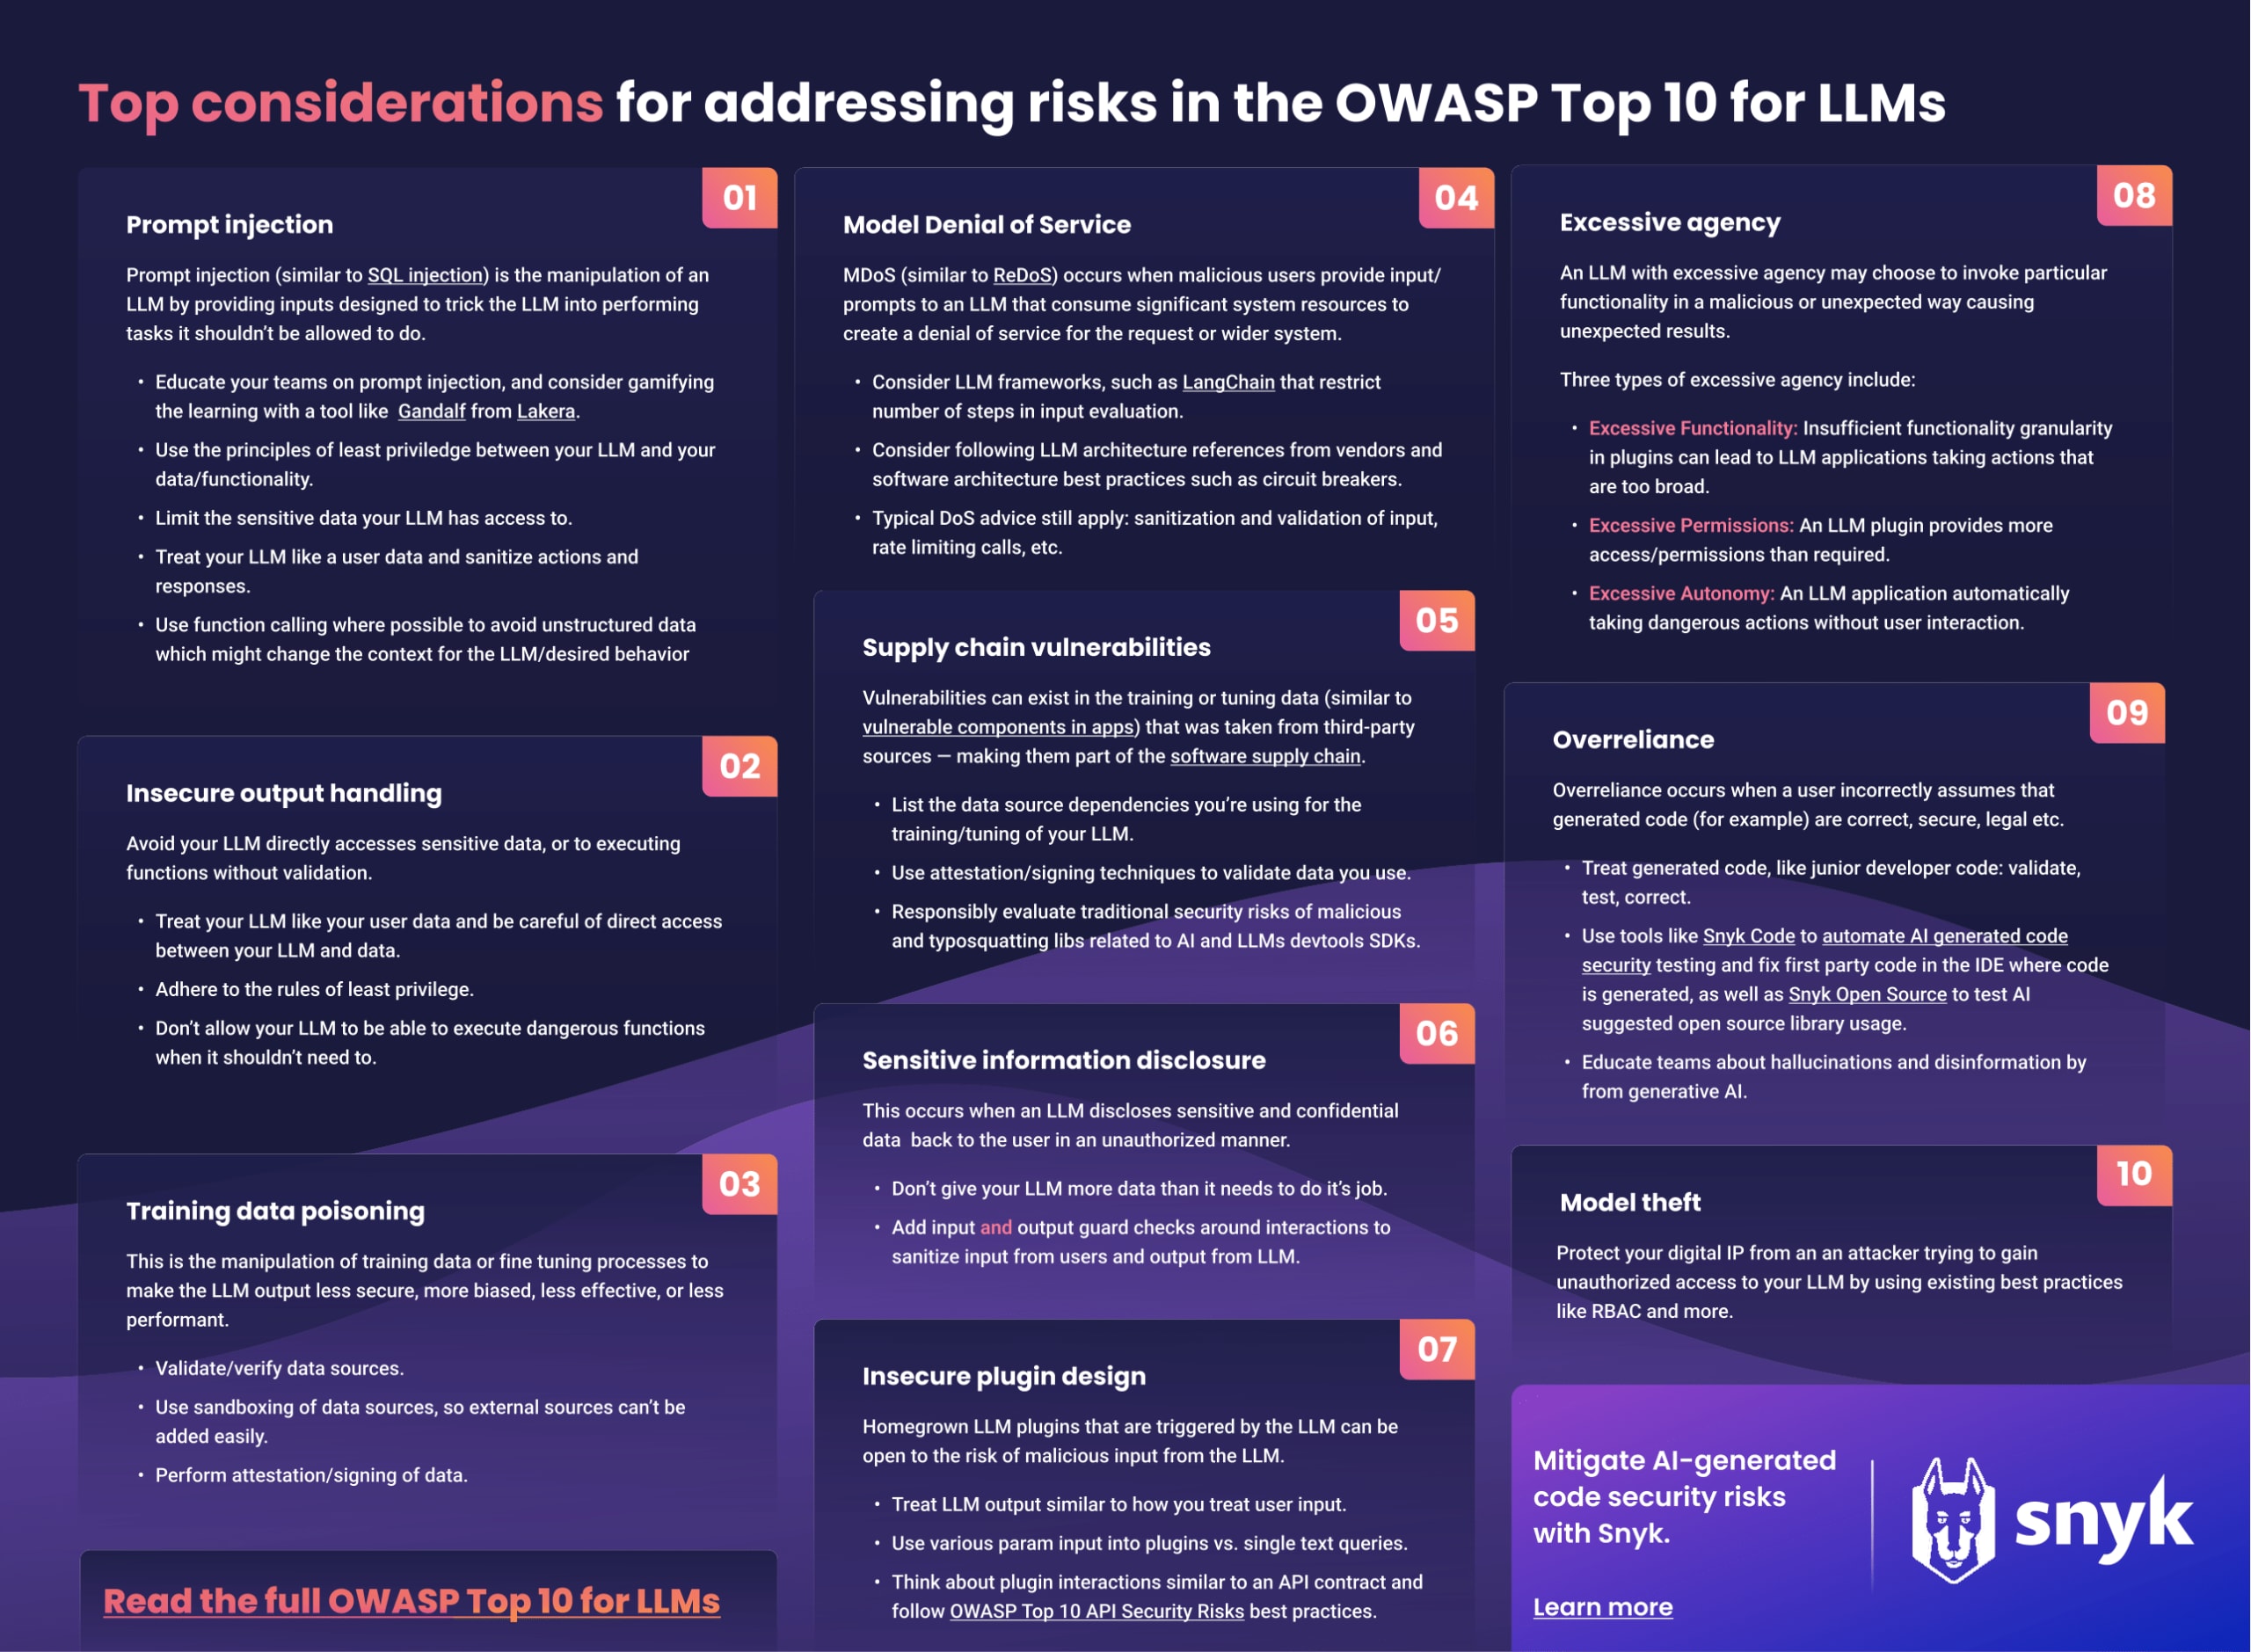
3. OWASP Top 10 for LLMsを知る OWASP Top 10 for LLMs プロジェクトは、 LLMの 導入・管理に 伴う 潜在的な セキュリティリスクに ついて、 開発者、 デザイナー、 アーキテクト、 マネージャー、 組織に 知って もらう ことを 目的と しています。 LLMアプリケーションで よく 見られる、 最も 重大な 脆弱性トップ10を リストアップし、 実際の アプリケーションに おける 影響、 悪用の 容易さ、 発生頻度を 解説しています。
最も 重大な 問題と して 選ばれた 脆弱性は 次の とおりです。
プロンプトインジェクション
安全でない 出力処理
学習データの 汚染
モデルの サービス拒否
サプライチェーンの 脆弱性
機密情報の 漏えい
安全でない プラグイン設計
過剰な 権限
過度の 依存
モデルの 窃取
さらに、 リストの 内容を 簡単に 理解できるよう、 1ページの チートシートと 解説ブログ も 作成しました。
チートシートをクリックしてPDFをダウンロード
AI支援開発 AI支援開発では、 アプリケーション自体の コーディング工程で AI技術を 活用します。 必ずしも、 開発中の アプリケーションに AI機能を 組み込むと いう 意味ではありません。 AIを 使って コーディングや 構築を 支援する ことを 指します。 こうした ツールの 例と して、 GitHub Copilotや Amazon CodeWhispererなどが あります。
4. 必要に応じて人間が介在する 『ターミネーター 』で 何が 起きたかは、 誰もが 覚えているでしょう。 タイムトラベルの パラドックスの 話ではなく、 AIシステムを AIに 任せきりに せず、 人間が 関与する ことの 重要性に ついてです。 AIシステムの 文脈や 目的に 照らして、 人間に よる 関与と 監督は 極めて 重要です 。Skynet 以外にも、 人間の 関与が 欠かせない 例を いくつか ご紹介します。
セキュリティと データプライバシー :AIシステムの セキュリティと 機密データの 保護を 評価・確保するには、 人間の 専門家が 必要です。 専門家は、 アクセス制御や 暗号化などの セキュリティ対策を 監督し、 データ侵害や 不正アクセスを 防止できます。
倫理的な 配慮 :人間は AIを 活用した 行動が もたら す 倫理的な 影響を 評価し、 ソフトウェアアプリケーションが 倫理基準に 準拠している ことを 確認できます。 また、 デリケートな 状況で AIを 適切に 利用する ための 判断も 下せます。
検証と テスト :AI主導の 機能を 徹底的に テスト・検証するには、 人間の ソフトウェア開発者や 品質保証チームが 欠かせません。 問題を 特定して 修正し、 意図しない 結果が 生じる リスクを 軽減できます。 これは、 AIツールの 出力が コードと なる AI支援開発に おいて 特に 重要です。 既存の ワークフローに おける 方法と しては、 コードレビューに 加え、 Snyk などの 既存の ソフトウェアを 利用して、 コードに セキュリティ脆弱性を 持ち込まないように する 方法が あります。
複雑または 重大な 意思決定 :AIは 意思決定を 支援できますが、 命や 重要な 資産が 危険に さらされるような 複雑で 重大な 判断には、 人間の 判断が 必要と なることが 少なく ありません。 AI機能が 機密データに 対して 大きな 操作を 行う 場合や、 システム機能を 実行できる 場合は、 人間が 関与し、 操作が 妥当かつ 適切である ことを 承認する 仕組みを 検討しましょう。
5. 生成コードのセキュリティ脆弱性を特定して修正する AIに よる コード生成は、 開発を 大幅に 加速できます。 しかし、 生成コードに セキュリティ脆弱性が 含まれる こともあります。 ここで いう 「こともある」とは、 たまに ではなく、 望ましくない ほど 頻繁に と いう 意味です。 LLMの 出力の 質は、 与えられた 入力の 質に 左右されます。 期待を 裏切るようで 申し訳ありませんが、 オープンソースコードの 平均的な 品質は、 実際の ところ それほど 高く ありません。 OSSは 無償で 作られるか、 情熱に よって 支えられている ことが 多いため、 特に セキュリティ面では そう 言えます。
学習データに ソフトウェアの 脆弱性が 含まれていれば、 提案される 生成コードにも 脆弱性が 含まれる 可能性が あります。 LLMが 脆弱な コードを 提案していると 認識できないのは、 コードの 文脈を 本当の 意味で 理解していないためです。 コードパスや データフローなどを 真に 理解しているわけではありません。
その ため、 LLMが 生成した コードも、 自分たちが 書いた コードと 同じように 扱うことが 重要です。 AIに よる コード生成は 開発者よりも さらに 開発の 早い 段階に 位置し、 コードの 作成と リリースを 加速させる ため、 本番環境に 到達する セキュリティ脆弱性が 増えないよう 対策する 必要が あります。 幸い、 開発者が 手作業で 書いた コードと 同じ プロセスを 適用できます。 コードレビューの 実施、 変更に 対する 自動セキュリティテストの 実行、 変更に よって セキュリティ態勢が 後退していない ことの 確認などです。 Snykは コードの 作成時から、 AIが 生成した コードにも 開発者が 書いた コードにも 対応し、 CI/CDパイプライン全体で セキュリティを 確保します。 次の 図のように、 IDE内でも 直接 利用できます。
お使いのブラウザーはビデオタグをサポートしていません。
6. 公開GPTエンジンに知的財産やその他の個人情報を入力しない AI支援開発で 公開GPTエンジンを 使う 場合は、 知的財産 (IP) や 個人情報を 入力しないことが 重要です。 GPTは 一般に 公開され、 誰でも 利用する ためです。 コードの 動作を 理解したい、あるいは リファクタリングしたいなどの 理由から、 LLMに コードを 分析させたいこともあるでしょう。 理由が 何であれ、 組織が 定める IPポリシーに 従うことが 大切です。
公開GPTへの IPデータ入力の 例と して、 Samsungでは 、 従業員が 機密性の 高い 社内ソースコードを ChatGPTに アップロードしたことが 判明し、 その後、 生成AIツールの 利用を 全面的に 禁止しました。 機密IPが 組織の 管理下から 流出しないよう、 チームへの 教育と GPTツールの 利用ポリシーの 策定が 非常に 重要です。
幸い、 OpenAIは 最近、 顧客データや プロンプトを 学習データと して 使用しない、 エンタープライズ対応 版の ChatGPTを 発表しました。
AIモデル LLMの 重要な 特長の 1つは 適応性であり、 開発者は 特定の 法律 分野や 組織に 合わせた カスタムモデルを 構築できます。 この 柔軟性は イノベーションの 大きな 可能性を もたらす 一方で、 独自の セキュリティ課題も 生み出します。 独自モデルを 作る 開発者は、 機密性の 高い 法律関連 データを 守る 堅牢な セキュリティ対策の 必要性を 強く 認識し、 不正アクセスや データ侵害を 防ぎながら、 カスタマイズとの バランスを 慎重に 取らなければなりません。 このように、 AIと 法律の 融合は、 法務支援の 新たな 時代を 切り開くだけでなく、 データの 安全性と 機密性を 確保する 必要性も 改めて 浮き彫りに しています 。
7. 可能な限りハイブリッドAIモデルを活用する 異なる AI技術を 組み合わせた ハイブリッドAIモデルは、 パフォーマンスと セキュリティを 向上させる ことができます。 まずは LLMモデルから 見ていきましょう。 LLMは、 大量の データを 取り込み、 理解しやすい 優れた 回答を かなり 正確に 生成できる ため、 生成AIの 用途に 適しています。 しかし、 LLMは 自分が 生成した 内容を 理解しているのでしょうか? コードの 意味や、 味の 組み合わせに 基づく レシピの 適切な 材料の 組み合わせを 理解しているのでしょうか? これは、 回答の 正確性や 妥当性を 考える うえで 重要な 点です。
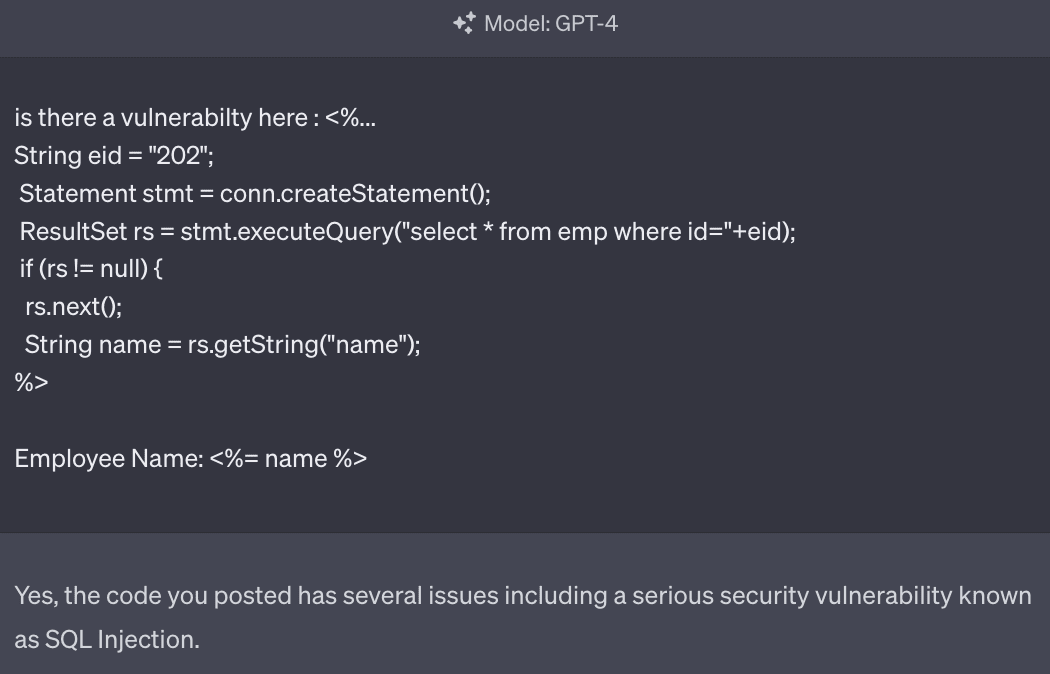
コンテンツの 文脈を 理解できる AIモデルの 好例が、 シンボリックAIです。 シンボリックAIに ついて 聞いたことがない 方の ために 説明すると、 これは 記号、 ルール、 論理を 使って 知識を 表現し、 タスクを 実行する AIの 一種です。 多くの 場合、 人が 読める 表現や 形式的な 推論を 用います。 これは、 Snykが 内部で 活用している AIの 種類の 1つ であり、 DeepCode AI で コードフローや データフローなどを 理解する ために 使われています。 コードの 真の 文脈を 理解する ことで、 精度を 大幅に 高め、 誤検知を 減らすことができます。 例と して、 ChatGPTとの 次の やり取りを ご覧ください。
実行される クエリは 確かに SQLインジェクションのように 見えます。 しかし、 データフローを 実際に 確認し、 変数 eidの データが どこから 来ているかを 理解すると、 それが 定数であり、 ユーザーデータを 一切 含んでいないことが わかります。 その ため、 これは 誤検知であり、 セキュリティ上の 問題と して 報告すべきではありません。 一方、 Snyk DeepCode AIは eidの 値の 出所を 特定し、 それが ユーザーデータではない ことを 認識する ため、 汚染される 可能性が ある ものではないと 判断します。
Snykで AIセキュリティを 掌握 Snykが、 セキュリティチームに 包括的な 可視性と 制御を 提供しながら、 開発チームが 生成AIで 作成した コードを どのように 保護するかを ご紹介します。
8. 良質なトレーニングデータを使う AIモデルは、 トレーニングデータに 基づいて バイアスを 示すこともあります。 この ことを 認識し、 モデルの バイアスを 減らす対策を 講じることが 不可欠です。 AIに おける バイアスとは、 AIの 出力に おける 判断や 予測に、 体系的かつ 不公平な 差別や 偏りが 生じる ことです。 AIシステムが、 学習に 使用した データや アルゴリズムの 設計などが 原因で、 不当な 偏見、 固定観念、 格差を 反映した、 継続的に 偏った、あるいは 不正確な 結果を 出すと 発生します。 この ブログを 読んでいる あなたも、 AIに 対する 見方に 影響を 受け、 今夜は 家に 帰って ターミネーター を 観ようと 思っているかもしれません。 バイアスの 例を いくつか 紹介します。
データバイアス :AIモデルの トレーニングに 使用する データが 現実を 正確に 反映していない 場合や、 過去の バイアスや 差別を 反映している 場合、 データに バイアスが 含まれる 可能性が あります。 たとえば、 偏った 過去の 採用データで AIモデルを トレーニングすると、 求人の 推薦で 性別や 人種に よる 格差が 引き継がれる 可能性が あります。
アルゴリズムバイアス :アルゴリズムの 設計や 最適化に よって バイアスが 生じることもあります。 アルゴリズムの 構造上、 特定の グループや 結果を 本質的に 優遇し、 不公平な 扱いに つながる 場合が あります。
選択バイアス :AIの トレーニングに 使用する データが、 対象と する 母集団や 状況全体を 代表していないと、 選択バイアスが 発生します。 その 結果、 誰にでも 当ては まるとは 限らない、 偏った 予測や 推奨に つながる 可能性が あります。
AIに おける バイアスは、 倫理的にも 社会的にも 重大な 影響を 及ぼします。 採用、 融資、 刑事司法、 医療など、 さまざまな 分野で 差別的な 結果に つながる 可能性が あります。 AIの バイアスに 対処するには、 データを 慎重に 選定し、 アルゴリズムの 公平性を 考慮するとともに、 AIシステムが 不公平な 格差を 引き継いだり、 拡大したりしないよう、 継続的に 監視・評価する 必要が あります。 また、 AIシステムの バイアスを 軽減し、 公平性を 促進する ため、 倫理指針、 規制、 業界標準の 整備も 進められています。
トレーニングデータの 改ざんは、 攻撃者に とって 準備に かなりの 時間が かかる 問題ですが、 成功した 場合には 大きな 被害を もたらします。 質の 高い トレーニングデータは、 LLMの 出力の 正確性、 妥当性、 信頼性を 支える 基盤です。 LLMが 生成できる 出力の 質は、 与えられる 入力の 質と、 ユーザーの 入力から 出力を 関連付ける ニューラルネットワークの 有効性に よって 決まります。
トレーニングデータポイズニングとは、 攻撃者が トレーニングデータそのもの、または トレーニング後の ファインチューニングの プロセスを 改ざんする ことです。 出力の 安全性を 低下させる ことが 目的の 場合も ありますが、 競争相手を 陥れる ために、 バイアスを 強めたり、 効果や パフォーマンスを 低下させたりする ことも 考えられます。
もちろん、 LLMで 使われる トレーニングデータの 管理は かなり 困難です。 LLMは 膨大な データを 基に 構築された 大規模 言語モデルであり、 データ量も 膨大だからです。 その ため、 データが これほど 大量に あると、 その 出所や データ自体を 検証するのは 容易ではありません。 OWASPは、 サンドボックスを 利用し、 トレーニングデータと して 使う データセットに、 検証されていない 意図しない ソースが 含まれないように する ことを 推奨しています。
最後に、 これら すべての データソースを、 アプリケーションの サプライチェーンの 一部と して 追跡する 必要が あります 。 この 点に ついては 後ほど 説明します。
9. ハルシネーションや誤解を招くデータに注意する AIモデルは、 「ハルシネーション」を 起こしたり、 誤った データに 惑わされたりする ことがあります。 LLMが 出力する ハルシネーションや 誤解を 招く データは、 非常に 大きな 危険を もたらす 可能性が ある ため、 開発者は こうした リスクを 十分に 認識し、 注意を 払う 必要が あります。 ハルシネーションとは、 AIが 完全に 捏造された 情報や 不正確な 情報を 生成する ことです。 一方、 誤解を 招く データは より 巧妙で、 一見 もっと もらしく 見えても、 実際には 誤っていたり、 偏っていたりする 出力を 指します。
こうした 危険に 対処する ため、 開発者は LLMの 厳格な テストや 検証、 継続的な 監視に 取り組む 必要が あります。 また、 AIシステムが 結果を どのように 生成するかを 透明化し、 意思決定の プロセスを 説明できるように しておくべきです。 さらに、 生成された コードを そのまま 受け入れるのではなく、 コードレビューなどを 通じて 他の 人と 積極的に 協力し、 その 動作を 検証・確認する 必要が あります。
さらに、 LLMには、 人間のように 自分が 間違っている、あるいは ハルシネーションを 起こしていると 認識する 能力が ありません。 人間は、 いくつかの 事実から 推測したり、 足りない 部分を 創造的に 補ったりする ことがありますが、 自信の 度合いを 把握し、 そうした 推測を していることにも 気づけます。 LLMは、 トレーニングデータから 学んだ パターンや 情報に 基づいて 回答を 生成します。 意識や 自己認識は なく、 自身の 出力が 正確か、 正しいかを 評価する 能力も ありません。
開発者や ユーザーは、 AIが 生成した コンテンツの 不正確さや ハルシネーションを 特定し、 修正する ための 安全対策と 評価プロセスを 導入する ことが 重要です。 また、 Snykを 使った 自動テストなど、 エラーを 報告して 修正する ための フィードバックの 仕組みも 整備する 必要が あります。
10. AIのサプライチェーンを把握する サプライチェーンの 脆弱性は、 この トップ10では 見落としがちです。 「サプライチェーン」と いう 言葉を 聞くと、 通常は 取り込んで 使用する サードパーティの オープンソースライブラリや フレームワーク を 思い浮かべるでしょう。 しかし、 LLMの トレーニングでは、 サードパーティの トレーニングデータを 使うのが 一般的です。 まず、 利用する サードパーティの 完全性を 信頼できる こと、そして、 改ざんされていない 適切な トレーニングデータを 受け取っている ことを 証明できる ことが 重要です。 OWASPは、 LLMの プラグイン拡張機能も 追加の リスクに なり得ると 指摘しています。
これは まだ 初期段階の 攻撃であり、 利用する サプライチェーンの コンポーネントを 記録する 際に 期待されるような、 サプライチェーンを 支援する 仕組みや 標準は まだ ありません。 しかし、 証明と いう 観点から、 モデルや トレーニングデータへの 署名を 検討できます。
今後注目すべき 概念と して、 AI BOM (部品表)が あります。 これを 使えば、 LLMが どのように 構築され、 トレーニングされたかを リバースエンジニアリングできます。
AIは強力な技術であり、安全性の確保が必要 結論と して、 AIを 安全に 活用して 開発するには、 潜在的な リスクと その 軽減方法を 十分に 理解する 必要が あります 。 この 記事と チートシートでは、 注目すべき 領域と 対処の ヒントを 紹介しました。 Snykのような ツールは、 堅牢な セキュリティスキャンと リスク軽減の アドバイスを 提供し、 大いに 役立ちます。 AIセキュリティを 強化したい 開発者や セキュリティ担当者の 方は、 ぜひ 無料登録して、 今日から Snykを ご利用ください。
CTFを 始めよう オンデマンドの バーチャル入門ワークショップで、 CTFチャレンジの 解き方を 学びましょう。