Vulnerabilidades de confusión de URL en la práctica: exploración de inconsistencias entre analizadores

Snyk Security Research Team
Claroty Team82
10 de enero de 2022
0 minutos de lecturaLas URL han cambiado para siempre la forma en que interactuamos con las computadoras. Concebidas en 1992 y definidas en 1994, las direcciones URL (Uniform Resource Locator) siguen siendo un componente fundamental de Internet, ya que permiten navegar por la web mediante direcciones descriptivas y comprensibles para las personas. Pero la necesidad de que fueran legibles para las personas también hizo necesario dividirlas en componentes que las máquinas pudieran usar; de eso se encargan los analizadores de URL.
Dada la ubicuidad de las URL durante décadas, uno pensaría que los analizadores que usamos hoy habrían llegado a un consenso sobre cómo analizar URL similares (o incluso idénticas). Aunque sería lo ideal, la realidad está muy lejos de eso. Esta falta de consenso ha contribuido a una clase de vulnerabilidad llamada confusión de URL, que exploraremos en esta publicación.
Nota: El proceso de desarrollo de los protocolos de Internet (HTTP, HTML, URL, etc.) usa documentos conocidos como Requests for Comment o RFC. En esta publicación, haremos referencia a estos documentos con frecuencia.
En nuestra investigación conjunta, examinamos muchas bibliotecas de análisis de URL en distintos lenguajes de programación y observamos algunas inconsistencias en la forma en que cada una dividía las URL en sus componentes básicos. Clasificamos los tipos de inconsistencias en cuatro categorías y buscamos flujos de código problemáticos tanto en aplicaciones web como en bibliotecas de código abierto. Estos esfuerzos revelaron numerosas vulnerabilidades, la mayoría con una de estas causas principales:
Se usan varios analizadores de URL
Con el tiempo, hubo varios RFC relacionados con las URL, y distintos analizadores implementaron distintos RFC
En esta publicación, repasaremos la historia de las URL, exploraremos posibles fuentes de confusión entre analizadores de URL, veremos una prueba de concepto de explotación y, luego, ofreceremos recomendaciones para protegerte de los ataques basados en la confusión de URL. Usa la tabla de contenido a continuación para ir directamente a una sección:
La investigación conjunta de los equipos de investigación de seguridad de Claroty y Snyk se inspira en trabajos anteriores de Orange Tsai, titulados «A New Era of SSRF», y en una comparación entre WHATWG y RFC 3986, realizada por Daniel Stenberg, creador de cURL. Queremos agradecerles por su innovadora investigación.
¿Qué son las URL y cómo llegamos hasta aquí?
Cuando pensamos en una URL, pensamos en algo como https://snyk.io. En su forma más básica, indica adónde ir (my-site.com) y cómo llegar (HTTPS). Además de esos componentes, también podemos encontrar elementos adicionales, como rutas (https://my-site.com/about), símbolos de numeral seguidos de una cadena (fragmentos; por ejemplo, https://my-site.com#contact) o signos de interrogación seguidos de parámetros (consultas; por ejemplo, https://my-site.com?source=li&device=mobile).
Si generalizamos y combinamos lo anterior, podemos dividir una cadena de URL en los siguientes componentes principales:
scheme://authority/path?query#fragment
Por ejemplo, una URL puede verse así: https://example.com:8042/over/there?name=ferret#nose
Durante nuestra investigación, analizamos cómo varios analizadores implementaban distintos RFC. Aunque el formato de URL anterior parece relativamente sencillo, los RFC que lo definieron han cambiado mucho desde 1994. Estas adiciones y revisiones dieron forma a la URL que conocemos hoy.
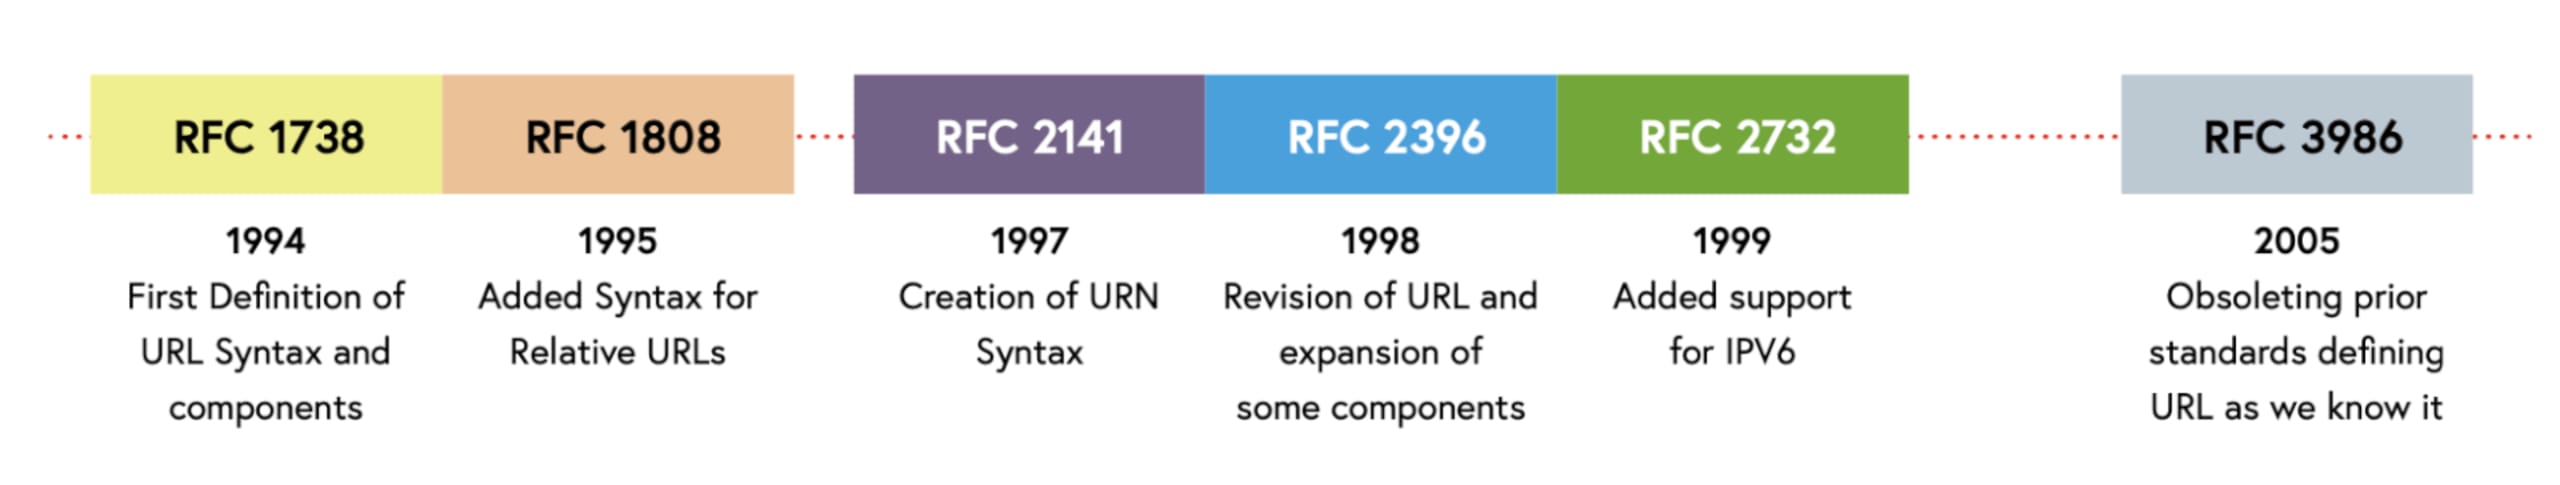
Más información: RFC 1738, RFC 1808, RFC 2141, RFC 2396, RFC 2732, RFC 3986
Para entender dónde se confunden los analizadores, primero debemos revisar (brevemente) qué significa cada componente de una URL completa y cómo se define.
Esquema
La sección del esquema es donde se define el protocolo (es decir, HTTP, HTTPS, FTP, Gopher, etc.). Los RFC definen qué caracteres se permiten en este componente y establecen que el esquema actual debe ajustarse al patrón ALPHA *( ALPHA / DIGIT / "+" / "-" / "." ). Veamos cómo funciona:
Primer carácter:
a–ZCaracteres que no son el primero:
a–Z,0–9,+,-,.
Esto significa que 1http no es un esquema válido (porque empieza con un número), pero h2ttp sí lo es (porque el primer carácter debe ser una letra). Además, a diferencia de los demás componentes de una URL, el esquema es el único obligatorio.
Autoridad (antes, Netloc)
Antes, este componente se llamaba «Netloc» (network-location) y luego pasó a llamarse Authority. Está compuesto por tres subcomponentes internos: userinfo, host y port. En conjunto, un ejemplo generalizado de una autoridad se ve así: authority = [ userinfo "@" ] host [ ":" port ]. El subcomponente userinfo también se puede reducir a sus elementos principales de la siguiente manera: username[:password]. Esto permite manejar URL con el formato scheme://user:password@domain:port/. Ten en cuenta que, desde RFC-2396, se desaconsejó el uso de user:password en texto sin formato, y que quedó obsoleto en RFC-3986.
Ruta
Este componente indica a qué recursos del servidor quiere acceder quien realiza la solicitud. Puede contener cualquier secuencia de caracteres (excepto /,;,=,?) dividida en segmentos (delimitados por /).
Aunque parece ser el componente más sencillo, también es el que más cambios ha tenido a lo largo de los años. RFC-1738 y RFC-1808 vincularon la estructura y las reglas del componente de ruta con el componente de esquema. Después, RFC-2396 estableció que cada segmento de ruta podía usar el carácter de punto y coma (;) para definir parámetros. Sin embargo, poco después de RFC-2396 llegó RFC-3986 y la sintaxis de parámetros con punto y coma quedó obsoleta.
¿Confuso? Pues los analizadores también se confunden.
Consulta
Las consultas son pares clave-valor que se envían mediante la URL al recurso solicitado. Los parámetros de consulta aparecen después del primer signo de interrogación (?) y terminan con un signo de numeral/hash (#).
Dentro de un componente de consulta, el punto y coma (;), la barra (/), el signo de interrogación (?), los dos puntos (:), el símbolo arroba (@), el ampersand (&), el signo igual (=), el signo más (+), la coma (,) y el signo de dólar ($) son caracteres reservados y se codifican en URL cuando se usan.
Este es un ejemplo de codificación de caracteres especiales en una URL:
Fragmento
El fragmento se usa para identificar y acceder a un segundo recurso dentro del primer recurso obtenido, especificado por el componente de ruta. La presencia de un numeral (#) indica un componente de fragmento, que termina al final del URI.
... ¡y eso es todo sobre los componentes!
URL relativas
Lo último que veremos en esta sección es el aspecto de las referencias relativas en las URL. Como las URL son jerárquicas por naturaleza, una puede ser relativa a otra. Por ejemplo, dada una URL «base» https://example.com/ y un segmento de cadena de URL que empieza con una ruta, como /foo/bar, el analizador los resolverá como https://example.com/foo/bar; sin embargo, primero se le debe proporcionar la URL «base».
Esto significa que los analizadores deben saber cómo analizar referencias relativas. RFC-3986 define tres tipos de referencias relativas:
Referencia de ruta de red: comienza con
//; por ejemplo,//example.comReferencia de ruta absoluta: comienza con
/; por ejemplo,/etc/passwdReferencia de ruta relativa: no comienza con
/; por ejemplo,foo/bar
Tipo de referencia | Ejemplo |
|---|---|
Ruta de red | //snyk.io |
Ruta absoluta | /etc/passwd |
Ruta relativa | app/login.js |
Mientras que los dos últimos tipos requieren una URL base para resolverse, la referencia de ruta de red solo requiere que esté presente el esquema. Por lo tanto, si un analizador establece HTTPS como esquema predeterminado, //example.com se convertirá en https://example.com.
¿Dónde se confunden los analizadores de URL?
Después de revisar todas las partes de una cadena de URL y los cambios en los RFC a lo largo de los años, decidimos enfocarnos en los analizadores de URL y buscar casos límite que les hicieran producir resultados de análisis incorrectos o inesperados.
Durante nuestra investigación, revisamos 15 bibliotecas (escritas en distintos lenguajes de programación), herramientas para obtener URL (como curl y wget) y navegadores.
Encontramos muchas inconsistencias entre los analizadores y las clasificamos en cuatro categorías principales. Las categorías que se describen a continuación nos permiten engañar a la mayoría de los analizadores y crear una variedad de comportamientos impredecibles, lo que facilita una amplia gama de vulnerabilidades.
Las categorías que definimos son:
¡Sin más preámbulos, veámoslas!
Confusión de esquema
Casi todos los analizadores de URL se confunden cuando no está presente el componente de esquema. La confusión se debe a que RFC 3986 establece que el esquema es la única parte obligatoria de la URL, mientras que RFC 2396 y los anteriores no lo establecen así. Implementar analizadores que intenten ser compatibles con versiones anteriores frente a estos matices no es sencillo y, por eso, se produce la confusión.
Para demostrarlo, aquí hay cuatro bibliotecas de Python distintas a las que se les proporcionó la URL google.com/abc:

Como se muestra arriba, la mayoría de los analizadores indican que el componente de host está vacío cuando reciben la cadena google.com/abc. Sin embargo, Urllib3 indica que el host es google.com y la ruta es /abc. Por su parte, httptools afirma que esta URL no es válida desde el principio. En resumen, casi ningún analizador procesa correctamente esta URL, ya que no cumple con las especificaciones de los RFC.
Dicho esto, algunos analizadores recurren al esquema predeterminado, como hace curl en este caso:

En este caso, los atacantes pueden aprovechar la diferencia entre analizadores para evadir la validación. Si un analizador de URL intenta validar hosts específicos, pero no puede analizar correctamente la URL para extraer el host y, al mismo tiempo, la biblioteca subyacente sí analiza correctamente la URL (o recurre a un valor predeterminado), se produce una evasión. Por ejemplo:

En el ejemplo anterior, urllib (específicamente la función urlsplit) analiza la URL sin netloc, por lo que la verificación se aprueba; sin embargo, urllib3 recurre al protocolo predeterminado http y obtiene el recurso prohibido.
Confusión de barras
El siguiente método de confusión tiene que ver con un número no estándar de barras en la URL. RFC 3986 indica que el componente de autoridad de la URL debe aparecer después de dos barras tras dos puntos, ://, y que se extiende hasta el final de la línea (EOL) o hasta que se encuentra un delimitador. En este caso, un delimitador puede ser una barra (que indica un componente de ruta), un signo de interrogación (componente de consulta) o un numeral (componente de fragmento).
Durante la investigación, observamos varios comportamientos de los analizadores al intentar procesar una URL que no sigue la sintaxis anterior. Ante la siguiente URL, http:///google.com, los analizadores se comportaron de forma interesante:

Como puedes ver, la mayoría de los analizadores afirmaron que esta URL no tiene host, sino que interpretaron /google.com como una ruta en una URL sin host, que es lo esperado según RFC 3986. Pudimos reproducir este comportamiento con cualquier cantidad de barras después del esquema. Sin embargo, encontramos un grupo de analizadores que intentaban «corregir» la URL e ignoraban las barras adicionales o faltantes (hasta cierto punto). Por ejemplo, la función nativa fetch de JavaScript tratará estas URL como si fueran correctas:

Y esto también es cierto para curl:

Estas diferencias en los resultados del análisis crean una amplia superficie de ataque. Al igual que con la idea de ataque anterior (la confusión de esquemas), ¿qué pasaría si pudiéramos eludir las comprobaciones porque el primer analizador interpreta la URL de forma distinta al cliente que la obtiene? Considera este ejemplo:

De nuevo, vemos una validación de netloc contra un dominio bloqueado y, otra vez, estará vacío debido al análisis, por lo que la comprobación se aprobará. Más adelante en el código, curl interpretará la URL de otra manera e intentará obtener el recurso de forma inesperada. Esto puede provocar SSRF y permitir el acceso a otros hosts no autorizados.
Confusión con barras invertidas
Una variante de la confusión con barras diagonales es la confusión con barras invertidas. Esta confusión puede producirse cuando una URL usa una barra invertida (\) en lugar de una barra diagonal (/) y, por lo tanto, crea una URL mal formada. Según RFC 396, una barra invertida es distinta de una barra diagonal y debe interpretarse de otra manera, por lo que http://google.com es diferente de http:\\google.com. Fieles a la RFC, la mayoría de los analizadores de URL programáticos efectivamente tratan las dos URL anteriores de forma distinta:

Sin embargo, Chrome opta por interpretar la barra invertida como si fuera una barra diagonal:

Navegará a la URL como si fuera válida. Llevando esto al extremo, este comportamiento también ocurre con https:/\google.com, y Chrome mostrará el recurso como (in)esperado.
Confusión con URL codificadas
La última categoría de confusión es la de las URL codificadas. Esta confusión ocurre cuando una URL contiene una subcadena codificada en URL en un lugar donde no se espera.
En términos generales, la codificación URL permite incluir caracteres no imprimibles en las cadenas de URL. Se realiza usando el valor hexadecimal de los caracteres, precedido por el símbolo %; por ejemplo, g es %67 cuando está codificado en URL. Este método permite que las cadenas de URL sigan siendo completamente textuales y visibles, independientemente de los caracteres que contengan. Aunque este método se usa principalmente con caracteres no imprimibles, también se pueden codificar en URL caracteres imprimibles, y ahí es donde surge la confusión.
RFC 3986 establece que todos los componentes de una URL, excepto el esquema, se pueden codificar en URL. Sin embargo, en la práctica, muchos analizadores no analizan el componente netloc.
Estos son los resultados del análisis cuando proporcionamos a los analizadores la URL http://google.com en su versión codificada en URL:

Aunque los resultados anteriores parecen esperables, tanto urllib como requests de Python mostraron un comportamiento interesante cuando se les proporcionó una URL codificada:

En ambos casos anteriores, se envió inesperadamente una solicitud a 127.0.0.1.
Por lo tanto, esta discrepancia crea otra superficie de ataque, ya que los patrones Regex simples no detectarán estas cadenas y es posible que podamos volver a eludir las comprobaciones.
Prueba de concepto de explotación (y CVE asignados)
Ahora que entendemos dónde está la confusión, veamos cómo explotar estos problemas y las vulnerabilidades que encontramos. Analizaremos un CVE, pero la lista completa de CVE se encuentra a continuación.
Clearance (Ruby): CVE-2021-23435: vulnerabilidad de redirección abierta
Las vulnerabilidades de redirección abierta se producen cuando una aplicación web acepta una entrada controlada por el usuario que especifica a qué URL se redirigirá al usuario después de una acción determinada (como iniciar sesión). Para ilustrar mejor el ataque, aquí tienes un diagrama que lo muestra:
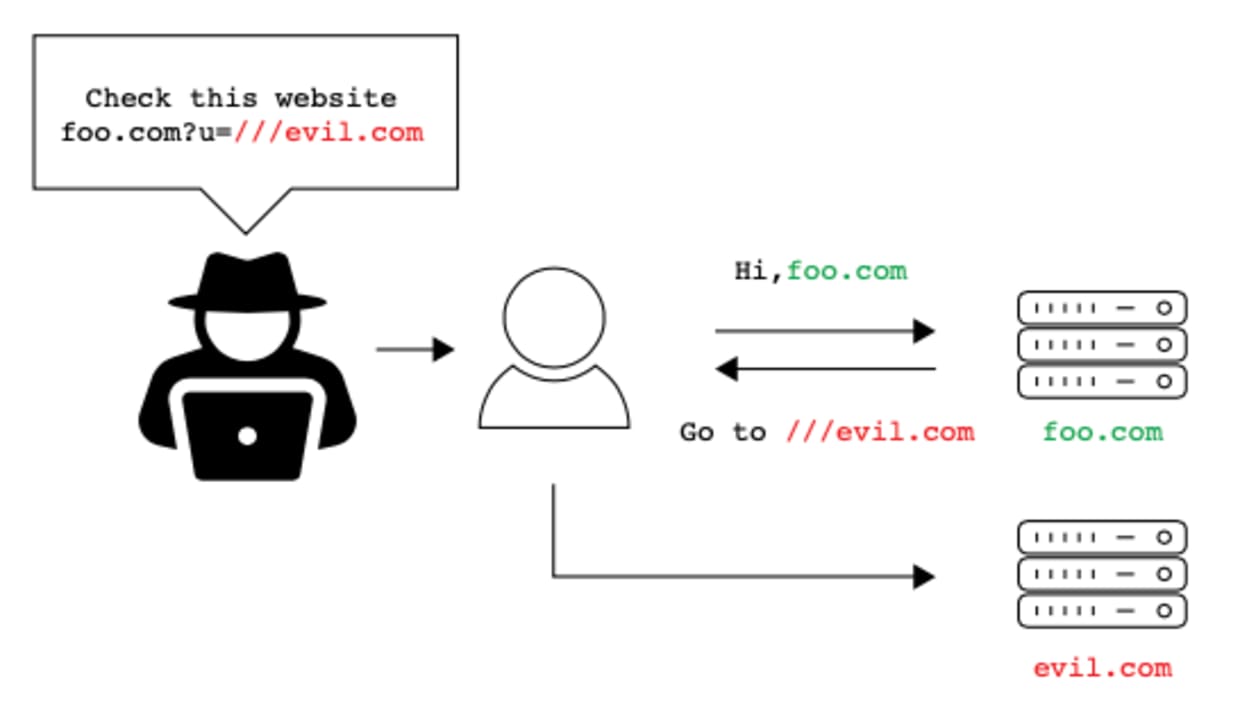
Como puedes ver, el atacante proporciona a la víctima una URL para que la use. Con la configuración adecuada, el servidor redirigirá al usuario a un sitio controlado por el atacante.
Clearance es una gema de Ruby cuyo objetivo es ampliar el mecanismo de autenticación del framework Rails mediante la incorporación de autenticación de email-and-password. Después de iniciar o cerrar sesión, redirige al usuario mediante una URL que obtiene de una solicitud anterior del usuario (es decir, el recurso que quien hizo la solicitud pidió antes de llegar a la página de inicio de sesión).
El código vulnerable está dentro de la función return_to (la devolución de llamada posterior al inicio o cierre de sesión):
Aunque tengamos en cuenta las redirecciones abiertas, return_to no permite que los usuarios indiquen libremente una URL de return_to. Sin embargo, si un usuario solicita un recurso auth-required sin haber iniciado sesión, el sistema llamará a store_location y redirigirá el navegador a la página de inicio de sesión. Por eso, si un atacante logra convencer a una víctima de que haga clic en un enlace como http://target.com/////evil.com, se activará la vulnerabilidad.
¿Por qué se produciría una redirección abierta? ¡Porque hay varios analizadores!
Como vimos, store_location almacena la ruta completa de la URL (esto también se debe a que Ruby ignora las barras diagonales múltiples en las URL). Esto significa que guarda /////evil.com en su caché. Cuando se llama a URI.parse, se eliminan dos barras diagonales adicionales, por lo que ahora tenemos ///evil.com. Cuando un navegador (como Chrome) recibe esta URL, la interpreta como una referencia de ruta de red y redirige al cliente a http://evil.com.
La razón por la que hoy los navegadores suelen «perdonar» estos errores en las URL (e intentar corregirlos) es que, a lo largo de los años, han tenido que lidiar con muchas URL imperfectas o que no cumplen con la RFC. Para ser más tolerantes con los errores de clientes y desarrolladores, con el tiempo han optado por omitir o agregar barras diagonales en los errores más comunes.
Este es un fragmento del código fuente del proyecto Chromium:
Otras vulnerabilidades
Estas son otras vulnerabilidades causadas por diferencias entre analizadores:
Flask-security (Python, CVE-2021-23385)
Flask-security-too (Python, CVE-2021-32618)
Flask-User (Python, CVE-2021-23401)
Flask-unchained (Python, CVE-2021-23393)
Belledonne’s SIP Stack (C, CVE-2021-33056)
Video.js (JavaScript, CVE-2021-23414)
Nagios XI (PHP, CVE-2021-37352)
Clearance (Ruby, CVE-2021-23435)
Recomendaciones para evitar la confusión con URL
Como los problemas analizados en esta publicación se deben principalmente a la presencia de varios analizadores y a sus distintos enfoques, es importante saber cuáles están presentes en tu aplicación al construir este tipo de sistemas. Esto se vuelve más complejo con las arquitecturas actuales (por ejemplo, microservicios y mallas de servicios) y puede tomar tiempo entender por completo qué componentes de análisis hay en tu aplicación y cuál es el recorrido de una solicitud.
Una vez que tengas la lista de analizadores, es fundamental que los desarrolladores comprendan a fondo las diferencias entre sus lógicas de análisis, para poder trabajar con eficiencia sin comprometer la aplicación.
En general, recomendamos lo siguiente:
Usa la menor cantidad posible de analizadores distintos. Así reducirás la superficie de «confusión» y la cantidad de posibles problemas de análisis.
Usa un único punto de análisis en sistemas descentralizados. Si las solicitudes pasan una y otra vez entre distintos componentes del sistema, es muy probable que se usen diferentes analizadores (por ejemplo, debido a que hay servicios en distintos lenguajes). Para mitigar este problema, puedes analizar la URL una sola vez, en el punto de entrada de las solicitudes al sistema, y pasar la solicitud ya analizada. De este modo, se usa un solo analizador durante todo el recorrido de la solicitud.
Comprende las diferencias entre los analizadores que usa tu lógica de negocio. Como a veces necesitamos analizar URL como parte de nuestro código o lógica de negocio, es importante que los desarrolladores que trabajan en la funcionalidad comprendan las variaciones entre los analizadores (como se indicó anteriormente).
Lee el informe técnico sobre la confusión de URL
Conoce más sobre los tipos de confusión de URL leyendo el informe técnico.