Programación segura con Snyk Code: la funcionalidad para ignorar, con un giro
Frank Fischer
30 de marzo de 2021
0 minutos de lecturaAl analizar tu código con nuestra herramienta de programación segura, Snyk Code puede encontrar todo tipo de vulnerabilidades de seguridad. Aunque Snyk Code es rápido, preciso y ofrece contenido completo, a veces es necesario silenciar advertencias específicas. Un caso de uso típico se da en el código de prueba, cuando usas explícitamente contraseñas codificadas para probar tus rutinas, o cuando conoces un problema pero decides no solucionarlo. Para estos casos, Snyk Code, al igual que los demás productos de la plataforma Snyk, te permite ignorar sugerencias.
Y hay más cosas que puedes ignorar de lo que crees (al menos, más de las que yo creía). Exploremos cómo ignorar un problema y luego veamos entre bastidores cómo implementamos esta funcionalidad.
Cómo usar la función para ignorar en Snyk Code
En la interfaz web de Snyk Code, encontrarás un nuevo botón llamado Ignorar (en la parte inferior derecha, con un ícono de ojo tachado):
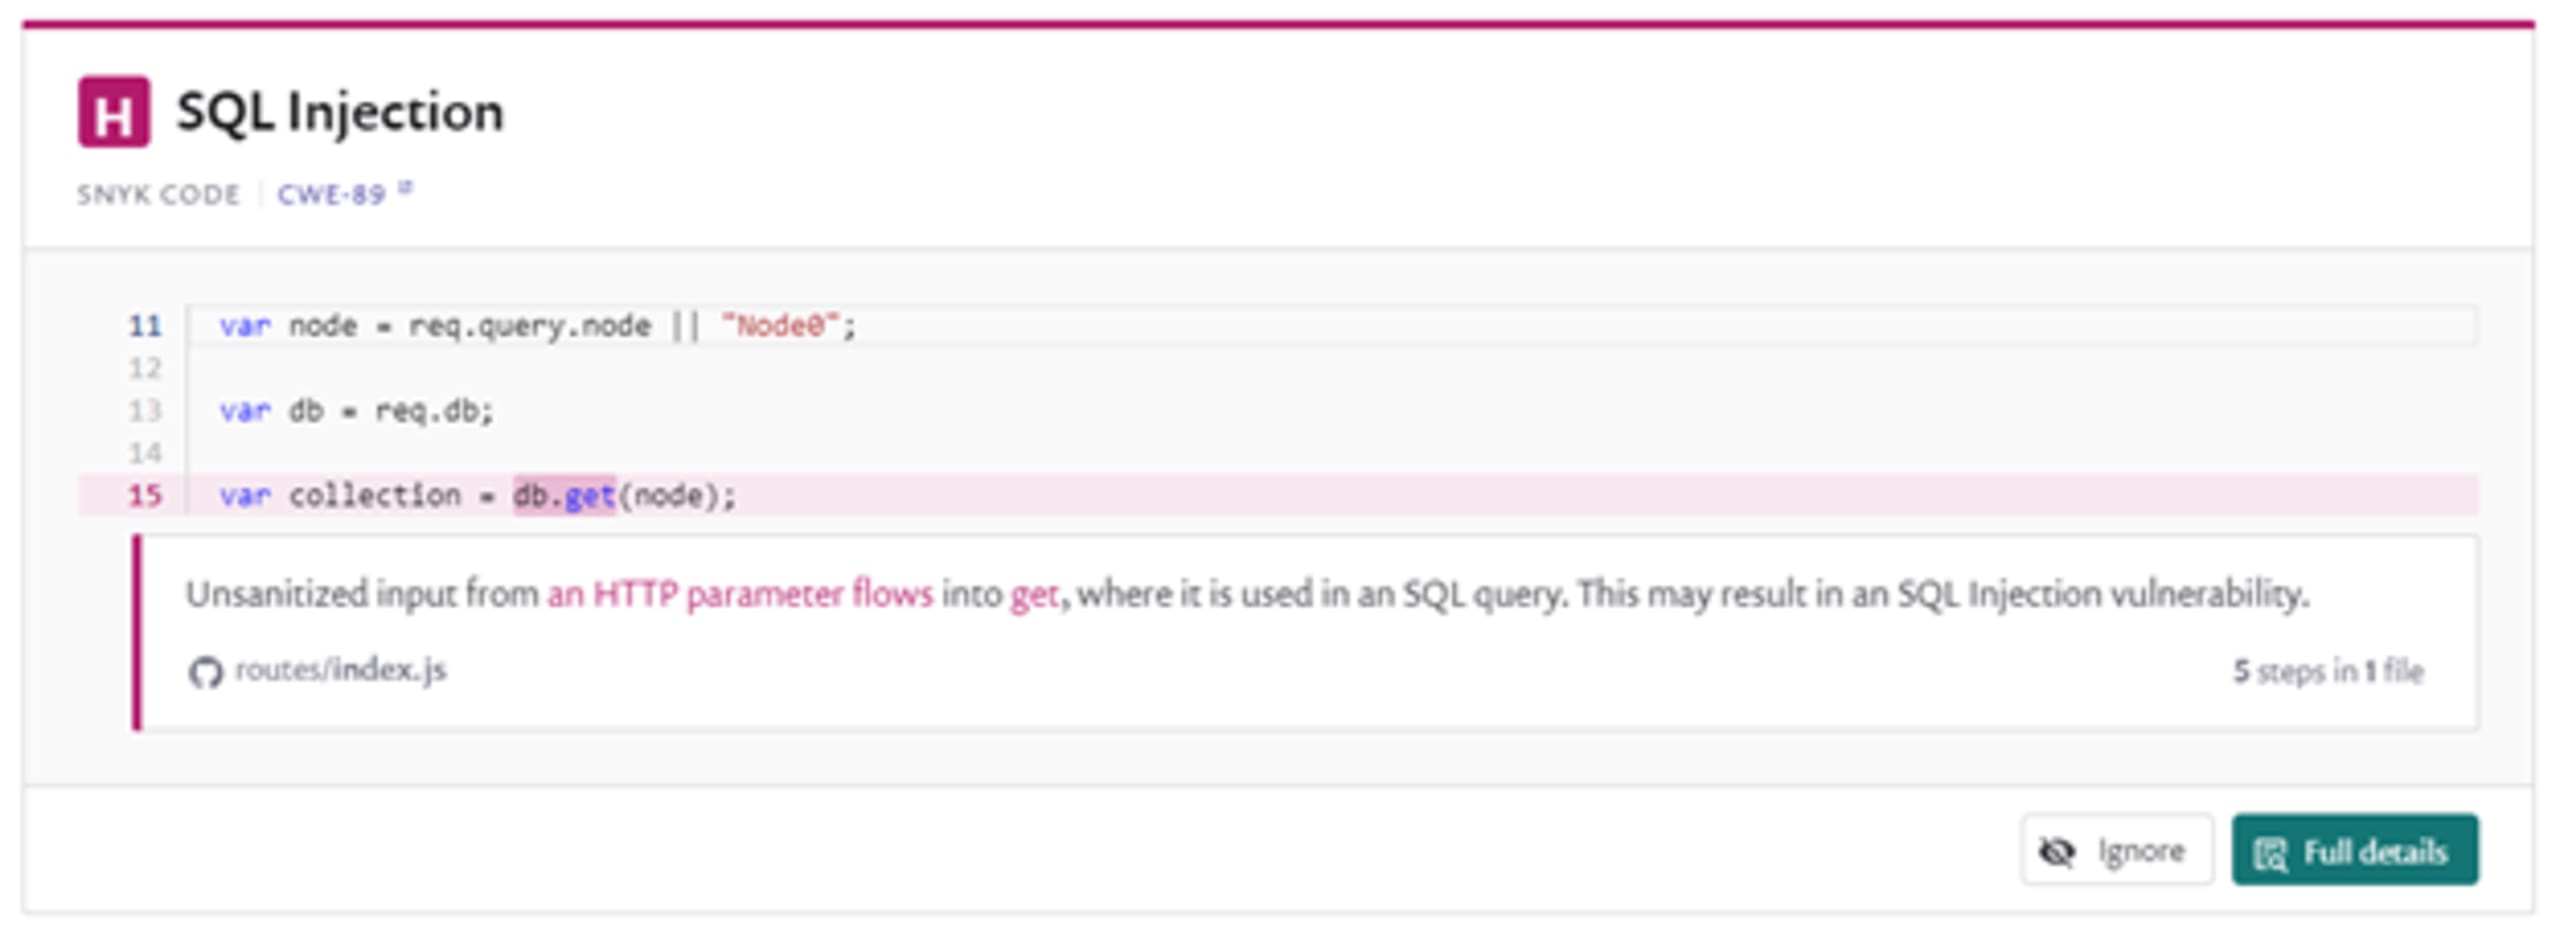
Te permite configurar el motor de pruebas de seguridad de aplicaciones estáticas (SAST). En un momento veremos cómo funciona, pero primero enfoquémonos en cómo usarlo.
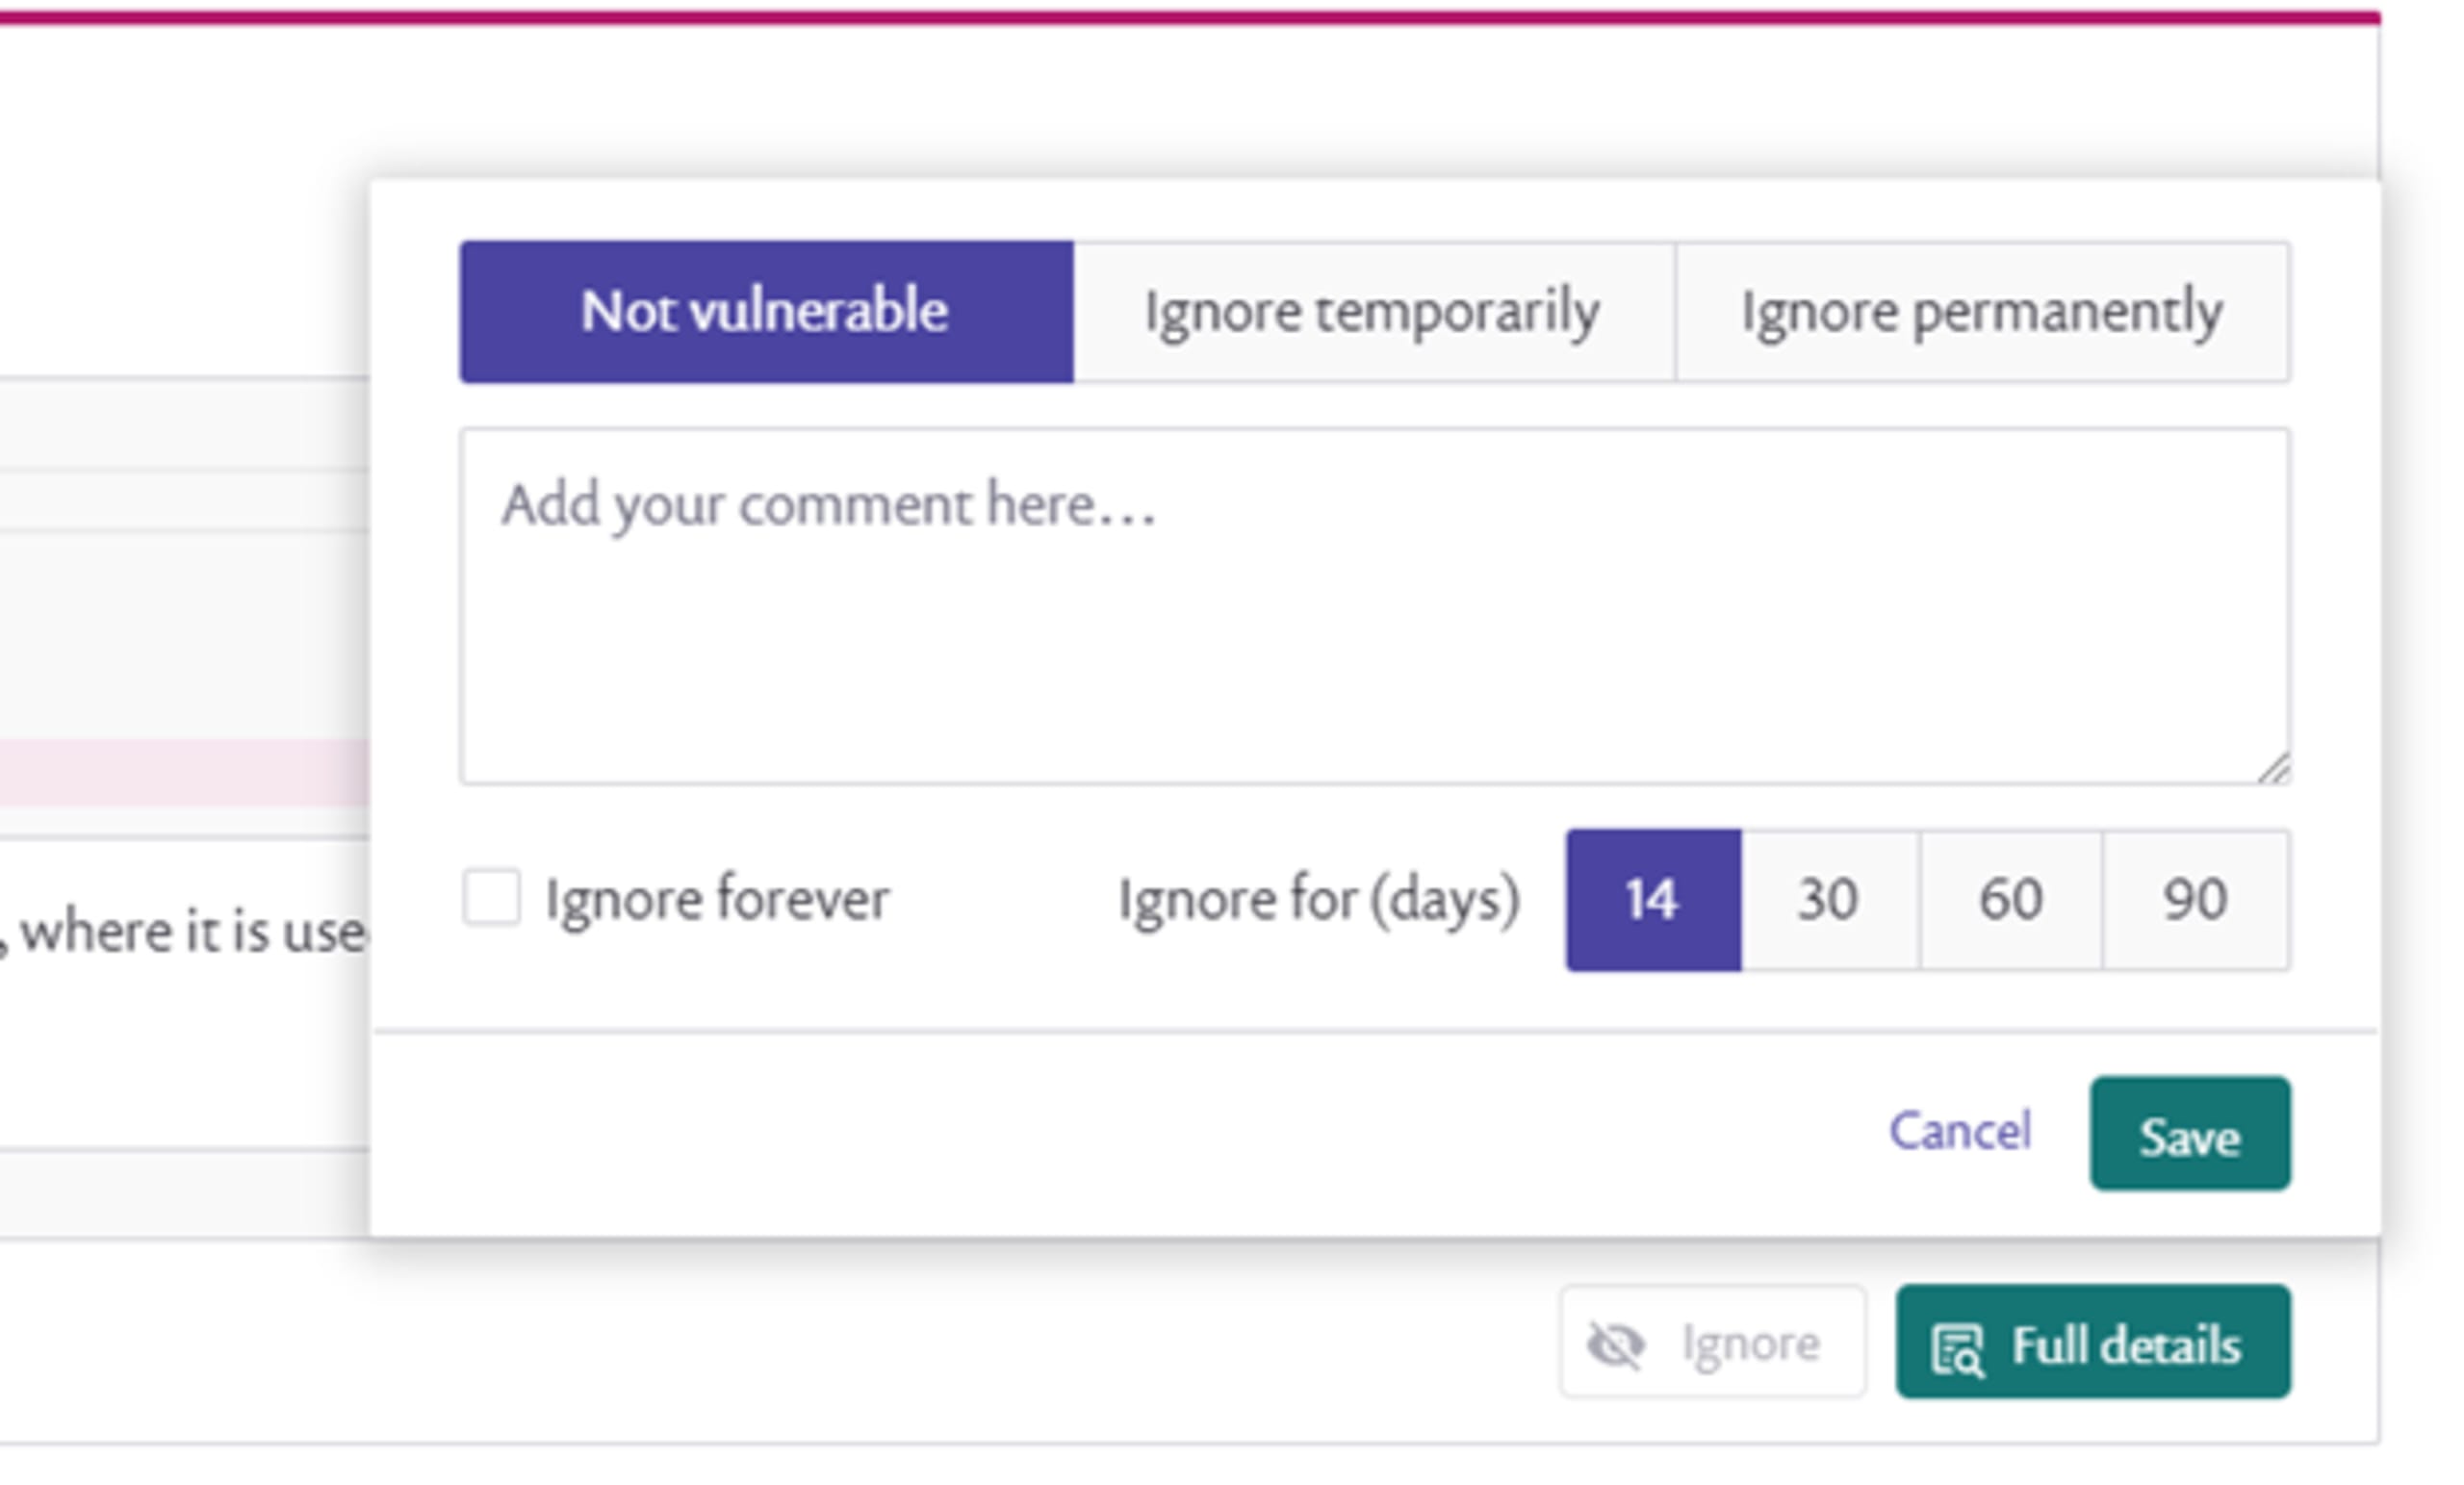
Al hacer clic en Ignorar, verás una ventana superpuesta (como se muestra arriba). El primer paso es clasificar el problema como no vulnerable, ignorar temporalmente (si solo quieres silenciar el mensaje por ahora) o ignorar permanentemente (no se solucionará). Después, puedes escribir un comentario para ti o tus colegas (te recomendamos mucho agregar una breve explicación, porque a veces las decisiones de la semana pasada parecen misteriosas si no hay comentarios). Por último, puedes establecer durante cuánto tiempo ignorar el problema (14, 30, 60 o 90 días, o para siempre).
Si eliges ignorar un problema, no se mostrará de forma predeterminada. A la izquierda hay un selector de estado para los problemas ignorados, desde donde puedes incluirlos (y quitar o editar la marca de ignorado). Para obtener más información sobre esta función, consulta nuestra documentación sobre cómo ignorar problemas en Snyk Code.
Ignorar sugerencias no es tan sencillo como parece
Como es lógico, para marcar algo como ignorado (o excluirlo del informe de problemas), es necesario identificar el problema de forma estable. Cada vez que vuelves a analizar el código, el motor debe encontrar el mismo problema y marcarlo de nuevo. Está claro que el algoritmo no puede simplemente recordar el nombre del archivo y el número de línea, porque el código cambia constantemente y, por lo tanto, también puede cambiar el número de línea. La solución tradicional que usan los linters consiste en agregar un comentario junto al problema para indicarle al sistema que lo ignore. Esa fue también la implementación original que seguimos. Sin embargo, algunos desarrolladores nos comentaron que no les gustaba llenar el código de comentarios solo para configurar el análisis estático. Por eso, se nos ocurrió una solución única y, en nuestra opinión, superior.
Los sistemas tradicionales usan el código fuente donde se produce el problema (y unas pocas líneas a su alrededor), calculan un hash y lo usan como identificador del problema. Si cambia el texto, cambia el ID del problema y se eliminan todas las marcas asignadas a este. Pero los seres humanos pensamos de otra manera. Si agrego un comentario junto al problema, en realidad no he cambiado el problema en sí, pero el hash sí cambia y el problema se considera nuevo.
Para resolver esto, la mayoría de las otras herramientas solo comparan unas pocas líneas del informe. Esto puede hacer que se ignoren informes similares si vuelve a aparecer otro problema con una firma parecida (ignorar de forma demasiado agresiva). También puede hacer que se pierda la coincidencia cuando hay cambios en código no relacionado (lo que genera informes repetitivos). Para ofrecer un mecanismo aceptable, algunas herramientas incluso usan listas de excepciones con decenas de reglas sobre cómo comparar los informes. Ambos enfoques tienen fallas. En esencia, operan a nivel del texto, sin tener en cuenta el analizador que generó el resultado. Es como si trataran las palabras de una oración como una secuencia de caracteres, sin intentar entender su significado.
Cómo implementa Snyk Code la función para ignorar
Una de las cosas que hace el análisis estático de código es transformar el código de entrada en lo que se conoce como una representación intermedia. Se trata de una estructura de datos que captura el flujo de datos o de control del código, pero abstrae algunos detalles. Nuestra idea es usar esta representación para generar el hash. Así, la implementación reconoce el mismo problema incluso cuando refactorizas el código o cambias el nombre de una variable. Además, flexibilizamos los requisitos de coincidencia exacta, de modo que la mayoría de los pequeños cambios en el código que contiene un problema ignorado no provoquen que el informe vuelva a aparecer sin motivo.
Al hacer la comparación a nivel semántico, podemos reconocer el mismo problema que antes, tal como lo haría un desarrollador. Y ya no necesitas comentarios en el código fuente. Por ejemplo, los siguientes dos fragmentos de código, pese a sus diferencias textuales, señalan el mismo problema, ya que solo cambiamos los nombres de las variables:
No ignoraremos tus comentarios
Esperamos que este nuevo enfoque para la funcionalidad de ignorar te resulte más útil. Este es solo un ejemplo de cómo los comentarios valiosos de nuestros usuarios nos permitieron tomar medidas. Cuéntanos qué te parece la nueva función para ignorar y cómo podemos mejorar el producto en el futuro. Nos encanta conocer tus comentarios.
Protege tu código con información de vanguardia
Conoce todas las funcionalidades de SAST de Snyk Code en solo 30 minutos.