RPM Package Manager: análisis de seguridad de paquetes RPM con Snyk

Ivan Stanev
13 de noviembre de 2020
0 minutos de lecturaAl analizar imágenes de contenedores, Snyk puede detectar diversos datos, como la distribución del sistema operativo, el administrador de paquetes de software, las aplicaciones instaladas y todas las dependencias de las aplicaciones. RPM es uno de los administradores de paquetes más comunes del ecosistema Linux y Snyk ofrece compatibilidad total con él.
¿Qué es RPM Package Manager?
RPM se usa en muchas distribuciones de Linux, incluidas Red Hat Enterprise Linux, Fedora, CentOS y otras. Se originó en Red Hat Linux y al principio significaba RedHat Package Manager, aunque ahora es un acrónimo recursivo que significa RPM Package Manager. RPM puede referirse tanto al administrador de paquetes como al formato de archivo rpm que usa para distribuir aplicaciones.
¿Qué formato de datos usa RPM?
Trabajar con RPM Package Manager es particularmente difícil porque no enumera sus dependencias en un formato legible para las personas (como JSON o XML). En su lugar, los paquetes se almacenan en formato binario en una base de datos BerkeleyDB, por lo que resulta imposible leerlos a menos que conozcamos el formato y la estructura binarios correctos tanto de la base de datos como de sus entradas.
Aunque había código abierto disponible para leer la base de datos RPM, no podíamos usarlo fácilmente en Snyk porque nuestra pila tecnológica se basa en Node.js y TypeScript. Es posible compilar y usar vinculaciones de C para BerkeleyDB, pero queríamos evitar el trabajo adicional de la compilación cruzada y el mantenimiento. Además, solo necesitábamos una biblioteca que leyera paquetes RPM, un subconjunto muy pequeño de las funciones que ofrecen RPM y BerkeleyDB.
Gracias a la magia del código abierto, la licencia de BerkeleyDB que se usa en RPM nos permitió leer y modificar el código libremente, así que optamos por recrear la funcionalidad nosotros mismos. Al final, resolvimos el desafío y publicamos una biblioteca de TypeScript totalmente de código abierto que puedes encontrar en nuestro repositorio de Snyk rpm-parser en GitHub.
En esta publicación del blog, quiero compartir cómo lo hicimos y explicar el proceso de diseccionar el funcionamiento interno de la base de datos RPM. ¡Prepárate para manipular bits y bytes a bajo nivel! ?ï¸
¿Cómo es una base de datos RPM?
Sabemos que BerkeleyDB es una base de datos binaria, pero ¿cómo podemos extraer contenido significativo? Los formatos de archivo binarios suelen detectarse examinando el inicio de un archivo, donde puede encontrarse un marcador especial (por ejemplo, un «número mágico») que indica el tipo de archivo. La mejor manera de averiguarlo es leer el código fuente y probarlo con una copia de la base de datos RPM. La base de datos BerkeleyDB que crea RPM se almacena en /var/lib/rpm/Packages, así que nuestro primer paso es inspeccionar su contenido. El código fuente de BerkeleyDB nos muestra que los primeros bytes del archivo contienen lo siguiente:
BerkeleyDB admite varios tipos de bases de datos: B-Tree, Hash (HStore) y Queue, además de otros tipos en las versiones más recientes. Cada tipo de base de datos tiene un número mágico diferente: 0x053162 para B-Tree, 0x061561 para Hash y 0x042253 para Queue. Resulta que todas las bases de datos RPM que abrimos son del tipo Hash, porque encontramos el número mágico 0x061561 a partir del byte 12 del archivo /var/lib/rpm/Packages. Además, type almacena el valor 0x08, que las definiciones de tipos del código fuente enumeran de la siguiente manera:
El campo pagesize y el last_pgno (número de la última página) que aparece después en la definición de tipo nos indican que la base de datos está dividida en páginas del mismo tamaño. Esto también significa que los elementos de datos individuales pueden ocupar varias páginas de la base de datos y que lo más probable es que las páginas no estén en orden (como veremos más adelante al analizarlas).
Resulta que estos metadatos genéricos de la base de datos se comparten entre todos los tipos de bases de datos, por lo que esta sección inicial _dbmeta33 se amplía según el tipo de base de datos. Como solo nos interesa la base de datos Hash, obtenemos los siguientes datos adicionales:
Con nelem (número de elementos) también podemos saber cuántos elementos hay en la base de datos. Sin embargo, iv (vector de inicialización) y chksum (suma de verificación) sugieren que probablemente se usa cifrado.
Si leemos estos bytes y los almacenamos en un objeto de JavaScript que podamos imprimir más tarde, obtenemos algo como esto:
Resulta que RPM no cifra la base de datos, al menos no de forma predeterminada, así que podemos ignorar por completo este caso de uso.
Hasta ahora, tenemos la siguiente vista de la estructura de la base de datos:
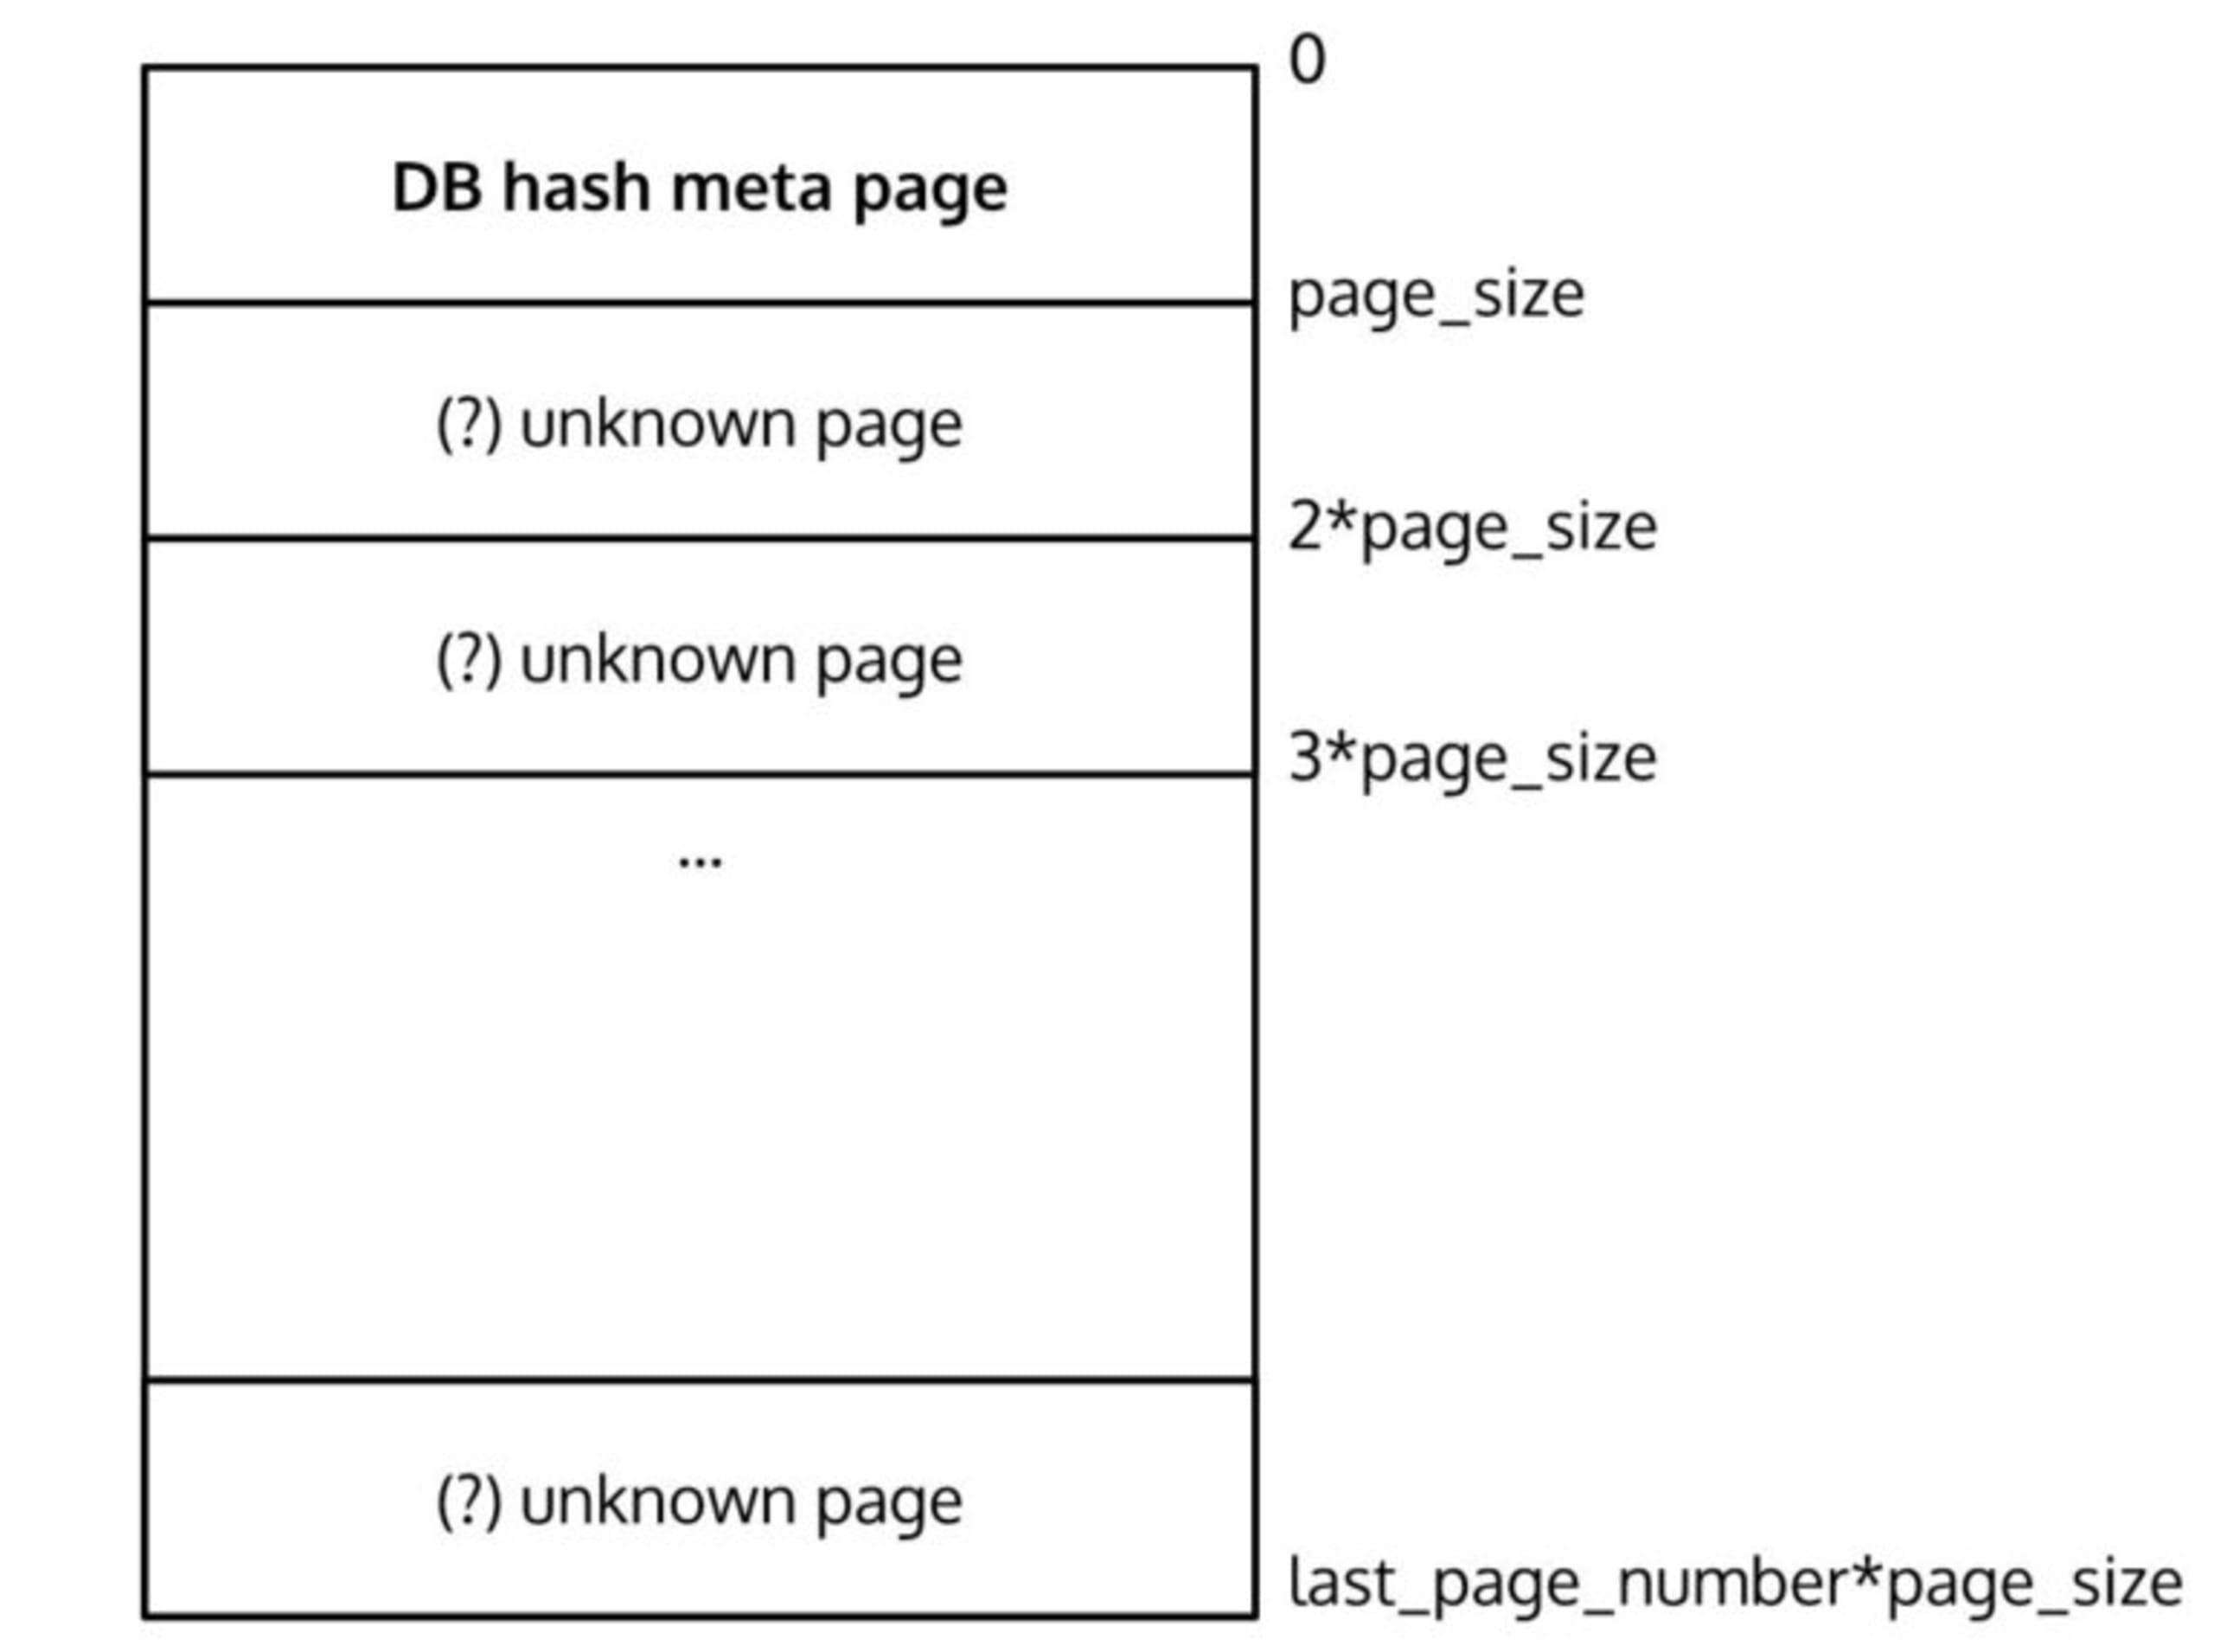
Como una página tiene 4096 bytes y la primera página contiene los metadatos de la base de datos, pasemos a la siguiente página para ver qué tipo de datos podemos encontrar. El código fuente de BerkeleyDB también resulta muy útil y nos indica que debemos esperar la siguiente estructura:
Las definiciones de tipos nos dan el tamaño de cada una de estas entradas. Así, al leer la cantidad correcta de bytes, podemos asignarlos a un objeto de JavaScript y obtener lo siguiente:
Observa type: 13, que indica un tipo de página completamente nuevo, que las definiciones de tipos enumeran como:
prev_pgno y next_pgno tienen el valor 0, lo que significa que los datos (sean cuales sean) están almacenados por completo en esta página y no tenemos que ir a otras páginas para recopilarlos.
Observa el valor de hf_offset. Al revisar todos los datos almacenados en la página, vemos que los bytes alrededor de la posición ~2850 están en cero, lo que coincide con el valor de hf_offset. Esto significa que hf_offset apunta al punto donde terminan los datos de la página. Esto será particularmente útil más adelante, cuando leamos elementos de datos de varias páginas y queramos saber dónde empiezan y dónde terminan.
Así que cada página comienza con un encabezado genérico de 26 bytes y los 4070 bytes restantes están ocupados parcial o totalmente por datos. La página de tipo hash contiene un índice con entradas que apuntan a ciertos bytes o desplazamientos de la página actual. Estos desplazamientos apuntan a datos ubicados en el extremo opuesto de la página. La forma en que se almacenan estos datos en la página hash se parece a la estructura de una pila y un montículo:
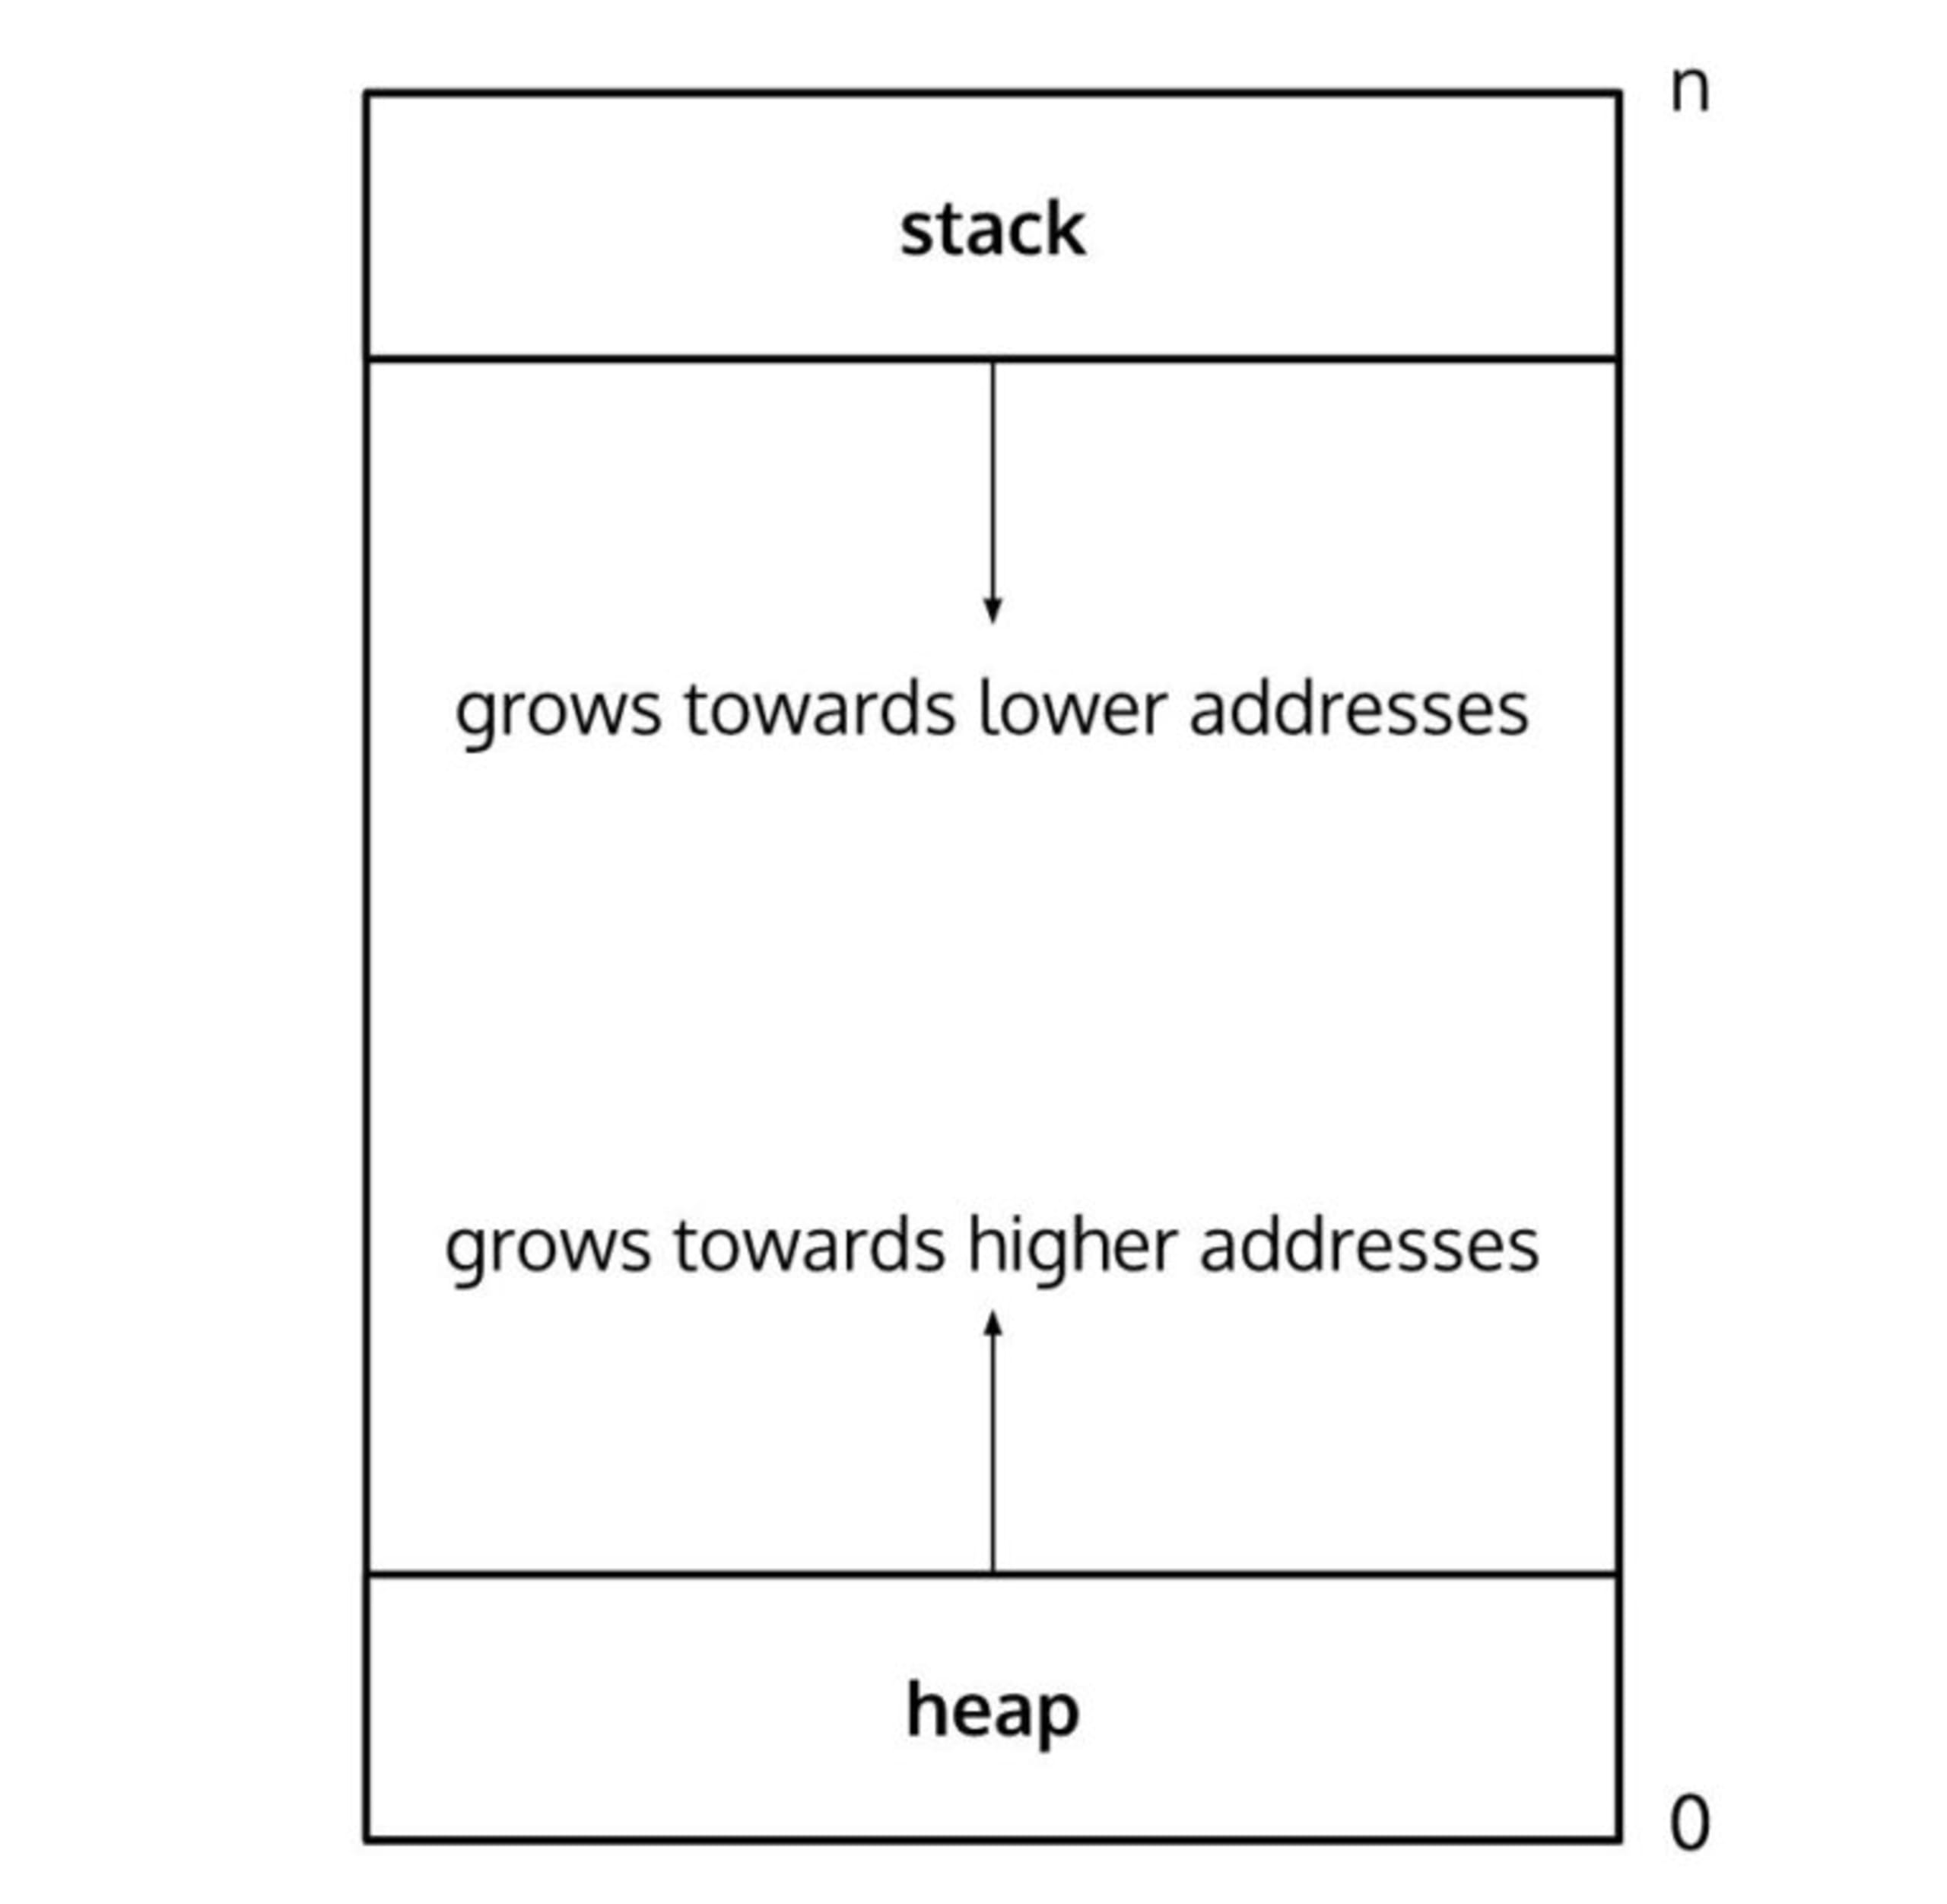
El índice se almacena en la región del montículo de la página, mientras que los datos (a los que apuntan los desplazamientos del índice) se almacenan en la región de la pila.
El índice contiene entradas en pares de claves y valores, enumerados uno tras otro. La clave es un identificador interno de la base de datos; el valor apunta a un desplazamiento dentro de la página actual. Podemos encontrar una definición de tipo que nos ayude a interpretar lo que se almacena en cada desplazamiento:
Con este dato podríamos determinar dónde se almacena esta pieza de información en toda la BerkeleyDB, o al menos dónde comienza. Los datos empiezan en un número de página específico y pueden ocupar varias páginas si su longitud supera el tamaño de página (¿recuerdas el valor de pagesize que leímos en la página 0?).
Hasta ahora, tenemos la siguiente vista de la base de datos:
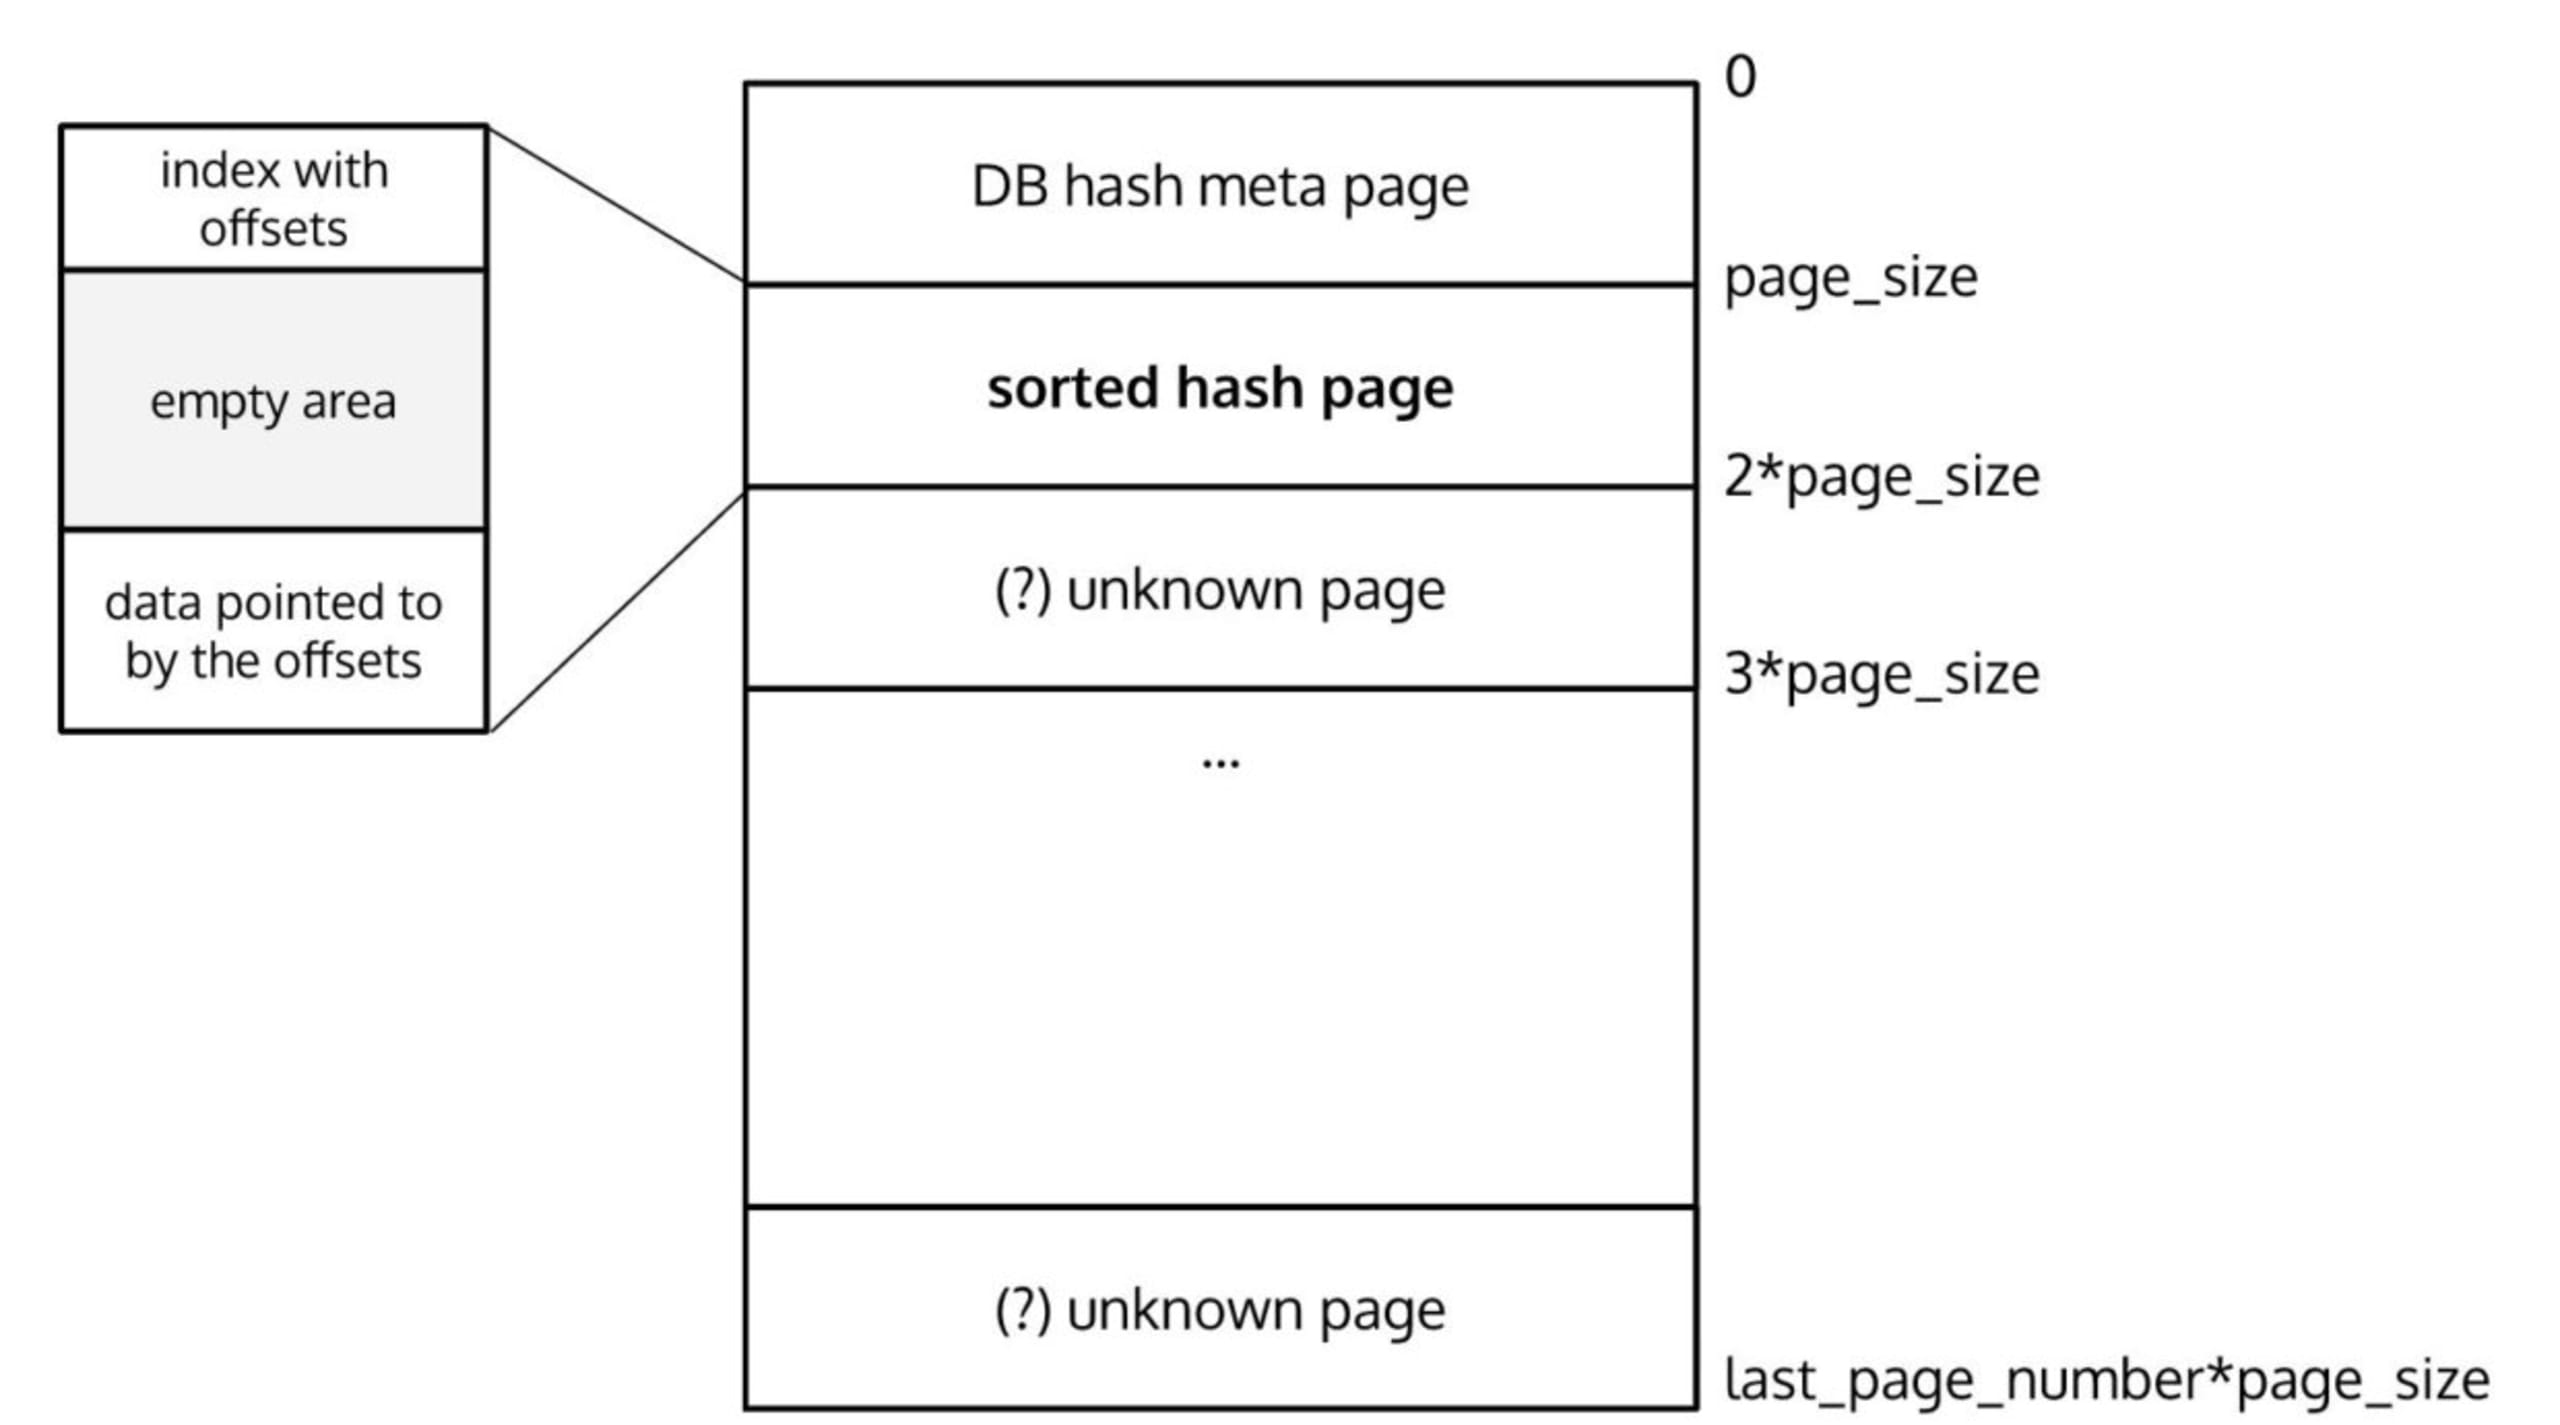
Ahora tomemos una entrada del índice de datos (representada por struct __hoffpage) y echemos un vistazo a la página a la que apunta. Podemos cargar esa página (ya que conocemos su número y el tamaño de cada página) y ver su contenido:
Observa que next_pgno tiene un valor que apunta a la siguiente página, donde se encuentra el resto de los datos. hf_offset tiene el valor 4070, lo que significa que toda esta página está llena de datos (tiene 4070 bytes porque el tamaño de página es de 4096 bytes menos el encabezado genérico de 26 bytes). Por lo tanto, para obtener todos los datos, debemos recorrer varias páginas siguiendo next_pgno y unir todos los bytes.
La vista final de la base de datos es la siguiente:
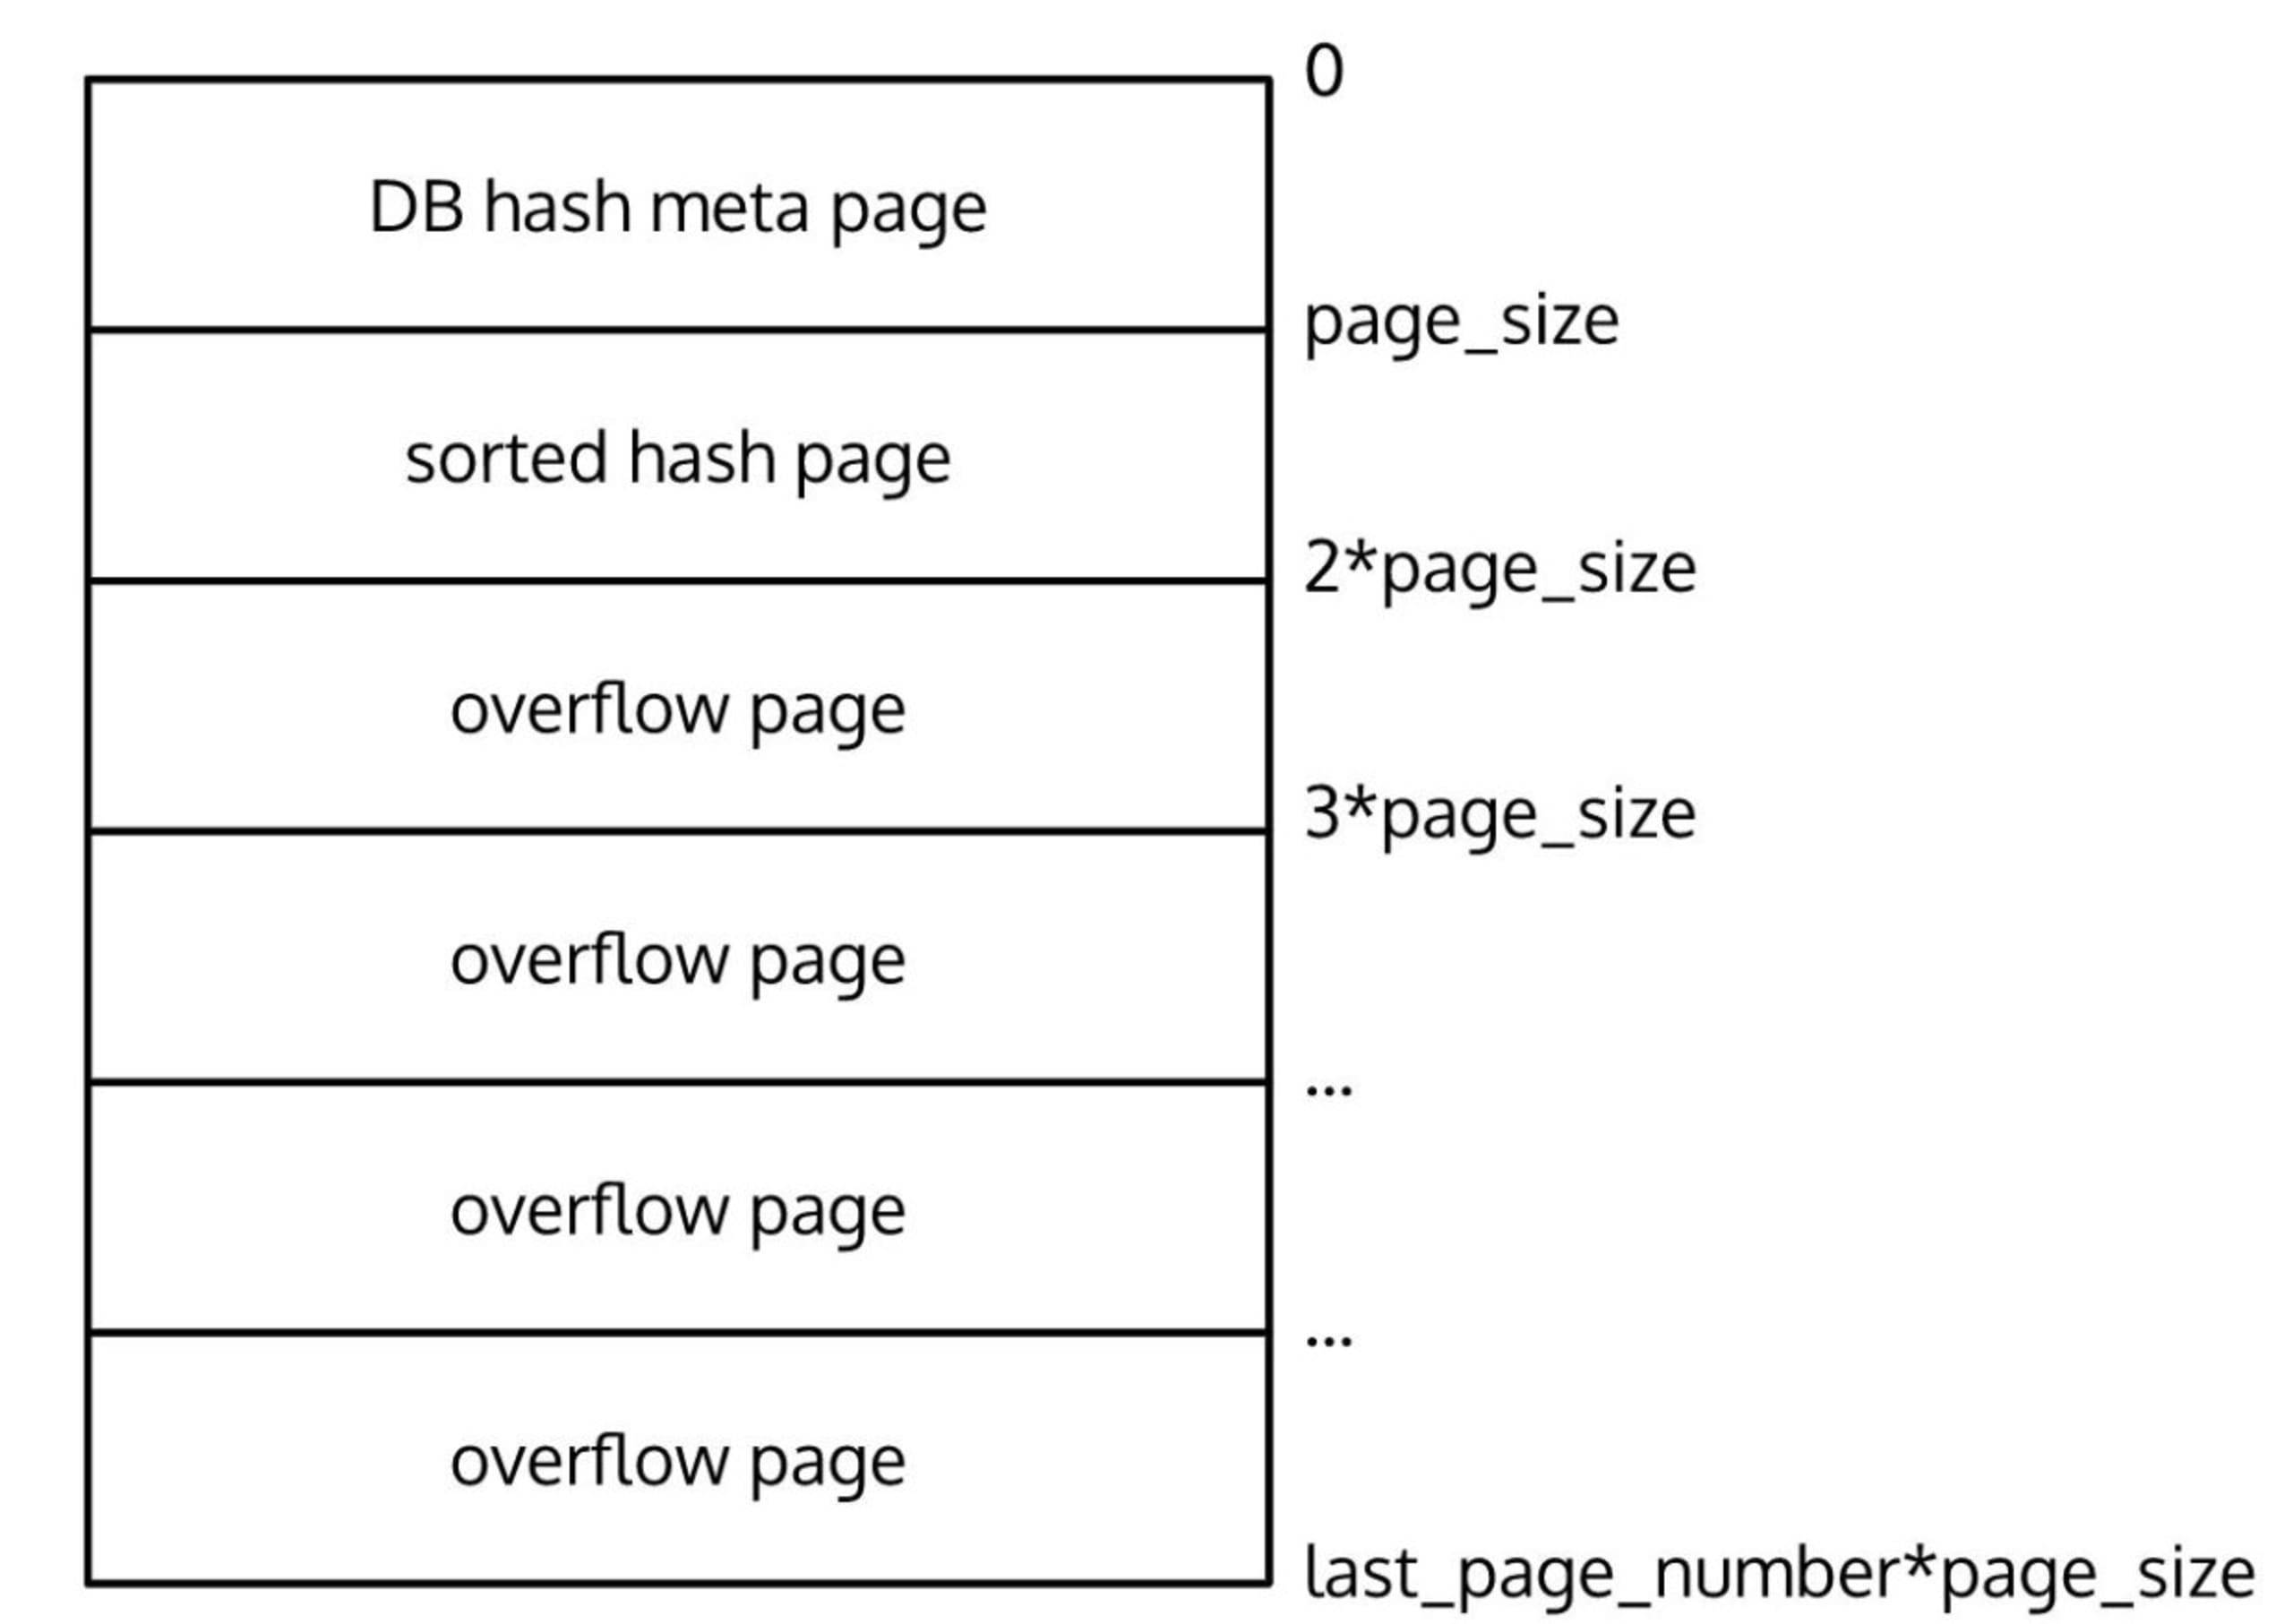
Esto es todo lo que necesitamos saber para poder leer los datos. Una vez que recorremos todas las páginas de desbordamiento conectadas, recopilamos una lista de bloques binarios, que son los paquetes RPM reales. El siguiente paso es leer los paquetes para extraer información como el nombre, la versión y la arquitectura del paquete, entre otros datos.
Análisis de los metadatos de los paquetes RPM
Aquí dejamos atrás el contexto de BerkeleyDB y pasamos al formato de los paquetes RPM y sus metadatos. Para entender cómo es un paquete RPM, consultamos la documentación del formato de archivo RPM.
Un archivo rpm consta de cuatro secciones: un lead, un header de firma, un header de carga útil y una carga útil (los datos reales). Ambas secciones de encabezado tienen el mismo formato. Las secciones siguientes especifican el formato de cada una. En el archivo, aparecen una después de otra, sin información adicional antes, entre ni después de ellas.
Después de algunas pruebas, descubrimos que lo que BerkeleyDB almacena en los bloques binarios son, en realidad, estos dos elementos: un header parcial de carga útil y una carga útil completa. Se omiten por completo el lead y el header de firma. Si consultamos la documentación de RPM, la estructura del header de carga útil es la siguiente:
Resulta que también faltan todas las entradas HMx (número mágico del encabezado), la versión y los bytes reservados. En su lugar, obtenemos un header parcial que incluye indexcount (el número de entradas del índice del encabezado), storesize (el tamaño del almacén de datos en bytes), las entradas del índice y el almacén de datos.
Cabe destacar que los datos se almacenan en formato big-endian, por lo que cada entrada debe leerse e interpretarse explícitamente de esa manera.
Hasta ahora, los bloques binarios que recopilamos de BerkeleyDB se ven así en pseudocódigo:
Podemos leer fácilmente los dos primeros elementos, pero para leer index_entries necesitamos entender su estructura. La documentación del formato de archivo RPM nos indica lo siguiente:
Resulta que cada index_entry tiene 16 bytes. Con este dato y el valor de indexcount, podemos recopilar todas las entradas del encabezado RPM.
Ahora podemos leer todas las entradas del índice en JavaScript y generar una lista similar a la siguiente:
Al consultar la documentación de RPM, vemos una tabla que indica qué representa cada valor de tag. Las etiquetas especifican información del paquete, como el nombre (1000), la versión (1001), la arquitectura (1022), entre otros datos. La documentación de RPM también especifica type, y vemos entradas como string (6), int32 (4) e incluso el tipo null (0).
Ahora, con offset, podemos saltar al inicio de los datos de cada una de estas entradas. Debemos tener cuidado de incluir también indexcount en el cálculo del desplazamiento para llegar al punto donde se encuentran los datos. Según el valor de type, podemos procesar de una manera determinada el arreglo de bytes que encontramos a continuación. Por ejemplo, para los tipos string, podemos leer la secuencia de bytes hasta llegar a un byte 0, que corresponde al final de la cadena (como es habitual en el software de estilo C). En cambio, si tenemos un tipo int32, sabemos que debemos leer solo 4 bytes.
Con toda esta información, podemos recorrer todas las entradas del índice y, finalmente, extraer suficientes datos del paquete para crear una dependencia. Aquí tienes un ejemplo de una entrada:
Al repetir el mismo proceso para todos los bloques de BerkeleyDB, podemos extraer la información de todos los paquetes y generar la lista de dependencias.
Resumen
Profundizamos en el funcionamiento interno de RPM Package Manager para entender la estructura binaria de los datos y cómo se representa internamente la información sobre los paquetes instalados. Este es exactamente el mismo proceso que usa Snyk para leer y entender la lista de dependencias de tus imágenes de contenedores. Snyk es gratis, y puedes crear una cuenta. También puedes consultar nuestra biblioteca de código abierto, el analizador RPM en GitHub, que hace todo este trabajo pesado.
Empieza con los desafíos de Capture the Flag
Aprende a resolver desafíos de captura la bandera con nuestro taller virtual introductorio a pedido.