Cómo la nube transforma la seguridad de TI en seguridad de aplicaciones

12 de marzo de 2020
0 minutos de lecturaLa computación en la nube representa, sin duda, un cambio sísmico en el mundo de la tecnología, pues permite alcanzar niveles de eficiencia e innovación sin precedentes. Sin embargo, también impulsó otro cambio clave del que no se habla con frecuencia: la nube hizo que la infraestructura pasara a formar parte de la aplicación.
Este cambio tiene importantes consecuencias para la forma en que practicamos la seguridad. En general, las herramientas y prácticas de seguridad actuales están diseñadas para los equipos centrales de TI y seguridad, y se adaptan a sus habilidades y entornos. En las aplicaciones en la nube, son los desarrolladores, no el área de TI, quienes toman decisiones sobre el acceso a la red, la aplicación de parches al sistema operativo, los permisos de acceso y otros aspectos. Las decisiones se toman individualmente para cada aplicación, no de forma centralizada. Y se toman constantemente como parte del proceso de desarrollo, no en etapas específicas de revisión.
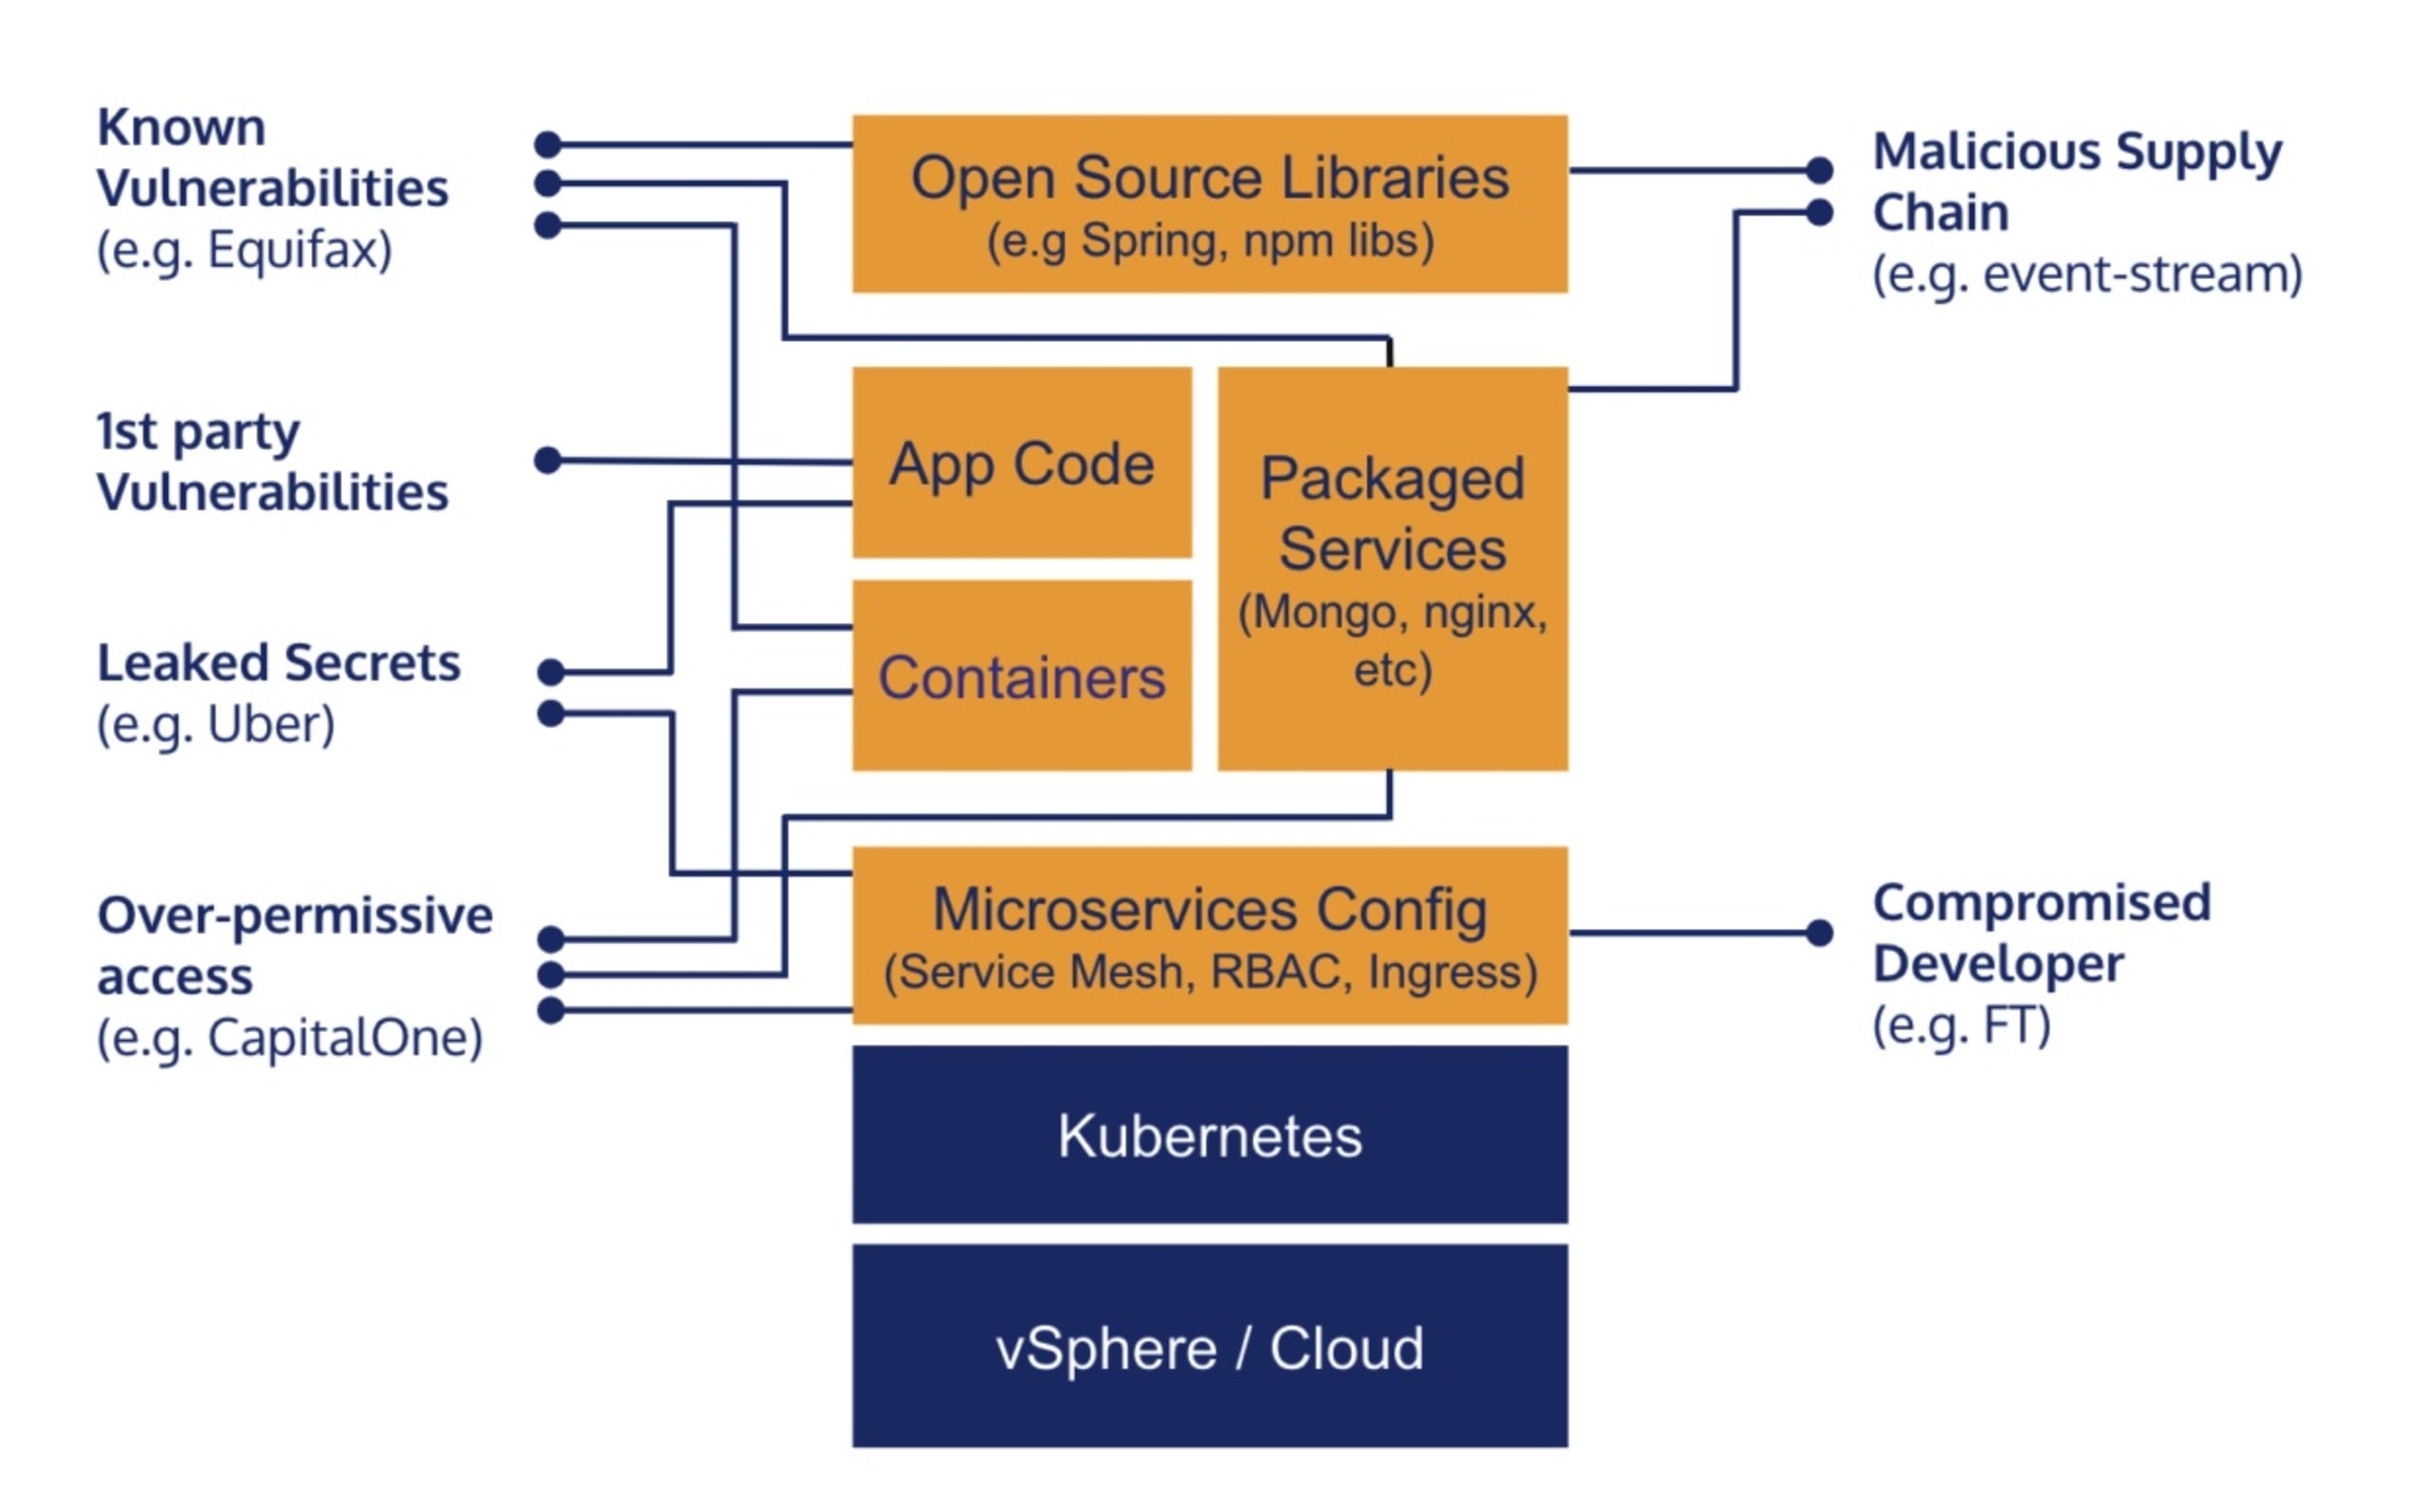
Y, sin embargo, las consecuencias de estas decisiones para la seguridad siguen siendo las mismas. Un puerto abierto puede comprometer una VPC en la nube, igual que podría hacerlo con un segmento de red de un centro de datos. Un contenedor sin parches puede ser vulnerado, al igual que una máquina física. Los mismos riesgos siguen vigentes y, a menudo, se amplifican por el alcance de la aplicación.
Por eso, debemos replantearnos cómo abordar estas amenazas, pero esta vez desde el contexto de las aplicaciones: distintos equipos, procesos y habilidades. En esta publicación, describo cómo el alcance de las aplicaciones se amplió hasta incluir la infraestructura y profundizo en las consecuencias para la seguridad. Creo que esta perspectiva es útil para diseñar tus prácticas de seguridad, elegir tus herramientas y organizar tus equipos.
Nota de estilo: Uso la palabra “nube” para referirme no solo a la computación en la nube, sino también a los contenedores, la tecnología sin servidor y muchas otras tecnologías posteriores. También hablo de la etapa “antes y después” de la nube, aunque en la práctica pocas empresas están en una etapa intermedia. Esta visión simplificada es intencional: busca ayudar a entender el panorama general. ¡Sé muy bien que este es un tema complejo!
Las aplicaciones en la era anterior a la nube
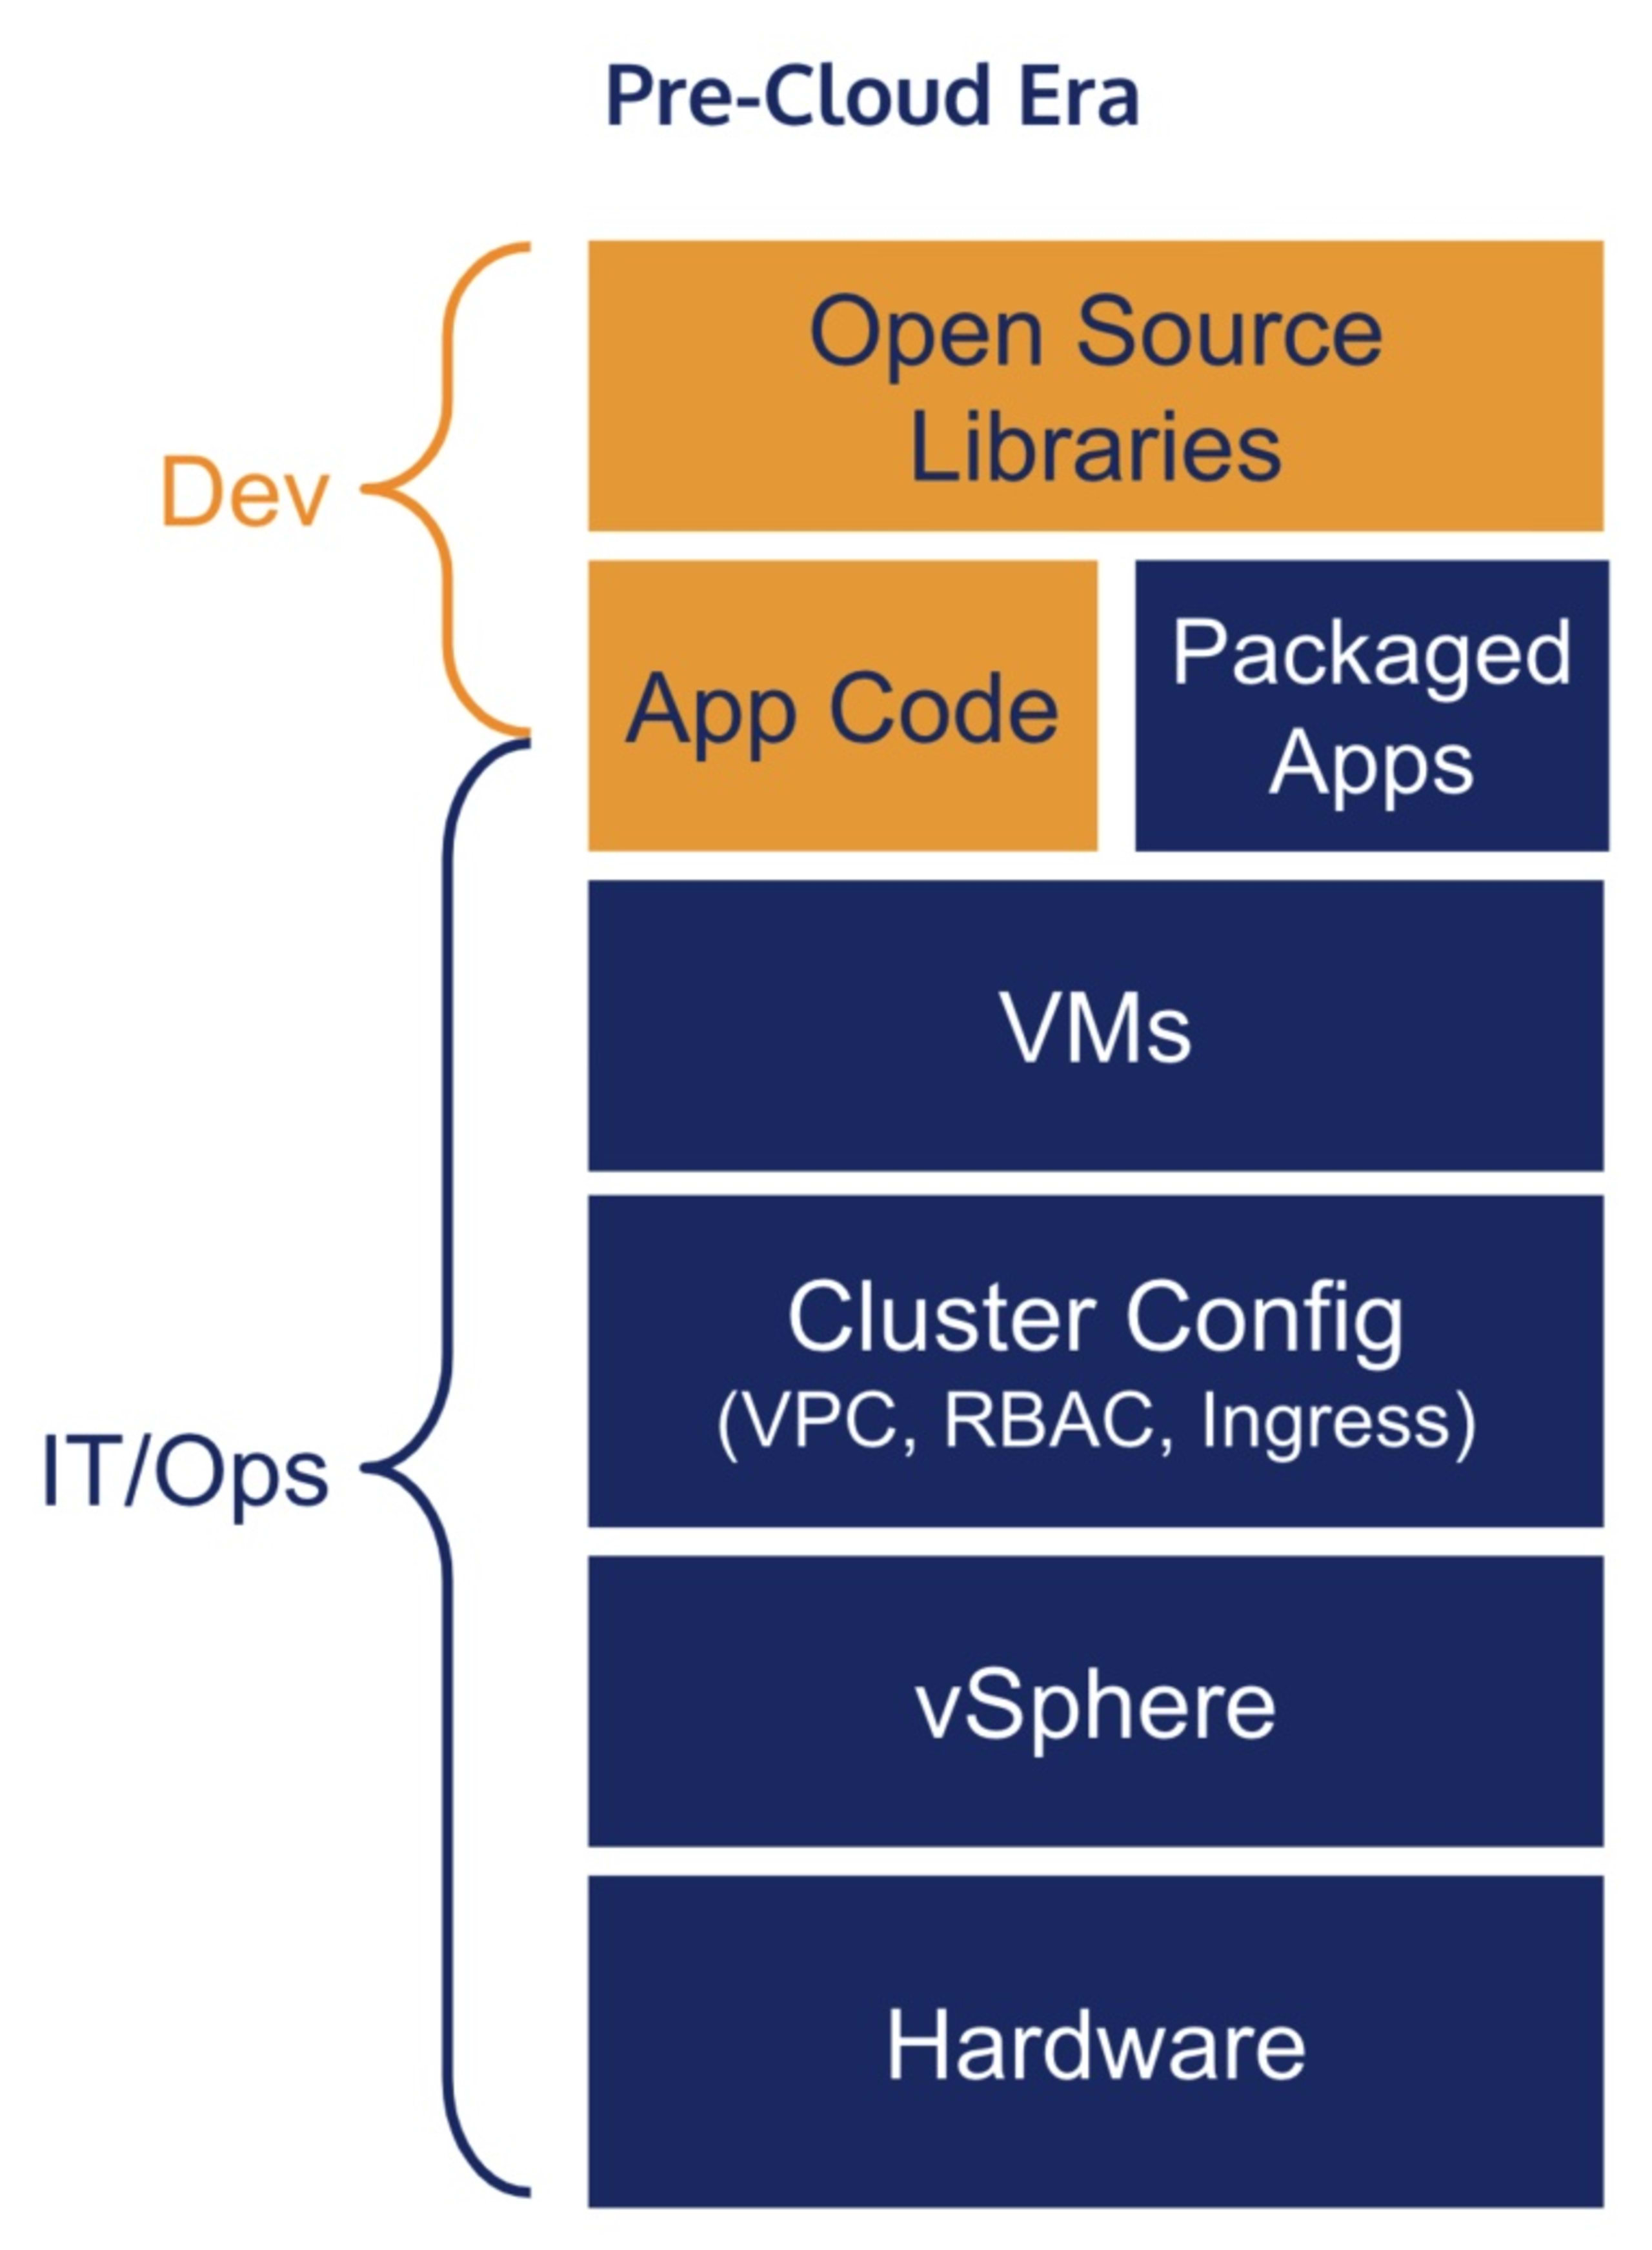
Antes de la nube, las aplicaciones se construían sobre una amplia pila de TI. Me referiré a este período en pasado, aunque en la práctica la mayoría de las empresas aún operan principalmente de esta manera.
Había un centro de datos donde el área central de TI administraba cuidadosamente la capacidad y asignaba los recursos. Las empresas tenían que gestionar el espacio en los racks, comprar servidores y ponerlos en funcionamiento, gestionar las fallas de hardware y llevar un registro de quién usaba cada servidor. Si una aplicación necesitaba un servidor, se requerían trámites y aprobaciones, ya que agregar otro servidor implicaba gastar más dinero o dejar a otra persona sin uno.
Cuando llegó la virtualización, se incorporó otra capa de TI —por lo general, vSphere— para administrar las máquinas virtuales sobre las físicas. Esto aumentó la eficiencia, pero no cambió el proceso fundamental: la capacidad seguía siendo limitada y compartida, así que para obtener un servidor había que abrir un ticket, y un equipo central de TI debía administrar tanto la capacidad de los servidores como la capa de virtualización.
Además de los servidores, el área de TI también administraba las redes. Estas se configuraban con switches y routers físicos y se enfocaban menos en la capacidad y más en los controles de acceso: qué usuarios podían acceder a la red y qué redes podían conectarse entre sí. Las redes suelen ser complejas, así que, una vez más, el área central de TI desempeñaba un papel clave al administrar los complejos permisos de comunicación en todo el centro de datos y asignar el ancho de banda.
Además del hardware, el área de TI también administraba los recursos centrales. Uno de ellos eran las imágenes maestras de las máquinas virtuales. Estas VM maestras contenían software aprobado, examinado por motivos legales, de seguridad y de calidad general. El área central de TI también supervisaba estas VM y las actualizaba para corregir vulnerabilidades o adaptarlas a cambios en las políticas corporativas. Las aplicaciones se instalaban sobre estas VM, a menudo de forma manual, y se reiniciaban cuando era necesario para aplicar esas actualizaciones.
Los servicios administrados eran otro ejemplo de un recurso central. Por ejemplo, es posible que el área de TI administrara una gran base de datos central de Oracle que las aplicaciones necesitaban para funcionar. Uno o más administradores de bases de datos (DBA) se encargaban de los índices y las tablas, y colaboraban con los distintos equipos de aplicaciones para ajustarlos a sus necesidades.
Por encima de todo eso estaba la propia aplicación. Las aplicaciones se componían de código y bibliotecas, y debían implementarse en entornos muy específicos para funcionar. Cualquier cambio en el hardware, las VM base, el uso de bases de datos, la CDN u otros aspectos requería abrir un ticket y esperar.
En aquel entonces, esto tenía sentido porque los recursos eran limitados y debían compartirse. Agregar capacidad física —ya fueran servidores, redes o almacenamiento— llevaba mucho tiempo y costaba mucho dinero. Implementar o ampliar una aplicación central requería un esfuerzo considerable del área central de TI, otro recurso compartido cuya capacidad aumentaba de forma lenta y costosa. Así, si una aplicación obtenía una mayor parte, otra recibía menos: un juego de suma cero.
Las aplicaciones en la era posterior a la nube
Entonces llegó la nube y eliminó estas limitaciones.
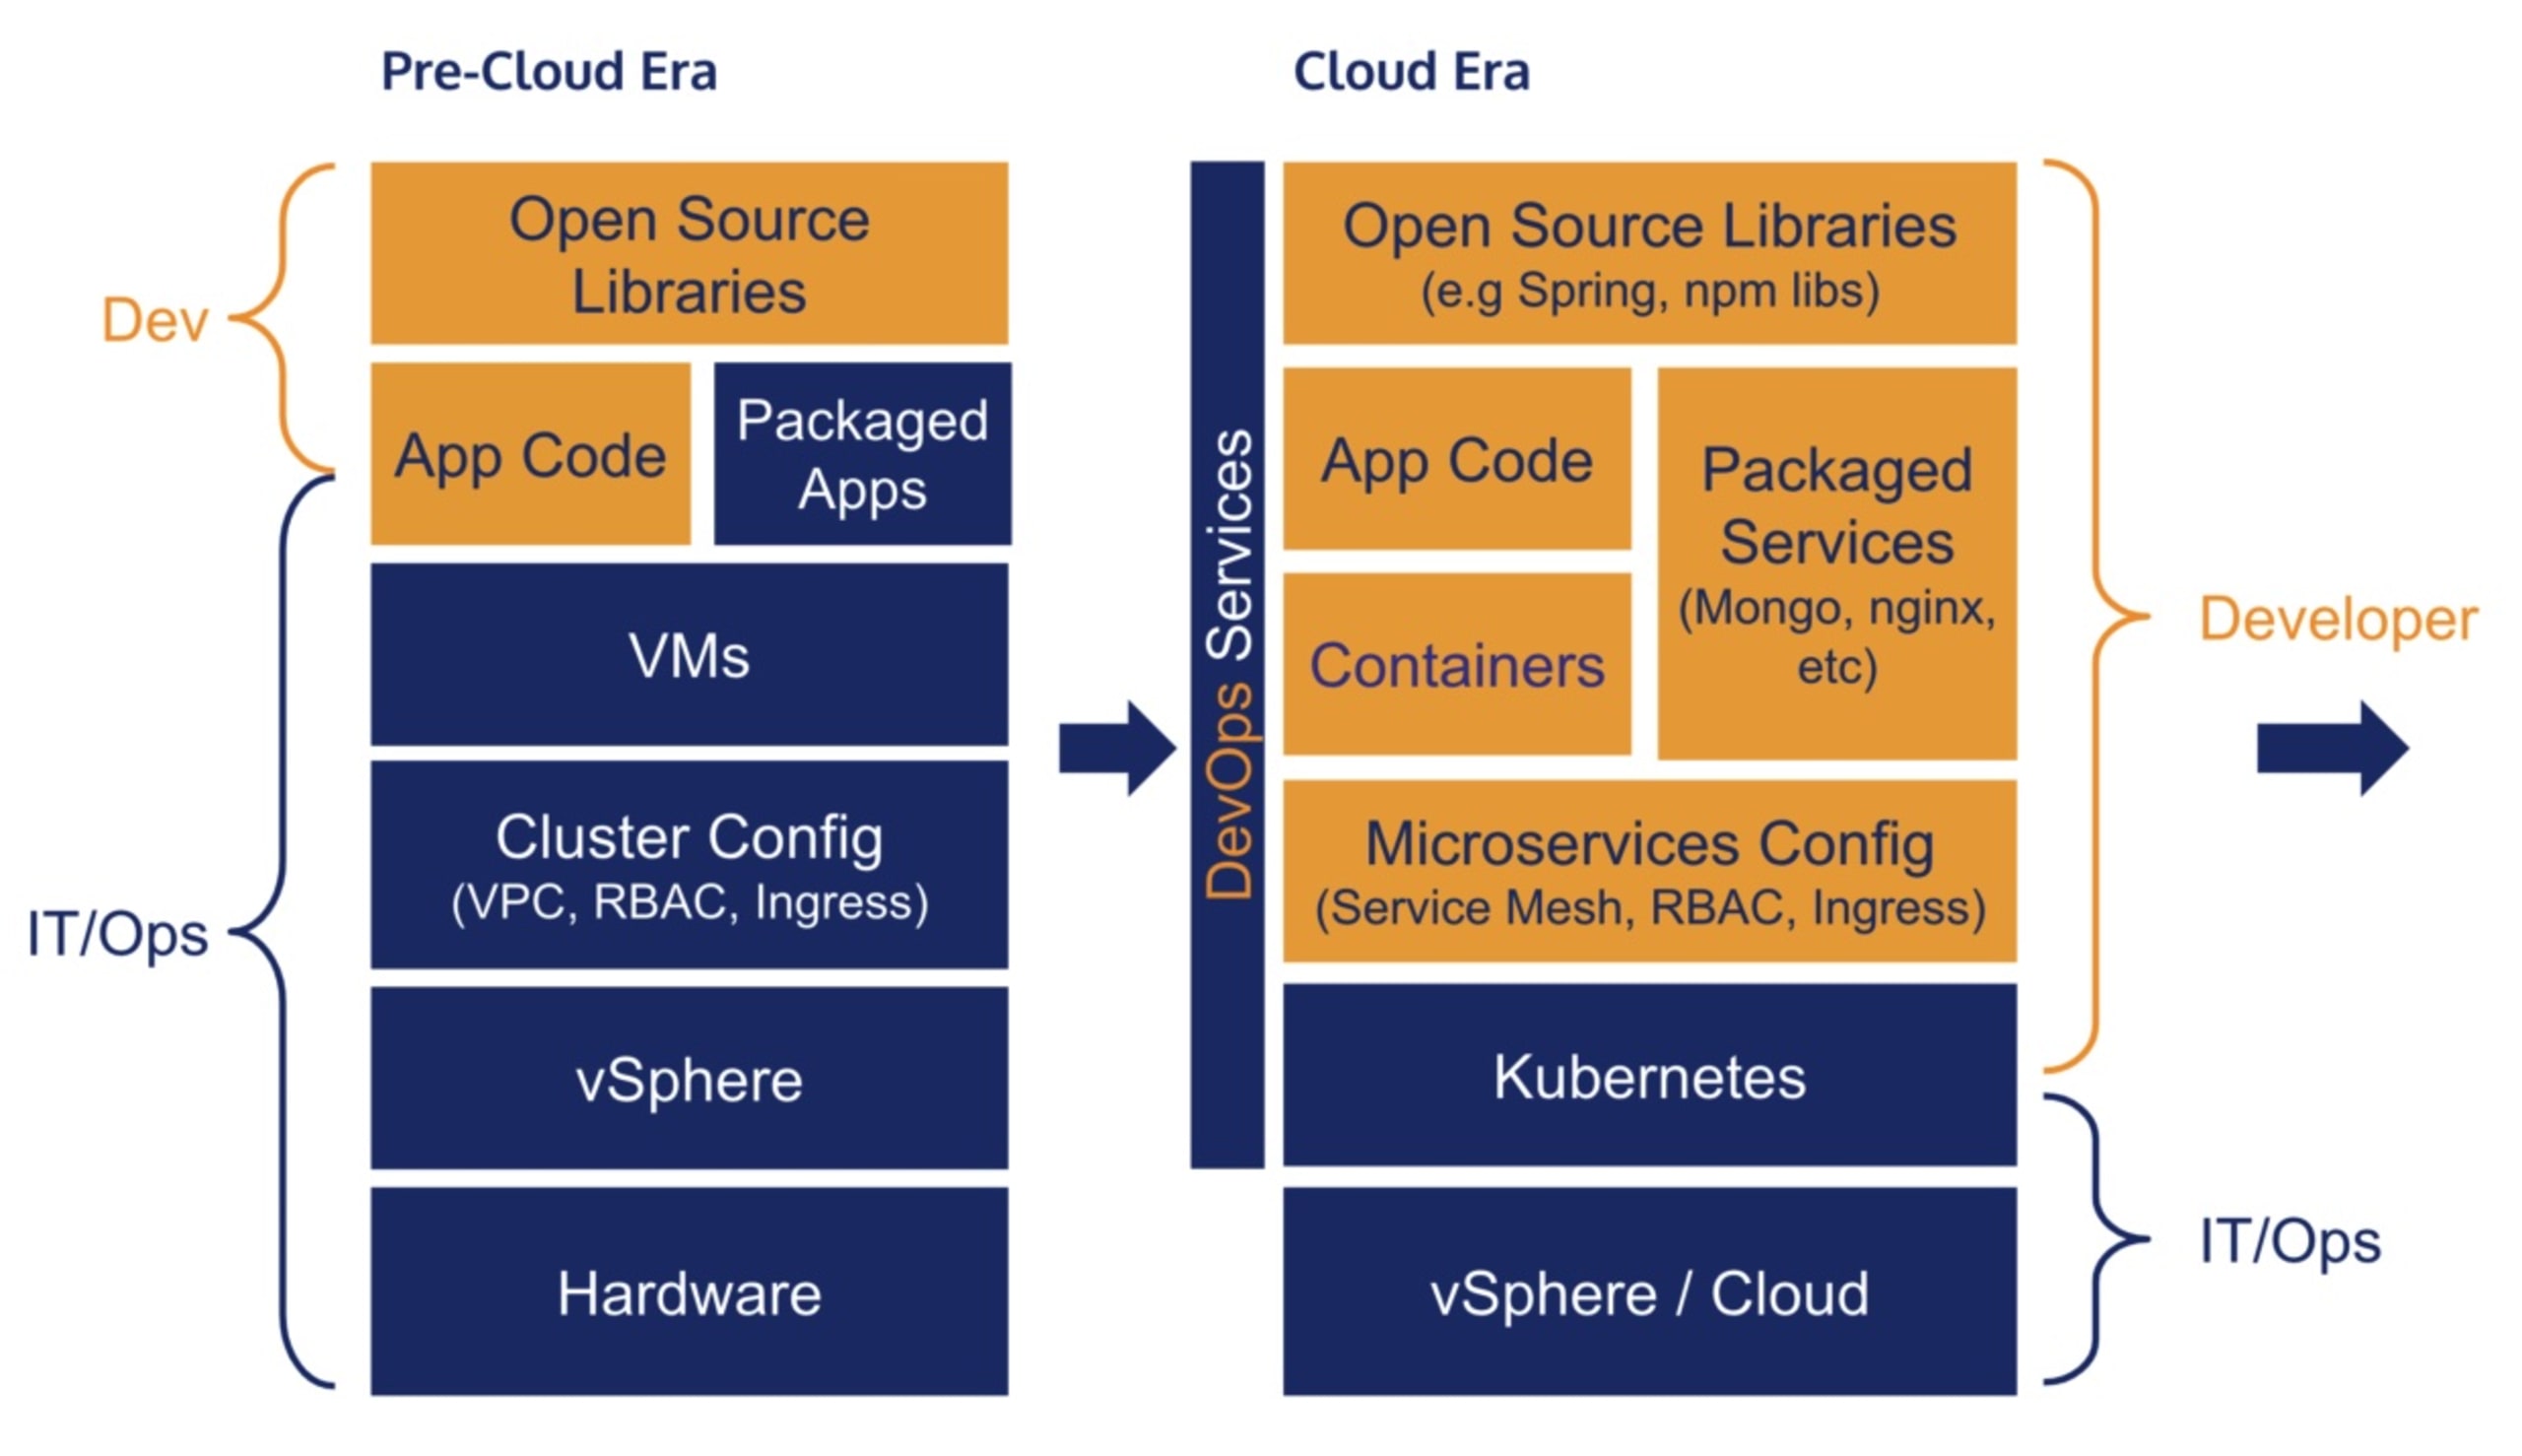
La capacidad de hardware dejó de ser un problema. Los desarrolladores solo necesitan acceso a una cuenta en la nube y pueden aprovisionar tantos servidores como permita su presupuesto. Estos servidores aumentan o disminuyen su capacidad de forma flexible mediante controles de autoservicio basados en software, sin intervención del área central de TI.
Las redes ya no dependen de un equipo central. Los equipos de aplicaciones pueden crear su propia nube privada virtual (VPC), y la plataforma en la nube se encarga de mantenerla aislada del resto. El acceso a estas redes se configura de forma granular, según las necesidades de la aplicación, y exclusivamente mediante software, en modalidad de autoservicio.
Aunque las VM en la nube se administran de forma menos centralizada que sus antecesoras en los centros de datos, los contenedores rompieron por completo ese vínculo. Las instrucciones para crear contenedores suelen definirse en un repositorio de código fuente y compilarse junto con la aplicación, lo que dificulta que el área central de TI pueda verlos y hace prácticamente imposible que les aplique parches. Incluso las “imágenes maestras” administradas de forma centralizada pierden atractivo, ya que los parches aplicados a esas imágenes no entran en vigor hasta que se vuelve a compilar una aplicación, y los desarrolladores dependen cada vez más de imágenes base externas.
Las aplicaciones centrales fueron reemplazadas por servicios fáciles de usar, integrados en la plataforma de la nube, como bases de datos, autenticación, mensajería y muchos más. A diferencia de la mayoría de las aplicaciones centrales, estos servicios se basan en API y están diseñados para que los equipos de desarrollo puedan aprovisionarlos y consumirlos por cuenta propia. Los contenedores empaquetados reemplazaron a las aplicaciones más pequeñas: se consumen fácilmente desde Docker Hub y pasan a ser otro microservicio dentro de la topología de la aplicación. En ambos casos, ya no hace falta abrir un ticket y esperar a que el área de TI aprovisione recursos limitados para la aplicación.
Por último, se crearon los equipos de DevOps (a veces llamados SRE o de plataforma), que reemplazaron al área central de TI con equipos de operaciones alineados. Estos equipos no intentan controlar la infraestructura que usan las aplicaciones; más bien, proporcionan herramientas y servicios, como Kubernetes, que permiten a los desarrolladores operar de manera independiente estas capas de infraestructura integradas en sus aplicaciones.
Proteger la infraestructura como aplicación
Con el tiempo, la nube elimina la necesidad de la mayor parte de la infraestructura administrada de forma centralizada. En su lugar, esa infraestructura pasa a formar parte de la propia aplicación. Es inevitable que esta tendencia continúe, ya que las CDN, las puertas de enlace de API, el middleware y otros elementos se incorporan a la aplicación, lo que aumenta la independencia y la velocidad del equipo de desarrollo. Este cambio comenzó en la nube pública, pero en la práctica también se extendió a la nube privada, que imita las mismas prácticas.
Sin embargo, los problemas de seguridad no han desaparecido.
Un contenedor sin parches puede ser vulnerado tan fácilmente como una VM descuidada o una máquina física. Un puerto abierto sin necesidad puede dar acceso a un atacante a datos confidenciales, sin importar dónde estén alojados; además, los datos sin cifrar en una base de datos pueden quedar comprometidos muy rápidamente, sobre todo si están almacenados en un servicio compartido. Se aplican los mismos vectores de ataque y debemos prestar atención a esos problemas de seguridad mientras tomamos medidas para proteger nuestras aplicaciones.
Lo que debe cambiar es cómo nos defendemos de estas amenazas a la infraestructura.Las soluciones y prácticas actuales están diseñadas para los equipos centrales de TI, no para los equipos de aplicaciones independientes. A veces se adaptan para que equipos separados puedan usarlas, pero es poco común que realmente respondan a ese caso de uso.
Debemos adoptar una nueva perspectiva, basada en esta nueva realidad de la “infraestructura como aplicación”. Repensar las cosas es una tarea importante y no puedo resumirla en unos pocos puntos sencillos, pero aquí tienes algunos ejemplos de cambios que puedes considerar:
Replantea la estructura de tu organización de seguridad para proteger los productos en la nube. La seguridad de las pilas de TI se diseñó para ser un buen socio de la estructura organizativa de TI, pero la seguridad de las pilas de aplicaciones debe estructurarse para trabajar con la organización de desarrollo. Tengo mucho más que decir sobre este tema, pero probablemente le dedicaré una publicación propia…
Comprende las necesidades de los desarrolladores de aplicaciones. Dedica tiempo a entender su realidad, no solo su tecnología, y procura adaptar tus prácticas, herramientas y expectativas a ella. Las prácticas recomendadas del sector suelen basarse en las necesidades de TI, no en las de desarrollo, así que no confíes ciegamente en ellas.
No des por sentado que tus soluciones anteriores a la nube son adecuadas para las aplicaciones en la nube. Aunque usar las mismas herramientas en tus pilas antiguas y nuevas es conveniente, es poco probable que funcionen bien en ambos contextos. Revisa qué otras herramientas ofrece tu proveedor —o qué ofrecen otros proveedores— y elige la adecuada para el entorno de nube.
Invierte en herramientas de seguridad flexibles, basadas en API y de autoservicio. Los equipos de TI son una función central, por lo que puedes dedicar más tiempo a las integraciones personalizadas. Los equipos y las pilas de desarrollo varían mucho más. Invierte en herramientas que se adapten a distintos entornos y, al mismo tiempo, ofrezcan controles y gobernanza de seguridad similares.
Esta transición no ocurrirá de la noche a la mañana. Dentro de una década, las aplicaciones anteriores a la nube se considerarán heredadas, al igual que hoy los entornos de mainframe, junto con sus controles de seguridad heredados. El momento de empezar a crear una nueva generación de seguridad es ahora.