Ataques de desbordamiento de búfer en C++: una guía práctica

Snyk Security Research Team
28 de julio de 2022
0 minutos de lecturaUn desbordamiento de búfer es un tipo de error en tiempo de ejecución que permite que un programa escriba más allá del final de un búfer o arreglo —de ahí el nombre «desbordamiento»— y corrompa la memoria adyacente. Como ocurre con la mayoría de los errores, un desbordamiento de búfer no se manifiesta cada vez que se ejecuta el programa. En cambio, la vulnerabilidad se activa en ciertas circunstancias, como cuando se recibe una entrada inesperada del usuario.
Un ataque de desbordamiento de búfer consiste en explotar una vulnerabilidad de desbordamiento de búfer —por lo general, por parte de un actor malicioso que busca obtener acceso o información. En esta publicación, explicaremos cómo se produce un desbordamiento de búfer y te mostraremos cómo proteger tu código C++ contra estos ataques.
Ejemplo de un ataque de desbordamiento de búfer
Para entender cómo se produce un desbordamiento de búfer, veamos el siguiente código, que realiza una simple comprobación de contraseña y es vulnerable a un ataque de desbordamiento de búfer:
El fragmento de código le pide al usuario que ingrese una contraseña (línea 14). Luego compara esta entrada con la contraseña almacenada (línea 23), que se había cargado previamente (línea 12). Si coinciden, se le concede acceso al usuario.
En la práctica, leeríamos la contraseña de un archivo mediante std::fscanf, pero para mantener este ejemplo sencillo, la leeremos de una constante de cadena. Además, lo ideal sería almacenar una versión cifrada con sal y con hash de la contraseña en vez de la original, pero, por simplicidad, usaremos una contraseña en texto plano.
Un mecanismo como este podría usarse para desbloquear la versión shareware —o de prueba— de una aplicación, o para conceder al usuario acceso a información y funciones dentro de la aplicación al ingresar la contraseña de un administrador.
Ejecutemos el programa y veamos qué sucede:
"Como esperábamos, al ingresar la contraseña correcta obtenemos acceso. En cambio, si ingresamos una contraseña incorrecta, se nos niega el acceso:
Hasta ahora, todo funciona correctamente. Sin embargo, ingresar la contraseña correcta no es la única forma de obtener acceso a esta aplicación. Veamos qué sucede si ingresamos «sunshinesunshine» en su lugar:
Eso no era lo esperado. Ingresamos algo muy distinto de la contraseña correcta, «rictro», y aun así obtuvimos acceso.
La explicación es que ejecutamos correctamente un ataque de desbordamiento de búfer contra el programa en cuestión. Para entender cómo sucedió, descomentemos las impresiones de depuración de las líneas 18–21 y volvamos a ejecutar la aplicación.
Primero, ejecutémosla con la entrada correcta:
El resultado no tiene nada de particular.
Probemos con una contraseña incorrecta:
Una vez más, la aplicación se comporta como se esperaba.
Sin embargo, observa qué sucede cuando ingresamos nuestra contraseña especial, «sunshinesunshine».
La contraseña ya no tiene el valor «rictro»; ahora contiene «sunshine».
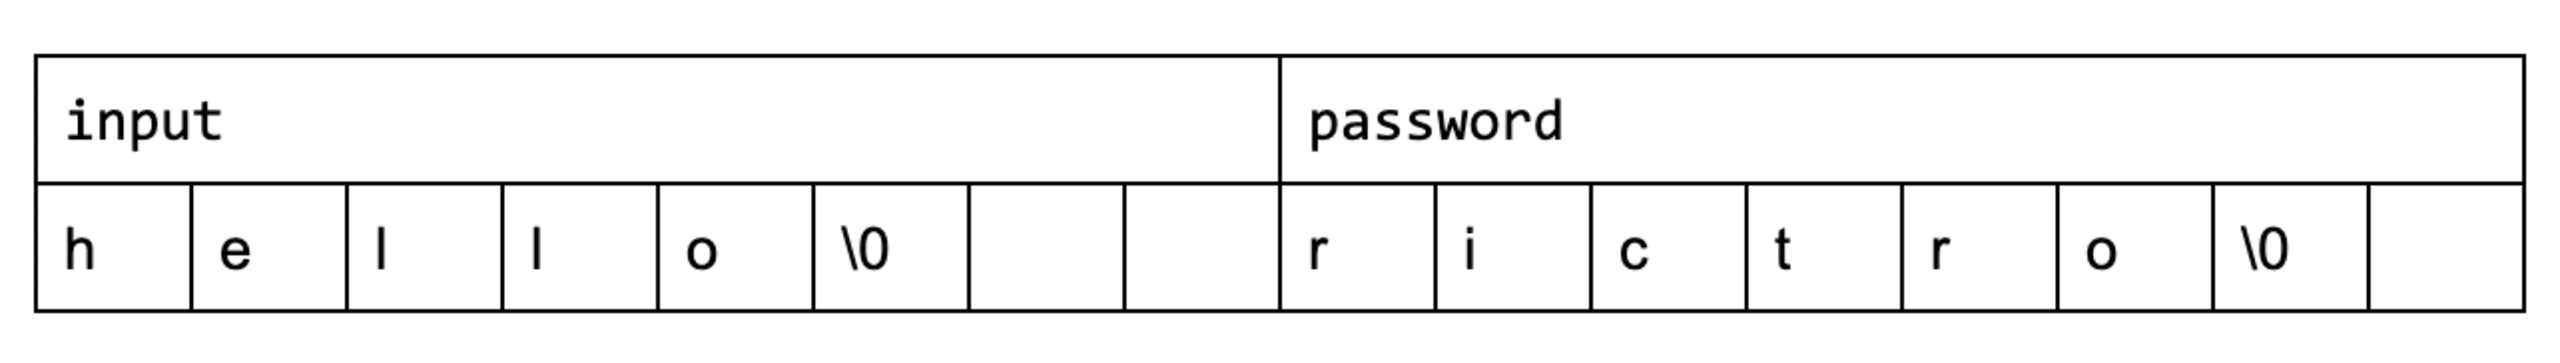
Usamos dos arreglos de 8 bytes: password almacena la contraseña de la aplicación y input almacena la entrada del usuario. El compilador que usamos en este ejemplo (GCC 10.3) coloca password ocho bytes después de input (0x7ffc5581e4b0 - 0x7ffc5581e4a8 = 8), por lo que los arreglos están juntos en la memoria. Ten en cuenta que otro compilador podría producir resultados distintos.
Las contraseñas de menos de ocho caracteres generan bloques de memoria similares a este:
Sin embargo, si ingresamos «sunshinesunshine», la memoria se ve así:
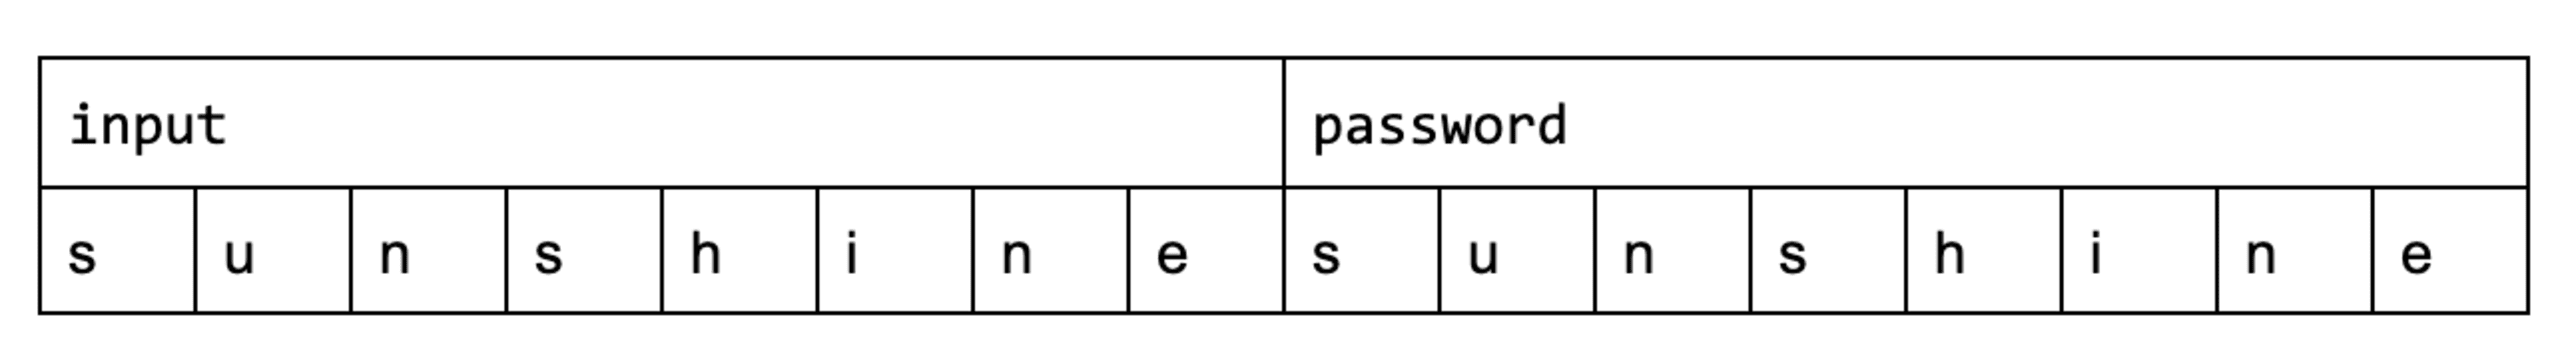
El terminador nulo \0 se escribe más allá del final de password, sobrescribiendo lo que haya en ese momento en la pila.
Esto sucede porque std::cin (línea 15) no realiza ninguna comprobación de límites. Lee desde la consola hasta encontrar una nueva línea —es decir, hasta que el usuario presiona Enter— sin verificar que el búfer receptor tenga suficiente espacio para la entrada del usuario.
Como solo comparamos los primeros ocho caracteres de password y input con std::strncmp (línea 23) para evitar leer más allá del final de cualquiera de los arreglos, obtenemos una coincidencia que no debería existir.
Cómo evitar desbordamientos de búfer en C++
En comparación con otros lenguajes de programación de alto nivel, C++ es especialmente vulnerable a los desbordamientos de búfer porque gran parte de su ecosistema, incluida una parte de la biblioteca estándar de C++, todavía usa punteros sin procesar. Podemos usar búferes administrados como std::vector o std::string en nuestro propio código, pero perdemos la capacidad de comprobar los límites en cuanto interactuamos con API de estilo C que nos obligan a pasar vector::data o string::c_str.
Aplica las prácticas recomendadas de programación en C++
La mejor manera de evitar desbordamientos de búfer es usar API que no sean vulnerables. En C++, esto significa usar búferes y cadenas administrados en lugar de arreglos y punteros sin procesar.
Prefiere | Evita |
|---|---|
|
|
|
|
|
|
|
|
Podemos usar std::string para corregir nuestra aplicación de ejemplo.
Veamos la versión corregida. Observa los cambios en las líneas 4, 10 y 24:
std::string sobrecarga el operador de extracción (>>), lo que le permite leer de forma segura desde los flujos. Para ello, consulta el tamaño de la entrada en el flujo, asigna suficiente memoria y solo entonces lee del flujo. Así, es imposible que desbordemos el búfer, sin importar cuánto mida la entrada. En el peor de los casos, podríamos quedarnos sin memoria.
Si tienes que usar API de estilo C, intenta usar sus alternativas «seguras» cuando estén disponibles. Se trata de versiones que comprueban los límites, aceptan un parámetro adicional size y se niegan a leer o escribir más allá de ese límite.
Prefiere | Evita |
|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
Sanitiza las direcciones para evitar desbordamientos de búfer
Además de las buenas prácticas de programación, existen herramientas automatizadas que pueden ayudar a detectar desbordamientos de búfer. AddressSanitizer (ASan) es una de las más populares. Es compatible con los principales compiladores, incluidos Visual Studio (v16.9 y versiones posteriores), GCC (v4.8 y versiones posteriores), Clang (v3.1 y versiones posteriores) y Xcode (v7.0 y versiones posteriores). La sanitización de direcciones se puede activar con la opción /fsanitize=address en Visual Studio y la opción -fsanitize=address en GCC/Clang.
ASan cumple dos funciones:
Agrega unos cuantos bytes de «memoria envenenada» alrededor de todos los objetos de la pila y las asignaciones del heap, reemplazando
mallocpor una versión modificada.El compilador inserta código en tu aplicación para detectar si intenta acceder a alguna zona de memoria envenenada.
Ya vimos cómo se organizan en memoria los arreglos input y password al compilar con GCC 10.3. Si activamos la sanitización de direcciones, la distribución podría cambiar y parecerse a la siguiente:
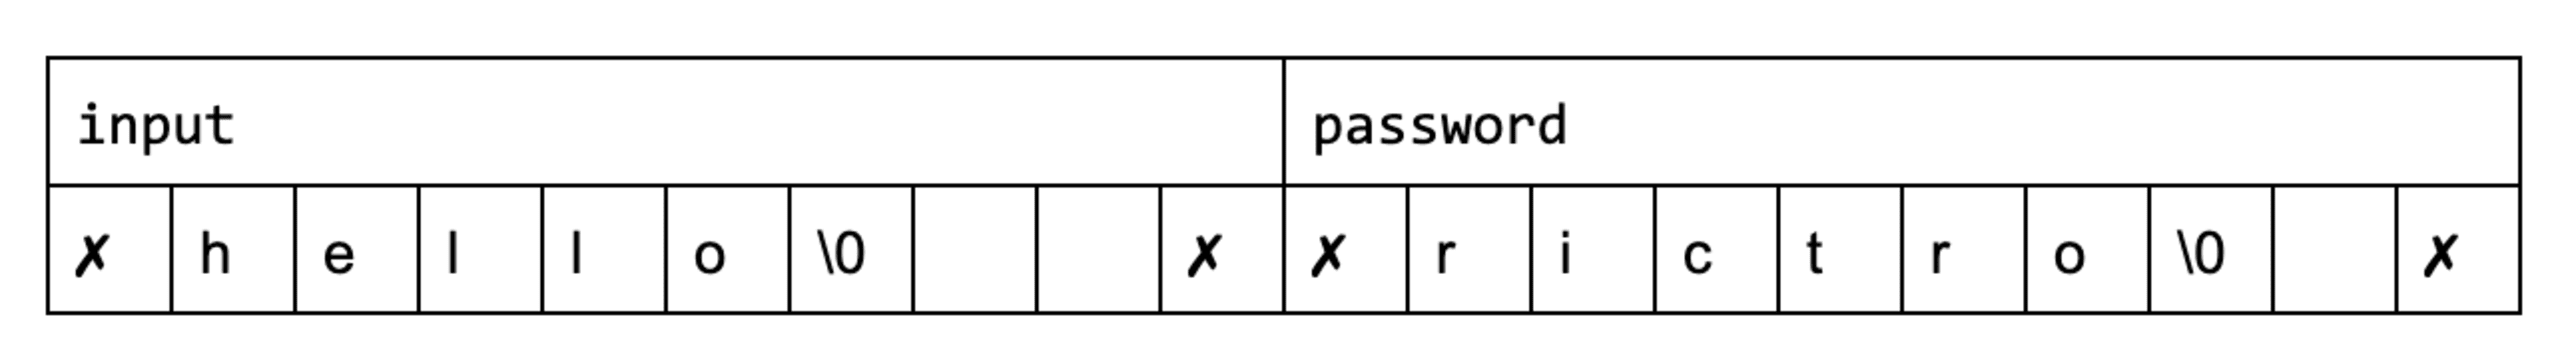
Los símbolos ✗ representan la memoria envenenada que se colocó alrededor de nuestros arreglos.
El código que inserta el compilador contiene lógica para detectar si intentamos acceder a memoria envenenada. Considera un fragmento de código sencillo antes de la transformación:
Después de que ASan lo procesa, el código queda así:
Para determinar si la aplicación intenta acceder a memoria envenenada —mediante la implementación de la función is_poisoned—, ASan usa «memoria sombra». Se trata de una región de memoria independiente que almacena metadatos sobre la memoria real de la aplicación.
En la práctica, el algoritmo tiene en cuenta más factores de los que podemos abordar en este artículo, pero esta sencilla implementación nativa ilustra la idea.
Imagina un conjunto de bits sencillo en el que cada byte al que accede la aplicación tiene un bit correspondiente en la memoria sombra que indica si ese byte está envenenado.
Podríamos ver una declaración sencilla como esta:
Para implementar la memoria sombra, la declaración podría transformarse en algo así:
El usuario declara un char array de 6 bytes en la pila. En cambio, el compilador crea un arreglo de 8 bytes y devuelve un puntero a la posición central, con 1 byte de relleno a cada lado. Luego escribe el patrón de bits 10000001 en bitset shadow_memory, usando la dirección temp como índice, para indicar que los 6 bytes de password están limpios, mientras que los dos bytes circundantes están envenenados.
Ahora el compilador puede determinar fácilmente si intentamos acceder a memoria envenenada. Considera el siguiente fragmento:
"Ahora que tienes una comprensión básica de la sanitización de direcciones, veamos qué sucede si ingresamos el dato malicioso «sunshinesunshine» en nuestra aplicación original y vulnerable, esta vez con la sanitización de direcciones activada:
Observa dos cosas:
La distancia entre los arreglos
inputypasswordaumentó de 8 a 32 bytes (0x7ffc5581e4c8-0x7ffc5581e4a8= 32) para dejar espacio para la memoria envenenada.El compilador detecta una corrupción de memoria en la dirección
0x7ffc5581e4b0, exactamente 8 bytes después deinput, donde se encuentra el primer byte envenenado que encuentra.
Protege tus proyectos de C++
En esta publicación, repasamos los conceptos básicos de los ataques de desbordamiento de búfer en C++ y cómo proteger mejor tus proyectos. En resumen, un desbordamiento de búfer es un tipo de vulnerabilidad que permite que un programa escriba más allá del final de un búfer y provoque una corrupción de memoria, que luego se puede explotar para obtener acceso a aplicaciones o información restringidas.
Entre los lenguajes de alto nivel, C++ es especialmente vulnerable a los desbordamientos de búfer porque muchas API todavía usan punteros sin procesar y no comprueban los límites. Esto se puede mitigar usando búferes y cadenas administrados en lugar de API de estilo C o, si es necesario usar una API de estilo C, recurriendo a sus versiones seguras, que aceptan un parámetro size adicional. También es posible evitar los ataques de desbordamiento de búfer con herramientas que activan la sanitización de direcciones para detectar defectos o desbordamientos de memoria.
Para obtener más información sobre la seguridad en C++, consulta nuestra introducción sencilla a las vulnerabilidades de C/C++ y descubre las vulnerabilidades de recorrido de directorios en C/C++.
Empieza con los desafíos de Capture the Flag
Aprende a resolver desafíos de captura la bandera con nuestro taller virtual introductorio a pedido.