10 prácticas recomendadas de seguridad serverless



31 de mayo de 2019
0 minutos de lecturaEn esta entrega de nuestra serie de guías rápidas, presentamos prácticas recomendadas para proteger tus implementaciones serverless.
Comencemos con nuestra lista de 10 prácticas recomendadas de seguridad serverless.
Si aún no lo hiciste, asegúrate de descargar esta guía rápida ahora y tenerla a la vista para tomar decisiones seguras en el futuro.
Muchos de los ejemplos y casos de uso hacen referencia a AWS Lambda, pero también se aplican a otros proveedores de nube y serverless. Consulta CNCF Landscape para ver una lista de referencia.
Comencemos con nuestra lista de 10 prácticas recomendadas de seguridad serverless.
1. Aplica parches a las dependencias de las funciones
Las plataformas de Function as a Service (FaaS) se encargan de aplicar parches a las dependencias de tu sistema operativo, pero no hacen nada para proteger las dependencias de tu aplicación, como las que se obtienen de npm, PyPI, Maven y similares. Estas bibliotecas son tan comunes y vulnerables como las dependencias del sistema operativo. Como propietario de la aplicación, eres responsable de actualizarlas o aplicarles parches cuando se divulga una vulnerabilidad.
Usa una solución como Snyk para analizar proyectos serverless en busca de vulnerabilidades conocidas en dependencias de código abierto. Snyk va más allá de generar informes de vulnerabilidades: también ofrece recomendaciones para corregirlas y aplica correcciones automáticamente mediante actualizaciones de versión y parches de seguridad.
Con las herramientas de Snyk, puedes proteger las funciones durante todo el ciclo de vida del desarrollo. Empieza en el entorno de desarrollo integrado (IDE) con nuestro complemento para VSCode o IntelliJ; luego, integra la app de GitHub para que Snyk emita pull requests automáticamente y corrija las vulnerabilidades de seguridad cuando se detecten, o interrumpa las compilaciones de integración continua (CI) para evitar implementaciones cuando se introduzcan nuevas vulnerabilidades.
Exige implementaciones seguras para las funciones
Además de monitorear la CI y los repositorios de código fuente, y aplicar proactivamente parches a las vulnerabilidades de seguridad, el flujo de implementación de una función también debe someterse a una revisión de seguridad. Las implementaciones deben detenerse cuando se encuentren vulnerabilidades en las funciones que se van a implementar.
El framework Serverless es un conjunto de herramientas común para desarrollar e implementar funciones serverless. Su arquitectura de complementos permite integrar flujos de trabajo personalizados en el ciclo de vida de las funciones. Snyk ofrece un complemento de Serverless de código abierto que se integra perfectamente con el framework.
A continuación, una imagen que muestra cómo el complemento evita activamente que se implemente una función al detectar vulnerabilidades de seguridad en las dependencias de código abierto:
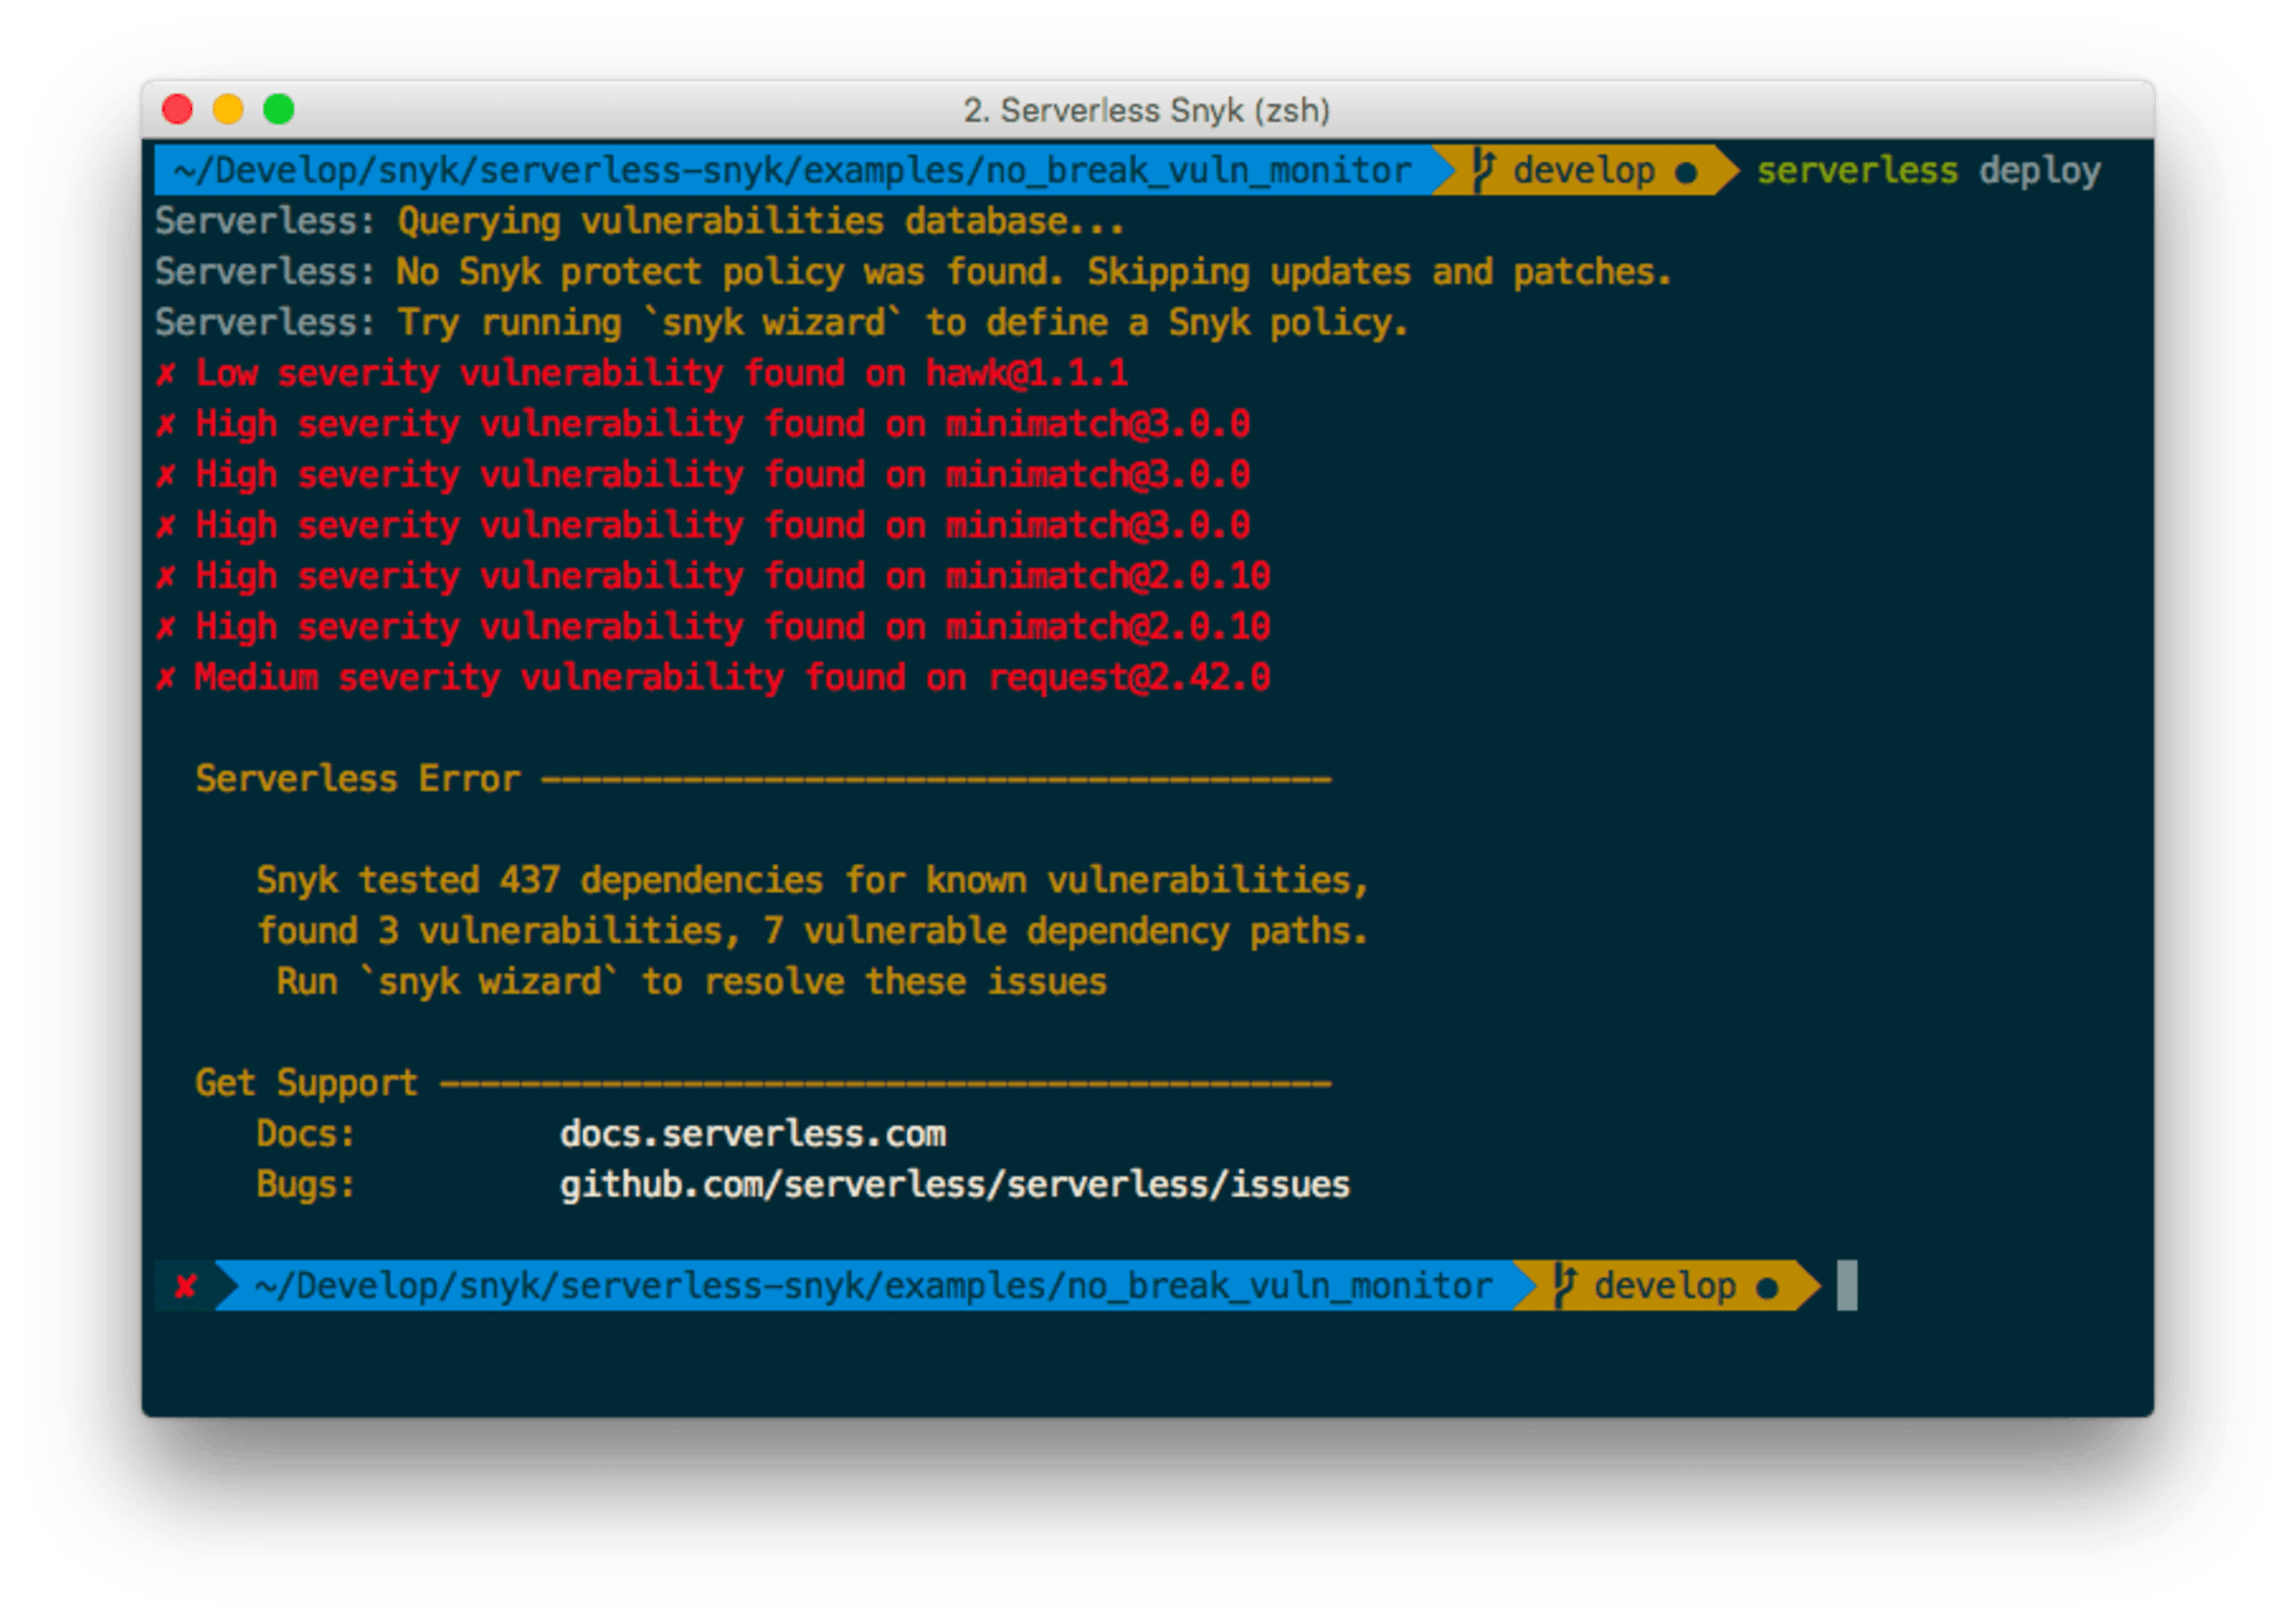
Para obtener más información sobre cómo configurar el complemento de Snyk para Serverless, crear instantáneas de proyectos para flujos de trabajo de CI/CD y monitorear tus proyectos, configura el complemento del framework Serverless. Consulta esta publicación.
2. Adopta el principio de privilegios mínimos
Como las funciones son pequeñas, podemos reducir cada conjunto de permisos al mínimo indispensable y permitir únicamente el acceso que cada función necesita para operar correctamente. Esto reduce considerablemente los daños que podría causar un ataque exitoso y minimiza la superficie de exposición de la integración general de varias funciones. Por ejemplo, es probable que la mayoría de las funciones no necesiten acceso a la base de datos ni permisos para conectarse a servidores externos. Los atacantes y usuarios maliciosos suelen realizar ambas acciones después de explotar una vulnerabilidad.
Mantén el principio de privilegios mínimos. Asegúrate de implementar tus funciones con los permisos estrictamente necesarios para minimizar la superficie de ataque y mantener una configuración segura.
Otorgar por error más permisos de los necesarios
Considera la siguiente configuración de serverless.yml, que define un único rol de permisos para todas las funciones implementadas con este proyecto:
Un error evidente en la configuración anterior es que el rol de IAM implementado con la función permite todas las acciones de lectura y escritura de DynamoDB que se integran con estas funciones. Sin embargo, en realidad algunas funciones solo necesitan leer y otras, eliminar. Este tipo de configuración predeterminada e ingenua de un proyecto serverless amplía la superficie de ataque. Es preferible implementar las funciones de forma granular para desglosar también los permisos según las necesidades.
Asigna correctamente roles y permisos a cada función
El framework Serverless recomienda configurar roles por función, como se muestra en el siguiente fragmento de un archivo serverless.yml:
A partir de la línea 7, se declaran dos funciones: func0, func1. Cada una tiene asignado su propio rol, definido por la directiva role en las líneas 9 y 12.
Las distintas definiciones de roles permiten un acceso mucho más granular, al otorgar únicamente lo que necesita cada función. Por ejemplo, una función puede tener capacidades de registro relacionadas con AWS, mientras que otra puede tener acceso a un bucket de Amazon S3.
3. Mantén perímetros de funciones aislados
Aunque se pueden implementar varias funciones para crear un flujo de trabajo completo, cada una debe tratarse como un perímetro independiente para evitar que una vulnerabilidad en una función se propague y comprometa las demás.
Veamos el siguiente escenario:
La función subscribeToEmailNotification depura la entrada y luego activa la función sendNotification para procesarla y entregarla. Podrías pensar que no hace falta depurar los datos de entrada del segundo evento, porque ya se depuraron en la función “subscribe”. Si más adelante se crea una nueva función subscribeToSMSNotification que no depura la entrada, la función sendNotification podría volver a procesar datos del evento sin depurarlos.
Sigue estas pautas para mantener las funciones aisladas dentro de sus perímetros:
No dependas del orden de acceso e invocación de las funciones: no des por hecho que una función solo se llama desde otra o que no se puede acceder a ella mediante una API gateway. El orden y el acceso a las funciones cambian con el tiempo.
Trata cada función como su propio perímetro de seguridad: cada función debe considerar que los datos de entrada de cualquier evento provienen de una fuente no confiable y siempre debe depurarlos.
Usa bibliotecas de seguridad: dedica tiempo a crear o adoptar bibliotecas de seguridad estandarizadas y exige su uso en todas las funciones.
4. Depura los datos de entrada de los eventos para evitar inyecciones
La arquitectura serverless suele requerir distintos tipos de ingesta de datos para las funciones de nube: síncrona, asíncrona o en streaming. Todos pueden incluir datos controlados por usuarios que circulan entre distintos almacenes de datos y funciones.
Aunque estén protegidas por API gateways, firewalls y otros proxies, las funciones que se usan en servicios de API procesan la entrada de los usuarios igual que un servidor de API tradicional. Además, las funciones que procesan datos de eventos provenientes de colas de mensajes y otras comunicaciones no públicas también pueden manejar datos de entrada de usuarios indirectamente. Sin embargo, en esos casos, el contexto y el origen de los datos se vuelven difusos y más difíciles de predecir.
La arquitectura serverless se basa principalmente en eventos, por lo que la inyección de eventos se convierte en un vector de ataque importante. Esto se debe a que una función suele crearse para realizar tareas pequeñas, como procesar datos de una cola de eventos. Sin embargo, si los datos maliciosos logran eludir una función de depuración y llegar a la carga útil del evento, la función de procesamiento podría ser vulnerable a ataques de inyección si no valida correctamente los datos.
A continuación, se muestran ejemplos de fuentes de datos menos tradicionales que suelen activar funciones y que estas no deben considerar confiables:
Almacenamiento: los nombres de archivos o directorios en el almacenamiento de nube, como los buckets de S3, pueden estar controlados por usuarios y generar entradas maliciosas para los intérpretes.
Mensajería: los payloads de datos de eventos para mensajes asíncronos en servicios como SNS y SQS deben sanitizarse y no deben considerarse confiables.
Flujos de bases de datos: las actualizaciones de una base de datos, como agregar o eliminar un registro, pueden activar funciones. Estos eventos pueden tener como origen entradas de usuarios, por lo que deben depurarse.
Sigue estas prácticas recomendadas para todos los datos de entrada de usuarios que procese la función y así mitigar los ataques de inyección de eventos:
Valida los datos según esquemas y objetos de transferencia de datos. Comprueba el tipo, la longitud y el rango esperados en lugar de serializar y deserializar objetos de datos a ciegas y pasarlos sin cambios.
Usa siempre un ORM y aplica el escape adecuado al trabajar con bases de datos SQL y no SQL para evitar estos tipos de inyección.
Evita iniciar procesos del sistema o evaluar código dinámico durante la ejecución con datos provenientes de eventos, ya que podrían originarse en entradas de usuarios. Además, ten cuidado con los servicios de terceros que integras en tus funciones, pues tienes poco control o visibilidad sobre el origen de los datos y el alcance de las entradas controladas por usuarios. Al iniciar procesos y ejecutar código dinámico, aplica las medidas de protección adecuadas, como la codificación y el uso de sandbox, respectivamente.
5. Usa API gateways como barrera de seguridad
Las funciones de nube implementadas suelen quedar expuestas y, por lo tanto, se puede acceder a ellas mediante un endpoint HTTP generado aleatoriamente que envía el evento, los datos y el contexto necesario para procesar la carga útil. Una práctica recomendada para exponer funciones es usar API gateways, que actúan como proxies inversos y crean una capa de separación entre los usuarios y las funciones.
Como interfaz de API de cara a los consumidores, los API gateways pueden configurarse para ofrecer varios mecanismos de seguridad que ayudan a reducir la superficie de ataque de las funciones.
API Gateway como filtro
Usa un API gateway antes de exponer tus funciones para limitar sus datos de entrada según una política de gateway. Cuanto más estricta sea la política, menor será el riesgo que llegue a tus funciones. AWS API Gateway recomienda declarar la asignación de solicitudes y respuestas según esquemas. Este patrón es similar al de los objetos de transferencia de datos; en las funciones y los gateways, la asignación puede servir como una regla estricta para las solicitudes entrantes.
A continuación, se muestra un ejemplo de esquema definido en el nivel de API gateway para una solicitud JSON entrante:
API Gateway como punto de autenticación
Filtrar las solicitudes HTTP antes de que lleguen a tus funciones de nube es fundamental para controlar el acceso de los usuarios a las aplicaciones mediante la autenticación y la autorización. Configura un API gateway y deja que el proveedor de nube y su infraestructura se encarguen de los aspectos relacionados con las funciones.
Una vez que los usuarios se autentican en el API gateway, puedes aplicar medidas de protección, como limitar la velocidad y establecer cuotas en el gateway, sin activar invocaciones de funciones.
API Gateway para mitigar ataques DDoS
Un API gateway agrega protección contra ataques de denegación de servicio (DoS) en el nivel del proveedor de nube y te permite limitar la velocidad de todas las solicitudes dirigidas a tus funciones. El control de la velocidad de las solicitudes deja de ser responsabilidad de tus funciones y tu lógica de negocio (como debería ser) y pasa a estar completamente a cargo de la infraestructura de nube. El uso de un API gateway te ayudará a evitar el agotamiento de recursos financieros.
6. Monitorea y registra las funciones
Las funciones tienen una vida muy corta y, cuando implementas muchas y aumentan sus invocaciones a medida que escalas, es fácil perder de vista el flujo de eventos y encontrar la causa de los errores. A medida que una organización adopta más tecnologías serverless, se vuelve más complicado monitorear los flujos inseguros y los intentos maliciosos de los atacantes por hacer que una función siga una ruta de código insegura.
AWS introdujo recientemente la posibilidad de etiquetar funciones Lambda para que sea fácil hacerles seguimiento y agruparlas. Con el framework Serverless, podemos etiquetar funciones en sus archivos YAML, ya sea de forma global (para todas las funciones del archivo serverless.yml) o individual.
Supervisar las funciones para detectar vulnerabilidades de seguridad
Snyk se integra con tu proveedor de FaaS para supervisar las funciones implementadas y mantenerlas protegidas. Esto te permite abordar vulnerabilidades de seguridad conocidas en todo el ciclo de vida del desarrollo de software, en lo que respecta a las funciones y al uso que hacen de dependencias de código abierto.
En la siguiente imagen vemos el proyecto de GitHub lirantal/bazz-serverless después de analizarlo, con varias vulnerabilidades críticas, medias y bajas. Este es el código fuente de mi proyecto serverless, que implementa varias funciones. Debajo del repositorio del proyecto de GitHub podemos ver las seis funciones de AWS Lambda que implementé: son las funciones reales tal como AWS las implementa y ejecuta.
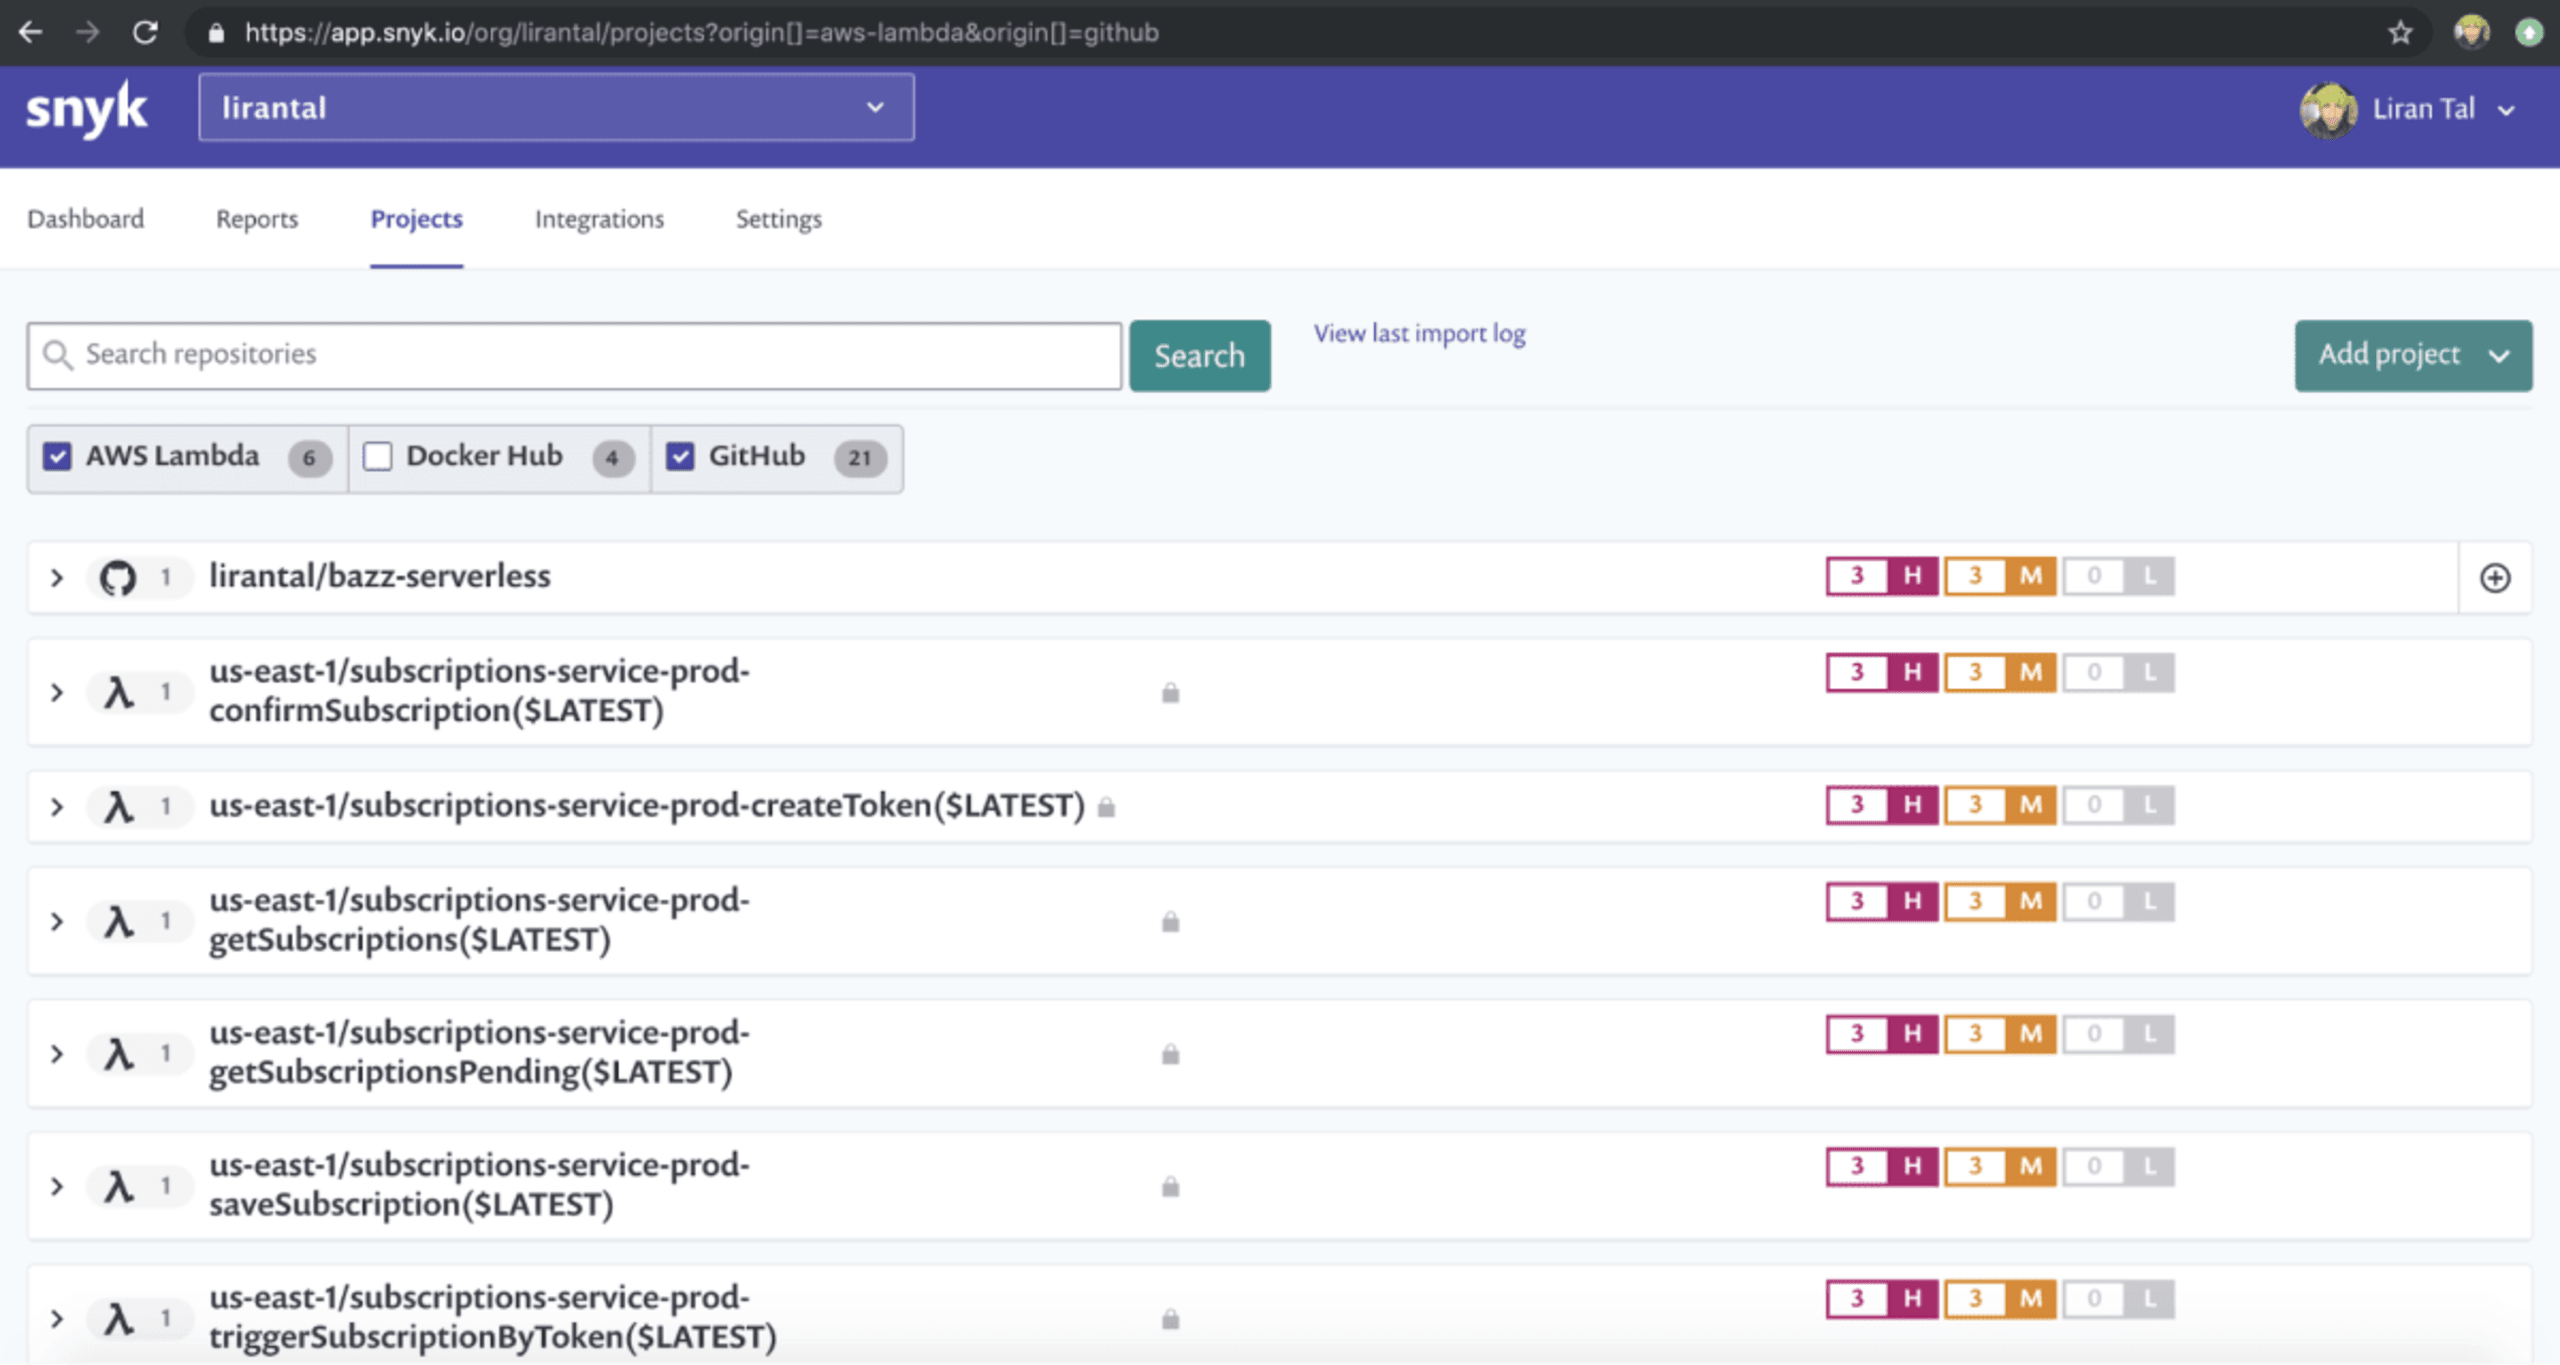
Snyk analizó cada una de estas funciones para detectar vulnerabilidades de seguridad conocidas. Como todas usan el mismo árbol de dependencias, podemos ver que se implementaron con versiones de bibliotecas vulnerables.
Los proveedores de servicios en la nube suelen incluir supervisión de recursos de aplicaciones y funciones para ofrecer esta información. Microsoft tiene Azure Monitoring y Amazon, AWS X-Ray. Por ejemplo, la consola de X-Ray de AWS ofrece información sobre el flujo de datos entre funciones y otros recursos en la nube, así como métricas como el tiempo de ejecución.
7. Sigue las convenciones de codificación segura para el código de las aplicaciones
Una gran ventaja de la infraestructura serverless es que la responsabilidad del sistema operativo subyacente pasa del propietario de la aplicación al proveedor de servicios en la nube, que debe mantenerlo y actualizarlo con parches de seguridad. Sin embargo, esto significa que los atacantes centrarán su atención en las áreas que siguen expuestas; la principal es el propio código de la aplicación.
El código de las aplicaciones sigue siendo vulnerable. Los desarrolladores deben seguir las convenciones de codificación segura y asegurarse de que se cumplan en actividades como las revisiones de código, para detectar pronto los problemas de seguridad en el proceso de desarrollo de software. Exigir el uso de bibliotecas de seguridad compartidas entre los equipos de desarrollo ayuda a garantizar que se cumplan las pautas de codificación segura y evita que los desarrolladores reinventen la rueda y cometan errores en áreas de seguridad que ya cuentan con soluciones estandarizadas.
OWASP Top 10 es una buena referencia para identificar áreas del código de las aplicaciones que requieren más atención en materia de seguridad. Algunos de estos temas son:
Ataques de inyección, en los que los datos no se filtran ni codifican según el contexto correcto y, por lo tanto, se interpretan como parte de una ejecución confiable. Esto se aplica a áreas como las inyecciones SQL, la ejecución de comandos del sistema y la ejecución de código CSS y JavaScript. Para evitar por completo la inyección maliciosa en cualquier contexto, bloquea la entrada del usuario siempre que sea posible; como alternativa, utiliza una lista de permitidos segura y codifica todos los datos proporcionados por el usuario según el contexto correcto.
Exposición de datos confidenciales, en la que los atacantes pueden aprovechar medios de comunicación inseguros para extraer información confidencial o el uso de algoritmos criptográficos inseguros en contextos de seguridad. Para mitigar estos riesgos, utiliza TLS como medio seguro de comunicación y cifra o aplica hash a las contraseñas y otras credenciales con algoritmos criptográficos seguros y adecuados.
Control de acceso deficiente, que permite a los atacantes acceder a recursos que no deberían estar disponibles. Para mitigar el problema, implementa mecanismos de control de acceso adecuados, como denegar el acceso de forma predeterminada y seguir un modelo de autorización restrictivo. Aplica límites de frecuencia cuando corresponda para reducir los intentos de fuerza bruta y el abuso del servicio.
Nota: Consulta la guía OWASP Top 10 2017 para ver la lista completa.
8. Protege y verifica los datos en tránsito
Según httparchive, el uso de HTTPS está cobrando cada vez más importancia a medida que se adoptan las prácticas recomendadas: el servicio informa que representa el 77 % de todo el tráfico que monitorea. Las funciones y los servicios con los que se integran, ya sean de terceros o estén dentro de los perímetros de la nube, no son la excepción: todos deben usar un medio seguro de comunicación.
Sigue estas pautas para garantizar la seguridad de las comunicaciones de datos en tránsito:
Usa HTTPS como medio de comunicación seguro, tanto dentro de tu perímetro interno para las funciones o los servicios a los que llamas, como para los servicios del proveedor de nube y los servicios de terceros que se encuentran fuera de la nube.
Verifica los certificados SSL para confirmar la identidad con la que te comunicas y asegúrate de detener toda comunicación si la identidad y autenticidad del servidor no coinciden con el certificado.
Habilita las solicitudes firmadas con los proveedores de servicios en la nube que las admitan.
Trata las respuestas de servicios de terceros como entradas de usuario no confiables y desinféctalas.
Medio seguro para los servicios en la nube
Siempre que sea posible, los servicios y el acceso a recursos locales de la infraestructura del proveedor de nube deben utilizar un medio seguro de comunicación. Por ejemplo, cuando una función de AWS Lambda se integra con SNS, debe optar por comunicarse mediante SSL:
Solicitudes firmadas
Al usar herramientas de proveedores de nube, como AWS SDK y AWS CLI, para crear solicitudes HTTP, estas incluyen automáticamente una firma en el encabezado HTTP o en los parámetros de consulta, que indica la identidad de quien realiza la solicitud HTTP. Esto protege aún más los datos en tránsito y mitiga los ataques de repetición HTTP.
Por ejemplo, en una solicitud firmada de AWS, la firma se agrega al mensaje HTTP como encabezado Authorization:
9. Administra los secretos en un almacenamiento seguro
Usa un almacenamiento seguro para tus secretos y credenciales confidenciales, compatible con los principales proveedores de servicios en la nube y de FaaS. Como alternativa, puedes implementar tus propias soluciones, como Vault de HashiCorp. Guardar las claves en un almacenamiento de secretos reduce el riesgo de que la información confidencial se almacene en archivos estáticos de un repositorio de código fuente o en variables de entorno, y disminuye considerablemente la probabilidad de que quede expuesta.
En el siguiente ejemplo se usa AWS Simple Systems Manager, que permite recuperar secretos cifrados de forma segura con AWS Parameter Store. En nuestro ejemplo, la variable de SSM permite acceder a un valor específico creado previamente y ponerlo a disposición de una función mediante una variable de entorno:
Ten en cuenta que ${ssm:/github/api-key} devolverá el valor cifrado de esa clave. Si queremos descifrarla y devolver el valor real, debemos especificar ${ssm:/github/api-key~true}.
Encontrarás más información sobre Parameter Store y KMS en la documentación de Amazon: https://docs.aws.amazon.com/kms/latest/developerguide/services-parameter-store.html
Para mejorar aún más la seguridad y la flexibilidad al administrar secretos en las aplicaciones, considera acceder a ellos y a otra información de configuración durante la ejecución, en lugar de usar variables de entorno, que requieren reiniciar el proceso para aplicar una nueva configuración.
Aunque usar un almacenamiento de secretos reduce la posibilidad de que se filtre una clave, no la elimina por completo. Por suerte, si usas un almacenamiento de secretos en tu función, significa que a nadie le importa cuál es la clave en sí... ¡así que puedes rotarla con frecuencia! De esta manera, si se filtra o la roban, solo será útil durante un período breve.
10. Implementa las funciones con una granularidad mínima
Por principio, se espera que las funciones sean pequeñas, por lo que el código que se implementa con ellas también lo es. Esto reduce la superficie de ataque y la información que podría filtrarse si la función se ve comprometida. No es recomendable implementar funciones en bloque ni implementar más código y funciones de los necesarios.
De forma predeterminada, las funciones que forman parte del mismo proyecto serverless comparten las mismas dependencias. Por ejemplo, los proyectos serverless de Node.js comparten un único archivo package.json con dependencias que se implementan con cada función, aunque no todas las demás funciones las necesiten explícitamente.
Como es posible que reutilices mucho código repetitivo, puede resultarte útil usar plantillas para crear la estructura inicial de proyectos, por ejemplo:
Descarga la hoja de referencia sobre prácticas recomendadas de seguridad serverless para tenerla a mano. ¡Y crea una cuenta gratuita de Snyk para empezar a proteger tu código hoy mismo!
Empieza con Capture the Flag
Aprende a resolver desafíos de Capture the Flag viendo nuestro taller virtual introductorio a pedido.