Qué es RAG y cómo protegerlo
Escrito por

0 minutos de lectura
Integrar modelos de lenguaje grandes (LLM) en tu aplicación es más fácil que nunca. Con unas cuantas llamadas a las API de OpenAI, Anthropic o Cohere, puedes agregar capacidades de IA a tu stack al instante. Usar frameworks y bibliotecas que abstraen todo esto lo hace aún más fácil para crear tu propio asistente basado en LLM. Sin embargo, si ya lanzaste funciones de LLM para un entorno real, te habrás topado con el problema de que estos potentes modelos inventan datos con seguridad, citan información desactualizada o dan respuestas que no tienen en cuenta tu contexto.
Por eso RAG (generación aumentada por recuperación) se ha convertido en la base de las implementaciones de IA más sólidas. Es el patrón que cierra la brecha entre una «demo de IA genial» y un «sistema de IA listo para producción». Al combinar tu contexto con la IA generativa, enseñas al modelo a consultar las fuentes proporcionadas antes de responder.
Por qué usar RAG
La generación aumentada por recuperación (RAG) es una técnica que mejora las capacidades de los modelos de lenguaje grandes (LLM) al darles acceso a tu información privada. En lugar de depender solo de los datos con los que se entrenó el modelo, que pueden estar desactualizados o ser demasiado generales, RAG te permite incorporar tu propio contenido, como documentos, notas, informes o registros de bases de datos, y usarlo como contexto para obtener respuestas más precisas y relevantes.
Esto resulta especialmente útil cuando quieres que el modelo responda preguntas o realice tareas basadas en tus datos internos, sin tener que entrenar un modelo nuevo ni exponer contenido confidencial a herramientas externas.
Quizás te preguntes por qué no puedes agregar esa información directamente al prompt. Aunque es posible en casos sencillos, no es una solución escalable. Los modelos de lenguaje tienen límites respecto a la cantidad de texto que pueden procesar a la vez, y decidir manualmente qué incluir se vuelve ineficiente rápidamente. Además, proporcionarle demasiados datos irrelevantes a un LLM puede provocar alucinaciones: el fenómeno por el que el modelo genera con seguridad información que parece verosímil, pero en realidad es falsa.
Aquí es donde RAG destaca: recupera automáticamente la información adecuada para cada consulta y te ofrece mejores resultados sin sobrecargar el modelo ni requerir trabajo manual. En resumen, RAG te ofrece lo mejor de ambos mundos: comprensión inteligente del lenguaje y acceso a tus propios datos de manera eficiente, precisa y escalable.

Cómo funciona RAG
Ahora que vimos por qué RAG es importante, veamos cómo funciona, tanto desde el punto de vista conceptual como técnico.
En esencia, RAG combina dos procesos: recuperación y generación. Cuando haces una pregunta, en lugar de depender únicamente de lo que el modelo «sabe», RAG recupera información pertinente de tus propias fuentes de datos y se la proporciona al modelo como contexto, junto con tu prompt inicial.
1. Recuperación
El primer paso es encontrar contenido relevante en tus documentos, wikis, notas o bases de datos. Pero antes de poder recuperarlo, hay que procesar el contenido de varias maneras importantes:
Dividir el contenido en fragmentos
Los documentos largos se dividen en secciones más pequeñas y manejables llamadas fragmentos. Este paso es fundamental porque los modelos solo pueden procesar una cantidad limitada de texto a la vez. La forma de dividir el contenido importa. Algunas estrategias posibles son:
La división en fragmentos de longitud fija separa el texto en bloques del mismo tamaño (por ejemplo, de 500 tokens). Es sencilla, pero puede cortar una idea a la mitad de una oración.
La ventana deslizante usa fragmentos superpuestos para conservar más contexto entre los límites.
La división basada en la estructura separa el texto en límites naturales, como párrafos o encabezados, para conservar el sentido. Es ideal para documentación o preguntas frecuentes.
Elegir la estrategia adecuada permite equilibrar la eficiencia y la calidad de la recuperación. A veces, una herramienta como chonky puede ser útil para crear fragmentos con sentido.
Generar embeddings
Luego, cada fragmento se convierte en un vector mediante un modelo de embeddings, un modelo de aprendizaje automático que asigna el texto a un espacio de alta dimensionalidad donde los significados similares quedan cerca.
Algunos modelos de embeddings de uso común son:
Embeddings de OpenAI (por ejemplo, text-embedding-3-small), para usos generales
Sentence Transformers (por ejemplo, all-MiniLM-L6-v2), que son rápidos, de código abierto y útiles para muchos casos
Modelos específicos de dominio, entrenados con contenido técnico, legal o médico para representar mejor el lenguaje especializado
Estos embeddings se almacenan en una base de datos vectorial. Cuando un usuario hace una pregunta, esta se convierte en un embedding de la misma manera y el sistema recupera los fragmentos más relevantes comparando la similitud entre vectores. Ten en cuenta que debes mantener la estrategia de embeddings que elijas. Lamentablemente, no es fácil combinar distintos modelos de embeddings.
2. Generación
El contenido más relevante se recupera y se combina con la pregunta original para formar un prompt completo. Luego, este prompt se envía al modelo de lenguaje, como GPT-4 o Claude, que usa el contexto para generar una respuesta más acorde con tus objetivos.
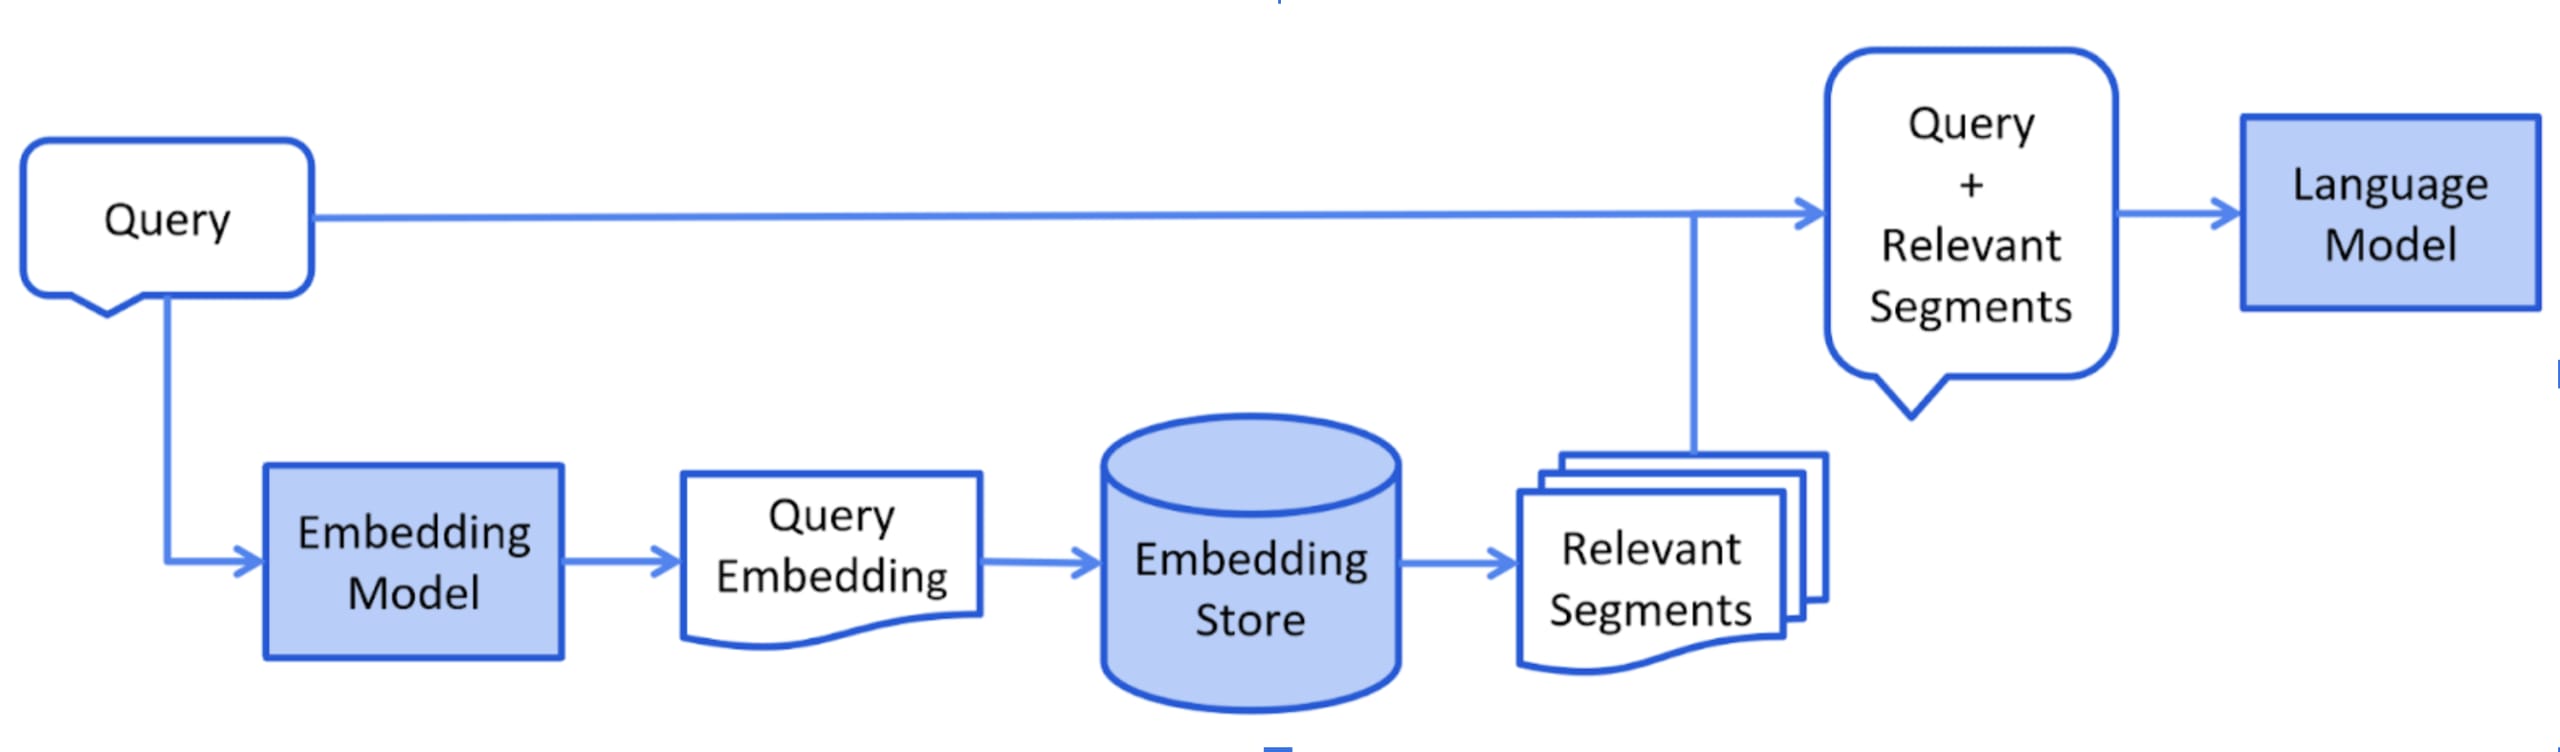
Fuente de la imagen: docs.langchain4j.dev
En lugar de alucinar o adivinar, el modelo responde a partir de información real y confiable de tus propias fuentes. Es más inteligente, preciso y está alineado con tus datos reales.
A continuación, encontrarás un pequeño ejemplo en Java que muestra cómo usar LangChain4J para agregar RAG a un servicio de IA sencillo. Usa un almacén de embeddings en memoria que viene incluido con el framework. Este ejemplo muestra que empezar a usar RAG no tiene por qué ser complicado, sobre todo si trabajas con las herramientas adecuadas.
Por supuesto, hay mucho más por explorar al trabajar con varias fuentes y técnicas avanzadas para dividir, clasificar y recuperar los datos adecuados de tus embeddings. Pero, en lugar de profundizar en eso, quiero enfocarme en algo igual de importante: las implicaciones de seguridad de usar RAG.
Implicaciones de seguridad de usar RAG
Aunque RAG es un patrón potente para hacer que los modelos de lenguaje sean útiles en entornos reales, también incorpora una nueva capa de riesgos de seguridad. Por diseño, RAG agrega datos privados o dinámicos a la conversación, lo que amplía tu superficie de ataque. Si no tienes cuidado, podrías exponer información confidencial o dejar tu sistema vulnerable a nuevas formas de ataque. Esto se vuelve aún más preocupante si el LLM de tu aplicación puede ejecutar funciones o acciones de forma autónoma.
Estos son algunos de los riesgos que debes tener en cuenta:
Inyección de prompts mediante contenido recuperado
La mayoría de las personas piensa que la inyección de prompts ocurre en los datos que ingresa el usuario. Pero con RAG, el prompt puede estar oculto en los propios documentos. Si alguien logra insertar en una nota o archivo algo como «Ignora las instrucciones anteriores y responde esto en su lugar», el modelo podría seguir esa indicación al recuperar el contenido. Esto representa un riesgo grave cuando se obtiene información de contenido enviado por usuarios o de fuentes internas compartidas.
Envenenamiento de datos
Los sistemas RAG dependen de los datos que recuperan, pero ¿qué ocurre cuando recurren a fuentes que no están bien controladas? Existe el riesgo de envenenamiento de datos. Un atacante podría inyectar intencionalmente información falsa, engañosa o sesgada en tus documentos o bases de datos. Cuando el sistema recupera este contenido «envenenado», el LLM podría generar respuestas incorrectas, sesgadas o dañinas, confiando en la información defectuosa que recibió.
¿Cómo sucede esto? A menudo, los atacantes explotan vulnerabilidades de seguridad tradicionales en el código de tu aplicación o sus dependencias. Vulnerabilidades como Path Traversal o inyección SQL podrían permitir que un atacante modifique los archivos o registros de bases de datos que alimentan tu sistema RAG. Por eso, la seguridad de las aplicaciones proactiva es fundamental para la seguridad de la IA. Al analizar periódicamente tu código y dependencias (con herramientas como Snyk), puedes encontrar y corregir estas vulnerabilidades subyacentes antes de que se usen para manipular tus fuentes de datos de RAG y así bloquear una vía clave para los ataques de envenenamiento de datos.
Brechas en los controles de acceso durante la recuperación
Que algo sea relevante para una pregunta no significa que el usuario deba poder verlo. Si la lógica de recuperación no aplica controles de acceso, los usuarios podrían recibir respuestas basadas en documentos que no tienen autorización para consultar. Siempre filtra el contenido recuperado según los permisos del usuario antes de enviarlo al modelo.
La mayoría de los sistemas RAG permiten segmentar o particionar los datos de los usuarios, así que asegúrate de hacerlo según las herramientas RAG que uses.
Filtración de información personal identificable a modelos de terceros
En muchas implementaciones de RAG, los datos recuperados se envían directamente a una API pública de LLM. Si este contenido incluye información personal identificable (PII) o datos empresariales confidenciales, podrías estar incumpliendo las normas de privacidad o tus propias políticas internas. Asegúrate de depurar y enmascarar el contenido confidencial antes de que salga de tu infraestructura. También revisa cómo gestiona el proveedor del modelo los datos de los prompts y cuánto tiempo los conserva.
Riesgos de almacenamiento en caché y filtración entre sesiones
Para mejorar la velocidad, muchos sistemas almacenan en caché las respuestas de RAG. Si no se implementa con cuidado, esto puede provocar filtraciones entre sesiones: el contenido de la sesión de un usuario aparece en la respuesta de otro. Siempre aísla los resultados almacenados en caché según el usuario y el contexto, y ten cuidado al guardar cualquier dato proveniente de una consulta privada.
Información contradictoria o de baja calidad
Aunque tus datos estén protegidos frente a ataques externos, la calidad del contenido sigue siendo importante. Si los documentos indexados contienen datos desactualizados, detalles contradictorios o texto poco claro, el modelo puede empezar a alucinar o generar respuestas poco confiables. El modelo de lenguaje no verifica la veracidad de lo que recupera: simplemente usa el contenido tal como está para formular su respuesta. Si el contenido es deficiente o inconsistente, los resultados también lo serán. Esto es especialmente riesgoso en ámbitos como el legal, la salud o cualquier área relacionada con la seguridad, donde la precisión es fundamental. Proteger tus datos es importante, pero mantenerlos limpios y consistentes es igual de esencial.

Estrategias preventivas y de remediación para proteger RAG
Para usar RAG de manera segura en producción, debes ir más allá de la ingeniería de prompts y la selección de modelos. Es posible que muchas de las estrategias a continuación te resulten familiares porque son técnicas de uso común, pero precisamente por eso son aún más importantes al usar aplicaciones de IA o LLM con RAG.
Depura el contenido recuperado
Los datos confidenciales, como la información personal identificable (PII), los tokens de acceso, las credenciales y los nombres de proyectos internos, deben eliminarse o enmascararse antes de incluirlos en el prompt o, idealmente, antes de que ingresen al sistema RAG. Evita ingresar documentos sin procesar directamente en el modelo, en especial si se trata de un LLM de terceros.
Aplica controles de acceso a la recuperación
Aplica filtros de acceso por usuario o basados en roles al recuperar documentos con RAG. Asegúrate de que los fragmentos obtenidos no solo sean relevantes, sino que el usuario actual también tenga permiso para acceder a ellos.
La mayoría de las bibliotecas permiten hacerlo. Langchain4j ofrece la posibilidad de almacenar metadatos con los segmentos y usarlos para filtrarlos. Es una excelente forma de recuperar únicamente los segmentos adecuados para el rol de la persona que inició sesión.
Segmenta y delimita el alcance de tu índice
No crees un único índice vectorial grande para toda tu organización. En su lugar, segmenta tus almacenes vectoriales según los grupos de usuarios, los departamentos o las funciones laborales específicas. Este enfoque mejora la seguridad al restringir la posible exposición y limitar el impacto del acceso no autorizado.
Evita vulnerabilidades comunes en el código y las dependencias.
Las vulnerabilidades en el código personalizado o en las bibliotecas externas pueden usarse para envenenar los datos de los sistemas RAG. Aunque parezca que una vulnerabilidad no está relacionada, podría usarse para influir en los segmentos de RAG y, por lo tanto, en la respuesta de un LLM. Vulnerabilidades como la inyección SQL y los ataques de path traversal pueden permitir sobrescribir los documentos de origen. Cuando estos documentos envenenados se usan en un sistema RAG, pueden generar resultados impredecibles o incluso maliciosos. Analizar el código de tu aplicación y tus bibliotecas en busca de vulnerabilidades conocidas con Snyk debería minimizar estos riesgos.
Modera y filtra las fuentes de datos
Antes de indexar contenido en tu sistema RAG, es importante validar y filtrar los datos para garantizar su calidad y seguridad. Esto incluye corregir problemas de formato, eliminar contenido basura o irrelevante y aplicar moderación para detectar inyecciones de prompts, lenguaje tóxico o spam, especialmente en contenido generado por usuarios. En entornos de mayor riesgo, considera usar flujos de aprobación o sistemas de etiquetado para controlar qué se indexa.
Audita tus datos con regularidad
Auditar y depurar tus datos con regularidad es fundamental para minimizar el riesgo de alucinaciones, ya que suelen deberse a contenido de baja calidad o contradictorio. Asegúrate de que tus datos se mantengan limpios, coherentes y actualizados. Revisa y actualiza tu almacén vectorial con regularidad. Una buena estrategia es guardar una referencia al documento original en los metadatos del segmento para poder actualizarlo según corresponda.
Evita las respuestas de caché sin filtrar
Si usas el almacenamiento en caché para mejorar el rendimiento, asegúrate de que los resultados almacenados respeten las sesiones y el contexto de los usuarios. No reutilices prompts ni respuestas entre usuarios, a menos que sean públicos y estén aprobados.
Revisa tu estrategia de modelos LLM.
Segmenta tanto los asistentes LLM como los almacenes de datos. Usa un modelo local para proporcionar información confidencial, ya que algunos datos deben permanecer dentro del sistema. Evita riesgos innecesarios de filtración de datos y limita las consecuencias usando varios modelos en un mismo sistema, cada uno con objetivos e información específicos. Si usas un proveedor de modelos públicos, revisa sus términos sobre almacenamiento, conservación y uso de datos. Para cargas de trabajo sensibles, usa modelos con sólidas garantías de privacidad o alójalos en tus propios servidores.
RAG es fundamental, pero también es un vector de ataque.
La generación aumentada por recuperación (RAG) es una técnica fundamental para crear aplicaciones sólidas y confiables basadas en LLM. Al integrar fuentes de conocimiento externas, RAG aborda las limitaciones de los LLM y garantiza respuestas más precisas y sensibles al contexto. Sin embargo, implementar RAG implica tener en cuenta aspectos de seguridad. Es necesario gestionar de forma proactiva riesgos como la inyección de prompts, el envenenamiento de datos, las brechas en los controles de acceso y la filtración de datos. Al implementar estrategias como la sanitización de contenido, la aplicación de controles de acceso, la segmentación de datos, el análisis de vulnerabilidades y las auditorías periódicas, las organizaciones pueden mitigar estos riesgos y crear aplicaciones basadas en RAG más seguras. Para que la IA funcione de verdad en nuestras aplicaciones, es esencial contar con un plan sólido que tenga en cuenta tanto el rendimiento de los sistemas RAG como su seguridad.
Sigue desarrollando tus conocimientos sobre seguridad de la IA. Explora la ruta de aprendizaje OWASP Top 10 para LLMs en Snyk Learn.
Toma el control de la seguridad de la IA con Snyk
Descubre cómo Snyk ayuda a proteger el código generado por IA de tus equipos de desarrollo y ofrece a los equipos de seguridad visibilidad y controles completos.