Cómo crear un resumen de noticias de seguridad con un agente de IA de CrewAI
Escrito por

0 minutos de lectura
Revisar numerosas fuentes de noticias de seguridad y bases de datos de vulnerabilidades requiere mucho trabajo, pero con el auge de los flujos de trabajo de IA agéntica, podemos delegarlo en un LLM. En este artículo, te mostramos cómo usar el framework de código abierto CrewAI para crear un agente de IA que seleccione noticias de seguridad.
Agentes de IA para seleccionar noticias de seguridad
En la aplicación que crearemos, nos enfocaremos específicamente en seleccionar nuevas vulnerabilidades de seguridad de Snyk Vulnerability Database para crear un feed de noticias de seguridad.
Nuestro agente de IA será una herramienta de línea de comandos que abrirá la página web de Snyk Vulnerability Database para un ecosistema determinado (usaremos el ecosistema de JavaScript de npm) y seleccionará los 3 informes de CVE más relevantes que considere importantes.
Primeros pasos con CrewAI
En la primera fase, crearemos un directorio para el nuevo proyecto en la ubicación que prefieras de tu entorno de desarrollo local e inicializaremos allí el framework CrewAI.
Estos son los requisitos:
El administrador de paquetes uv está instalado y disponible localmente
Un entorno de ejecución de Python >= 3.x (se puede instalar con
uv)
En el directorio que elegiste, comencemos por instalar la biblioteca y las herramientas de crewai:
Luego, agrégalo al entorno de tu shell de trabajo para poder ejecutar el comando crewai como un ejecutable global:
Ahora podemos comenzar a crear la estructura de un nuevo proyecto de crewai:
Luego, instala las dependencias del proyecto con este comando:
Ahora, el directorio del proyecto debería tener esta estructura:
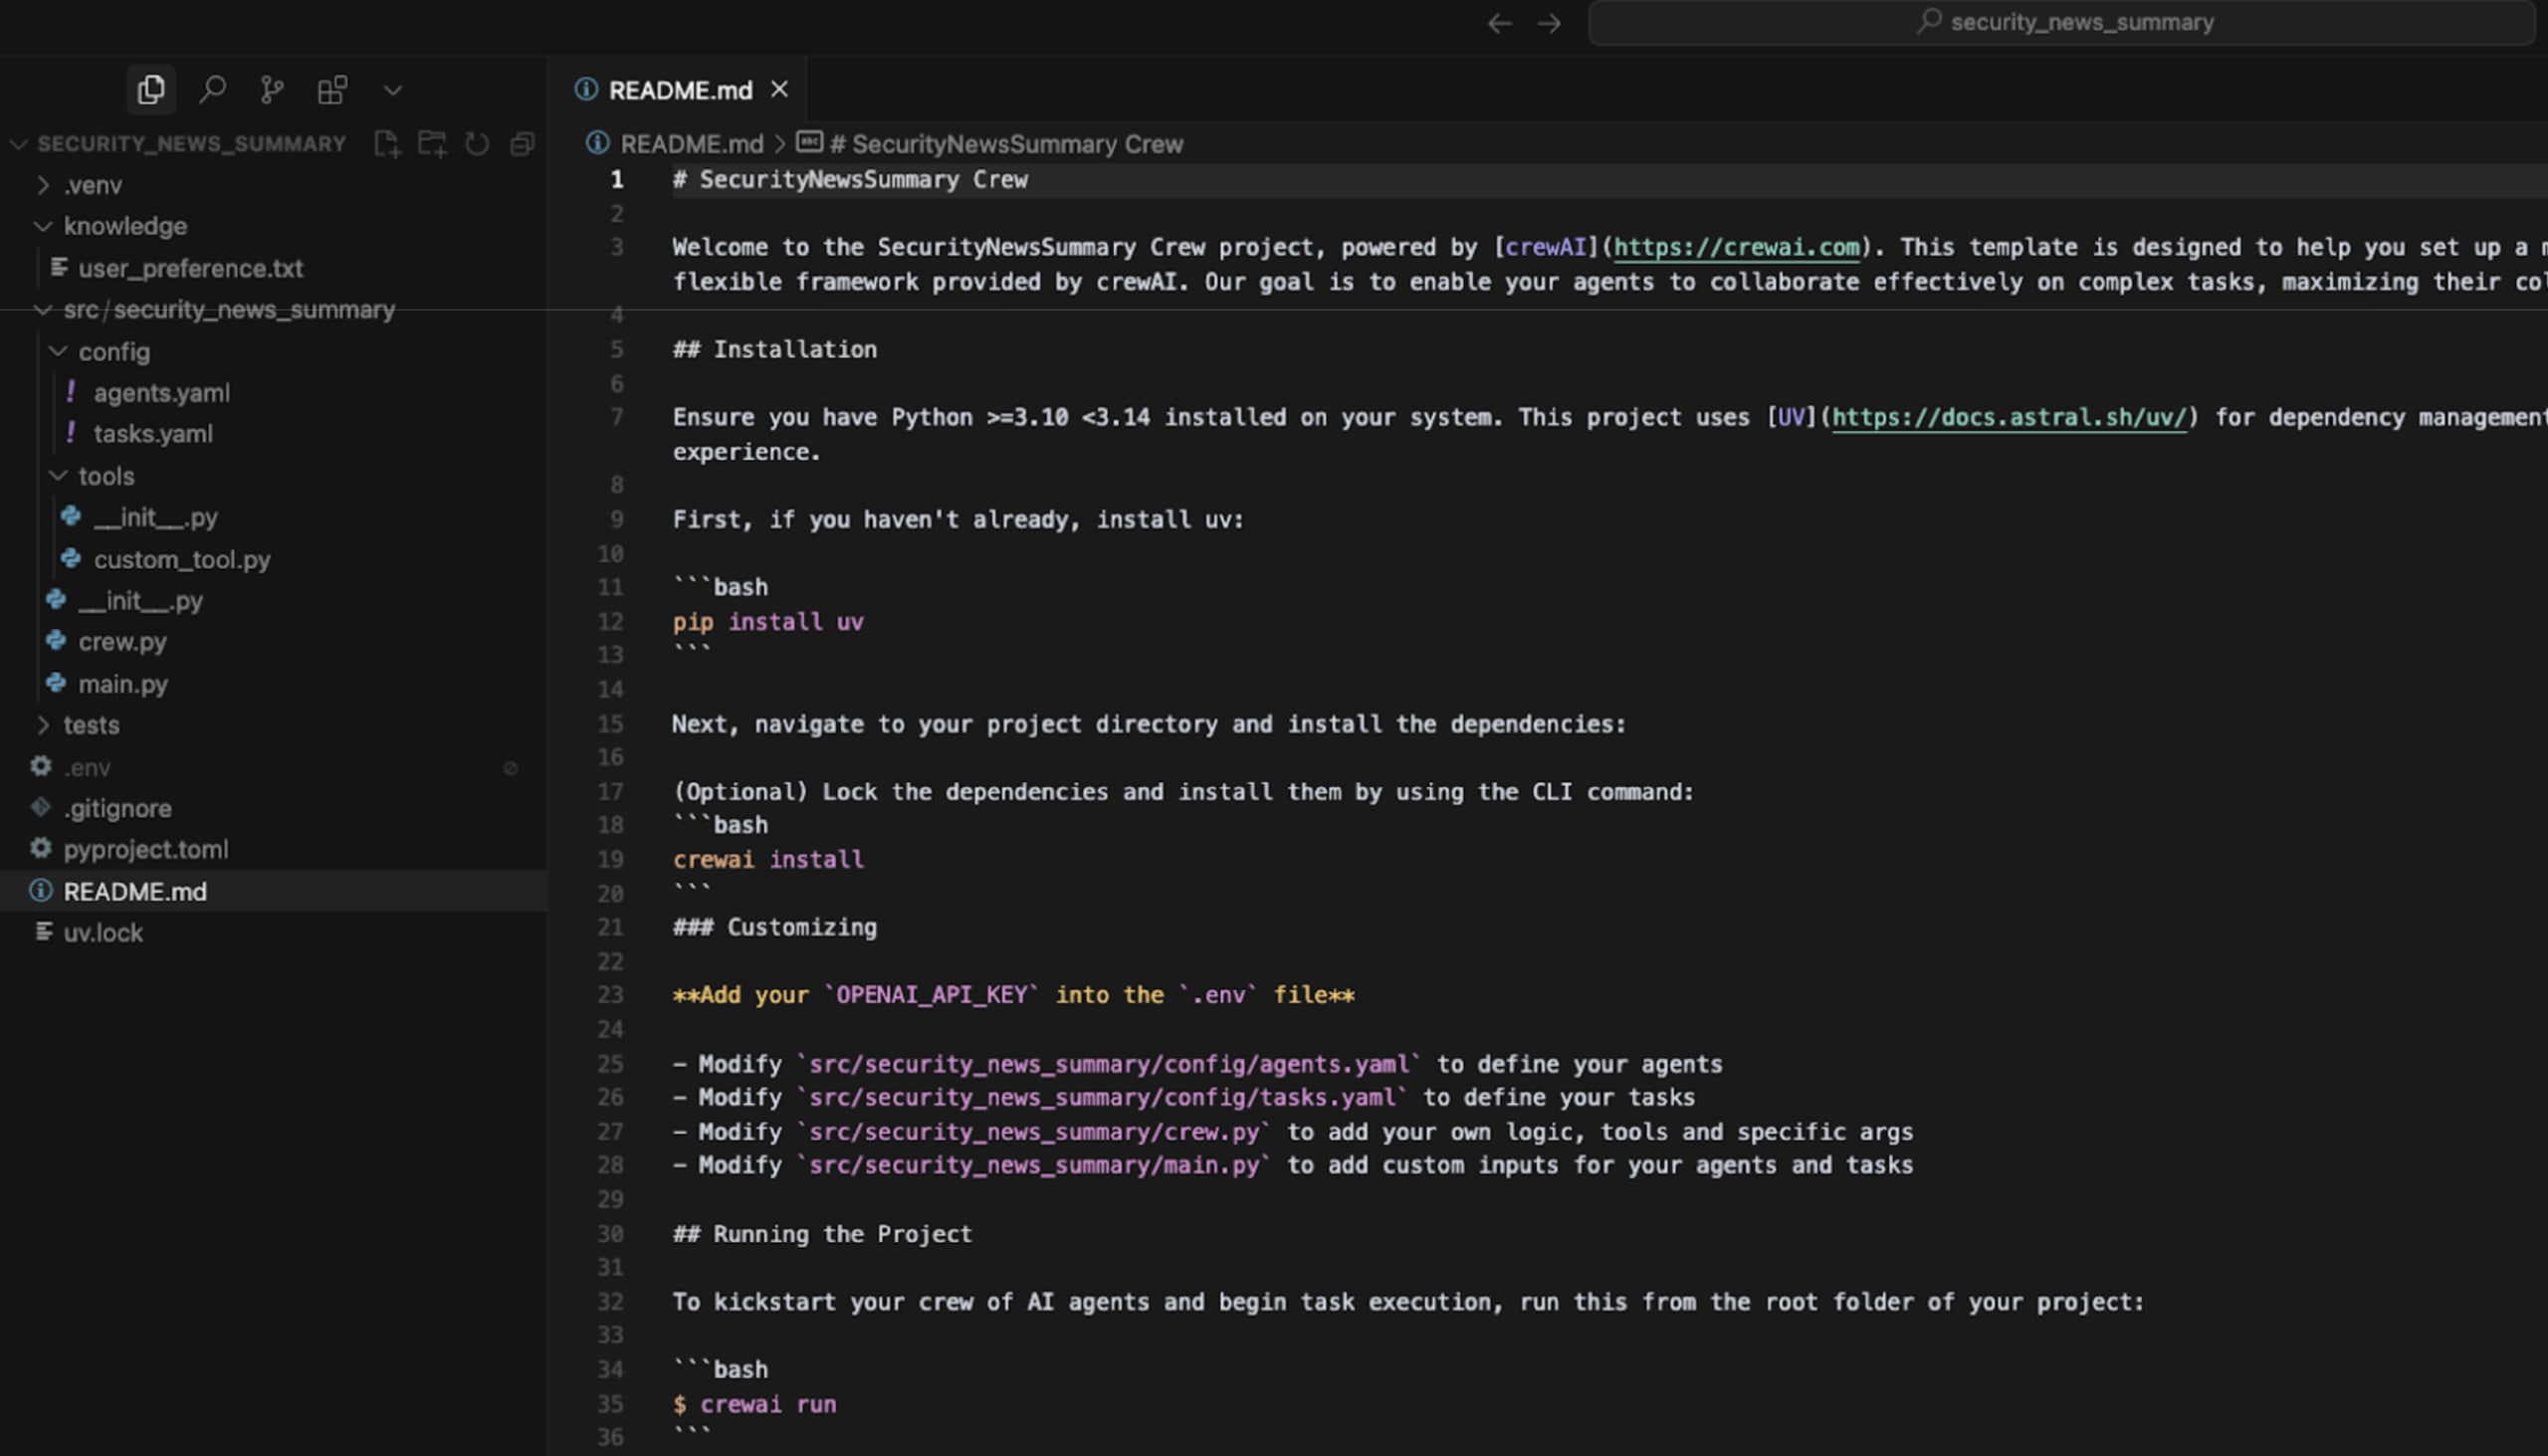
A grandes rasgos, CrewAI tiene un archivo crew.py que define los agentes y las tareas:
El mismo archivo también incluye las tareas que queremos llevar a cabo con esos agentes:
El archivo main.py incluye varias funciones exportadas, como run(), train() y otras, que invocan a los agentes y les proporcionan la información que necesitan para realizar su trabajo.
Así se ve el flujo de inicio de los agentes en el archivo principal de Python:
Lo anterior describe la estructura de directorios del ejemplo predeterminado que CrewAI crea para el proyecto. Sin embargo, vamos a hacer cambios, definir nuestros propios agentes y tareas, y crear una herramienta personalizada para que la usen los agentes.
Cómo crear flujos de trabajo agénticos personalizados con CrewAI
Haremos cambios en tres partes principales del directorio del proyecto CrewAI:
Cambios en los agentes de
config/agents.yamlCambios en las tareas de
config/tasks.yamlCambios en el programa principal de CrewAI en crew.py
Además, crearemos una herramienta personalizada en el directorio tools/ que extrae el HTML de una página web con BeautifulSoup, una popular biblioteca de Python.
Agentes de IA
Una buena regla general para los agentes de IA es dividir sus tareas en pasos lo más pequeños posible. Al igual que en el enfoque de la ingeniería y el diseño de software, descomponer los problemas grandes en otros más pequeños resulta útil.
Siguiendo este consejo, definiremos dos agentes:
Un curador de CVE, cuya función es encontrar en la página web los enlaces a los CVE que considere más importantes.
Un investigador de CVE, cuya función es visitar los enlaces individuales a los CVE (páginas web) y extraer datos de ellos.
Abre config/agents.yaml y reemplaza la definición de los agentes que creó CrewAI por lo siguiente:
Tareas
A continuación, tendremos que definir las tareas correspondientes:
La tarea inicial consiste en extraer los enlaces a los CVE del directorio de la base de datos de vulnerabilidades (la página web principal con los resultados de búsqueda y el listado de vulnerabilidades).
La tarea de seguimiento del agente investigador de CVE consiste en extraer los datos de vulnerabilidad de cada CVE de su página de información.
Abre el archivo config/tasks.yaml y reemplaza el contenido que creó la biblioteca CrewAI por lo siguiente:
Verás que las tareas están redactadas cuidadosamente para que nuestros agentes de IA las interpreten y cumplan. También incluyen un ejemplo del resultado esperado y las reglas que deben seguir.
Herramientas personalizadas
Para la primera tarea y nuestro primer agente, el curador de CVE, necesitamos crear una herramienta personalizada con código Python. Debemos hacerlo porque la herramienta integrada de CrewAI, ScrapeWebsiteTool, solo extrae texto de una página web y no puede analizar el código fuente HTML para extraer los elementos de anclaje (<a href>) que contienen los enlaces a los datos de cada CVE en la página.
Para empezar a crear una herramienta personalizada que puedan usar nuestros agentes, primero abre el archivo tools/__init__.py y actualízalo para exportar una nueva herramienta TableScraperTool de la siguiente manera:
Ten en cuenta que MyCustomTool ya estaba incluido en la estructura del proyecto de ejemplo de CrewAI.
A continuación, tenemos que crear TableScraperTool. Para ello, crea un archivo nuevo en tools/table_scraper.py y agrega el siguiente código de Python:
Por último, también debemos incluir y actualizar la biblioteca de Python BeautifulSoup como parte del proyecto. Para ello, actualiza la lista de dependencies de myproject.toml de la siguiente manera:
Luego, aplícala con este comando:
Archivo principal de ejecución de CrewAI
Ahora enfoquémonos en el archivo principal crew.py, que encontrarás en src/security_news_summary o en el directorio donde hayas creado la estructura del proyecto CrewAI.
Edita el archivo y, primero, actualiza la importación de la siguiente manera (incluiremos nuestra herramienta personalizada TableScraperTool):
Luego, desplázate hacia abajo y busca las funciones con anotaciones para agentes (identificadas con la anotación @agent) y tareas (identificadas con la anotación @task). Actualízalas para que reflejen los agentes y las tareas que acabamos de definir:
Ejecutar agentes de IA con CrewAI
Eso es todo. Ya estamos listos para ejecutar nuestros agentes de IA y que seleccionen nuevas vulnerabilidades de seguridad usando Snyk Vulnerability Database como fuente de datos.
Solo tenemos que iniciar los agentes de CrewAI desde la terminal con este comando:
Y los agentes de IA comienzan a trabajar:
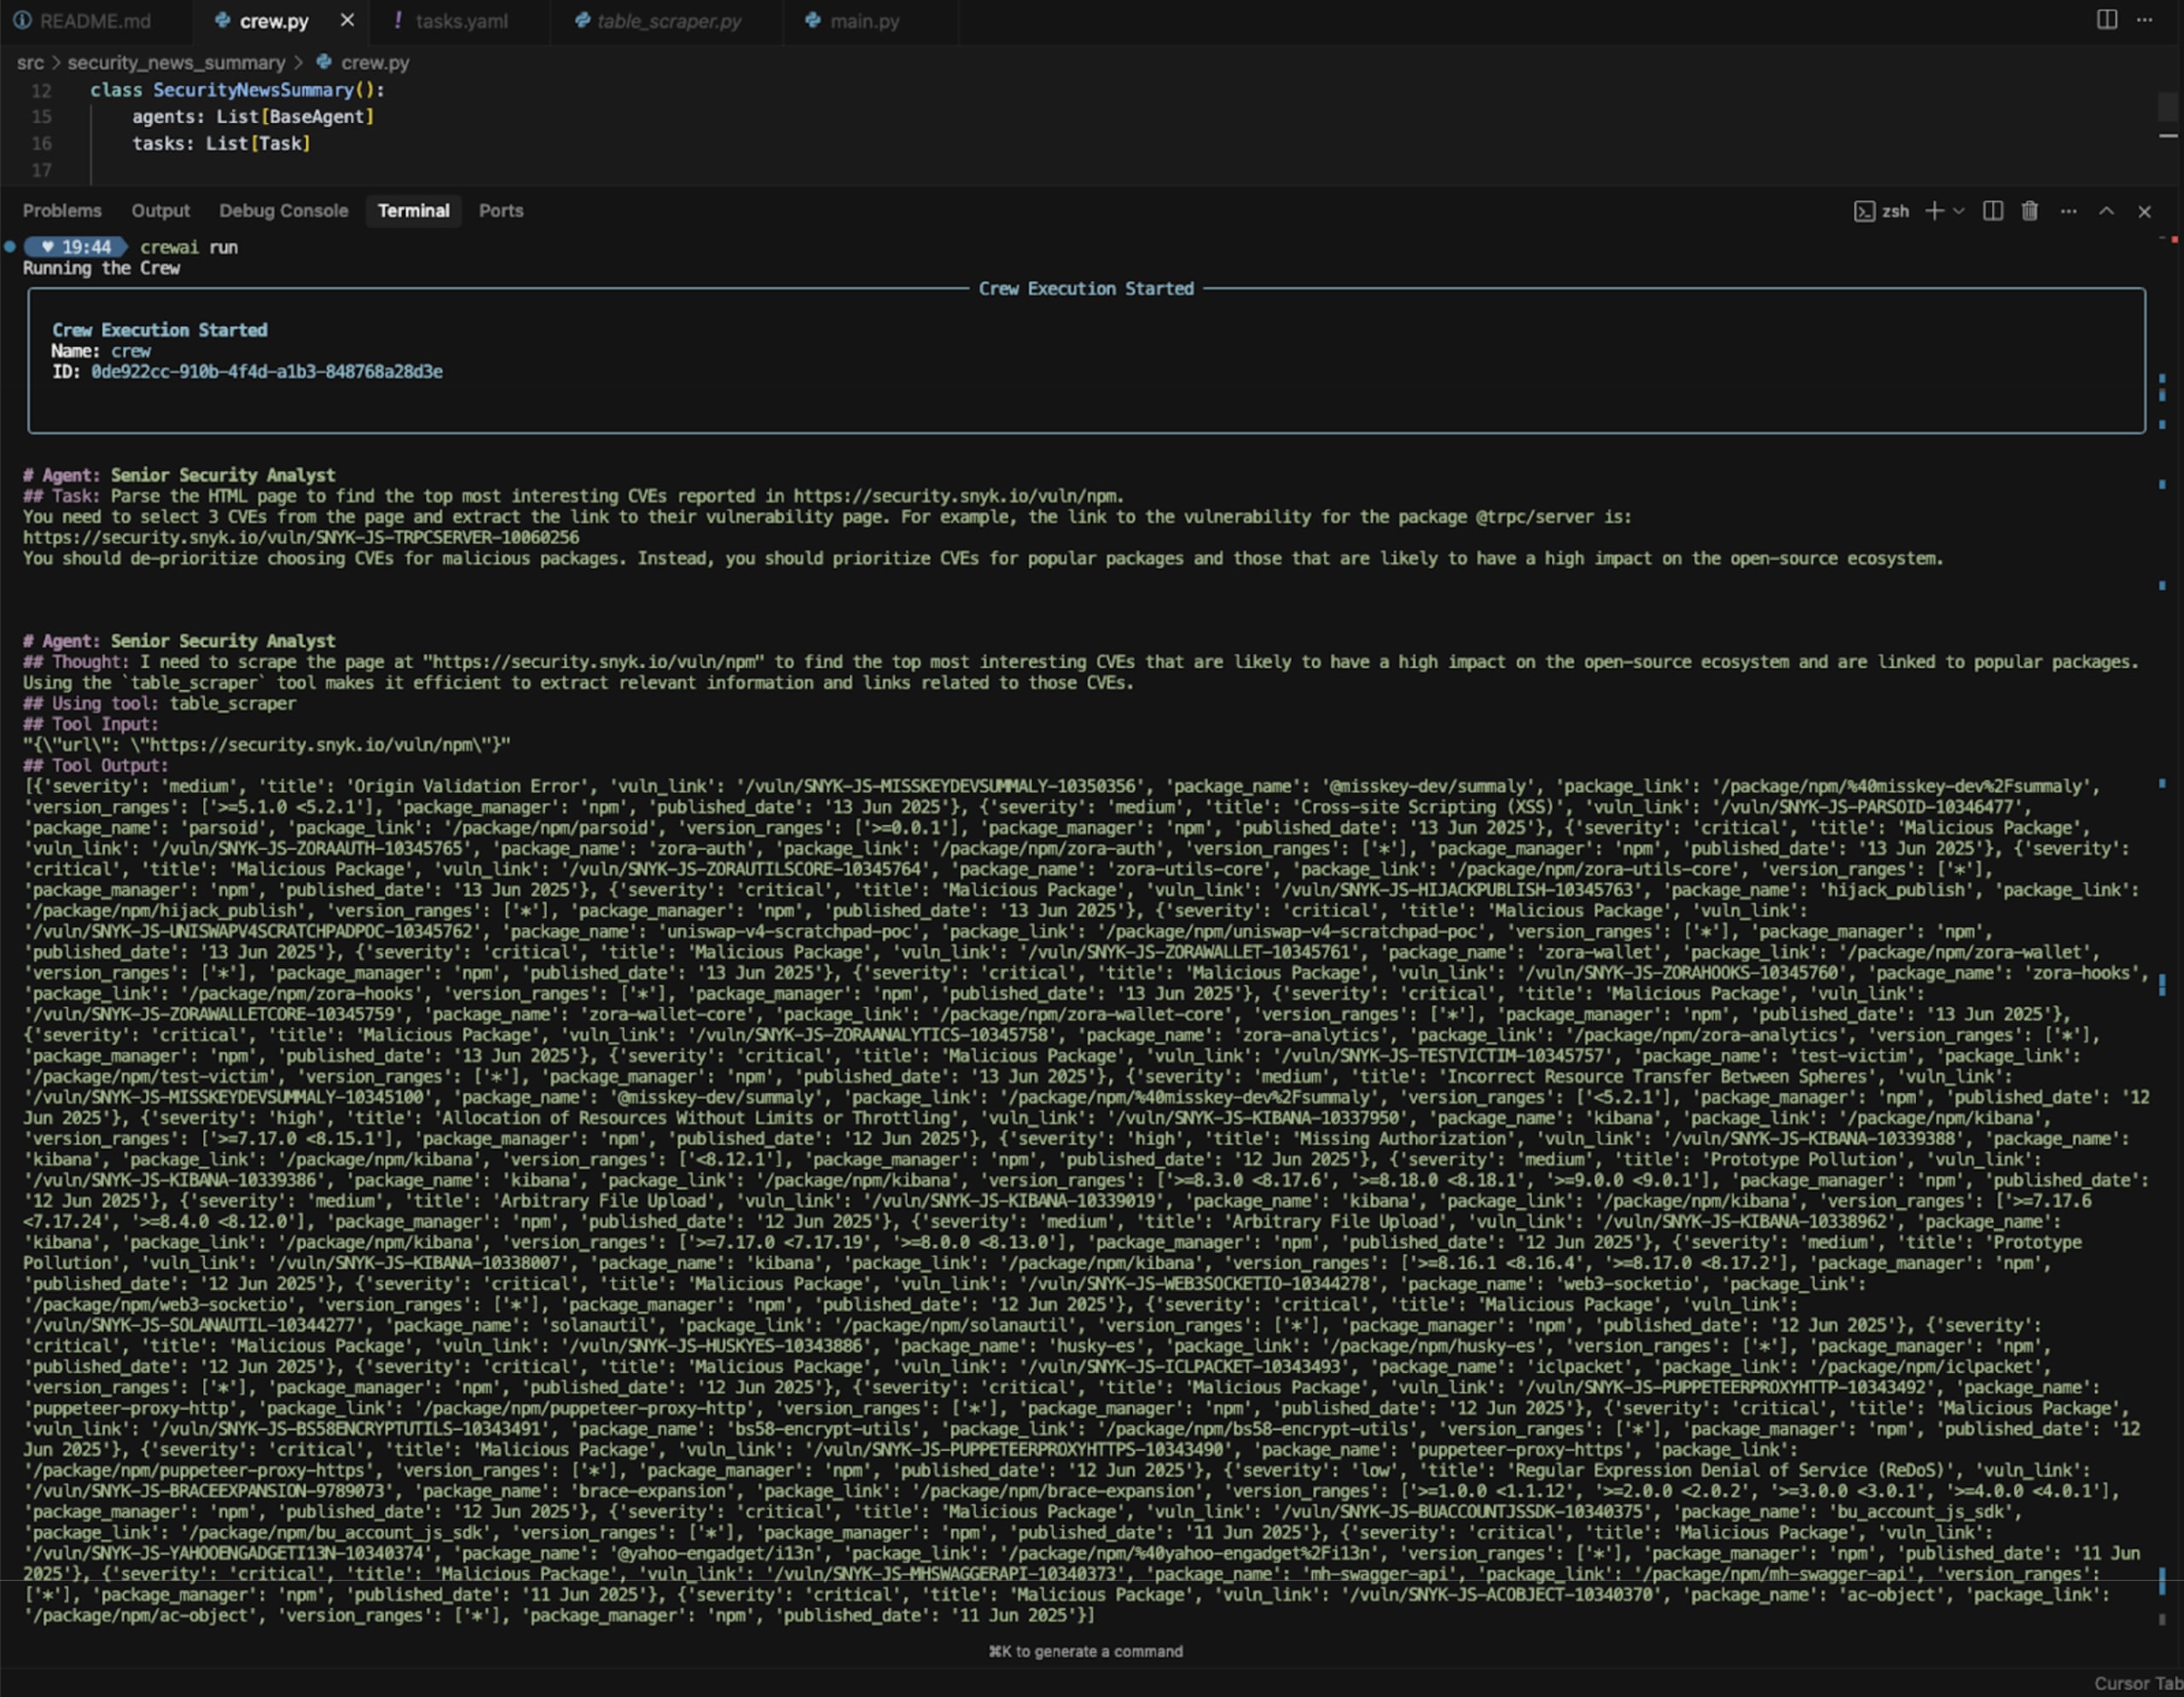
A medida que avanzan, se informa el estado de las tareas:

Acerca de la seguridad de la IA y los flujos de trabajo agénticos
Crear agentes de IA parece mágico. Cuando funciona, su ejecución es sorprendentemente buena, y la biblioteca CrewAI para la orquestación de agentes es muy fácil de usar.
Dado el rápido avance de la IA y los flujos de trabajo de programación agéntica, debes prestar mucha atención a la confianza en la IA y establecer barreras de seguridad para evitar introducir riesgos y vulnerabilidades, como implementaciones inseguras de servidores MCP, ataques de inyección de prompts y otras superficies vulnerables relacionadas con la seguridad de la IA.
Te recomiendo estos recursos:
Revisa las barreras de seguridad para el código de IA de Snyk
Programación segura con IA con Snyk (y servidores MCP)
Entender la inyección de prompts: técnicas, desafíos y riesgos.
Desarrolla con IA de forma segura desde el inicio
Aprende a integrar la seguridad en cada etapa de tu flujo de trabajo de programación con IA, con consejos prácticos de implementación de expertos.